
AI Model Fine-tuning
汎用AIをファインチューニングし、 自社データで業務特化の精度へ。
公開されている汎用AIモデルは、そのままでは自社特有の書式・専門用語・複雑なレイアウトに弱いことがあります。私たちは、公開モデルを土台に自社データで追加学習(LoRAファインチューニング)を行い、特定業務での精度を大きく引き上げます。まずは、複雑な表の構造化AIでの実験結果をご紹介します。
評価方法・学習手法・比較事例をまとめた詳細レポート(PDF)を、フォームからその場でダウンロードいただけます。
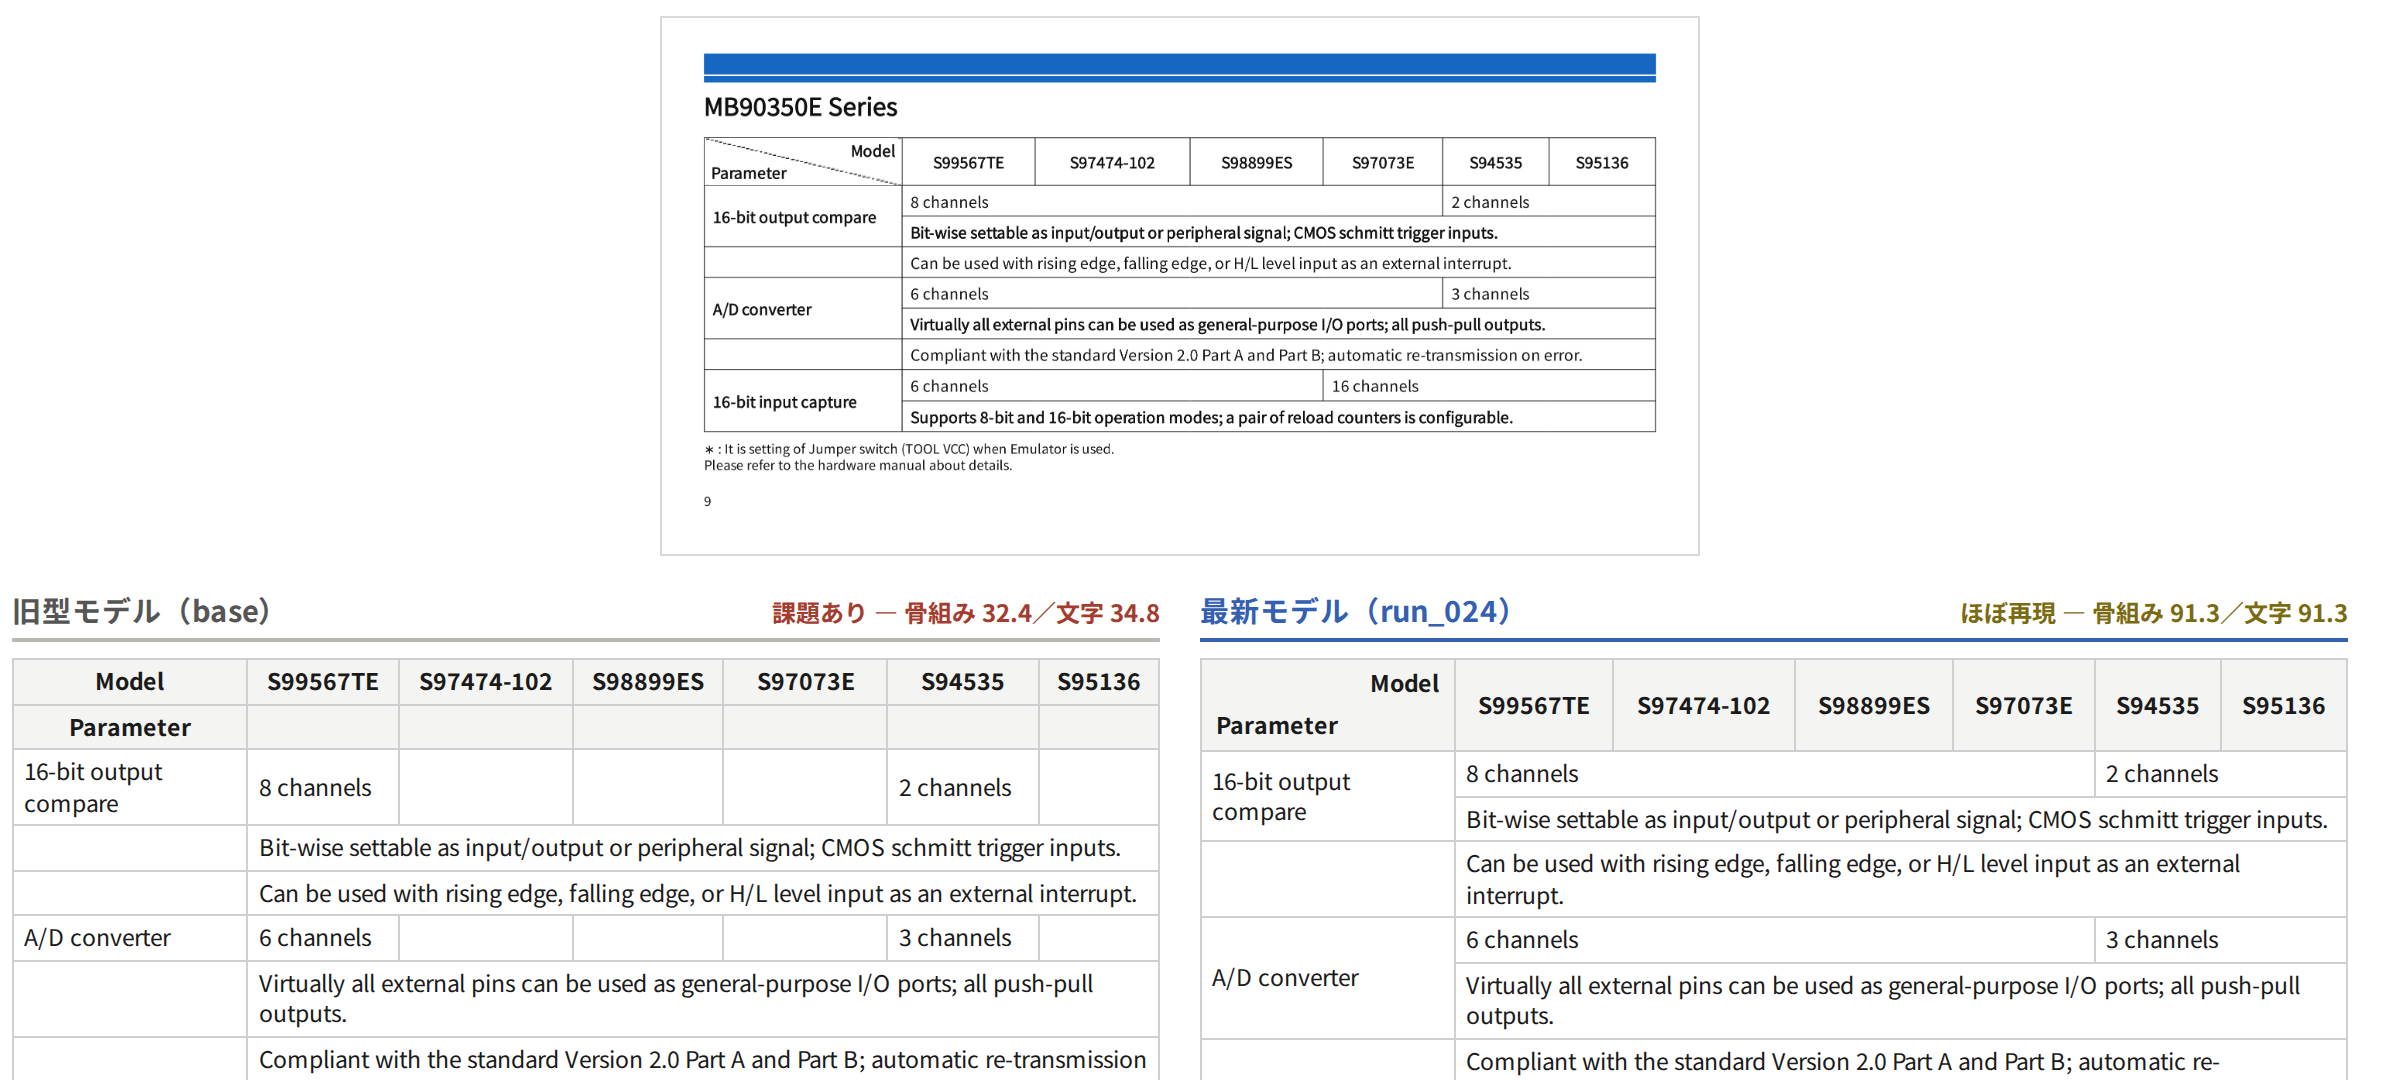
(左は従来モデル、右は当社チューニング後)
Performance
複雑な表で、精度が大きく向上
学習に使用していない同一のテストデータ(表1,000枚)で測定した、追加学習前の汎用AIとの比較です。
2.5倍
複雑な表の再現精度
37.6 → 94.3(結合セルの正確さ)
99%
斜線ヘッダの認識
従来は認識不可 → 99.3%
1/31
読み間違いを削減
誤検出 23.9% → 0.8%
Before / After
AIが起こしがちな“表のミス”を、追加学習で低減
左のイラストは、AIが表の読み取りで犯しがちなミスの種類です。追加学習(ファインチューニング)により、各項目が「従来 → 最新」でこれだけ改善しました(同一の1,000枚テストでの実測値)。
| 結合 | ||
複雑な表の正確さ結合セル(行・列をまたぐマス)の位置・範囲
従来 37.6→94.3約2.5倍
結合セルの多い複雑な表を、崩さず正しく再現。
| 見出し | ||
表の骨組み行・列・結合を含む構造の一致
従来 70.1→95.4
多段の見出しや入れ子構造も、階層を保って再現。
| ABC | 12 |
| ◯ | △ |
文字の一致各マスの中身が完全一致した割合
従来 36.9→94.8
上付き・下付き文字や単位も、取り違えずに保持。
<table>
<tr><td>…</td>
</table>
<tr><td>…</td>
</table>
そのまま使える出力壊れていない正しいHTML形式か
従来 93.6→96.1
人手の再入力なしに、業務システムへ取り込める形式で出力。
| 余分 | ||
ありもしないセルの誤追加AIが余分なセルを作ってしまう割合(少ないほど良い)
従来 23.9%→0.8%約1/31に削減
実在しない情報を作り出す“ハルシネーション”を大幅に抑制。
| 抜け | ||
セルの読み落とし本来あるセルを取りこぼす割合(少ないほど良い)
従来 29.3%→4.6%約1/6に削減
情報の抜け漏れを減らし、表を余さずデータ化。
| 列名行名 | A |
| 項目 | 1 |
斜線ヘッダの認識1マスを斜線で分け、縦横の見出しを同居させた表
従来 認識不可→99.3%
従来モデルが構造ごと崩していたデータシート特有の表を、列名・行名の向きまで正しく構造化。実物のデータシート紙面でも確認済み。
各指標の意味は左のイラストの通りで、数値は学習に使用していない同一テスト(表1,000枚、斜線は専用テスト)での実測値です。
Approach
汎用モデルを、貴社の業務に合わせて鍛える
元のモデルには手を加えず、追加学習した差分だけを保存(LoRA)。安全かつ低コストに、業務特化の精度を実現します。
読みにくいデータに強くなる
結合セル・多段ヘッダなど、自社特有の書式・レイアウトを、追加学習で正しく扱えるようにします。
元のモデルを壊さない
ベースモデルは凍結し、追加分だけを小さく学習・保存(LoRA)。安全かつ短時間で調整できます。
自社環境で完結
学習・推論とも社内サーバーで実行可能。データを外部に出さず、機密性の高い業務にも対応します。
実物のデータシート紙面での認識も確認済み。すべての数値は学習・調整に一切使用していない最終評価用テストセットでの実測値です。
Contact
技術レポート(PDF)を無料でダウンロードいただけます
評価方法・学習手法・複雑な表での旧型/新型の比較事例をまとめた技術レポートを、フォームからその場でダウンロードいただけます。自社データでのファインチューニングのご相談・PoCのご依頼もお気軽にどうぞ。