AIと著作権の基本。学習と生成の2段階で見る侵害リスクと企業が決めておく5項目
「生成AIを業務で使いたいが、著作権の面で問題がないのか判断できず、社内の展開が止まっている」という方も多いでしょう。法務から「著作権は大丈夫か」と聞かれても、どこを確認すればよいのか分からないという声は、AI推進の担当者からよく聞かれます。
ただし、AIと著作権の問題は1つではありません。AIに学習させる場面と、AIで作ったものを使う場面では、適用される条文も判断の基準も異なります。この2つを混ぜたまま議論すると、「全部危ない」か「全部大丈夫」のどちらかに振れてしまいます。
そこで本記事では、
- 文化庁の考え方に沿った、学習・開発段階と生成・利用段階の論点の分け方
- 著作権法30条の4で許される学習の範囲と、生成物が侵害になる条件、成果物の権利の帰属
- 主要な生成AIサービスの補償条件、国内外の訴訟事例、社内で決めておく5項目
についてわかりやすく解説します。社内の生成AI活用やAI開発の推進を任されている方は、ぜひ最後までご覧ください。
本記事は、文化庁が公表している資料をもとに論点を整理したもので、個別の事案についての法的な判断を示すものではありません。具体的な判断が必要な場合は、弁護士などの専門家に相談してください。
自社のデータを使ったAI活用を、権利面も確認しながら進めたいという方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
AIと著作権の基本。文化庁が示す2つの段階
AIと著作権を考えるときは、まず「何が守られているのか」と「どの段階の話なのか」を切り分けます。この2点を押さえると、後の議論が整理しやすくなります。
著作権で守られるのは「創作的な表現」
著作権法は、著作物を「思想又は感情を創作的に表現したものであつて、文芸、学術、美術又は音楽の範囲に属するもの」と定義しています(第2条第1項第1号)。守られるのは具体的な表現であり、作風やアイデアそのものは原則として保護の対象になりません。
例えば、ある作家の文章をそのまま写すことは問題になり得ますが、「その作家のような簡潔な文体」で書くこと自体は、表現を写していない限り著作権の問題にはなりにくい、ということです。
学習・開発段階と生成・利用段階で論点が変わる
文化審議会著作権分科会法制度小委員会が令和6年3月15日にまとめた、AIと著作権に関する考え方の文書(以下、「AIと著作権の考え方」)は、生成AIで著作物が使われる場面を「開発・学習段階」と「生成・利用段階」の2つに分けて整理しています(p.18)。
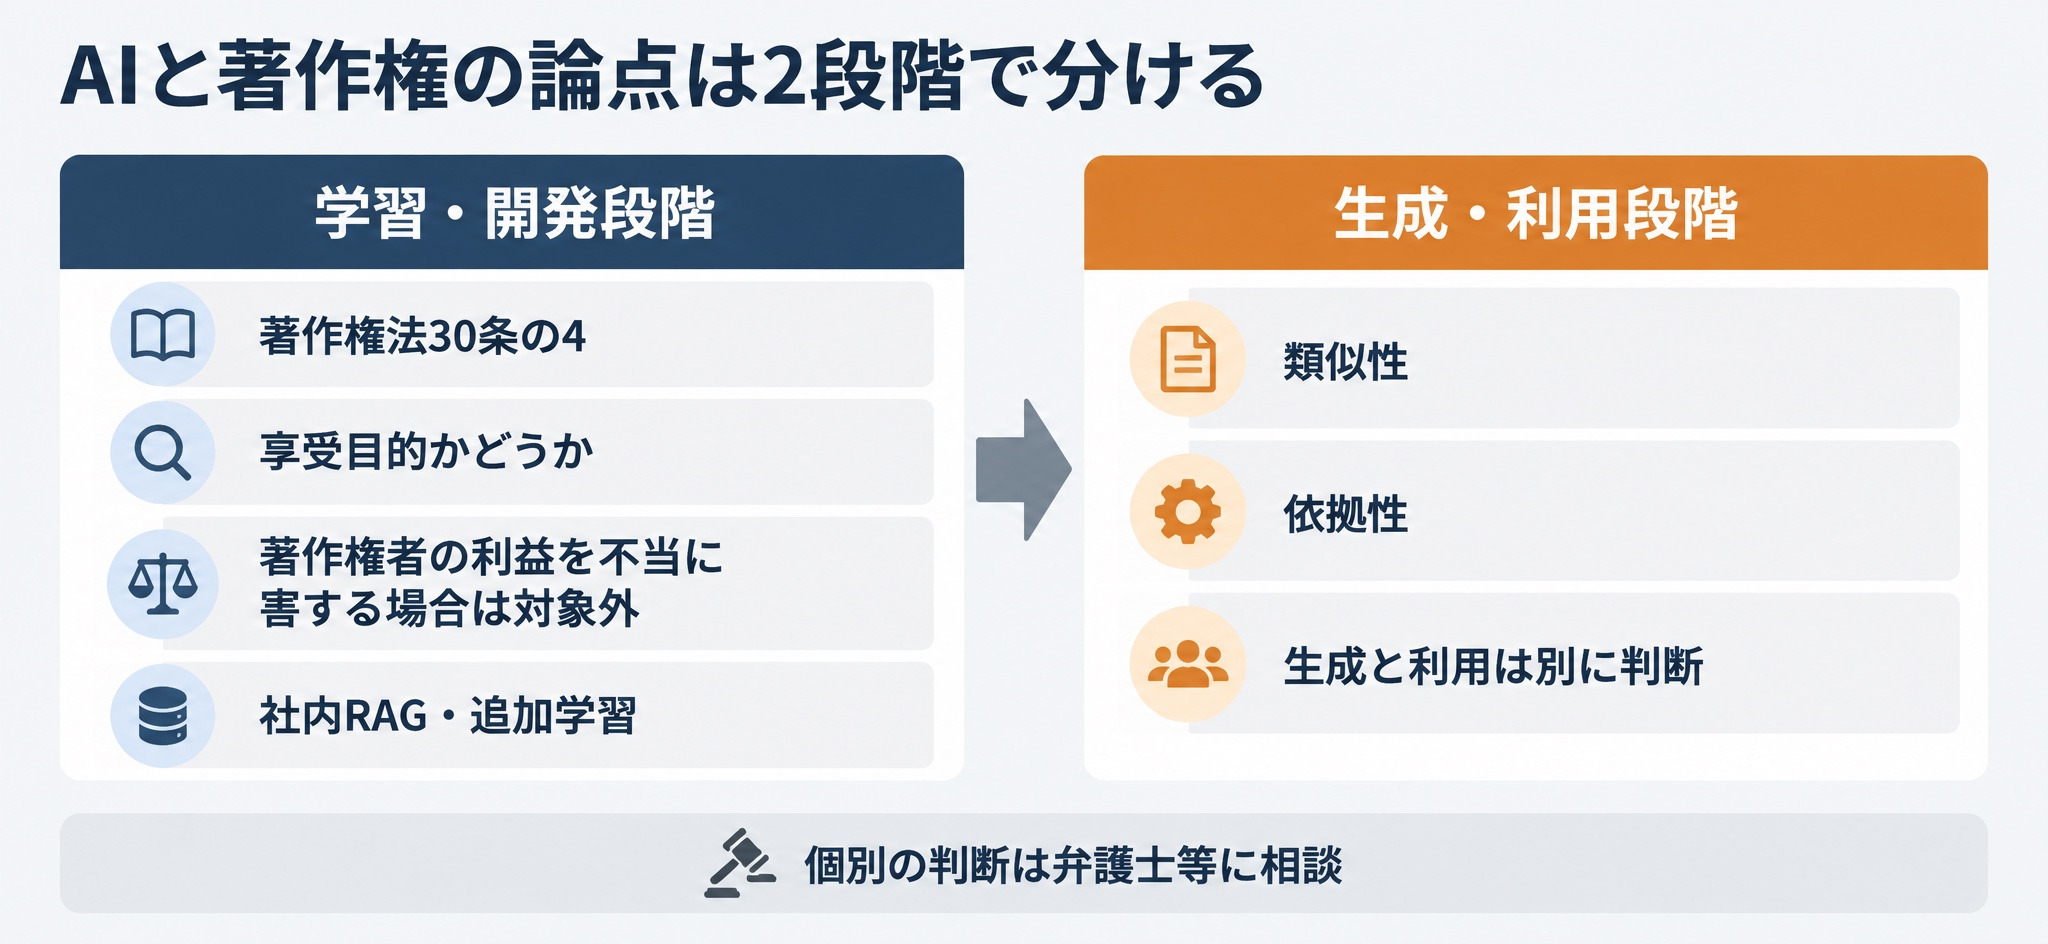
2つの段階で主に問われることを並べると、次のとおりです。
| 段階 | 主な行為 | 主な論点 | 主な条文 |
|---|---|---|---|
| 学習・開発段階 | 学習データの収集、事前学習、追加学習、RAG用データベースの作成 | 許諾なしで著作物を使える範囲か | 第30条の4、第47条の5 |
| 生成・利用段階 | AIで文章や画像を作る、作ったものを公開・販売する | 生成物が既存の著作物の侵害にならないか | 通常の侵害判断(類似性と依拠性) |
この表から分かるのは、同じ「AIと著作権」でも、学習の段階では「許諾なしで使えるか」、生成・利用の段階では「作ったものが他人の権利を侵害しないか」と、問いそのものが異なるという点です。外部の生成AIを使うだけの企業は主に生成・利用段階に、社内データでRAGや追加学習を行う企業は両方の段階に関わります。
文化庁の資料は2024年版が最新。法的拘束力はない
2026年9月時点で、文化庁の「AIと著作権について」のページに掲載されている中核の資料は、「AIと著作権の考え方」(令和6年3月15日)と「AIと著作権に関するチェックリスト&ガイダンス」(令和6年7月31日)の2つです。その後に追加されたのは、文化庁と経済産業省による「AIと著作権に関する関係者ネットワークの総括」(令和7年5月30日)で、中核の2資料は改訂されていません。
注意したいのは、「AIと著作権の考え方」の冒頭に、この考え方自体が法的な拘束力を持つものではないと明記されている点です。最終的な判断は裁判所が行います。本記事で紹介する内容も、文化庁が示した考え方としてお読みください。
参照:AIと著作権に関する考え方の文書(PDF)|文化審議会著作権分科会法制度小委員会
学習データと著作権。著作権法30条の4で許される範囲
全体像を押さえたところで、自社でAIを作る側に回ったときに最初に問われる、学習データの扱いを見ていきます。中心になるのが著作権法第30条の4です。
30条の4の条文と「享受目的」
第30条の4の本文は、「著作物は、次に掲げる場合その他の当該著作物に表現された思想又は感情を自ら享受し又は他人に享受させることを目的としない場合には、その必要と認められる限度において、いずれの方法によるかを問わず、利用することができる」と定めています。
条文の第2号には「情報解析」が挙げられており、AIの学習はこの情報解析に当たり得ます。つまり、著作物の表現を人が味わうことを目的としない利用であれば、原則として権利者の許諾なく学習に使えるという仕組みです。
ここでいう「享受」とは、「AIと著作権の考え方」によれば、著作物を見たり聞いたりして知的・精神的な欲求を満たす効用を得ることに向けられた行為かどうかで判断されます(p.10)。そして、複数の目的のうち1つでも享受の目的が含まれていれば、30条の4は適用されません(p.19)。
「AIと著作権の考え方」は、享受目的が併存する例として、学習データに含まれる著作物の創作的表現の全部または一部を、意図的に出力させることを目的とした追加学習を挙げています(p.20)。いわゆる過学習を意図的に行う場合がこれに当たります。
「著作権者の利益を不当に害する場合」は対象外
30条の4にはただし書があり、「著作権者の利益を不当に害することとなる場合は、この限りでない」とされています。「AIと著作権の考え方」は、この該当性を、著作権者の著作物の利用市場と衝突するか、将来の販路を妨げるかという観点で判断するとしています(p.23)。
具体例として挙げられているのは、次のような場面です。
- 情報解析用に整理されたデータベースの著作物が販売されている場合に、そのデータベースを学習目的で複製すること(p.24)
- 有料のAPIで提供されているのに、閲覧用に掲載された記事からデータを収集すること(p.25)
- robots.txtなどで学習用の収集を拒む技術的な措置がとられ、データベースとして販売する予定が推認される場合に、その措置を回避して大量に収集すること(p.26〜27)
一方で、著作権者が「学習に使わないでほしい」と表明しているだけでは、ただし書には当たらないとされています(p.26)。表明があるかどうかではなく、技術的な措置や市場との衝突が判断の材料になる、という整理です。
社内RAG・追加学習で気をつけること
企業が自社でAIを作るときに関係が深いのが、RAG(検索拡張生成)と追加学習です。RAGとは、AIが回答を作る前に社内文書などを検索し、見つかった内容を根拠として回答させる仕組みを指します。
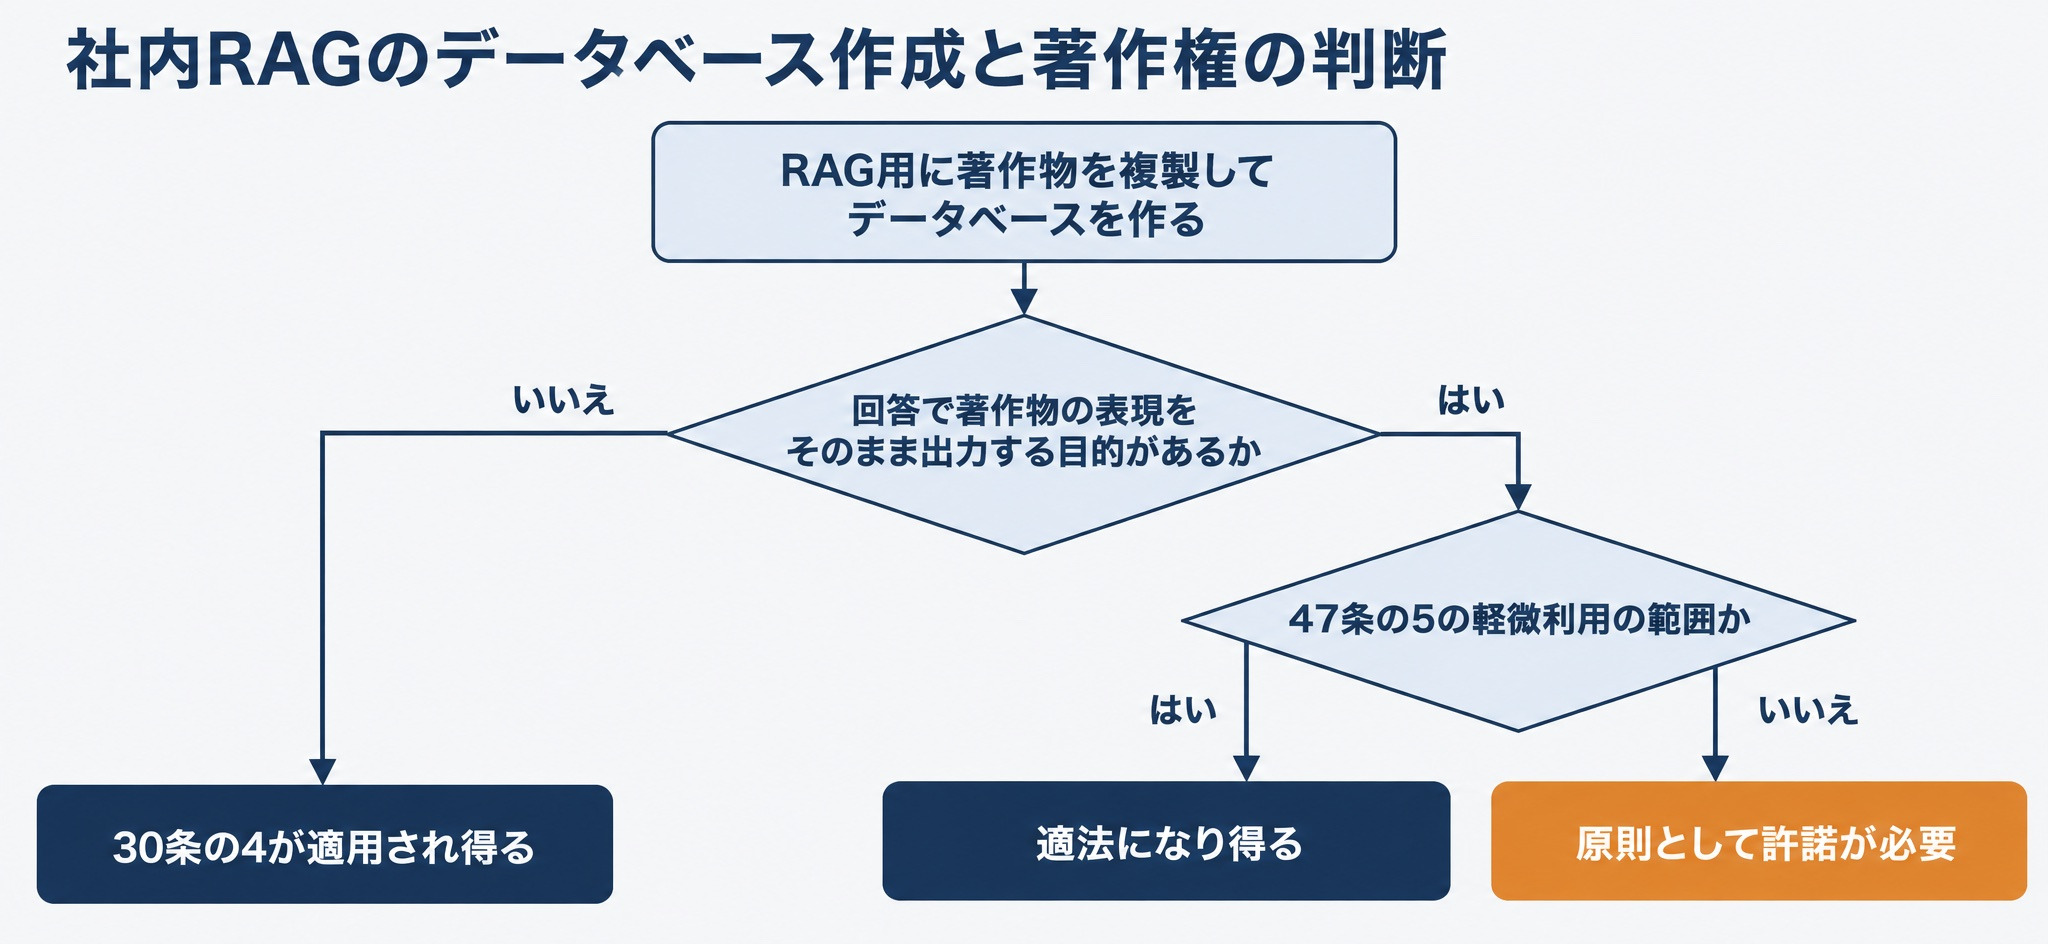
「AIと著作権の考え方」は、RAGのために著作物を複製してデータベースを作る行為について、次のように整理しています(p.22)。
- 著作物の創作的表現を出力することを目的としないものであれば、30条の4が適用され得る
- 回答の中で著作物の表現をそのまま出力する目的がある場合は、30条の4は適用されない
- その場合でも、第47条の5が定める「軽微利用」の範囲であれば適法になり得る。軽微利用を超えれば、原則として許諾が必要になる
例えば、社内規程や自社が作成したマニュアルを検索対象にするRAGは、著作権の問題が起きにくい構成です。これに対し、購読している業界誌の記事や外部の有料レポートを取り込み、回答にその文章を長く引用させる構成は、許諾が必要になる可能性があります。追加学習でも、特定の作家の少量の作品だけを学習させて作風を再現させる使い方は、享受目的の併存が問題になり得ると「AIと著作権の考え方」は述べています(p.20〜21)。
つまり、自社でAIを作る場合は「何のデータを、どこから入手し、回答でどこまで表現を出すか」を設計の段階で決めておくことが、学習段階の論点への備えになります。
生成AIの出力が著作権侵害になる条件
学習が30条の4で認められる場合でも、AIで作ったものの使い方は別に判断されます。ここからは、生成AIの利用者に最も関係する生成・利用段階を見ていきます。
類似性と依拠性の2つがそろうと侵害になり得る
「AIと著作権の考え方」は、生成・利用段階で既存の著作物との類似性と依拠性が認められれば、著作権者は差止請求や損害賠償請求をし得るとしています(p.32)。これは、AIを使わない通常の著作権侵害と同じ枠組みです。
- 類似性:生成物から、既存の著作物の表現上の本質的な特徴を直接感じ取れるか
- 依拠性:既存の著作物をもとにして作られたか
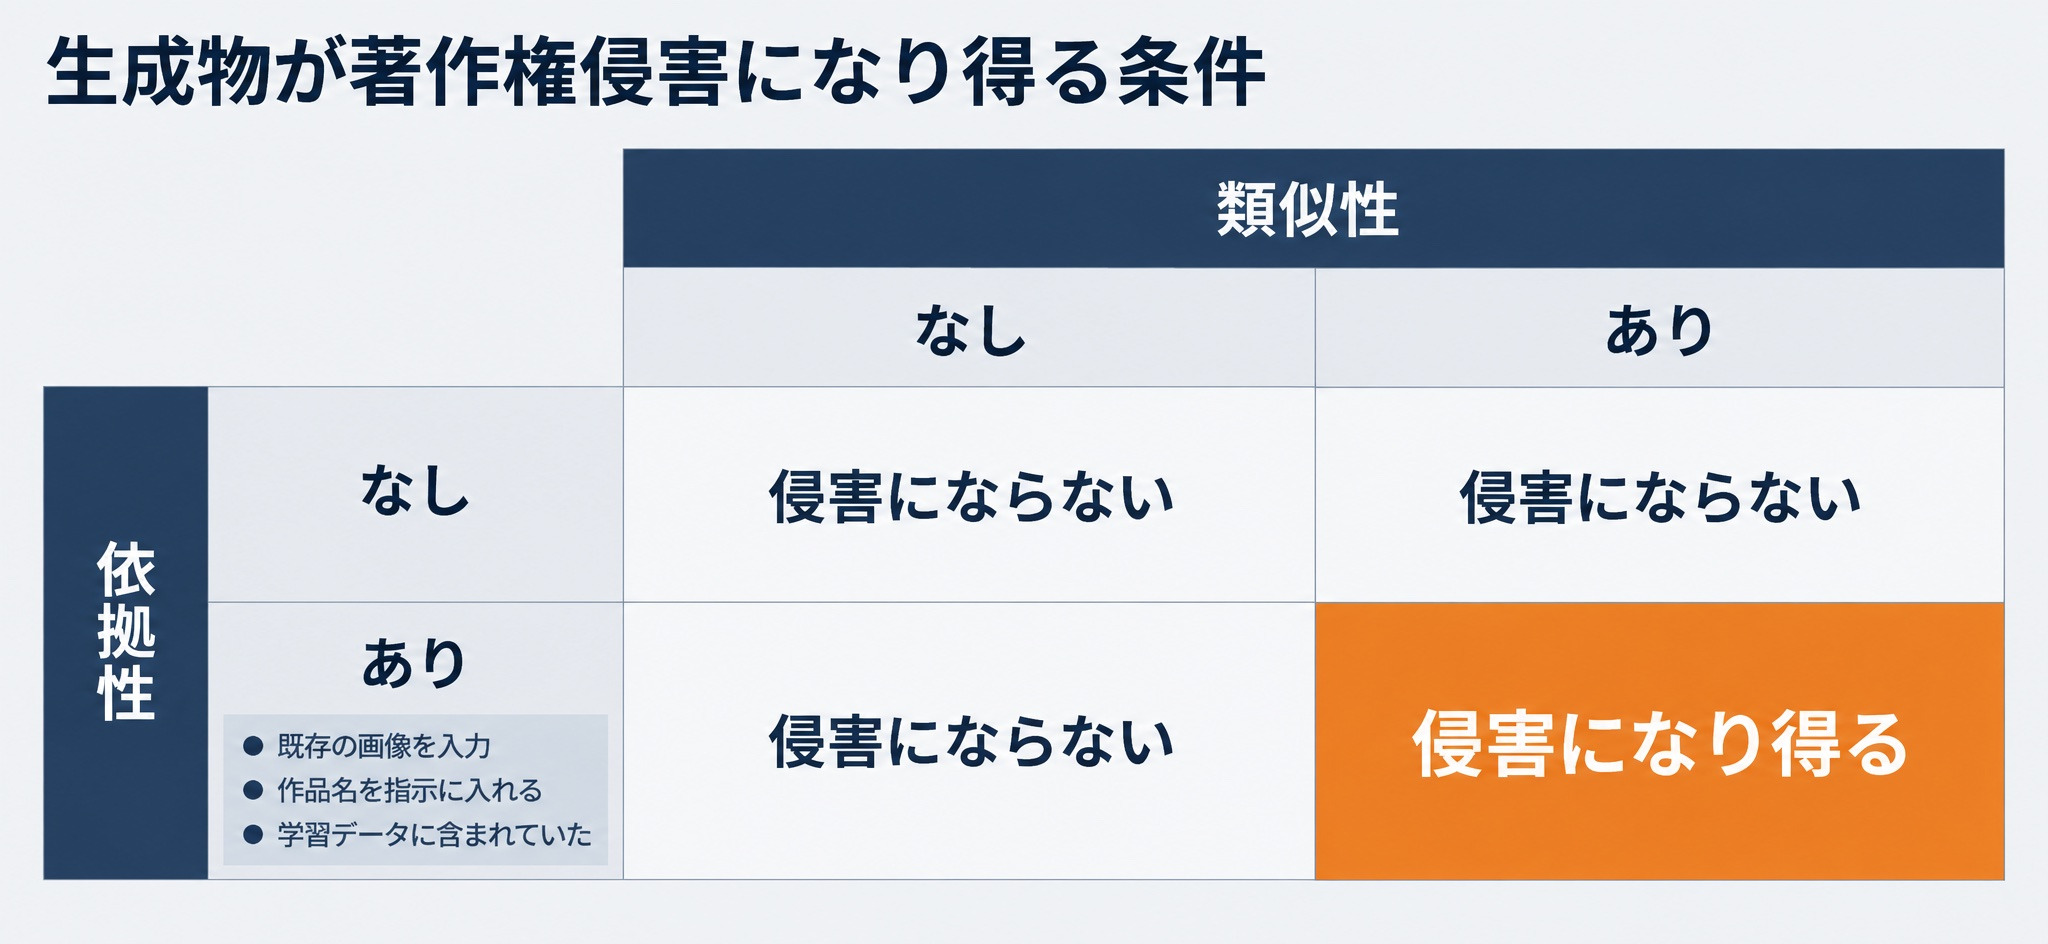
依拠性が認められやすい典型例として、「AIと著作権の考え方」は、既存の画像を入力して画像を生成する使い方(Image to Image)や、作品名などの固有名詞を指示に入れる使い方を挙げています(p.33)。利用者が既存の著作物を認識したうえで生成している場合です。
学習データに含まれていた作品は依拠性が推認され得る
利用者が既存の著作物を知らなかった場合でも、安心はできません。「AIと著作権の考え方」は、既存の著作物がAIの学習データに含まれていた場合、類似した生成物が生成されれば、通常は依拠性があったと推認され、AI利用者による著作権侵害になり得るとしています(p.34)。
一方で、利用者も学習データも既存の著作物に接していなければ、偶然の一致として侵害は成立しないとされています(p.34〜35)。ただし、外部の生成AIを使う企業は、そのモデルの学習データに何が含まれているかを通常は確認できません。このため、出力が既存の作品に似ていないかを、公開前に確かめる工程が実務上の防御になります。
生成と利用は別に判断される
「AIと著作権の考え方」は、AIで生成する行為と、生成物を公開・販売する行為を、それぞれ別に判断するとしています(p.35)。社内の検討用に生成するだけなら問題にならない場合でも、同じ生成物を広告やWebサイトで公開すれば、侵害と判断される可能性があります。
故意も過失もない場合でも、損害賠償は認められない一方で、差止請求は受け得るとされています(p.35)。「知らなかった」場合でも、公開した制作物の取り下げや作り直しが必要になることがある、ということです。
AI生成物に著作権はあるか。成果物の帰属の考え方
ここまでは、他人の著作権を侵害しないための話でした。次は反対側の、AIで作った自社の成果物が著作権で守られるのか、誰のものになるのかという話に進みます。
著作物性を分けるのは人の創作的寄与
「AIと著作権の考え方」は、生成AIへの指示が表現に至らないアイデアにとどまる場合、AI生成物に著作物性は認められないとしています(p.39)。そのうえで、人の創作的寄与があるかを判断する要素として、次の3つを挙げています(p.40)。
- 指示・入力の分量と内容:創作的表現を具体的に示す詳細な指示は、著作物性を認める方向に働き得る
- 生成の試行回数:試行回数が多いこと自体は影響しない。ただし、生成物を確認して指示を修正しながら試行を重ねる場合は、著作物性が認められることもあり得る
- 複数の生成物からの選択:単に選ぶだけでは影響しない
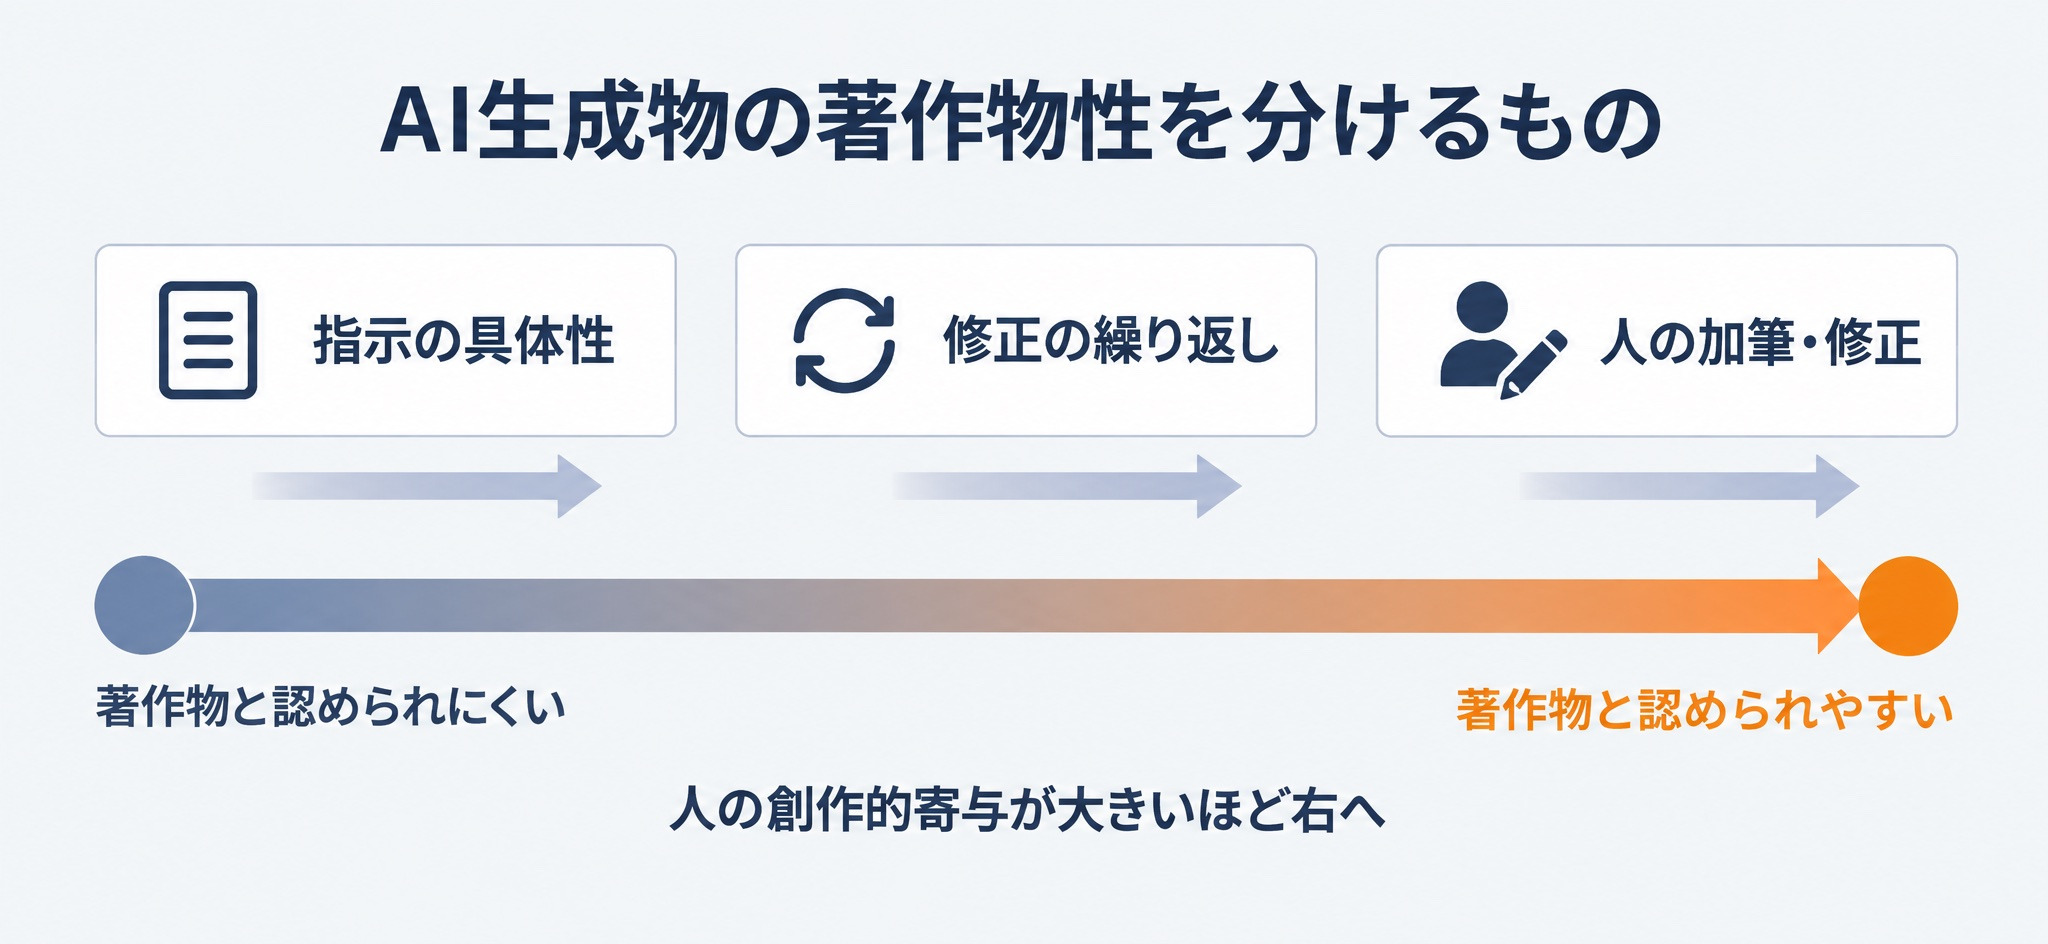
人がAI生成物に創作的表現といえる加筆・修正を加えた場合は、その部分について通常、著作物性が認められるとされています(p.40)。米国でも、著作権局が2025年1月に公表した報告書で、プロンプトの入力だけでは保護されず、人の創作的な関与が十分にある場合に保護されるという考えを示しています。
参照:Copyright and Artificial Intelligence, Part 2: Copyrightability|U.S. Copyright Office
利用規約の「出力は利用者のもの」と著作権の有無は別の話
多くの生成AIサービスの規約には、出力の権利を利用者に帰属させる条項があります。例えば、OpenAIの個人向け利用規約(2026年1月1日発効)は、利用者が出力を所有し、OpenAIが出力について持つ権利を「if any(存在する限り)」利用者に譲渡すると定めています。Anthropicの規約も同様の書き方です。
ここで押さえたいのは、この条項は「サービス提供者が権利を主張しない」という意味であり、出力に著作権が発生することを保証するものではない、という点です。Adobeの生成AI向け規約は、出力が知的財産権で保護されない可能性があると明記しています。
つまり、成果物の帰属を考えるときは、規約上の帰属と、法律上の著作物性を分けて確認します。自社の成果物として権利を主張したい制作物は、人が手を入れた部分と、その過程の記録を残しておくことが備えになります。
生成AIサービスの著作権補償と商用利用の条件
成果物の帰属を規約で確認したので、次は、生成物が第三者から著作権侵害を主張されたときの補償を、各社の規約で見ていきます。以下は2026年9月時点の各社の公式規約で確認した内容です。
| サービス | 出力の権利 | 著作権侵害の補償の対象 | 補償が外れる主な条件 |
|---|---|---|---|
| OpenAI | 利用者に帰属(if any) | APIとChatGPT Enterprise等の法人契約。個人向けプランは対象外 | 侵害を知り得た、安全機能の無効化、出力の改変や組み合わせ |
| Microsoft | 顧客データとして扱い、Microsoftは所有しない | 有償のAzure OpenAIと各種Copilot。無料プレビューは対象外 | コンテンツフィルタの無効化、必須の対策の未実装、侵害を知り得た |
| 顧客データとして扱い、Googleは所有権を主張しない | Google Cloudの対象サービスとWorkspaceのGeminiの有料利用 | 侵害を知り得た、フィルタや引用表示の回避、権利者の通知後の使用 | |
| Anthropic | 利用者に帰属(if any) | Commercial Termsの有償利用。個人向けのClaude.aiは対象外 | 出力の改変、他の技術との組み合わせ、侵害を知り得た |
| Adobe Firefly | 知的財産権で保護されない可能性を明記 | 補償付きの法人向けプランを購入した顧客 | 出力の改変、他の素材との組み合わせ、ベータ機能や他社モデルの出力 |
この表から読み取れるのは、補償はどの社も「有料の法人向け契約」に限られ、しかも一定の条件を外れると適用されないという点です。
補償の対象は有料の法人向けに限られる
OpenAIの個人向け利用規約とAnthropicの個人向け規約には、提供者から利用者への補償がありません。反対に、事業者として使う場合に利用者側が提供者を補償する条項があります。従業員が個人アカウントの無料版や個人向け有料プランで作った生成物を業務で公開すると、補償のない状態で使うことになります。
商用利用そのものは、確認した各社の規約で一般には禁止されていません。ただし、OpenAIは人が作ったと偽ることを禁じており、Adobeはベータ表示のある機能について製品内の表示に従うよう求めています。
補償が外れる共通の条件
各社の条件を並べると、補償が外れる条件にはおおむね共通点があります。
- 侵害していることを知っていた、または知り得た
- コンテンツフィルタや安全機能を無効化・回避した
- 出力を改変した、または他のコンテンツと組み合わせた
- 入力した素材を使う権利を持っていなかった
- 商標に関する請求である
- ベータ版や無料枠で生成した
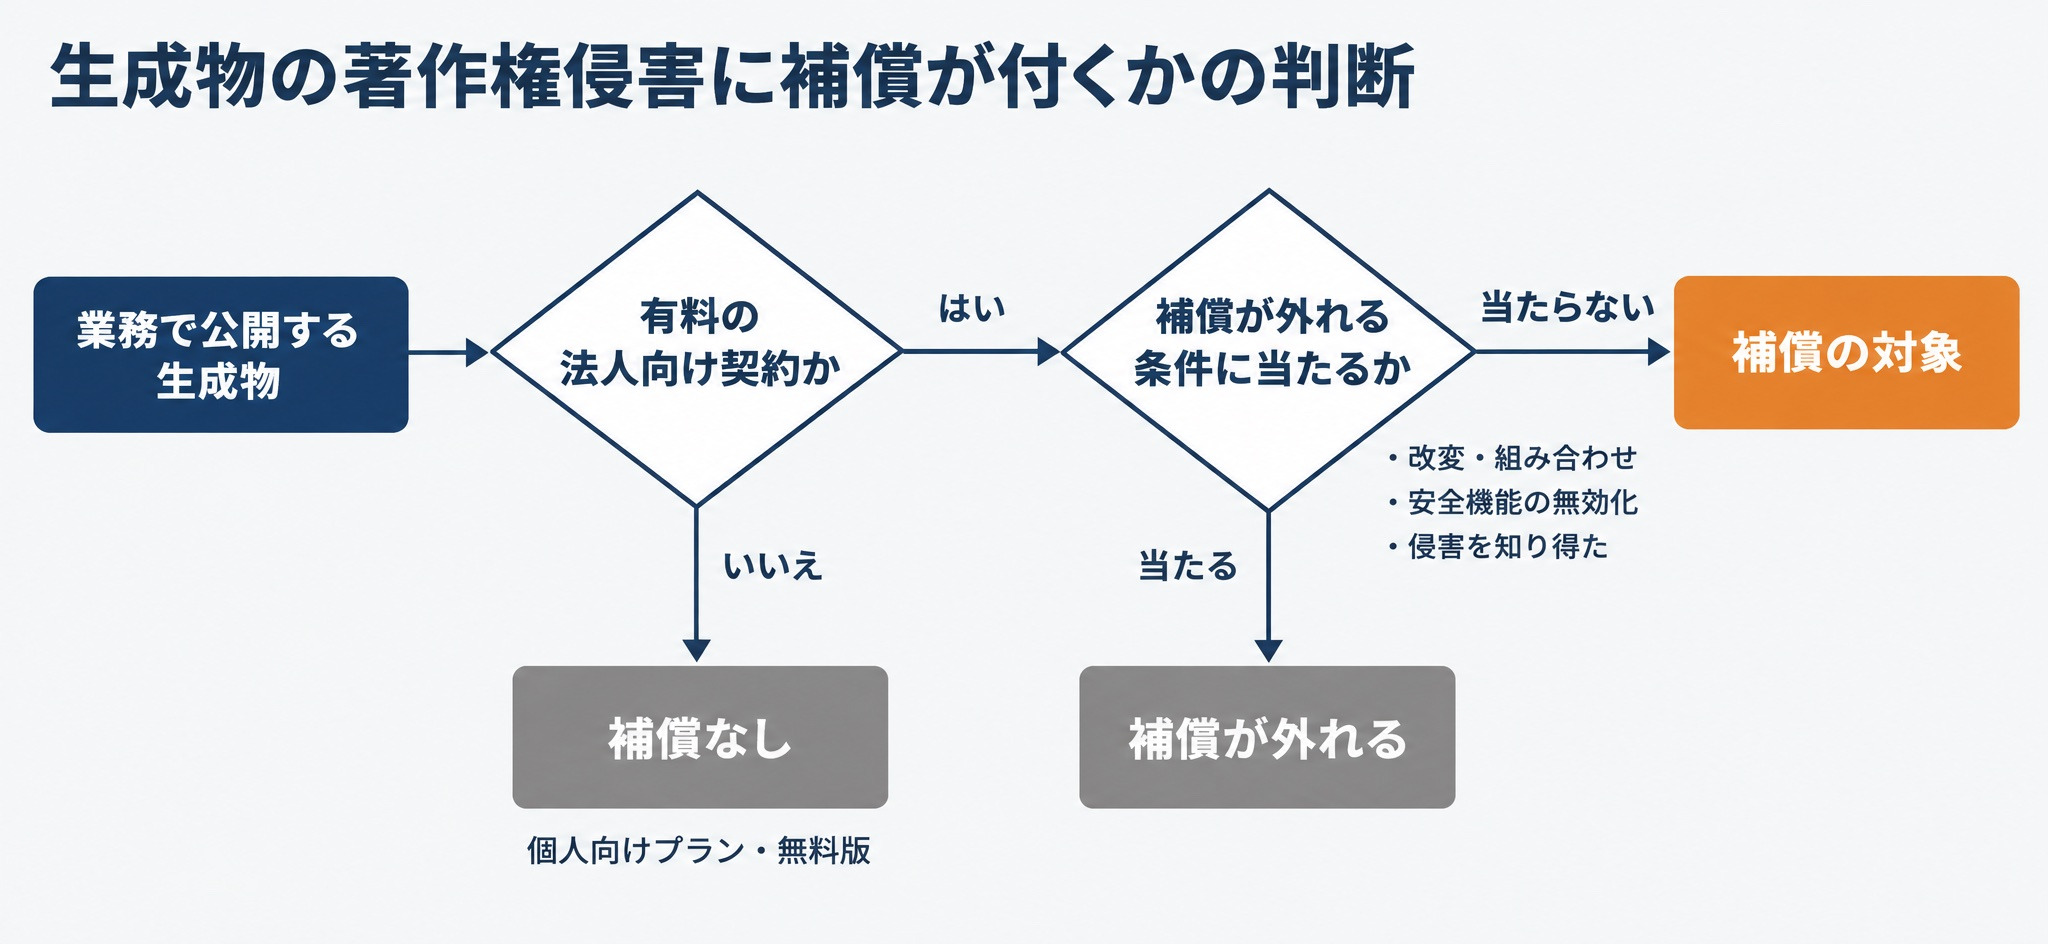
特に「改変」と「組み合わせ」は、業務では通常行う作業です。補償があるから安心と考えるのではなく、補償は最後の備えと位置づけ、公開前の確認と社内ルールで侵害を防ぐことが前提になります。
参照:Customer Copyright Commitment Required Mitigations|Microsoft Learn
参照:Generative AI Indemnified Services|Google Cloud
参照:Commercial Terms of Service|Anthropic
参照:Adobe Generative AI Product Specific Terms|Adobe
ここまでAIと著作権の論点とサービスの補償条件について解説しましたが、「外部サービスの補償だけに頼らず、自社データを使うAIを権利面も確認しながら作りたい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、社内データを使ったRAGやファインチューニングを、外部に出さない閉域環境で構築することが可能です。ただ、構築するだけでなく、学習や検索の対象にするデータの範囲と入手経路、回答での出典表示を設計の段階から一緒に決められるため、権利面の確認がしやすい自社専用のAIの構築支援が可能。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
AIと著作権をめぐる国内外の訴訟・事例
条件と規約の整理を、実際に公表された事例で確かめます。国内では生成AIと著作権侵害を正面から判断した確定判決はまだありませんが、訴訟や摘発は始まっています。
| 事例 | 国 | 状況(2026年9月時点) | 関わる段階 |
|---|---|---|---|
| 日本経済新聞社・朝日新聞社、読売新聞社 対 Perplexity | 日本 | 東京地裁で係属中 | 学習・開発と生成・利用の両方 |
| AI生成画像を無断複製した男性の書類送検 | 日本 | 千葉県警が書類送検 | 生成物の著作物性 |
| Bartz v. Anthropic | 米国 | 15億ドルの和解が最終承認 | 学習データの入手経路 |
| Thaler v. Perlmutter | 米国 | 最高裁が上告を受理せず確定 | 生成物の著作物性 |
| Getty Images v Stability AI、GEMA v. OpenAI | 英国、ドイツ | いずれも控訴審へ | モデルと出力が複製に当たるか |
この表のとおり、争われている論点は学習の段階と生成・利用の段階の両方にまたがっています。以下、企業の判断に関わる点を中心に紹介します。
国内:新聞社3社がPerplexityを提訴
2025年8月、読売新聞社と、日本経済新聞社・朝日新聞社が、それぞれ生成AIを使った検索サービスを提供する米Perplexityを東京地裁に提訴しました。日本経済新聞社のプレスリリースによれば、両社は、Perplexityがrobots.txtによる拒否を無視して記事を複製・保存し、回答に表示したと主張し、複製権・公衆送信権などの侵害と各社22億円の損害賠償を求めています。Perplexity側は訴えの却下を求めて争っており、2026年9月時点で判決は出ていません。
この事例は、社内でRAGやAI検索を作る企業にとっても参考になります。外部の記事を収集して回答に表示する構成は、先に見た30条の4のただし書や、47条の5の軽微利用の範囲が問われる場面だからです。
参照:日本経済新聞社と朝日新聞社、米パープレキシティを提訴(PDF)|日本経済新聞社
国内:AI生成画像の無断複製で書類送検
2025年11月、千葉県警は、他人が生成AIで作った画像を無断で複製し、自身が販売する電子書籍の表紙に使ったとして、神奈川県の男性を著作権法違反の疑いで書類送検しました。報道によれば、県警は、制作者が具体的な指示と入力を繰り返して作った画像であることから、著作物に当たると判断しました。AI生成画像を著作物として摘発した全国初の例とみられると報じられています。起訴されたかどうかは、2026年9月時点で確認できていません。
この事例は、先に見た「人の創作的寄与があれば著作物性が認められ得る」という整理が、実際の判断に使われた例です。AIで作った画像だから自由に使ってよい、とは言えないことを示しています。
参照:生成AI画像を無断複製、著作権法違反容疑で書類送検 千葉県警|日本経済新聞
海外:学習データの入手経路と生成物の扱いをめぐる判断
米国のBartz v. Anthropicでは、2025年6月に連邦地裁が、購入した書籍を学習に使うことはフェアユースに当たる一方、海賊版サイトから入手した書籍を保持することはフェアユースに当たらないと判断しました。その後、15億ドルの和解が成立し、2026年7月に最終承認されています。学習が適法とされ得る場合でも、データの入手経路によって大きな負担が生じ得ることを示した事例です。
生成物の著作物性については、AIだけを作者とする作品の著作権登録をめぐるThaler v. Perlmutterで、2025年3月に米DC巡回区控訴裁判所が、著作権法は人間の作者を求めていると判断しました。2026年3月に最高裁が上告を受理せず、この判断が確定しています。
欧州では、判断が分かれています。英国高等法院は2025年11月、Getty Images v Stability AIで、学習済みモデルの重みは作品の複製物を保存しておらず、侵害複製物に当たらないと判断しました。一方、ドイツのミュンヘン第一地裁は同じ月、GEMA v. OpenAIで、歌詞がモデル内に再現可能な形で記憶されていたことを複製と認めました。どちらも控訴審に進んでおり、結論は確定していません。
参照:Court grants final approval of Anthropic copyright settlement|Authors Guild
参照:Thaler v. Perlmutter 判決文(PDF)|U.S. Court of Appeals for the D.C. Circuit
参照:Getty Images v Stability AI|Courts and Tribunals Judiciary
参照:Pressemitteilungen 2025(GEMA v. OpenAI)|Landgericht München I
AIの著作権リスクに備えて社内で決めておく5項目
事例に共通するのは、「どのデータを、どのサービスで使い、生成物をどう確認して公開したか」が問われている点です。ここでは、文化庁のチェックリストのうちAI利用者向けの項目(3-1-1〜3-1-8)を、AI推進の担当者が社内で決める5項目に落とします。
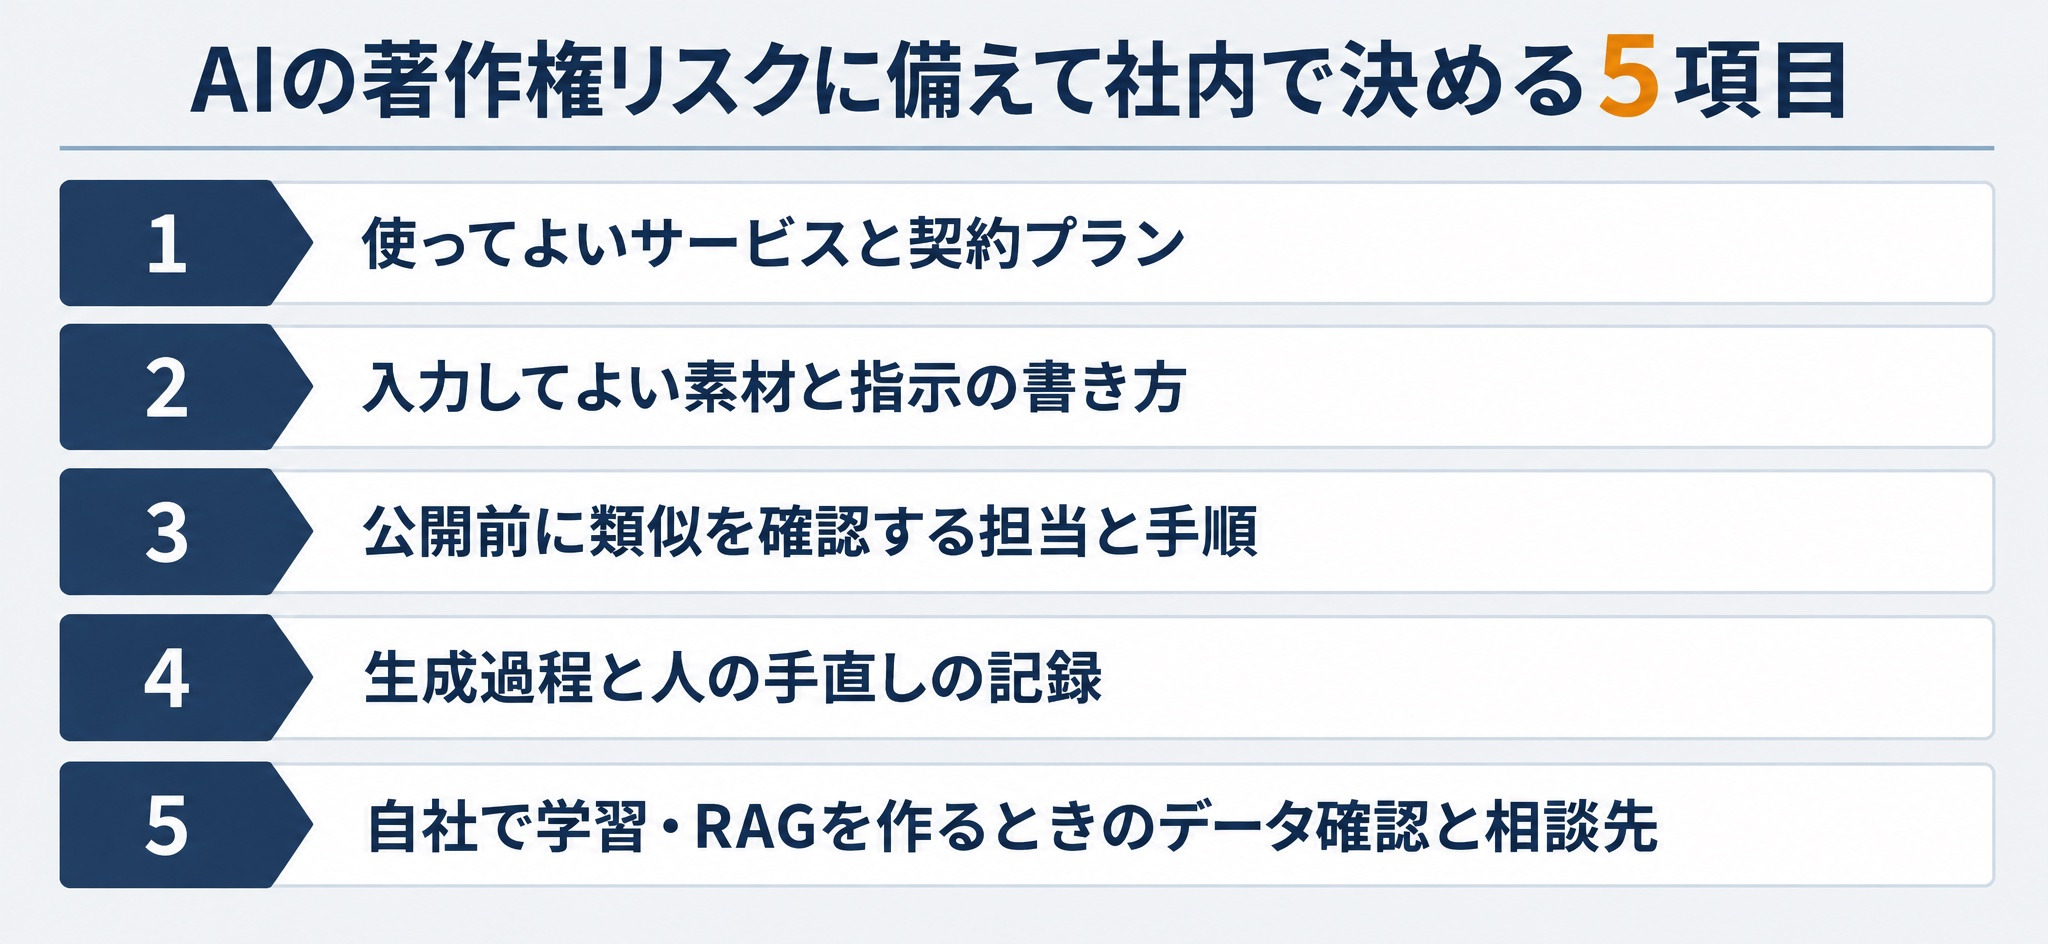
1. 使ってよいサービスと契約プランを決める
最初に、AI推進の担当者と情報システム部門が、業務で使ってよい生成AIサービスと契約プランを決めます。前章で見たとおり、補償は有料の法人向け契約に限られるため、公開する制作物に使うサービスは補償の対象になるプランに寄せます。あわせて、各社の規約で補償が外れる条件を一覧にし、全社に周知します。許可ツールの決め方は、生成AIの利用ルールの作り方。守れる社内ポリシーを設計する7つの要素で解説しています。
2. 入力してよい素材と指示の書き方を決める
次に、法務と推進担当が、入力の禁止事項を決めます。他人の著作物を画像生成に入力すること、作品名や作家名を指示に入れて似たものを作らせることは、依拠性が認められやすい使い方です。「第三者の著作物は、権利を確認したもの以外は入力しない」「固有の作品名や作家名で作風の再現を指示しない」といった具体的な文で書きます。機密情報の入力については、生成AIで情報漏洩は起こるのかもあわせてご覧ください。
3. 公開前に類似を確認する担当と手順を決める
社外に公開する生成物は、公開前に既存の作品と似ていないかを確認します。文化庁のチェックリストも、利用する前にインターネット検索などで類似を確認することを挙げています(3-1-5)。広告・Webサイト・製品パッケージなど公開範囲の広いものは、制作担当に加えて広報や法務が確認する、という2段階にしておくと抜けが減ります。
4. 生成過程と人の手直しを記録する
生成に使ったプロンプト、選んだ出力、人が加えた修正を記録しておきます。チェックリストも、生成の過程を後から確認できるようにしておくことを求めています(3-1-7)。記録は、侵害を主張されたときに依拠していないことを説明する材料になり、反対に自社の成果物の著作物性を主張するときの材料にもなります。取引先に納品する場合は、AI生成物を含むことを伝える運用も決めておきます(3-1-6)。
5. 自社で学習・RAGを作るときのデータ確認と相談先を決める
社内データでRAGや追加学習を行う場合は、開発担当が、使うデータの入手経路と利用条件を一覧にします。自社で作成した文書か、購読契約や利用規約で使い方が制限された外部資料か、robots.txtなどで収集が拒否されていないかを確認し、回答で原文をどこまで表示するかを決めます。判断に迷うデータは、法務と顧問弁護士に相談する流れを先に決めておきます。文化庁のチェックリストでは、AIと著作権について無料で弁護士に相談できる窓口も紹介されています(p.43)。
参照:AIと著作権に関するチェックリスト&ガイダンス(PDF)|文化庁
5項目を社内の利用ルールに組み込むときは、生成AIガイドラインの作り方。社内ルールに盛り込む項目とひな形のひな形を土台にすると早く形になります。
まとめ
本記事の要点を整理します。
- AIと著作権の論点は、文化庁の考え方に沿って「学習・開発段階」と「生成・利用段階」に分けると整理しやすい。文化庁の中核資料は2024年版が最新で、法的拘束力はない
- 学習は著作権法30条の4により原則として許諾なく行えるが、享受目的が併存する場合や、著作権者の利益を不当に害する場合は対象外になり得る。社内RAGでは回答で表現をどこまで出すかが論点になる
- 生成物は、既存の著作物との類似性と依拠性がそろうと侵害になり得る。学習データに含まれていた作品は依拠性が推認され得る
- AI生成物の著作物性は人の創作的寄与で分かれる。規約上の「出力は利用者のもの」と、法律上の著作権の有無は別の話
- 著作権侵害の補償は有料の法人向け契約に限られ、改変や安全機能の無効化などで外れる
- 社内では、サービスと契約プラン、入力の禁止事項、公開前の類似確認、生成過程の記録、自社で学習やRAGを作るときのデータ確認と相談先の5項目を決めておく
AIと著作権は、使うか使わないかの二択ではなく、場面ごとに論点を分けて備える問題です。個別の判断が必要な場面では、弁護士などの専門家に相談しながら進めてください。
ウェビナー資料(ホワイトペーパー)のダウンロード
生成AIの社内ルールづくりについては、ウェビナー「社内AI利用ルールの作り方:実例テンプレートで見る『守れるポリシー』の設計」で解説しました。許可ツールの決め方やデータ分類の設計をまとめた当日の資料を、無料で配布しています。本記事の5項目を社内ルールに組み込む際の資料としてご活用ください。
⇨ウェビナー資料のダウンロードはこちら
AIの著作権対策とAI開発の相談は「リベルクラフト」へ
ここまで、AIと著作権の論点を2つの段階に分けて整理し、サービスの補償条件と社内で決めておく項目を解説してきました。論点は整理できても、自社のデータや業務にどう当てはめるかは、判断に迷う場面が多いのではないでしょうか?
リベルクラフトでは、社内データを使ったRAGやファインチューニングの設計・構築から、AI利用ルールの整備、PoC・本格導入までを一気通貫で支援しています。学習や検索に使うデータの範囲と入手経路を設計の段階から整理し、閉域環境で自社専用のAIを構築できます。
- 社内データでRAGを作りたいが、どの資料を対象にしてよいか整理したい
- 生成AIの利用ルールに、著作権の確認手順を組み込みたい
- 外部サービスに頼らず、閉域環境で自社専用のAIを構築したい
という方は、リベルクラフトへお気軽にご相談ください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。