マルチモーダルとは?AIが画像と文章を一緒に扱う仕組みを、小さなモデルで確かめる
「ChatGPTに写真を送ると内容を説明してくれるけれど、文章のAIがなぜ画像を読めるのかは説明できない」という方も多いでしょう。こうしたAIを説明する言葉として、「マルチモーダル」という言葉をよく見かけるようになりました。
ただし、「複数の種類のデータを扱えるAI」という説明だけでは、画像と文章という形のまったく違うデータを、AIの中でどうやって比べているのかは分かりません。どのモデルが何に対応しているのかも、各社の更新が速く、古い情報のまま紹介されていることが少なくありません。
そこで本記事では、
- マルチモーダルの意味と、シングルモーダルとの違い
- 画像と文章を同じ数値の空間にそろえる仕組み(CLIP・VLM)
- 2026年9月時点の主なモデルの対応状況と、公表されている活用例
- マルチモーダルAIの限界と、作る側に回るための学び方
について、小さなモデルを実際に動かした結果を見ながらわかりやすく解説します。データサイエンティストやAIエンジニアを目指して学び始めた方は、ぜひ最後までご覧ください。
「画像や音声も扱えるAIを、使う側ではなく作る側として理解したい」という方は、リベルクラフトへご相談ください。
⇨Craft Collegeへの無料相談はこちら
マルチモーダルとは。AIが種類の違うデータを一緒に扱うこと
AIでいうマルチモーダルとは、文章・画像・音声・動画など種類の違うデータを、1つのモデルで一緒に受け取ったり出力したりできることです。 例えば、写真と「この部品の名前は?」という質問を同時に渡し、写真の内容を踏まえた答えを文章で返すAIは、マルチモーダルAIです。
総務省の情報通信白書(令和6年版)も、マルチモーダル機能を「テキストだけでなく、画像や音声など複数のモードを扱う能力」と説明しています(出典:総務省 令和6年版 情報通信白書)。
モダリティとは。データの「種類」のこと
マルチモーダルの「モーダル」は、英語のmodality(モダリティ)から来ています。モダリティとは、情報がどの形で表されているか、つまりデータの種類のことです。 AIの分野では、主に次のものをモダリティと呼びます。
- 文章(テキスト)
- 画像(写真・図・スクリーンショット)
- 音声
- 動画
- 表の数値やセンサーの値
「マルチ」は複数という意味なので、マルチモーダルは「複数のモダリティを扱う」という意味になります。
シングルモーダルAIとの違い
これに対して、1種類のデータだけを扱うAIをシングルモーダルAI(ユニモーダルAIとも呼びます)といいます。違いを整理すると、次のようになります。
| 比較項目 | シングルモーダルAI | マルチモーダルAI |
|---|---|---|
| 扱うデータ | 1種類だけ(文章だけ、画像だけなど) | 2種類以上を一緒に扱う |
| 例 | 文章を翻訳するAI、画像を分類するAI、音声を文字にするAI | 写真について質問すると文章で答えるAI、文章から画像を作るAI |
| 得意なこと | 1つの作業を速く、安定してこなす | 種類をまたいだ判断(写真と説明文を合わせて答えるなど) |
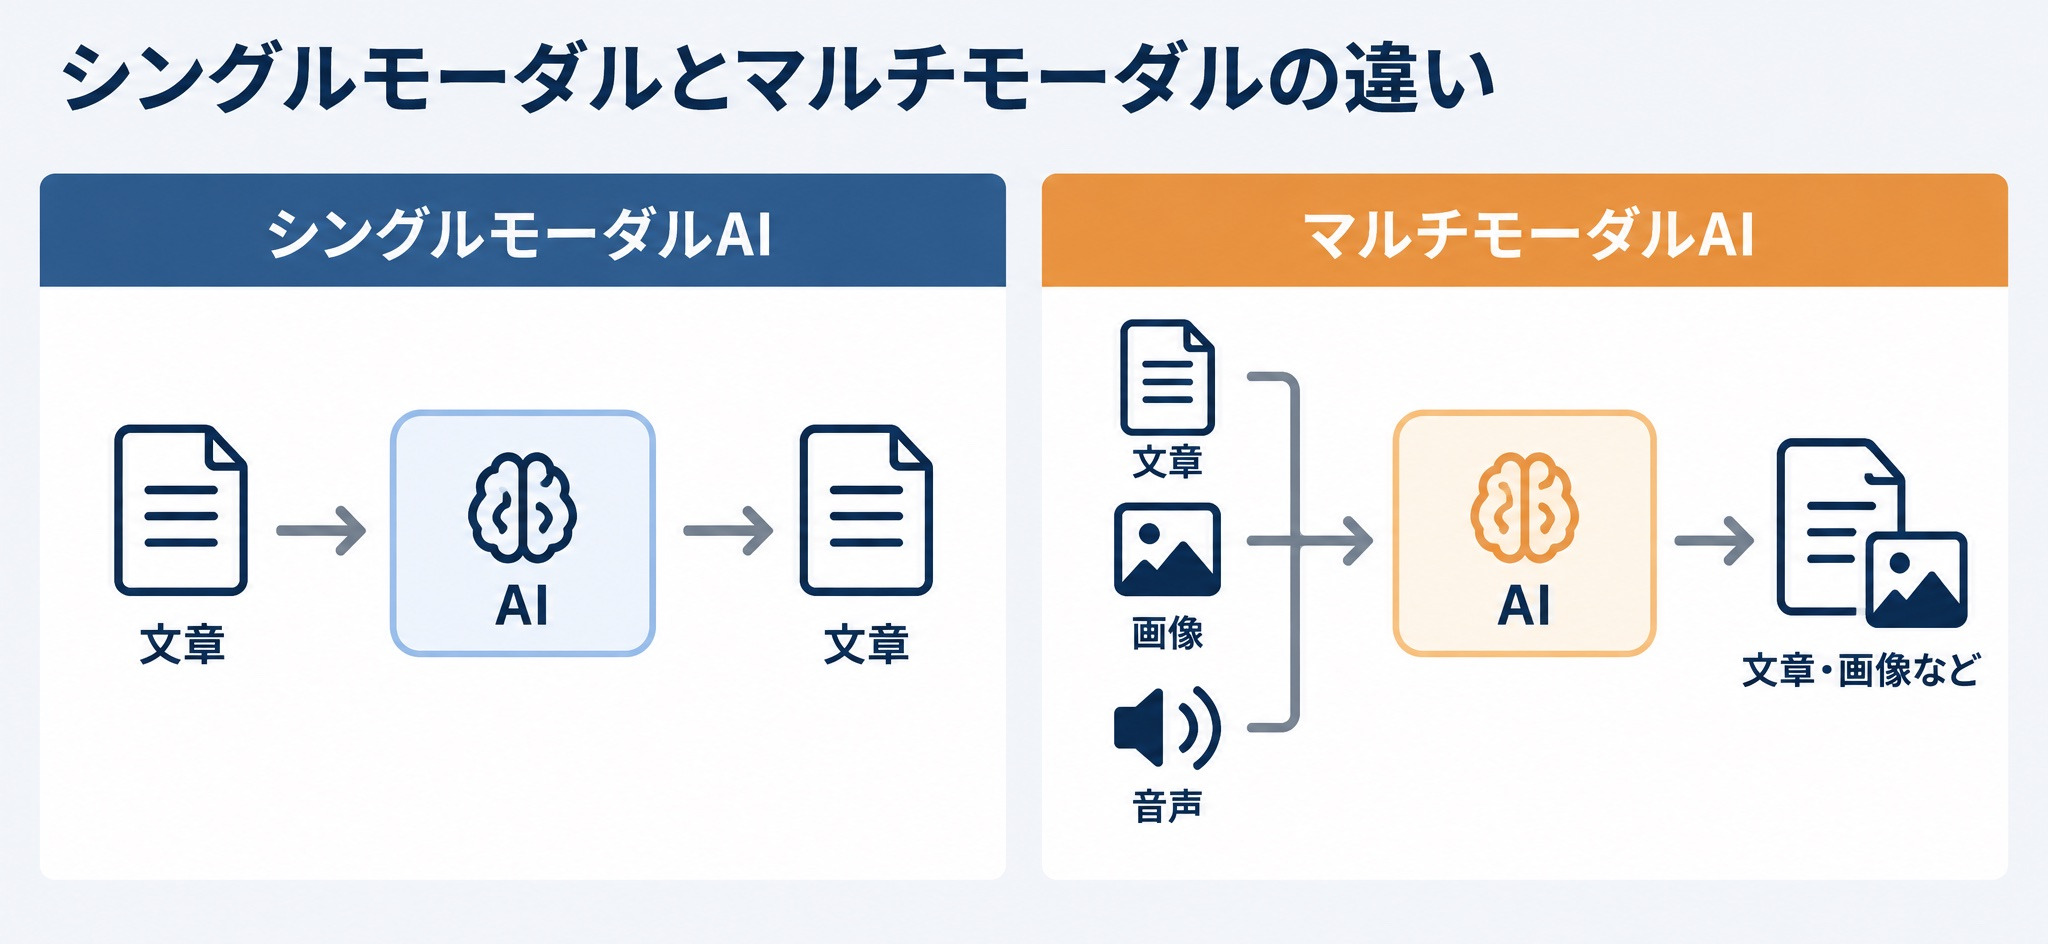
この表から分かるのは、両者の差が「扱うデータの数」だけでなく、「種類をまたいだ判断ができるか」にあることです。写真だけを見るAIは写っている物を分類できますが、「この部品は交換が必要か」という文章の質問には答えられません。文章だけのAIは質問を理解できますが、写真を見ることはできません。1つのモデルで両方を受け取れることが、マルチモーダルAIの強みです。
マルチモーダルAIが一般に広まった背景
画像と文章を結びつける研究は以前からありましたが、2021年にOpenAIが発表したCLIPによって、画像と文章を同じ物差しで比べる方法が広く使われるようになりました。2023年には、Be My Eyesというアプリが、OpenAIのGPT-4に写真を読ませて視覚障害のある人を支援する機能を発表しています。
現在では、多くのチャットAIが画像やPDFの入力に対応しており、利用者が意識しないまま、マルチモーダルAIを使っている状態になっています。
マルチモーダルAIの仕組み。種類の違うデータを同じ数値の空間にそろえる
ここまでで、マルチモーダルの意味を確認しました。次は、形のまったく違う画像と文章を、AIがどうやって一緒に扱っているのかを見ていきます。
エンコーダーで、画像も文章も数値の並びにする
コンピュータは、画像も文章もそのままでは比べられません。そこでマルチモーダルAIは、データの種類ごとにエンコーダーを用意します。エンコーダーとは、データを数百個ほどの数値の並び(ベクトル)に変換する部品のことです。この変換を埋め込みと呼びます。
仕組みの要点は、次の3つです。
- 画像は画像用のエンコーダーで、文章は文章用のエンコーダーで、それぞれ数値の並びにする
- どちらの数値の並びも、同じ長さで、同じ空間に置かれるように学習させる
- 同じ空間にあるので、「この画像とこの文章はどれくらい近いか」を計算で比べられる
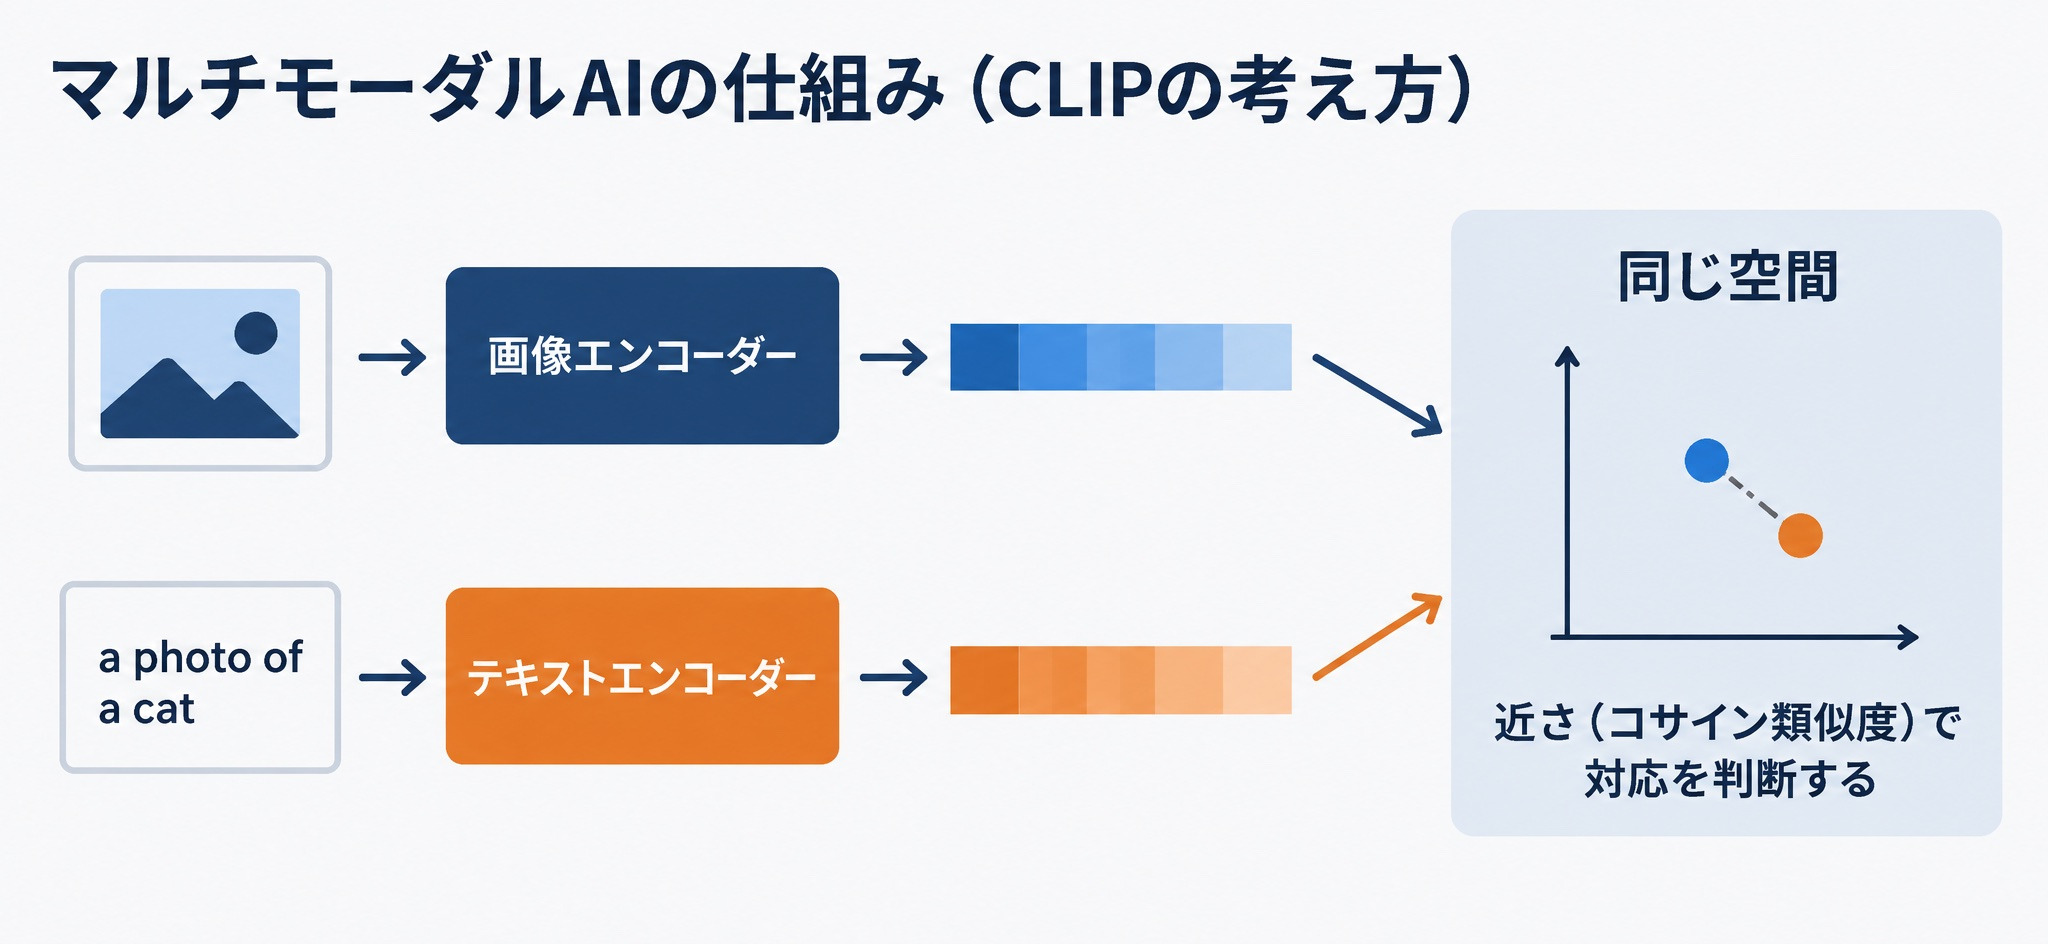
つまり、マルチモーダルAIの土台にあるのは、種類の違うデータを「同じ単位の数値」に翻訳することです。一度同じ空間に置けば、画像と文章の近さを、数値どうしの計算として扱えます。
CLIP。画像と文章の組を4億組集めて対応を学んだモデル
この考え方を大規模に実現したのが、OpenAIが2021年に発表したCLIPです。CLIPは、インターネットから集めた4億組の「画像と、その画像に付いていた文章」の組で学習しました。
学習のやり方は、正しい組(犬の写真と「犬の写真」という文章)は近く、違う組(犬の写真と「車の写真」という文章)は遠くなるように、2つのエンコーダーを同時に調整するというものです。この学び方を対照学習と呼びます。
こうして学習したCLIPは、分類用の学習をしていない画像でも、候補の文章の中から最も近いものを選ぶだけで分類できます。論文では、ImageNetという画像分類の評価で、専用の学習データを1枚も使わずに76.2%の正解率を出し、ImageNet専用に学習した代表的なモデル(ResNet-50)と同じ水準に並んだと報告されています(出典:Learning Transferable Visual Models From Natural Language Supervision)。
VLM。画像を読めるようにしたLLM
ChatGPTやClaude、Geminiのように、画像を見て文章で答えるAIは、VLM(視覚言語モデル)やマルチモーダルLLMと呼ばれます。LLM(大規模言語モデル)は、文章を読んで次に来る言葉を予測するモデルです。
参照記事:LLM(大規模言語モデル)とは?企業での活用方法と事例・利用時の注意点も解説
VLMの代表的な作り方の1つは、画像エンコーダーが作った数値の並びを変換して、LLMが読む言葉の数値と同じ形にそろえ、文章の前に並べて渡す方法です。2023年に発表されたLLaVAというモデルは、CLIPの画像エンコーダーの出力を、学習させた変換(線形の層)でLLMの言葉の数値の空間に写し、画像を「言葉の並び」のようにしてLLMに読ませています(出典:Visual Instruction Tuning)。
LLMから見ると、画像は「少し変わった単語の並び」として入ってきます。そのため、文章と画像を混ぜた質問にも、いつもの文章と同じ流れで答えを作れます。なお、ChatGPTやGeminiなど商用モデルの内部構造は公開されていないものが多く、すべてがこの作り方とは限りません。
音声と動画はどう扱われているか
音声と動画も、専用のエンコーダーで数値の並びにしてから文章と同じ空間にそろえる点は、画像と変わりません。
- 音声:音の波形を、音声用のエンコーダーで数値の並びにしてから、文章と同じ空間に渡す
- 動画:動画を一定の間隔のコマ(静止画)に分け、1枚ずつ画像として読む。音声が付いていれば、音声は別に読む
例えば、Googleが公開しているオープンモデルGemma 4のモデルカードには、動画を「1秒に1コマ」として処理した場合に最大60秒まで扱えると書かれています(出典:Gemma 4 model card)。動画を丸ごと理解しているのではなく、コマに分けた画像の並びとして読んでいることが分かります。
なお、ここまでは画像や音声を「読む」側の仕組みです。文章から画像や動画を「作る」側の仕組みは、以下の記事で解説しています。
参照記事:生成AIの仕組みとは。学習と推論の流れを図解でわかりやすく解説
マルチモーダルの仕組みを手元で確かめる。CLIPで画像と文章の近さを計算する
仕組みを説明したところで、実際に小さなCLIPを動かし、画像と文章が同じ空間に並ぶ様子を数字で確かめてみます。
準備。ダウンロード約580MBの小さなCLIPを使う
使うのは、OpenAIがHugging Faceで公開している「openai/clip-vit-base-patch32」です。ダウンロードは約580MBで、GPUの無いパソコンのCPUでも動きます。Pythonのライブラリtransformersで読み込めます。
本記事の実行例は、すべて2026年9月23日にApple M1 Proのパソコンで実行しました(Python 3.13.13、transformers 5.17.0、torch 2.14.0、Pillow 12.3.0、CPUで計算)。
まず、モデルの大きさを確認します。
from transformers import CLIPModel

model = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
count = lambda m: sum(p.numel() for p in m.parameters())
print("画像エンコーダー:", f"{count(model.vision_model):,}")
print("テキストエンコーダー:", f"{count(model.text_model):,}")
print("全体:", f"{count(model):,}")
print("類似度に掛ける倍率:", round(model.logit_scale.exp().item(), 1))
画像エンコーダー: 87,456,000
テキストエンコーダー: 63,165,952
全体: 151,277,313
類似度に掛ける倍率: 100.0画像用と文章用、2つのエンコーダーが別々に入っており、全体で約1.5億個のパラメータ(学習で値が決まる数値)です。最後の「倍率」は、後で確率を計算するときに使う値です。
画像4枚と文4つの類似度を計算する
次に、画像4枚と英語の文4つを用意し、すべての組み合わせの近さを計算します。画像のうち3枚は、コードで描いた赤い丸・青い四角・緑の三角の図です。残りの1枚は、画像認識の評価で広く使われているCOCOデータセットの写真(ソファの上で2匹の猫が寝ている写真)です。
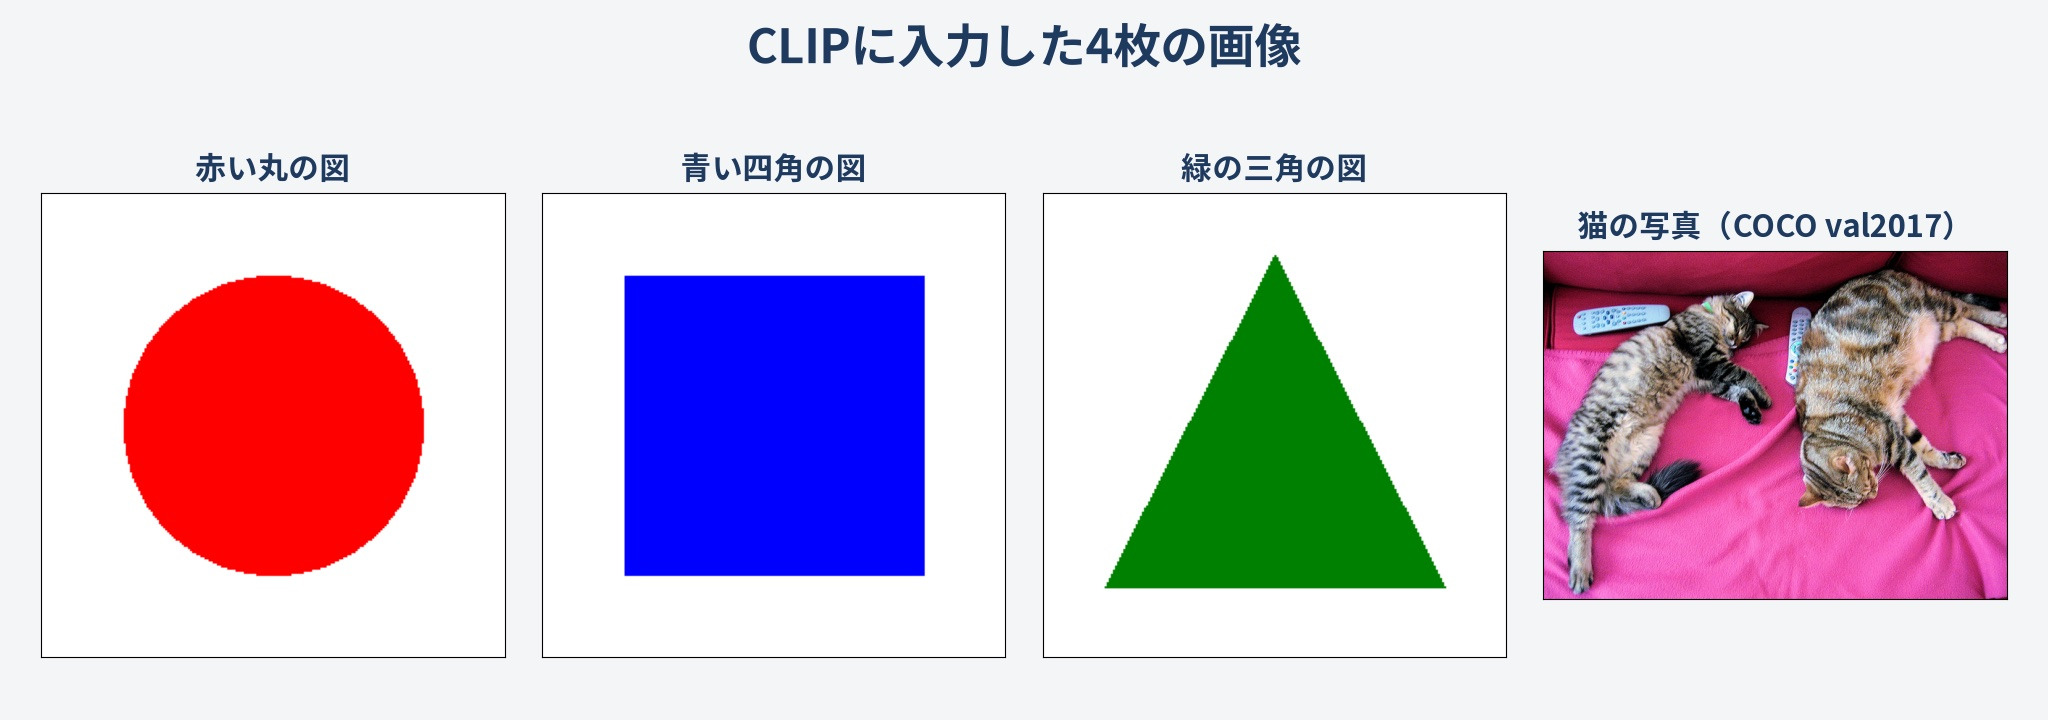
近さはコサイン類似度で測ります。コサイン類似度とは、2つの数値の並びがどれだけ同じ向きを向いているかを示す値で、1に近いほど似ていることを表します。
import requests, torch
from PIL import Image, ImageDraw
from transformers import CLIPModel, CLIPProcessor

name = "openai/clip-vit-base-patch32"
model = CLIPModel.from_pretrained(name).eval()
processor = CLIPProcessor.from_pretrained(name)

# 1. 画像を4枚用意する(3枚は図形を描き、1枚は写真を読み込む)
def shape(kind, color):
    img = Image.new("RGB", (224, 224), "white")
    d = ImageDraw.Draw(img)
    if kind == "circle":
        d.ellipse([40, 40, 184, 184], fill=color)
    elif kind == "square":
        d.rectangle([40, 40, 184, 184], fill=color)
    else:
        d.polygon([(112, 30), (194, 190), (30, 190)], fill=color)
    return img

url = "http://images.cocodataset.org/val2017/000000039769.jpg"
images = {
    "赤い丸の図": shape("circle", "red"),
    "青い四角の図": shape("square", "blue"),
    "緑の三角の図": shape("triangle", "green"),
    "猫の写真": Image.open(requests.get(url, stream=True).raw).convert("RGB"),
}

# 2. 画像とテキストを、それぞれのエンコーダーでベクトルにする
def embed(texts):
    inputs = processor(text=texts, images=list(images.values()),
                       return_tensors="pt", padding=True)
    with torch.no_grad():
        out = model(**inputs)
    img = out.image_embeds / out.image_embeds.norm(dim=-1, keepdim=True)
    txt = out.text_embeds / out.text_embeds.norm(dim=-1, keepdim=True)
    return img, txt, out.logits_per_image

texts_en = ["a red circle", "a blue square", "a green triangle",
            "a photo of two cats on a sofa"]
img, txt, logits = embed(texts_en)
print("画像ベクトル:", tuple(img.shape), " テキストベクトル:", tuple(txt.shape))

# 3. コサイン類似度(行=画像、列=テキスト)
sim = img @ txt.T
print("\nコサイン類似度(英語の文)")
for i, label in enumerate(images):
    print(f"{label:<8}", "  ".join(f"{v:.3f}" for v in sim[i].tolist()))

# 4. 各画像について、4つの文のどれに当たるかの確率
probs = logits.softmax(dim=-1)
print("\n各画像がどの文に当たるかの確率(英語の文)")
for i, label in enumerate(images):
    best = probs[i].argmax().item()
    print(f"{label:<8} → {texts_en[best]}({probs[i, best].item():.1%})")

# 5. 同じ内容を日本語の文で試す
texts_ja = ["赤い丸", "青い四角", "緑の三角", "ソファの上の2匹の猫の写真"]
img, txt, logits = embed(texts_ja)
probs = logits.softmax(dim=-1)
print("\n各画像がどの文に当たるかの確率(日本語の文)")
for i, label in enumerate(images):
    best = probs[i].argmax().item()
    print(f"{label:<8} → {texts_ja[best]}({probs[i, best].item():.1%})")
画像ベクトル: (4, 512) テキストベクトル: (4, 512)
コサイン類似度(英語の文)
赤い丸の図 0.302 0.248 0.236 0.158
青い四角の図 0.243 0.326 0.249 0.184
緑の三角の図 0.241 0.249 0.354 0.166
猫の写真 0.190 0.199 0.205 0.293
各画像がどの文に当たるかの確率(英語の文)
赤い丸の図 → a red circle(99.4%)
青い四角の図 → a blue square(99.9%)
緑の三角の図 → a green triangle(100.0%)
猫の写真 → a photo of two cats on a sofa(100.0%)
各画像がどの文に当たるかの確率(日本語の文)
赤い丸の図 → 緑の三角(72.0%)
青い四角の図 → 青い四角(38.8%)
緑の三角の図 → 緑の三角(64.0%)
猫の写真 → ソファの上の2匹の猫の写真(95.4%)1行目から、画像も文章も同じ512個の数値の並びになっていることが分かります。形の違うデータが、同じ長さのベクトルにそろったということです。
類似度の表は、行が画像、列が文です。4つの画像とも、自分に合う文(表の対角線)の値が最も大きくなりました。ただし、その値は0.29〜0.35で、同じ画像の不正解の文との差は0.05〜0.11しかありません。CLIPは、この小さな差に倍率100を掛けてから確率に直すため、英語の文では4枚とも99%以上の確率で正しい文を選べています。
日本語の文では、赤い丸を緑の三角と取り違えた
同じ画像を日本語の文で試すと、結果が変わりました。赤い丸の図は「緑の三角」を72.0%で選び、青い四角の図は正解したものの38.8%にとどまりました。
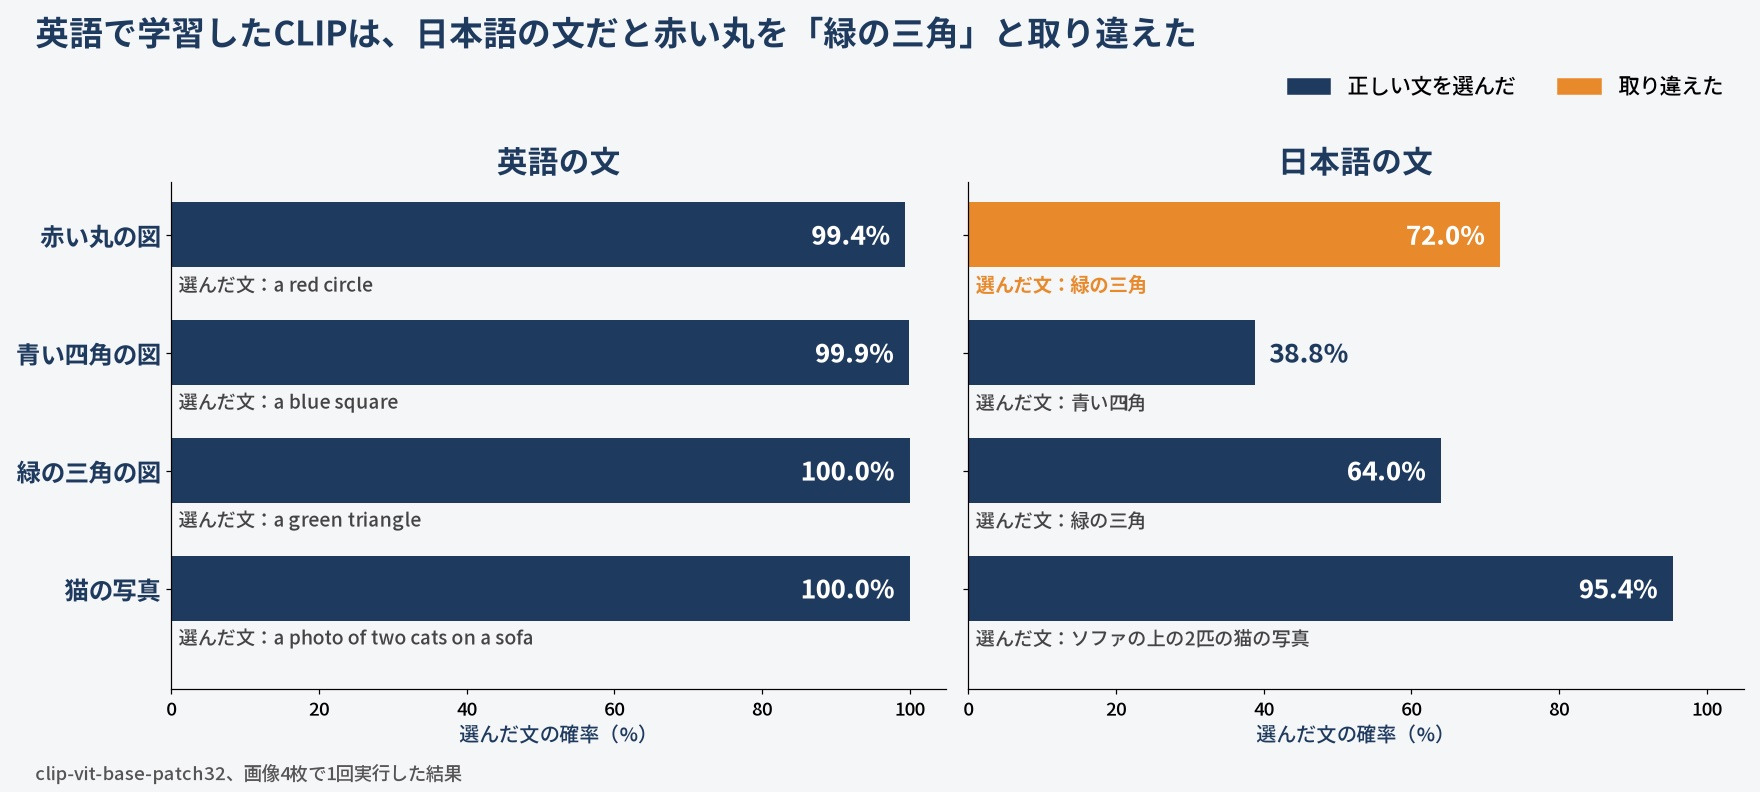
理由は、文章が数値の並びになる前の段階にあります。文章を区切る処理(トークン化)の結果を比べてみます。
from transformers import CLIPProcessor

processor = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")
for text in ["a red circle", "赤い丸"]:
    print(text, "→", processor.tokenizer.tokenize(text))
a red circle → ['a</w>', 'red</w>', 'circle</w>']
赤い丸 → ['è', 'µ', '¤', 'ãģĦ', 'ä¸', '¸</w>']英語は「red」「circle」という単語の単位に分かれましたが、日本語は文字をさらに細かく分けた断片(コンピュータ内部の文字コードの切れ端)になりました。このモデルは英語の文章で学習しており、Hugging Faceのモデルカードにも「英語以外の言語では学習も評価もしていないため、英語での利用に限るべき」と書かれています(出典:openai/clip-vit-base-patch32)。
画像4枚・1台のパソコンで1回試しただけの結果なので、日本語が常にこの割合で外れるとは言えません。ただ、マルチモーダルAIの精度は、学習に使ったデータの言語や種類に強く左右されることは、数字で確かめられました。日本語で使う場合は、日本語の文章と画像の組で学習したモデルを選ぶことが1つの対策になります。
ここまでマルチモーダルの仕組みを手元で確かめましたが、「数行のコードで画像と文章を比べられるのは分かったが、自分で仕組みを組み立てられるところまで、何から学べばいいか分からない」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座では、Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMの活用と開発までを、現役データサイエンティストの1対1の伴走で体系的に学べます。本記事のように小さなモデルを動かして確かめるところから始め、社内の文書を扱うAIを自分で設計して試作する段階まで進めます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
主なマルチモーダルAIモデルの対応状況(2026年9月時点)
手元の小さなモデルで仕組みを確かめたところで、実際のサービスで使われている主なモデルが、どの種類のデータに対応しているかを見ていきます。
次の表は、2026年9月23日時点で、各社の公式ドキュメントのモデルページに書かれている入力と出力をまとめたものです。APIで提供される仕様であり、チャット製品の画面で使える機能とは異なる場合があります。
| 提供元 | モデル | 入力 | 出力 |
|---|---|---|---|
| OpenAI | GPT-6 Astra(主力モデル) | 文章・画像 | 文章 |
| OpenAI | GPT-Realtime-2.1(音声対話) | 文章・音声・画像 | 文章・音声 |
| OpenAI | GPT-Image-2.5 Sunburst(画像生成) | 文章・画像 | 画像 |
| OpenAI | Sora 2(動画生成) | 文章・画像 | 動画・音声 |
| Anthropic | Claude(現行の全モデル) | 文章・画像・PDF | 文章 |
| Gemini 3.8 Flash | 文章・画像・動画・音声・PDF | 文章 | |
| Gemini 3.8 Live(音声対話) | 文章・画像・音声・動画 | 文章・音声 | |
| Veo 3.1(動画生成) | 文章・画像 | 音声付きの動画 | |
| Google(オープンモデル) | Gemma 4 | 文章・画像(音声は一部のモデルのみ) | 文章 |
| Alibaba(オープンモデル) | Qwen3-Omni-30B-A3B-Instruct | 文章・画像・音声・動画 | 文章・音声 |
出典:OpenAI Models、Anthropic Models overview、Gemini API Models、Gemma 4 model card、Qwen3-Omni-30B-A3B-Instruct(いずれも2026年9月23日に確認)
この表から、入力はマルチモーダルでも、出力は文章だけのモデルが多いことが読み取れます。画像・音声・動画を「作る」ことは、専用のモデルに分けて提供されるのが今の主流です。
文章・画像を読んで文章で答える汎用モデル
GPT-6 Astra、Claude、Gemini 3.8 Flashは、いずれも画像を読んで文章で答えられます。差が出るのは画像以外の入力で、Gemini 3.8 Flashは動画と音声も入力できます。PDFは、Claudeでは現行の全モデルが処理でき、OpenAIのモデルではファイル入力のガイドで扱いが説明されています(出典:OpenAI File inputs)。
音声で対話するモデルと、画像・動画を作るモデル
音声で会話するには、音声を受け取り、音声で答えるモデルが要ります。表ではGPT-Realtime-2.1とGemini 3.8 Liveです。画像や動画を作る場合は、GPT-Image-2.5 Sunburst、Sora 2、Veo 3.1のように、作るものごとに専用のモデルを選びます。
手元で動かせるオープンモデル
Gemma 4とQwen3-Omniは、重みが公開されたオープンモデルです。Gemma 4は全モデルが画像を読め、音声はE2B・E4B・12Bの3つが対応しています。どちらも本記事のCLIPよりはるかに大きく、手元で動かすには相応のメモリが必要です。
マルチモーダルAIの活用例。発表元が公表している3つの事例
モデルの対応状況が分かったところで、マルチモーダルAIが実際にどう使われているかを、発表元が公表している事例で見ていきます。
写真を言葉で説明し、視覚障害のある人を支える(Be My Eyes)
Be My Eyesは、視覚障害のある人とボランティアをビデオ通話でつなぐアプリです。2023年に、OpenAIのGPT-4を使った「Be My AI」を発表しました。利用者が写真を撮ると、AIが写っている内容を文章で詳しく説明し、続けて質問もできます。回答の言語は29言語から選べます(出典:Be My Eyes「Announcing ‘Be My AI’」)。
AIが答えられない場合に、人のボランティアへつなげる設計になっている点も特徴です(出典:Be My Eyes「Introducing Be My AI」)。
- 組み合わせたモダリティ:画像(写真)+文章(質問)→ 文章
電子カルテと病理画像を合わせて、がんの再発を予測する(NEC・理化学研究所・日本医科大学)
NEC・理化学研究所・日本医科大学は2023年6月13日、前立腺がんを対象に、手術前の電子カルテのデータと病理生検の画像などを合わせて解析するマルチモーダルAIを構築したと発表しました。手術から5年後までの再発予測の精度は、既存の手法と比べて約10%向上したとされています(出典:NEC プレスリリース)。
1種類の検査データだけでは見えにくい傾向を、複数の種類を合わせることで捉えようとした例です。
- 組み合わせたモダリティ:画像(病理生検)+表の数値や文章(電子カルテ)→ 予測
ゲームの映像を、言葉で検索できるようにする(バンダイナムコエンターテインメント)
バンダイナムコエンターテインメントは、大量のゲーム映像から目的の場面を探せるシステム「ClipSearch」をPoC(試作による検証)として開発しました。開発を支援したアイレットの導入事例によると、Geminiで動画を「視覚情報・セリフ情報・テキスト情報」の3つに分けてメタデータ(検索用の説明文やタグ)にし、自然言語で場面を検索できるようにしています(出典:アイレット(cloudpack)導入事例)。
動画をそのまま検索するのではなく、いったん文章にしてから検索する点は、本記事で見た「種類の違うデータをそろえる」考え方と共通しています。
- 組み合わせたモダリティ:動画(映像と音声)→ 文章 → 文章で検索
マルチモーダルAIの限界と注意点
活用例を見てきましたが、マルチモーダルAIは何でも正しく読めるわけではありません。使うときに押さえておきたい点を3つ整理します。
学習した言語やデータから外れると、取り違える
本記事の実行例では、英語で学習したCLIPに日本語の文を渡したところ、赤い丸の図を「緑の三角」と取り違えました。同じことは、言語だけでなく画像の種類でも起こります。医療画像や工場の検査画像のように、一般の写真と見た目の違うデータでは、学習したデータとの違いが精度に響きます。
- 使う言語で学習・評価されたモデルかを確認する
- 自分の業務の画像で、少数でも試してから使う
画像や音声の読み違いも、もっともらしい文章で答える
VLMは、画像を読み違えた場合でも、自然な文章で自信があるように答えます。事実と違う内容をもっともらしく出力するハルシネーションは、文章だけのAIに限った問題ではありません。写真の数を数える、細かい文字を読む、といった作業は、答えを人が確かめる手順を用意しておくと安心です。
参照記事:AIハルシネーションとは?発生する原因・事例とRAGによる対策を解説
一度に渡せる量と、使ってよい用途には決まりがある
マルチモーダルAIには、一度に渡せる量の上限があります。公式ドキュメントに書かれている例を挙げます。
- ClaudeのAPIでは、画像は1リクエストあたり最大600枚(200kトークンのモデルは100枚)で、1枚の大きさは最大8000×8000ピクセル(出典:Anthropic Vision)
- Gemma 4では、音声は最大30秒、動画は1秒1コマとして最大60秒
使ってよい用途が決められているモデルもあります。本記事で使ったCLIPのモデルカードは、研究目的の公開であることを明記し、商用・非商用を問わず製品への組み込みは対象外、監視や顔認識への利用も対象外としています。学習や検証には使えますが、そのままサービスに組み込むものではありません。また、写真や音声には、人の顔や声、画面に映った個人情報が入りやすいため、社内のデータを外部のAPIに送る前には、社内のルールを確認しておきましょう。
マルチモーダルAIを作る側に回るための4ステップ
限界まで分かったところで、マルチモーダルAIを使う側から作る側に回るには、何から学べばよいかを整理します。仕組みを自分の手で確かめながら進めると、用語が実感を伴って身につきます。
- Pythonで小さなモデルを動かす:本記事のCLIPのように数百MBのモデルなら、手元のパソコンのCPUで動く。まずはPythonの基礎と、ライブラリの読み込み方を身につける
- 自分の画像と文章で類似度を測る:手元の写真と説明文で、どの組が近いかを計算する。画像を文章で探す検索の仕組みが、自分で組めるようになる
- APIで画像やPDFを渡して答えさせる:VLMに資料の画像を読ませ、答えを取り出す。出力が正しいかを確かめる手順も合わせて作る
- 評価用の組を作って精度を測る:画像と正解の組を用意し、正解率を測って改善する。作ったものを業務で使える水準に近づける工程で、実務で最も時間を使う部分でもある
ステップ1と2は、本記事のコードをそのまま出発点にできます。ステップ3と4まで進むと、社内の文書や画像を扱うAIを自分で試作できる段階に入ります。
まとめ
- マルチモーダルとは、AIが文章・画像・音声・動画など種類の違うデータを、1つのモデルで一緒に扱うこと。1種類だけを扱うAIはシングルモーダルAIと呼ぶ
- 仕組みの土台は、種類ごとのエンコーダーでデータを数値の並びにし、同じ空間にそろえること。CLIPは4億組の画像と文章の組でこれを学習した
- VLMは、画像エンコーダーの出力をLLMが読める形に変換して渡すことで、画像を読んで文章で答える
- 小さなCLIPを手元で動かすと、英語の文では4枚とも99%以上で正しい文を選んだ一方、日本語の文では赤い丸の図を「緑の三角」と取り違えた
- 2026年9月時点の主なモデルは、入力はマルチモーダルでも出力は文章だけのものが多く、画像・音声・動画の生成は専用のモデルに分かれている
- 学習した言語やデータの偏り、読み違い、扱える量と用途の決まりに注意して使う
マルチモーダルAIを作る側に回るなら「Craft College」へ
「マルチモーダルAIの仕組みは分かったが、自分でモデルを動かし、画像や文書を扱う仕組みを作れるようになるには何から学べばいいのか」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- マルチモーダルAIの仕組みを、用語の理解から自分で動かして確かめられる段階へ進めたい方
- 社内の文書や画像を扱うAIを、自分で設計できるようになりたい方
- 独学で何から手をつければいいか分からず、止まってしまっている方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。