強化学習とは。報酬で学ぶ仕組みとQ学習、LLMを支えるRLHFまで解説
強化学習と聞くと、囲碁やテレビゲームでAIが人間に勝った話を思い浮かべる方が多いと思います。ただ、話はそこで終わっていません。
いま使っているChatGPTのようなLLMも、最後は強化学習の枠組みで人間の好みに合わせて仕上げられています。「正解は用意できないが、出てきたものの良し悪しは言える」という状況を扱うのが強化学習で、文章の生成はまさにその状況にあたります。
なお、この分野の基礎を築いた Andrew G. Barto と Richard S. Sutton は、2024年のACM A.M. チューリング賞を受けています(2025年3月発表)。
そこで本記事では、
- 強化学習とは何か。教師あり学習・教師なし学習との違い
- エージェントと環境の枠組み
- Q学習など代表的なアルゴリズム
- 報酬設計でつまずく3つの型
- LLMがRLHFで仕上げられている仕組み
- 自分の仕事で使える場面と、使いにくい場面
- 学ぶならどの順番か
を解説します。
強化学習とは。正解ではなく報酬から学ぶ機械学習
強化学習の定義。報酬の合計が大きくなる行動の選び方を学ぶ
強化学習とは、あらかじめ正解を教わる代わりに、行動の結果として受け取る報酬を手がかりにして、報酬の合計が大きくなる行動の選び方を試行錯誤から学ぶ機械学習の手法です。
なぜ正解を教えないのか。教えられないからです。
たとえば二足歩行のロボットを歩かせたいとき、「この瞬間に右の膝を何度曲げるのが正解か」を人が全部書き下すことはできません。しかし「前に進んだら加点、転んだら減点」という点数のつけ方なら書けます。
正解の手順は書けないが、結果の良し悪しには点数をつけられる。この状況で使うのが強化学習です。
機械学習の3つの学び方。教師あり学習・教師なし学習との違い
機械学習には大きく3つの学び方があります。
| 教師あり学習 | 教師なし学習 | 強化学習 | |
|---|---|---|---|
| 正解ラベル | ある | 無い | 無い |
| 学習の手がかり | 正解との誤差 | データの中の構造 | 行動に対して返る報酬 |
| 解くこと | 入力から出力を当てる | データをまとめる、特徴を取り出す | 行動の選び方を決める |
| 代表的な用途 | 需要予測、画像の判別 | 顧客の分類、異常の検出 | ロボット制御、ゲーム、LLMの調整 |
違いは何を手がかりに学ぶかです。教師あり学習は1つ1つのデータに正解がついていて、外れた分を修正します。教師なし学習は正解が無く、データの中の構造を見つけます。強化学習は正解こそありませんが、行動の結果に点数がつきます。
もうひとつ大きな違いがあります。教師あり学習と教師なし学習では、学習に使うデータは最初から手元にあります。強化学習では、エージェントが動くことでデータが生まれます。何を試したかによって、集まるデータ自体が変わります。
強化学習の出番になる問題の条件
ここまでを整理すると、強化学習の出番になる条件は2つです。
- 正解の手順を人が書き下せない
- 行動の良し悪しを、あとから点数にできる
この2つが揃っているかどうかが、後半で自分の仕事に当てはめるときの判断軸になります。
強化学習の仕組み。エージェント・環境・状態・行動・報酬の5要素
5つの要素と、1ステップで起きること
強化学習は5つの要素で表されます。
- エージェント:行動を選ぶ側。学習する主体
- 環境:エージェントが働きかける対象。ゲーム、シミュレータ、設備など
- 状態:いま環境がどうなっているか
- 行動:エージェントが選べる選択肢
- 報酬:行動の結果として環境が返す点数
この5つが次のように回ります。
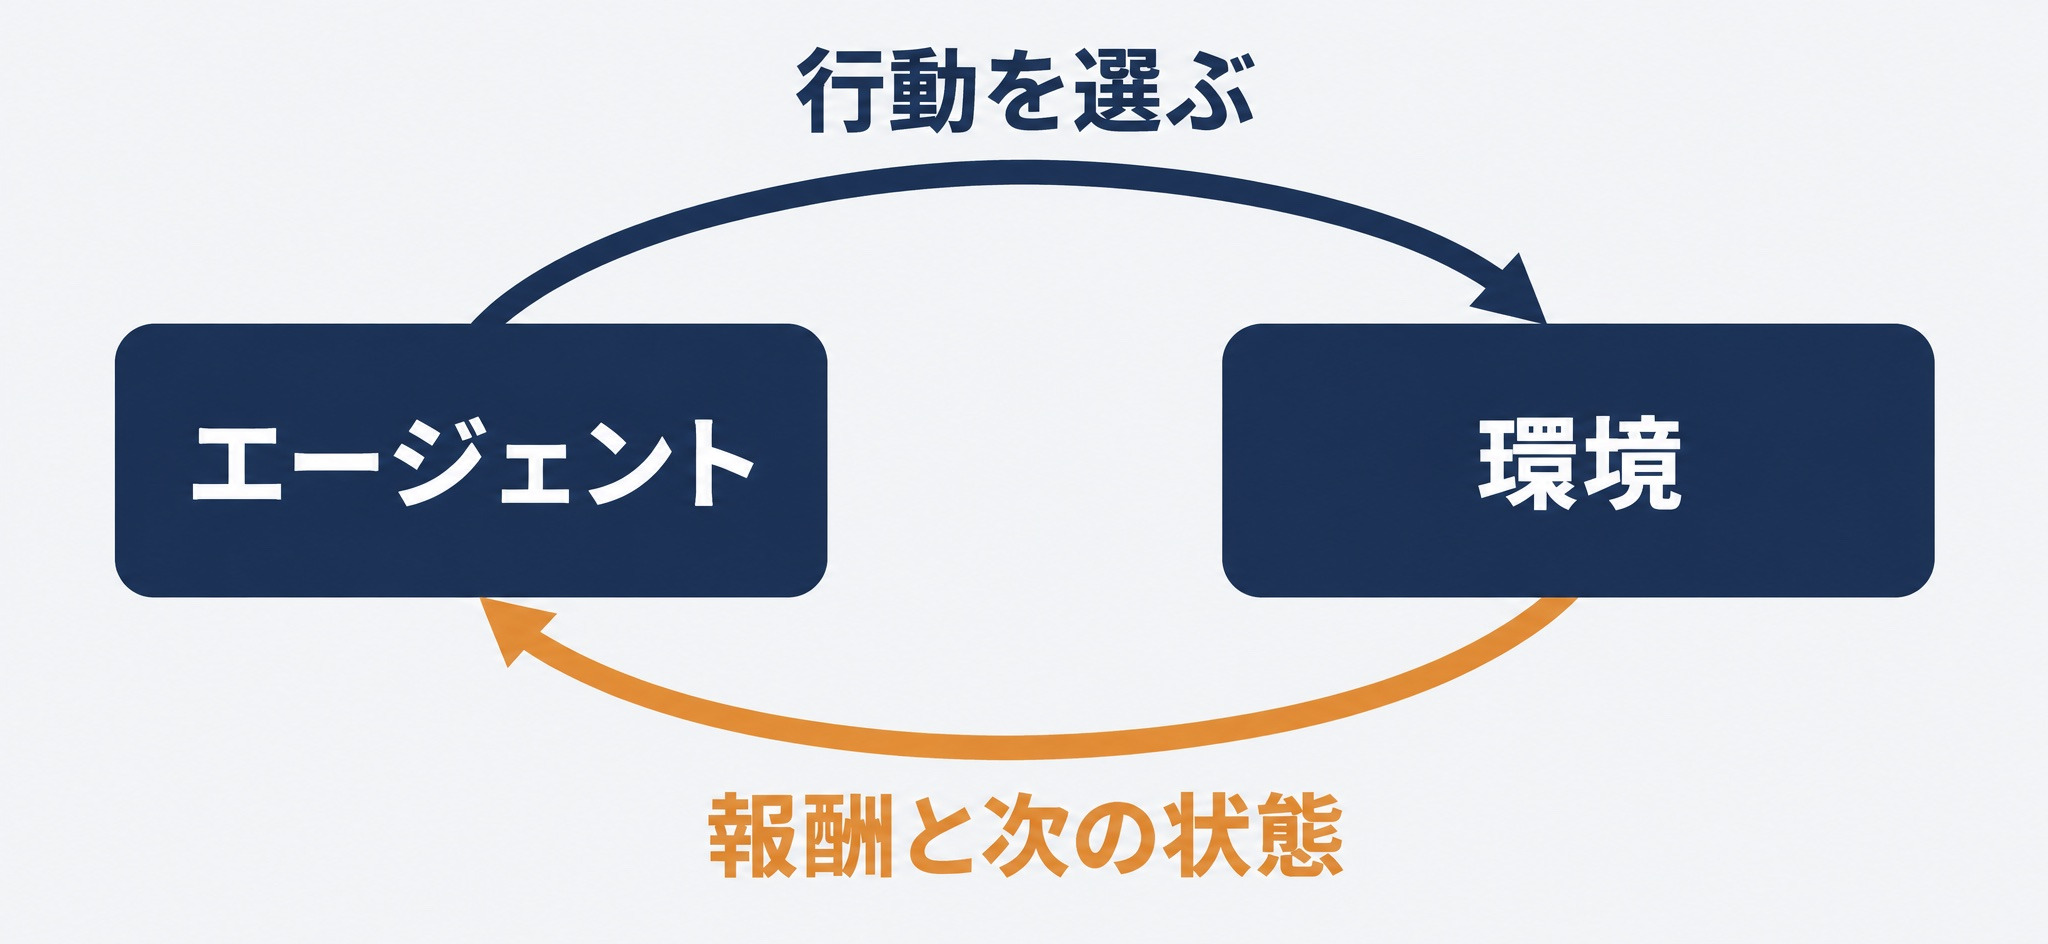
エージェントが環境の状態を見て、行動を1つ選びます。環境はその行動を受けて次の状態に変わり、報酬を返します。エージェントはまた状態を見て、次の行動を選びます。この繰り返しです。
厳密には、状態と観測は別物です。状態は環境の完全な記述で、エージェントが実際に見られるのはその一部でしかない場合があります。
強化学習のエージェントと、AIエージェントは別のもの
用語で混乱しやすいので、ここで区別しておきます。
強化学習で言うエージェントは、環境の状態を見て行動を選ぶ学習主体を指します。最近よく聞く「AIエージェント」は、LLMにツールの実行と手順の判断を任せる仕組みを指す言葉で、別のものです。
同じ言葉ですが、指しているものが違います。
方策と価値。目先の報酬ではなく先まで含めた合計で選ぶ
方策とは、どの状態でどの行動を選ぶかの決め方です。学習によって更新されていくのが、この方策です。
価値とは、その状態から先で受け取れる報酬の見込みです。ここが強化学習の肝で、エージェントは目先の報酬ではなく、先まで含めた合計が大きくなるように選びます。
いま1点もらえる行動と、いまは0点だが3手先で10点につながる行動があれば、後者を選ぶべきです。この判断ができるように、先の報酬まで含めて評価します。
ただし遠い先の報酬は不確かなので、少し割り引いて評価します。どれくらい先まで見るかは、設計で決める項目のひとつです。
探索と活用。良い手を使い続けるか、試していないことを試すか
もうひとつ避けて通れないのが探索と活用です。
いま良いと分かっている手を使い続けるのが活用、まだ試していない手を試すのが探索です。活用ばかりでは、もっと良い手があっても見つかりません。探索ばかりでは、良い手が分かっていても点が伸びません。
そしてここが重要ですが、探索には試行回数が要ります。強化学習が「大量に試せる場面」で強く、「試行回数を稼げない場面」で使いにくいのは、この性質が理由です。
強化学習の代表的なアルゴリズム。Q学習から深層強化学習まで
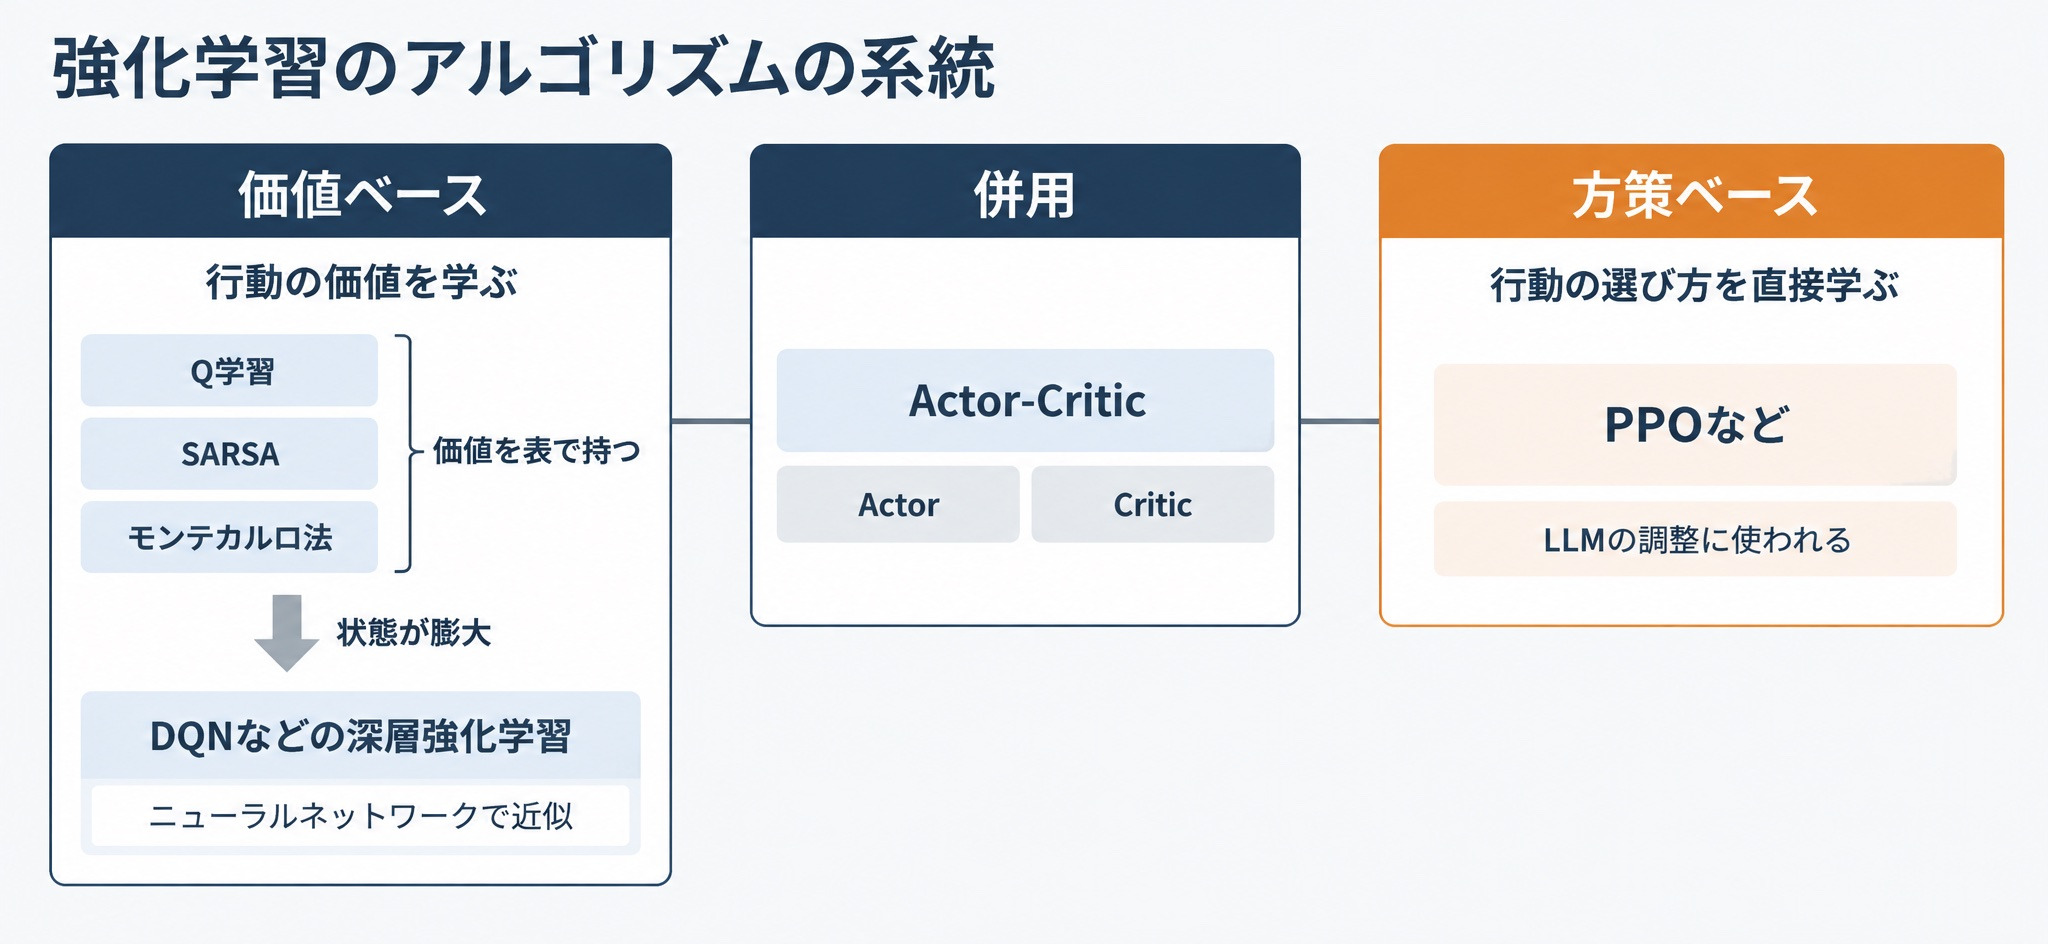
代表的な手法を先に一覧で見ます。
| 手法 | 系統 | 学習の仕方 | 向いている場面 |
|---|---|---|---|
| Q学習 | 価値ベース | 各行動の価値を1手ごとに更新する | 状態と行動の数が限られている |
| SARSA | 価値ベース | 実際に次に選んだ行動の結果で更新する | 学習中の失敗も避けたい |
| モンテカルロ法 | 価値ベース | 1回終わるまで待って、結果から遡る | 途中の評価が難しい |
| PPOなどの方策ベース | 方策ベース | 行動の選び方そのものを直接更新する | 行動が連続値、選択肢が多い |
| Actor-Critic | 併用 | 方策と価値の両方を持って補い合う | 学習を安定させたい |
| DQNなどの深層強化学習 | 価値ベース | 価値をニューラルネットワークで近似する | 状態が膨大で表に持てない |
Q学習・SARSA・モンテカルロ法。価値を表で持って更新する
Q学習は、ある状態である行動を選んだときに、その先で受け取れる報酬の見込み(Q値)を表として持ち、実際に行動した結果で少しずつ更新していく手法です。
迷路を例にすると、最初はどのマスでどちらに進めばよいか分かりません。何度も歩かせるうちに、ゴールに近いマスから順に「この向きは価値が高い」という数字が埋まっていきます。
SARSAはQ学習と似ていますが、更新に使う値が違います。Q学習は「次の状態で最も価値の高い行動」を使い、SARSAは「実際に次に選んだ行動」を使います。結果として、SARSAのほうが学習中の失敗を避ける方策になりやすいという性質があります。
モンテカルロ法は、1回のエピソードが終わるまで待ってから、結果をもとに遡って更新します。途中の評価をせずに済む代わりに、終わりのある問題でしか使えません。
方策を直接学ぶ手法。PPOなどの方策ベースとActor-Critic
価値を経由せず、「どの行動をどのくらいの確率で選ぶか」を直接更新する系統もあります。PPOなどが該当します。
行動が連続値のとき(ハンドルを何度切るか、など)、価値ベースの手法は選択肢を区切る必要があります。方策ベースはそのまま扱えます。
Actor-Criticは、行動を選ぶ側(Actor)と、その良し悪しを評価する側(Critic)の両方を持ち、互いに補い合わせる形です。
後半で扱うLLMの調整に使われているのは、この方策ベースの系統です。
深層強化学習。表で持てない状態をニューラルネットワークで扱う
Q学習は表で価値を持つため、状態の数が増えると破綻します。画面のピクセルをそのまま状態にすると、組み合わせは天文学的な数になります。
そこで、表の代わりにニューラルネットワークで価値を近似するのが深層強化学習です。DQN以降、この方式が広く使われています。
強化学習でつまずく報酬設計。狙いと違う行動を学ぶ3つの失敗の型
強化学習では、何を学ばせたいかを報酬という形でしか渡せません。だから報酬の決め方が、設計の本体になります。
そして報酬の決め方は、想像よりずっと簡単に失敗します。
失敗の型1。近道が見つかると、目的を達成せず報酬だけ稼ぐ
有名な実例があります。OpenAIが2016年12月に公開した報告です。
ボートレースのゲーム「CoastRunners」でエージェントを学習させたところ、このゲームはコースの進行そのものではなく、ルート上に置かれた的を叩くことで点が入る作りでした。エージェントが見つけたのは、入り江で大きく旋回し、再び出現する3つの的を叩き続ける方策です。
繰り返し炎上し、他のボートに衝突し、逆走しながら、コースを正規に完走するよりも高い点を出しました。OpenAIの報告では、人間のプレイヤーの平均を20%上回る点数に達しています。
「速くゴールする」ことを学ばせたかったのに、「点を稼ぐ」ことを学んでしまった。これが報酬設計の失敗です。
この現象は報酬ハッキングと呼ばれます。2016年の論文「Concrete Problems in AI Safety」が挙げた5つの問題の1つとして、以前から名前のついている論点です。
失敗の型2。測れるものだけを報酬にすると、測れない価値が削られる
業務に置き換えると、この型がいちばん起きます。
たとえば問い合わせ対応を「処理件数」だけで採点すると、時間のかかる相談を避ける行動が学習されます。件数は伸びますが、難しい相談ほど後回しになります。
測りやすいものを報酬にするのは自然な発想ですが、測っていない価値は守られません。削られても点は下がらないからです。
失敗の型3。報酬が遠すぎて、いつまでも学習が進まない
最後に成功したときしか点が入らない設計にすると、偶然たどり着くまで手がかりがありません。学習がいつまでも進まない状態になります。
では途中の進み具合に点をつければよいかというと、今度は型1が起きやすくなります。途中に点を置くほど、その点だけを稼ぐ抜け道ができるからです。
この2つは引っ張り合う関係にあり、どちらかに寄せれば済むものではありません。
強化学習の報酬設計を確かめる4つの手順
そこで、報酬を決めたあとに次の4つを踏みます。
- 最終的に達成したい状態を、報酬とは別の言葉で先に書き出す。「速く完走する」と日本語で書いておきます
- その状態に至らずに報酬だけ最大化する方法が無いか、意図的に探す。ここが最も重要で、型1への直接の対処になります。抜け道を探す側に回って考えます
- 測れない制約は、報酬への加点ではなく禁止条件として別に置く。加点にすると、他の点と引き換えに破られます
- 短い試行で走らせて、学習した行動を必ず目で見る。点数の推移だけで判定しません。CoastRunnersの件も、点数のグラフだけ見ていれば「うまくいっている」と読めてしまいます
報酬設計の考え方は分かったが、自分でモデルを組んで、学習した行動が狙いどおりかを確かめるところまで一人でたどり着ける気がしない、という方もいると思います。何をどの順番で身につければよいのかも、独学では見えにくいところです。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座は、Pythonと統計の基礎から始めて、モデルを作り、精度を測って良し悪しを判断する流れを先に身につけてから、生成AI・LLMの開発へ進む構成になっています。本記事の後半で触れる「強化学習から入らない」という順序が、そのままコースの進み方です。詰まったところは現役データサイエンティストと1対1で相談しながら進められます。
まずは講座の内容を確認してみてください。
⇨Craft Collegeの詳細はこちら
LLMは強化学習で仕上げられている。RLHFと推論モデルの学習
ここからが本記事の主題です。
文章に唯一の正解はありません。しかし、2つの答えを並べて「どちらが良いか」は人が言えます。これは、前半で述べた強化学習の出番の条件そのものです。正解の手順は書き下せないが、結果の良し悪しには点をつけられる。
いまのLLMは、この構図の上で仕上げられています。
RLHF。人の好みを報酬モデルにして、強化学習でLLMを更新する
RLHF(人間のフィードバックによる強化学習)は、3段階で進みます。
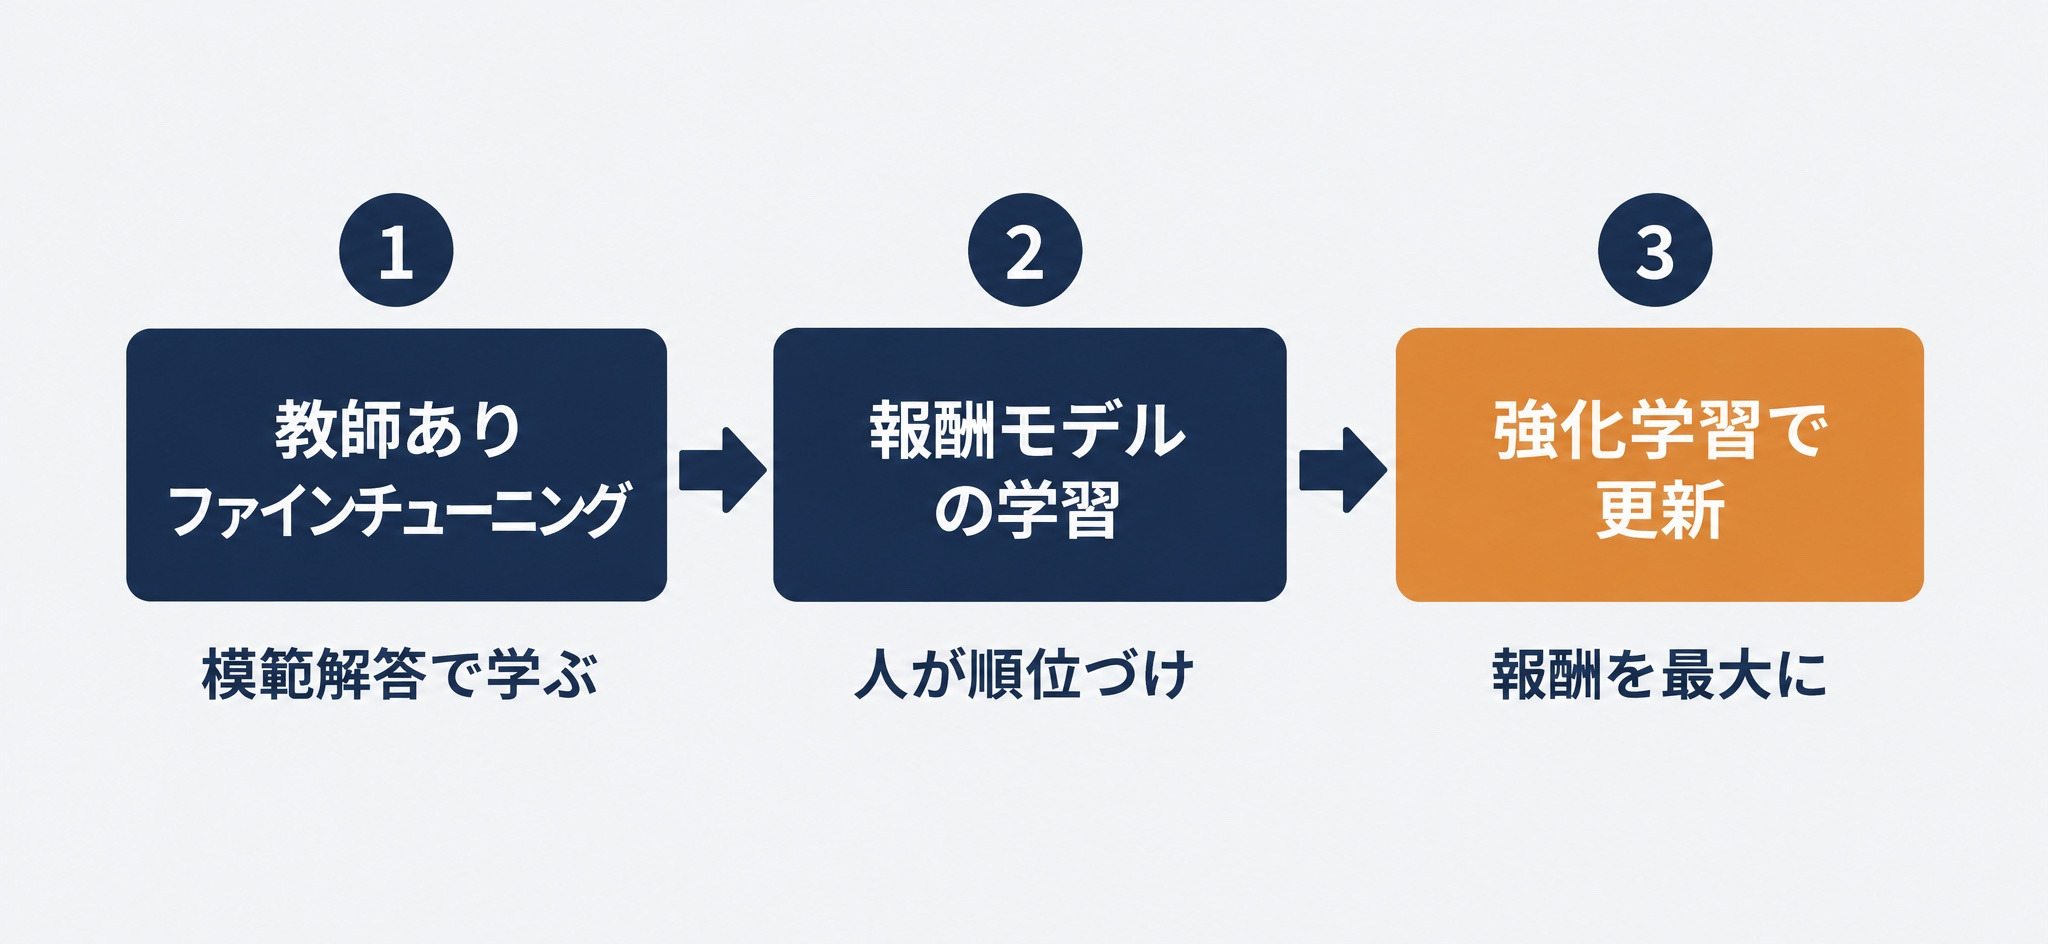
- 人が書いた模範解答で、教師ありファインチューニングを行う
- 同じ質問への複数の答えを人が順位づけし、その比較データから「人の好みを点数にする報酬モデル」を学習する
- その報酬モデルを環境に見立てて、強化学習でLLMの出力の選び方を更新する
2番目がこの方式の要です。人に「良い答えを書いてください」と頼むのは大変ですが、「AとBのどちらが良いですか」と尋ねるのは簡単です。比較なら大量に集められるので、それを点数に変換するモデルを作ります。
効き目は数値で出ています。OpenAIのInstructGPT論文では、13億パラメータのInstructGPTの出力が、パラメータ数が100倍以上ある1,750億のGPT-3の出力よりも、人手評価で好まれたと報告されています。モデルを大きくするのではなく、報酬で仕上げるほうが効く領域があるということです。
LLMそのものの仕組みはLLMとは何か。仕組みと種類、企業での活用方法をわかりやすく解説、事前学習で何を覚えているのかは生成AIの仕組みとは。データからテキストが生成されるまでをわかりやすく解説、1番目のファインチューニングはファインチューニングとは。仕組み・種類・RAGとの違いをわかりやすく解説で扱っています。
人の評価をAIに任せるRLAIF。Constitutional AIの考え方
比較データを人が作る部分は、それでも負荷が大きく残ります。
Anthropicが示したConstitutional AIでは、人が与えるのは守ってほしい原則のリストだけで、2つの出力のどちらが良いかの判定はAIモデルが行います。人のフィードバックの代わりにAIのフィードバックを使うので、RLAIFと呼ばれます。
検証できる報酬で推論を伸ばす。DeepSeek-R1が示したこと
もうひとつの方向が、人の好みではなく、機械で正誤を検証できるものを報酬にするやり方です。
DeepSeek-R1の論文(2025年1月)は、人が書いた思考過程のデータを使わず、強化学習だけで推論能力を引き出す方式(R1-Zero)を示しました。報酬はルールで決めています。数学なら指定の形式で書かせた最終解答を機械で照合し、コードならコンパイラとテストケースで判定します。それに加えて、思考過程を決まったタグで囲ませる形式の報酬を置きます。
結果として、数学競技AIME 2024の正答率(pass@1)が学習の過程で15.6%から71.0%へ上がり、複数回答の多数決を使うと86.7%に達したと報告されています。教師ありファインチューニングを挟んだDeepSeek-R1は79.8%で、OpenAI-o1-1217の79.2%と同水準です。
正誤を機械で検証できる領域では、強化学習の効きが大きい。逆に言えば、検証できるかどうかが、この方式を使えるかの分かれ目になります。
LLMの学習でも報酬ハッキングは起きる
ここで前半と結び直します。
同じDeepSeek-R1の論文は、R1-Zeroでニューラルネットワークによる報酬モデルを使わなかった理由を明記しています。大規模な強化学習の過程で報酬ハッキングを受ける可能性がある、というのがその理由です。
報酬設計の失敗はゲームの昔話ではありません。最新のLLMの学習でも、設計の判断を左右しています。
強化学習が使える場面と、使いにくい場面
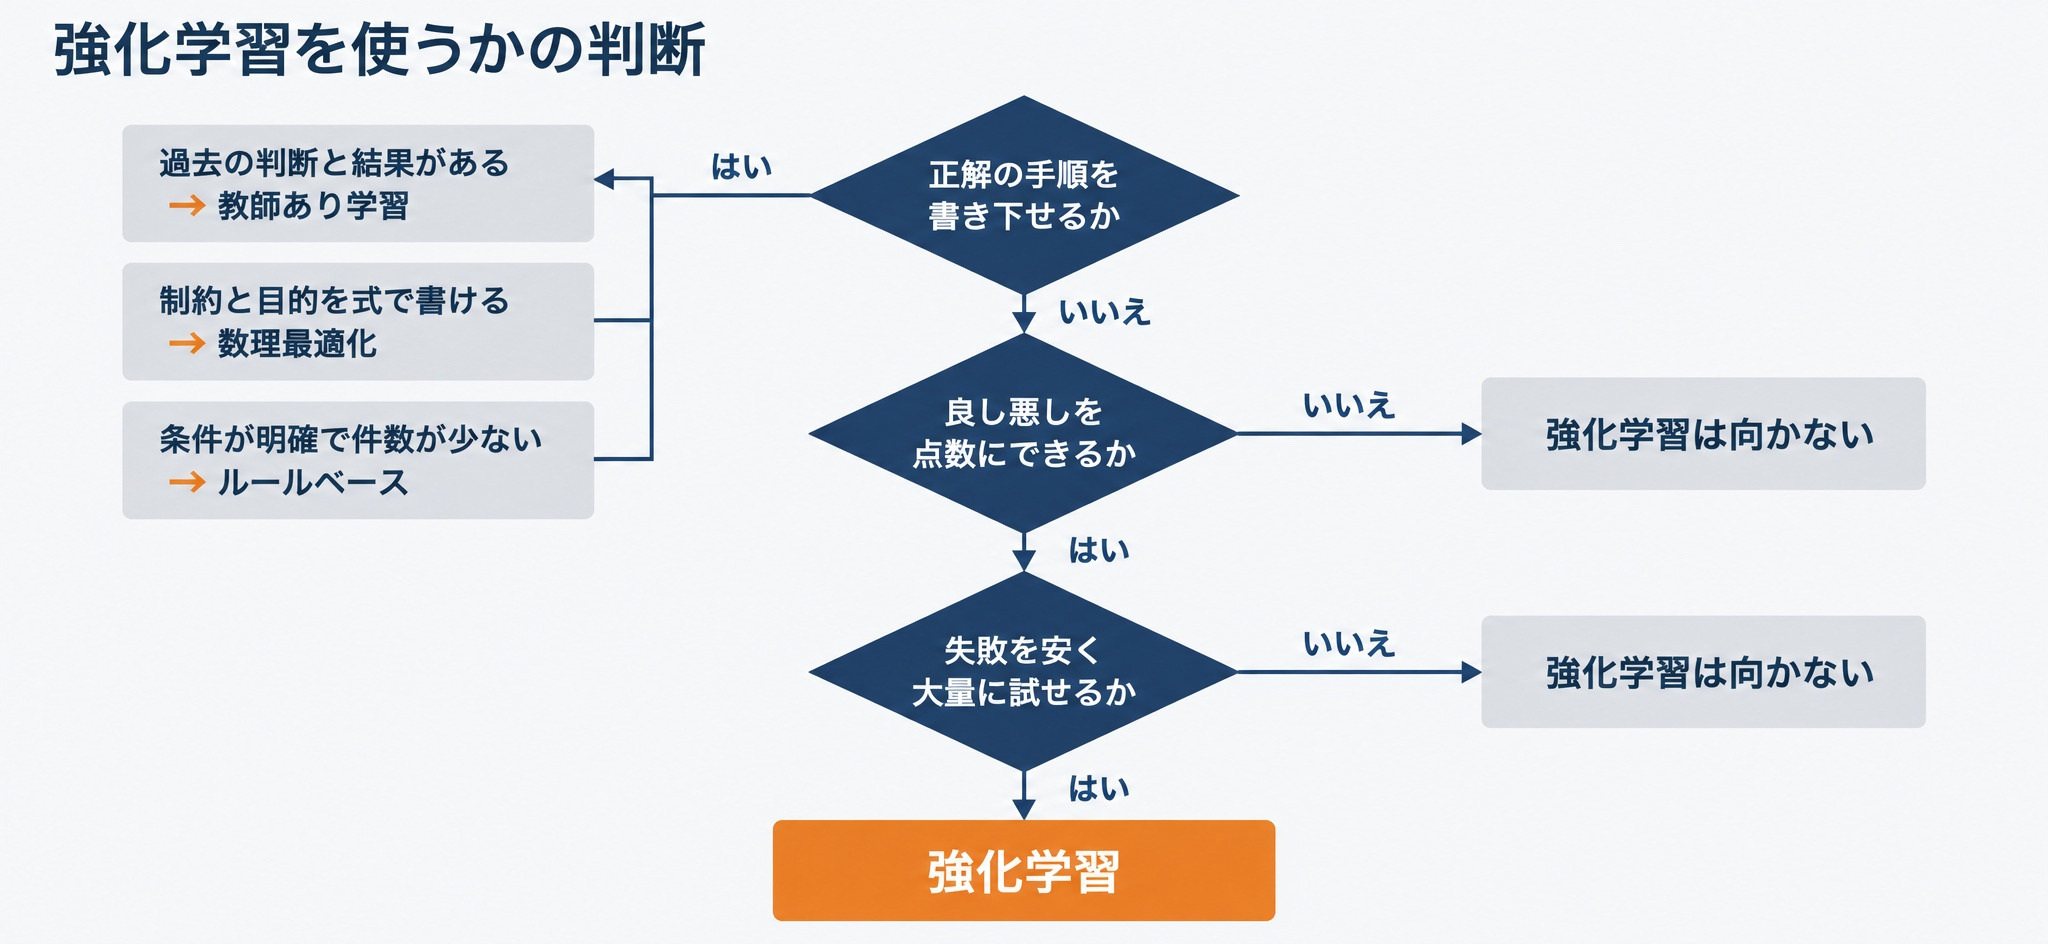
では自分の仕事ではどうか。前半で挙げた2つの条件を判断軸にして整理します。
| 条件1:正解の手順を書き下せない | 条件2:良し悪しを点数にできる | 向く手法 | |
|---|---|---|---|
| 設備の制御・運用 | 満たす | 満たす(消費電力、稼働率) | 強化学習 |
| 配信・推薦の出し分け | 満たす | 満たす(クリック、成約) | 強化学習 |
| 需要の予測 | 満たさない(過去データに答えがある) | ー | 教師あり学習 |
| 配送ルートの決定 | 満たさない(制約と目的を式で書ける) | ー | 数理最適化 |
| 与信・医療の判断 | 満たす場合がある | 満たすが、失敗のコストが高い | 強化学習以外を先に検討 |
使える場面1。シミュレータの上で制御と運用を詰める
本命は、失敗を安く大量に試せて、良し悪しを数字にできる領域です。
Google DeepMindは、データセンターの冷却制御に機械学習を適用し、冷却に使うエネルギーを最大40%、電力使用効率(PUE)のオーバーヘッドを15%削減したと公表しています(2016年)。設備の制御、在庫や配車の運用、ロボットの動作などがこの型にあたります。
共通しているのは、本番ではなくシミュレータの上で何万回も試せることです。
使える場面2。配信や推薦のように、選んで結果を見る行為を繰り返せる
どの案を出すかを選び、クリックや成約という形で結果が返る。この構図は、そのまま行動と報酬になります。
しかもこの領域は試行の単位が小さく、1日に何万回も回ります。多腕バンディットのような単純な形から始められるのも利点です。
使いにくい場面。試行回数を稼げない、失敗のコストが高い業務
逆に、次のどれかに当てはまるなら、強化学習は向きません。
- 試行回数を稼げない。月に数回しか判断の機会が無い業務では、学習に必要な試行数に届きません
- 失敗のコストが高い。実機、患者、与信など、試しに間違えることが許されない領域です。強化学習は学習に多くの試行を要するため、本番環境でいきなり試行錯誤させる設計は現実的ではありません
- 良し悪しが後から数字にならない。評価が半年後にしか分からない、関係者ごとに評価軸が違う、といった場合です
使いにくいときの代替手段。教師あり学習・数理最適化・ルール
向かないと判断したら、次のどれかに寄せます。
- 過去の判断とその結果がデータとして残っている → 教師あり学習
- 制約と目的が数式で書ける → 数理最適化
- 条件が明確で、件数も多くない → ルールベース
「これは強化学習の問題ではない」と言えることが、使いこなしの第一歩です。
強化学習の学び方。何からどの順番で学ぶか
未経験から強化学習にたどり着く5つのステップ
- Pythonの基本文法と、pandasでのデータの扱い
- 教師あり学習で、モデルを作って精度を測る流れを一度通す
- 強化学習の用語と枠組みを、迷路のような小さな問題でQ学習を実装して確かめる
- ニューラルネットワークの基礎を入れて、深層強化学習に進む
- Sutton & Barto『Reinforcement Learning: An Introduction』第2版(MIT Press, 2018)で体系を通す(全文が無償公開されています)
強調したいのは、強化学習から入らないということです。
2番目を飛ばすと、学習・評価・過学習という感覚が無いまま強化学習に入ることになります。すると、出てきた結果が良いのか悪いのかを判断できません。報酬のグラフが上がっていても、それが狙った行動なのかは別の話だからです。
機械学習を含むデータサイエンス全体の学ぶ範囲はデータサイエンスとは。定義・活用事例・学び方をわかりやすく解説で整理しています。
まとめ
- 強化学習とは、正解を教わる代わりに報酬を手がかりにして、報酬の合計が大きくなる行動の選び方を学ぶ手法
- エージェント・環境・状態・行動・報酬の5要素で回る。目先ではなく先まで含めた合計で選ぶ
- Q学習などで価値を更新し、状態が多すぎて表に持てない場合はニューラルネットワークで近似する
- 報酬の決め方を誤ると、目的を達成せずに点だけ稼ぐ行動を学ぶ。報酬を決めたら、抜け道が無いかを意図的に探す
- いまのLLMはRLHFなど強化学習の枠組みで仕上げられている。検証できる報酬を使う方向も出てきている
- 試行を安く繰り返せて、良し悪しを数字にできる場面が本命。当てはまらないなら教師あり学習・数理最適化・ルールに寄せる
強化学習を学ぶなら「Craft College」へ
「強化学習の考え方は分かったが、自分でモデルを動かせるようになるには何から始めればいいのか」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- 用語の解説を読む段階から、自分でモデルを作れる段階へ進めたい方
- 作ったモデルの良し悪しを、自分で判断できるようになりたい方
- 独学で何から手をつければいいか分からず、止まってしまっている方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。