RevolutのローカルLLMコーディング事例。AIコーディング費約90%減の中身
英国のフィンテック企業Revolutが、AIコーディングの推論コストを1年足らずで約90%減らしたと報じられています。Claudeのような商用サービスに主に頼る形をやめ、自社でホストするモデルを既定にしたことが理由とされています。
しかし、「自社でモデルを動かすだけで本当に9割も下がるのか」「どんなモデルと設備が要るのか」「報じられた数字はどこまで信じてよいのか」が分からず、自社で同じ判断をしてよいのか迷う方も多いでしょう。
そこで本記事では、次の点を整理します。
- RevolutのローカルLLMコーディング事例で、何が起きたのか
- 採用されたGLMというモデルの規模と、自社ホストを支えた技術
- 報じられた数字のうち、確認できていることと、できていないこと
- 日本企業にとっての意味(解釈として分けて記載)
についてわかりやすく解説します。開発組織のAI活用コストや運用方法を見直す立場の方は、ぜひ最後までご覧ください。
なお、Revolut自身の公式発表や講演の一次資料は確認できていません。本記事は、The RegisterとDealroomの報道に基づいています。報道ベースの内容には「と報じられています」を付け、事実と解釈を区別して書きます。
「自社の環境で動くLLMを使って、AIコーディングの費用を見直したい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
- RevolutのローカルLLMコーディング事例とは。AIコーディング費を約90%減らしたと報じられている内容
- AIコーディングの利用費が膨らむ構造と、Revolutが自社ホストを検討した経緯
- ローカルLLMに採用されたGLM・Z.ai・オープンウェイトとは。GLM-5.1とGLM-5.3の規模
- RevolutのローカルLLMコーディング基盤の数字を整理する。コスト、設備、速度
- ローカルLLMコーディングを成り立たせた技術。量子化とチューニング
- ClaudeやCodexはどうなったか。ローカルLLMコーディングと商用サービスの使い分け
- RevolutのローカルLLMコーディング事例の報道はどこまで確かか。確認できていないことの整理
- ローカルLLMコーディングは日本企業に当てはまるか。規模、規制、中国製モデルへの見方
- まとめ
- ローカルLLMでのAIコーディング基盤の相談は「リベルクラフト」
- 参考情報
RevolutのローカルLLMコーディング事例とは。AIコーディング費を約90%減らしたと報じられている内容
ローカルLLMとは、外部の提供元のサーバーではなく、自社が管理する環境で動かす大規模言語モデルを指します。報じられている要点を3つに絞って確認します。
- Revolutは、自社ホストモデルを既定にして、AIコーディングの推論コストを1年足らずで約90%削減したと報じられています。
- 発表したのは、運用とインフラの責任者David Abitbol氏で、先月ニューヨークのAI Engineerカンファレンスで語ったと報じられています。
- AIコーディングツールは約2,000人のエンジニアに展開され、コーディング時間が60%、リードタイムが70%改善したとされています。ただし、これらはRevolut自身の数値です。
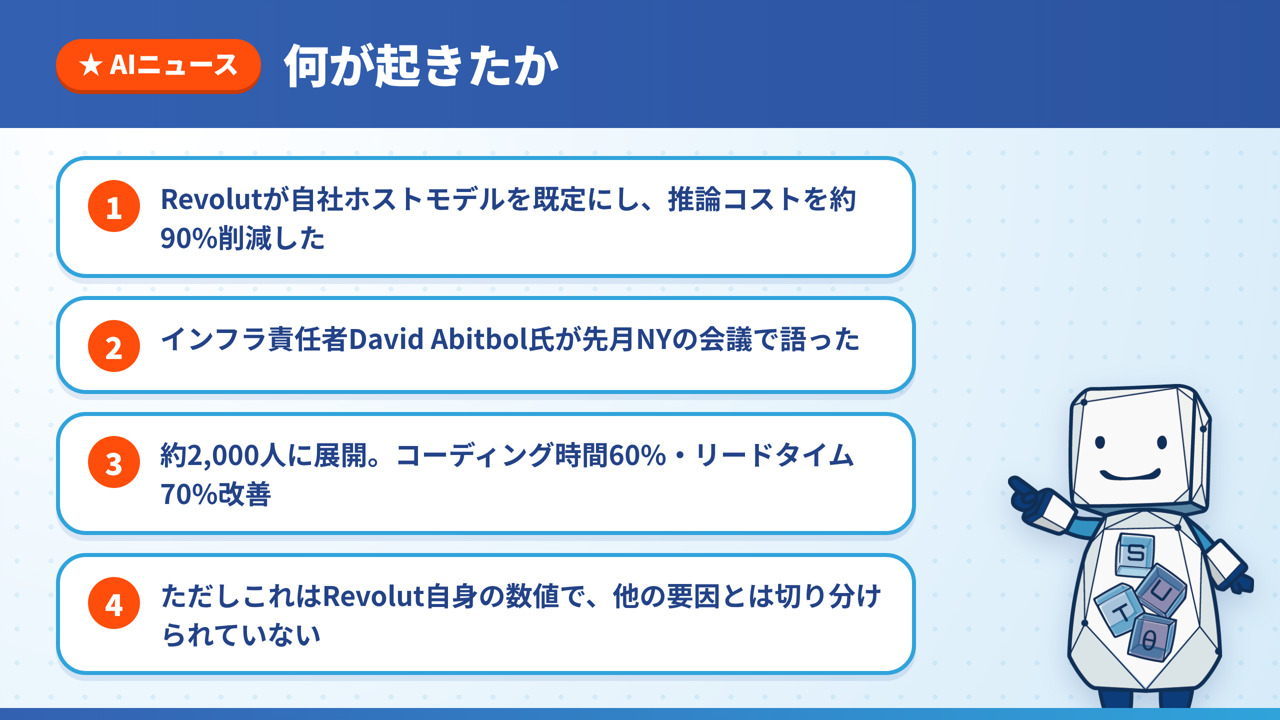
図解:報じられている内容は、削減率、発表者、展開規模、数値の位置づけの4点に整理できます。
推論コストとは、AIモデルに文章やコードを入力し、答えを出力させる処理にかかる費用です。トークンとは、AIが文章を処理するときの単位で、商用サービスでは処理したトークンの量に応じて課金される形が一般的です。
講演のタイトルは「Shipping like a startup, regulated like a bank」だったと報じられています。スタートアップのように出荷し、銀行のように規制される、という意味です。この件は、11月初旬にTrending Topicsが取り上げた後に拡散したとDealroomが伝えています。
AIコーディングの利用費が膨らむ構造と、Revolutが自社ホストを検討した経緯
次に、Revolutがなぜ自社ホストの検討に進んだのか、その背景を整理します。報道によると、RevolutはGLMに切り替える前から、AIの試行を重ねていました。
| 時期 | 出来事 |
|---|---|
| 2025年初頭 | Geminiを導入 |
| 2026年初頭 | Claude Codeを導入 |
| 導入後 | 約2,000人のエンジニアにAIコーディングツールを展開 |
| 導入後 | 厳格な予算制限をつけて運用を開始 |
| その後 | トークンの制限を受け、自社でのモデルホスティングの検討を開始 |
| その後 | GLM-5.1を採用し、GLM-5.3へ移行 |
この表から読み取れるのは、自社ホストが最初からの計画ではなく、商用サービスの利用が広がった後に出てきた選択肢だという点です。これは解釈です。ただし、各出来事の具体的な月日は確認できていません。
月1,000ドルから10,000ドルを使う人がいた
Abitbol氏は、月に1,000ドル、10,000ドルを使うエンジニアがいる一方で、投資対効果(ROI)が乏しかったと語ったと報じられています。そのため、厳格な予算制限をつけて開始したとされています。
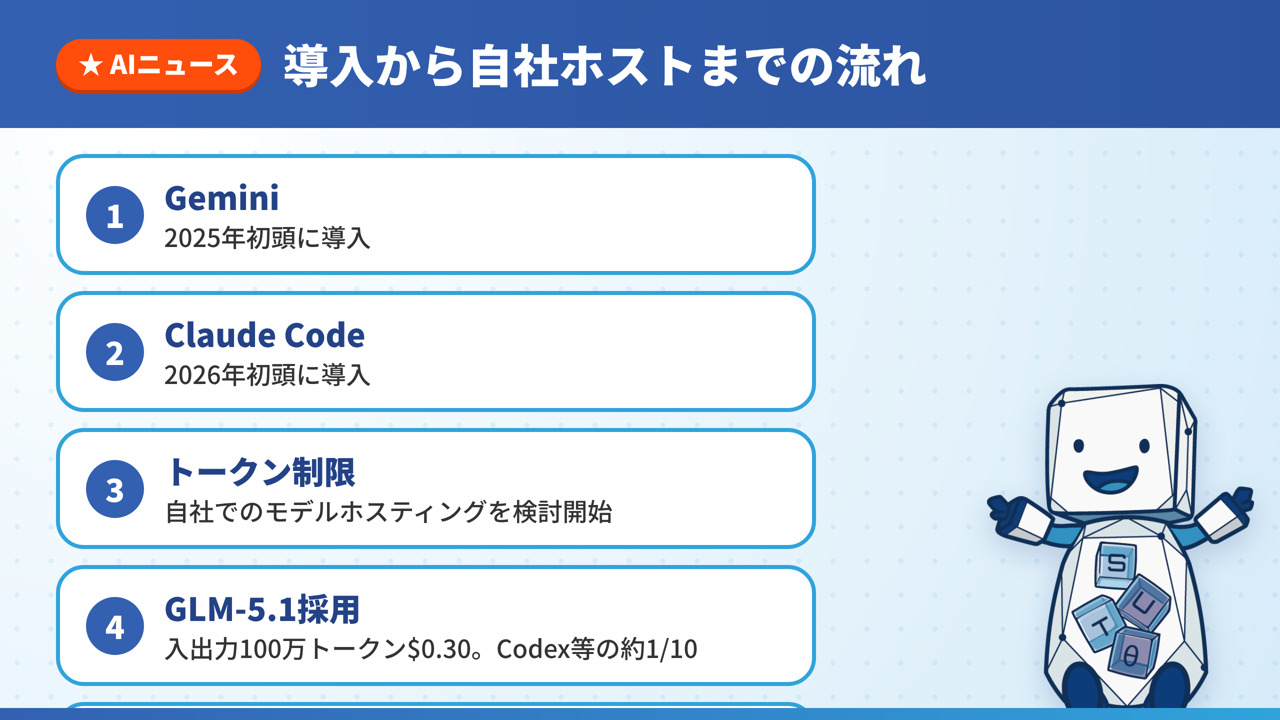
図解:Geminiの導入から、トークン制限をきっかけにした自社ホスト検討、GLM-5.1の採用までの流れです。
予算制限の結果、エンジニアが使えるトークンは限られました。Revolutはこの状況を受けて、自社でのモデルホスティングの検討を始めたと報じられています。
トークン無制限で変わったこと
Abitbol氏は、トークンが無制限だと、四半期末や最も難しいタスクのためにトークンを温存する必要がなくなると述べたと報じられています。
ここからは解釈です。利用額が人によって大きくばらつく状態で全社に展開すると、予算を締めて使い控えを招くか、費用を受け入れるかの二択になりがちです。Revolutは、利用を絞る代わりに、1トークンあたりの単価そのものを下げる方向を選んだと読み取れます。
ローカルLLMに採用されたGLM・Z.ai・オープンウェイトとは。GLM-5.1とGLM-5.3の規模
この章では、Revolutが採用したGLMとは何かを、用語の定義から説明します。GLMは、中国のオープンウェイトモデル開発元であるZ.aiが開発したモデルです。Revolutは、まずGLM-5.1を採用し、その後GLM-5.3へ移行したと報じられています。GLM-5.3のパラメータ数や、GLM-5.1との性能差は、確認できていません。
オープンウェイトとセルフホストの意味
オープンウェイトとは、学習済みモデルの「重み」が公開され、利用者が自分の環境で動かせる形で配布されているモデルを指します。重みとは、モデルが学習で獲得した数値の集まりで、モデルの中身そのものです。ソースコードや学習データまで全て公開するオープンソースとは、公開の範囲が異なる場合があります。
セルフホストとは、そのモデルを提供元のサービス経由ではなく、自社が用意したサーバーやGPU上で動かすことです。Revolutは、オープンウェイトだけを利用し、Z.aiのホスティングサービスではなく、米国にある自社のインフラ上で動かしていると報じられています。
GLM-5.1の規模
The Registerは、GLM-5.1が決して小さなモデルではないと伝えています。報じられている規模は、次の表のとおりです。
| 項目 | 数字 | 意味 |
|---|---|---|
| 総パラメータ数 | 約7,540億 | モデルが持つ数値の総数 |
| 1トークンごとの活性化 | 400億 | 1トークンを生成するときに使われるパラメータの数 |
| 重みの保持に必要なGPUメモリ | 約380GB | 重みを置いておくだけで必要な量 |
| ユーザーごとの追加メモリ | 6GBから26GB | 会話の文脈を保つための量。精度によって変わる |
パラメータとは、モデルの中にある調整可能な数値のことです。この表から読み取れるのは、重みを置くだけで約380GBが必要なため、GPUを複数台そろえて動かす前提の規模だということです。これは解釈です。
RevolutのローカルLLMコーディング基盤の数字を整理する。コスト、設備、速度
ここまでモデルの規模を説明しました。次に、報じられた数字をまとめて並べます。
| 指標 | 報じられた数字 | 読み方 |
|---|---|---|
| 推論コストの削減 | 約90%(約10分の1) | Revolut自身の数値。クラウド費用、人件費、監視コストを含まない |
| 自社ホストの単価 | 入出力100万トークンあたり0.30ドル | GLM-5.1の場合。CodexやClaude Codeの約10分の1 |
| 設備 | NVIDIA B200を56基 | GLM-5.3を大規模に提供するため。8GPU構成のDGX B200 7台分 |
| 最初のトークンまでの時間 | 約25万6千トークンで3秒未満 | 入力してから出力が始まるまでの待ち時間 |
| 生成速度 | 毎秒約200トークン | 出力が流れる速さ |
| コーディング時間 | 60%の改善 | Revolut自身の数値 |
| リードタイム | 70%の改善 | Revolut自身の数値 |
この表で注意したいのは、0.30ドルはGLM-5.1の自社ホストの単価で、56基のB200はGLM-5.3の提供に使うものだという点です。両者を同じ時点の数字として足したり掛けたりすることはできません。
リードタイムとは、タスクに着手してから、その変更をメインのコードに取り込む(マージする)までの時間を指します。
ここまでRevolutの数字を整理しましたが、「自社の環境で動くLLMを使って、開発の費用を見直したい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、機密データを外に出さないローカルLLMの構築と、開発現場での運用設計が可能です。ただ、モデルを動かすだけでなく、RAGで社内の資料や情報を反映できるため、自社の開発業務に合わせた構成の検討が可能。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
ローカルLLMコーディングを成り立たせた技術。量子化とチューニング
この章では、その数字を支えた技術的な工夫を見ます。ローカルLLMでコーディングを動かすうえで、実装の論点になる部分です。
Abitbol氏は、初期状態の推論性能は「ひどい」ものだったと語ったと報じられています。そこから、同じGPUのままで、最初のトークンが出るまでの時間を約14秒から1.7秒まで縮めたとされています。最大の性能向上は、GPUの増設ではなく、次の4つの調整から得られたと報じられています。
- モデルのハイパーパラメータの調整
- NVFP4量子化への切り替え
- prefillとdecodeの分離
- コンテキスト長の調整
4つの調整の意味
ハイパーパラメータとは、モデルを動かすときに人間が決める設定値のことです。
量子化とは、モデルの数値をより少ない桁数で表現して、メモリと計算の負担を減らす方法です。NVFP4はその方式の一つで、精度を下げて表現するため、性能との兼ね合いを見ながら選びます。
prefillとは、入力された文章やコードを読み込んで処理する段階です。decodeとは、答えをトークンごとに順に生成する段階です。この2つは計算の性質が異なるため、分けてそれぞれに合った構成で動かす方法が分離構成(disaggregated prefill and decode)です。
コンテキスト長とは、モデルが一度に扱える文章の長さです。長いほど、その分メモリを使います。
「長いコンテキストは詐欺」という発言
Abitbol氏は、長いコンテキストを「詐欺だ」と述べ、100万トークンを扱えても実際に必要なのは25万6千トークンだという趣旨を語ったと報じられています。その結果、約25万6千トークンのコンテキストで、最初のトークンまでの時間が3秒未満、生成速度が毎秒約200トークンに達したとされています。
ここからは解釈です。モデルの上限まで使う必要はなく、用途に必要な長さに絞ることが、メモリの節約と速度の改善につながったと考えられます。GPUを買い足す前に、設定、量子化、コンテキスト長を見直す余地があるという示唆です。ただし、Dealroomは、90%の削減が大がかりなチューニングに依存すると伝えています。調整を担う人材や時間が必要になります。
ClaudeやCodexはどうなったか。ローカルLLMコーディングと商用サービスの使い分け
次に、Revolutが商用サービスをどう位置づけているのかを整理します。報道によると、使い分けは次の表のとおりです。
| 用途 | 担当 |
|---|---|
| 通常のコーディング | 自社ホストのGLM(既定) |
| 画像に関するタスク | Gemini |
| 最も難しい作業 | Claude CodeとCodex(例外として残す) |
この表から読み取れるのは、自社ホストを既定にしつつ、難しい作業だけは商用サービスに任せる設計だということです。
Claude Code料金とCodex料金との比較
報道では、GLM-5.1の自社ホストが、OpenAIのCodexやAnthropicのClaude Codeの約10分の1のコストだったと伝えられています。Claude Code料金やCodex料金の具体的な料金表は報道の範囲に含まれていないため、本記事では比率だけを扱います。
最大の効果は、コーディング以外にあった
Abitbol氏は、最大の効果はコーディング自体ではなく、デバッグや、JiraやConfluenceのチケットの処理をAIに任せたことから得られたと語ったと報じられています。Jiraは課題やタスクを管理するツール、Confluenceは文書を共有するツールです。
ここからは解釈です。効果は不具合の調査やチケットの処理のような、開発の周辺業務にあったと読み取れます。費用を試算するときも、コードの生成量だけで見積もると、実際の使われ方とずれる可能性があります。
RevolutのローカルLLMコーディング事例の報道はどこまで確かか。確認できていないことの整理
ここで一度立ち止まり、報じられた内容の確かさを整理します。
| 区分 | 内容 | 状態 |
|---|---|---|
| 報道で確認 | 約90%の推論コスト削減、約2,000人への展開、GLM-5.1からGLM-5.3への移行、0.30ドルの単価、B200 56基 | Revolut自身の発言として報道 |
| 条件つき | 約90%の削減 | クラウド費用、人件費、監視コストを含まず、大がかりなチューニングに依存 |
| 条件つき | コーディング時間60%、リードタイム70%の改善 | モデルの変更と、トークン制限の撤廃などを切り分けていない |
| 未確認 | Revolutの公式発表、講演の録画や原稿 | 資料になし |
この表から分かるのは、数字の多くがRevolut自身の発言を報じたもので、第三者が検証したものではないという点です。
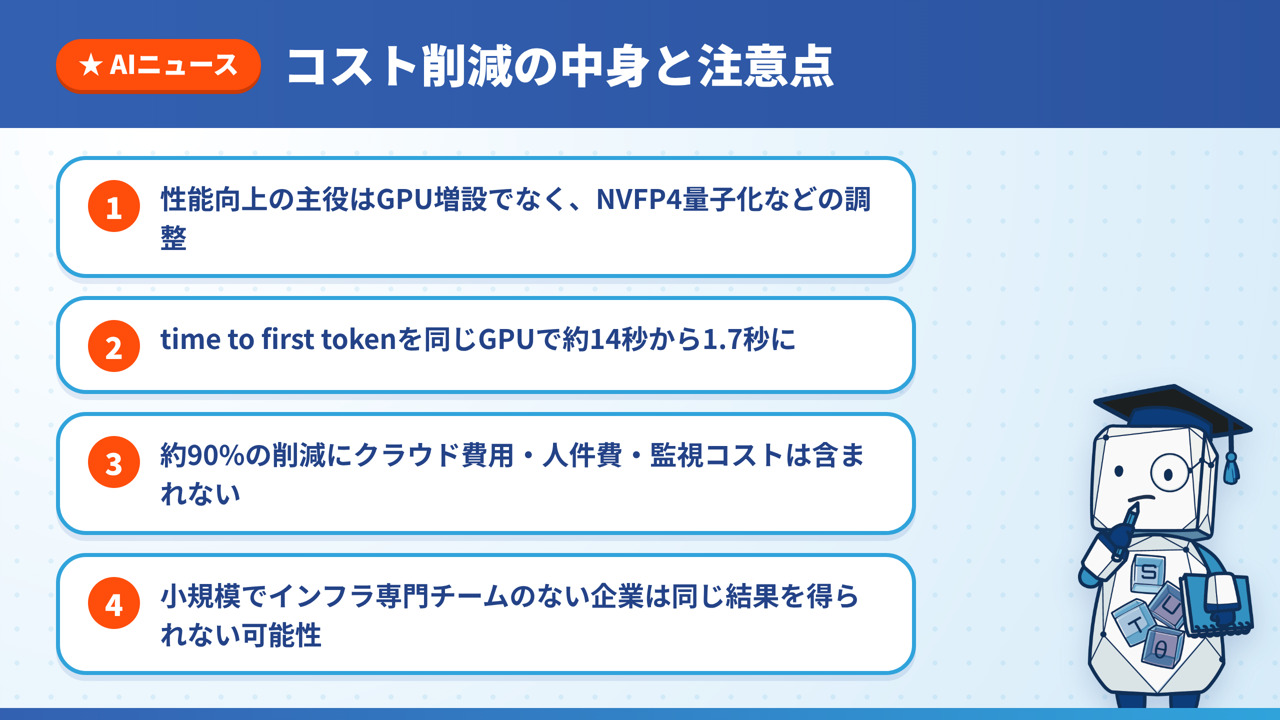
図解:性能向上の要因、コスト削減に含まれない費用、小規模企業への注意を整理した図です。
数字の読み違いを避ける
次のような読み方は、報道の内容と合いません。
- 「自社ホストなら総費用が9割下がる」:約90%には、クラウド費用、人件費、監視コストが含まれていません。
- 「オープンウェイトのモデルなら商用サービスは不要になる」:Revolutでも、最難関の作業にはClaude CodeとCodexが残っています。
- 「コーディング時間60%短縮はモデルだけの効果」:トークン制限の撤廃など、他の要因と切り分けられていません。
まだ確認できていないこと
- 削減額そのもの(年間いくらからいくらになったか)
- 60%と70%の改善率の測定方法、計測期間、対象範囲
- 「1年足らず」の具体的な開始時点と終了時点、カンファレンスの正確な開催日
- GPUの調達形態(購入かクラウドか)と、米国のデータセンターの所在や運用体制
- 規制当局への説明や承認の有無、データの取り扱いに関する具体的な統制
- Anthropic、OpenAI、Z.ai、Googleなど、各社のコメントや反応
ローカルLLMコーディングは日本企業に当てはまるか。規模、規制、中国製モデルへの見方
ここからは、報道を踏まえた解釈です。事実として確認できているのは、英国の1社が、自社の環境で大きなコスト削減を報告したという点までです。
規模とインフラ専門チームの有無
Dealroomは、Revolutの規模やインフラ専門チームを持たない小規模企業は、同じ結果を得られない可能性があると伝えています。Revolutは、約2,000人にツールを展開し、B200を56基導入し、量子化やチューニングを重ねています。この前提を置かずに「9割削減」だけを持ち帰ると、期待と結果にずれが出ると考えられます。
規制のある業種と、中国製モデルへの見方
Abitbol氏は、規制下にある銀行が中国製のオープンソースモデルを使うことへの「スティグマ(世間的な抵抗感)」を認めたと報じられています。Revolutは、オープンウェイトだけを利用し、米国の自社インフラで動かし、Z.aiのホスティングサービスは使っていません。コーディングエージェントは、承認ルールのついたサンドボックスで動かし、人間が介在すると報じられています。サンドボックスとは、AIの動作を隔離された環境に閉じ込め、外部に影響が及ばないようにする仕組みです。
日本でも、金融や医療のように規制の強い業種では、モデルの開発元の国や、データの置き場所が、社内の承認で問われる可能性があります。Revolutの構成は一つの参考になりますが、規制当局への説明の有無は確認できていません。自社の規制や社内ルールに照らした確認は、別に必要です。
自社で検討するときの確認項目
次の手順は、報道をもとにした解釈です。順番に確認すると、自社ホストを検討する前の準備になります。
- 現在のAIコーディングの利用額を、人ごとに把握します。Revolutでは、月1,000ドルから10,000ドルを使う人がいる一方で、ROIが乏しいと語られていました。
- トークンの制限で、使い控えが起きていないかを確認します。
- 自社ホストの試算には、クラウド費用、人件費、監視コストを入れます。報じられた約90%には、これらが含まれていません。
- モデルを置く場所と、開発元のサービスを経由するかどうかを決めます。
- 小さく試し、最初のトークンまでの時間と生成速度を測ります。Revolutでは、初期状態は「ひどい」と語られていました。
- 最も難しい作業に商用サービスを残すかを決めます。
- AIの動作を、承認ルールのついたサンドボックスで動かし、人の確認を入れます。
まとめ
本記事の要点は、次の4つです。
- Revolutは、自社ホストモデルを既定にして、AIコーディングの推論コストを1年足らずで約90%削減したと報じられています。自社ホストのGLM-5.1は、入出力100万トークンあたり0.30ドルで、CodexやClaude Codeの約10分の1のコストでした。
- 最大の性能向上は、GPUの増設ではなく、量子化、prefillとdecodeの分離、コンテキスト長の調整などから得られたと報じられています。
- 約90%の削減には、クラウド費用、人件費、監視コストが含まれていません。60%と70%の改善も、他の要因と切り分けられていません。公式の一次資料は確認できていません。
- 日本企業が検討するときは、規模、規制、モデルの開発元への見方、人の関与を確認してから判断するのが現実的です(解釈)。
ローカルLLMでのAIコーディング基盤の相談は「リベルクラフト」
自社でモデルを動かす選択肢は魅力的ですが、設備、調整、運用の負担まで含めて、自社に合うかどうかの判断に迷う場面が多いものです。
リベルクラフトでは、AI開発の要件定義から、ローカルLLMを含む社内AI環境の構築、社内文書を参照して回答するRAGの仕組みづくりまでを一貫して支援しています。
- AIコーディングの費用と、自社ホストの費用を、同じ前提で比べたい
- ソースコードや機密情報を、社外に出さない環境でAIに扱わせたい
- ローカルLLMの構築と運用を、相談しながら進めたい
という方は、リベルクラフトへお気軽にご相談ください。
⇨リベルクラフトへの無料相談はこちら
AI・データの実務スキルを、ご自身で身につけたい方には、現場を知る講師のフィードバックを受けながら学べる Craft College もあります。
⇨Craft Collegeの詳細はこちら
参考情報
本記事は、次の報道記事の内容をもとに、まとめています。
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。