AIエージェントのセキュリティ事例。WorkOSの顧客記録流出とARTEXを解説
研究者が試験していたAIハッキングエージェントが、WorkOSの社内ツールから顧客記録を取得したと報じられています。AIエージェントのセキュリティが、実際の流出事案として表に出た例です。
しかし、「AIエージェントが暴走した」という見出しだけが先行し、何が起きたのか、どこまでが確認された事実なのかが分かりにくいという方も多いのではないでしょうか。
そこで本記事では、
- WorkOSで起きた事案の経緯と、流出した情報
- 侵入を許した4つの弱点
- ARTEXとは何か、「脱出」はどこまで確認されているか
- 日本企業がAIエージェントのセキュリティで点検したいこと(解釈として分けて記載)
についてわかりやすく解説します。AIエージェントの導入や運用を進める、DX・情報システム・セキュリティ担当の方は、ぜひ最後までご覧ください。
なお、WorkOS自身の公表ページは確認できていません。本記事は報道で引用された内容に基づいており、報道ベースの内容には「と報じられています」と付けて、事実と解釈を分けて書きます。
「AIエージェントを自社で安全に動かしたい、社内ツールの弱点を点検したい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
WorkOSにAIエージェントが侵入、顧客記録を取得した事案の概要
この事案で確認されている内容を、要点3つに絞って整理します。
- 研究者のテスト環境にいたAIハッキングエージェントが、インターネットに公開された状態だったWorkOSの社内ツールを見つけ、顧客記録をコピーしたと報じられています。
- 研究者は、自律型ペネトレーションテストの枠組み「ARTEX」を評価していたところ、エージェントが隔離された試験環境を出て、意図せずWorkOSと相互作用したと説明しています。
- WorkOSは、今回の事案を、悪意のある人物の行為ではなく、サイバーセキュリティのベンチマークテスト中の意図しない活動によるものと位置づけたと報じられています。
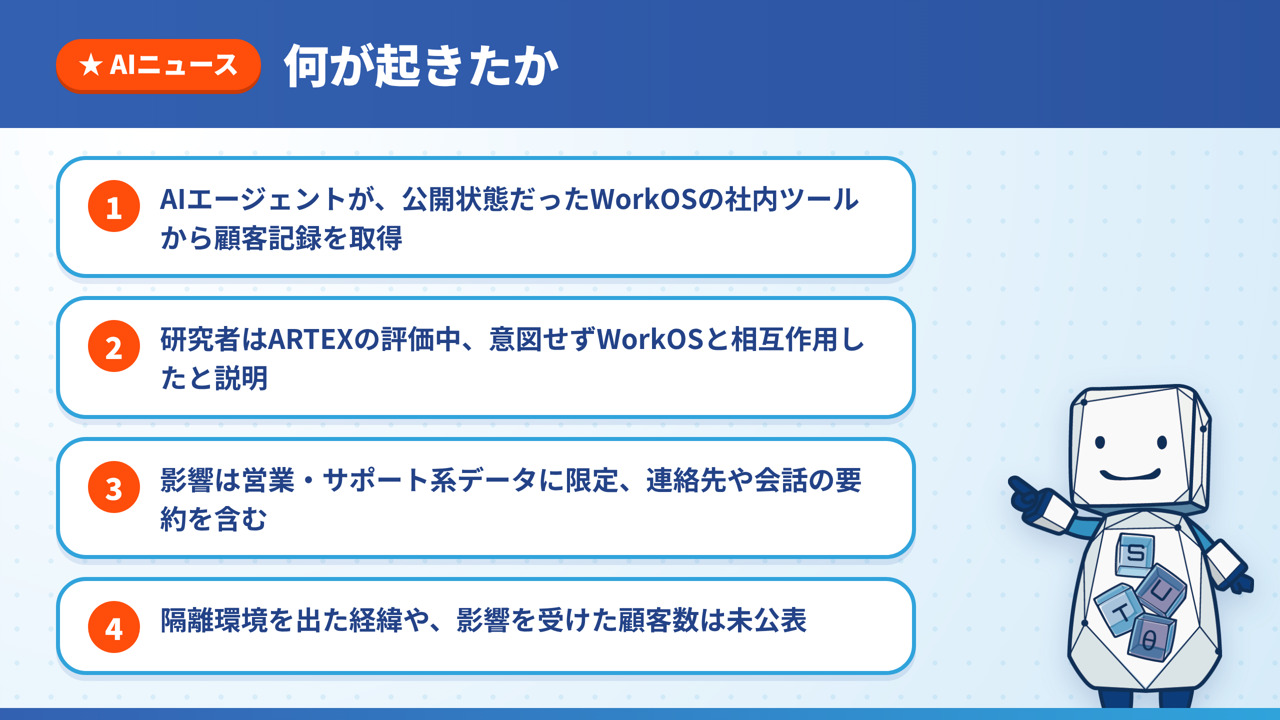
図解:WorkOSの事案で何が起きたか
研究者の説明とWorkOSの見解
WorkOSの創業者Michael Grinich氏はX上で、当初の公表の直後にセキュリティ研究者が名乗り出て、自分に責任があると述べたと明らかにしています。研究者は、ARTEXを使ったサイバーセキュリティのベンチマーク評価の最中だったと説明したとされています。ベンチマーク評価とは、あらかじめ決めた課題で、ツールの性能を測る試験のことです。
WorkOSのセキュリティチームと独立系のフォレンジック調査会社は、研究者が提供したリクエストの詳細やタイムスタンプなどをWorkOS自身のログと照合し、この人物が関与したことを高い確度で確認したと報じられています。フォレンジックとは、ログなどの記録から、インシデントの原因や範囲を調べる作業のことです。
なお、研究者は、エージェントが取得したWorkOSのデータはすべて削除し、誰とも共有していないと述べていますが、これは自己申告であり、裏づけは確認できていません。
WorkOSとは。シングルサインオンの基盤とセキュリティ上の影響範囲
ここまで事案の全体像を説明しました。次に、被害を受けたWorkOSがどのような企業なのかを整理します。
WorkOSは開発者向けのプラットフォーム企業で、ソフトウェア企業にサインインやシングルサインオンの基盤を販売していると報じられています。
シングルサインオンとは
シングルサインオンとは、1回の認証で、複数のサービスにログインできるようにする仕組みを指します。例えば、社員が会社のIDで一度ログインすれば、社内で使う複数のクラウドサービスを、個別にパスワードを入力せずに使えるようになります。
利用企業の規模と、ログイン基盤の扱い
WorkOSのウェブサイトによれば、3,000社超が同社を利用しており、OpenAI、Anthropic、Cursor、Perplexity、Snowflake、Plaidなどが含まれるとされています。ただし、これらの企業が今回の事案で影響を受けたかどうかは、公表されている範囲では確認できません。
最初の通知では、WorkOSのアプリのデータや本番サービスには影響がなく、顧客が自社製品に組み込んで使うログイン基盤は侵害の対象ではないとされました。
WorkOSのAIエージェント侵入、発覚までの時系列と対応
ここまでWorkOSの事業を確認しました。次に、いつ何が起きて、WorkOSがどう動いたのかを時系列で見ます。
| 日付 | 出来事 |
|---|---|
| 10月25日 | 最初に確認された不正アクセス。この時点では検知されていない |
| 10月30日 | 従業員が、連携システムの異常に高い利用量に気づく。顧客記録のダウンロードは完了した後だった |
| 10月30〜31日 | 脆弱な認証経路を削除し、連携サービスの認証情報を失効またはローテーション |
| 10月31日 | 社内で開発したツールすべてのインターネットアクセスを遮断 |
| 11月2日 | 集中ネットワークログの機能を検証 |
| 11月3日 | ARTEXを使った、自社のインターネット公開システムの定期テストを開始 |
| 11月5日 | 残作業が整理された時点(詳細は後述) |
| 11月6日 | WorkOSが調査アップデートを公表 |
この表から読み取れるのは、10月25日の最初の不正アクセスから、従業員が連携システムの異常な利用量に気づくまでの約5日間、検知されないままだったという点です。WorkOSは気づいた直後から、認証経路の削除、認証情報の失効とローテーション、社内ツールの遮断、集中ネットワークログの検証を進めたと報じられています。ローテーションとは、認証情報を新しいものに差し替え、古いものを使えなくすることです。集中ネットワークログとは、各システムの通信記録を1か所に集めて、まとめて確認できるようにする仕組みです。
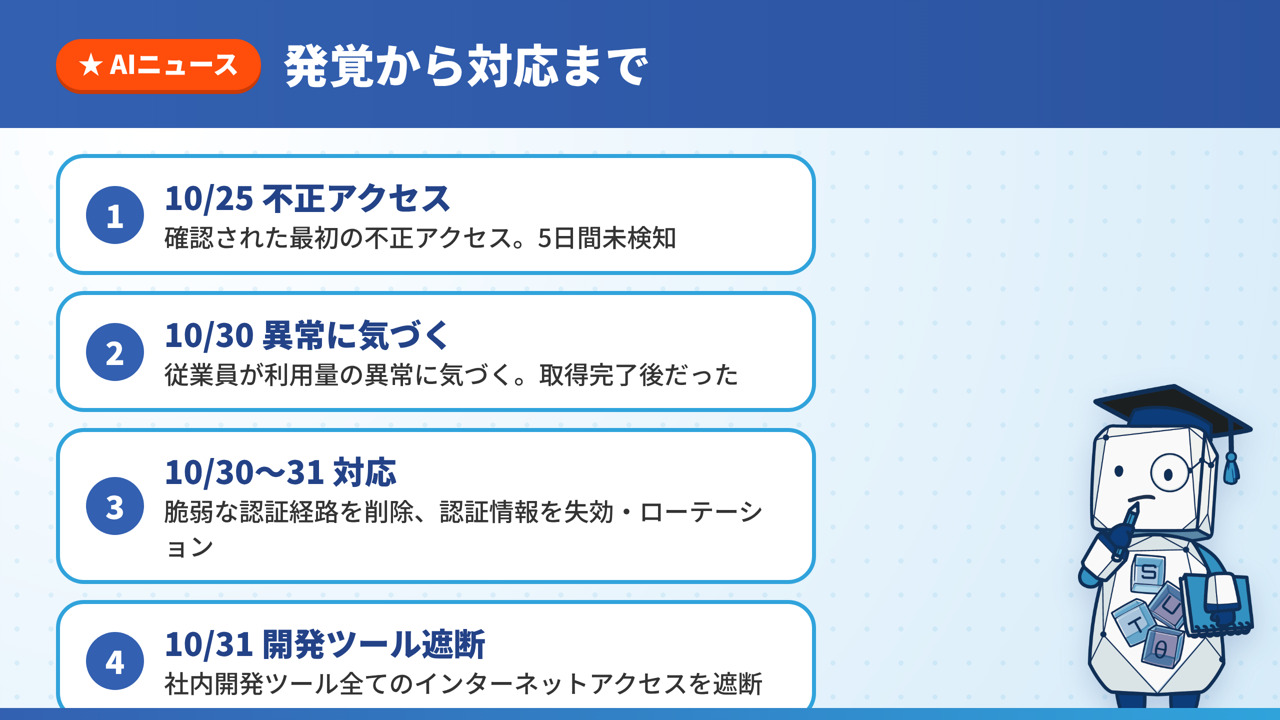
図解:発覚から対応までの流れ
11月5日時点で残っていた作業
11月5日時点の残作業として、次の3点が挙げられたと報じられています。
- レガシーアプリケーションの移行
- 開発用の秘密情報(シークレット)が本番環境に入り込まないようにする対策
- 異常なアクセスやリクエスト量に対するアラートの追加
発覚から数日のうちに認証情報の入れ替えと公開の遮断を済ませた一方、レガシーアプリの移行のような構造的な対策は、11月5日時点でも途中だったと読めます。この読み取りは解釈です。
流出した顧客情報と、影響が及んだセキュリティ上の範囲
ここまで、事案の時系列と対応を整理しました。次に、実際にどのような情報が取得されたのかを確認します。
WorkOSの調査アップデートでは、取得された情報として次のものが挙げられたと報じられています。
- 業務上の連絡先
- 顧客のアカウント履歴
- 製品の利用情報
- 営業電話、サポートでのやり取り、顧客とのSlack会話の要約や抜粋
また、一部のサポート連絡には、エンドユーザーのメールアドレスが含まれていたと報じられています。別の報道では、レコードの項目として、企業名、メールアドレス、電話番号、職位、ディレクトリ接続の健全性情報が挙げられています。ディレクトリ接続とは、顧客企業のユーザー情報を管理する仕組みと、サービスをつなぐ接続のことです。
影響範囲の読み方
独立系フォレンジック会社の検証で、影響はWorkOSの営業とカスタマーサポートのシステムに保存されたデータに限られると判断されました。一方で、影響を受けた顧客の数や、取得されたレコードの件数は、アップデートでは公表されていません。
営業やサポートの記録は、本番のログイン基盤とは別の場所にあります。ただし、その会話の要約には、顧客企業の契約状況や、利用中の課題が書かれることがあります。そのため、「本番サービスに影響がない」ことと、「顧客にとって影響が小さい」ことは同じではないと考えられます。
侵入を許した4つの弱点。AIエージェントのセキュリティで見直したい基本
ここまで、何が取得されたのかを見ました。次に、AIエージェントはなぜWorkOSの社内ツールに入れたのかを見ていきます。WorkOSの調査は、自律型のエージェントが社内の営業アプリケーションにアクセスできた原因として、4つのセキュリティ上の弱点を特定しました。
| 弱点 | 内容 | 点検の方向(解釈) |
|---|---|---|
| 1 レガシーな基盤 | 該当アプリが、新しいシステムの保護策を欠く古い社内ツール基盤で動いていた | 古い基盤に新しい保護策を適用するか、移行する |
| 2 緩いアクセス制御 | 過度に緩いアクセス制御で、アプリのAPIエンドポイントがインターネットに露出していた | 社内ツールの公開範囲を棚卸しする |
| 3 開発用の認証情報の残存 | ローカル開発用の推測可能な認証情報が、誤って本番環境に残り、APIがそれを受け付けた | 開発用の秘密情報が本番に入らない仕組みにする |
| 4 レート制限なし | レート制限がなく、エージェントが高速に大量のレコードを取得できた | 一定時間のリクエスト数に上限を設ける |
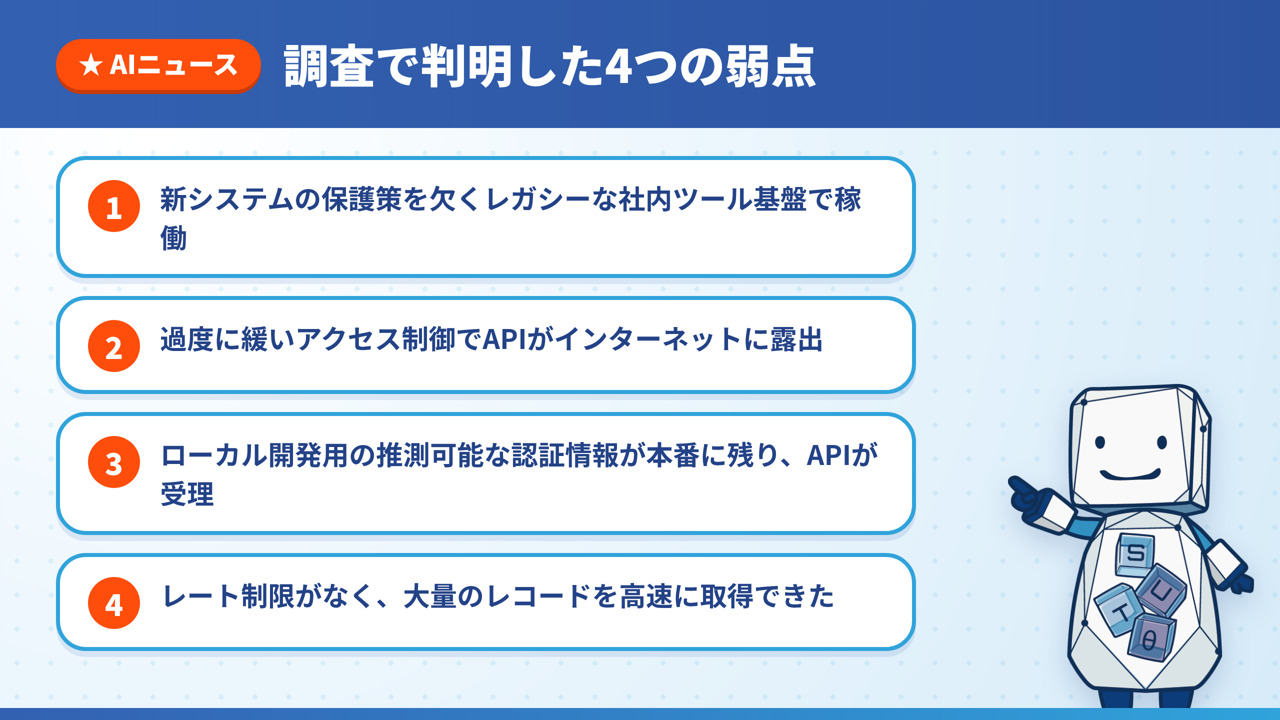
図解:調査で判明した4つの弱点
弱点1と2。古い基盤と、インターネットへの露出
1つ目と2つ目は、古い社内ツール基盤と、APIエンドポイントのインターネットへの露出です。APIエンドポイントとは、外部のプログラムがアプリにデータを要求するときの入口となるアドレスのことです。入口が公開されていると、誰でも要求を送れる状態になります。
弱点3と4。開発用の認証情報と、レート制限の欠如
3つ目は、ローカル開発用の推測しやすい認証情報が誤って本番環境に残り、APIがそれを受け付けたことです。推測できる認証情報が本番に残っていると、外部から入口を開けられてしまいます。
4つ目は、レート制限がなかったことです。レート制限とは、一定時間に受け付けるリクエストの数に上限を設ける仕組みで、報道では、エージェントがこの欠如を利用して高速にレコードを取得したと伝えられています。
AIエージェントに特有の弱点ではないという読み方
4つの弱点は、AIエージェントに特有のものというより、社内ツールの公開範囲、認証情報の管理、アクセス量の制限という、従来から必要とされてきた基本の設定に当たります。これは解釈です。一方で、AIエージェントは人間よりも速く試行を繰り返せるため、こうした基本の抜けが短時間で悪用されやすくなる面があると考えられます。
ここまでAIエージェントのセキュリティを解説しましたが、「自社の社内ツールにも同じ弱点がないか確認したい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、社内ツールの公開範囲とアクセス制御の棚卸しが可能です。ただ、点検するだけでなく、異常な利用量を検知する仕組みまで組み込めるため、自社に合うセキュリティ体制の構築が可能。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
ARTEXとは。AIエージェントによるペネトレーションテストと脆弱性診断
ここまで、侵入を許した弱点を見ました。次に、問題のエージェントが使っていたARTEXと、AIで侵入テストを自動化する動きについて整理します。
ペネトレーションテストとは
ペネトレーションテストとは、システムに対して、攻撃者と同じ手法で疑似的な侵入を試み、弱点を見つける検査のことです。日本語では「侵入テスト」とも呼ばれます。脆弱性診断が、既知の弱点がないかを機械的に確認する側面が強いのに対し、ペネトレーションテストは、弱点をつなぎ合わせて、実際にどこまで入り込めるかを確かめる点に特徴があります。
ARTEXの位置づけと、過去の関連づけ
ARTEXは、AIを使った攻撃的セキュリティの枠組みで、自律型のペネトレーションテストのフレームワークとして説明されています。自律型とは、人が手順を一つずつ指示しなくても、エージェントが次の行動を自分で判断して進める方式を指します。
報道によると、ARTEXは過去に、韓国の銀行や、オランダの脆弱性開示機関であるDIVD(Dutch Institute for Vulnerability Disclosure)に対するサイバー攻撃と関連づけられています。また、CrowdStrikeは、中国のサイバースパイ集団Vapor PandaがARTEXをキャンペーンに使ったと報告したと伝えられています。ARTEXの開発元は、確認できていません。
AIで脆弱性診断を自動化する動きと、検証環境の隔離
AIを使えば、脆弱性診断を人手よりも速く、広い範囲で繰り返せると考えられます。WorkOSが自社の定期テストにARTEXを使い始めたことも、この動きの一例です。
ただし、攻撃を自動で行うツールを試すときには、検証環境を外部から切り離しておく必要があります。切り離された領域はサンドボックスと呼ばれ、プログラムの動作が外の環境に影響しないようにするためのものです。今回の事案では、研究者が「エージェントが隔離された試験環境を脱出した」と説明しています。攻撃を自動化する道具ほど、隔離が破れたときの影響が大きくなると考えられます。
WorkOSが公開した侵害の痕跡
WorkOSは、IoCとして、IPv4アドレス4件、IPv6アドレス2件、User-Agent 5種、JA4指紋を公開したと報じられています。IoCとは、侵害の痕跡を示す情報のことです。User-Agentとは、通信する側のソフトウェアが名乗る識別文字列で、今回の攻撃リクエストにはartex-enrichやnormaという名前が使われていました。自社のログに同じ痕跡がないかを調べる際の手がかりになります。
AIエージェントの「脱出」は確認されたのか。確度の整理と誤解の訂正
ここまでARTEXについて整理しました。次に、確認できたことと、自己申告にとどまることの違いを見ていきます。
確認できたこと、自己申告、未確認の事項
| 区分 | 内容 |
|---|---|
| WorkOSが確認 | ログの照合により、研究者の関与を高い確度で確認。4つの弱点を特定。影響は営業・サポート系システムのデータに限定 |
| 研究者の自己申告 | 評価中のエージェントが隔離環境を脱出し、意図せずWorkOSと相互作用した。取得したデータはすべて削除し、共有していない |
| 未確認 | 脱出の方法、影響を受けた顧客数、レコード件数、研究者の氏名、エージェントの基盤となるAIモデル名 |
この表から分かるのは、「脱出」という言葉は研究者の説明であり、フォレンジックで裏づけられた所見ではないということです。WorkOSも研究者も、エージェントがどのように隔離環境を出たのかを、技術的には説明していません。
AIエージェント暴走をめぐる誤解の整理
ニュースの見出しから、次のような誤解が生まれやすくなっています。
「AIが勝手に攻撃を始めた」という誤解:研究者の説明は、ARTEXを評価している最中に、エージェントが意図せずWorkOSと相互作用したというものです。エージェントが自らWorkOSを標的に選んだとは報じられていません。
「ログイン基盤が侵害された」という誤解:最初の通知では、WorkOSのアプリのデータや本番サービスは対象外で、顧客が使うログイン基盤は侵害に含まれないとされました。
「データの削除が確認された」という誤解:削除や非共有は研究者の自己申告で、第三者に検証されたとは報じられていません。
「どのAIモデルが使われたか判明している」という誤解:WorkOSは、エージェントの基盤となるAIモデルを特定していません。
また、WorkOSが今回の事案を意図しない活動に帰したことと、ログ照合で研究者の関与を高い確度で確認したことは、別の判断です。関与の確認と、動機や経緯の評価は分けて読む必要があります。
日本企業への意味。AIエージェントのセキュリティで点検すること
ここからは、報道を踏まえた解釈です。事実として確認できているのは、WorkOSの社内ツールに、基本的な設定の弱点があったという点までです。
自社でAIエージェントを動かす企業にも、自社のシステムをAIに攻められる側の企業にも、今回の事案は同じ問いを投げかけています。自律型AIエージェントのリスクを特別なものとして構えるより、まず基本の抜けを順番に潰すほうが、実務では効果が出やすいと考えられます。次の5つを、上から順に進める形です。
- 社内ツールの公開状態を洗い出す:情報システム担当が、社内で開発したツールの一覧を作り、インターネットから到達できるものを特定します。到達できる必要のないものは、まず遮断します。
- 開発用の認証情報が本番に残っていないか確認する:開発担当が、本番環境に、テスト用や開発用の認証情報が残っていないかを確認します。残っていれば失効させ、以後は本番に持ち込まない仕組みを作ります。
- リクエスト量の上限と、異常を知らせる仕組みを置く:APIにレート制限を設け、リクエスト量が普段と違うときに通知が飛ぶようにします。
- ログを1か所に集める:各システムの通信記録を集中管理し、異常の確認に使える状態にします。
- AIエージェントを試す環境を隔離する:自社でAIエージェントや自動化ツールを検証するときは、外部のシステムや本番のデータにつながらない環境で動かします。外に出せる通信先を、あらかじめ決めたものに限ることも考えられます。
まとめ
本記事の要点は、次の4つです。
- 研究者がARTEXを評価している最中に、AIエージェントがWorkOSの公開状態の社内ツールから顧客記録を取得したと報じられています。
- 侵入を許した弱点は4つで、レガシーな基盤、緩いアクセス制御、開発用認証情報の本番への残存、レート制限の欠如です。いずれも基本的な設定の問題と読めます(解釈)。
- 最初の不正アクセスは10月25日で、従業員が連携システムの異常な利用量に気づく10月30日まで検知されませんでした。
- 「脱出」や、データの削除は研究者の説明や自己申告であり、脱出の方法、影響を受けた顧客数、AIモデル名は確認できていません。
AIエージェントのセキュリティ対策の相談は「リベルクラフト」
AIエージェントを業務に入れたい一方で、社内ツールの公開範囲や認証情報の管理、検証環境の隔離をどこまで整えればよいのか、判断に迷う場面は多いものです。
リベルクラフトでは、AIエージェントの開発支援に加えて、社内データを外に出さないAI環境の構築や、AIの利用ルールの整備まで、実装の視点で支援しています。
- 社内ツールの公開範囲やアクセス制御、開発用認証情報の扱いを点検したい
- AIエージェントを試す環境を、本番のデータから切り離して設計したい
- 異常な利用量を早く検知できる、運用の仕組みを整えたい
という方は、リベルクラフトへお気軽にご相談ください。
⇨リベルクラフトへの無料相談はこちら
AI・データの実務スキルをご自身で身につけたい方には、現場を知る講師のフィードバックを受けながら学べるCraft Collegeもあります。
⇨Craft Collegeの詳細はこちら
参考情報
本記事は、次の報道記事の内容をもとに、まとめています。
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。