gpt-ossとは。20bと120bの選び方、動かし方とライセンスの注意点を解説
gpt-ossを手元で試してみたいものの、20bと120bのどちらが自分の環境で動くのか、業務で使ってよいのかを決めきれずにいる方も多いでしょう。
実際、日本語の解説記事を読み比べると、20bの必要メモリを「16GB」とする記事と「32GBは要る」とする記事があり、VRAMとPCのメモリの話も混ざっています。
そこで本記事では、OpenAIのモデルカードとHugging Faceの公式ページを出典に、次の4点を整理します。
- gpt-ossの公式仕様(公開日・パラメータ数・MoE・量子化・コンテキスト長)
- gpt-oss 20bとgpt-oss 120bの選び方と必要メモリ
- Ollama・LM Studio・vLLM・Transformersでの動かし方と、reasoning effortの指定方法
- 業務で使う前に確かめること(データの置き場所・Apache 2.0・事実性)
本記事に載せた実行結果は、すべて実際に動かして得た出力です。環境はApple M1 Pro、Python 3.13.13、huggingface_hub 1.32.0、openai-harmony 0.0.8、transformers 5.17.0、実行日は2026年9月23日です。ディスク容量の都合でモデル本体(20bでも約13.8GB)はダウンロードしておらず、設定ファイルとトークナイザーだけを取得して確かめています。
ローカルLLMの構築や、gpt-ossを社内システムに組み込む進め方で迷っている方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
gpt-ossとは。OpenAIが公開したオープンウェイトモデル
gpt-ossとは、OpenAIが2025年8月5日に公開した、重みを誰でもダウンロードして自分の環境で動かせる言語モデルのシリーズです。推論(考えてから答える)とツール呼び出しに強い設計で、Apache 2.0ライセンスで提供されています(出典:gpt-oss-120b & gpt-oss-20b Model Card)。
公開日と2つのモデル(gpt-oss-120bとgpt-oss-20b)
gpt-ossには、gpt-oss-120bとgpt-oss-20bの2つのサイズがあります。Hugging Faceの公式ページでは、120bを「本番・汎用・高い推論性能向けで、80GBのGPU1枚に収まるモデル」、20bを「低遅延やローカル、特定用途向けのモデル」と位置づけています(出典:openai/gpt-oss-20b|Hugging Face)。
モデルカードの値を並べると次のとおりです。
| 項目 | gpt-oss-120b | gpt-oss-20b |
|---|---|---|
| 総パラメータ数 | 116.83B(約1,170億) | 20.91B(約210億) |
| 1トークンで使うパラメータ数 | 5.13B | 3.61B |
| 層の数 | 36 | 24 |
| エキスパート数(1トークンで使う数) | 128(4) | 32(4) |
| 重みの形式 | MoE部分をMXFP4で量子化 | 同左 |
| チェックポイントの大きさ | 60.8GiB | 12.8GiB |
| 必要メモリの公式の目安 | 80GBのGPU1枚 | 16GB |
| コンテキスト長 | 131,072トークン | 131,072トークン |
この表から読み取れるのは、120bは20bより総パラメータが5倍以上大きいのに、1トークンの処理で動くパラメータは1.4倍ほどしか違わない点です。この差が、次に説明するMoEという構造から来ています。
共通の性質として、入出力はテキストだけで、画像は扱えません。学習データの知識は2024年6月までで止まっています。どちらもモデルカードに明記されている制約です。
オープンソースではなく「オープンウェイト」である意味
OpenAIは、gpt-ossを「open-weight models」、つまりオープンウェイトモデルと呼んでいます。オープンウェイトとは、学習済みの重み(モデル本体のパラメータ)が公開されていて、ダウンロードして動かしたり追加学習したりできる状態を指します。学習に使ったデータや学習用のコードまで公開されているわけではありません。
名前に「oss」と入っているため、オープンソースソフトウェアと同じものと受け取られがちです。業務では「重みを自由に使える」ことと「中身を再現できる」ことを分けて考えてください。オープンソースとオープンウェイトの違いや、モデルごとのライセンスの見方は「オープンソースLLMとは?商用利用の可否とライセンスの見方」で詳しく解説しています。
MoEとMXFP4で、大きなモデルを少ないメモリで動かす
gpt-ossが大きさの割に軽く動くのは、2つの工夫によるものです。
1つ目はMoE(Mixture of Experts)です。MoEとは、モデルの中に「エキスパート」と呼ばれる小さなネットワークを多数並べ、入力ごとに一部だけを使う構造です。gpt-oss-120bは128個、gpt-oss-20bは32個のエキスパートを持ち、どちらも1トークンごとに4個だけを選んで計算します。総パラメータに比べて計算量が小さいのはこのためです。
2つ目はMXFP4という量子化形式です。量子化とは、重みの数値を少ないビット数で表してメモリを減らす手法です。gpt-ossはMoE部分の重みを1パラメータあたり4.25ビットに量子化した状態で公開されています。MoE部分は総パラメータの90%以上を占めるため、この量子化で120bが80GBのGPU1枚に、20bが16GBに収まるようになりました(出典:モデルカード 2.1節)。
公式値が実物と一致しているかを、Hugging Faceから設定ファイルだけを取得して確かめました。重み本体はダウンロードしていません。
# gpt-oss の公式設定ファイルとファイルサイズを Hugging Face から確認する(重み本体は落とさない)
import json
from huggingface_hub import hf_hub_download, HfApi

api = HfApi()
for repo in ["openai/gpt-oss-20b", "openai/gpt-oss-120b"]:
    cfg = json.load(open(hf_hub_download(repo, "config.json")))
    info = api.model_info(repo, files_metadata=True)
    st = sum(f.size for f in info.siblings
             if f.rfilename.endswith(".safetensors") and not f.rfilename.startswith("original/"))
    print(repo)
    print("  層の数          :", cfg["num_hidden_layers"])
    print("  エキスパート数  :", cfg["num_local_experts"])
    print("  1トークンで使う :", cfg["num_experts_per_tok"])
    print("  最大コンテキスト:", cfg["max_position_embeddings"])
    print("  量子化          :", cfg["quantization_config"]["quant_method"])
    print("  重みファイル合計: %.1f GB" % (st / 1e9))
openai/gpt-oss-20b
層の数 : 24
エキスパート数 : 32
1トークンで使う : 4
最大コンテキスト: 131072
量子化 : mxfp4
重みファイル合計: 13.8 GB
openai/gpt-oss-120b
層の数 : 36
エキスパート数 : 128
1トークンで使う : 4
最大コンテキスト: 131072
量子化 : mxfp4
重みファイル合計: 65.2 GB層の数・エキスパート数・コンテキスト長はモデルカードと一致しました。重みファイルの合計(13.8GBと65.2GB)も、モデルカードの12.8GiBと60.8GiBをGBに換算した値とほぼ同じです。解説記事でサイズの数字が割れているのは、GiBとGBの単位の違いによるものと考えられます。
gpt-oss 20bとgpt-oss 120bの選び方
ここまででgpt-ossの仕様を整理しました。次に、20bと120bのどちらを選ぶかを、必要メモリと性能の2つの面から見ていきます。
必要メモリは「16GB」と「80GB GPU1枚」が公式の目安
公式の目安は、20bが16GB、120bが80GBのGPU1枚です。OpenAIのCookbookでは、OllamaやLM Studioで動かす場合の目安を、20bが16GB以上、120bが60GB以上の「VRAMまたはユニファイドメモリ」と書いています(出典:How to run gpt-oss locally with Ollama|OpenAI Cookbook)。ユニファイドメモリとは、Apple SiliconのMacのようにCPUとGPUが同じメモリを共有する方式です。
「16GB」を読むときは、次の3点に気をつけてください。
- GPUの種類で変わる:Transformersの手順書によると、MXFP4をそのまま使えるのはNVIDIAのHopper世代以降とRTX 50シリーズです。MXFP4を使わずbfloat16で読み込むと、20bでも約48GBが必要になります(出典:How to run gpt-oss with Transformers|OpenAI Cookbook)
- 16GBは重みが載る目安:長い文書を入れると、文脈を保持するためのメモリが別に増えます。16GBちょうどの環境では、長い入力で余裕がなくなることがあります
- 足りなければCPUに逃がせるが遅い:Ollamaの手順書は、VRAMが足りない場合にCPUへ処理を逃がせるものの、速度は落ちると書いています
モデル規模とVRAMの関係や、GPUの選び方の一般論は「ローカルLLMに必要なスペック早見。モデル規模・VRAM・GPUの選び方」を参照してください。
性能差が大きいのは知識量を問うタスク
では、性能にはどれほどの差があるのでしょうか?モデルカードの評価(推論レベルhigh、ツールなし)では、次のような差が出ています。
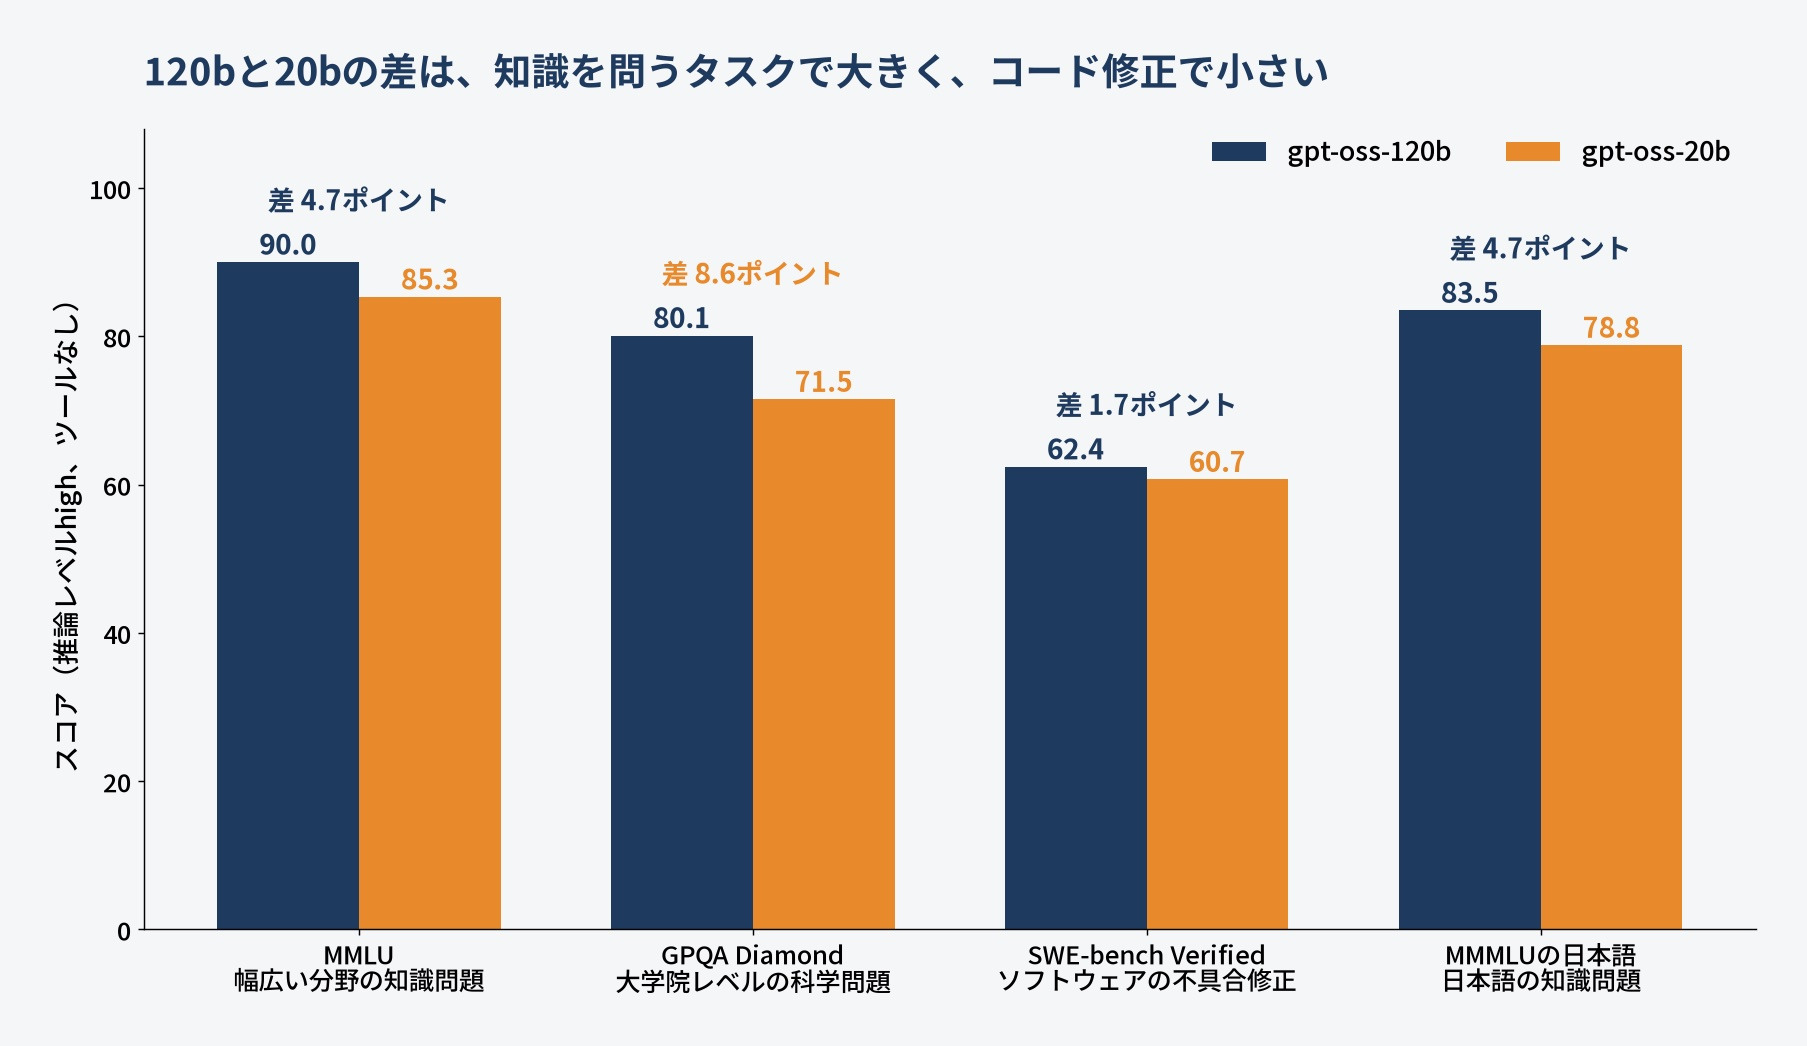
- MMLU(幅広い分野の知識問題):120bが90.0、20bが85.3
- GPQA Diamond(大学院レベルの科学問題):120bが80.1、20bが71.5
- SWE-bench Verified(実際のソフトウェアの不具合修正):120bが62.4、20bが60.7
- MMMLUの日本語(MMLUを人手で翻訳した多言語版):120bが83.5、20bが78.8
コード修正の差は1.7ポイントにとどまる一方、専門知識を問うGPQAでは8.6ポイント開いています。モデルカードも、知識を問うタスクでは20bがサイズの小ささから遅れると説明しています。日本語の質問への回答でも差は約5ポイントあるため、日本語の社内文書を扱う用途では、この差を自社のデータで測る価値があります。
20bと120bのどちらを選ぶか
ここまでの数値を踏まえると、選び方は次のように整理できます。
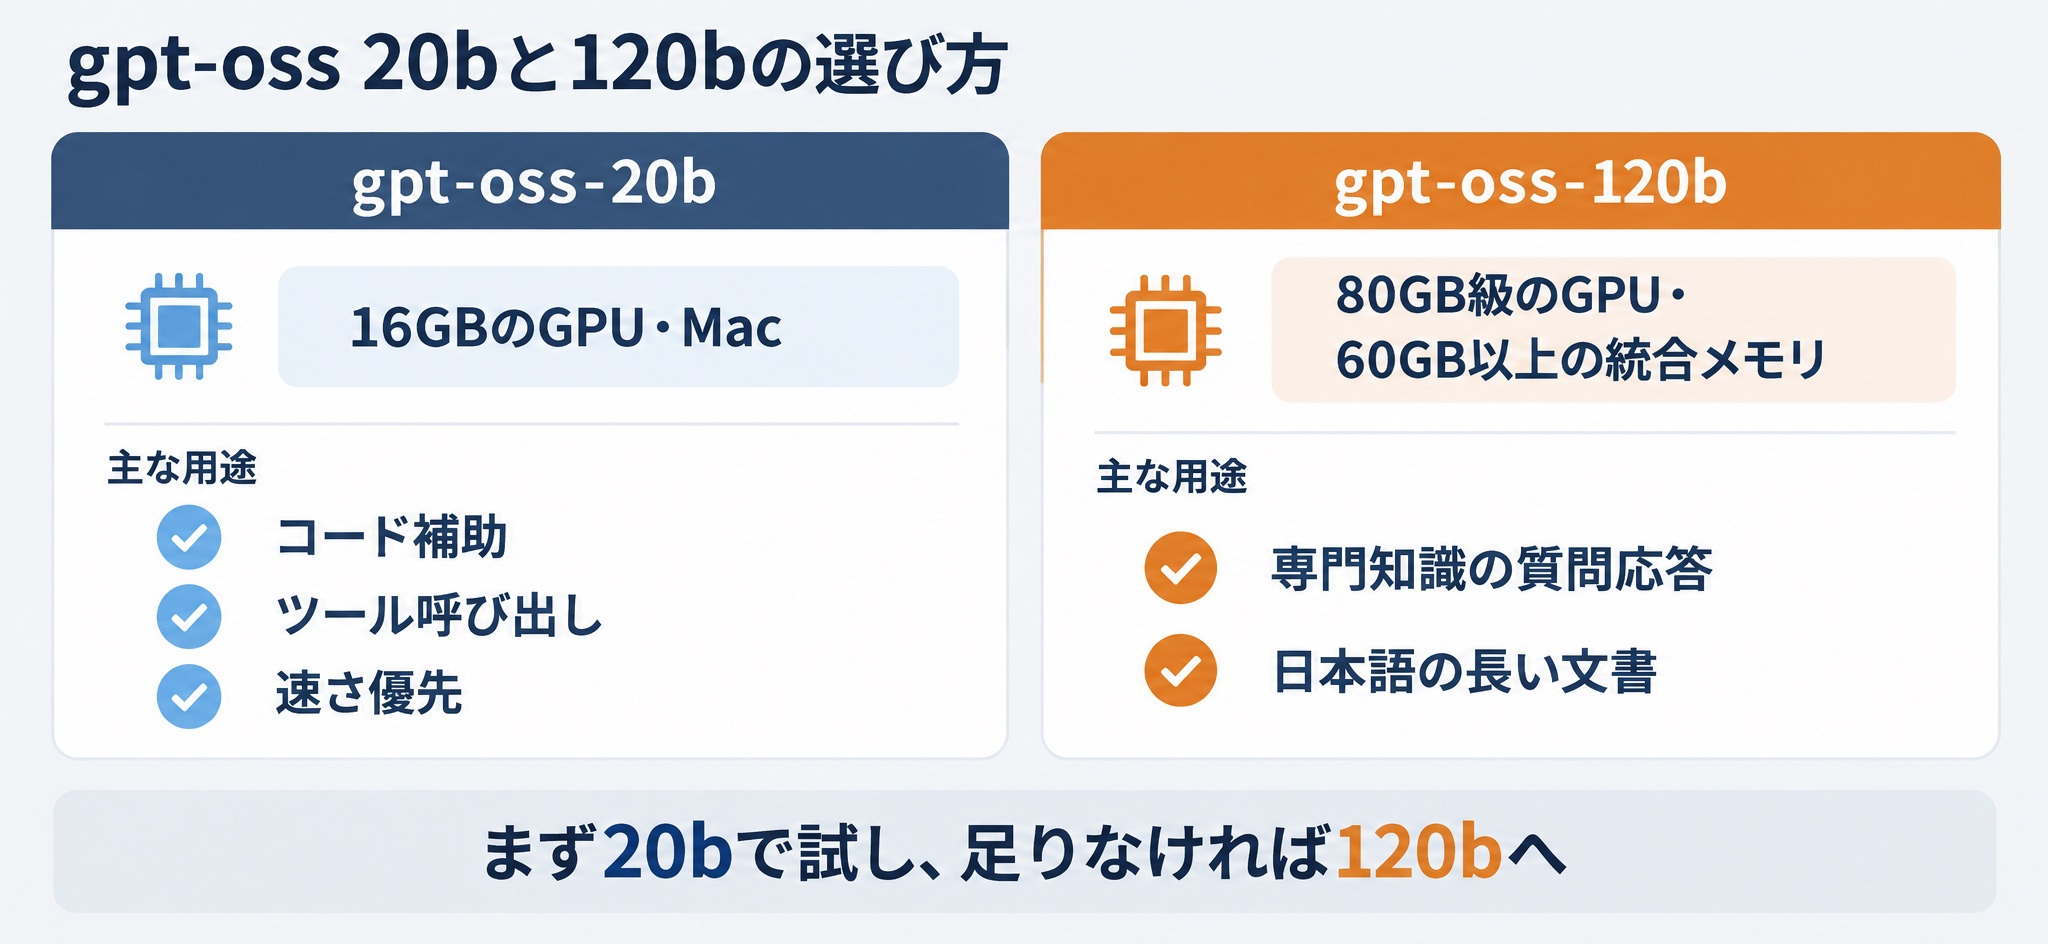
- gpt-oss-20bを選ぶ場面:16GB程度のGPUや、メモリ16GB以上のMacで試したいとき。コード補助やツール呼び出しなど、知識量より手順の正確さが効く用途。応答の速さを優先したいとき
- gpt-oss-120bを選ぶ場面:80GB級のGPU(H100など)や60GB以上の統合メモリを用意できるとき。専門知識を問う質問応答や、日本語の長い文書の読解など、精度の差が業務の成果に直結する用途
迷う場合は、まず20bで自社の評価用の質問を解かせ、足りない箇所が知識量によるものかを確かめてから120bに進むのが無駄のない順序です。
gpt-ossを動かす4つの方法(Ollama・LM Studio・vLLM・Transformers)
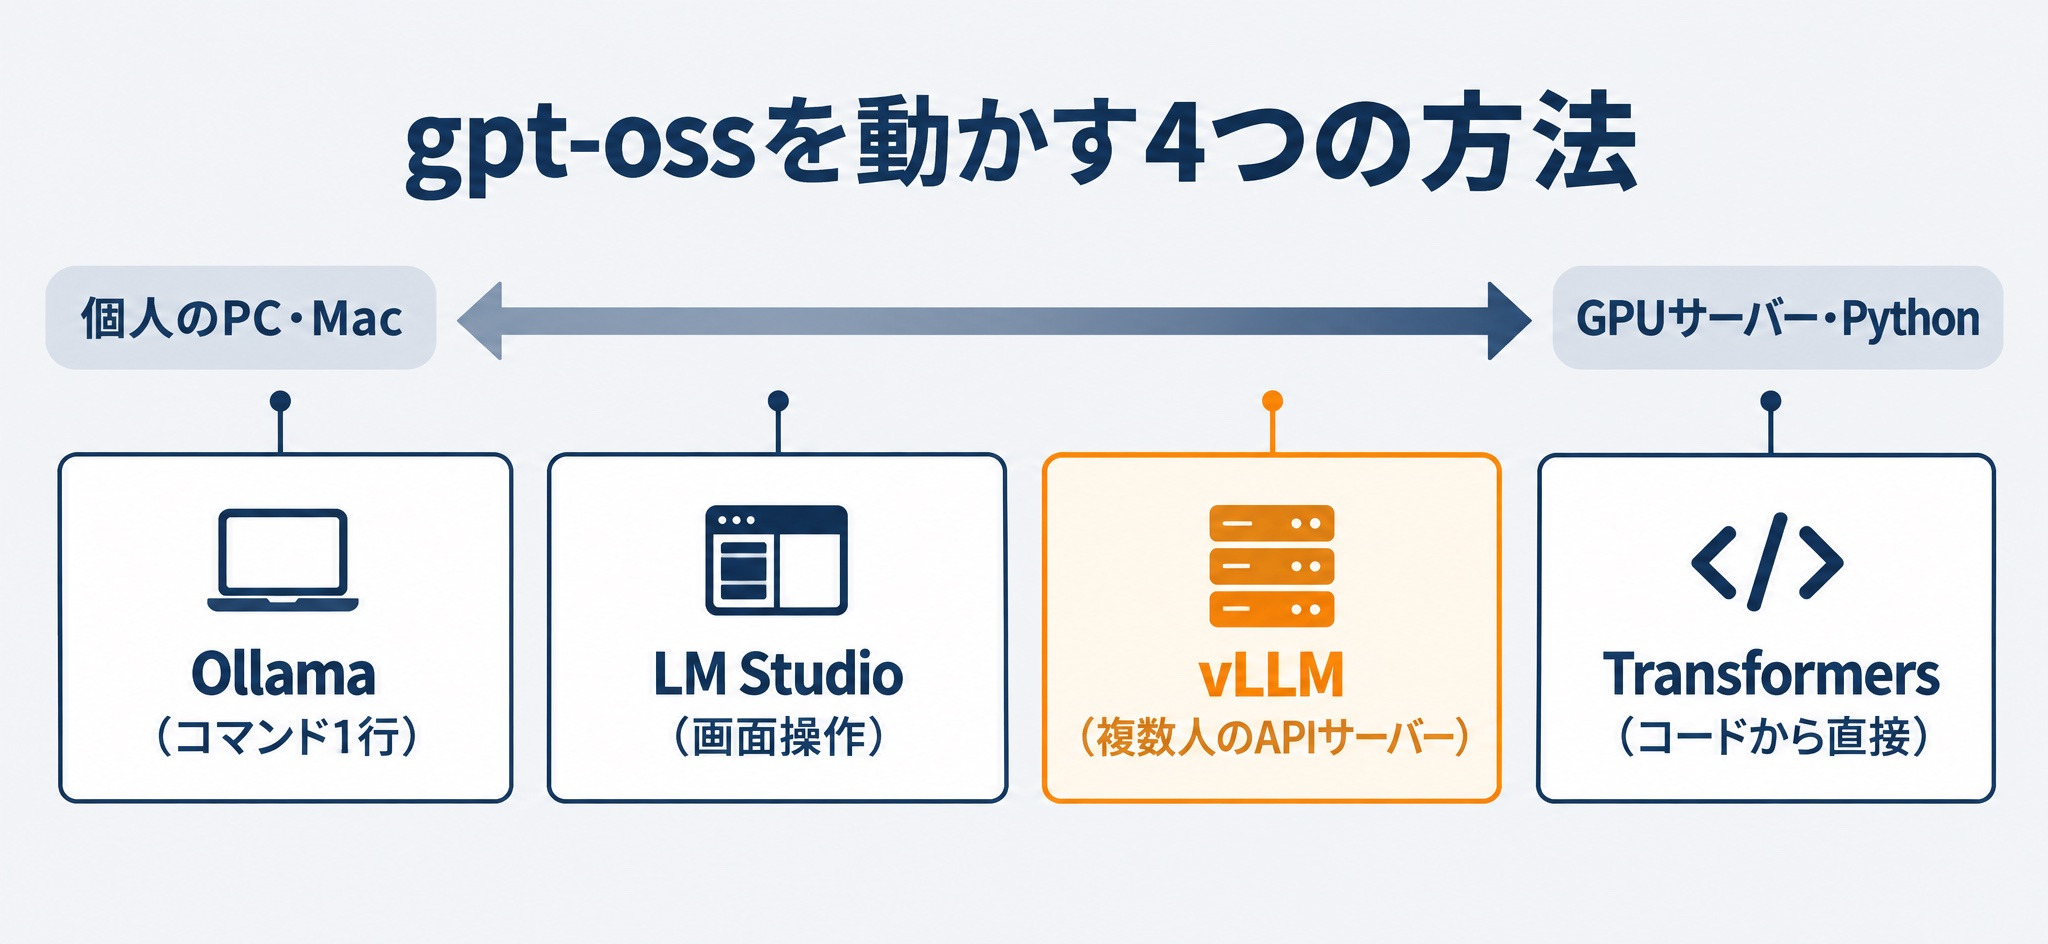
どちらのモデルを使うかが決まったら、次は動かし方です。公式に案内されている主な方法は次の4つで、向いている環境が異なります。
| 方法 | 向いている環境 | 使い方 | OpenAI互換API |
|---|---|---|---|
| Ollama | 個人のPC・Mac | コマンド1行で起動 | あり(11434番ポート) |
| LM Studio | 個人のPC・Mac | 画面操作が中心 | あり(1234番ポート) |
| vLLM | GPUサーバー | 複数人から使うAPIサーバー | あり(8000番ポート) |
| Transformers | Python環境 | コードから直接呼ぶ | transformers serveで提供 |
この表のとおり、個人で試すならOllamaかLM Studio、社内の複数人で使うならvLLM、学習や細かい制御が要るならTransformersが目安です。
以下のコマンドは、Hugging Faceの公式ページとOpenAIのCookbookに載っているものです。本記事ではモデル本体をダウンロードしていないため、出力は載せていません。
1. Ollamaで動かす
Ollamaは、ローカルLLMをコマンド1行で動かせるツールです。インストール後に次のコマンドでモデルを取得して、対話を始めます。
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
120bを使う場合は gpt-oss:120b に置き換えます。Ollamaの公式ページでは、ダウンロードサイズは20bが14GB、120bが65GBと表示されています(出典:gpt-oss|Ollama)。インストール方法や基本コマンドは「Ollamaの使い方。ローカルLLMを自分のPCで動かす手順を解説」で解説しています。
2. LM Studioで動かす
LM Studioは、画面操作でローカルLLMを動かせるデスクトップアプリです。コマンドで取得する場合は次のとおりです。
lms get openai/gpt-oss-20bCookbookによると、LM Studioはllama.cppとApple MLXの2つの推論エンジンを備え、どちらの場合もOpenAIのharmonyライブラリで入力を組み立てています。画面の操作手順は「LM Studioの使い方。GUIでローカルLLMを動かす手順を解説」を参照してください。
3. vLLMでAPIサーバーとして動かす
vLLMは、大量のリクエストを効率よくさばくための推論エンジンです。社内の複数のアプリやメンバーからgpt-ossを呼ぶ場合に向いています。vLLMの公式レシピでは、通常のインストールでgpt-ossに対応しています(出典:GPT-OSS|vLLM Recipes)。
uv pip install vllm --torch-backend=auto
vllm serve openai/gpt-oss-20b
起動すると8000番ポートでOpenAI互換のAPIが立ち上がり、OpenAIのPython SDKの base_url を差し替えるだけで呼び出せます。同じレシピでは、H100などのHopper世代に加え、A100(Ampere世代)でも動くと説明しています。
4. Transformersで動かす
Pythonのコードから直接動かす場合は、Hugging FaceのTransformersを使います。Hugging Faceの公式ページに載っている最小のコードは次のとおりです。
from transformers import pipeline

pipe = pipeline("text-generation", model="openai/gpt-oss-20b",
                torch_dtype="auto", device_map="auto")
messages = [{"role": "user", "content": "MXFP4量子化とは何か、簡潔に説明してください。"}]
outputs = pipe(messages, max_new_tokens=256)
print(outputs[0]["generated_text"][-1])
どの方法でもharmony形式が前提になる
4つの方法に共通する注意点が、harmony形式です。harmony形式とは、gpt-ossが学習時に使った会話の書式で、OpenAIはこの形式以外では正しく動かないと明記しています。
harmony形式では、メッセージにsystem・developer・user・assistant・toolの役割があり、モデルの出力は用途別の3つの「チャネル」に分かれます。
- final:ユーザーに見せる最終回答
- analysis:モデルの思考過程(chain-of-thought)
- commentary:関数呼び出しなどのツール利用
Ollama・LM Studio・vLLM・Transformersのチャットテンプレートは、この形式を自動で組み立てます。自前で model.generate を呼ぶ場合や独自の推論サーバーを書く場合は、チャットテンプレートかOpenAIの openai-harmony パッケージで書式をそろえる必要があります(出典:OpenAI Harmony Response Format|OpenAI Cookbook)。
gpt-ossのreasoning effortと主な設定
gpt-ossを動かせるようになったら、次は出力の質と速さを左右する設定です。最も影響が大きいのがreasoning effortです。
reasoning effortはsystemメッセージの1行で決まる
reasoning effortとは、モデルが答える前にどれだけ考えるかを、low・medium・highの3段階で指定する設定です。レベルを上げると思考過程が長くなり、精度が上がる代わりに応答は遅くなります。
モデルカードでは、GPQA Diamondの正解率が120bでlow 67.1、medium 73.1、high 80.1と、レベルに応じて上がっています。20bでもlow 56.8からhigh 71.5まで上がりました。
この設定は、harmony形式のsystemメッセージに「Reasoning: high」のような1行として入ります。openai-harmony でlowとhighの会話を組み立て、モデルに渡る文字列を確かめました。
# reasoning effort を変えたとき、gpt-oss に渡る system メッセージがどう変わるかを確認する
from openai_harmony import (load_harmony_encoding, HarmonyEncodingName, Conversation,
                            Message, Role, SystemContent, DeveloperContent, ReasoningEffort)

enc = load_harmony_encoding(HarmonyEncodingName.HARMONY_GPT_OSS)
for effort in [ReasoningEffort.LOW, ReasoningEffort.HIGH]:
    convo = Conversation.from_messages([
        Message.from_role_and_content(
            Role.SYSTEM,
            SystemContent.new().with_reasoning_effort(effort).with_conversation_start_date("2026-09-23")),
        Message.from_role_and_content(
            Role.DEVELOPER, DeveloperContent.new().with_instructions("日本語で簡潔に答えてください。")),
        Message.from_role_and_content(Role.USER, "社内規程の要点を3行でまとめて"),
    ])
    tokens = enc.render_conversation_for_completion(convo, Role.ASSISTANT)
    print(f"--- {effort.name}: 入力 {len(tokens)} トークン")
    print(enc.decode(tokens))
--- LOW: 入力 97 トークン
<|start|>system<|message|>You are ChatGPT, a large language model trained by OpenAI.
Knowledge cutoff: 2024-06
Current date: 2026-09-23
Reasoning: low
# Valid channels: analysis, commentary, final. Channel must be included for every message.<|end|><|start|>developer<|message|># Instructions
日本語で簡潔に答えてください。<|end|><|start|>user<|message|>社内規程の要点を3行でまとめて<|end|><|start|>assistant
--- HIGH: 入力 97 トークン
<|start|>system<|message|>You are ChatGPT, a large language model trained by OpenAI.
Knowledge cutoff: 2024-06
Current date: 2026-09-23
Reasoning: high
# Valid channels: analysis, commentary, final. Channel must be included for every message.<|end|><|start|>developer<|message|># Instructions
日本語で簡潔に答えてください。<|end|><|start|>user<|message|>社内規程の要点を3行でまとめて<|end|><|start|>assistant2つの出力で違うのは「Reasoning: low」と「Reasoning: high」の1行だけで、入力のトークン数も97で同じでした。つまり、reasoning effortを上げても入力は増えず、増えるのはモデルが生成する思考過程の長さです。また、利用者が書く指示はsystemではなくdeveloperの役割に入っている点も分かります。harmony形式では、いわゆるシステムプロンプトはdeveloperメッセージに書きます。
ツールごとの指定方法の違い
reasoning effortの指定方法は、ツールによって異なります。
- Transformers:チャットテンプレートに
reasoning_effort引数を渡します。指定しない場合はmediumです - vLLM:Chat Completions APIの
reasoning_effortパラメータで指定し、vLLMがharmony形式のsystemメッセージに変換します(出典:vLLMのソースコード) - Ollama:
ollama run gpt-oss --think=lowのように指定します。gpt-ossでは思考を完全に止めることはできず、low・medium・highのいずれかを選びます(出典:Thinking|Ollama)
Transformersの既定値がmediumになることは、トークナイザーだけを取得して確かめました。
# Transformers のチャットテンプレートに reasoning_effort を渡すと何が変わるかを確認する(トークナイザーだけ取得)
from transformers import AutoTokenizer

tok = AutoTokenizer.from_pretrained("openai/gpt-oss-20b")
messages = [{"role": "user", "content": "社内規程の要点を3行でまとめて"}]
for effort in [None, "low", "high"]:
    kwargs = {} if effort is None else {"reasoning_effort": effort}
    text = tok.apply_chat_template(messages, add_generation_prompt=True, tokenize=False, **kwargs)
    line = [l for l in text.splitlines() if l.startswith("Reasoning:")][0]
    print(f"reasoning_effort={effort!s:5} -> {line}")
reasoning_effort=None -> Reasoning: medium
reasoning_effort=low -> Reasoning: low
reasoning_effort=high -> Reasoning: high速さが要る問い合わせ対応はlow、正確さが要る設計レビューはhighというように、処理の種類ごとに切り替えると速度と精度の釣り合いを取りやすくなります。
思考過程(analysisチャネル)はユーザーに見せない
gpt-ossは思考過程をすべて出力します。デバッグには便利ですが、そのまま画面に表示してはいけません。
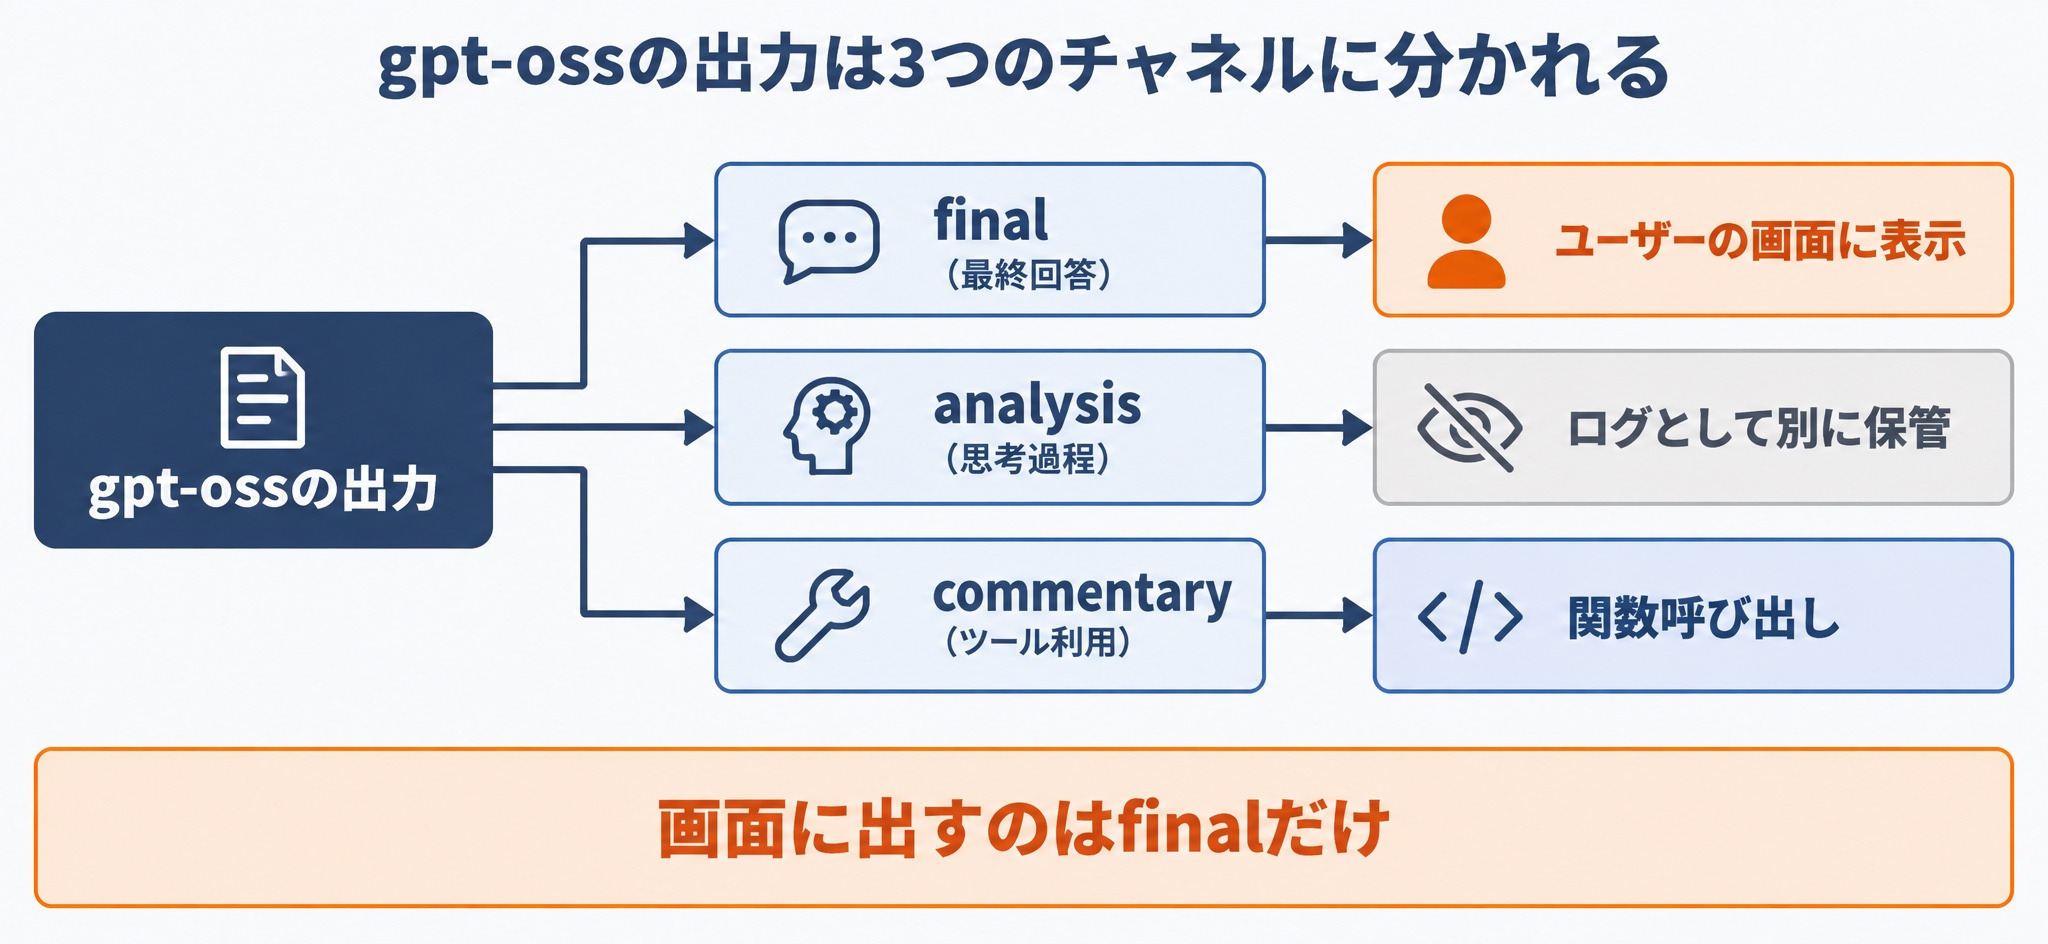
モデルカードは、思考過程には事実でない内容や、OpenAIの安全基準に沿わない表現が含まれうるとして、フィルタリングや要約をせずにユーザーへ直接見せないよう開発者に求めています。harmony形式のガイドも、analysisチャネルは最終回答と同じ安全基準を満たさないと明記しています。社内向けのチャット画面を作る場合も、表示するのはfinalチャネルだけにし、analysisチャネルはログとして別に扱う設計にしてください。
ここまでgpt-ossの動かし方と設定を解説しましたが、「RAGやエージェントに組み込んで評価するところまで自分で作れるか不安」という方は、Craft College DS ADVANCEDを検討してみてください。
DS ADVANCEDは、LLMアプリ・RAG・AIエージェントを実装する実務者向けの12週の上級プログラムです。ローカルLLMとクラウドAPIの使い分けも課題で扱い、毎週のコードレビューを通じて、設定の判断を自分のコードで確かめながら身につけられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft College DS ADVANCEDの詳細はこちら
gpt-ossを業務で使うときの判断
ここまでで、gpt-ossを選んで動かし、設定するところまでを見てきました。最後に、業務に入れてよいかを判断するための論点を整理します。
社外にデータを出さない構成と、クラウドで使う構成を分けて考える
gpt-ossを業務で使う最大の理由は、自社のPCやサーバーで動かせば、入力した文書を社外に送らずに済む点です。ただし、gpt-ossの使い方はこれだけではありません。
- ローカル・オンプレミスで動かす構成:自社のPCや社内サーバーでOllamaやvLLMを動かします。入力も出力も社内にとどまります
- クラウド事業者のサービスで使う構成:Amazon BedrockやAzure AI Foundryなどが提供するgpt-ossを呼び出します。自社でGPUを持つ必要はありませんが、データはその事業者の環境で処理されます
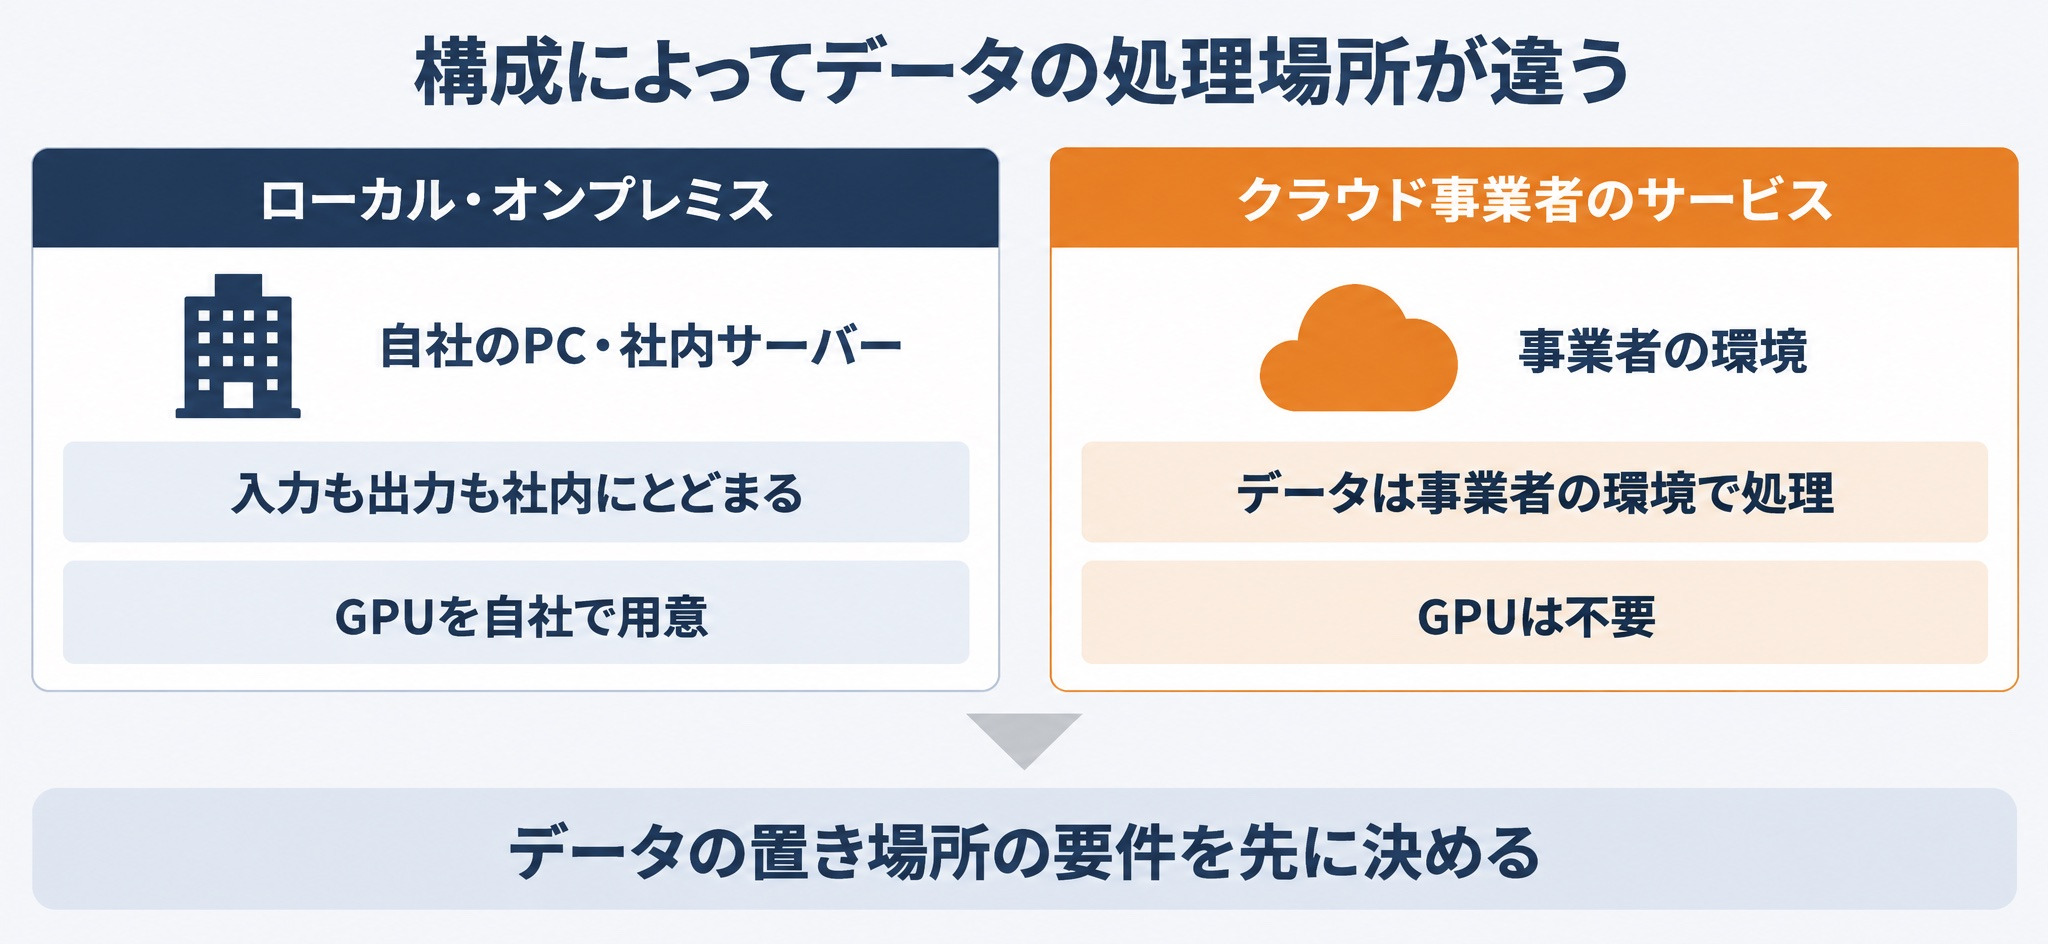
同じgpt-ossでも、後者は「社外にデータを出さない」構成ではありません。データの置き場所の要件を先に決め、それに合う構成を選んでください。クラウドで使う場合の料金は、2026年9月時点で各社の料金表で確認する必要があります。重み自体はHugging Faceから無料でダウンロードできます。
Apache 2.0とusage policyで確認すること
gpt-ossは、Apache 2.0ライセンスと「gpt-oss usage policy」の2つのもとで提供されています。
Apache 2.0とは、商用利用・改変・再配布を認めるオープンソースライセンスの1つで、特許の利用許諾も含む点が特徴です。業務で使ったり、追加学習したモデルを社内で使ったりすることは認められています。モデルを社外に再配布する場合は、ライセンス文を添付し、改変したファイルには変更したことを示す必要があります(出典:Apache License, Version 2.0)。
usage policyの全文は1文です。安全で責任ある利用を目指すことと、gpt-ossを使う人は適用されるすべての法令を守ることに同意する、という内容です(出典:USAGE_POLICY|GitHub openai/gpt-oss)。独自の禁止事項の一覧があるわけではないため、何が許されるかは各国の法令と自社の規程で判断することになります。
もう1点、安全面の責任が利用者側に移ることも押さえておいてください。モデルカードは、公開された重みは悪意ある人が追加学習で安全対策の拒否を外せること、公開後はOpenAIが追加の対策や利用停止をできないことを明記しています。社内で使う場合も、入力と出力の記録や利用者の権限の管理は自社で用意する必要があります。
gpt-ossの公表されている導入例
gpt-ossを業務向けに提供した例として、次の発表があります。
- 株式会社リコー:2025年8月8日、gpt-oss-120bのオンプレミス環境での動作検証を完了し、顧客への個別提供を始めたと発表しました。オンプレミスのGPUサーバーにLLMと生成AI開発基盤のDifyなどを載せて提供する「RICOH オンプレLLMスターターキット」への搭載も予定するとしています(出典:リコー ニュースリリース)
- Microsoft:2025年8月5日、Azure AI Foundryでgpt-oss-120bと20bを、Windows AI Foundryでgpt-oss-20bを利用できると発表しました。20bは16GB以上のVRAMを持つGPUなど、Windowsの幅広い機器で動くとし、オフラインや閉じたネットワークでの利用にも触れています(出典:Microsoft Azure Blog)
- Amazon Web Services:gpt-oss-120bと20bをAmazon BedrockとAmazon SageMaker AIで提供すると発表しました。Bedrockの安全機能であるGuardrailsと組み合わせられるとしています(出典:About Amazon)
リコーの例はオンプレミス構成、MicrosoftとAWSの例は主にクラウド構成に当たります。
業務に入れる前に確かめる5つのステップ
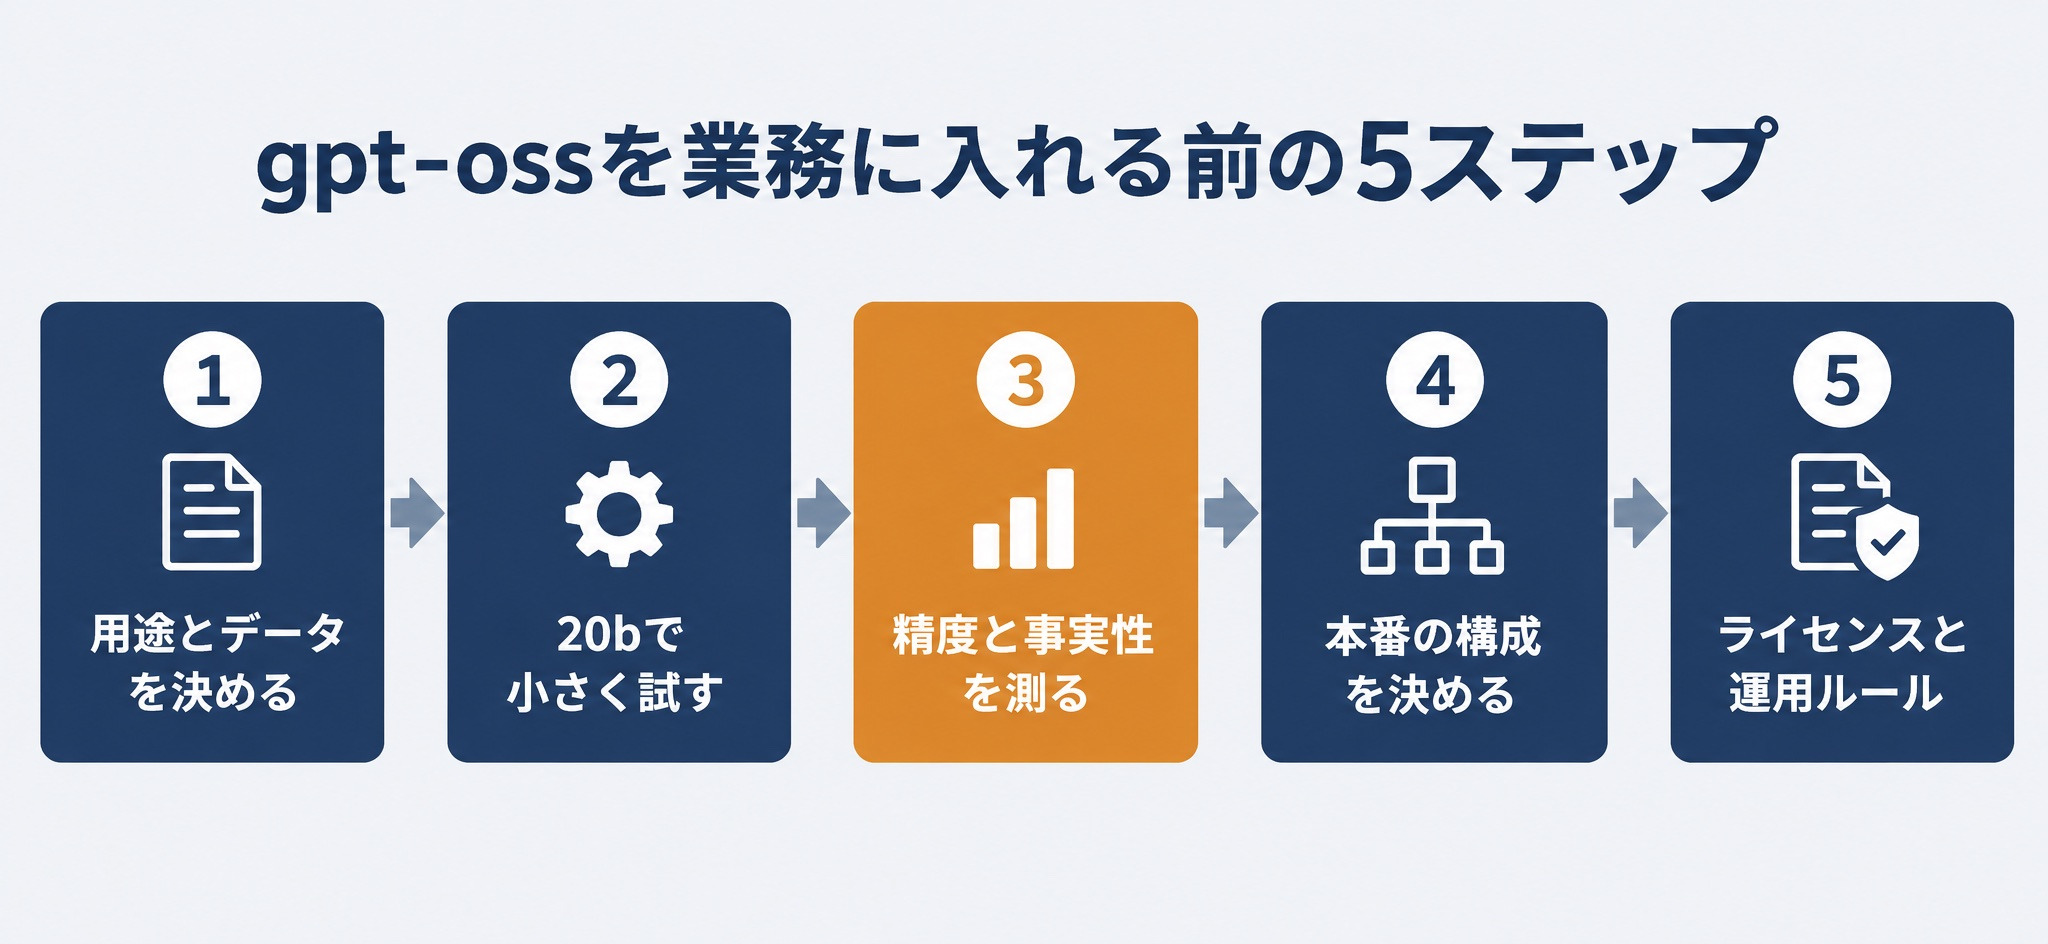
gpt-ossを業務に入れるときは、次の順で進めると手戻りが少なくなります。
- 用途と扱うデータを決める(業務の担当者と情報システム部門):どの業務で、どの機密度の文書を入力するかを書き出します。社外に出せないデータがあれば、ローカルかオンプレミスの構成に絞ります
- 20bで小さく試す(開発担当者):手元の16GB以上の環境でOllamaかLM Studioを使い、実際の業務の質問を20〜50問ほど用意して答えさせます
- 精度と事実性を測る(開発担当者と業務の担当者):モデルカードでは、短い事実を問うSimpleQAでの誤答(ハルシネーション)の割合が120bで0.782、20bで0.914と高めに出ています。知識は2024年6月までなので、社内文書を検索して渡すRAGと組み合わせたうえで、正答率とreasoning effortごとの応答時間を記録します
- 本番の構成を決める(開発担当者と情報システム部門):複数人で使うならvLLMでAPIサーバーを立て、利用者の認証、入出力の記録、analysisチャネルを画面に出さない処理を入れます。精度が足りなければ、ここで120bへの切り替えを検討します
- ライセンスと運用ルールを整える(情報システム部門と法務):社外に再配布する予定があればApache 2.0の表示を用意し、社内の利用規程に入力してよいデータの範囲を書き込みます
20bで足りないと分かった場合も、モデルを替える前に、足りないのが知識なのか検索なのかを評価用の質問で切り分けると、120bへの切り替えとRAGの改善のどちらが効くかを判断できます。
2026年9月時点のgpt-ossの更新状況
業務の判断材料がそろったところで、その情報がいまも有効かを確かめておきます。gpt-ossは公開から1年以上たっているため、後継の有無が気になる方も多いでしょう。
モデル本体は2025年8月の公開版のまま
2026年9月23日に、Hugging FaceのOpenAI公式アカウントのモデル一覧とGitHubのリポジトリを確認した結果は次のとおりです。
- モデルの重み:gpt-oss-120bとgpt-oss-20bのほかに、新しいサイズや後継の重みは公開されていません。gpt-oss-20bのリポジトリの最終更新は2025年8月26日です
- GitHubのリポジトリ:参照実装とツールの更新は続いており、最新のリリースは2026年1月13日のv0.0.9、最終コミットは2026年7月24日です(出典:GitHub openai/gpt-oss)
一部の海外サイトには新しいサイズの追加を伝える記述がありますが、公式の配布元では確認できませんでした。最新の状況は、Hugging FaceのOpenAI公式アカウントとGitHubのリリースで確かめてください。
派生モデルgpt-oss-safeguard
更新として押さえておきたいのが、2025年10月29日に公開されたgpt-oss-safeguardです。gpt-oss-safeguardとは、gpt-ossを元に、利用者が書いた安全ポリシーに沿って文章を分類するよう追加学習したモデルです。120bと20bの2サイズがあり、同じくApache 2.0で提供されています(出典:openai/gpt-oss-safeguard-20b|Hugging Face、ROOST)。
用途は、LLMへの入力や出力の検査、投稿内容の分類などです。汎用の質問応答に使うモデルではないため、gpt-ossの後継ではなく、gpt-ossを使ったシステムの安全対策に組み合わせる部品と考えるのが適切です。
まとめ
- gpt-ossは、OpenAIが2025年8月5日に公開したオープンウェイトモデルで、120b(総116.83B・稼働5.13B)と20b(総20.91B・稼働3.61B)の2サイズがあります
- MoEとMXFP4量子化により、公式の目安では120bが80GBのGPU1枚、20bが16GBで動きます。ただしGPUの世代や入力の長さで必要量は変わります
- 20bと120bの差はコード修正では小さく、専門知識を問うタスクや日本語の質問では大きく開きます。まず20bで自社の質問を試し、足りなければ120bに進むのが無駄のない順序です
- Ollama・LM Studio・vLLM・Transformersのどれで動かしてもharmony形式が前提で、reasoning effortはsystemメッセージの1行で決まります。思考過程はユーザーに見せません
- Apache 2.0で商用利用できますが、データの置き場所、安全対策、事実性の確認は利用者側の責任になります。2026年9月時点でモデル本体の後継は公開されていません
gpt-ossを使ったローカルLLMの構築・学習は「リベルクラフト」へ
「gpt-ossを試すところまではできたが、自社のデータで精度を測り、社内で安全に使える形まで仕上げるにはどうすればよいか」と考えている方もいらっしゃるのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced(DS ADVANCED)を提供しています。LLMアプリ・RAG・AIエージェントを12週で実装する実務者向けの上級プログラムで、ローカルLLM(Ollama)とクラウドAPIの使い分けも課題の中で扱います。毎週の実装課題には現役データサイエンティストのコードレビューが付きます。
リベルクラフト本体では、ローカルLLMの構築支援も行っています。
- 社外に出せない文書を扱うための、ローカルLLMやオンプレミス環境の設計
- gpt-ossなどのオープンウェイトモデルの選定と、自社の質問を使った精度評価
- 社内文書を参照させるRAGの構築と、本番運用での監視
モデル選びの段階からご相談いただけます。
⇨ローカルLLM構築・AI開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。