
AIの作り方を5ステップで解説。モデルを借りる時代に必要な要件・データ・評価
「AIを自分で作ってみたいけれど、何から始めればいいのか分からない」「AIの作り方を調べると数学や機械学習の話ばかりで、自分には無理だと感じた」という方も多いでしょう。
しかし、いま業務やサービスの中で作られているAIの多くは、学習済みのAIモデルを借りて組み立てるものです。作る人の力量が問われるのは、モデルの中身よりも、何を正解とするかを決め、データを整え、答えの正しさを確かめ続ける工程に移っています。
そこで本記事では、
- AIを作るとは何をすることか、AIを使うこととの違い
- 作れるAIの種類と、ノーコードとPythonの選び方
- AIの作り方5ステップと、メーカーでの開発事例
- 今の経験が効く工程と、作れるようになるための学習ステップ
についてわかりやすく解説します。AIを使う側から作る側に回りたい方は、ぜひ最後までご覧ください。
「AIを作れるようになりたいが、何をどの順番で学べばいいか相談したい」という方は、リベルクラフトへご相談ください。
⇨Craft Collegeへの無料相談はこちら
AIの作り方とは。「使う」と「作る」は何が違うのか
まず、「AIを作る」という言葉が何を指すのかをそろえます。ここがずれると、学ぶ内容も手順もずれるためです。
AIを作るとは、業務の中で正しく動く仕組みを作ること
AIを作るとは、業務やサービスの中で正しく動くAIの仕組みを作り、その答えの正しさに責任を持つことを指します。
代表的なものは、社内の規定や手順書を検索して質問に答えるAI(RAG)や、決められた業務を自分で順番に進めるAIエージェントです。RAGとは、AIが回答する前に社内文書などを検索し、見つけた根拠をもとに答えさせる仕組みのことです。
これに対して、Claude CodeやCodexのようなツールにコードを書かせて開発を速くすることは「AIを使って開発する」ことです。言葉は似ていますが、この2つは別の層の話です。
AIを使う人はすでに多数派になりつつあります。パーソル総合研究所の調査では、生成AIを業務で使っている人は全国の就業者で32.4%、IT・開発職に限ると64.5%でした(パーソル総合研究所「生成AIとはたらき方に関する実態調査」、2026年2月公表)。転職の場面でも、doda編集長は、AIツールを「使えるかどうか」だけでなく、AIを活用したうえでどのような実績を具体的に残せたかがこれまで以上に問われていくと解説しています(パーソルキャリア、2026年3月)。
一方で、作れる人はまだ多くありません。IPAの「DX動向2026」では、AIを活用したソフトウェアやシステムを実装できるAI開発者が「十分にいる」と答えた企業は1.6%でした。「まあまあいる」は7.9%、「不足している」は49.9%、「自社には必要ない」は40.7%です(IPA「DX動向2026」)。
AIを使うこととの違いは、答えの確かめ方
使う人と作る人の違いがいちばん表れるのは、AIの答えをどう確かめるかです。
- AIを使う人:自分が受け取る1回の答えを確かめます。間違いに気づいたら、その場で聞き直して直せます
- AIを作る人:大勢の人に何度も出す答えを確かめます。受け取った人が間違いに気づかないこともあるため、テスト問題を用意し、どれくらいの精度が出るかを測ります
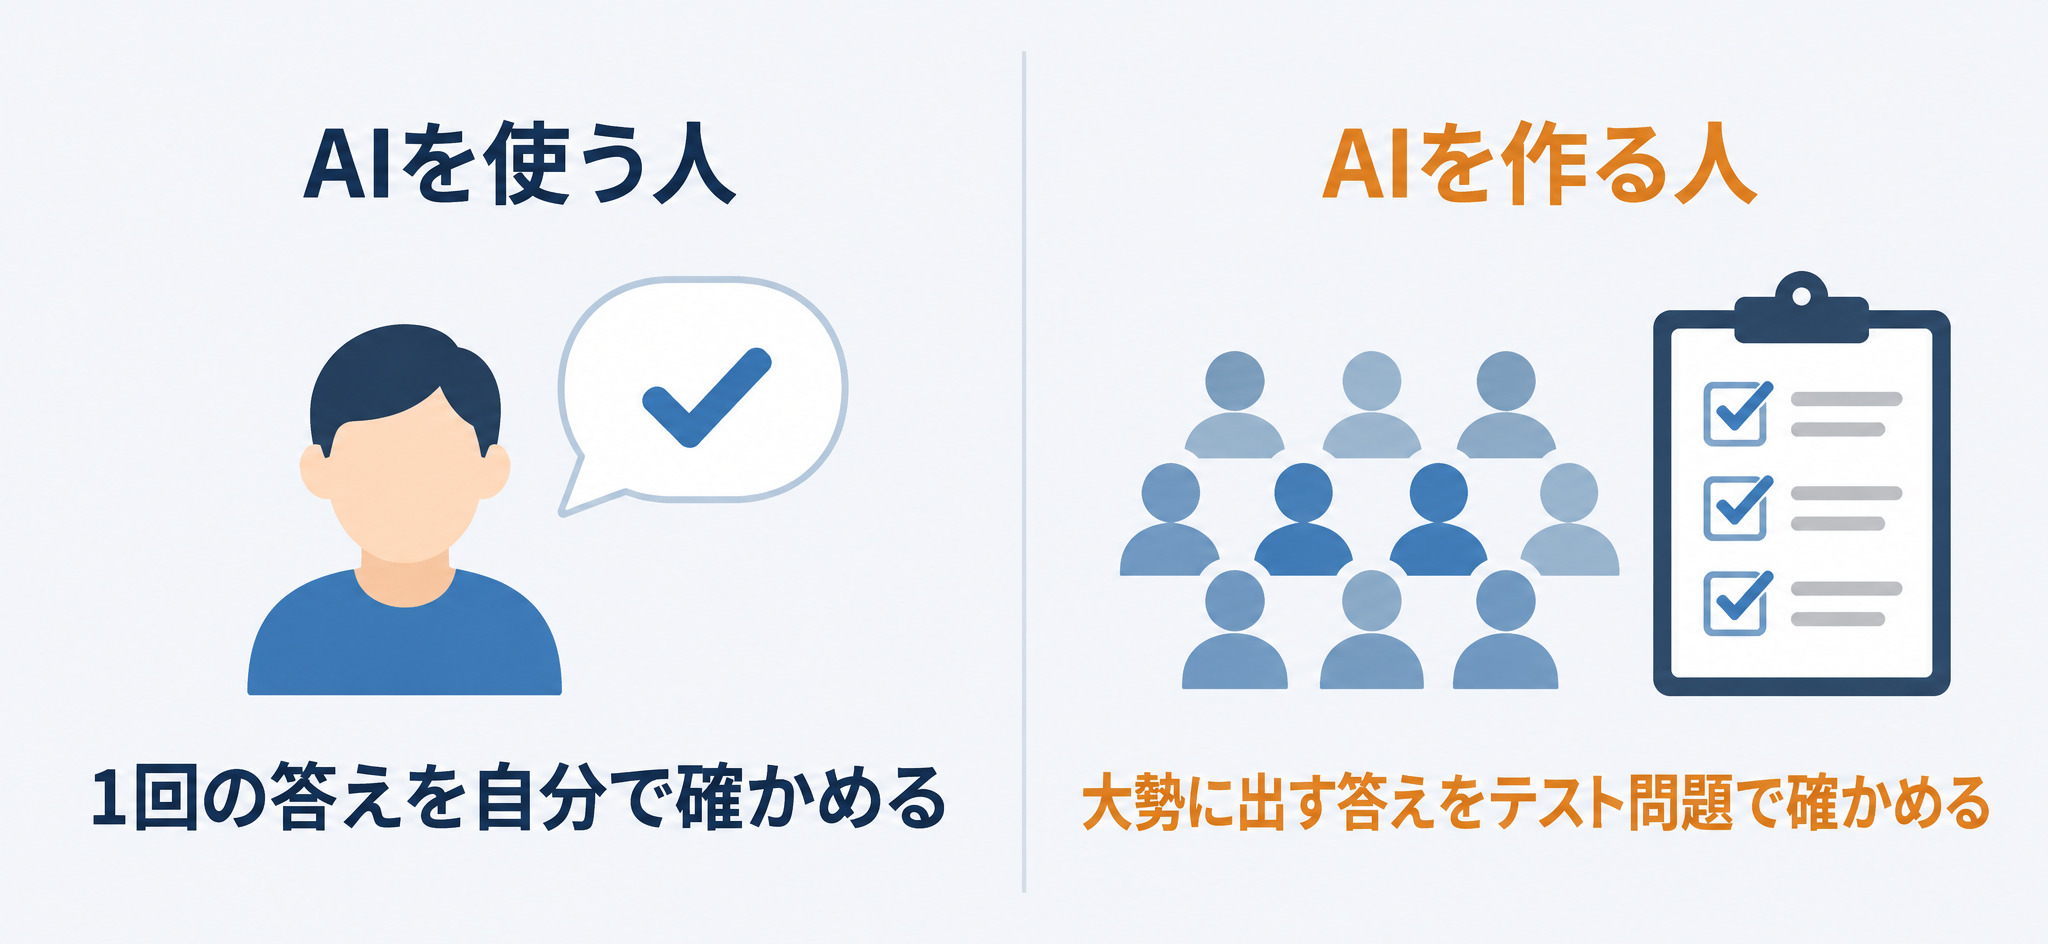
例えば、社内の問い合わせに答えるAIを作るなら、「有給休暇は何日前までに申請するか」のような質問と正しい答えを何十問も用意し、AIが何問正解するかを数えます。1回うまく答えたから合格、とはしません。
初心者でもAIは作れる。モデルは借りられる
AIの作り方を調べると、数学やモデル開発から学ぶ前提の説明が多く見つかります。ClaudeやGPTのようなAIモデルそのものを作るなら、その知識は今も欠かせません。
ただ、業務で使うAIの仕組みを作る場合、頭脳にあたるモデルはAPIで他社から借りられます。APIとは、外部のサービスの機能を自分のプログラムから呼び出すための窓口です。借りたモデルを使ってRAGやAIエージェントを組み立てるため、数学を一から学び直さなくても、作り始めることはできます。
ただし、何も学ばずに作れるわけではありません。データを整えて数える力や、結果の差がたまたまかどうかを見分ける統計の考え方は、作る工程のあちこちで必要になります。つまり、初心者が最初に向き合うのは数式よりも、データと評価だと考えると学ぶ順番を決めやすくなります。
AIの作り方は作るAIの種類で変わる。ノーコードとPythonの選び方
ここまでで、AIを作るとは業務で正しく動く仕組みを作ることだと整理しました。次に、どんな仕組みを、どの手段で作るのかを見ていきます。
いま作られているAIの主な4種類
個人でAIを自作する場合も、企業で開発する場合も、作るAIはおおむね次の4種類に分かれます。
| 種類 | できること | 主な作り方 |
|---|---|---|
| 生成AIアプリ | 文章の要約・分類・下書きなど、決まった用途に絞った対話や処理 | 借りたモデルに指示文と入出力の形を決めて組み込む |
| 社内文書に答えるAI(RAG) | 規定・マニュアル・過去資料を根拠に質問へ答える | 文書を検索できる形に整え、検索結果をモデルに渡す |
| AIエージェント | ファイルの整形や集計など、複数の手順を自分で進める | モデルに使える道具と手順、人の承認が必要な箇所を決める |
| 予測・分類の機械学習モデル | 売上や需要の予測、顧客のグループ分けなど | 表形式のデータを整え、モデルを学習させて精度を測る |
この表から分かるように、上の3つは借りたモデルを組み立てる作り方で、データを整えることと答えを確かめることが中心になります。4つ目は従来の機械学習で、自分でモデルを学習させます。
AIエージェントの設計パターンについては、以下の記事で詳しく解説しています。
参照記事:AIエージェントの作り方完全ガイド。仕組み・設計パターン・実装まで解説
ノーコードで作る場合
Difyのようなノーコードツールを使うと、プログラムを書かずに画面上でRAGや簡単なAIエージェントを組み立てられます。まず動くものを作り、どんな質問にどう答えるかを確かめる試作に向いています。
ただし、ノーコードでも作った後の評価は省けません。何十問ものテスト問題の正答数を数えたり、社内のデータを加工したりする段階では、手作業が追いつかなくなります。
Pythonで作る場合
Pythonは、データの加工、モデルの呼び出し、正答率の集計までを1つの言語で書けるため、AIの作り方を学ぶときの標準的な選択肢です。最近はClaude CodeのようなAIエージェントツールにPythonのコードを書かせながら進められるので、文法をすべて覚えてから始める必要はありません。
判断に迷う場合は、試作はノーコードで始め、評価とデータの加工が必要になった時点でPythonに移る、と考えると選びやすくなります。
参照記事:Pythonを用いたAI開発の6ステップ。開発を進める上で必要なスキルとコツも解説
AIの作り方5ステップ
ここまでで作るAIの種類と手段を整理しました。ここからは、どの種類でも共通するAIの作り方を、開発の流れに沿って5つのステップで解説します。
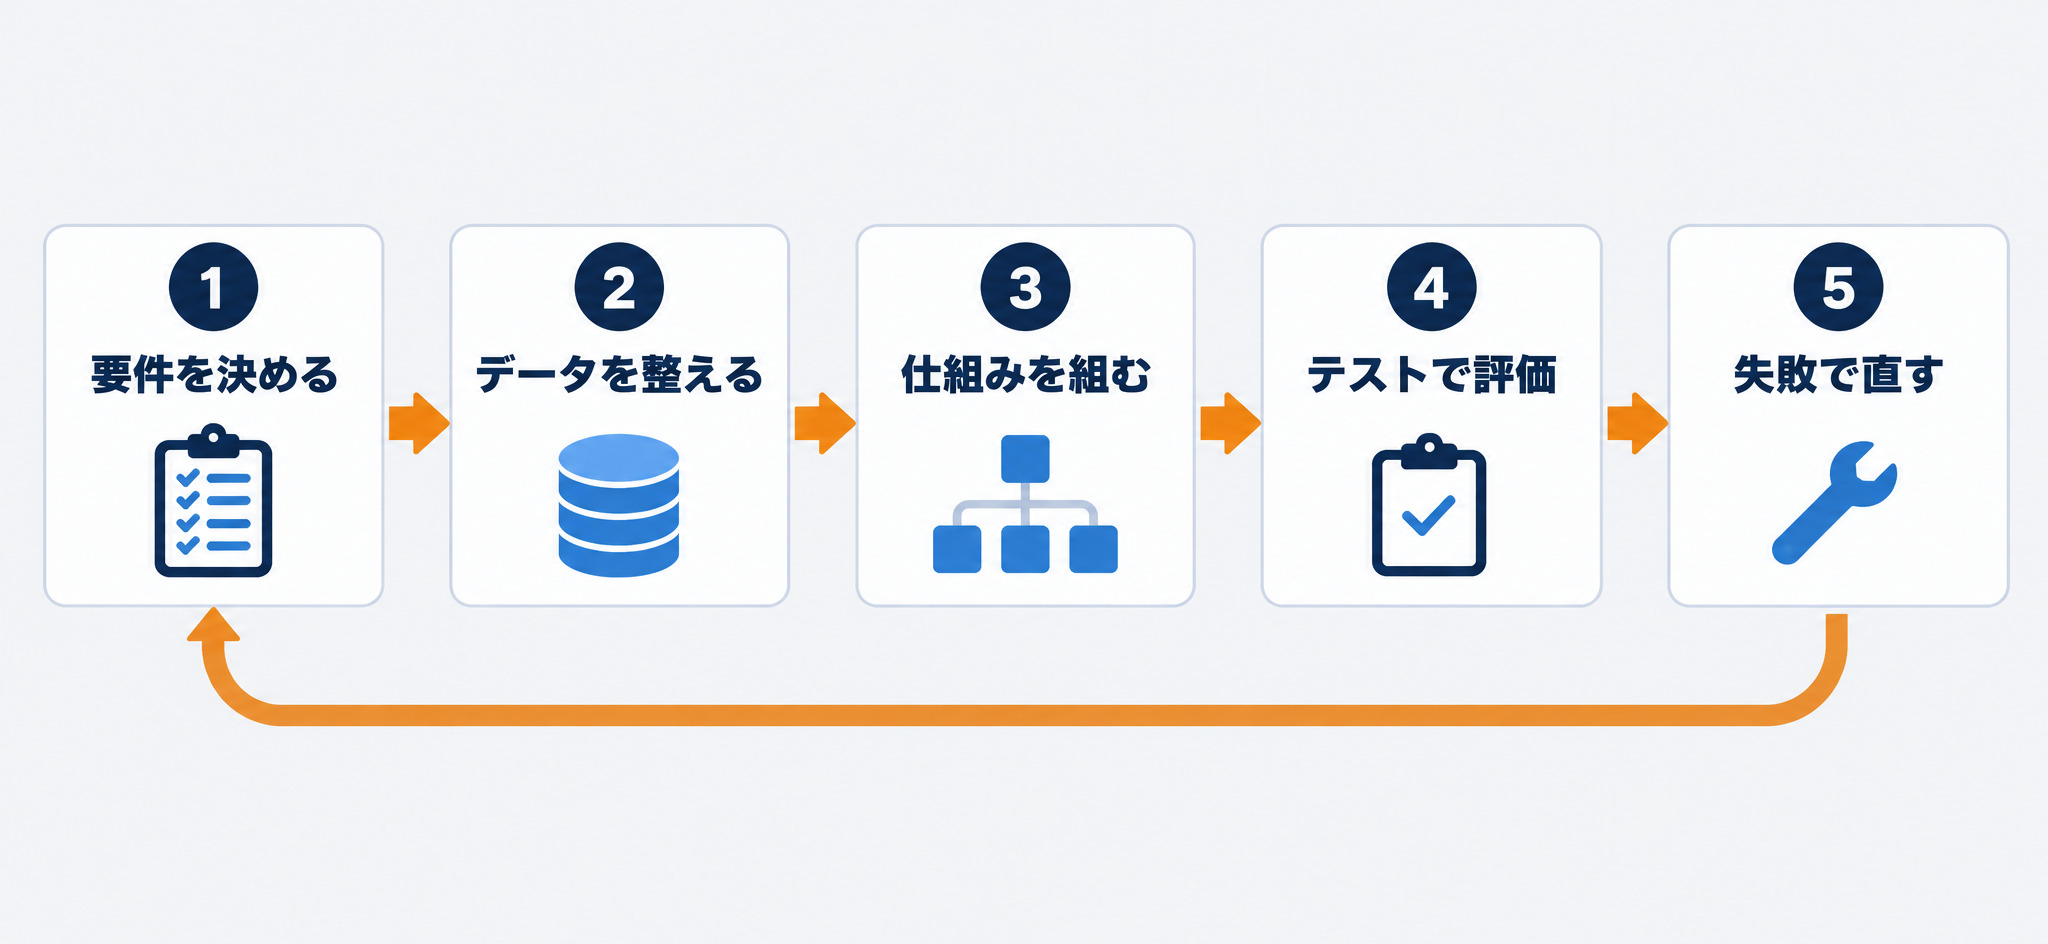
AIを作る仕事は1回で完成させるものではなく、次の5ステップを回し続けます。
STEP1:要件を決める
最初に、AIに任せることと人に残すこと、そして何を正解とするかを決めます。
- AIに任せる範囲を決める:大量の資料を読む、下書きを作るなど、間違えても人が確認して直せる作業から任せます
- 人に残す判断を決める:最終判断、優先順位の決定、社外に影響する意思決定は人が持ちます
- 正解の基準を書き出す:どんな答えなら合格か、どんな答えは不合格かを言葉にします
Anthropicは、評価の仕組みは後回しにするほど作りにくくなり、開発の初期なら製品の要件がそのままテスト問題になると述べています(Anthropic『Demystifying evals for AI agents』、2026年1月)。STEP1で書いた正解の基準は、STEP4のテスト問題の元になります。
STEP2:データを整える
次に、AIが読むデータを、読み間違えにくい形に整えます。社内の文書や記録は、そのまま渡してもAIが精度よく読めないことがほとんどです。
- 種類をそろえる:PDF、表計算、ログなど形式が違うデータを、検索や集計ができる形に変換します
- 階層や所属を付ける:どの部署の規定か、どの設備の記録かといった情報をデータに持たせます
- 古い版を混ぜない:同じ規定の旧版と新版が両方残っていると、AIが古い内容で答える原因になります
AIがコードを書いてくれる時代でも、どのデータをAIに読ませるか、どんな状態で保管しておくかは、作る人が設計する部分です。
STEP3:仕組みを組む
データが整ったら、モデルとデータ、道具をつないで仕組みを組みます。このとき、1つのAIにすべてを任せず、役割を分けて組み合わせる設計がよく使われます。
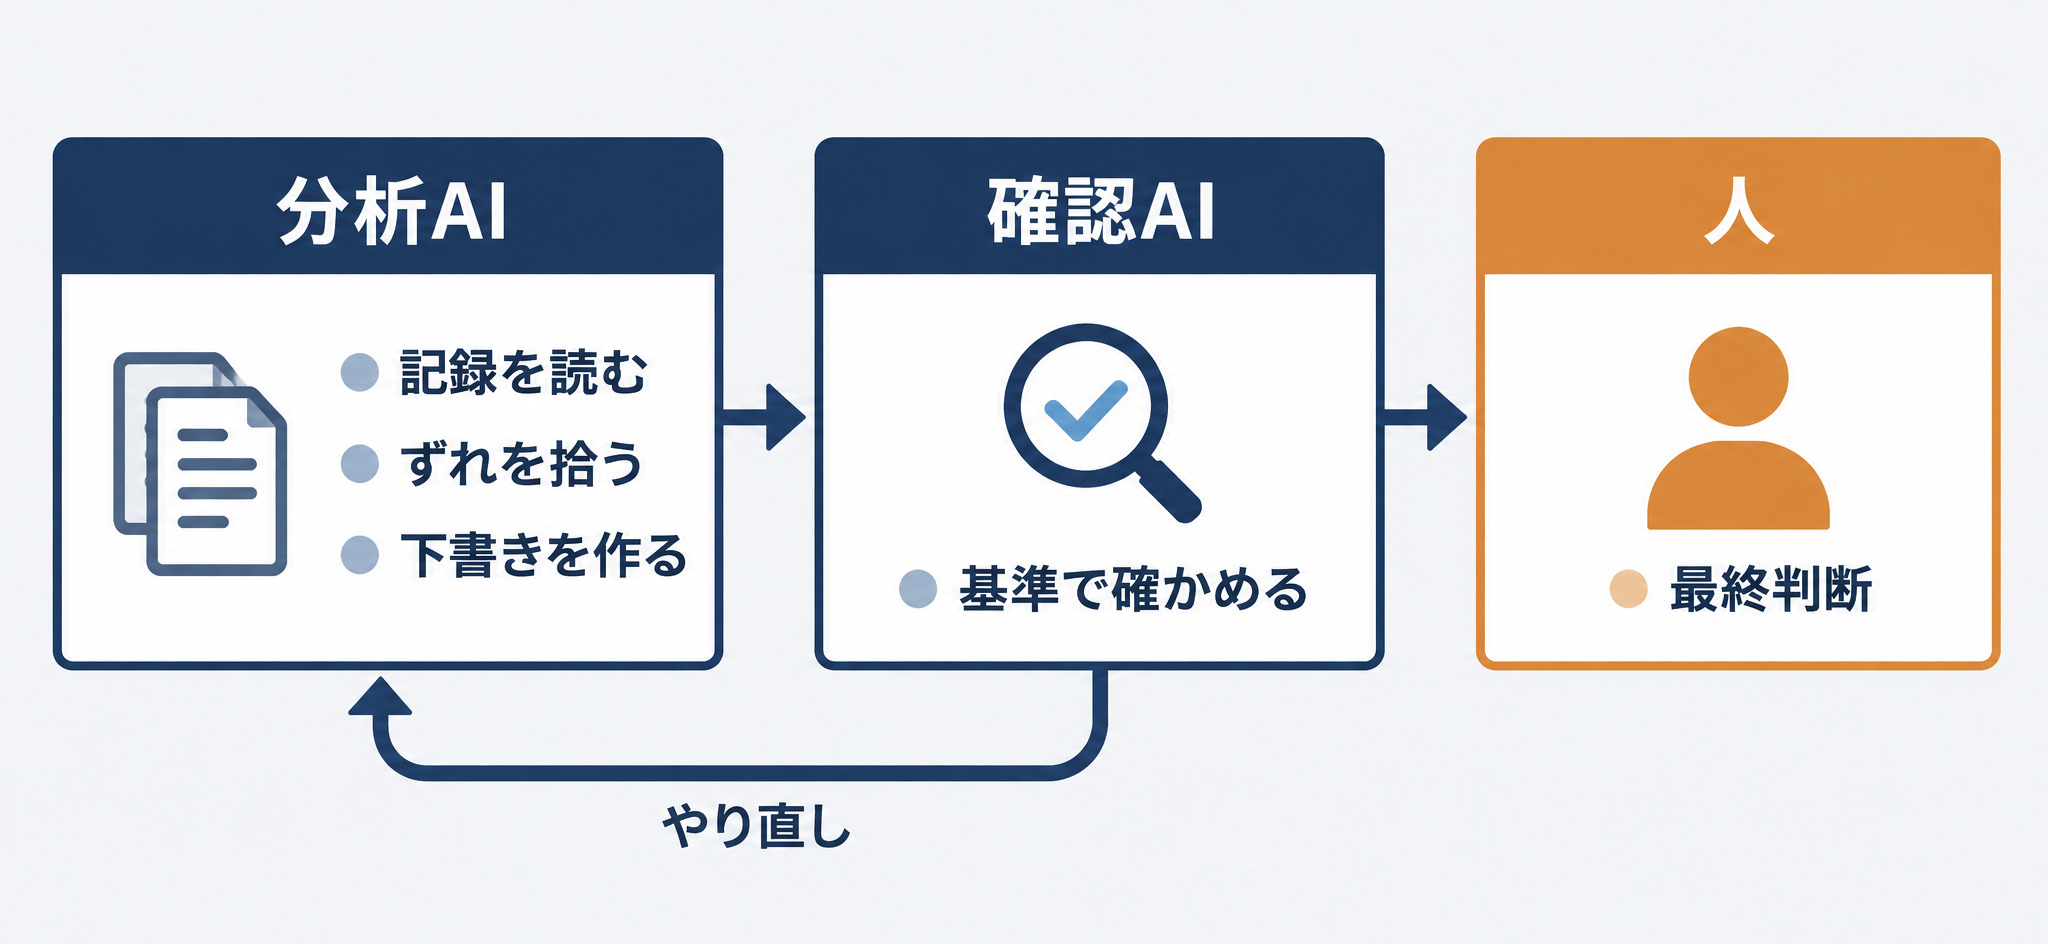
例えば、分析するAIとは別に、その結果を基準に照らして確かめるAIを用意し、不十分ならやり直させる構成です。複数のAIに役割を分けて組む仕組みは、マルチAIエージェントとも呼ばれます。
STEP4:テスト問題で精度を評価する
仕組みが動いたら、テスト問題を使って精度を測ります。Anthropicは、評価について次のような作法を示しています(出典は同上)。
- 最初は20〜50問で始める:実際の失敗から集めた簡単な問題20〜50問で、最初のテストとしては十分です
- 合否がぶれない問題にする:良いテスト問題とは、その分野の専門家2人が別々に採点しても合否が一致する問題です
- 同じ問題を複数回試す:AIの出力は実行のたびに変わるため、1回の結果で判断しません
- 採点の方法を組み合わせる:プログラムによる判定、別のAIによる判定、人による判定の3種類を組み合わせます
RAGの精度を「検索」と「生成」に分けて測る方法は、以下の記事で解説しています。
参照記事:RAGASとは?RAGの精度を「検索」と「生成」に分けて数字で測る評価方法
STEP5:本番で出た失敗を評価データに足して直し続ける
公開した後も、AIの作り方は終わりません。実際に使われると、テスト問題には無かった質問や失敗が出てきます。
Google Cloudは、本番で起きた新しい失敗や珍しい質問を拾い、匿名化して正解を付け、評価用のデータに追加する進め方を示しています(Google Cloud Blog『A methodical approach to agent evaluation』、2025年11月)。Anthropicも、AIエージェントを良くするいちばんの方法は、出力、とくに失敗した例をよく見ることだと述べています(Anthropic『Building agents with the Claude Agent SDK』、2025年9月)。
失敗を読んで原因がSTEP1〜3のどこにあるかを突き止め、直した結果をSTEP4のテスト問題で確かめます。この繰り返しが、作ったAIの精度を上げていきます。
事例で見るAIの作り方。メーカーの設備記録を読む分析AI
ここまでは5ステップを一般論として説明しました。ここでは、リベルクラフトが複数拠点を持つメーカーと実証実験(PoC)として作った分析AIを例に、各ステップで何を決めたのかを追います。内容は一部を書き換えています。
作る前の課題:記録はあるのに、見切れていなかった
製造の現場では、設備の操作記録や警報など、多くの記録が日々たまっていきます。ところが、その記録は異常が起きたときの対処にしか使われておらず、何かあったときの判断はベテランの保全担当の経験に頼っていました。
そこで、記録を読んで定期の分析レポートの下書きを作り、確認すべき箇所を示すAIを業務の中に組み込むことにしました。
要件:AIに任せることと人に残すこと
STEP1にあたる要件では、役割を次のように分けました。
- AIに任せること:大量の記録を漏れなく読む、いつもの傾向からずれた動きを拾う、レポートの下書きを作る
- 人に残すこと:現場の知識を踏まえた最終判断、何から手をつけるかの優先順位、社外に関わる意思決定
あわせて、AIに見分けさせる「いつもと違う動き」も決めました。記録が急に増えたり減ったりした、記録のリズムが崩れた、予定どおり出るはずの記録が出ていない、制御の切り替わり方がおかしい、といった観点です。これを決めるには設備の知識が要るため、作る側はその知識を持つ現場の方と一緒に決めるか、自分がその知識を持っている必要があります。
データと仕組み:記録を整え、分析するAIと確かめるAIを分けた
STEP2では、操作記録、警報、制御の記録、運転スケジュールといった種類の違う記録と、設備の階層、拠点や製造ラインごとの用途の違いを、AIが読み取れる形に整えました。そのまま渡すと、AIは記録を精度よく読めないためです。
STEP3では、分析するAIが結果をそのまま返すのではなく、別のAIがその結果を基準に照らして確かめ、不十分なら分析をやり直させる構成にしました。
評価と改善:現場のOK・NGで判定し、失敗を足していく
STEP4とSTEP5では、評価用の問題を集め、1回試しただけで合格にせず、出てきた結果を現場の目でOKかNGかを判定しました。精度の低いAIは現場で使われないためです。うまくいかなかった例は読んで原因を直し、新しく見つかった失敗は評価用のデータに足していきます。
AIを作る仕事に向いている人。今の経験が効く工程と最初の一歩
事例で、作る工程ごとに何を決めるのかを見てきました。ここでは、読者自身の経験がAIを作る仕事のどの工程に当たるかを確かめます。
要件定義・データ連携・テスト・保守運用の経験は、そのまま効く
AIを作る仕事は、まったく新しい仕事ではありません。これまでの仕事の経験は、次のように作る工程に対応します。
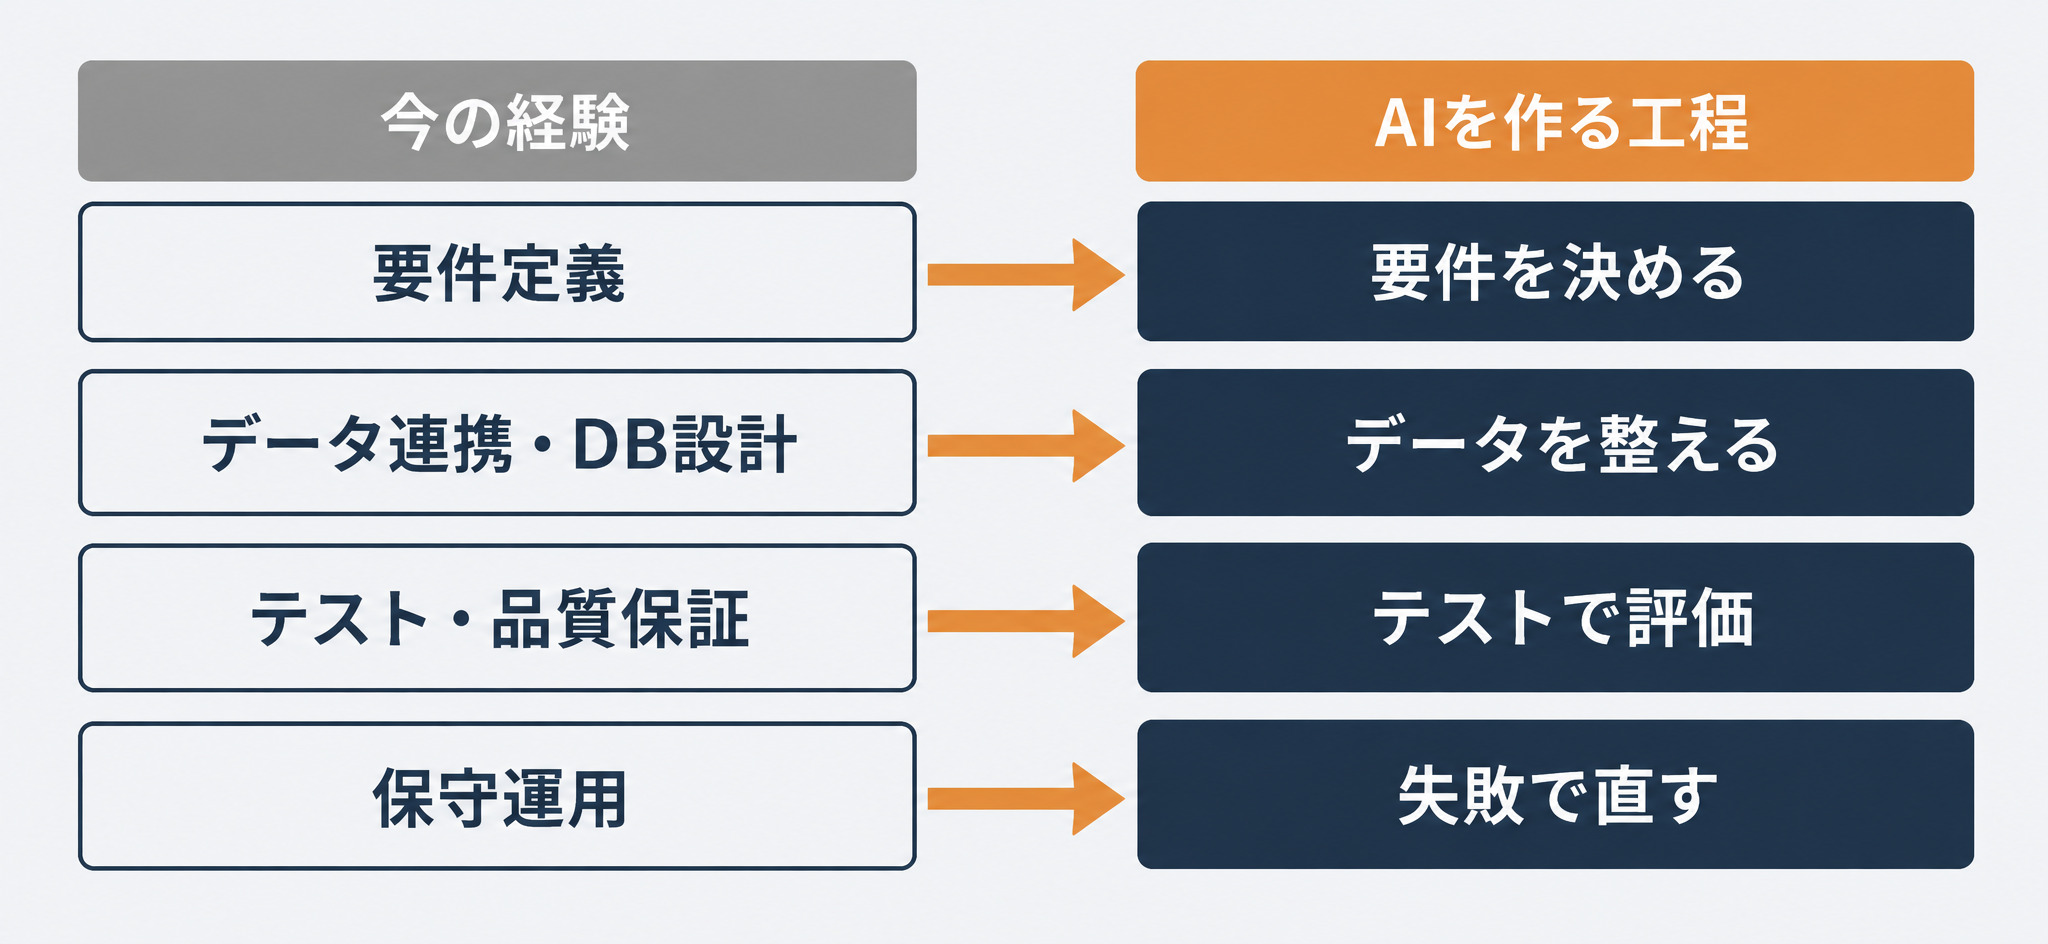
- 業務知識:STEP1で「いつもと違う動き」や正解の基準を決めるときに効きます
- 要件定義(PMやテックリードの経験):STEP1の、任せる範囲と人に残す判断を決める工程に効きます
- データ連携やデータベース設計:STEP2のデータを整える工程に効きます
- テストや品質保証:STEP4のテスト問題を作り、精度を測る工程に効きます
- 保守運用:STEP5の、本番の失敗を拾って直し続ける工程に効きます
最初の一歩は、仕事のよくある問いと正しい答えを書き出すこと
AIを使う側から作る側へ進む最初の一歩は、自分の仕事でよく聞かれる問いと、その正しい答えを書き出せるかどうかです。これはその仕事を知っている人にしか書けず、そのままテスト問題になります。
- 問いを選ぶ:自分の仕事でよく聞かれる質問を10個ほど選びます
- 正しい答えと根拠を書く:それぞれの正しい答えと、根拠になる規定や手順書を書き出します
- AIに聞く:同じ質問をAIに聞き、答えを記録します
- 合っている数を数える:AIの答えが正しい答えと合っているかを判定し、何問合っていたかをPythonで数えます
ここまでできれば、仕事を知っている人として、AIの答えを確かめる側に立てます。
ここまでAIの作り方を解説しましたが、「データの扱いや評価を1人で身につけられるか不安」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeでは、Pythonでのデータ分析から、社内文書に答えるAIやAIエージェントの開発までを段階的に学べます。ただ教材を進めるだけでなく、課題の添削と週1回の面談で詰まった箇所を確認できるため、作る側に回る力を身につけることが可能。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
AIを作れるようになるための学習ステップ
最初の一歩を踏み出したら、次はAIを作れるようになるまでに何をどの順番で積み上げるかを決めます。AIを作るのに必要なものは、次の5段の階段で考えると整理しやすくなります。
AIを作れるようになる5段の階段
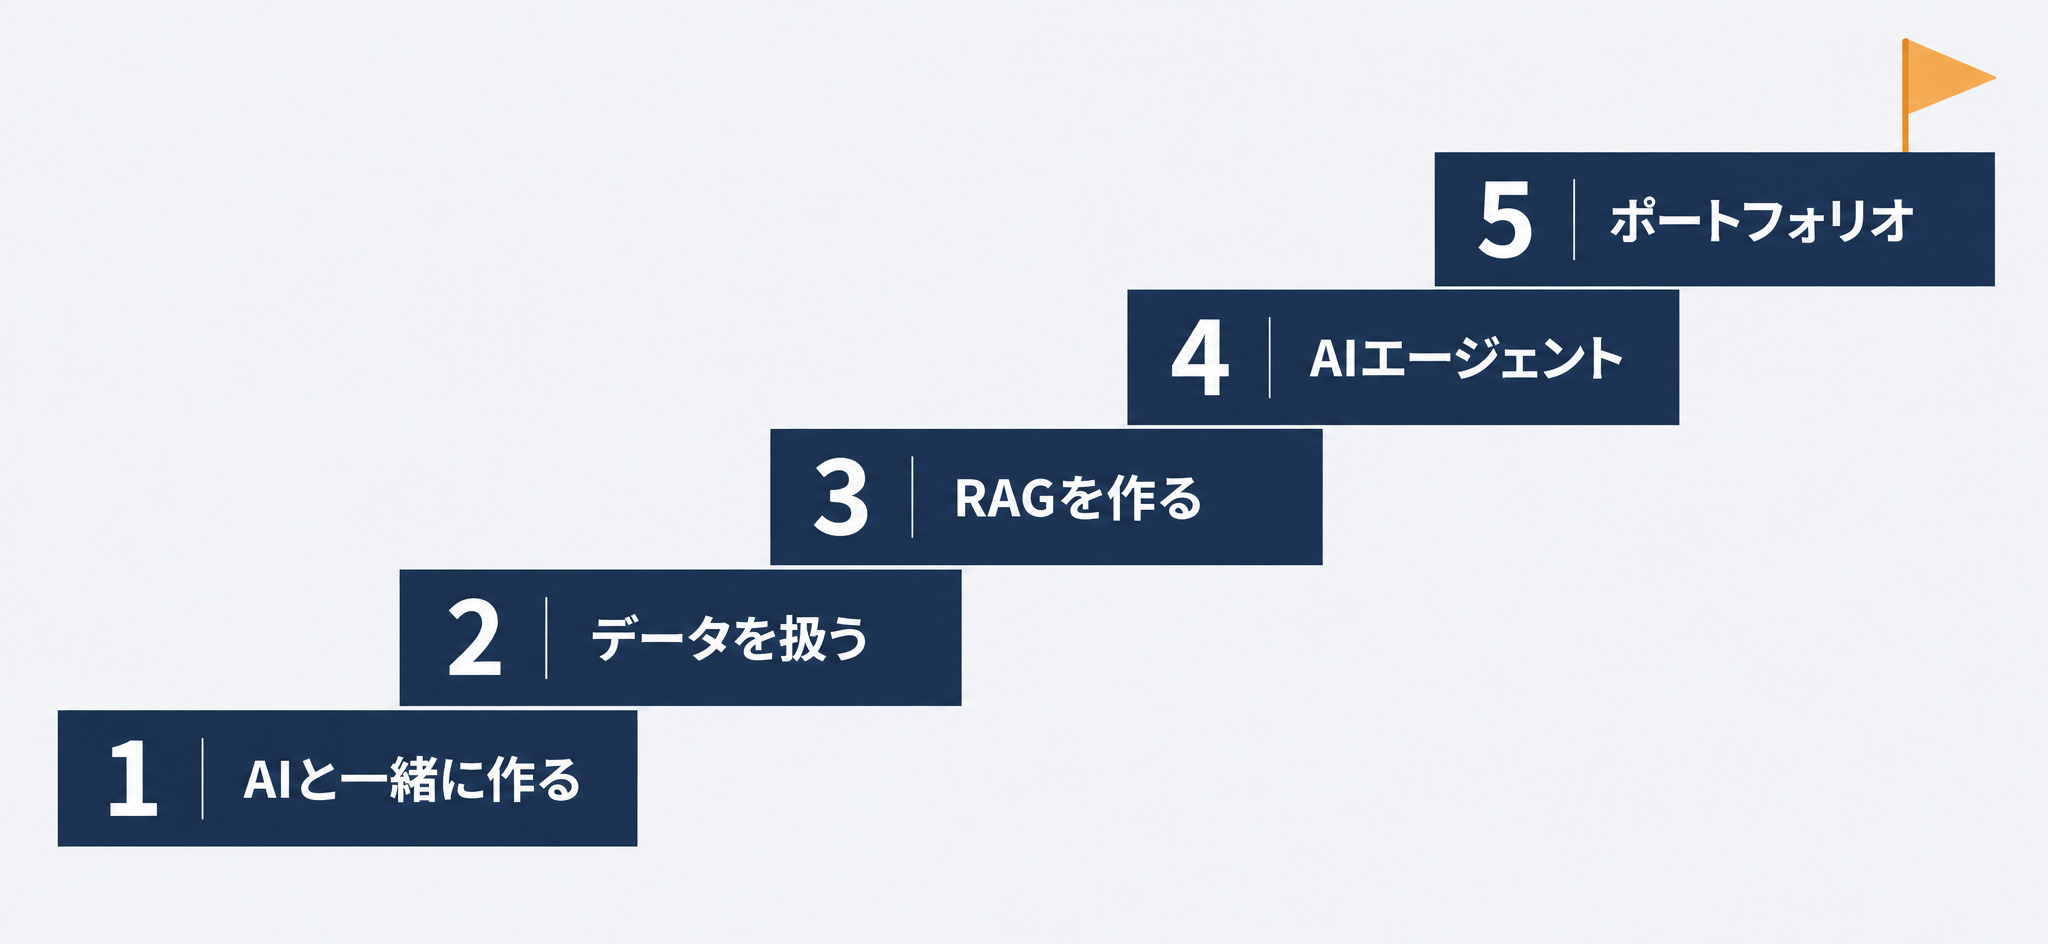
- AIと一緒に作る:Claude CodeやCodexのようなAIエージェントツールにPythonを書かせ、手元のデータを扱う作業に慣れます。チャットで質問するだけの使い方から一歩進むことが土台になります
- データを扱う:データを分析し、ABテストで差がたまたまかどうかを確かめる、顧客をグループに分ける、価格を予測するといった統計と機械学習の基本を身につけます
- 社内文書に答えるAI(RAG)を作る:社内の文書をAIが読める形に整え、検索して根拠つきで答える仕組みを作ります
- 業務を自動化するAIエージェントを作る:例えば、月ごとに形式が違うファイルを整える手順をAIに渡し、自分で進めながら求める成果物を作らせます
- ポートフォリオを作る:自分でテーマを選んで作品を作り、何をどう確かめられるようになったかまでをまとめます
学ぶ順番は人によって多少変わりますが、自分に足りない段を見つけて下から埋めていくと、作る力が積み上がりやすくなります。
データを扱う力には時間がかかる
5段のうち、時間がかかりやすいのは2段目のデータを扱う力です。数週間で身につくものではありません。Craft College データサイエンティスト養成講座でも、社内文書に答えるAIに入る前のデータ分析と統計・機械学習に16週を使っています。これは講座の設計上の配分で、誰にとってもこの期間が必要という意味ではありませんが、目安の1つになります。
なお、Pythonは手段です。Pythonを覚えただけでAIが作れるわけではなく、作る力の中心はデータを扱い、答えを数えて確かめる力にあります。
個人でAI開発を進めるときに必要なスキルの全体像や、未経験からの学習の進め方は、以下の記事でも解説しています。
参照記事:個人でAI開発するには?進め方から必要スキル・学習方法まで解説!
参照記事:未経験からAIエンジニアを目指す学習方法。独学ロードマップを6ステップで解説
AIを作るときに失敗しやすい4つのポイント
学ぶ順番が見えたところで、実際にAIを作り始めたときにつまずきやすい点を先に押さえておきます。
| 失敗しやすいポイント | 起きること | 対策 |
|---|---|---|
| 作ること自体を目的にする | 誰のどの仕事に使うかが決まらず、使われないAIが残る | STEP1で、任せる作業と正解の基準を先に書き出す |
| 1回試して合格にする | 出力が毎回変わるため、本番で精度が下がって見える | 同じ問題を複数回試し、20〜50問の単位で正答率を見る |
| テスト問題そのものを疑わない | 正答率が極端に低いとき、AIの能力不足と誤解する | 問題文や正解の付け方に誤りがないかを先に確認する |
| 公開後に直す仕組みを用意しない | 新しい質問や失敗が出ても精度が上がらない | 本番の失敗を記録し、評価用のデータに足す流れを決めておく |
3つ目について、Anthropicは、何度試しても正答率が0%のときは、たいていAIの能力不足ではなく、テスト問題の作り方が壊れているサインだと述べています(Anthropic『Demystifying evals for AI agents』)。4つのポイントはいずれも、作り方の5ステップのどこかを飛ばしたときに起きる失敗です。
まとめ
- AIを作るとは、業務やサービスの中で正しく動くAIの仕組みを作り、その答えの正しさに責任を持つこと。AIを使って開発することとは別の層の話
- 使う人と作る人の違いは答えの確かめ方にあり、作る人は大勢に出す答えをテスト問題で確かめる
- いま作られるAIの多くは学習済みモデルを借りて組み立てるため、数学から学び直さなくても作り始められる
- AIの作り方は、要件を決める、データを整える、仕組みを組む、テストで評価する、本番の失敗で直す、の5ステップを回し続けること
- 要件定義、データ連携、テスト、保守運用の経験は、作る工程にそのまま効く
- 最初の一歩は、仕事のよくある問いと正しい答えを書き出し、AIの答えが合っているかを数えること
ウェビナー資料(学習ロードマップ)の無料ダウンロード
「AI時代に『替えがきかないエンジニア』になる」というテーマで実施したウェビナーの内容をもとに、AIを作る側に進むための学習ロードマップをまとめています。必要になるスキルの全体像、役割ごとに変わる学習範囲、学ぶ順番を詳しく確認したい方は、以下からダウンロードしてください。
⇨資料のダウンロードはこちら
AIの作り方を学ぶなら「Craft College」へ
「AIの作り方の流れは分かったが、自分の経験がどの工程に活きるのか、何から学べばいいのかまでは決めきれない」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。AIと一緒に作るところから、データ分析、統計と機械学習、社内文書に答えるAI(RAG)、業務を自動化するAIエージェント、ポートフォリオ作成までを、6つのSTEPで段階的に学ぶ講座です。以下のようなニーズをお持ちの方に向いています。
- AIツールは使っているが、AIを組み込んだ仕組みを作る側に回りたい方
- 要件定義やテスト、データ連携などの経験を、AI開発に活かしたい方
- 独学ではデータの扱いや評価の方法でつまずき、止まってしまっている方
講座の期間は9ヶ月(36週)で、課題の添削と週1回の面談を通じて学びます。受講費用は693,000円(税込)です。
厚生労働省の専門実践教育訓練給付制度と、経済産業省の「第四次産業革命スキル習得講座(Reスキル講座)」の認定を受けています。専門実践教育訓練給付では、受講中に費用の50%が支給され、修了後1年以内に目標の資格取得などを経て雇用保険の被保険者として就職または在職した場合は累計70%、さらに賃金が受講開始前より5%以上上がった場合は累計80%が支給される可能性があります。対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、最終的にはハローワークが判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。


