
PyTorchとは。TensorFlowとの選び方と実務で詰まる3つの場所
PyTorchの入門記事は、たいてい「動的計算グラフだから柔軟」「NumPyに似た書き心地」で終わります。ところが実際に手を動かし始めると、止まる場所はそこではありません。
学習ループはどこまで書けば実務で使える形になるのか。CUDA out of memory はなぜ出て、何から手を付ければよいのか。学習したモデルを、他の人が使える形にどう配るのか。このあたりが書かれている記事は、あまり見かけません。
そこで本記事では、
- PyTorchの構成要素と、それぞれが担う工程
- 2026年時点でPyTorchとTensorFlowのどちらを選ぶかの判断軸
- 実務で崩れない学習ループの書き方
- GPUメモリが足りないときに見る順番
- 学習したモデルを推論に持っていく3つの経路
- 公開済みモデルを自社データに合わせる、という実務での使いどころ
を解説します。テンソルの作り方や四則演算といった入門部分は扱いません。すでにPyTorchを触り始めていて、次の一手を探している方に向けた内容です。
出典はPyTorch公式ドキュメント(2.14・2026年9月21日取得)を中心にしています。
「自社のデータでモデルを調整したいが、環境と進め方の設計から相談したい」という方は、リベルクラフトへご相談ください。
PyTorchとは。実務者が押さえる4つの構成要素
PyTorchは、Meta(旧Facebook)のAI研究部門から生まれた、Python向けの機械学習ライブラリです。深層学習のモデルを書いて学習させ、推論に使うまでを一式で扱えます。
入門記事で並ぶ機能の一覧より、先に押さえておきたいのは役割分担です。PyTorchのコードは、次の4つが噛み合って動いています。
Tensor・autograd・nn.Module・optimがそれぞれ担う工程
| 構成要素 | 担う工程 | 具体的に何をしているか |
|---|---|---|
| Tensor | データと勾配の器 | 数値の多次元配列。CPUとGPUのどちらに置くかを持ち、勾配も一緒に抱える |
| autograd | 微分 | 順伝播の計算を記録しておき、backward() で各パラメータの勾配を逆算する |
| nn.Module | パラメータの持ち主 | 重みとバイアスをまとめて持ち、parameters() で取り出せるようにする |
| torch.optim | 更新則 | 勾配を受け取って、重みをどう動かすかを決める。AdamWやSGDなど |
学習が止まったとき、原因がこの4つのどこにあるかで打ち手は変わります。勾配が流れていないのか、更新則が効いていないのか、デバイスの配置がずれているのか。役割で切り分けられると、原因の絞り込みが速くなります。
動的計算グラフという性質も、実利で捉えると分かりやすくなります。Pythonのif文やforループがそのまま計算グラフになるため、途中の値を print して確かめられます。学習が発散したときに、どの層の出力からおかしくなっているかを、その場で見に行けるということです。
なお、2026年9月21日時点で https://pytorch.org/docs/stable/ は2.14のドキュメントへ転送されます。2.14.0が公開されたのは2026年9月2日です。インストールのコマンドはOSとCUDAのバージョンで変わるため、公式のインストールページの指示に従ってください。
PyTorchとTensorFlowのどちらを選ぶか。2026年の判断軸
「研究はPyTorch、本番はTensorFlow」という説明をよく見かけます。これは2020年前後の構図で、いまの選択にはそのまま使えません。2026年時点で何が変わったかを、2つの事実から見ます。
ひとつめは、Hugging Face Transformers v5の移行ガイドが、TensorFlowとJAXのコードを削除し、torch を唯一のbackendにすると明記したことです。公開モデルの多くをTransformers経由で調達する以上、これは選択に直接効きます。
ふたつめは、Keras 3が KERAS_BACKEND で jax・tensorflow・torch から選べるようになったことです。「Kerasの書きやすさ」は、もうTensorFlowを選ぶ理由にはなりません。
プロジェクトごとの判断軸4つ
| 判断軸 | 見るところ |
|---|---|
| モデルの調達先 | 使いたいモデルがどのフレームワークで配布されているか。Transformers経由ならPyTorch |
| 既存コードの資産 | チームが持っている学習コードがどちらで書かれているか |
| 推論基盤 | 本番の推論環境が何を受け付けるか。ONNXを受けるなら、学習側の自由度は上がる |
| 運用できる人 | 社内に、そのフレームワークで詰まったときに追える人がいるか |
4つの軸のうち、多くのプロジェクトで最初に決着がつくのは「モデルの調達先」です。画像分類や物体検出、文章の分類や要約といった用途では、公開済みの学習済みモデルを起点にすることがほとんどです。その配布元がTransformers経由である以上、学習側をPyTorchに揃えておけば、モデルを読み込んでから自社データで調整するまでの間に変換の手間が入りません。
逆に「既存コードの資産」と「運用できる人」は、チームごとに答えが変わる軸です。TensorFlowで数年運用してきた学習基盤があり、そこで詰まったときに追える人も社内にいるなら、フレームワークの人気だけを理由に乗り換える根拠は弱くなります。
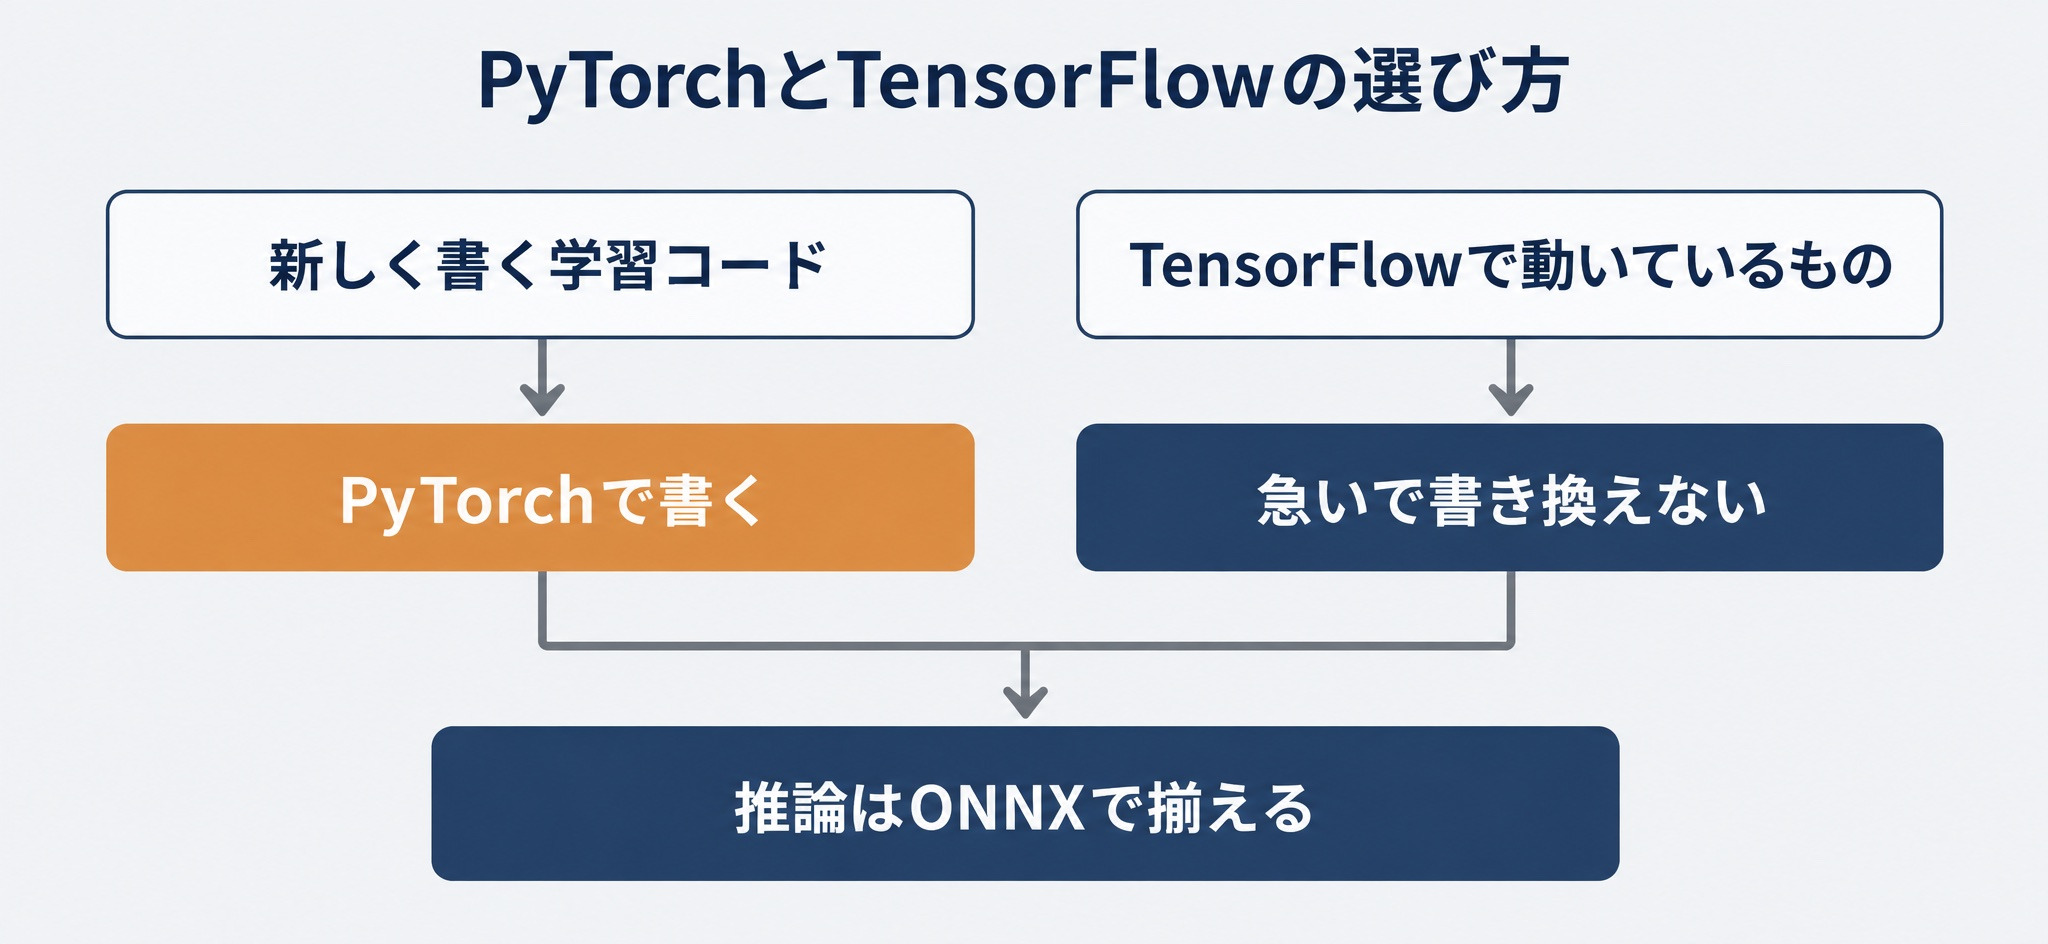
すでにTensorFlowで動いているものがある場合、書き換えを急ぐ必要はありません。新規の学習コードからPyTorchに寄せ、推論側はONNXで揃える、という線が現実的です。どのモデルを調達できるかという判断の材料は、オープンソースLLMの選び方でも扱っています。
PyTorchの学習ループを、実務で崩れない形に書く
PyTorchの学習ループの最小構成は5つです。model.train()、順伝播、loss.backward()、optimizer.step()、optimizer.zero_grad()。公式チュートリアルもこの形です。
ただし最小構成のままでは、実務に入った途端に足りなくなります。足すのは次の4点です。
- 評価を分ける。
model.eval()とtorch.no_grad()を使い、評価だけ別関数に切ります。DropoutとBatchNormは学習時と評価時で挙動が変わるため、混ぜると数字が信用できなくなります - 混合精度を入れる。
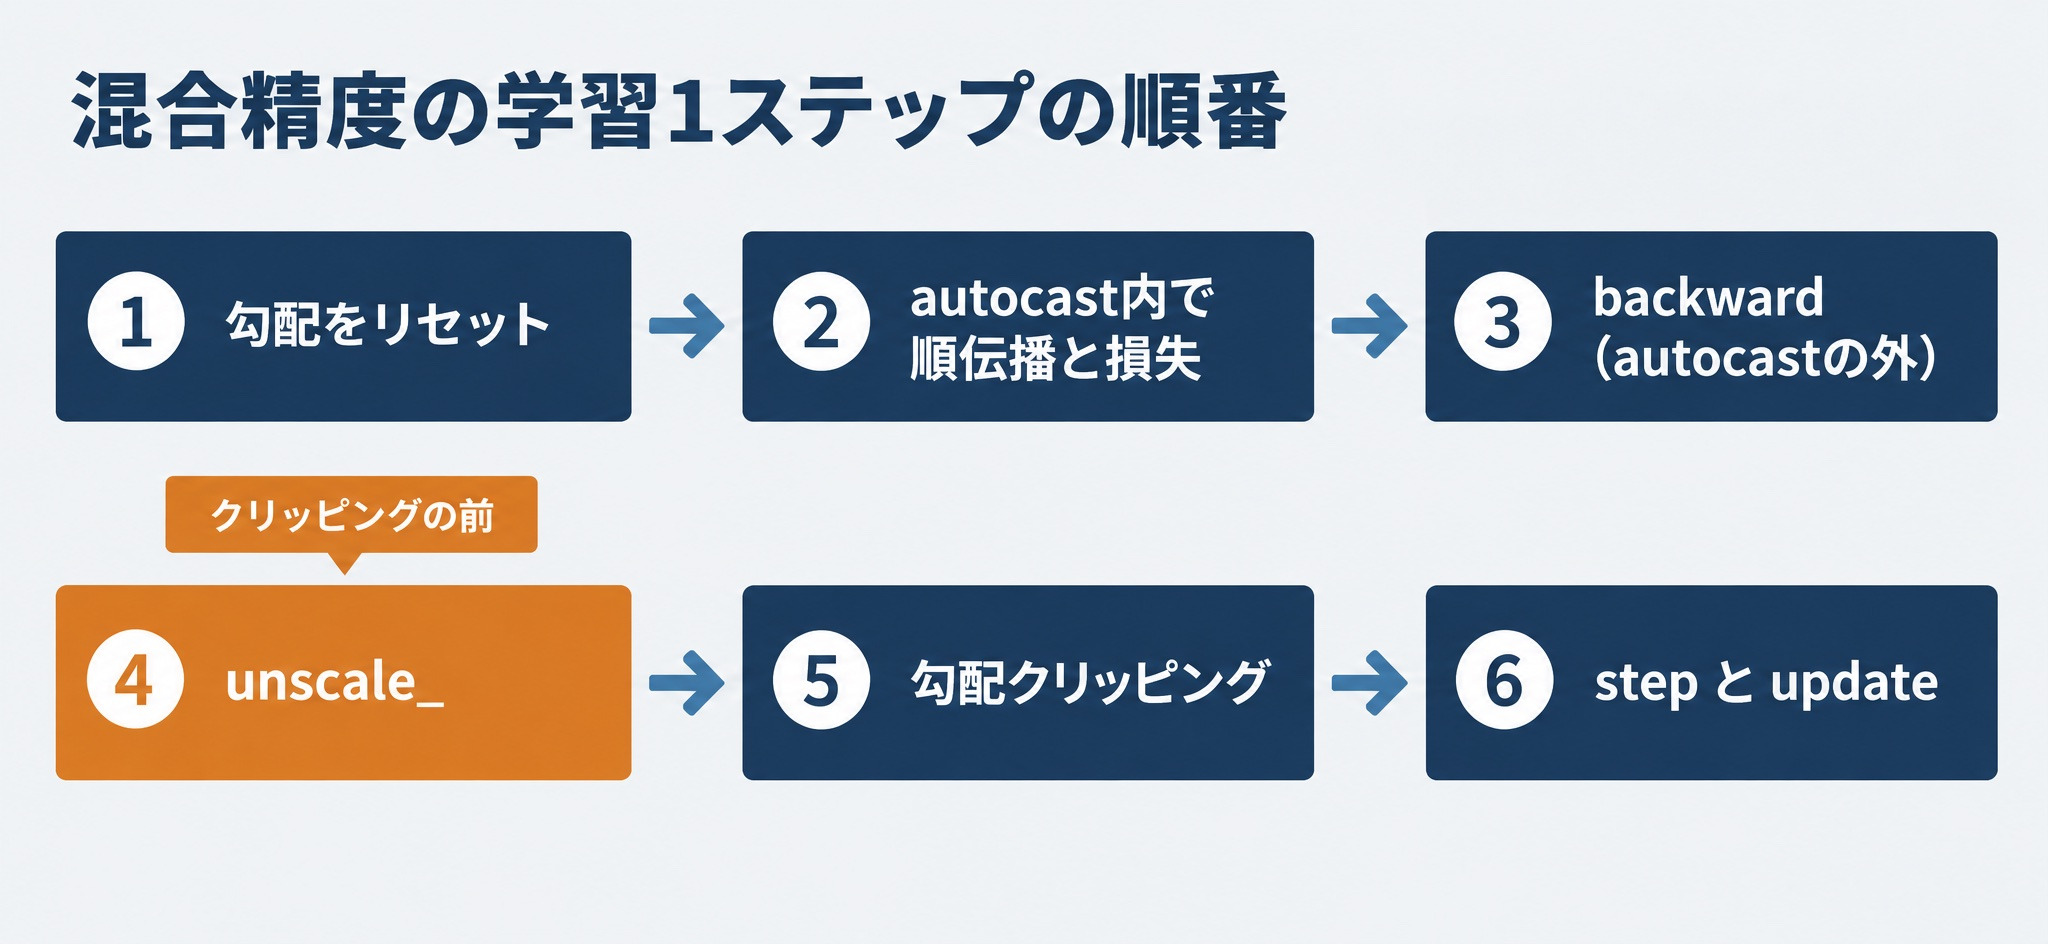
torch.autocastとtorch.amp.GradScalerを使います。CUDAの既定はtorch.float16、CPUの既定はtorch.bfloat16です。torch.cuda.amp.autocast形式は非推奨で、torch.amp.autocast("cuda", ...)に統一されました - 勾配クリッピングの順番に注意する。
clip_grad_norm_の前にscaler.unscale_(optimizer)を呼びます。スケールがかかったままの勾配を切ると、max_normに指定した上限が本来の勾配に対して効きません - チェックポイントを保存する。モデルとオプティマイザの
state_dictを一緒に保存しないと、学習を途中から再開できません
もうひとつ、公式のAutomatic Mixed Precisionのドキュメントが「Backward passes under autocast are not recommended」と明記している点も押さえておきます。backward() はautocastブロックの外に出します。
混合精度を入れると、1ステップの中で呼ぶ処理が増え、順番を1つ入れ替えただけで結果が静かに崩れます。エラーが出ないため気づきにくいので、次の順番を基準にコードを確認してください。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

device = "cuda" if torch.cuda.is_available() else "cpu"
use_amp = device == "cuda"
amp_dtype = torch.float16 if use_amp else torch.bfloat16

# 実際は自社データのDatasetに差し替える
x = torch.randn(1024, 32)
y = torch.randint(0, 3, (1024,))
loader = DataLoader(
    TensorDataset(x, y),
    batch_size=64,
    shuffle=True,
    num_workers=0,  # 増やす場合は if __name__ == "__main__": の中で実行する
    pin_memory=use_amp,
)

model = nn.Sequential(nn.Linear(32, 128), nn.ReLU(), nn.Linear(128, 3)).to(device)
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
scaler = torch.amp.GradScaler(device, enabled=use_amp)

for epoch in range(3):
    model.train()
    for xb, yb in loader:
        xb = xb.to(device, non_blocking=True)
        yb = yb.to(device, non_blocking=True)
        optimizer.zero_grad(set_to_none=True)
        with torch.autocast(device_type=device, dtype=amp_dtype, enabled=use_amp):
            loss = loss_fn(model(xb), yb)
        scaler.scale(loss).backward()          # backwardはautocastブロックの外
        scaler.unscale_(optimizer)             # クリッピング前にスケールを戻す
        nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        scaler.step(optimizer)
        scaler.update()

    torch.save(
        {
            "epoch": epoch,
            "model": model.state_dict(),
            "optimizer": optimizer.state_dict(),
        },
        f"checkpoint_{epoch}.pt",
    )


@torch.no_grad()
def evaluate(model, loader, device):
    model.eval()
    correct = total = 0
    for xb, yb in loader:
        xb, yb = xb.to(device), yb.to(device)
        pred = model(xb).argmax(dim=1)
        correct += (pred == yb).sum().item()
        total += yb.numel()
    return correct / total
num_workers を増やす場合は、if __name__ == "__main__": の中で実行する必要があります。ここを忘れると、Windowsやmacosでプロセスが無限に増えます。
再現性については、シードを固定しただけでは結果が揃わない点に注意してください。cuDNNの非決定的なアルゴリズムや、DataLoaderのワーカーの順序が影響します。論文の数値を1桁まで再現する必要がある場合は別途設定が要りますが、業務で使うモデルを作るだけなら「おおむね揃う」程度で進めるほうが現実的です。
学習ループでよくある3つの誤り
学習ループは動いているように見えても、次の3つの誤りを抱えたまま数字だけが出ていることがあります。
- 損失をテンソルのまま足し込む。エポックの平均損失を記録するために
total_loss += lossと書くと、各ステップの計算履歴がtotal_lossにぶら下がったまま残ります。公式のFAQは「Don’t accumulate history across your training loop」と書き、float(loss)で数値に変換してから足す方法を示しています。ステップを重ねるごとにGPUメモリが少しずつ増えていく場合は、まずここを疑います - 勾配のリセットを忘れる。PyTorchの
backward()は、既存の勾配に新しい勾配を足し込みます。optimizer.zero_grad()を呼ばないと、前のステップの勾配が混ざったまま更新が進みます。この足し込む性質は、次の章で扱う勾配累積に使われている仕組みでもあります - 最後のエポックのチェックポイントを採用する。学習用データの損失が下がり続けていても、評価データの正解率が途中から下がることがあります。これは過学習の典型的な兆候です。
evaluateの結果をエポックごとに記録し、評価データで最も良かったエポックのチェックポイントを採用します
PyTorchでGPUメモリが足りないときに見る順番
実務で最も頻繁に当たる壁です。CUDA out of memory が出たときに、いきなりバッチサイズをいじる前に、まず測ります。
測り方。allocatedとreservedは別物
PyTorchが報告するメモリには2種類あります。
torch.cuda.memory_allocated()とmax_memory_allocated()は、テンソルが実際に占めている量torch.cuda.memory_reserved()とmax_memory_reserved()は、キャッシングアロケータが確保している量
公式ドキュメントは「the unused memory managed by the allocator will still show as if used in nvidia-smi」と書いています。つまり nvidia-smi の数字は後者に近く、テンソルの占有量そのものではありません。
この違いを知らないまま torch.cuda.empty_cache() を叩いても、解放されるのはアロケータのキャッシュだけです。テンソルが占めている分は減りません。
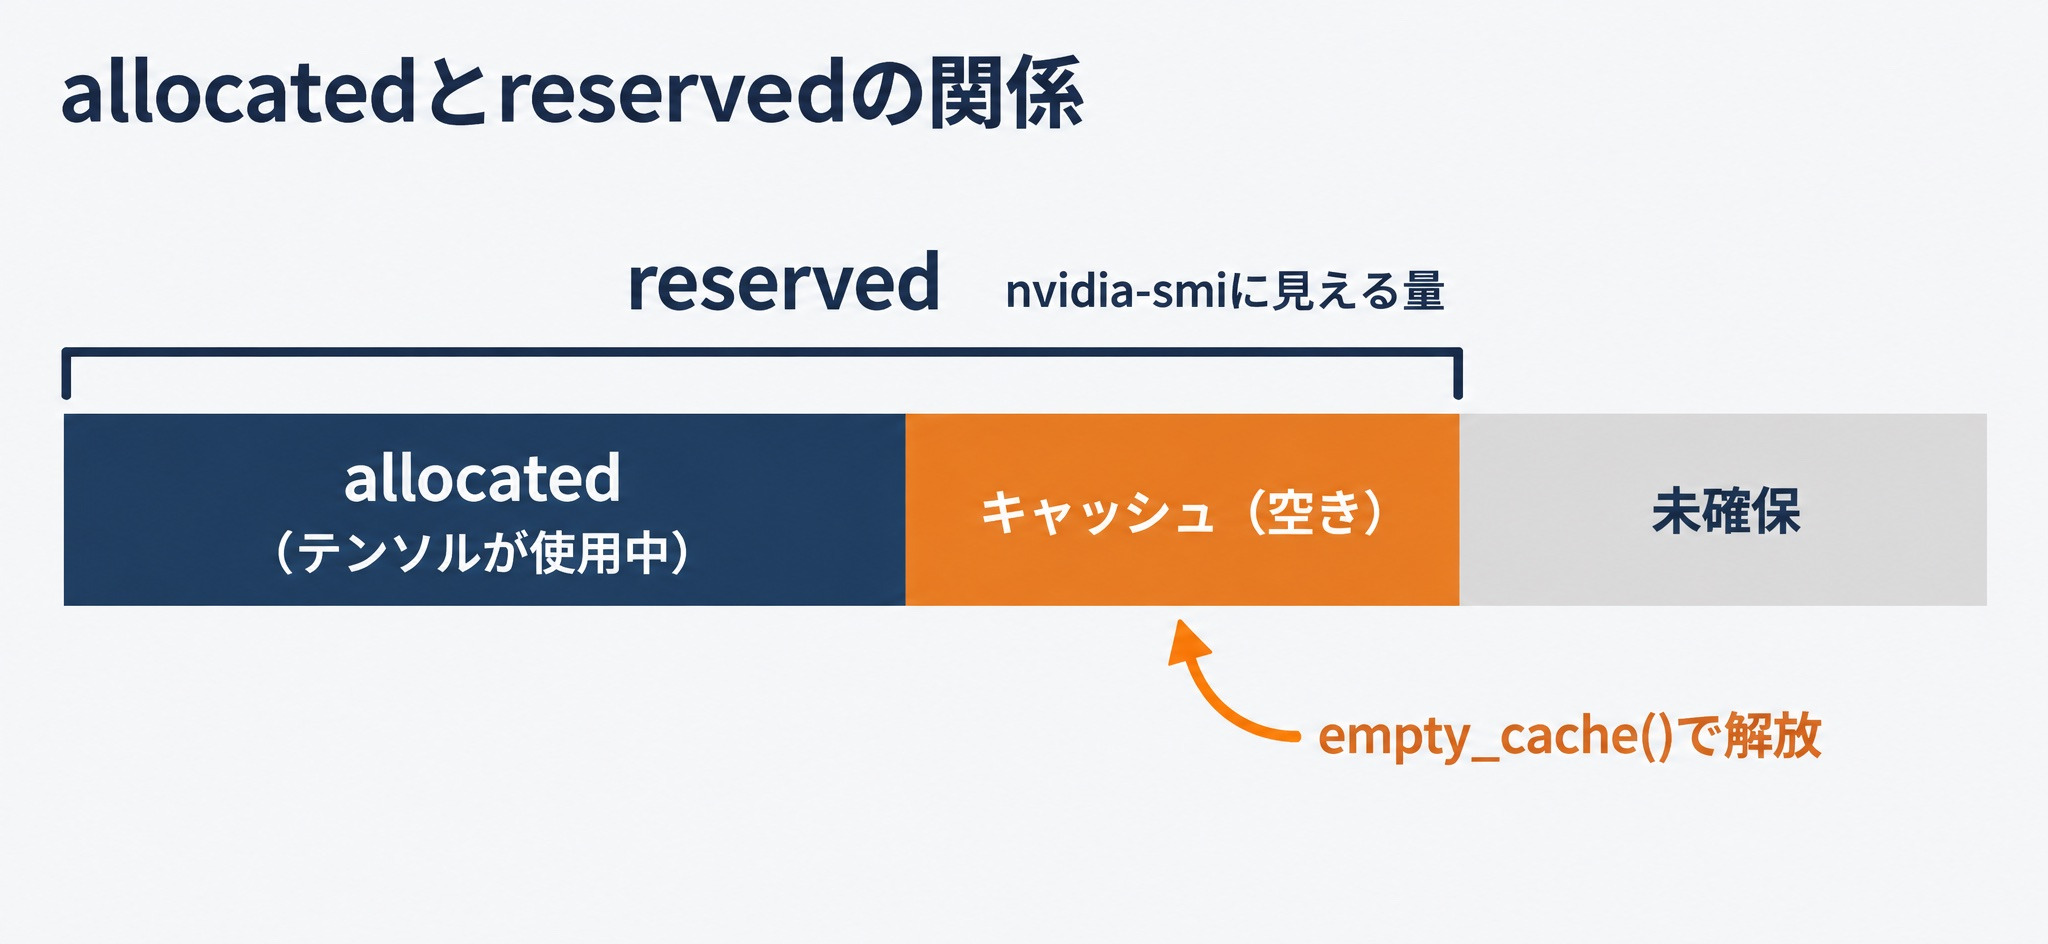
図のとおり、nvidia-smi で残りが少なく見えても、テンソルが実際に使っている量はそれより小さいことがあります。逆に empty_cache() の後も memory_allocated() の値が減らない場合は、テンソルへの参照がどこかに残っています。
import torch

GB = 1024 ** 3


def show_gpu_memory(tag: str = "") -> None:
    if not torch.cuda.is_available():
        return
    print(
        f"[{tag}] "
        f"allocated={torch.cuda.memory_allocated() / GB:.2f}GB "
        f"peak={torch.cuda.max_memory_allocated() / GB:.2f}GB "
        f"reserved={torch.cuda.memory_reserved() / GB:.2f}GB"
    )


if torch.cuda.is_available():
    torch.cuda.reset_peak_memory_stats()
    show_gpu_memory("学習開始前")
どの確保が効いているかまで見たい場合は、スナップショットを取ります。
import torch

torch.cuda.memory._record_memory_history(max_entries=100_000)
# ここで学習を数ステップだけ回す
torch.cuda.memory._dump_snapshot("snapshot.pickle")
torch.cuda.memory._record_memory_history(enabled=None)
出力した snapshot.pickle を https://pytorch.org/memory_viz のビューアに読み込ませると、どの確保がいつ起きたかを時系列で追えます。アンダースコアで始まる非公開APIのため、将来仕様が変わる可能性はあります。またNCCLのようにPyTorchのアロケータの外で確保されるメモリは、ここには現れません。
学習中のGPUメモリを使う4つの内訳
対処を選ぶ前に、学習中に何がメモリを占めているかを分けておきます。学習中のGPUメモリは、おおむね次の4つに分かれます。
| 内訳 | 何に比例するか |
|---|---|
| パラメータ | モデルのパラメータ数 |
| 勾配 | 更新するパラメータ数 |
| オプティマイザの状態 | 更新するパラメータ数。AdamWは1つのパラメータにつき、勾配の移動平均と2乗の移動平均の2つを持つ |
| 活性値 | バッチサイズと層の数。逆伝播のために順伝播の途中結果を保持する |
float32で学習する場合、1つの値は4バイトです。AdamWではパラメータ・勾配・2つの状態で、1パラメータあたり16バイトになります。1億パラメータのモデルなら、活性値を除いても約1.6GBを使う計算です。AdamWの公式ドキュメントが示すとおり、状態はパラメータごとに保存されます。
この内訳を持っておくと、次の5つの対処がそれぞれどこを減らすのかが分かります。バッチサイズの引き下げと torch.utils.checkpoint は活性値を、混合精度は活性値の精度を、更新するパラメータを絞る手法は勾配とオプティマイザの状態を減らします。
効き目の大きい順に5つ
- バッチサイズを下げる。最も効きます。精度への影響は学習率とセットで調整します
- 混合精度を入れる。学習ループのところで入れた
autocastがそのまま効きます - 勾配累積を使う。小さいバッチを複数回まわしてから更新し、実効的なバッチサイズを保ちます。バッチサイズ16で4回累積すれば、実効的なバッチサイズは64です。各ステップの損失を累積回数で割ってから
backward()を呼び、optimizer.step()とzero_grad()は累積回数ごとに1回だけ呼びます torch.utils.checkpointで活性値を捨てる。逆伝播のときに再計算します。計算時間と引き換えにメモリを減らす手です- アロケータを設定する。断片化が疑われる場合だけ。環境変数の正式名は
PYTORCH_ALLOC_CONFで、PYTORCH_CUDA_ALLOC_CONFは後方互換の別名です。max_split_size_mb・garbage_collection_threshold・per_process_memory_fractionなどを指定できます
5番から手をつけないでください。断片化はそれほど多い原因ではなく、設定をいじっても解決しないまま時間だけが過ぎます。1番から順に試すほうが早く着きます。
そもそもどのくらいのGPUが要るのかという見積りは、ローカルLLMに必要なGPUスペックで扱っています。
ここまで切り分けの手順を見てきましたが、「自社のGPUで本当に回しきれるのか、メモリと速度の折り合いをどこで付けるのかが判断できない」という方は、リベルクラフトへご相談ください。
リベルクラフトは、ファインチューニングとローカルLLM構築の受託実績があります。更新するパラメータを絞る設計、学習環境と推論環境の分け方、評価データの作り方を、実際の案件で組み立ててきました。いまのGPUと納期で足りるのか、どこを変えれば足りるのかを、扱うデータと社外に出せる範囲から一緒に整理します。
⇨AI開発の無料相談はこちら
学習したPyTorchモデルを推論に持っていく
学習が終わったモデルを、他の人が使える形にする段階です。経路は3つあります。
| 経路 | 向いている場面 | 注意点 |
|---|---|---|
| Pythonプロセスを常駐させる | 手早く動かしたいとき | 依存関係とGPUを抱えたままになる |
torch.export でグラフを固める | Pythonの外へ持ち出す公式の経路 | グラフが切れる書き方だとエクスポートに失敗する |
| ONNXに変換する | 既存の推論基盤がONNXを受けるとき | 変換できない演算があると詰まる |
torch.export.export() は、モデルの計算グラフを追跡して ExportedProgram に包みます。torch.compile と同じTorchDynamoを使いますが、公式は「does not support graph breaks」と書いています。Pythonの分岐がグラフを切る書き方をしていると、エクスポートで失敗します。
ここから分かるのは、エクスポートできる書き方を、学習コードの段階から意識しておく必要があるということです。学習が終わってから書き直すのは手戻りになります。
もうひとつ詰まりやすいのが入力の形です。torch.exportのチュートリアルは「By default, torch.export produces a static program」と書いています。バッチサイズ1の例でエクスポートすると、その形に固定され、バッチサイズを変えた入力は受け付けません。推論時に件数をまとめて流したい場合は、dynamic_shapes 引数でバッチの次元を可変に指定します。指定には torch.export.Dim を使い、Dim.AUTO を渡すと、どの次元を可変にできるかをトレースから判断させられます。
ONNXへの変換も、いまは同じ仕組みの上にあります。ONNXエクスポートの公式ドキュメントによると、torch.onnx.export は2.9から dynamo=True が既定になり、torch.export を土台に変換します。torch.export で失敗する書き方は、ONNX変換でも失敗すると考えておくと、3つの経路のどれを選んでも手戻りを減らせます。
3つの経路の選び方は、推論を誰がどこで動かすかで決まります。社内の検証で自分たちだけが使うならPythonプロセスの常駐で足ります。他のチームのサービスに組み込む、推論専用のサーバーに載せるといった場面では、受け取る側がONNXを扱えるかを先に確かめ、扱えるならONNX、扱えないなら torch.export を選びます。
import torch
from torch import nn

model = nn.Sequential(nn.Linear(32, 128), nn.ReLU(), nn.Linear(128, 3))
model.eval()

example = torch.randn(1, 32)
exported = torch.export.export(model, (example,))
torch.export.save(exported, "model.pt2")

# 別のプロセスや別の環境で読み込む
loaded = torch.export.load("model.pt2").module()
with torch.inference_mode():
out = loaded(torch.randn(1, 32))TorchScriptについては、2.14のドキュメントで単独ページ(jit.html)が torch.compiler_api.html へ転送されるようになりました。新規の実装では選ばない、と判断してよい段階に入っています。既存のTorchScript資産をいますぐ捨てる必要はありません。
推論側で最初に効くのは model.eval() と torch.inference_mode() です。この2つを入れ忘れると、余計な勾配計算が走り、速度もメモリも損をします。
PyTorchの実務用途は「ゼロから学習」より「借りたモデルを自社データに合わせる」
ここまで学習から推論までを見てきましたが、実務でPyTorchを使う場面の多くは、ゼロからのモデル設計ではありません。公開済みのモデルを自社のデータに合わせる作業です。
全部を更新しないのが、いまの標準
Hugging Face PEFTの公式ドキュメントは「PEFT methods only fine-tune a small number of (extra) model parameters」と書いています。全パラメータを更新しない手法が標準になっています。
これは前章のGPUメモリの話と直結します。更新するパラメータが減れば、オプティマイザが持つ状態のメモリも減ります。手元のGPUで回るかどうかの分かれ目が、ここにあることは少なくありません。
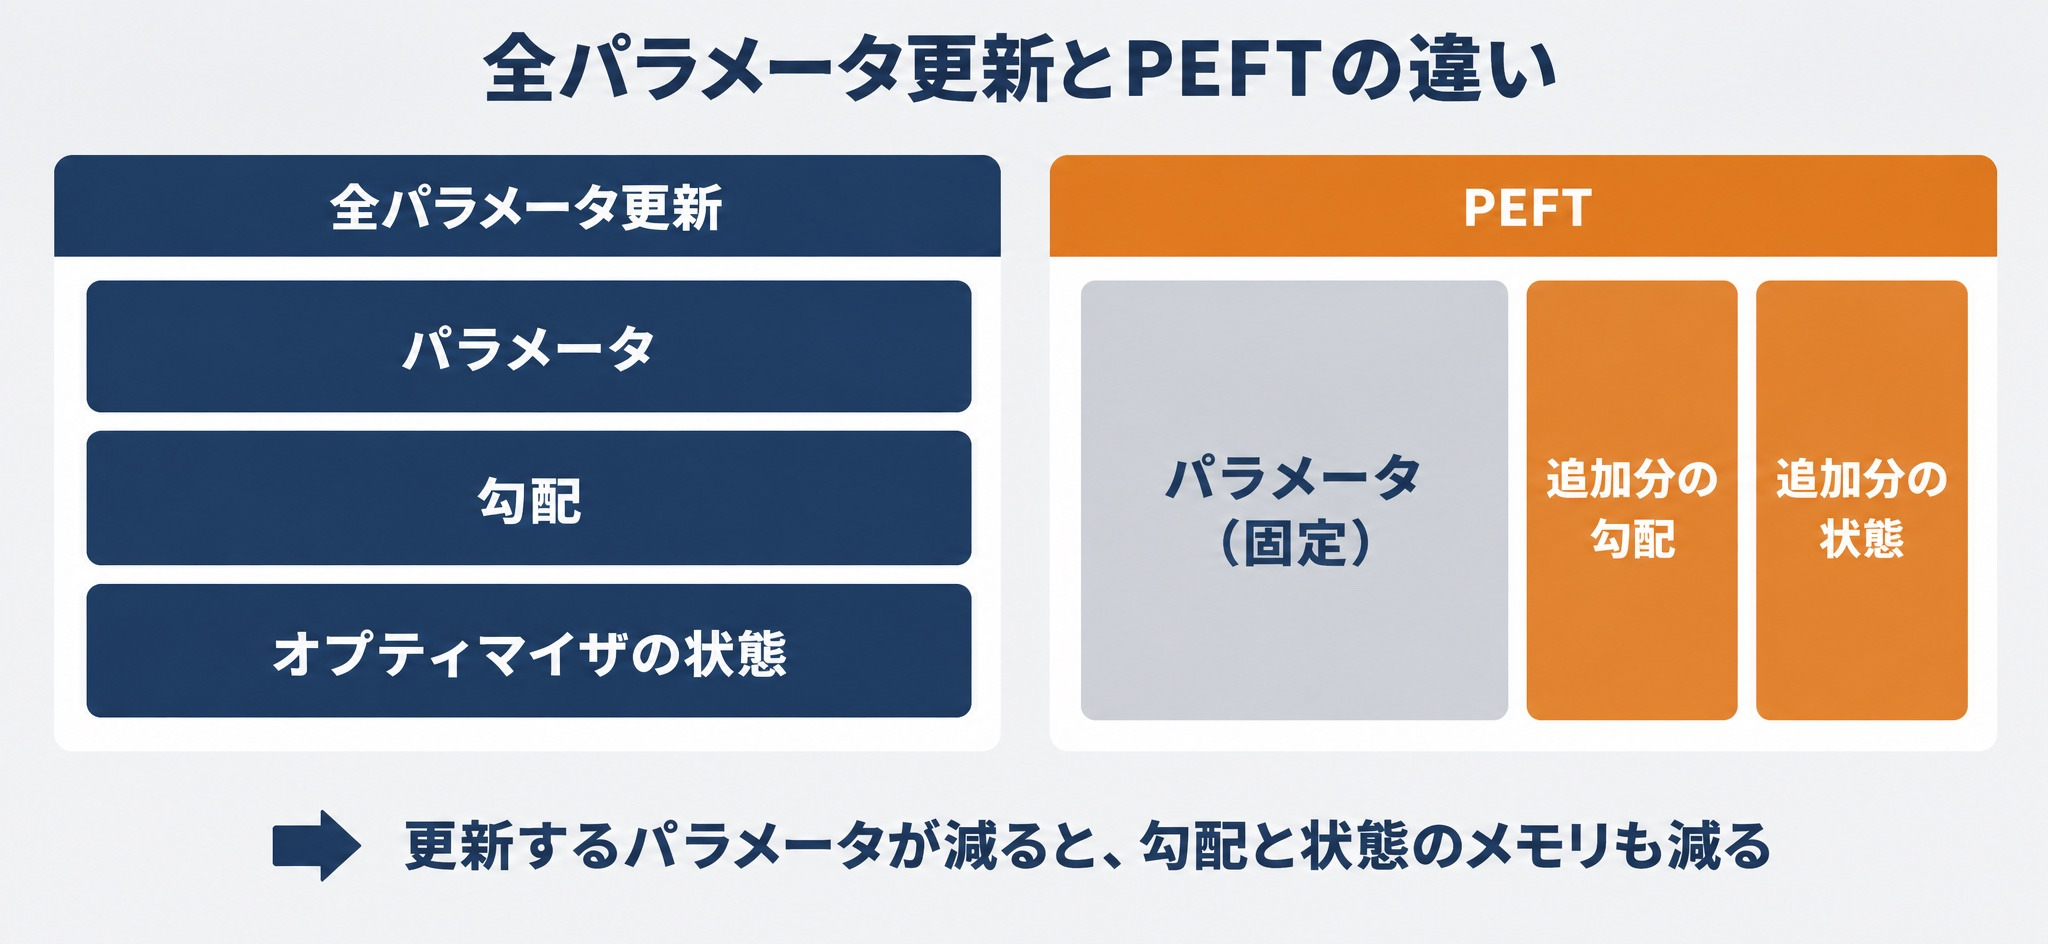
PEFTの代表的な手法であるLoRAは、元のモデルの重みを固定し、小さな行列を追加してその部分だけを学習します。前章の4つの内訳に当てはめると、パラメータ本体の分は残りますが、勾配とオプティマイザの状態は追加した小さな行列の分だけで済みます。AdamWの2つの状態がモデル全体にかからないため、同じGPUで扱えるモデルの規模が変わります。
学習済みモデルを起点に自社用のモデルを作る方法は転移学習とファインチューニングの違いで、基本的な仕組みはファインチューニングとはで扱っています。
LLMを自社データに合わせる場合
対象がLLMの場合は、扱うパラメータ数の桁が変わるため、前提も変わります。LLMとはで全体像を、LLMファインチューニングの実装5ステップで手順を、ローカルLLMで自社環境に置く場合の構成を整理しています。
自社データで調整する前に決める3点
- 評価データを先に作る。どの質問にどう答えられれば成功なのかを、学習を始める前に固定します。後から決めると、都合の良い基準に寄ります
- 学習の単位を決める。どのモデルを、どの粒度のデータで、何を更新するのか。ここが曖昧なまま回すと、良くなったのか悪くなったのかが判断できません
- データとモデルを置く環境を決める。学習環境と推論環境を分けるか。そもそも外部のAPIに出してよいデータなのか。ここは技術より先に決まっていることが多い項目です
ある製造業のお客様では、社外に出せない図面と仕様書を扱う必要があり、3番目の条件から構成が決まりました。使えるモデルや手法を広げて考える前に、社外に出せるデータの範囲を確定させるほうが、結果的に早く進みます。
まとめ。PyTorchでのモデル開発・ファインチューニングは「リベルクラフト」へ
- PyTorchはTensor・autograd・nn.Module・torch.optimの4つで動いている。止まったときはこの役割分担で切り分ける
- 2026年時点では、Transformers v5がPyTorchを唯一のbackendにし、Keras 3がbackendを選べるようになった。「研究はPyTorch、本番はTensorFlow」という構図はもう使えない
- 学習ループの最小構成に、評価の分離・混合精度・勾配クリッピングの順番・チェックポイントの4点を足す
- GPUメモリは測ってから手を打つ。allocatedとreservedは別物で、バッチサイズから順に試す
- 学習したモデルを外へ出す公式の経路は
torch.export。エクスポートできる書き方を学習時から意識する
「自社のデータでモデルを調整したいが、環境の設計から詰まっている」と感じた方も多いのではないでしょうか?
リベルクラフトは、ファインチューニングとローカルLLM構築の受託開発を行っています。限られたGPUで学習と推論を成立させる構成、社外に出せないデータを前提とした環境設計、評価データの作り方まで、要件定義から本番運用まで一貫してお手伝いしています。
受託ではなく、ご自身のチームで回せる状態を目指す場合は、Craft CollegeのDS ADVANCEDという進め方もあります。3ヶ月で、Fine-tuningとW&B・MLflowでの評価・精度改善を扱う、データサイエンティストとエンジニアの実務者向けの講座です。
⇨AI開発・ファインチューニングのご相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。


