バイブコーディングとは?意味と始め方、AI任せのコードを実験で検証した結果も解説
「バイブコーディングという言葉をよく聞くが、AIを使った開発と何が違うのか分からない」「AIに任せたコードを、仕事でそのまま使ってよいのか迷う」という方も多いのではないでしょうか?
バイブコーディングは2025年に一気に広まった言葉で、今では「AIに自然言語で指示して作る開発」全般を指して使われることもあります。ただし、提唱者が最初に示した意味はもっと狭く、「AIが書いたコードを読まずに、動くかどうかだけで判断する作り方」でした。この違いを押さえないと、試作では便利でも、業務のコードでは思わぬ誤りを抱えることになります。
そこで本記事では、
- バイブコーディングとは何か。提唱者の定義と、ノーコードや通常のAI活用開発との違い
- バイブコーディングのメリット、使うツールと始める5つのステップ
- Claude Codeに作らせたスクリプトを7つのCSVで動かした検証の結果と、公表されているリスクや事故、企業で使うときの手順
を解説します。ツールの規約は2026年9月23日に確認した各社の公式ドキュメントに基づきます。
AIコーディングツールを取り入れた開発や、社内での使い方の設計を検討している方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
バイブコーディングとは。AIに任せ、コードを読まずに作る開発の進め方
バイブコーディングは、AIに作りたいものを言葉で伝え、出てきたコードを細かく読まずに、動くかどうかで次の指示を決める作り方です。まず言葉の由来と、どこまでをバイブコーディングと呼ぶのかを整理します。
バイブコーディングの意味と語源
バイブコーディング(Vibe Coding)とは、AIに自然言語で指示を出し、生成されたコードの中身を確かめずに受け入れ、動作の結果だけを見て開発を進めるやり方を指します。「vibe」は英語で「雰囲気」「ノリ」という意味です。
この言葉は、OpenAIの共同創業者で、テスラでAI部門を率いたアンドレイ・カルパシー氏が、2025年2月2日(米国時間)にXへ投稿したことで広まりました(カルパシー氏の投稿)。投稿では、次のように説明されています。
- 雰囲気に完全に身を任せ、コードが存在することさえ忘れる、新しい種類のコーディング
- AIの変更は常に「すべて受け入れる」で、差分(変更箇所)はもう読まない
- エラーが出たら、エラーメッセージをそのままAIに貼り付ける
- 使い捨ての週末のプロジェクトなら悪くない
投稿の全文は、ソフトウェア開発者のSimon Willison氏がブログで引用しています(Simon Willison’s Weblog)。言葉はその後も広がり、英国のCollins辞書は2025年の「Word of the Year」にvibe codingを選びました(Collins Dictionary)。
AIを使った開発のすべてがバイブコーディングではない
言葉が広まるにつれて、AIに指示してコードを書く開発を、すべてバイブコーディングと呼ぶ使い方も増えました。国内の解説記事でも、定義の広さは記事ごとに違います。
これに対してWillison氏は、先のブログで次のように区別しています。AIがコードを書いたとしても、そのコードを人がレビューし、十分にテストし、どう動くのかを説明できる状態にしたなら、それはバイブコーディングではなく、ソフトウェア開発だという考え方です。
本記事でもこの区別に従い、「AIの出したコードを人が読まず、確かめないまま使う」ことを、バイブコーディングの核心として扱います。同じAIのツールを使っていても、レビューとテストをするかどうかで呼び方が変わります。
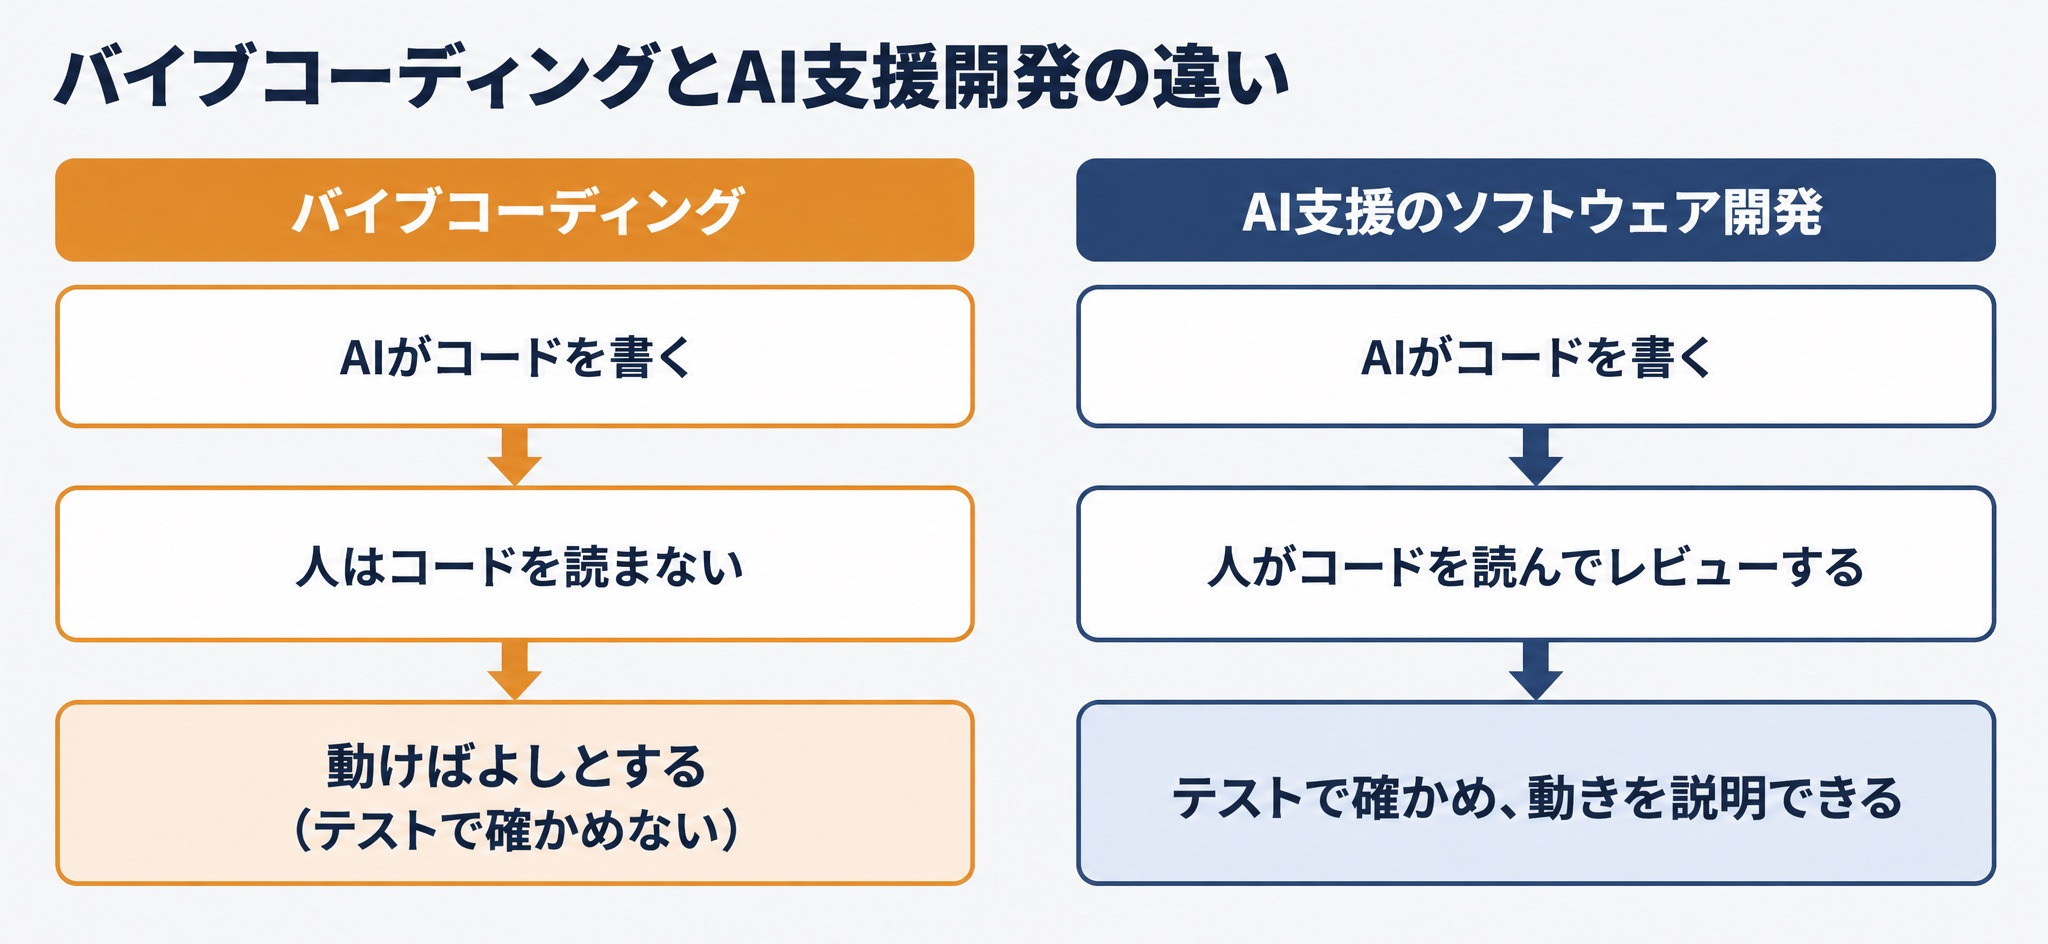
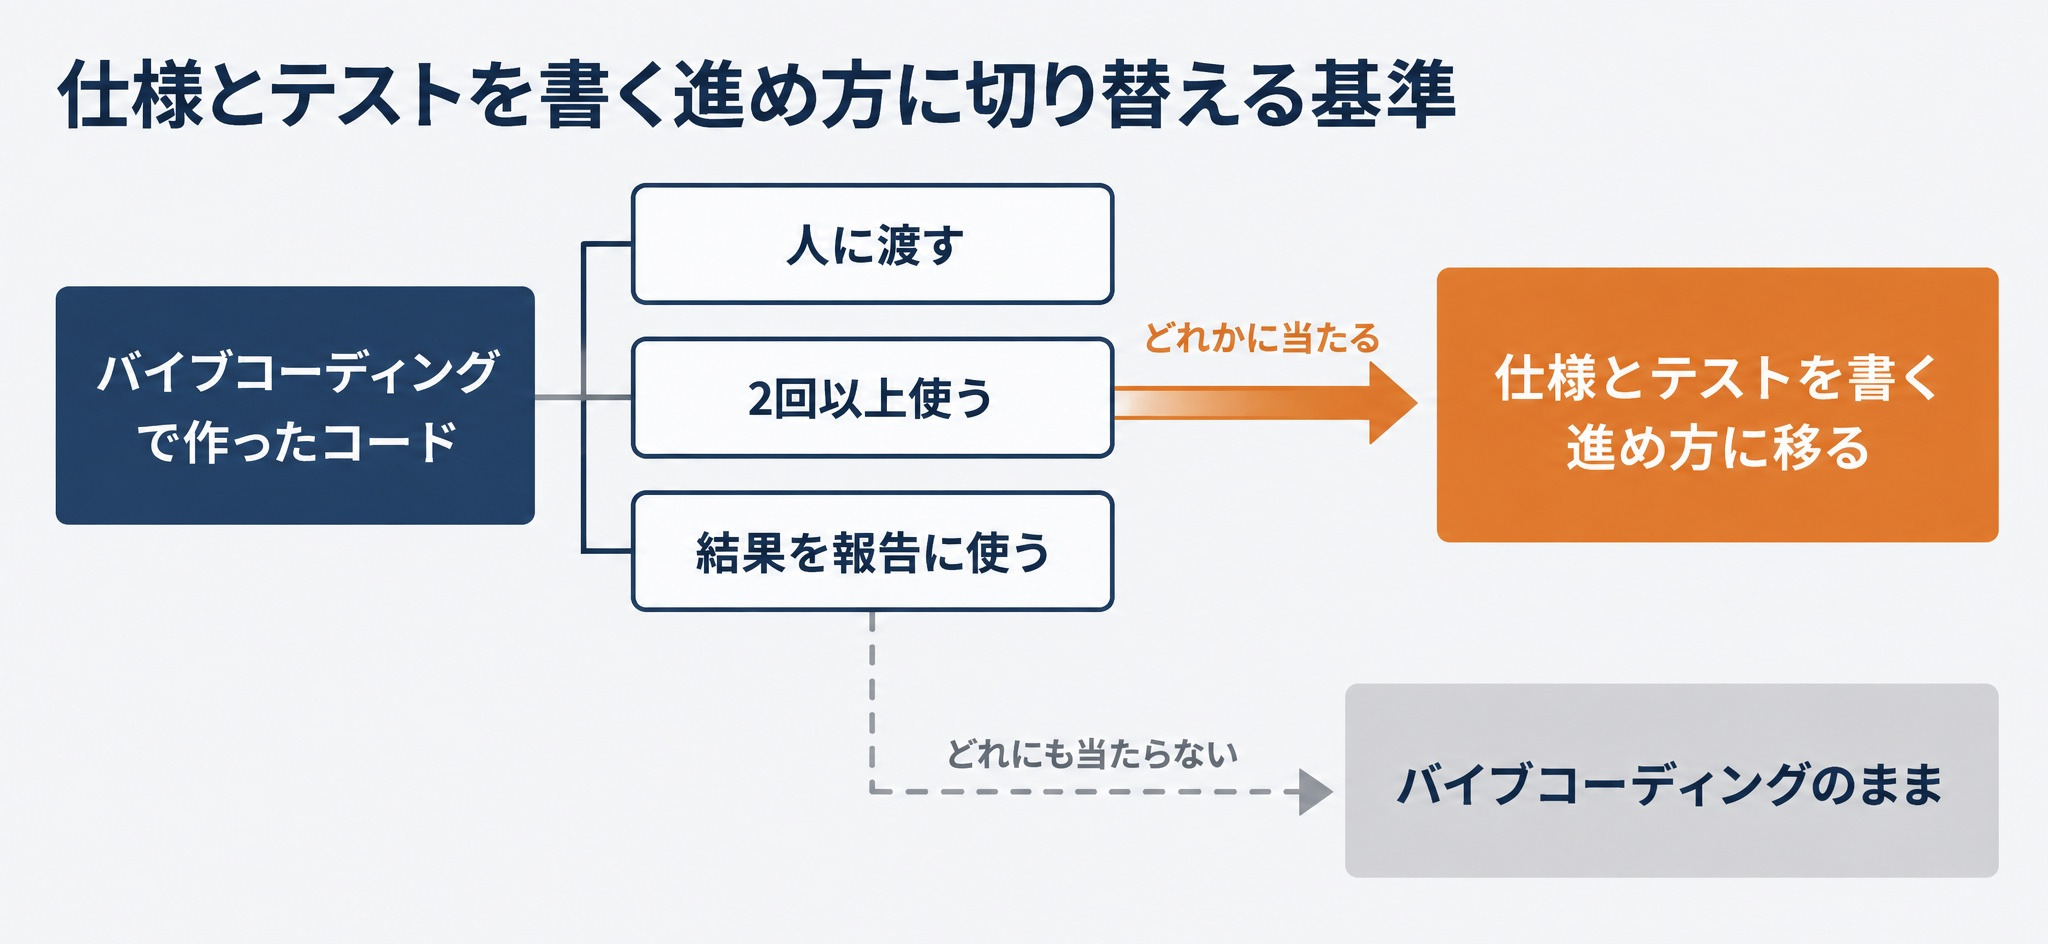
図のように、分かれ目はAIを使うかどうかではなく、人が結果を確かめる工程を残すかどうかにあります。
2026年には「エージェンティックエンジニアリング」という呼び名も
提唱者のカルパシー氏は、最初の投稿から1年たった2026年2月4日に、振り返りの投稿をしています(カルパシー氏の投稿)。
その中で同氏は、最初の投稿は思いつきで出したものだったと述べたうえで、プロの開発者がAIのエージェントを使い、品質を落とさずに開発する進め方を、バイブコーディングと区別する呼び名として「agentic engineering(エージェンティックエンジニアリング)」を挙げました。エージェントとは、目的を受け取り、ファイルの編集やコマンドの実行といった手順を自分で進めるAIを指します。
同氏の説明では、「agentic」は、人がコードを直接書くことはほとんどなくなり、コードを書くエージェントを指揮して監督する役に回ることを表します。「engineering」は、そこに技術と専門性があり、学んで上達できるものだということを強調しています。つまり提唱者自身も、遊びの作り方と仕事の作り方を分けて考えています。
バイブコーディングとノーコード・従来の開発の違い
バイブコーディングの意味を押さえたところで、似ている作り方との違いを整理します。比べる軸は「誰がコードを書くか」「人がコードを読むか」「品質を何で担保するか」の3つです。
| 作り方 | 誰がコードを書くか | 人がコードを読むか | 品質を何で担保するか | 向く用途 |
|---|---|---|---|---|
| 従来の開発 | 人 | 読む(書いた本人と、レビューする人) | 設計・レビュー・テスト | 本番のシステム全般 |
| AI支援開発 | 主にAI | 読む(差分をレビューする) | 仕様・レビュー・テスト | 本番のシステム、チームで保守するコード |
| バイブコーディング | AI | 読まない | 動かした結果を目で見るだけ | 試作、個人用の道具、一度きりの作業 |
| ノーコード | 書かない(部品と設定を組み合わせる) | コードが無い | ツールの部品の品質と、設定の確認 | 定型の業務アプリ、社内の申請フォーム |
この表から分かるのは、バイブコーディングとAI支援開発は「AIがコードを書く」点では同じで、違いは人が読んで確かめるかどうかだけだということです。
ノーコードとの違いは、中身がコードかどうかです。ノーコードはツールが用意した部品の範囲でしか作れない代わりに、部品そのものはツールの提供元が作り込んでいます。バイブコーディングは普通のプログラミング言語のコードを生成するため自由度は高いものの、そのコードの品質は誰も確かめていません。
バイブコーディングのメリットと向いている用途
違いが分かったところで、あえてコードを読まずに任せることの利点を見ていきます。利点が生きる場面と、避けたほうがよい場面はかなりはっきり分かれます。
バイブコーディングの3つのメリット
- 試作が速い:画面や処理の動きを言葉で伝えるだけで、動くものが数分で出てきます。仕様を詰める前に「こういうものか」を確かめられます
- コードを書かない人がアイデアを形にできる:企画や業務の担当者が、自分で動く見本を作ってからエンジニアに相談できます
- 一度きりの作業を片づけられる:ファイル名の一括変更や、手元のデータを一度だけ集計するスクリプトなど、保守しない小さな道具づくりに向きます
データ分析の実務でも、探索の段階で使い捨てのグラフや集計を作る場面では、3番目の使い方が効きます。
向いている用途と向かない用途
バイブコーディングが向くのは、失敗しても困る人がいない作業です。
- 向いている:自分だけが使う試作、デモ用の画面、一度だけ実行する集計、学習のための遊びのプロジェクト
- 向かない:本番環境で動くシステム、顧客や社員の個人情報を扱う処理、他の人が保守するコード、集計の結果が経営判断や報告に使われる分析
つまり、結果が間違っていても自分で気づけて、捨てても困らないものならバイブコーディングで作ってよく、誰かがその結果を信じて使うものなら、次の章以降で扱う確かめる工程が必要になります。
バイブコーディングの始め方。ツールの種類と5つのステップ
用途が決まったら、道具と手順を選びます。ここでは料金やプランには触れず、道具の種類と、始めるときの順番に絞って解説します。
バイブコーディングに使うツールは3種類
バイブコーディングに使われるツールは、作業する場所で3つに分けられます。
- エディタ型:VS Codeなどのエディタの中で、AIに指示してファイルを編集させる。CursorやGitHub Copilotがこの型です
- ターミナル型:コマンドを打つ画面(ターミナル)でAIに指示し、AIがファイルの編集やテストの実行まで進める。Claude Code、Codex CLI、Gemini CLIがこの型です
- アプリ生成型:ブラウザで作りたいアプリを説明すると、画面・データベース・公開までをまとめて作る。ReplitやLovableがこの型です
エディタ型とターミナル型は、手元のフォルダのコードを扱うため、プログラミングの経験がある方に向きます。アプリ生成型は、コードを書かない方でも始めやすい代わりに、データベースの権限などの設定もAIとツールに任せることになります。Claude Codeで業務の道具を作るときにできることと限界は、Claude Codeで非エンジニアが業務ツールを作れる理由。できること・できないことと部署展開の設計で解説しています。
バイブコーディングを始める5つのステップ
- 使い捨てのフォルダで始める:会社のリポジトリや本物のデータから始めず、新しい空のフォルダと、架空のサンプルデータを用意します
- 作りたいものを1〜2文で伝える:「売上のCSVを月別に合計するスクリプトを作って」のように、目的と入力と出力を短く伝えます
- 動かして結果を目で確かめる:AIが「動作確認済み」と答えても、自分で実行して、出てきた数字や画面が合っているかを見ます
- エラーはそのままAIに渡す:エラーメッセージを貼り付けて直させます。ここまでがバイブコーディングの基本の繰り返しです
- 残すと決めたら作り方を切り替える:人に渡す、繰り返し使う、と決めた時点で、仕様を書き出し、テストを作らせ、差分を読む進め方に移ります
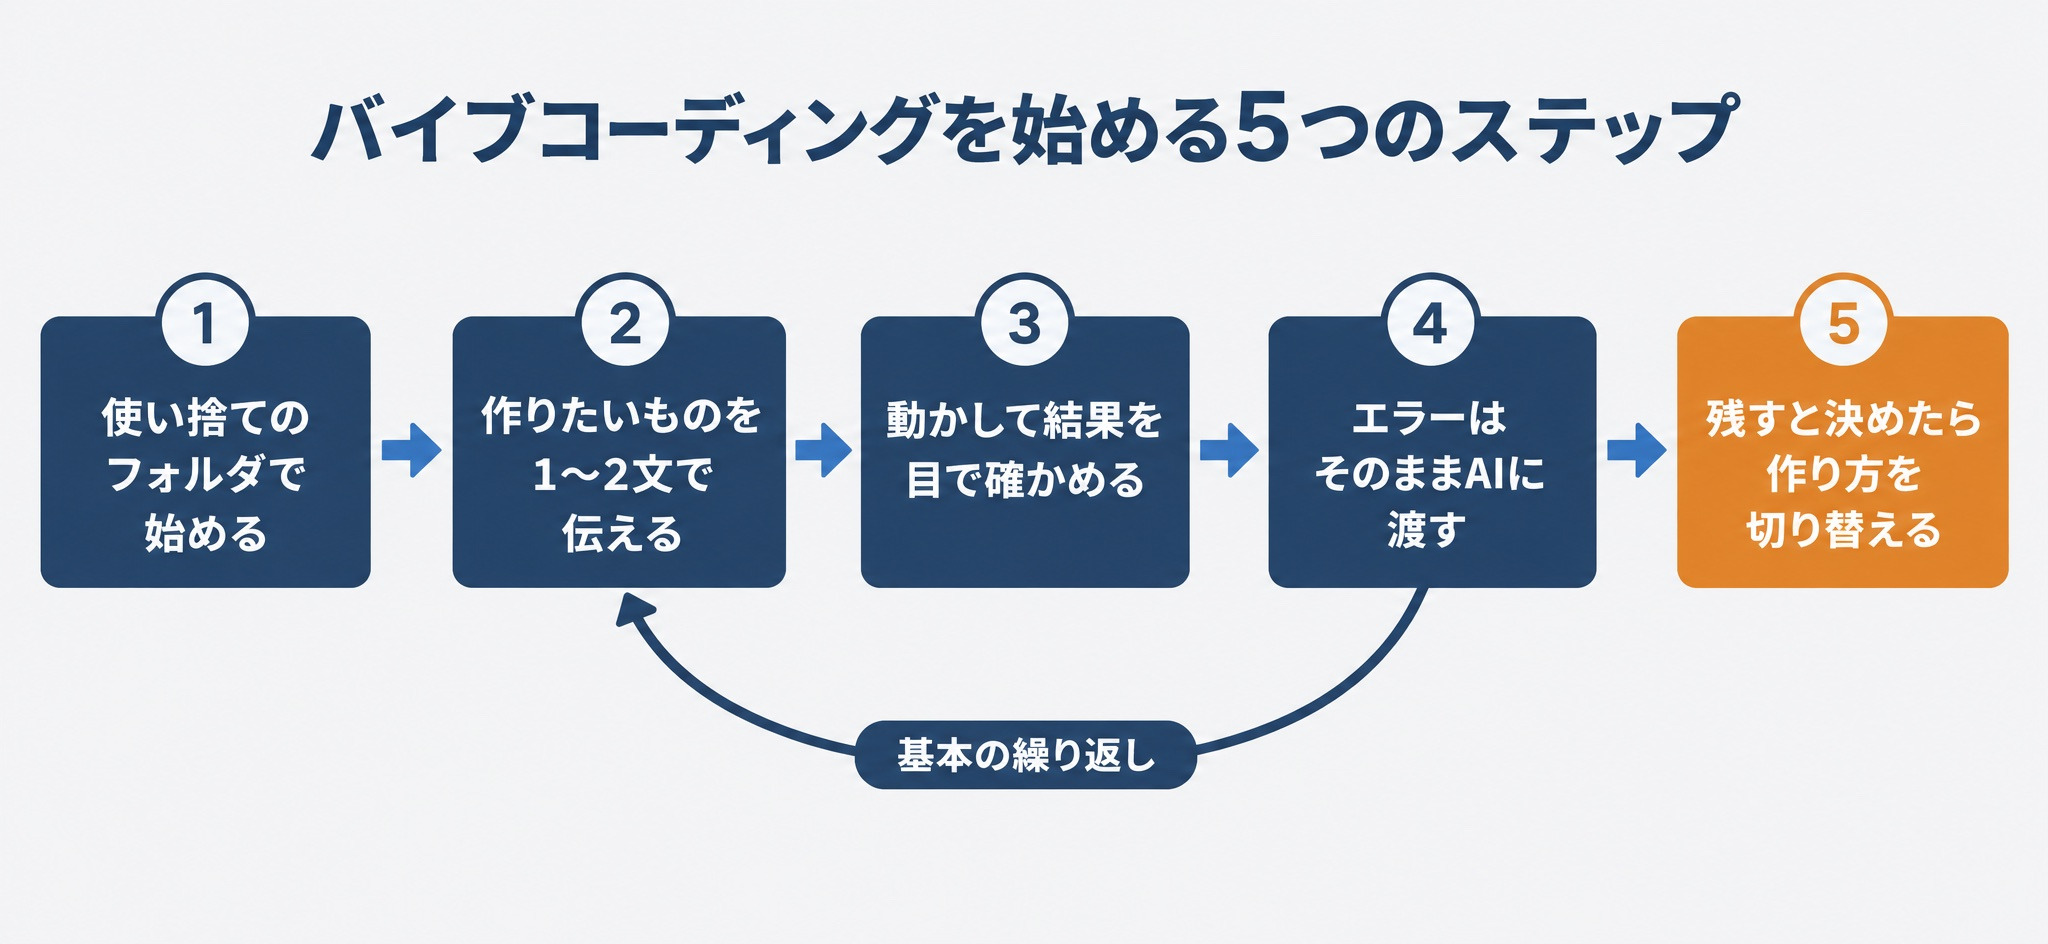
5番目の切り替えを省くと、AIのもっともらしい誤りがそのまま残ります。AIが誤りを出す仕組みは、AIハルシネーションとは?発生する原因・事例とRAGによる対策を解説で解説しています。
バイブコーディングで作ったコードを検証した実験
始め方の5番目で「残すなら切り替える」と書きました。その必要が本当にあるのかを、実際にAIに作らせたコードで確かめます。
実験の条件
題材は、データ分析の前処理でよくある「売上のCSV(列は date と amount)を月別に合計するPythonのスクリプト」です。Claude Code(モデルはclaude-sonnet-5)に、2通りの依頼でスクリプトを作らせました。
- 仕様なし版:月別に合計するスクリプトを作ってほしい、という要旨だけの依頼
- 仕様とテスト版:日付に「2026-01-05」と「2026/01/05」が混ざる、金額に桁区切りのカンマが入る、金額が空の行は警告を出して除く、BOM付きのUTF-8がある、という仕様を渡し、先にテストを書かせてから実装させた依頼
仕様なし版が作ったコードは、次の20行ほどです。
import csv
import sys
from collections import defaultdict


def main():
    if len(sys.argv) != 2:
        print(f"Usage: python {sys.argv[0]} <csv_file>", file=sys.stderr)
        sys.exit(1)

    path = sys.argv[1]
    totals = defaultdict(float)

    with open(path, newline="", encoding="utf-8") as f:
        reader = csv.DictReader(f)
        for row in reader:
            month = row["date"][:7]
            totals[month] += float(row["amount"])

    for month in sorted(totals):
        print(f"{month}: {totals[month]:.2f}")


if __name__ == "__main__":
    main()
このときAIは「サンプルCSVで動作確認済み」と報告していました。読みやすく、基本の形のCSVでは正しく動くコードです。日付の先頭7文字を月として扱う、という前提だけが、コードの中に黙って埋め込まれています。
2本のスクリプトを、表記ゆれを含む7つのCSVで動かしました。実行は2026年9月23日、Apple M1 ProのMac(macOS 14.6.1)、Python 3.11.6の標準ライブラリだけで行っています。仕様とテスト版に付いていた17件のテストは、同じ環境ですべて通りました。
仕様を渡さなかったコードは7件中3件で黙って集計を誤った
7つのCSVでの結果は次のとおりです。
| CSVの内容 | 仕様なし版 | 仕様とテスト版 |
|---|---|---|
| 1. 基本の形 | 正しい | 正しい |
| 2. 日付に「2026/01/20」が混ざる | 誤り(エラーなし) | 正しい |
| 3. 金額が「”1,200″」 | エラーで停止 | 正しい |
| 4. 金額が空の行がある | エラーで停止 | 正しい(警告を出して除外) |
| 5. Excelで保存したBOM付きのUTF-8 | エラーで停止 | 正しい |
| 6. 月が1桁(「2026-1-5」)とマイナスの金額 | 誤り(エラーなし) | 正しい |
| 7. 6に加えて小数の金額「1200.5」 | 誤り(エラーなし) | エラーで停止 |
仕様なし版で正しく集計できたのは基本の形の1件だけで、3件はエラーで止まり、3件はエラーを出さずに間違った集計を返しました。仕様とテスト版は6件で正しく、仕様に書かなかった小数の金額の1件だけで止まりました。
最も気づきにくいのは、2番の「黙って誤る」ケースです。仕様なし版の出力は次のとおりでした。
2026-01: 1000.00
2026-02: 300.00
2026/01: 500.00
1月の売上が「2026-01」と「2026/01」の2行に分かれ、1月の合計が1,500ではなく1,000と表示されています。スクリプトは正常に終わるため、行数の多い実データでは、この誤りに気づかないまま報告書に数字が載るおそれがあります。
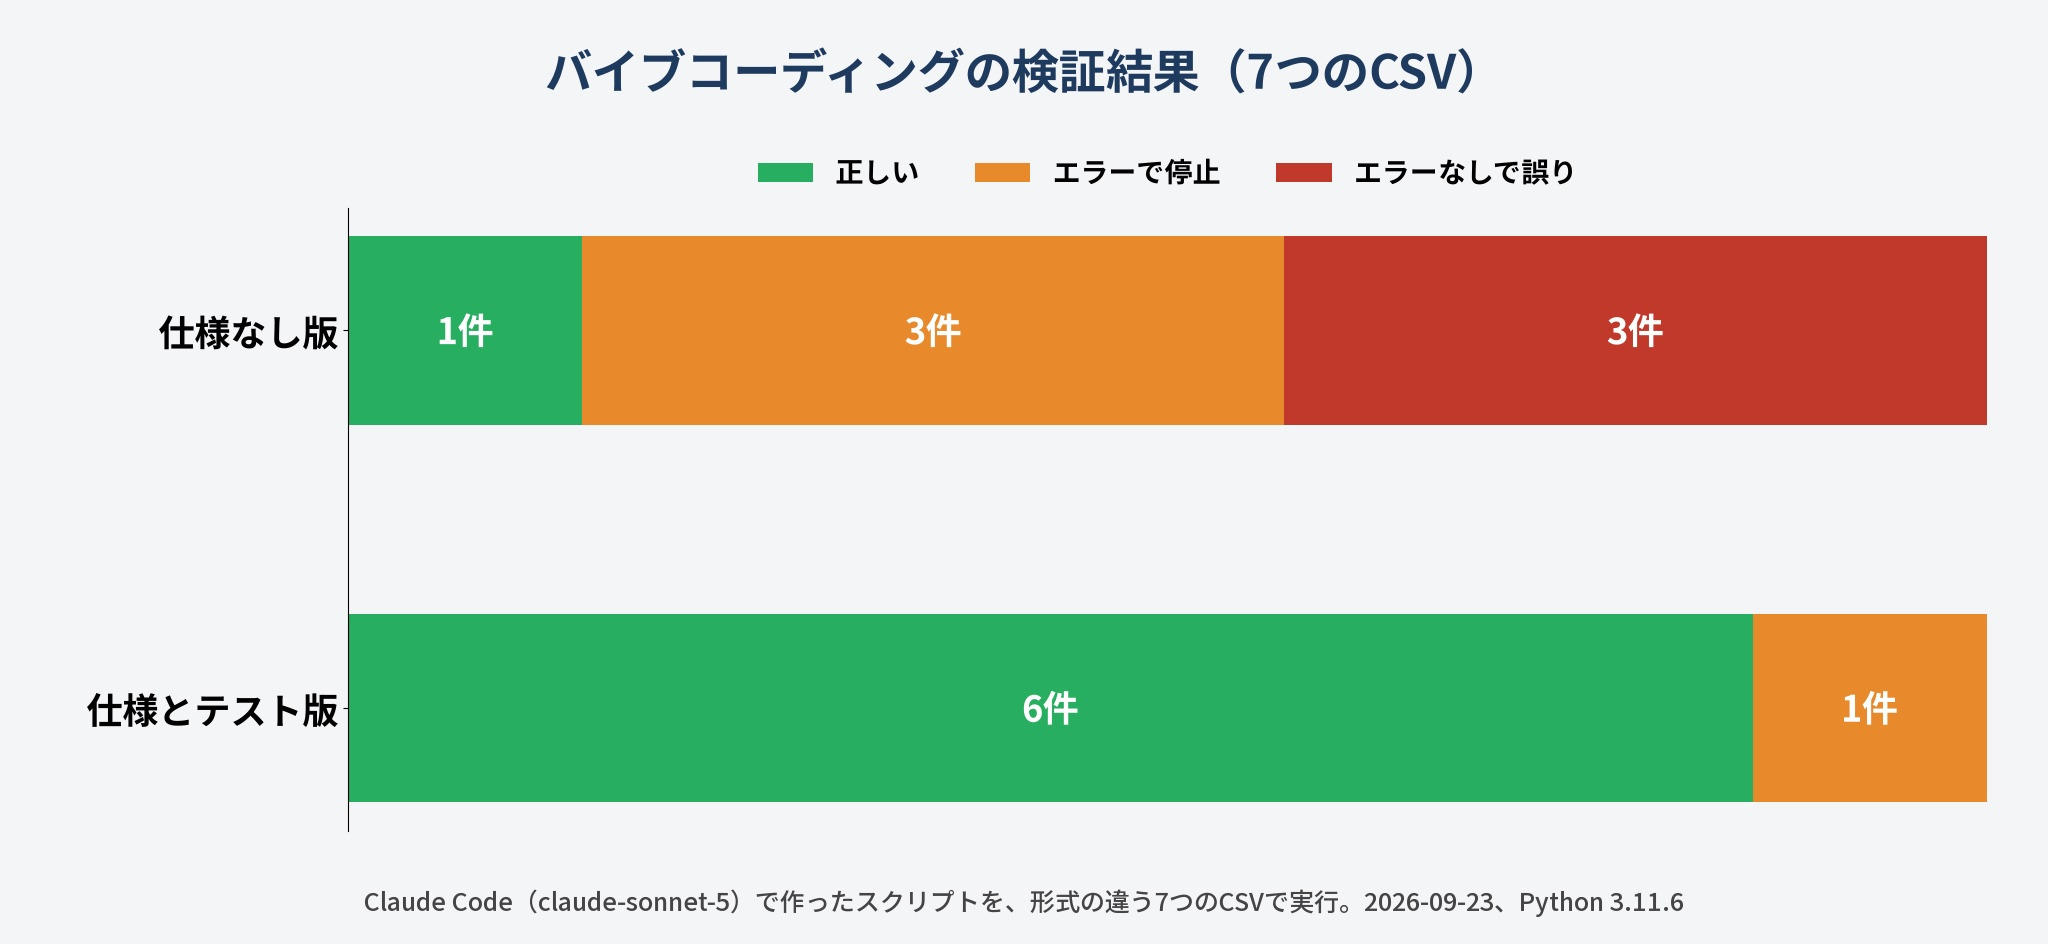
なお、生成にかかった時間は、実行の記録で仕様なし版が約15秒、仕様とテスト版が約92秒でした。テストを書かせる分だけ時間はかかりますが、差は1分余りです。1回ずつの生成と1つの題材での結果なので、依頼の仕方やモデルが変われば結果も変わります。
実験から分かる、AIに任せる前に決めること
- エラーで止まるより、黙って誤るほうが危ない:止まれば直せますが、誤った数字は正常な出力と見分けがつきません
- 仕様とテストは、書いた範囲しか守らない:仕様とテスト版も、小数の金額のように依頼に書かなかった入力では止まりました
- 想定する入力を決めるのは人:日付の書式、金額の形、空欄の扱いなど、データの実物を見て例外を書き出すのは、データを知っている人の仕事です
つまり、残すコードでは「動いた」ではなく「想定する入力の一覧に対してテストが通った」を完成の条件にすると、バイブコーディングの速さを生かしながら誤りを減らせます。
ここまでバイブコーディングで作ったコードの検証を見てきましたが、「AIに任せたコードや分析の結果が正しいかを、自分で確かめて直せるようになりたい」という方は、Craft CollegeのDS ADVANCEDをご覧ください。
DS ADVANCEDは、実務者向けの12週の上級プログラムです。Agentic RAGやマルチエージェントの実装に加えて、W&BとMLflowを使った評価と精度改善までを扱うため、AIの出力を測って直す進め方を身につけられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft College DS ADVANCEDの詳細はこちら
バイブコーディングのリスクと公表された事例
手元の実験は、1つの題材で行った小さな例です。ここからは、大規模な調査と、実際に公表された事故から、バイブコーディングのリスクを確認します。
AIが書いたコードの45%にセキュリティ上の欠陥
アプリケーションのセキュリティ検査を手がけるVeracodeは、2025年7月に、100を超える大規模言語モデル(LLM)に80種類のコーディングの課題を解かせた調査を公表しました(Veracode)。
この調査では、生成されたコードの45%が、Webアプリケーションの代表的な脆弱性の一覧であるOWASP Top 10に当たる欠陥を含んでいました。言語別の失敗率は、Javaが72%、Pythonが38%、JavaScriptが43%、C#が45%です。Veracodeは、新しいモデルや大きなモデルでも、安全なコードを書く割合はあまり上がっていないとしています。
コードを読まないバイブコーディングでは、この種の欠陥を人が見つける機会がありません。
公表されている2つの事故
- Replit(2025年7月):SaaStrの創業者Jason Lemkin氏が試していたReplitのAIエージェントが、変更を止めるよう指示されていた期間に、本番のデータベースを削除しました。1,200人を超える経営者と1,190社の記録が失われたと報じられています。ReplitのCEOは謝罪し、開発用と本番用のデータベースを自動で分けるなどの対策を表明しました(Fortune)
- Lovable(2025年5月公表):アプリ生成型のLovableで作られたサイトで、データベースの行単位のアクセス制御(Row Level Security)の設定が不十分なため、認証していない第三者がデータを読み書きできる脆弱性が、CVE-2025-48757として登録されました。Lovableは、アプリのデータの保護は利用者の責任だとして異議を示しています(NVD)。発見者は、調べた1,645件のプロジェクトのうち170件で問題の設定を確認したと報告しています(発見者の報告)
2件とも、AIに渡した権限や、AIが作った設定を人が確かめていなかったことが問題の中心です。
速くなったという体感と実測はずれることがある
バイブコーディングは速いと感じやすい作り方ですが、体感と実測がずれることを示した研究もあります。研究機関のMETRは、経験豊富なオープンソースの開発者16人に、自分のリポジトリの実際の課題246件を解いてもらうランダム化比較試験を行いました(METR 2025)。
開発者は作業前に、AIを使うと所要時間が24%短くなると予想し、作業後も20%短くなったと感じていました。しかし実測では、AIを使った作業のほうが19%長くかかっていました。この研究はバイブコーディングそのものを調べたものではありませんが、「速くなった気がする」を判断の根拠にしないほうがよいことを示しています。
企業でバイブコーディングを使うときの注意と手順
リスクを踏まえて、会社の業務でバイブコーディングを使う場合に何を決めておくかを見ていきます。まず確かめたいのは、入力したコードやデータがAIの学習に使われるかどうかです。
コードが学習に使われるかはプランで決まる
2026年9月時点の公式ドキュメントでは、主なツールの扱いは次のとおりです。
- Claude Code:Free・Pro・Maxの個人プランでは、本人が学習への利用を許可した場合に学習に使われ、保持期間は5年です。許可しない場合の保持期間は30日です。Team・Enterprise・APIなどの商用の契約では、学習に使いません(Claude Codeのデータ利用)
- Cursor:Privacy Modeを有効にすると、Cursorは顧客のデータを学習に使わず、モデルの提供元も保存や学習をしません。無効のままでは、コードやプロンプトが学習に使われる場合があります(Cursorのデータ利用)
- GitHub Copilot:2026年4月24日から、Free・Pro・Pro+・Maxのプランでは、入力・出力・コードの断片が学習に使われる場合があります。本人が設定で無効にできます。Business・Enterpriseのデータは学習に使いません(Copilotの個人設定)
ライセンスの面では、AIの提案が公開されているコードと一致することがあります。GitHub Copilotには、一致したファイルのURLとライセンス名を記録する機能があり、公開コードと一致する提案を許可するかどうかを設定で選べます(Copilotのコード参照)。
社員が個人のプランで業務のコードを扱うと、これらの設定を会社が管理できません。生成AIの利用で起きるセキュリティリスクの全体像は、LLMの利用で発生するセキュリティリスクとは?実施すべき5つの対策方法を解説で解説しています。
業務でバイブコーディングを使うための5つの手順
- 契約をまとめる:情報システム部門が、使うツールを法人向けの契約にまとめ、個人プランでの業務利用を禁止します
- 試してよい場所を分ける:開発チームの責任者が、バイブコーディングで試してよいフォルダと、架空のサンプルデータを用意します。本物の顧客データ、APIキー、本番のデータベースの接続情報は、そこに置きません
- AIに渡す権限を絞る:管理者が、コマンドの自動承認を禁止し、本番環境につながる認証情報を開発者の端末に置かない設定を配ります
- 切り替えの基準を決める:チームで「人に渡す」「2回以上使う」「結果を報告に使う」のどれかに当たったら、仕様とテストを書く進め方に移る、と決めておきます
- レビューを通してから取り込む:AIが作った変更も、人のレビューと、想定する入力の一覧に対するテストを通してから本番のコードに取り込みます
ソースコードやデータを社外に一切出せない現場では、手元のパソコンで動かすローカルLLMを使う方法もあります。選び方はローカルLLMでコーディングする方法。向くモデル・ツール・必要スペックで解説しています。
バイブコーディングの要点まとめ
- バイブコーディングとは、AIに自然言語で指示し、生成されたコードを読まずに、動くかどうかで判断して進める作り方。2025年2月にカルパシー氏が提唱した
- AIがコードを書いても、人がレビューしテストして説明できる状態にするなら、それはバイブコーディングではなくソフトウェア開発。2026年には提唱者自身も「エージェンティックエンジニアリング」という呼び名を挙げている
- 向くのは試作・個人用の道具・一度きりの作業で、本番・個人情報・他人が保守するコードには向かない
- ツールはエディタ型・ターミナル型・アプリ生成型の3種類。使い捨てのフォルダで始め、残すと決めたら仕様とテストに切り替える
- 検証では、仕様を渡さなかったスクリプトが7件中3件でエラーを出さずに集計を誤った。仕様とテストを付けた版も、書かなかった入力では止まった
- 企業で使うなら、法人向けの契約、試してよい場所、権限、切り替えの基準、レビューの5つを決めてから配る
バイブコーディングを取り入れた開発は「リベルクラフト」へ
「バイブコーディングの速さは生かしたいが、どこまで任せ、どう確かめればよいか決めきれない」と感じた方もいらっしゃるのではないでしょうか?
リベルクラフトが運営するCraft CollegeのDS ADVANCEDは、実務でデータやAIを扱う方に向けた12週の上級プログラムです。Agentic RAGやマルチエージェントの実装、Fine-tuning、W&BとMLflowを使った評価と精度改善を扱い、AIに任せた作業の結果を測って直す進め方を身につけられます。
リベルクラフト本体では、AI開発・データサイエンス開発の支援も行っています。次のようなご相談に対応しています。
- AIコーディングツールを、社内のデータの扱いと規程に合わせて導入したい
- 試作で作ったAIのアプリやスクリプトを、業務で使える品質に仕上げたい
- ソースコードやデータを社外に出せない環境で、AIを使った開発環境を整えたい
⇨AI開発・データサイエンス開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。