機械学習とは。3つの種類と代表的なアルゴリズム、活用事例をわかりやすく解説
生成AIを仕事で使う人は、この1年で急に増えました。総務省の「令和7年版 情報通信白書」によれば、生成AIサービスを使ったことがある個人の割合は、日本で26.7%です。2023年度調査の9.1%から3倍近くに伸びています。
一方で、その土台にある機械学習が何をする技術なのかを説明できる人は、まだ多くありません。AIとの違い、ディープラーニングとの関係、生成AIがどこに位置するのか。言葉は聞くけれど整理されないまま使われがちです。
そこで本記事では、
- 機械学習とは何か。AI・ディープラーニング・生成AIとの関係
- データからモデルができるまでの仕組み
- 教師あり学習・教師なし学習・強化学習という3つの種類
- 代表的なアルゴリズムと、課題から手法を絞る手順
- 業務での活用事例と、実務で使うときの注意点
- 未経験から学ぶ場合の順序
についてわかりやすく解説します。機械学習をこれから学ぶ方、社内のAI活用を任された方は、ぜひ最後までご覧ください。
「機械学習を自分で手を動かして使えるようになりたい」という方は、リベルクラフトへご相談ください。
機械学習とは。AI・ディープラーニング・生成AIとの関係
機械学習とは、データからパターンを学習し、人が判断のルールを明示的に書かなくても、予測や分類を行えるようにする技術です。
従来のプログラムとの違いは、判断基準を誰が作るかにあります。従来は「気温が30度を超えたら在庫を増やす」といった条件を、人がひとつずつ書いていました。機械学習では、過去の気温と売上の組み合わせを大量に見せて、どの条件でどう動くべきかを機械側に作らせます。
条件が10個なら人が書けます。しかし条件が数百、数千になり、しかも条件どうしが絡み合う場合、人が書き切ることはできません。そこが機械学習の出番です。
逆にいえば、ルールが少なく、誰が見ても判断が変わらない業務には向いていません。機械学習を検討する前に、その判断が本当に「書き切れないほど複雑か」を確かめておくと、遠回りを避けられます。
AIと機械学習の違い
AIと機械学習は、よく同じ意味で使われます。ただし包含関係は明確です。
総務省と経済産業省が公表している「AI事業者ガイドライン(第1.2版)」では、AIを「『AIシステム』自体又は機械学習をするソフトウェア若しくはプログラムを含む抽象的な概念」と定義しています。同ガイドラインは参考としてJIS X 22989:2023の定義も併記しています。
つまりAIは幅の広い概念で、機械学習はそれを実現する手段のひとつという位置づけです。ルールベースのエキスパートシステムのように、機械学習を使わないAIも存在します。
ディープラーニング・生成AIと機械学習の関係
ディープラーニング(深層学習)は、機械学習の手法のひとつです。人間の神経回路を模したニューラルネットワークの層を深く重ねたものを指します。
そして生成AIやLLM(大規模言語モデル)は、そのディープラーニングを使って作られています。関係を並べると、AI ⊃ 機械学習 ⊃ ディープラーニング ⊃ 生成AI・LLM という入れ子になります。
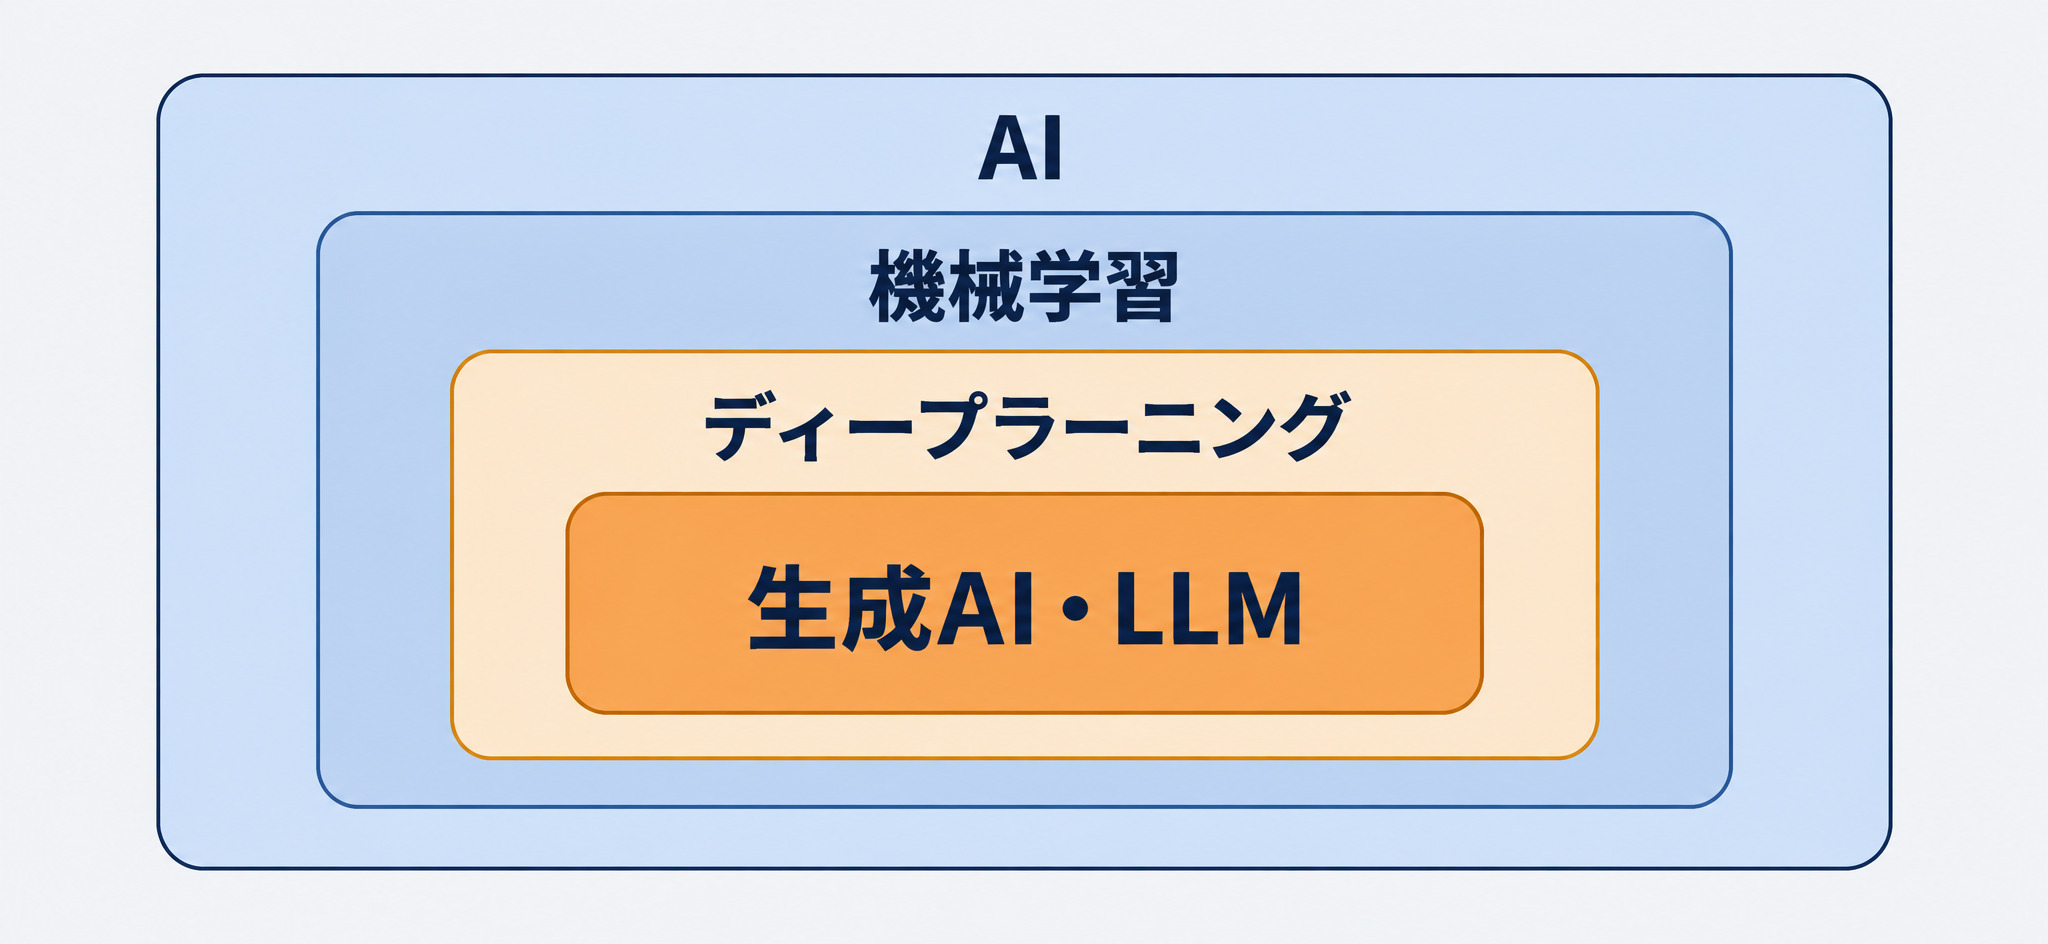
情報通信白書によれば、深層学習が提唱されたのは2006年で、これが第3次AIブームのきっかけになりました。生成AIが広く使われるようになったのは2022年です。つまりいま話題の生成AIは、突然現れたものではなく、機械学習の延長線上にあります。
LLMそのものの仕組みはLLMとは何か。仕組みと種類、企業での活用方法をわかりやすく解説で、生成AIが文章を作る流れは生成AIの仕組みとは。データからテキストが生成されるまでをわかりやすく解説で詳しく扱っています。
機械学習の仕組み。学習データからモデルができるまで
機械学習を理解するうえで押さえたい言葉は3つです。学習データ、特徴量、モデルです。
学習データ・特徴量・モデルの関係
中古住宅の価格を予測する場面で考えます。
学習データは、過去に成約した物件の情報と、そのときの価格をセットにしたものです。価格という答えがついているところが重要です。
特徴量は、価格を予測する手がかりとして使う項目です。この例なら専有面積、築年数、最寄り駅からの距離などが当たります。
何を特徴量にするかで精度は大きく変わります。同じ「駅からの距離」でも、地図上の直線距離にするか、徒歩何分にするかで結果が変わります。坂や踏切がある土地なら、直線距離は実感と合いません。データをそのまま使うのではなく、予測したいものとの関係を考えて作り直す作業が要ります。
モデルは、特徴量と価格の関係を覚えた計算の手順です。学習データから作られ、新しい物件の特徴量を入れると価格の予測値を返します。
学習フェーズと推論フェーズ
機械学習には2つの段階があります。
学習フェーズでは、学習データを読み込んでモデルを作ります。大量の計算が必要で、時間も計算資源もかかります。
推論フェーズでは、できあがったモデルに新しいデータを入れて答えを出します。こちらは軽く、何度でも繰り返せます。
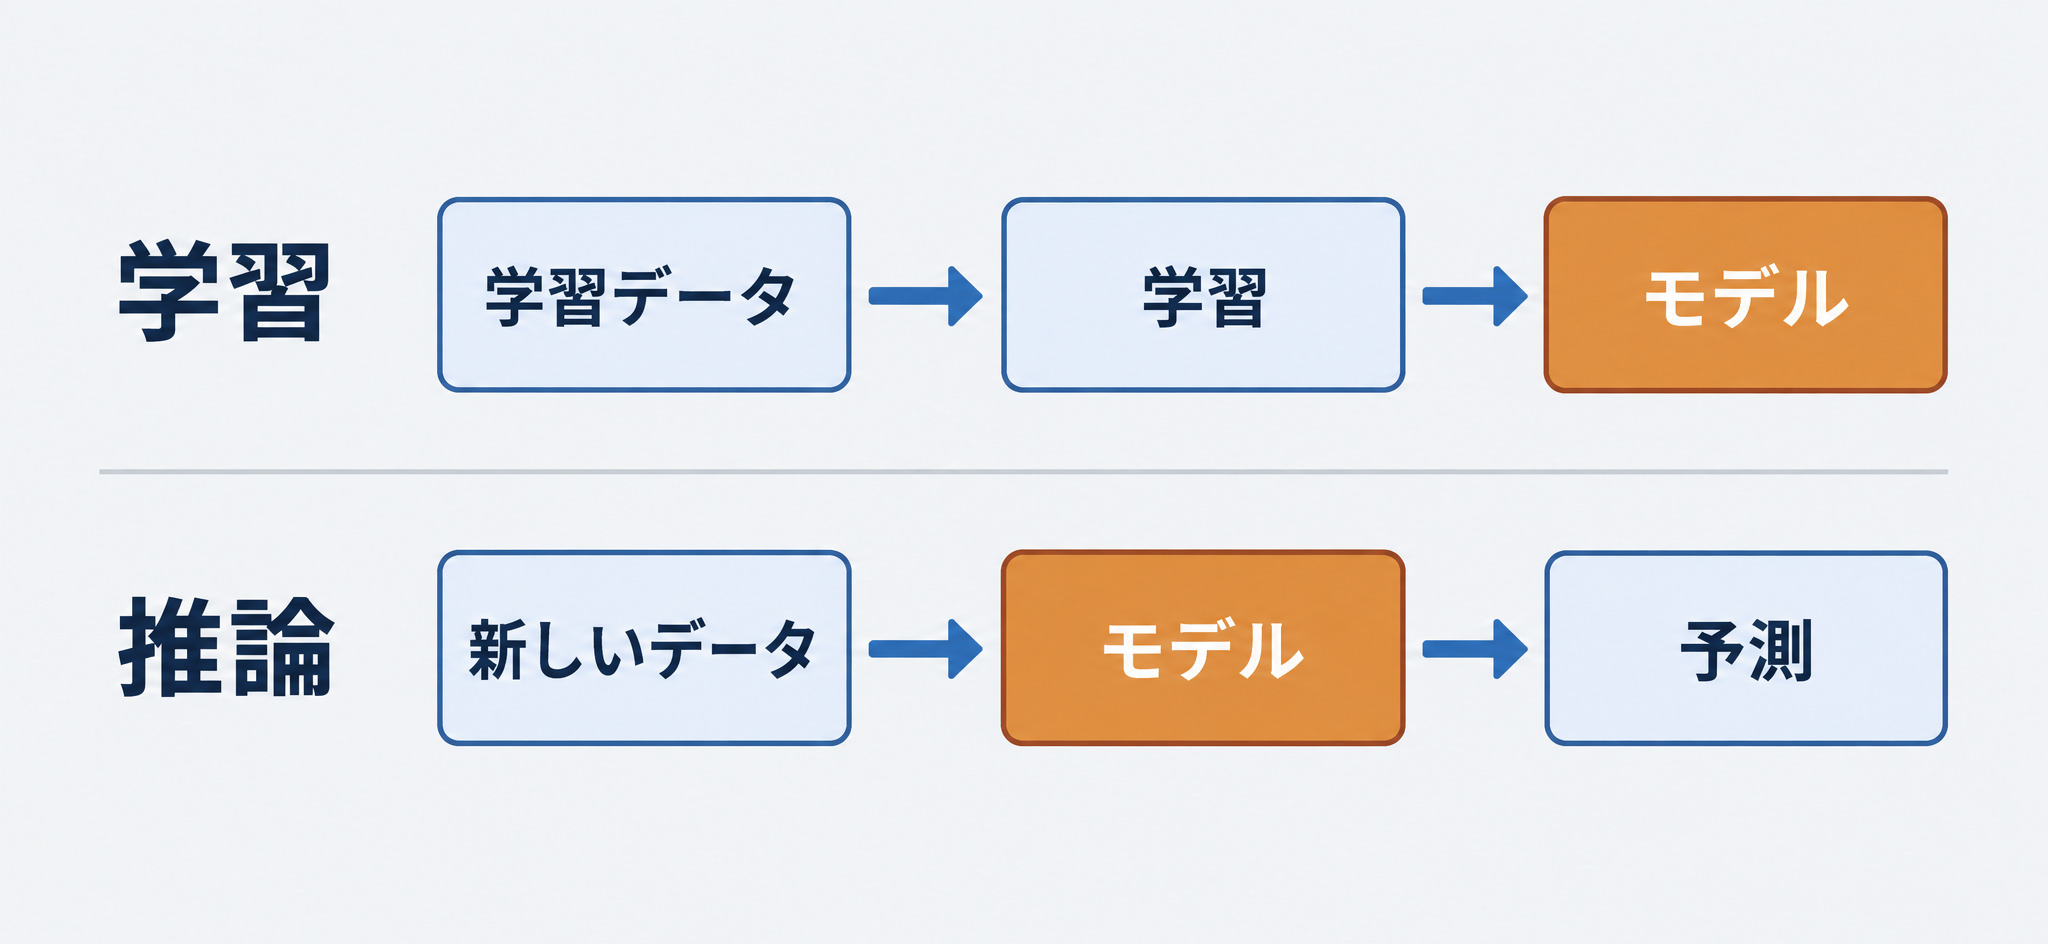
この非対称性は実務で効いてきます。モデルを作るときはGPUを積んだマシンが要るのに、できたモデルを使うだけなら普通のサーバーで足りる、という場面は珍しくありません。
ここでよくある誤解が、「一度作った機械学習のモデルは、使っているうちに勝手に賢くなる」というものです。通常の構成では、推論フェーズでモデルの中身は変わりません。新しいデータが何万件たまっても、それを学習データに加えて学習フェーズをもう一度回さない限り、予測の癖は作った時点のままです。後で触れる「作って終わりにしない」という注意点は、この性質から来ています。
機械学習の3つの種類。教師あり学習・教師なし学習・強化学習
機械学習は、学習のさせ方によって3つに分かれます。
| 種類 | 正解データ | 代表的なタスク | 使う場面 |
|---|---|---|---|
| 教師あり学習 | 必要 | 回帰、分類 | 需要予測、スパム判定、与信審査 |
| 教師なし学習 | 不要 | クラスタリング、次元削減 | 顧客のグループ分け、異常検知 |
| 強化学習 | 不要(報酬を設計する) | 方策の学習 | ロボット制御、ゲーム、広告配信 |
教師あり学習。正解つきのデータから予測を学ぶ
教師あり学習は、答えのついたデータを使って学習します。3つのなかで最も使われている型です。
解くタスクは大きく2つに分かれます。ひとつは回帰で、売上や価格のような数値を当てます。もうひとつは分類で、迷惑メールかどうか、不良品かどうかといった区分を当てます。
同じデータでも、何を答えにするかでどちらになるかが変わります。先ほどの中古住宅の例で、成約価格そのものを当てるなら回帰です。「3か月以内に売れるかどうか」を当てるなら分類になります。業務で機械学習を検討するときは、手法より先に、この「答えを何にするか」を決める作業から始まります。
つまずきやすいのは、正解データを用意する工程です。過去の記録にラベルが付いていない場合、人が手作業で付けることになり、ここが実務では最大のコストになります。
教師なし学習。正解の無いデータから構造を見つける
教師なし学習では、答えを与えません。データの中にある構造を機械側に見つけさせます。
代表的なのがクラスタリングです。顧客の購買履歴から似た行動をとるグループを切り出す、といった使い方をします。もうひとつが次元削減で、項目数の多いデータを、情報をなるべく落とさずに少ない軸へまとめます。
正解が無いため、出てきた結果が意味のあるまとまりかどうかは人が判断します。ここは機械任せにできません。
たとえばクラスタリングでは、顧客をいくつのグループに分けるかを人が指定することが多く、3つに分けるか5つに分けるかで結果の見え方が変わります。判断の目安は、分けたグループごとに違う打ち手を取れるかどうかです。グループの違いを言葉で説明できず、どのグループにも同じ施策を打つことになるなら、その分け方は業務の役に立っていません。
強化学習。試行錯誤から良い手順を学ぶ
強化学習は、環境の中で行動を試し、得られる報酬が大きくなるような行動の選び方を学びます。
囲碁や将棋のAI、ロボットの動作制御、広告の出し分けなどで使われています。報酬の設計を間違えると、狙いと違う行動を学習してしまうため、何を報酬にするかの設計が成否を分けます。広告の出し分けでクリック数だけを報酬にすれば、クリックはされても購入につながらない広告ばかりを選ぶようになりかねません。本当に増やしたい結果を報酬に含められるかどうかが、設計の最初の論点になります。
このほか、少量の正解つきデータと大量の正解なしデータを組み合わせる半教師あり学習もあります。ラベル付けのコストを抑えたい場面で使われます。
機械学習の代表的なアルゴリズムと、手法の選び方
種類が分かったところで、その中で実際に使われる手法を見ていきます。
教師あり学習の代表的なアルゴリズム
| 手法 | 学習の種類 | 向いているデータ | 代表的な用途 |
|---|---|---|---|
| 線形回帰 | 教師あり(回帰) | 表形式、項目が少ない | 売上予測、価格予測 |
| ロジスティック回帰 | 教師あり(分類) | 表形式 | 解約予測、与信審査 |
| 決定木 | 教師あり(両方) | 表形式 | 判断ルールを見せたい場面 |
| ランダムフォレスト | 教師あり(両方) | 表形式 | 精度と安定性を両立したい場面 |
| 勾配ブースティング | 教師あり(両方) | 表形式 | 表データで高い精度が要る場面 |
| サポートベクターマシン | 教師あり(分類) | 項目が多く件数が少ない | 文書分類、画像分類 |
| k近傍法 | 教師あり(分類) | 件数が少ない | 類似商品の推薦 |
分類はscikit-learn公式ドキュメントのUser Guideの章立てに沿っています。
ニューラルネットワークとディープラーニング
ニューラルネットワークは、入力から出力までの間に中間の層を置き、層ごとに重みを掛けて情報を変換していく手法です。この層を深く重ねたものがディープラーニングです。
画像、音声、文章のように、人が特徴量を設計しにくいデータで強さを発揮します。逆に、項目が揃った表形式のデータでは、勾配ブースティングのような決定木系の手法のほうが精度で上回ることが少なくありません。
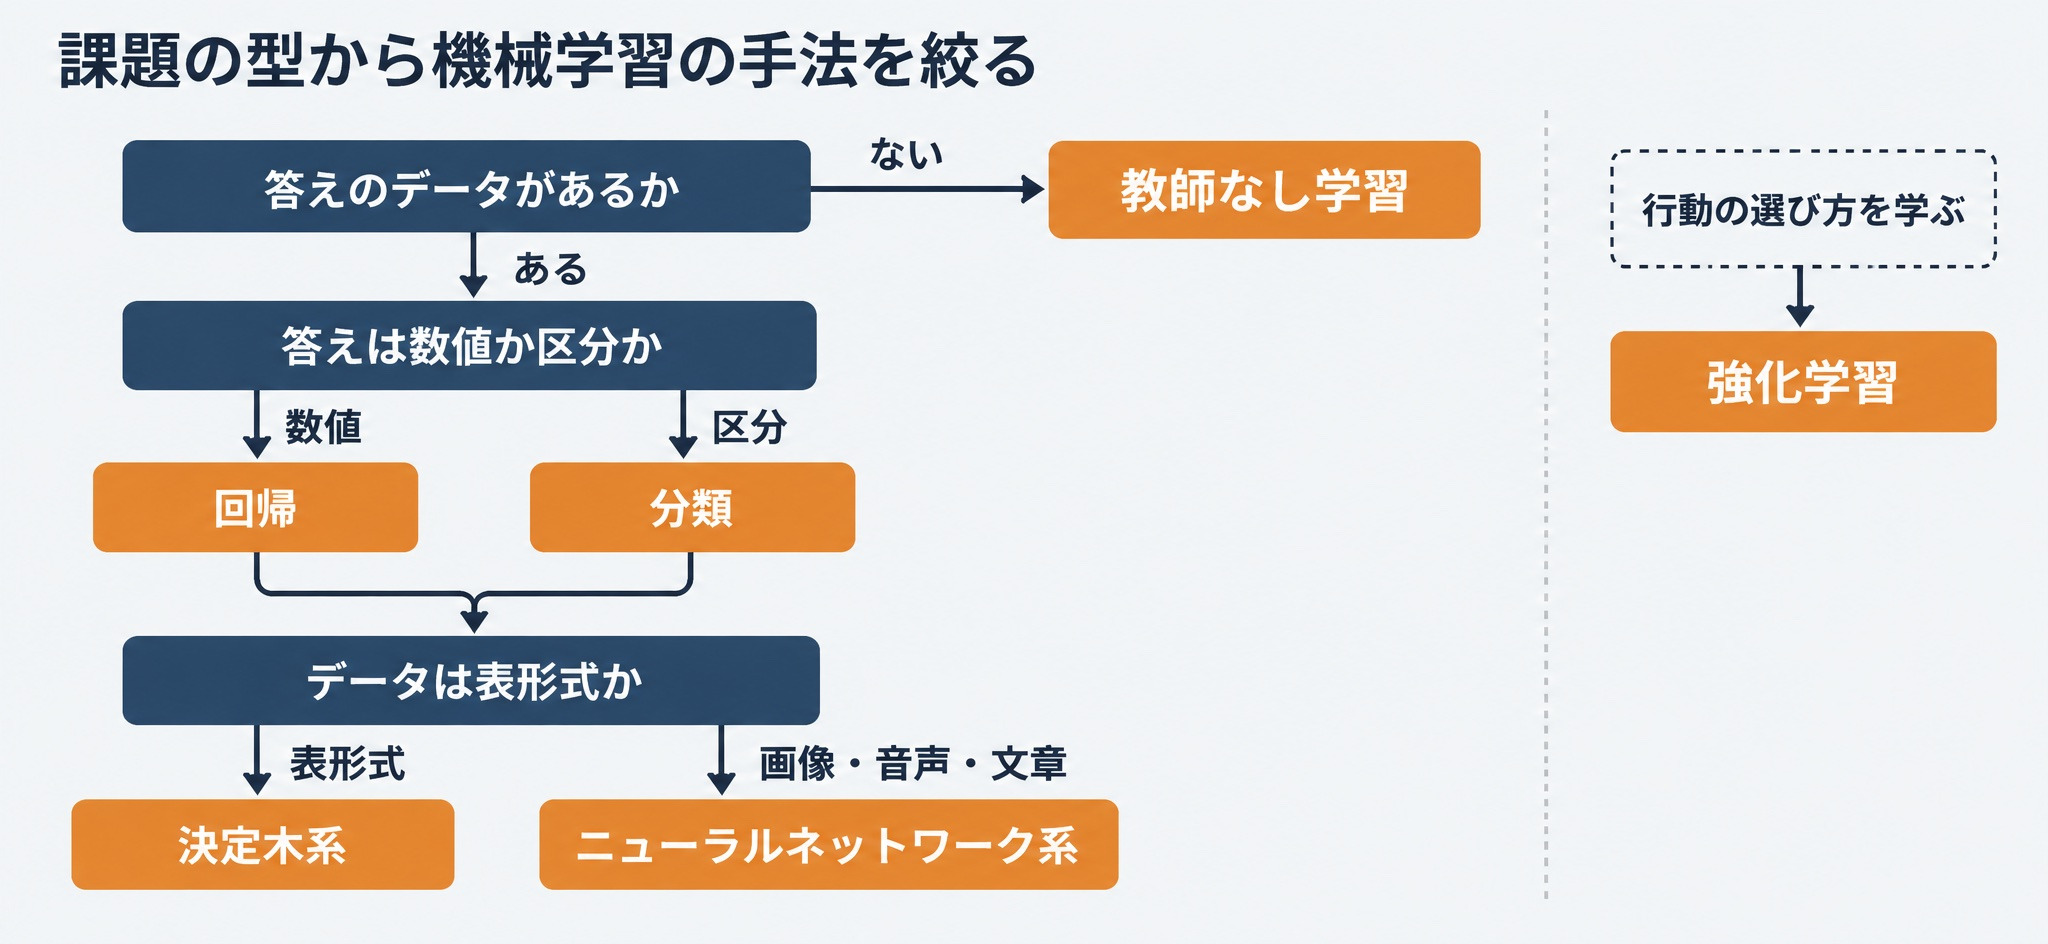
課題の型から機械学習の手法を絞る4つの手順
手法の一覧を眺めても、自分の課題にどれを使うかは決まりません。次の順で絞ると、候補は数個まで狭まります。
- 予測したい答えのデータが手元にあるか。 無ければ教師なし学習から検討します
- 答えが数値か、区分か。 数値なら回帰、区分なら分類です
- データは表形式か、画像・音声・文章か。 表形式なら決定木系から、それ以外ならニューラルネットワーク系から試します
- 答えを当てるのではなく、行動の選び方そのものを学びたいか。 そうであれば強化学習です
あわせて、順序についてもうひとつ。最初から複雑で精度の高そうなモデルを選ばないほうがうまくいきます。線形回帰のような単純な手法で基準となる精度をまず作り、複雑な手法がそれを超えるかどうかで判断します。基準が無いまま複雑なモデルを回すと、出た数字が良いのか悪いのか判断できません。
もうひとつ、いまは手法を選ぶ前に「そもそも自分でモデルを作る必要があるか」という分かれ道があります。問い合わせ文の要約や分類のように文章を扱う課題なら、学習済みのLLMに指示を与えるだけで、実用になる水準に届くことがあります。一方で、自社の売上実績から来月の需要を当てる、自社の設備データから故障の兆候を見つける、といった課題は、自社にしか無いデータで学習させなければ答えが出ません。前者は生成AIの使い方を工夫する課題、後者は機械学習のモデルを作る課題です。この2つを混ぜて検討すると、必要な人材も費用も見積もりを誤ります。
ここまで機械学習の種類と手法の選び方を解説しましたが、「自分のデータでモデルを作って動かすところまで一人でたどり着けるか不安」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeでは、Pythonの基礎からpandasでのデータ処理、scikit-learnでのモデル構築と評価、さらに生成AI・LLMを使った開発までを、6つのSTEPで順番に学べます。途中で詰まったときは、現役のデータサイエンティストと1対1で相談しながら、自分の関心があるテーマの制作物まで仕上げられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft College データサイエンティスト養成講座の詳細はこちら
機械学習でできること。業務での活用事例
ここからは、実際の業務でどう使われているかを見ていきます。ここまでに整理した「学習の種類」と「手法」に対応づけながら読むと、自社の課題に引き寄せやすくなります。
| 課題 | 学習の種類 | 代表的な手法 |
|---|---|---|
| 需要予測、売上予測 | 教師あり(回帰) | 勾配ブースティング、線形回帰 |
| 異常検知、外観検査 | 教師なし、教師あり(分類) | 外れ値検知、ニューラルネットワーク |
| 問い合わせ対応、文書分類 | 教師あり(分類)、生成AI | ニューラルネットワーク、LLM |
| 商品推薦、顧客のグループ分け | 教師なし(クラスタリング) | k-means、協調フィルタリング |
需要予測・売上予測
過去の実績と、天候やイベントといった外部要因から、これからの需要を数値で予測します。教師あり学習の回帰にあたります。
予測が当たれば、在庫の持ちすぎや欠品が減り、人員配置も前もって組めるようになります。小売や外食のように、日々の変動が大きい業種で効果が出やすい領域です。
導入のときに見落とされやすいのは、予測の精度そのものより、予測を受けて誰がどう動くかです。発注の締め切りに間に合わない時点で予測が出ても、業務は変わりません。
異常検知・外観検査
正常な状態のデータを学習させておき、そこから外れたものを見つけます。正常品の画像だけで学習できるため、不良品のサンプルが集まらない場面でも使えます。
製造業の検査工程や、設備の故障予知で使われています。ベテランが目や音で判断していた兆候を、数値の条件として定義し直す作業でもあります。
この定義し直しが、実際には最も手間のかかる工程です。「なんとなく音が違う」を、どのセンサーのどの帯域の変化として表すのか。ここを現場と一緒に決められるかどうかで、成否が分かれます。
自然言語処理とチャットボット
文章を分類する、要約する、問い合わせに答える、といった使い方です。近年はLLMの登場で、扱える範囲が大きく広がりました。
社内の問い合わせ対応では、過去の回答履歴やマニュアルを参照させることで、担当者の負荷を下げる使い方が増えています。
この方式では、LLMそのものを自社データで学習し直すのではなく、質問のたびに関係する文書を検索して回答の材料として渡します。文書を差し替えれば回答も変わるため、規程やマニュアルが頻繁に改訂される業務と相性が良い方式です。ただし、LLMはもっともらしい誤りを返すことがあるため、回答の根拠となった文書を一緒に表示し、最終判断は担当者が行う運用にしておくと安全です。
レコメンドと顧客のグループ分け
購買履歴や閲覧履歴から、似た嗜好の顧客をまとめたり、次に買いそうな商品を提示したりします。教師なし学習のクラスタリングが土台になります。
ここで押さえておきたいのは、技術が広まったことと、使いこなせていることは別だという点です。情報通信白書によれば、何らかの業務でAIを使用していると回答した日本の企業は55.2%でした。AIを利用する方針を定めている事業所の割合は2024年度調査で49.7%と、2023年度調査の42.7%から上がっています。
同じ白書の企業におけるAI利用の現状を見ると、導入にあたっての懸念として最も多く挙がったのは「効果的な活用方法がわからない」でした。技術が手に入らないことではなく、自社の課題と技術を結びつけられないことが、いま最大の壁になっています。
機械学習を実務で使うときの注意点
実際に使おうとすると、精度以前のところでつまずくことが多くあります。AI開発の支援現場で実際に問題になりやすい順に並べます。
- 学習データの質と量が精度を決める。件数を増やす前に、ラベルの付け方が揃っているか、欠損や表記ゆれが残っていないかを見たほうが効きます
- 過学習に注意する。学習データにだけよく当たり、新しいデータでは外すモデルになる現象です。学習用のデータで98%当たっているのに、実運用では60%しか当たらない、という形で表面化します。データを学習用と検証用に分け、検証用での精度で判断します
- 正解率の高さだけで判断しない。不良品が100個に1個しか出ない工程なら、すべてを「良品」と答えるだけのモデルでも正解率は99%になります。こうしたモデルは不良品を1個も見つけられません。件数に偏りがあるデータでは、見逃したくない側をどれだけ拾えたかを別に確かめます
- 判断の根拠を示しにくい。特に層の深いモデルは、なぜその結論になったかの説明が難しくなります。審査や医療、製造の検査など説明責任がある場面では、精度より説明性を優先する判断もあります
- 作って終わりにしない。作った時点の精度は時間とともに落ちます。顧客の行動も市場も変わり、学習したときのデータと現実がずれていくためです。精度を定期的に測る仕組みと、落ちたときに作り直す手順まで含めて運用を設計します
過学習がどう現れるかは、手元で簡単に確かめられます。scikit-learnに付属している乳がん診断のデータ(569件、30項目)を学習用と検証用に7対3で分け、決定木の深さを1から6まで変えて正解率を測りました。深さは、木がいくつの条件を重ねて判断するかを表し、深いほど複雑なモデルになります。学習用データの正解率は深さ1で93.2%、深さ6で100.0%まで上がりました。一方、検証用データの正解率は深さ2の時点で90.6%に達し、その後は90%前後で止まったままです。
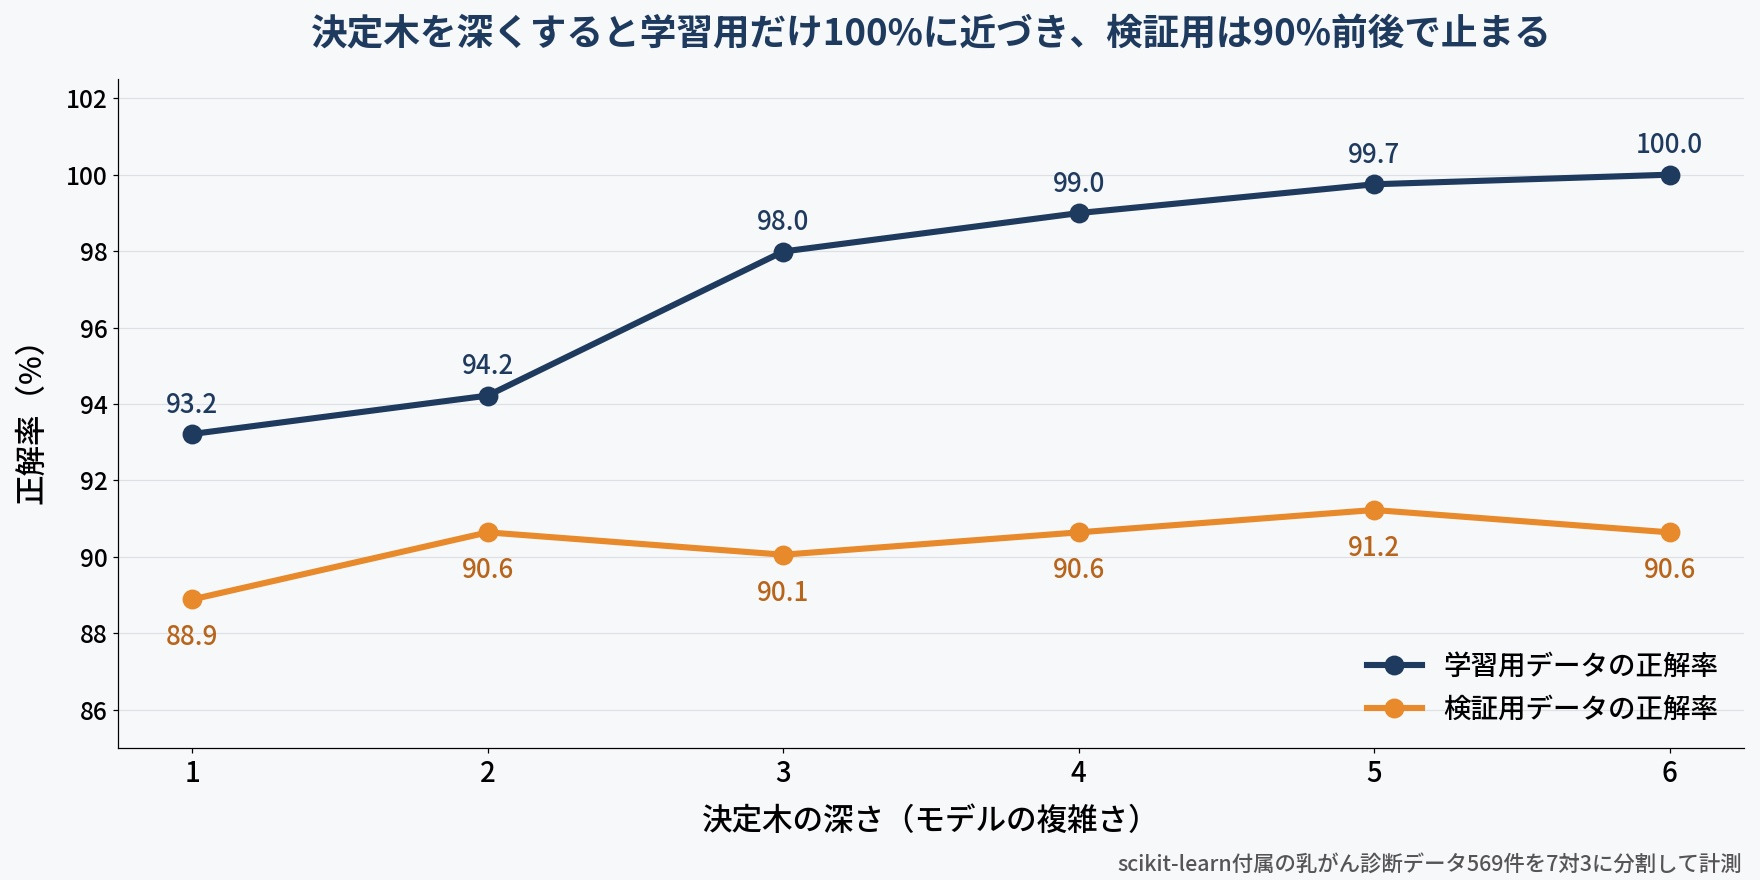
学習用データでの100%という数字は、新しいデータでの成績を約束しません。複雑にするほど学習用データの細かな癖まで覚え込み、検証用の成績は伸びなくなります。単純なモデルから始めて検証用の精度で比べる、という先ほどの順序が大切なのはこのためです。
このうち説明性については、決定木のように判断の道筋をそのまま見せられる手法を選ぶ、という解き方もあります。精度だけで手法を決めないほうがよい理由がここにあります。
社内で合意を取る場面でも同じことが起きます。精度が数ポイント高いモデルより、なぜその判断になったかを説明できるモデルのほうが、現場に受け入れられて結果的に使われる、というのはよくある話です。
機械学習の学び方。何からどの順番で学ぶか
最後に、これから学ぶ方に向けて順序を示します。
- Pythonの基本文法。機械学習で使う範囲に絞ります。Web開発向けの内容まで広げる必要はありません
- pandasでのデータの読み込みと集計。実務の時間の多くはここに使われます
- scikit-learnで教師あり学習のモデルを1つ動かす。最初から複数を試さず、1つを最後まで通します
- 精度の測り方と、学習用・検証用の分け方。ここを飛ばすと、良いモデルかどうかを自分で判断できません
- 自分の関心がある実データで、課題設定からやり直す。用意された練習データと、現実のデータの違いがここで分かります
科目名を上から順に学ぶのではなく、作りたいものから逆算して学ぶ範囲を絞るほうが、途中で止まりにくくなります。深層学習のフレームワークに進むのは、この5段階を終えてからで間に合います。
機械学習を含むデータサイエンス全体の学び方はデータサイエンスとは。定義・活用事例・学び方をわかりやすく解説で、学習済みモデルを自社のデータで調整する方法はファインチューニングとは。仕組み・種類・RAGとの違いをわかりやすく解説で扱っています。
まとめ
- 機械学習とは、データからパターンを学習し、人がルールを書かなくても予測や分類を行えるようにする技術
- AI ⊃ 機械学習 ⊃ ディープラーニング ⊃ 生成AI・LLM という包含関係にある。生成AIは機械学習の延長線上にある
- 学習フェーズでモデルを作り、推論フェーズで使う。学習は重く、推論は軽い
- 学習のさせ方は、教師あり学習・教師なし学習・強化学習の3つに分かれる
- 手法は一覧から選ぶのではなく、正解データの有無、答えが数値か区分か、データの形式、の順に絞る
- 単純なモデルで基準の精度を作ってから、複雑な手法がそれを超えるかで判断する
- 技術より先に、自社の課題と技術を結びつけられないことが企業側の壁になっている
機械学習を学ぶなら「Craft College」へ
「機械学習の全体像は分かったが、自分が手を動かして作れるようになるには何から始めればいいのか」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- 機械学習を、解説を読む段階から自分で作れる段階へ進めたい方
- 独学で何から手をつければいいか分からず、止まってしまっている方
- 自社のデータで何ができるのかを、手を動かしながら確かめたい方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。