ニューラルネットワークとは。一次関数から1000億パラメータまで仕組みを解説
ニューラルネットワークの解説を読むと、たいてい「人間の脳の神経回路をまねた仕組み」と書かれています。ただ、この一文だけで中身が分かった気になれる人は少ないはずです。
まねたのは何なのか。中で何を計算しているのか。1000億パラメータといわれても、その1個が何を指しているのかが見えてきません。
そこで本記事では、中学数学の一次関数を出発点にして、1000億パラメータまでを一本でつなぎます。具体的には、
- ニューラルネットワークとは何か。機械学習・ディープラーニングとの関係
- ニューロン1個が計算していること。重みとバイアスの意味
- なぜ層を重ねるのか
- 重みがどう決まるのか。損失関数と誤差逆伝播
- パラメータが2個から1750億個になると何が変わるのか
- 全結合からCNN・RNN・Transformerまでの系譜
を解説します。数式は最小限にし、使うときは意味を日本語で添えます。
「ニューラルネットワークを自分で組めるようになりたい」という方は、リベルクラフトへご相談ください。
ニューラルネットワークとは。機械学習・ディープラーニングとの関係
ニューラルネットワークとは、データから判断のしかたを学ぶ計算の仕組みです。入力を受け取り、内部で数値を変換していき、答えを出します。
ニューラルネットワークと機械学習・ディープラーニングの関係
位置づけを先に整理します。機械学習という大きな枠があり、その中の手法のひとつがニューラルネットワークです。そして、ニューラルネットワークの層を深く重ねたものをディープラーニング(深層学習)と呼びます。
つまり、ニューラルネットワークは深層学習の土台にあたります。いま話題の生成AIもLLMも、この仕組みの上に作られています。
「脳の神経回路をまねた」という説明だけでは分からない理由
脳をまねた、という説明は間違っていません。ただ、それだけでは何も分かりません。
実際にまねたのは、「複数の入力を受け取り、重みをつけて足し合わせ、一定を超えたら信号を出す」という一点だけです。脳の化学的な働きや、記憶の仕組みまで再現しているわけではありません。
だから、この記事では比喩を脇に置いて、中で実際に行われている計算から見ていきます。
ニューラルネットワークのニューロン1個は何を計算しているのか。重みとバイアス
まずネットワーク全体ではなく、その構成単位であるニューロン1個を見ます。
出発点は中学数学の一次関数。傾きと切片が直線の形を決める
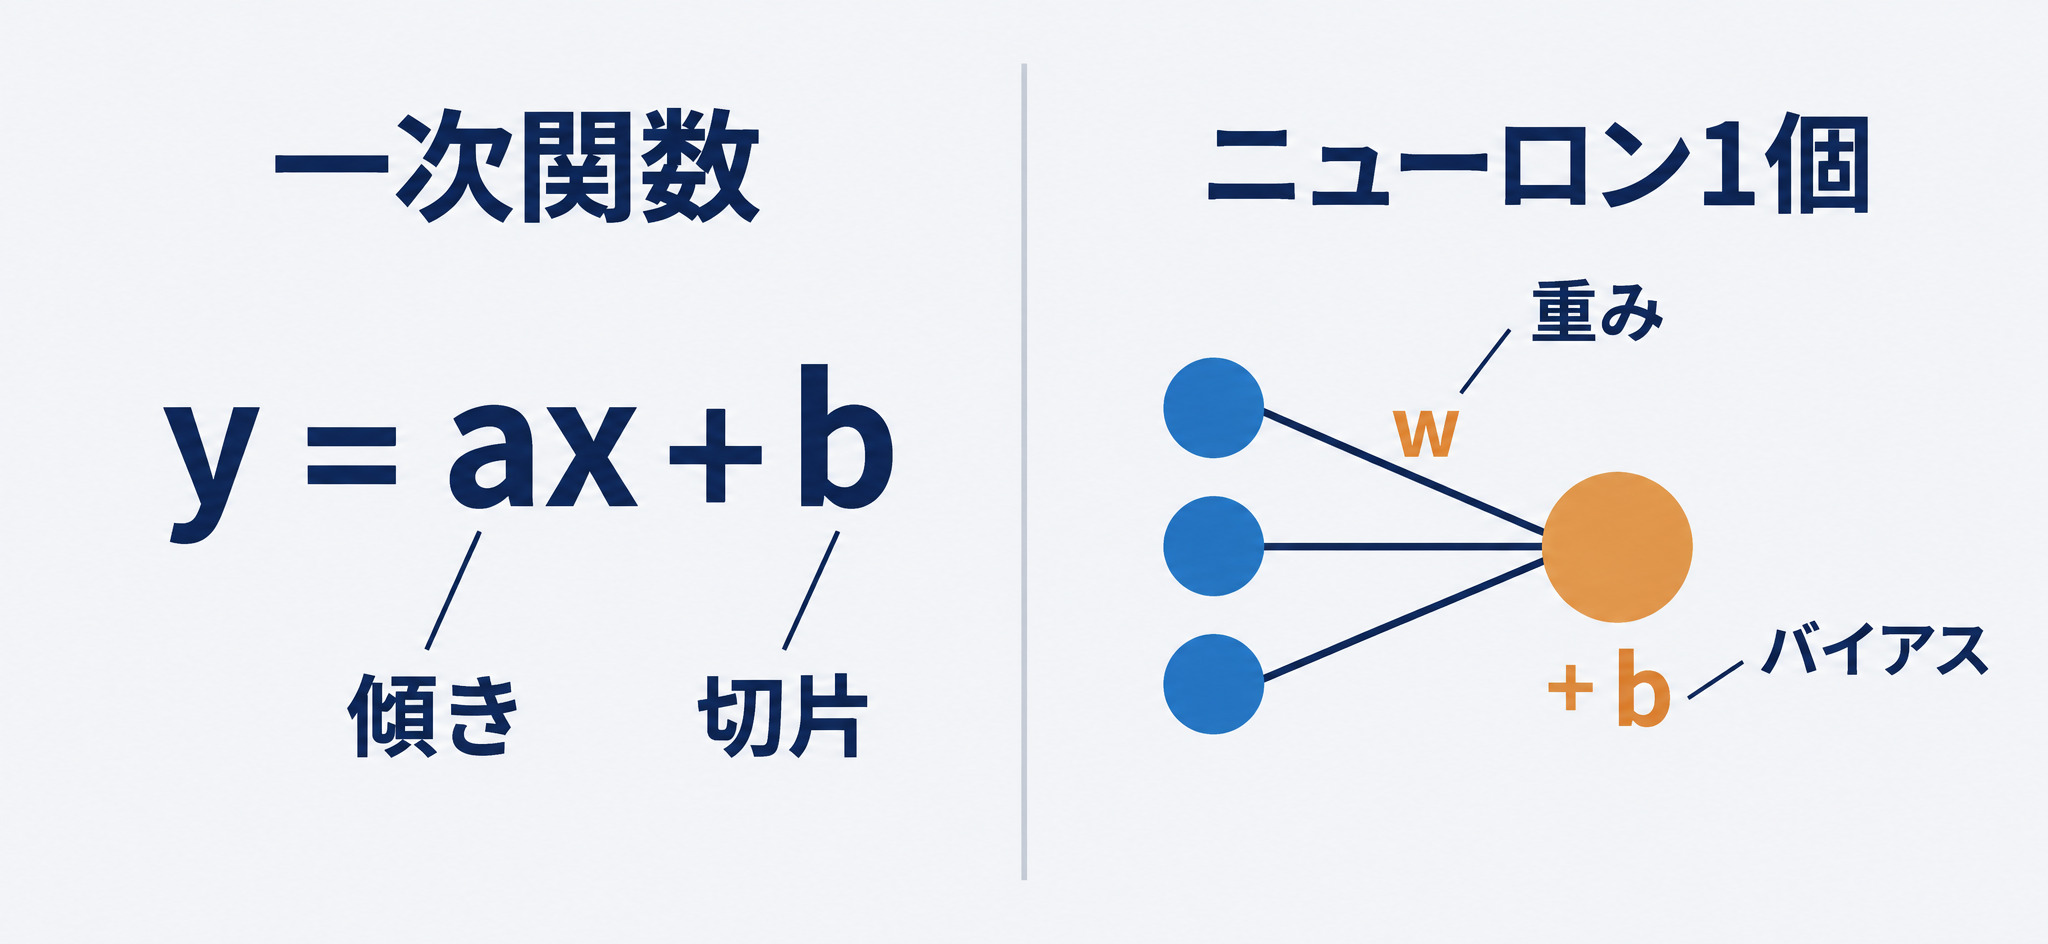
一次関数を思い出してください。y=ax+b という形です。中学校学習指導要領では第2学年で扱い、用語として「傾き」が挙げられています。
a は傾きで、x が1増えたときに y がどれだけ増えるかを決めます。b は切片で、直線が縦軸のどこを通るかを決めます。この2つの数値を変えれば、直線の形と位置が決まります。
この2つが、ニューラルネットワークのパラメータの正体です。
ニューロン1個の計算は、入力に重みをかけて足し、バイアスを足すだけ
ニューロン1個がやっているのは、一次関数を入力の数だけ並べた計算です。
入力が3つあるなら、それぞれに重みをかけて足し合わせ、最後にバイアスを足します。式にすると w1x1+w2x2+w3x3+b です。
重みは一次関数の傾きにあたり、バイアスは切片にあたります。名前が変わっただけで、やっていることは変わりません。重みが大きい入力ほど、答えへの影響が大きくなります。
PyTorchのtorch.nn.Linearのドキュメントも、全結合の層が行う変換を「入力に重みをかけ、バイアスを足す」式で定義し、重みとバイアスをどちらも「学習可能な」値として持つと書いています。実際のライブラリの中身も、ここで説明した計算そのものです。
活性化関数。足し算と掛け算のままでは曲がった境界を引けない
ただし、これだけでは足りません。足し算と掛け算だけを何層重ねても、結果は1本の直線にしかならないためです。
そこで、足し合わせた値に対して活性化関数という変換を加えます。たとえばReLUという関数は「マイナスなら0、プラスならそのまま」という単純な処理をします。
数字で追ってみます。入力が2、1、3、重みが0.5、マイナス1、0.2、バイアスが0.1のニューロンなら、0.5×2+(−1)×1+0.2×3+0.1で0.7です。ReLUを通しても、プラスなので0.7のまま次の層へ渡ります。バイアスがマイナス1だった場合は合計がマイナス0.4になり、ReLUを通すと0になります。つまり、このニューロンは次の層に何も伝えません。
バイアスは、ニューロンが信号を出し始める境目を動かす役割を持っていることが分かります。冒頭で触れた「一定を超えたら信号を出す」の「一定」を決めているのが、バイアスです。
この一手間が入ることで、直線では分けられないデータも扱えるようになります。層を重ねる意味が生まれるのも、活性化関数があるからです。
ニューラルネットワークはなぜ層を重ねるのか。入力層・中間層・出力層の役割
ニューロンを並べて層を作り、層を重ねてネットワークにします。
入力層・中間層(隠れ層)・出力層がそれぞれ担うこと
| 層 | 担うこと |
|---|---|
| 入力層 | データをそのまま受け取る。画像なら画素の値、表なら各列の数値 |
| 中間層(隠れ層) | 受け取った値を変換していく。ここが何層あるかで「深さ」が決まる |
| 出力層 | 答えの形に整える。分類なら各クラスの確率、予測なら1つの数値 |
中間層が隠れ層と呼ばれるのは、外から入力も出力も見えないためです。学習が終わったあとに中の数値を見ても、人が意味を読み取れる形にはなっていません。
層を重ねると表現できる形が増える
層を1つ増やすと、前の層が見つけた特徴を次の層が組み合わせられるようになります。
画像認識で言えば、最初の層が線や角のような単純な形を捉え、次の層がそれを組み合わせて目や耳のような部分を捉え、さらに次の層が顔全体を捉える、という積み上がり方をします。
人が「目と耳と鼻があれば猫」という手がかりを設計しなくても、層を重ねれば機械側が見つけます。ここが従来の機械学習との大きな違いです。
この性質には理論の裏づけもあります。1989年のHornikらの論文「Multilayer feedforward networks are universal approximators」は、中間層を持つネットワークが幅広い関数を任意の精度で近似できることを示しました。ただし、これは「表現できる形が存在する」という保証です。その形にたどり着くための重みを、手元のデータから見つけられるかどうかは別の問題で、それを担うのが次の章で扱う学習です。
多層パーセプトロン(MLP)とディープラーニングの境目
中間層を複数持つ基本形を多層パーセプトロン(MLP)と呼びます。scikit-learnのニューラルネットワークのドキュメントは、MLPを「データで学習して関数を学ぶ教師あり学習のアルゴリズム」と位置づけ、重みを coefs_、バイアスを intercepts_ という名前で保持しています。
では何層からディープラーニングかというと、厳密な線引きはありません。慣例として中間層が2層以上、あるいは相当に深いものを指して使われます。境目を覚えるより、層を重ねるほど表現できる形が増えるが、その分だけデータと計算資源が要るという関係を押さえるほうが役に立ちます。
ニューラルネットワークの重みはどう決まるのか。損失関数と誤差逆伝播
重みとバイアスの正体が分かったところで、その値がどう決まるのかを見ます。
学習とは、重みとバイアスを少しずつ動かしていく作業
最初、重みはランダムな値です。この状態では当然、答えは外れます。
そこで、答えとのズレを見ながら重みを少しずつ動かし、ズレが小さくなる方向へ寄せていきます。この繰り返しが学習です。
損失関数。答えとのズレを1つの数値にまとめる
重みを動かすには、どれだけ外れているかを数値で表す必要があります。この役目を果たすのが損失関数です。
予測値と正解の差を計算し、ネットワーク全体のズレを1つの数値にまとめます。学習の目的は、この数値を小さくすることに尽きます。
誤差逆伝播法。ズレの責任を出力側から手前の層へ配る
問題は、どの重みをどれだけ動かせばよいかです。層が深いと、重みの数は数万から数億になります。
ここで使うのが誤差逆伝播法です。出力側で計算したズレを、出力層から入力層に向かって逆向きにたどりながら、各層の重みが「そのズレにどれだけ責任があるか」を計算していきます。
責任の大きい重みほど大きく動かす。この計算を効率よく行う方法が整理されたのは1986年のことで、いまのニューラルネットワークの学習はすべてこの上に成り立っています。原典はRumelhart、Hinton、Williamsの論文「Learning representations by back-propagating errors」です。
学習率とミニバッチ。重みをどれだけ、何件ごとに動かすか
誤差逆伝播法で分かるのは、各重みを「どちらの向きに、どれだけ動かすと損失が減るか」です。実際にどれだけ動かすかは、学習率という設定値で決めます。学習率が大きすぎると損失の最も低い地点を飛び越えて行ったり来たりし、小さすぎるといつまでも学習が進みません。
また、データを全件見てから1回動かすのではなく、数十件から数百件ずつ区切って、そのたびに重みを動かすのが一般的です。この区切りをミニバッチと呼び、この進め方を確率的勾配降下法(SGD)と呼びます。その改良版であるAdamは、重みごとに動かす量を自動で調整します。scikit-learnのMLPでも、学習の方法として sgd と adam を選べます。
ニューラルネットワークの学習の流れ5ステップ
- 重みとバイアスをランダムな値で初期化する
- データを入力して、順方向に計算し、予測値を出す
- 損失関数で、予測値と正解のズレを数値にする
- 誤差逆伝播法で、各重みをどれだけ動かすべきかを計算する
- 重みを少しずつ動かし、2に戻る
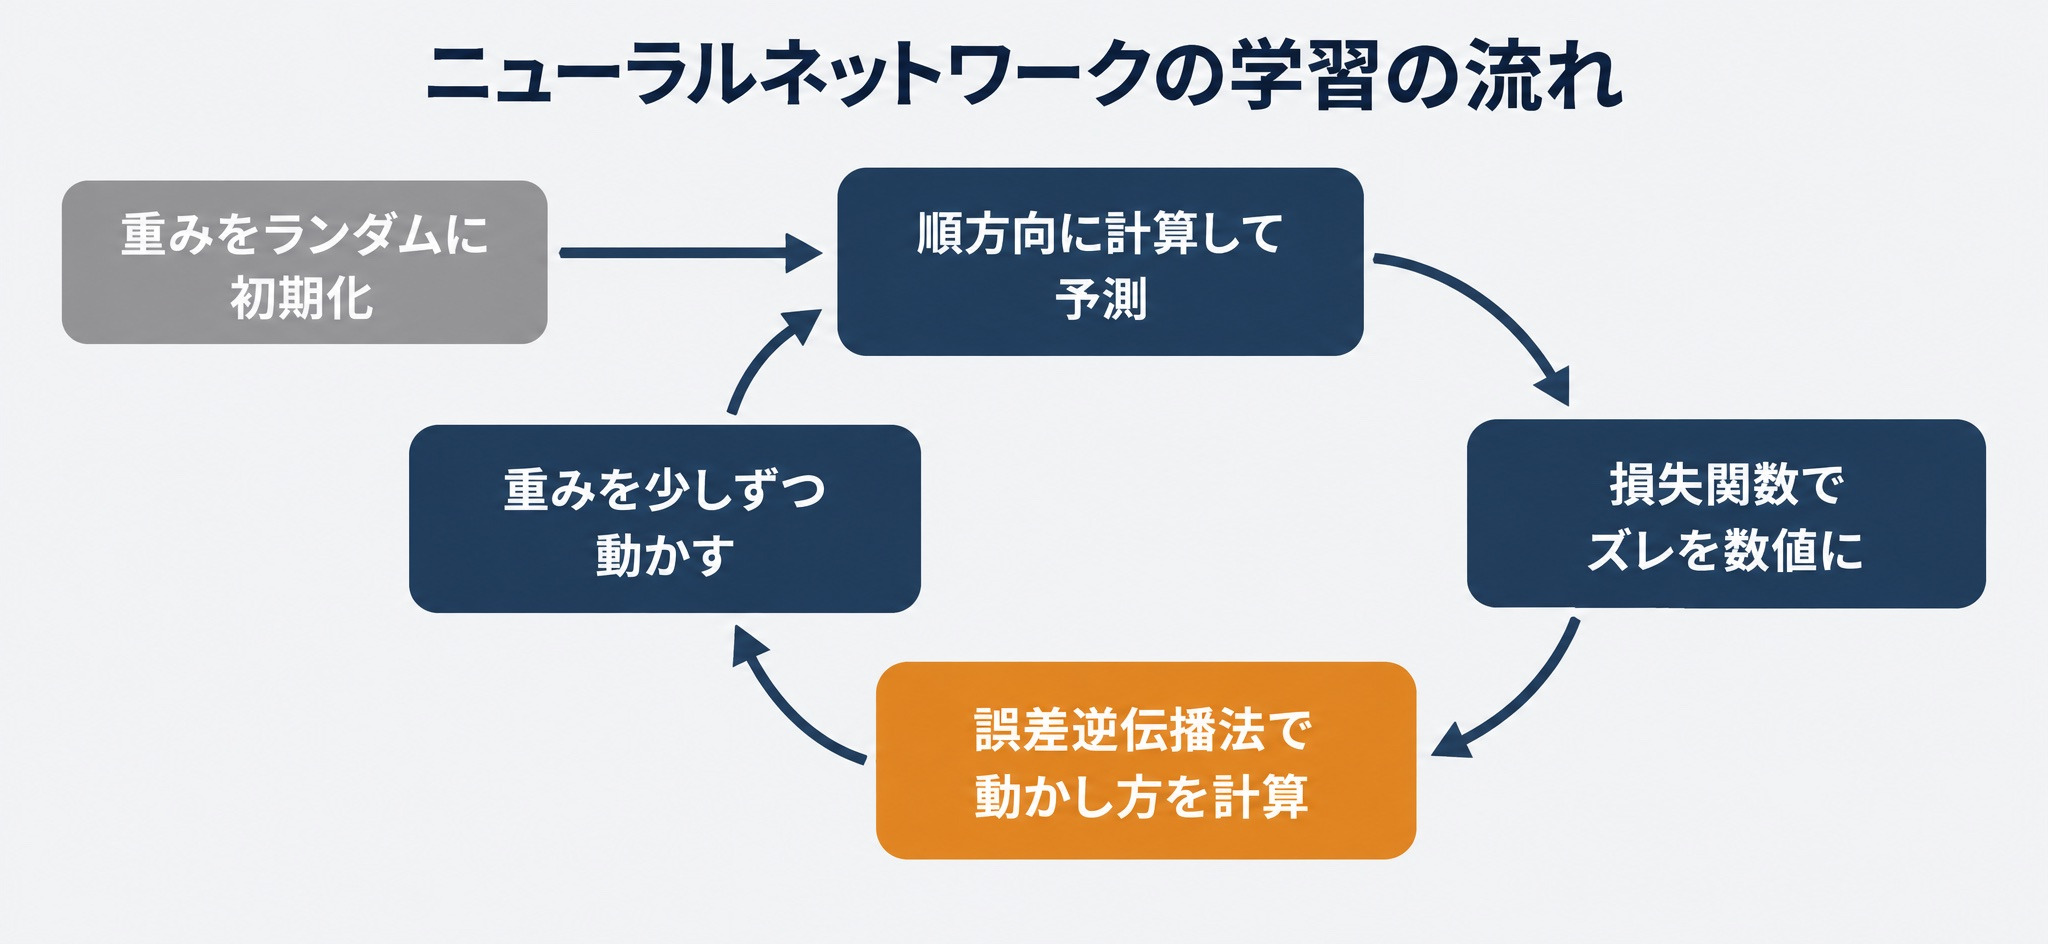
この2から5を、データを変えながら何万回、何百万回と繰り返します。学習に時間と計算資源がかかるのは、この繰り返しの回数が理由です。
ここまでニューラルネットワークの仕組みを解説しましたが、「理屈は追えたが、自分で組んで動かせる気がしない」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeでは、Pythonの基礎からデータの扱い、機械学習モデルの構築と評価までを順番に学べます。教材を進めるだけでなく、課題の添削と週1回の面談で詰まった箇所を確認できるため、自分の手で動かせる状態まで持っていけます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
ニューラルネットワークのパラメータ。一次関数の2個から1000億個まで
ここで冒頭の一次関数に戻ります。
パラメータとは、重みとバイアスをまとめた呼び方
ニュースで「パラメータ数1750億」と聞いたとき、その1個が何を指しているのか。答えは、重みかバイアスのどちらかです。
一次関数 y=ax+b のパラメータは、傾き a と切片 b の2個です。ニューロンが増え、層が増えれば、重みとバイアスの数もそれだけ増えます。パラメータ数とは、その総数のことです。
小さな例で数えてみます。縦横28画素の手書き数字の画像を読み取り、0から9のどれかを答えるネットワークを考えます。入力は28×28で784個です。中間層に128個のニューロンを置き、出力層を10個にします。
- 入力層から中間層。128個のニューロンそれぞれが784個の重みと1個のバイアスを持つので、784×128+128で100,480個
- 中間層から出力層。10個のニューロンそれぞれが128個の重みと1個のバイアスを持つので、128×10+10で1,290個
合計は101,770個です。中間層が1層しかない小さなネットワークでも、10万個を超えます。
一次関数は2個、GPT-3は1,750億個
数の変化を並べてみます。
| モデル | パラメータ数 |
|---|---|
| 一次関数 y=ax+b | 2個 |
| 小さなニューラルネットワーク | 数千から数万個 |
| GPT-3(2020年の論文で公表) | 1,750億個 |
| Llama 3の最大モデル(2024年の論文で公表) | 4,050億個 |
やっている計算の中身は、一次関数と同じ「かけて足す」です。それが1750億個分あり、層をまたいで組み合わさっている。この規模の差が、複雑な言語の扱いを可能にしています。
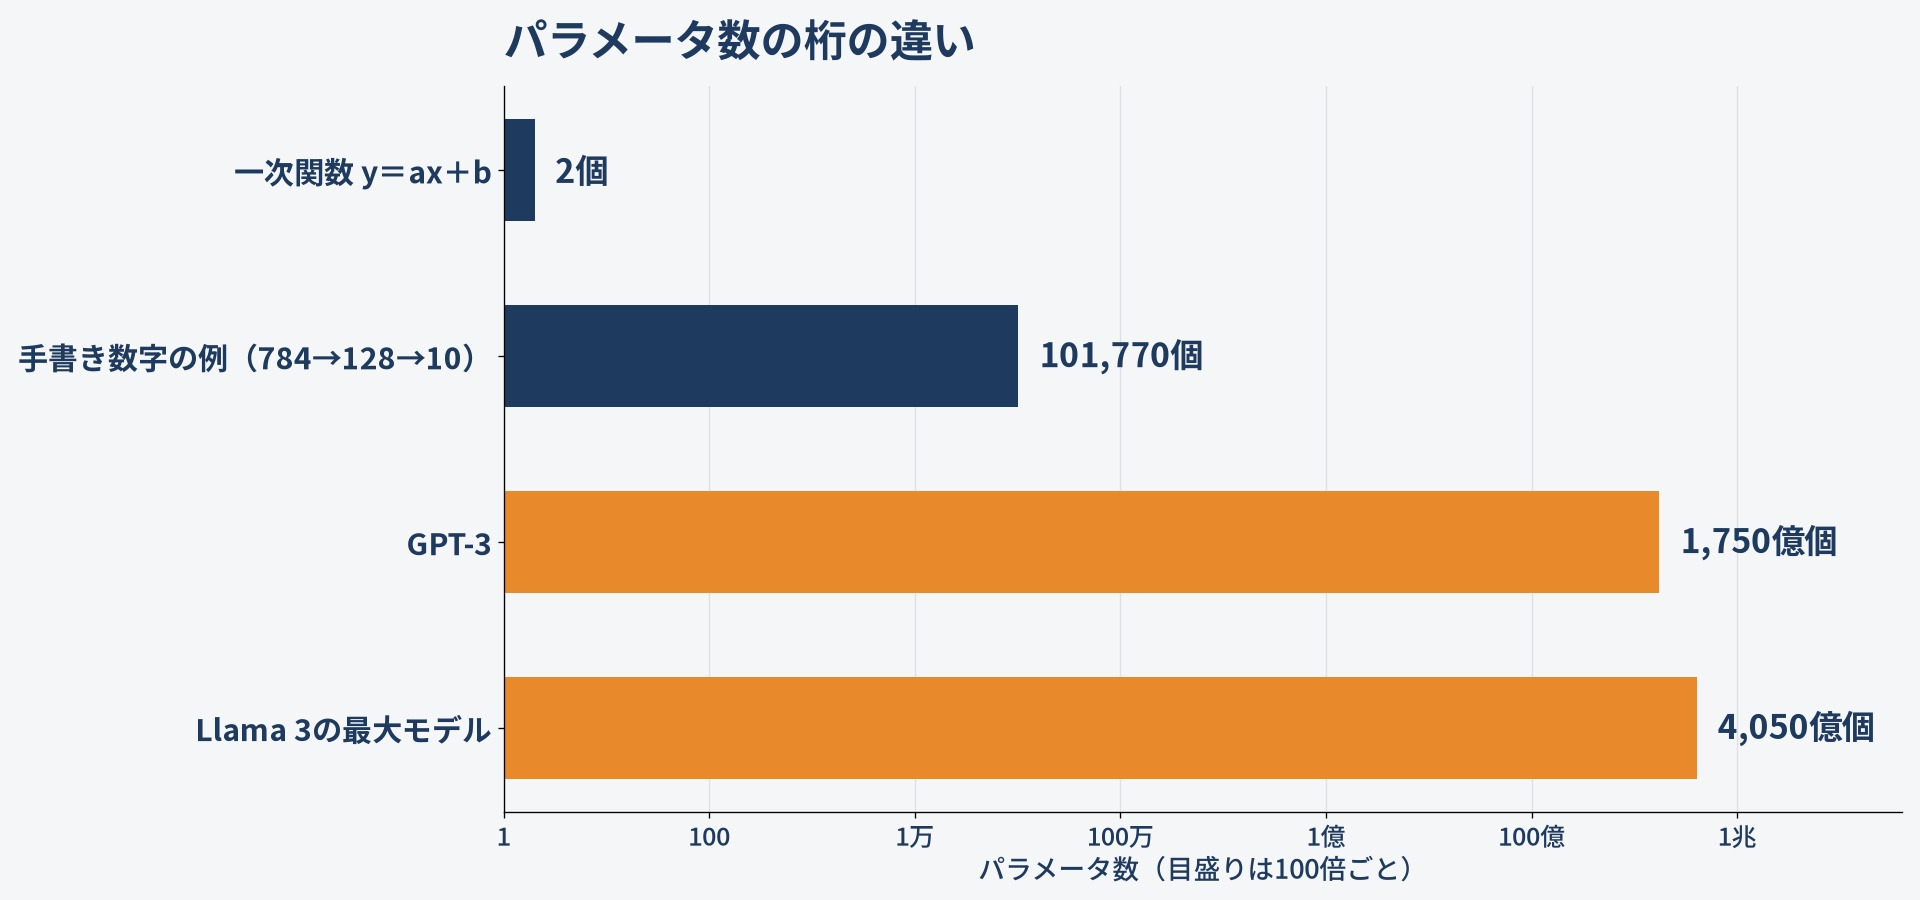
グラフの目盛りは100倍ごとに刻んでいます。手書き数字の例からGPT-3までは、100万倍以上の開きがあります。
パラメータを増やして得られるものと、必要になるもの
パラメータを増やせば、表現できる関係は複雑になります。ただし、増やせば必ず賢くなるわけではありません。
増やすほど、学習に必要なデータ量も、計算資源も、学習時間も増えます。データが足りないまま大きなモデルを使うと、学習データを覚えるだけで新しいデータに外す状態になります。
どこまで大きくするかは、手元のデータ量と目的で決まります。小さいモデルで足りる用途は少なくありません。小規模なモデルの考え方はSLM(小規模言語モデル)とは。LLMとの違いと使いどころを解説で扱っています。
ニューラルネットワークの種類。全結合からCNN・RNN・Transformerまでの系譜
種類が多く見えますが、並列に並ぶ別物ではありません。前の形の何が苦手だったかを埋める形で出てきたという系譜があります。
全結合型(DNN・MLP)。すべてのノードをつなぐ基本形
前の層のすべてのノードと、次の層のすべてのノードをつなぐ基本形です。汎用性は高いものの、入力が大きくなると重みの数が爆発します。
画像を扱う場合、縦横100画素の白黒画像でも入力は1万個です。全結合にすると重みが数千万個になり、現実的ではありません。
畳み込みニューラルネットワーク(CNN)。画像の位置のずれに強くする
そこで出てきたのがCNNです。画像の小さな領域ごとに同じフィルタをかけていき、線や角のような局所的な特徴を拾います。
同じフィルタを使い回すので重みの数が抑えられ、しかも対象が画像の中で少しずれていても同じものとして扱えます。画像認識が実用になったのはこの構造のおかげです。
再帰型ニューラルネットワーク(RNN)とLSTM。順番のあるデータを扱う
文章や音声のように順番があるデータでは、前の情報を覚えておく必要があります。RNNは、前の時点の出力を次の時点の入力に回す構造でこれを実現しました。
ただし、順番が離れると情報が薄れてしまう弱点があり、それを補うためにLSTMという改良型が使われました。それでも、前から順に処理する以上、計算を並列化できないという制約は残りました。
オートエンコーダとGAN。正解ラベルなしで特徴をつかむ・作り出す
オートエンコーダは、入力をいったん小さく圧縮してから元に戻すように学習します。圧縮した部分にデータの特徴が凝縮されるので、次元削減や異常検知に使われます。
GANは、作る側と見破る側の2つのネットワークを競わせて、本物に近いデータを作り出します。画像生成で広く使われた構造です。
Transformer。離れた語どうしの関係を一度に見る
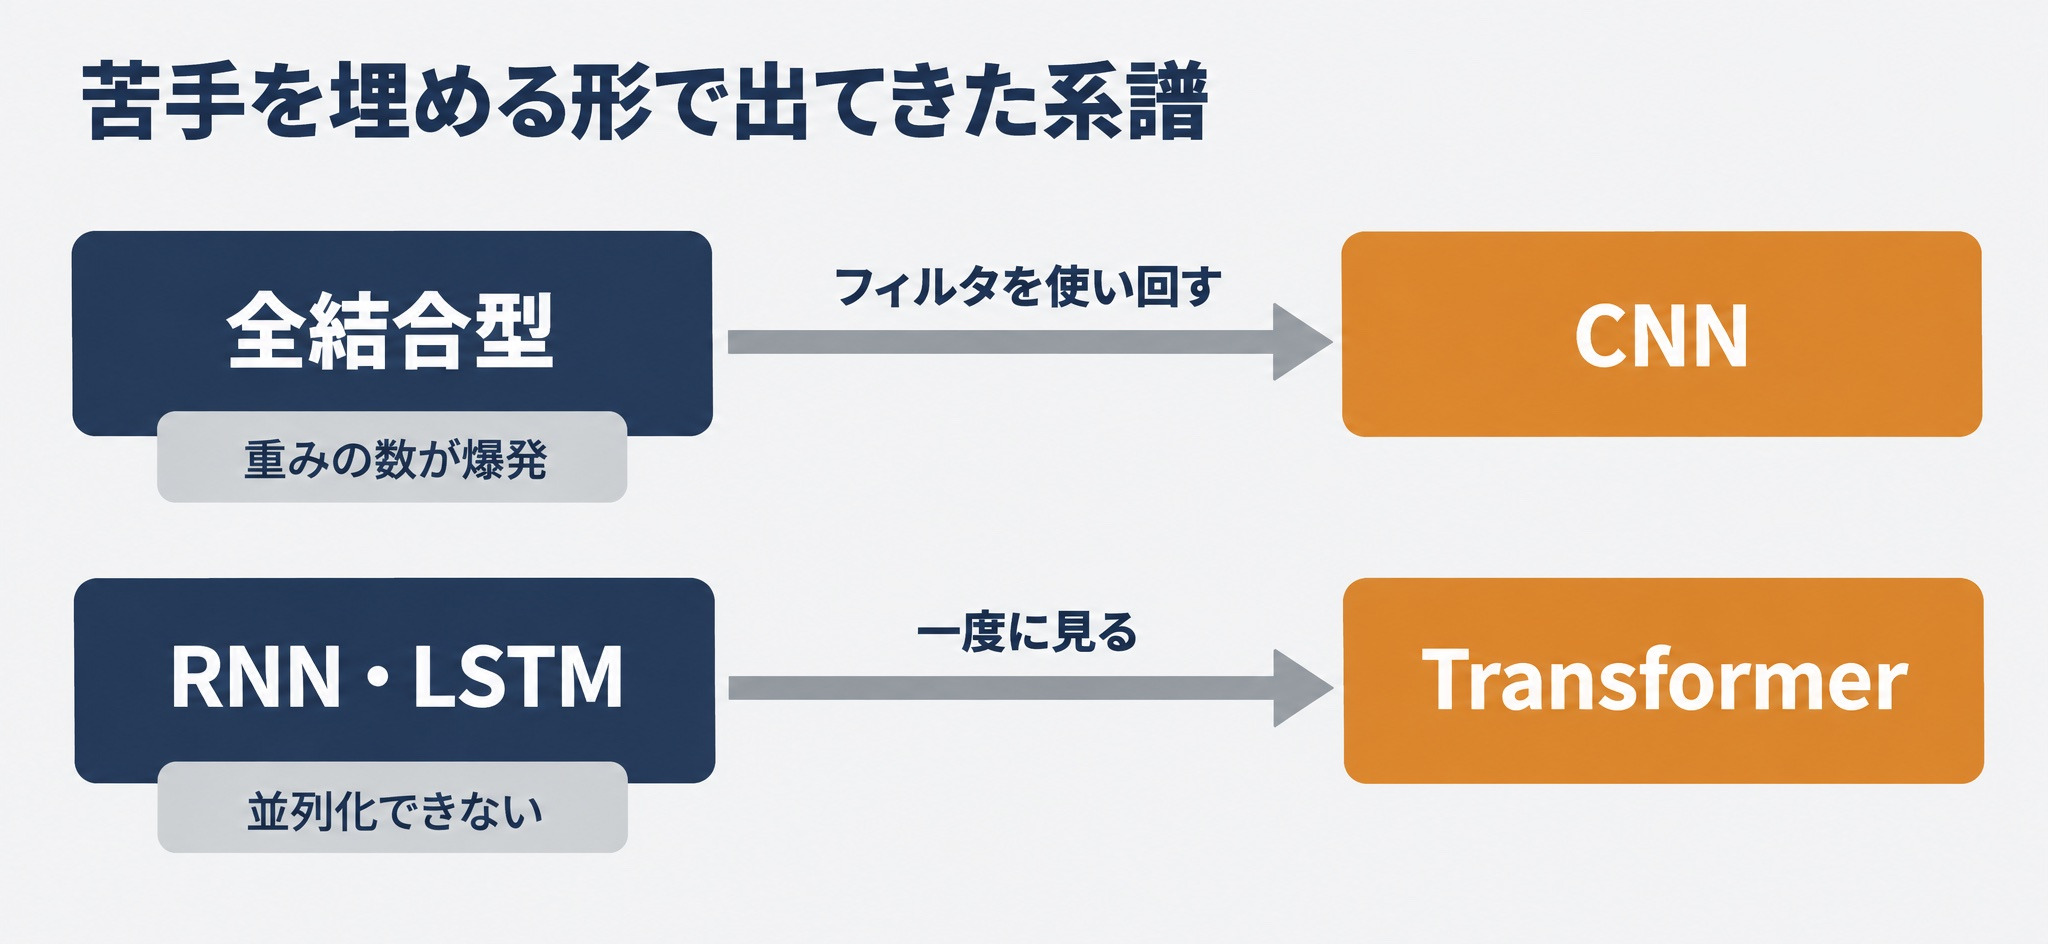
RNNの制約を外したのがTransformerです。前から順に処理するのをやめ、文中のどの語とどの語が関係しているかを一度に見る仕組みを導入しました。
これによって離れた語の関係を捉えられるようになり、同時に計算を並列化できるようになりました。いまのLLMはこの構造の上に成り立っています。
LLMそのものはLLMとは何か。仕組みと種類、企業での活用方法をわかりやすく解説で、生成AIが文章を作る流れは生成AIの仕組みとは。データからテキストが生成されるまでをわかりやすく解説で扱っています。公開されているモデルの一覧はLLMモデル一覧。主要モデルの特徴と選び方を解説にまとめています。
ニューラルネットワークの活用事例と、実務で注意すること
画像認識・自然言語処理・音声認識・レコメンドでの使われ方
画像認識では、製造業の外観検査や医療画像の診断支援に使われています。自然言語処理では文章の分類や翻訳、対話。音声認識では議事録の文字起こし。レコメンドでは、購買履歴から次に買いそうな商品を出す用途です。
いずれも、人が手がかりを設計しにくいデータを扱う点が共通しています。
学習データの質と量が精度を決める
実務でつまずくのは、たいていモデルの選び方ではなくデータのほうです。
件数を増やす前に、ラベルの付け方が揃っているか、欠損や表記ゆれが残っていないかを見るほうが効きます。質の悪いデータを大量に入れても、精度は上がりません。
過学習と、判断の根拠を説明しにくいこと
学習データにだけよく当たり、新しいデータで外すモデルになることがあります。これを過学習と呼びます。データを学習用と検証用に分け、検証用での精度で判断するのが基本です。
過学習を抑える代表的な工夫がDropoutです。学習中に、一部のニューロンの出力をランダムに0にして計算します(PyTorchのnn.Dropout)。特定のニューロンの組み合わせだけに頼った答え方を覚えにくくなるため、新しいデータへの当たり方が安定します。検証用の精度が学習用より大きく下がり始めた時点で学習を止める方法も、あわせて使われます。
もうひとつ、中間層の重みがどうなっているかを人が読み取れないため、なぜその判断になったかを説明しにくいという性質があります。審査や医療のように説明責任がある場面では、精度が多少低くても説明できる手法が選ばれることがあります。
学習済みモデルを自社のデータに合わせる方法はファインチューニングとは。仕組み・種類・RAGとの違いをわかりやすく解説と転移学習とファインチューニングの違い。使い分けをわかりやすく解説で、動かすために必要なGPUの見積りはローカルLLMに必要なGPUスペックで扱っています。
まとめ
- ニューラルネットワークとは、データから判断のしかたを学ぶ計算の仕組み。機械学習の手法のひとつで、層を深く重ねたものがディープラーニング
- ニューロン1個の計算は、一次関数と同じ「入力に重みをかけて足し、バイアスを足す」だけ。重みは傾き、バイアスは切片にあたる
- 活性化関数を入れることで、直線では分けられないデータも扱えるようになる
- 層を重ねると、前の層が見つけた特徴を次の層が組み合わせられる
- 学習とは、損失関数でズレを数値にし、誤差逆伝播法で各重みの動かし方を計算して、少しずつ寄せていく作業
- パラメータとは重みとバイアスの総数。一次関数は2個、GPT-3は1,750億個。やっている計算の中身は変わらない
- 種類は並列の別物ではなく、前の形の弱点を埋める形で出てきた系譜。全結合からCNN、RNN、そしてTransformerへ
ニューラルネットワークを学ぶなら「Craft College」へ
「仕組みは分かったが、自分で組んで動かせるようになるには何から始めればいいのか」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- 用語の解説を読む段階から、自分で組める段階へ進めたい方
- 数式で止まってしまい、独学が続かなかった方
- 自社のデータで何ができるのかを、手を動かしながら確かめたい方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
データサイエンス全体の学び方はデータサイエンスとは。定義・活用事例・学び方をわかりやすく解説でも扱っています。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。