Claude APIとは。使い方・料金・レート制限を2026年9月時点の実測で読み解く
「Claudeを自社のシステムに組み込みたいが、料金表のどこを読めば月の費用が分かるのか」「AnthropicとAmazon Bedrockのどちらで契約すべきか」と迷っている方も多いのではないでしょうか?
Claude APIの費用は、モデルの単価だけでは決まりません。入力と出力のトークン数、プロンプトキャッシュの効き方、バッチで流すかどうかの掛け算で変わります。しかもモデルと単価は数か月で入れ替わり、2026年9月にもSonnet 5の価格の扱いが変わりました。
そこで本記事では、
- Claude APIのキー発行から最初の呼び出しまでの手順
- 2026年9月時点のモデルの選び方と、料金表の読み方
- レート制限、Bedrock・Google Cloud経由との違い、業務データの扱い
を解説します。掲載したコードと出力は、2026年9月23日に実際にClaude APIを呼んで得たものです。実行環境はApple M1 Pro、Python 3.11.6、Anthropic公式のPython SDK(anthropic 0.100.0)で、APIキーは環境変数から読み込んでいます。料金とモデルの情報は、同日に確認した公式ドキュメントに基づきます。
Claude APIを使った社内システムの開発を検討している方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
- Claude APIとは。Anthropicのモデルを自社のプログラムから呼ぶ仕組み
- Claude APIの使い方。キー発行から最初の呼び出しまでの4ステップ
- Claude APIのモデルの選び方。2026年9月時点の4モデル
- Claude APIの料金の読み方。入力・出力・キャッシュ・バッチ
- Claude APIのレート制限。ティアと429エラーへの対処
- Claude APIとAmazon Bedrock・Google Cloud経由の違い
- Claude API固有の機能。思考とツール使用
- Claude APIで業務データを扱うときの確認手順
- Claude APIの要点まとめ
- Claude APIを使ったAI開発は「リベルクラフト」へ
Claude APIとは。Anthropicのモデルを自社のプログラムから呼ぶ仕組み
Claude APIは、チャット画面を通さずに、Claudeを自社のアプリケーションや業務システムから呼び出すための入口です。
Anthropic APIと同じもの。Messages APIが入口になる
Claude APIとは、Anthropicが提供する大規模言語モデル「Claude」を、HTTPリクエストで呼び出すための開発者向けAPIです。「Anthropic API」と呼ばれることもありますが、指しているものは同じです。
呼び出しの中心は POST /v1/messages(Messages API)の1本です。会話の履歴、システムプロンプト、使わせたいツールの定義をまとめて送ると、Claudeの応答と、消費したトークン数が返ってきます。バッチ処理やトークン数の計算といった周辺の機能も、このMessages APIに渡す形式をそのまま使います。
LLMそのものの仕組みはLLM(大規模言語モデル)とは。企業での活用方法と事例で解説しています。
チャット版のClaude(Pro・Max)との違い
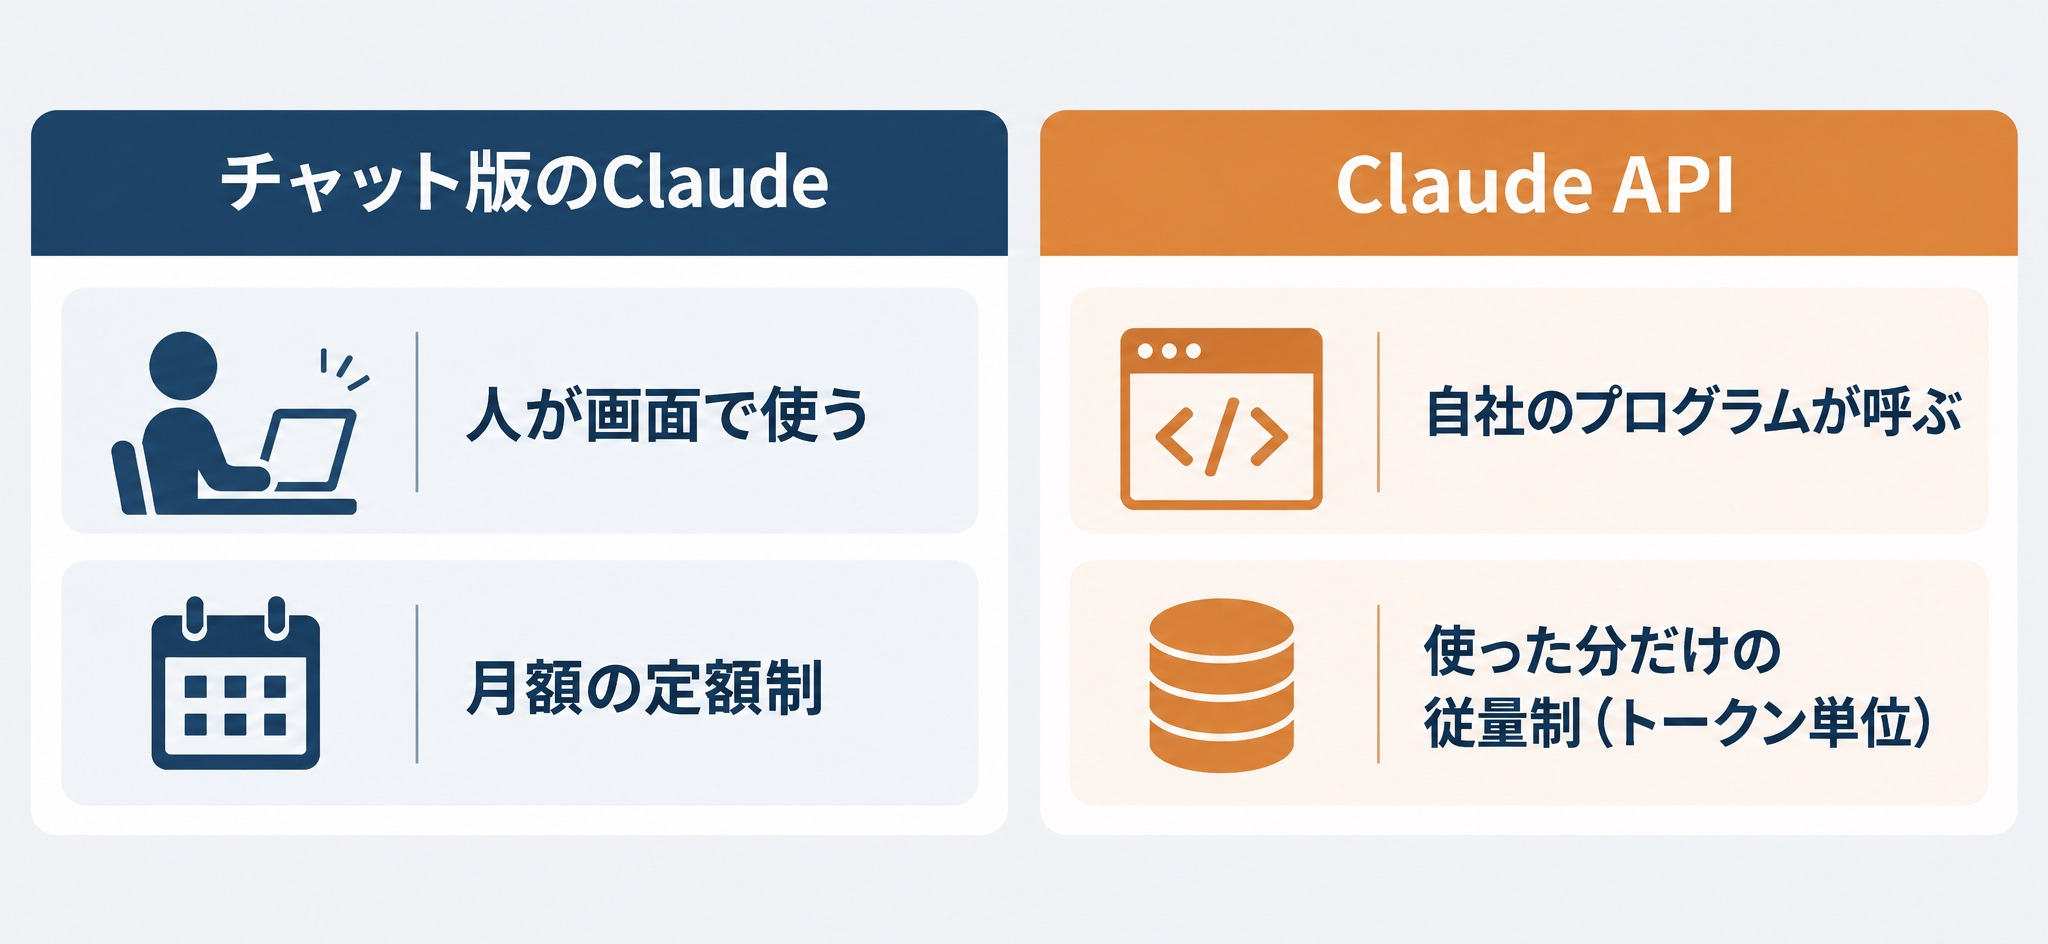
チャット版とAPIの違いは、使う場所と支払い方にあります。
- チャット版(claude.ai):人が画面で対話する。Proは年払いで月17ドル(月払いなら20ドル)、Maxは月100ドルからの定額制で、上限の範囲で使う
- Claude API:自社のプログラムが呼び出す。使ったトークンの量に応じて払う従量制
つまり、Proを契約してもAPIの利用枠は付きません。API用の契約と支払いは、後述するClaude Consoleで別に設定します(料金はclaude.com/pricing、2026年9月23日確認)。
社内の問い合わせ対応やRAG、AIエージェントのように、Claudeを業務システムの部品として組み込む用途では、APIを使うことになります。
Claude APIの使い方。キー発行から最初の呼び出しまでの4ステップ
ここまででClaude APIの位置づけを整理しました。次に、実際に最初の1回を呼ぶまでの手順を4つに分けて説明します。手順は公式のクイックスタートに沿っています。
1. Claude Consoleでアカウントを作り、支払いを設定する
Claude Consoleでアカウントを作成し、組織(Organization)を用意します。支払い方法と支出の上限は、Consoleの Settings の Billing で設定します。支出上限は、次の手順で発行するキーを使い始める前に決めておくと、テスト中の想定外の請求を防げます。
2. APIキーを発行して環境変数に入れる
Consoleの Settings の API keys で「Create key」を押し、名前・有効期限・紐づけるアカウントを選びます。公式のAPIキーの説明によると、キーは sk-ant- で始まり、全体が表示されるのは作成時の一度だけです。控え損ねたら作り直すしかないので、その場でシークレット管理の仕組みに保存します。
キーには、本人として動く「個人キー」と、CIや本番サービス向けの「サービスアカウントキー」があります。公式は、手元の開発には個人キー、共有するものにはサービスアカウントキーを勧めています。担当者が異動しても本番が止まらないよう、本番用は後者で発行しておくのが安全です。
発行したキーは、コードに直接書かずに環境変数へ入れます。
export ANTHROPIC_API_KEY="sk-ant-..."3. Python SDKを入れて最初の呼び出しを送る
公式SDKを入れれば、環境変数のキーは自動で読み込まれます。
pip install anthropic次のコードは、最も安いHaiku 4.5に質問を1つ送る例です。
import anthropic

client = anthropic.Anthropic()  # 環境変数 ANTHROPIC_API_KEY を自動で読む

message = client.messages.create(
    model="claude-haiku-4-5",
    max_tokens=300,
    messages=[
        {"role": "user", "content": "Claude APIを業務で使う前に確認すべきことを3つ、1行ずつ挙げてください。"}
    ],
)

print(message.content[0].text)
print("stop_reason:", message.stop_reason)
print("usage:", message.usage.input_tokens, "input /", message.usage.output_tokens, "output")
実行すると、次の出力が返りました(2026年9月23日)。
# Claude APIを業務で使う前に確認すべきこと

1. **利用規約と料金体系** - 業務用途での利用が許可されているか、予想される費用を把握しているか確認する

2. **セキュリティとデータ保護** - 送信するデータの機密性レベル、APIの暗号化通信、Anthropicのデータ取り扱いポリシーを確認する

3. **API仕様と制限事項** - レート制限、レスポンス時間、モデルのバージョン、エラーハンドリング方法を確認する
stop_reason: end_turn
usage: 40 input / 176 output
LangChainなどのフレームワークから呼ぶ場合も、内部では同じMessages APIを使っています。
4. レスポンスのusageでトークン数を確かめる
請求額の元になるのは、レスポンスの usage に入っているトークン数です。上の例は入力40トークン、出力176トークンでした。Haiku 4.5の単価(入力が100万トークンあたり1ドル、出力が5ドル)で計算すると、この1回は約0.00092ドルです。
stop_reason は応答が終わった理由を示します。end_turn は最後まで答えた状態で、max_tokens なら上限で打ち切られています。本番のコードでは、この値を見てから本文を使う習慣をつけておくと、途中で切れた応答をそのまま後工程へ渡す事故を防げます。
Claude APIのモデルの選び方。2026年9月時点の4モデル
呼べるようになったら、次はどのモデルを呼ぶかを決めます。2026年9月23日時点で、公式のモデル一覧が現行として並べているのは4モデルです。
現行4モデルの違い
| モデル | API ID | 入力単価 | 出力単価 | キャッシュ読み出し | コンテキスト | 最大出力 |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | claude-fable-5-1 | 10ドル | 50ドル | 0.25ドル | 100万 | 12.8万 |
| Claude Opus 5.5 | claude-opus-5-5 | 4ドル | 20ドル | 0.20ドル | 100万 | 12.8万 |
| Claude Sonnet 5 | claude-sonnet-5 | 2ドル | 10ドル | 0.20ドル | 100万 | 12.8万 |
| Claude Haiku 4.5 | claude-haiku-4-5 | 1ドル | 5ドル | 0.10ドル | 20万 | 6.4万 |
単価はいずれも100万トークンあたり、コンテキストと最大出力はトークン数です(2026年9月時点・料金ページ)。
この表から読み取れるのは、上位モデルほど単価が上がる一方で、キャッシュ読み出しの単価はOpus 5.5とSonnet 5で同じ0.20ドルになっている点です。Opus 5.5のキャッシュ読み出しは入力単価の5%、Fable 5.1は2.5%に設定されていて、同じ前提を繰り返し送る用途では上位モデルとの差が縮まります。
迷ったらOpus 5.5、量が多い処理はSonnet 5かHaiku 4.5
公式は、迷ったらOpus 5.5から始め、難しい推論や長時間のエージェント処理で足りなければFable 5.1を使うよう案内しています。これを実務に当てはめると、次のように分けられます。
- Opus 5.5:設計レビュー、長い文書の突き合わせ、AIエージェントの司令塔
- Sonnet 5:RAGの回答生成や社内チャットボットのように、件数が多く応答速度も求められる処理
- Haiku 4.5:分類・抽出・振り分けのような短い定型処理
Sonnet 5の単価は、発表時に「2026年8月31日までの導入価格」とされていた入力2ドル・出力10ドルが標準価格になり、9月1日に予定されていた3ドル・15ドルへの値上げは行われないと料金ページに明記されています。古い記事の単価をそのまま見積もりに使わないよう注意してください。
もう1つの注意点は提供終了の予定です。Haiku 4.5はモデル一覧で「2026年10月15日より前には提供を終了しない」とされています。つまり10月15日以降は終了の可能性があるため、長く使う処理に組み込むなら、モデルの提供終了のページを定期的に確認してください。
他社を含むLLMの全体像は主要なLLMモデル8選一覧比較表にまとめています。
Claude APIの料金の読み方。入力・出力・キャッシュ・バッチ
モデルの単価が分かったところで、次は請求額がどう決まるかを見ていきます。Claude APIは、使ったトークンの分だけConsoleで設定した支払い方法に請求される従量制です。
料金は100万トークンあたりの単価で決まる
1回の料金は「入力トークン数×入力単価+出力トークン数×出力単価」です。出力の単価は入力の5倍なので、長い回答を書かせる処理ほど費用がかさみます。
注意したいのは、画面に見える質問と回答のほかにも、課金されるトークンがある点です。
- 入力に数えられる会話の履歴(2回目以降のやり取りでは、前の発言も毎回送り直す)
- 入力に数えられるシステムプロンプトと、RAGで検索して差し込んだ文書
- 入力に数えられるツールの定義(ツールを使うと、定義とは別にツール用のシステムプロンプトが加わる。Opus 5.5では286トークン)
- 出力に数えられる「思考」のトークン(後述)
同じ文章でもトークン数はモデルと言語で変わる
見積もりの前に、手元の文章が何トークンになるかを確かめておきます。Claude APIには、呼び出しの前にトークン数だけを数える count_tokens があります。日本語の問い合わせ文(90字)と、同じ内容の英文(38語)を3つのモデルで数えました。ここから先のコードは、最初の例と同じく import anthropic と client = anthropic.Anthropic() を済ませた状態から書いています。
ja = ("当社では、問い合わせメールを分類し、担当部署と優先度を付けてから"
      "チケット管理システムに登録しています。月に約3,000件あり、"
      "分類ミスが起きると対応が1日以上遅れることがあります。")
en = ("We classify incoming support emails, assign a department and a priority, "
      "and then register them in our ticketing system. We receive about 3,000 "
      "emails a month, and a misclassification can delay the response by more than a day.")

for model in ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]:
    counts = [client.messages.count_tokens(model=model, messages=[{"role": "user", "content": t}]).input_tokens
              for t in (ja, en)]
    print(f"{model:18s} 日本語 {counts[0]:4d} tokens / 英語 {counts[1]:4d} tokens")
print("日本語の文字数:", len(ja), "英語の単語数:", len(en.split()))
claude-haiku-4-5 日本語 84 tokens / 英語 58 tokens
claude-sonnet-5 日本語 82 tokens / 英語 68 tokens
claude-opus-5-5 日本語 84 tokens / 英語 70 tokens
日本語の文字数: 90 英語の単語数: 38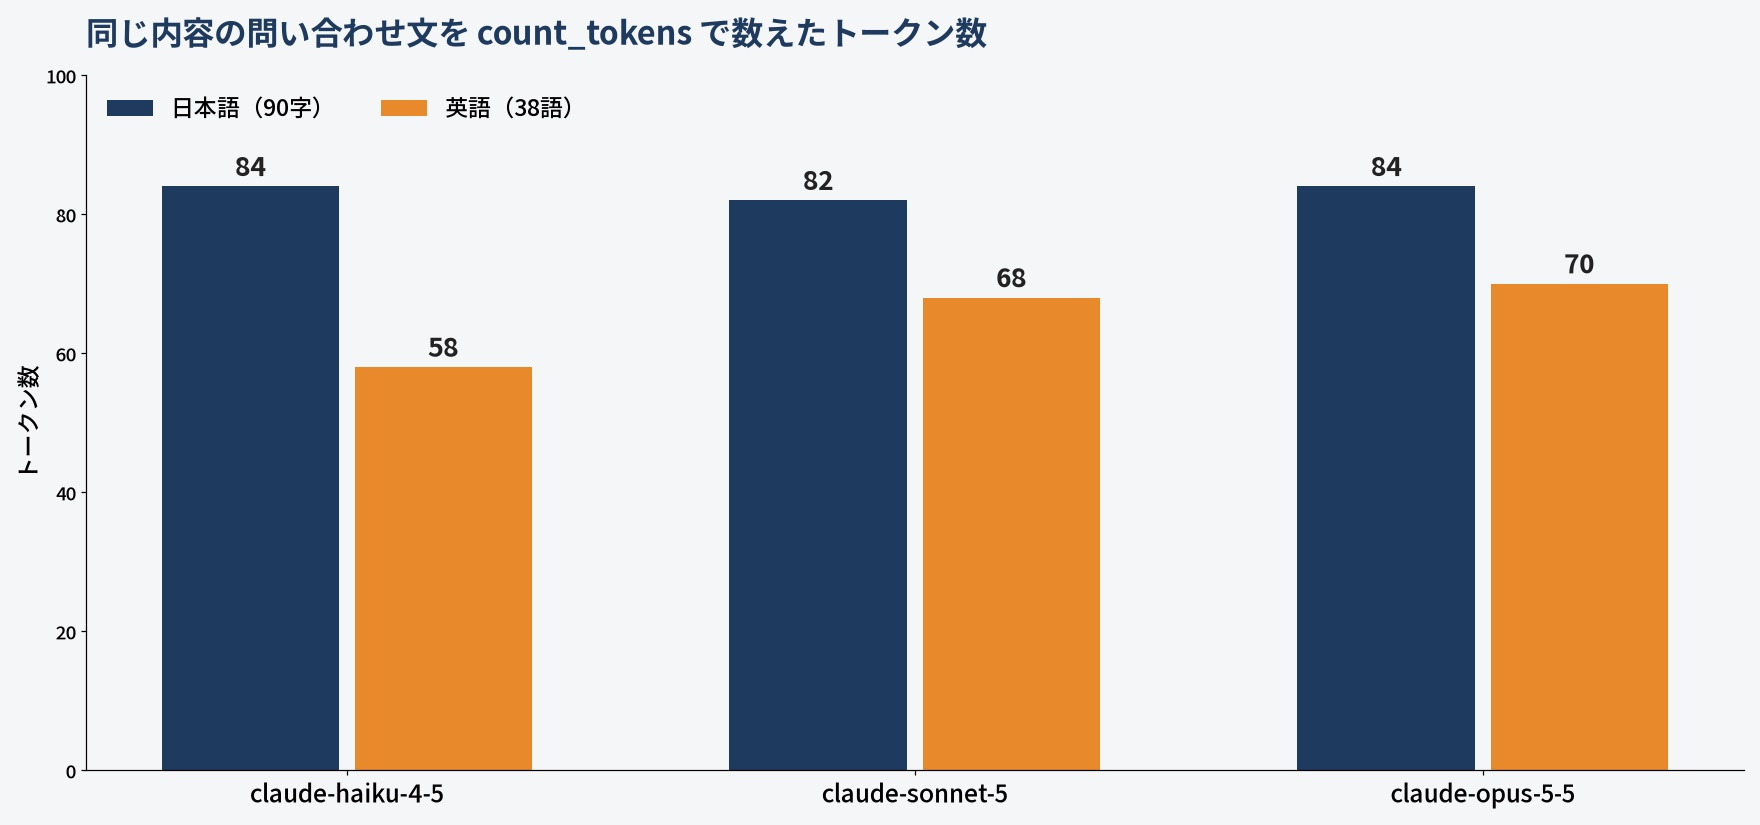
この文では、日本語は90字で82〜84トークンとほぼ1字1トークンになり、モデルによる差はほとんど出ませんでした。一方、英文はHaiku 4.5の58トークンに対し、Opus 5.5では70トークンに増えています。公式の料金ページは、Claude 4.7以降のモデルが使う新しいトークナイザーについて「同じ文章でおよそ30%多いトークンになる」と注記しています。今回の1文の測定だけで一般化はできないため、モデルを乗り換えるときは、自社の実際の入力で count_tokens を測り直してから見積もるのが確実です。
プロンプトキャッシュ。同じ前提を2回目から約10分の1で読む
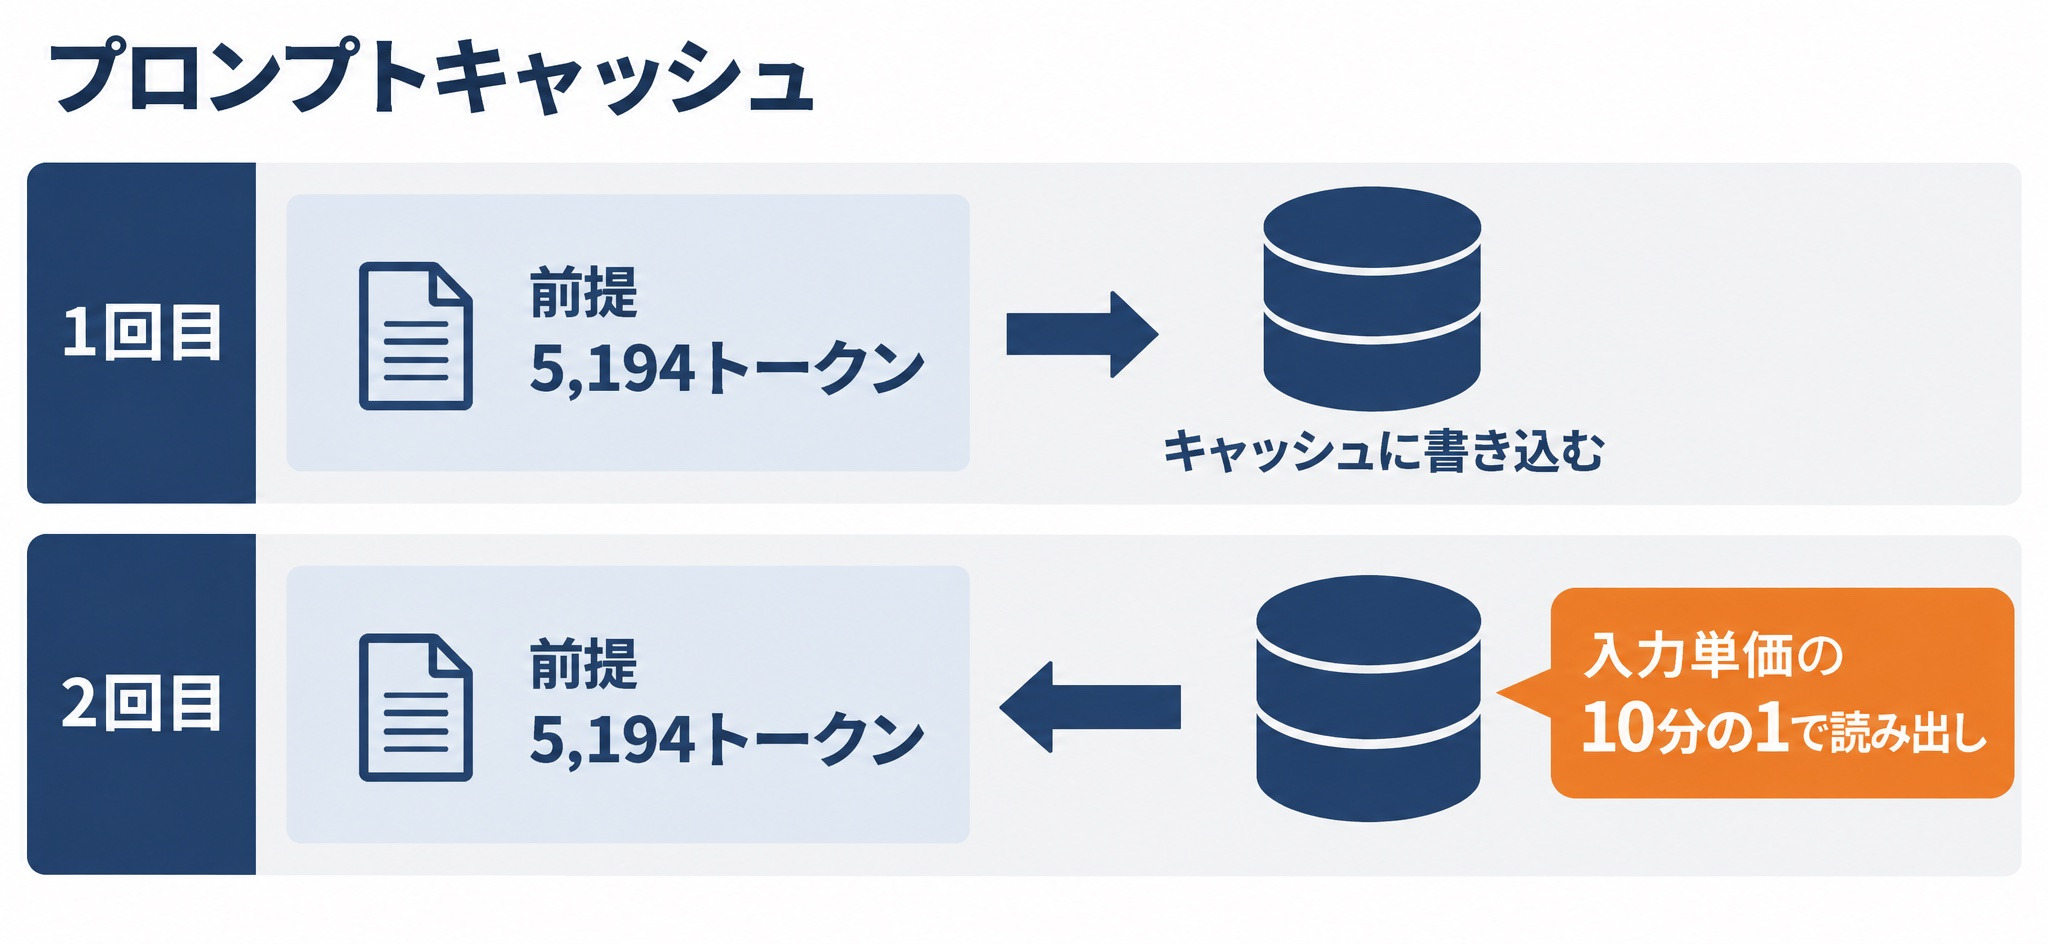
Claude APIで費用を大きく左右するのが、プロンプトキャッシュです。プロンプトキャッシュとは、毎回同じ内容を送る前半部分(システムプロンプトや社内規程など)をAnthropic側に一時保存し、2回目以降は安い単価で読み出す仕組みです。
公式のプロンプトキャッシュの説明と料金ページによると、単価は入力単価に対する倍率で決まります。
- 5分間有効な書き込み:1.25倍
- 1時間有効な書き込み:2倍
- 読み出し:0.1倍(Opus 5.5は0.05倍、Fable 5.1は0.025倍)
5分のキャッシュは、読まれるたびに有効期限が延びます。キャッシュできる最小の長さもモデルごとに決まっていて、Sonnet 5は1,024トークン、Opus 5.5は512トークン、Haiku 4.5は4,096トークンです。これより短いと、指定してもエラーにならずに素通りします。
問い合わせの分類ルール(約5,000トークン)をシステムプロンプトに置き、Sonnet 5で2通のメールを続けて分類しました。
# 社内の分類ルールを想定したダミー文書(5種類のルールを24回繰り返した120行)
rules = "\n".join(
    f"ルール{i:03d}:件名または本文に「{kw}」を含む問い合わせは{dept}に割り当て、優先度は{prio}とする。"
    for i, (kw, dept, prio) in enumerate(
        [("請求", "経理部", "中"), ("解約", "営業部", "高"), ("障害", "開発部", "高"),
         ("パスワード", "情報システム部", "中"), ("見積", "営業部", "低")] * 24, start=1)
)
system = [{"type": "text",
           "text": "あなたは問い合わせメールを分類する担当者です(分類ルール第2版)。次の分類ルールに従い、部署と優先度だけを答えてください。\n" + rules,
           "cache_control": {"type": "ephemeral"}}]  # ここまでをキャッシュする

for i, mail in enumerate(["先月分の請求書が届いていません。", "管理画面にログインできず、障害でしょうか。"], start=1):
    r = client.messages.create(model="claude-sonnet-5", max_tokens=1000, system=system,
                               messages=[{"role": "user", "content": mail}])
    u = r.usage
    print(f"{i}回目: cache_creation={u.cache_creation_input_tokens} "
          f"cache_read={u.cache_read_input_tokens} input={u.input_tokens} output={u.output_tokens}")
    text = "".join(b.text for b in r.content if b.type == "text")
    print("  回答:", text.strip().replace("\n", " "), "| stop_reason:", r.stop_reason)
1回目: cache_creation=5194 cache_read=0 input=17 output=44
回答: **部署:経理部** **優先度:中** | stop_reason: end_turn
2回目: cache_creation=0 cache_read=5194 input=22 output=40
回答: 部署:開発部 優先度:高 | stop_reason: end_turn1回目は5,194トークンがキャッシュに書き込まれ、2回目は同じ5,194トークンがキャッシュから読み出されました。input に入っているのは、キャッシュより後ろにあるメール本文の分だけです。コードの要点は、システムプロンプトの最後のブロックに cache_control を付けた1か所だけです。そこまでの内容が前回と1文字でも違うとキャッシュは当たらず、もう一度書き込みになります。
Sonnet 5の単価で、前提の5,194トークン分の費用を比べると、次のとおりです。
- キャッシュを使わない場合:毎回約0.0104ドル
- 1回目(書き込み):約0.0130ドル
- 2回目以降(読み出し):約0.0010ドル
出力まで含めた1回の総額は、1回目が約0.0135ドル、2回目が約0.0015ドルでした。月3,000件をキャッシュが切れない間隔で流せたと仮定すると、キャッシュなしの約32ドルに対し、キャッシュありでは約5ドルに収まる計算です。RAGやAIエージェントのように、社内規程やツール定義を毎回同じ前提として送る設計では、この差が月額の大半を決めます。前提の文章を先頭に固定し、日時など毎回変わる値をキャッシュより後ろに置くのが、設計の基本になります。
Batch API。急がない処理は半額になる
すぐに結果が要らない処理は、Message Batches APIでまとめて送ると、入力・出力とも単価が50%になります。公式のバッチ処理の説明によると、1バッチは10万件か256MBまでで、多くは1時間以内に終わり、24時間以内に終わらなかった分は期限切れとして課金されません。結果は作成から29日間取得できます。
3件の問い合わせをHaiku 4.5のバッチで送りました。
import time

mails = {
    "mail-001": "先月分の請求書が届いていません。",
    "mail-002": "契約を今月末で解約したいです。",
    "mail-003": "管理画面にログインできません。",
}

batch = client.messages.batches.create(requests=[
    {"custom_id": cid,
     "params": {"model": "claude-haiku-4-5", "max_tokens": 50,
                "messages": [{"role": "user", "content": f"次の問い合わせの担当部署を1語で答えてください:{text}"}]}}
    for cid, text in mails.items()])
print("作成:", batch.processing_status)
start = time.time()
while (batch := client.messages.batches.retrieve(batch.id)).processing_status != "ended":
    time.sleep(30)
print(f"完了: {time.time() - start:.0f}秒後", batch.request_counts)

for res in client.messages.batches.results(batch.id):
    if res.result.type == "succeeded":
        print(res.custom_id, res.result.message.content[0].text.strip())
作成: in_progress
完了: 212秒後 MessageBatchRequestCounts(canceled=0, errored=0, expired=0, processing=0, succeeded=3)
mail-002 契約解除部門
または
解約部門
(1語で最も簡潔に答えると「**解約**」)
mail-003 サポート
mail-001 経理コードは、3件の依頼に custom_id を付けて1回で登録し、30秒ごとに状態を確認して、終わったら結果をまとめて取り出す流れです。3件は212秒で終わり、結果は001、002、003の順ではなく002、003、001の順で返りました。バッチの結果は送った順に返らないため、custom_id で元のデータと突き合わせる必要があります。また、mail-002の回答は「1語で」という指示を守っていません。バッチでは途中で人が確認しないので、出力形式を後段で検査する処理も合わせて用意しておきます。
Claude Codeの料金とClaude APIの関係
「claude code 料金」と一緒に調べる方が多いので、関係だけ整理しておきます。公式のClaude Codeのコスト管理の説明によると、Claude Codeの費用は、どの方法でログインしたかで決まります。
- Pro・Maxなどのサブスクでログインした場合:プランの利用枠の中で使う
- ConsoleのAPIキーで使う場合:Claude APIと同じトークン単価で、組織に従量課金される
- Bedrock・Google Cloud経由の場合:各クラウドの請求に載る
APIキーで使うと、Consoleに「Claude Code」という専用のワークスペースが自動で作られ、そこで費用を集計できます。企業での導入では、開発者1人あたり稼働日1日で平均約13ドル、月150〜250ドルという目安が公式に示されています。公式は、Claude Codeの利用分が組織全体のレート制限に数えられる場合に備えて、このワークスペースに上限を設け、本番のアプリケーションを守る方法も案内しています。
Claude APIのレート制限。ティアと429エラーへの対処
料金の読み方が分かったら、次は一度にどれだけ呼べるかの上限を確認します。公式のレート制限の説明によると、上限は組織単位で、利用実績に応じて自動で上がる「ティア」で決まります。
RPM・ITPM・OTPMの3つで制限される
レート制限は、1分あたりのリクエスト数(RPM)、入力トークン数(ITPM)、出力トークン数(OTPM)の3つで、モデルごとに別々にかかります。あわせて、月の支出上限もティアごとに決まっています。
| ティア | 月の支出上限 | Opus 5.5・Sonnet 5・Haiku 4.5(RPM・ITPM・OTPM) | Fable 5.1(RPM・ITPM・OTPM) |
|---|---|---|---|
| Start | 500ドル | 1,000・200万・40万 | 1,000・50万・10万 |
| Build | 1,000ドル | 5,000・500万・100万 | 2,000・150万・30万 |
| Scale | 20万ドル | 10,000・1,000万・200万 | 4,000・400万・80万 |
この表から読み取れるのは、Fable 5.1だけ上限が低く設定されている点です。大量の処理をFable 5.1に集める設計は、費用より先にレート制限で詰まる可能性があります。なお、利用実績の少ない新しい組織は、この表より低い「Evaluation」ティアから始まる場合があります。
キャッシュから読んだトークンはITPMに数えない
Claude APIのレート制限で見落とされやすいのが、キャッシュとの関係です。多くのモデルでは、キャッシュから読み出したトークンはITPMに数えられません。公式の例では、ITPMの上限が200万で、入力の80%がキャッシュから読まれる場合、1分あたり実質1,000万トークンの入力を処理できるとしています。
つまり、前の章で見たキャッシュの設計は、費用を下げるだけでなく、1分あたりに処理できる入力の量も増やします。
429が返ったときの対処
上限を超えると、HTTPの429エラーが返ります。対処は原因によって分かれます。
- レート制限の場合:レスポンスの
retry-afterヘッダーに書かれた秒数だけ待って再送する。公式のエラーの説明によると、公式SDKは既定で2回まで自動で再送する - 支出上限に達した場合:同じ429でも
retry-afterが付かず、error_codeがenforced_spend_limit_reachedになる。翌月1日(UTC)まで再送しても通らないので、ティアを上げるか上限を見直す - 利用が急に増えた場合:急激な増加でも429になることがあるため、本番の切り替えでは流量を段階的に増やす
残りの枠は、anthropic-ratelimit- で始まるレスポンスヘッダーで確認できます。
ここまでClaude APIの始め方から料金、レート制限までを見てきましたが、「APIは呼べたものの、キャッシュや制限まで踏まえた本番の設計を自分で組めるか不安」という方は、Craft CollegeのDS ADVANCEDをご覧ください。
DS ADVANCEDは、実務でデータやAIを扱うエンジニア・データサイエンティスト向けの12週の上級プログラムです。Agentic RAGやマルチエージェントの実装に加え、W&BやMLflowを使った評価と精度改善までを扱うため、APIの呼び出しを「測って直せる仕組み」に組み込むところまで身につけられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft College DS ADVANCEDの詳細はこちら
Claude APIとAmazon Bedrock・Google Cloud経由の違い
Claudeは、Anthropicと直接契約するClaude APIのほか、Amazon BedrockやGoogle Cloud(Vertex AI。Anthropicのドキュメントでは「Agent Platform」と表記)からも使えます。同じモデルでも、経由先によって使える機能や請求の仕組みが変わります。
同じ6項目で比べる
2026年9月23日時点の公式ドキュメント(Bedrock・Google Cloud)をもとに、同じ項目で並べました。
| 項目 | Claude API | Amazon Bedrock | Google Cloud |
|---|---|---|---|
| 請求元 | Anthropic | AWS | Google Cloud |
| 認証 | APIキー | IAMロールや短期のベアラートークン | Google Cloudの認証情報 |
| モデルID | claude-opus-5-5 | anthropic.claude-opus-5-5 | claude-opus-5-5(URLで指定) |
| 料金 | 公式の単価 | AWSの料金表。リージョン指定は10%上乗せ | Google Cloudの料金表。リージョン指定は10%上乗せ |
| 使えない主な機能 | なし | Message Batches API・Files API・構造化出力・Web検索などのサーバーツール | Message Batches API・Files API・コード実行やWeb取得のサーバーツール |
| データの扱い | Anthropicの方針に従う | Amazon Bedrockのデータ保護に従う | Google Cloudのデータガバナンスに従う |
この表から読み取れるのは、クラウド経由ではAnthropicのMessage Batches APIが使えず、前の章で見た「バッチで半額」がそのままは当てはまらない点です。一方、プロンプトキャッシュ・思考・ツール使用はどちらでも使えます。Bedrockでは、Anthropicの社員が推論基盤にアクセスできない構成で動き、東京リージョン(ap-northeast-1)を含むリージョンが選べます。既定のクォータは入力で毎分200万トークンで、追加の承認なしに入力毎分500万トークンまで引き上げを申請できます。
公表されている例では、野村総合研究所(NRI)がClaude in Amazon Bedrockを使い、複雑な日本語の業務文書のレビュー時間を50%短縮しています(Anthropicの事例ページ)。
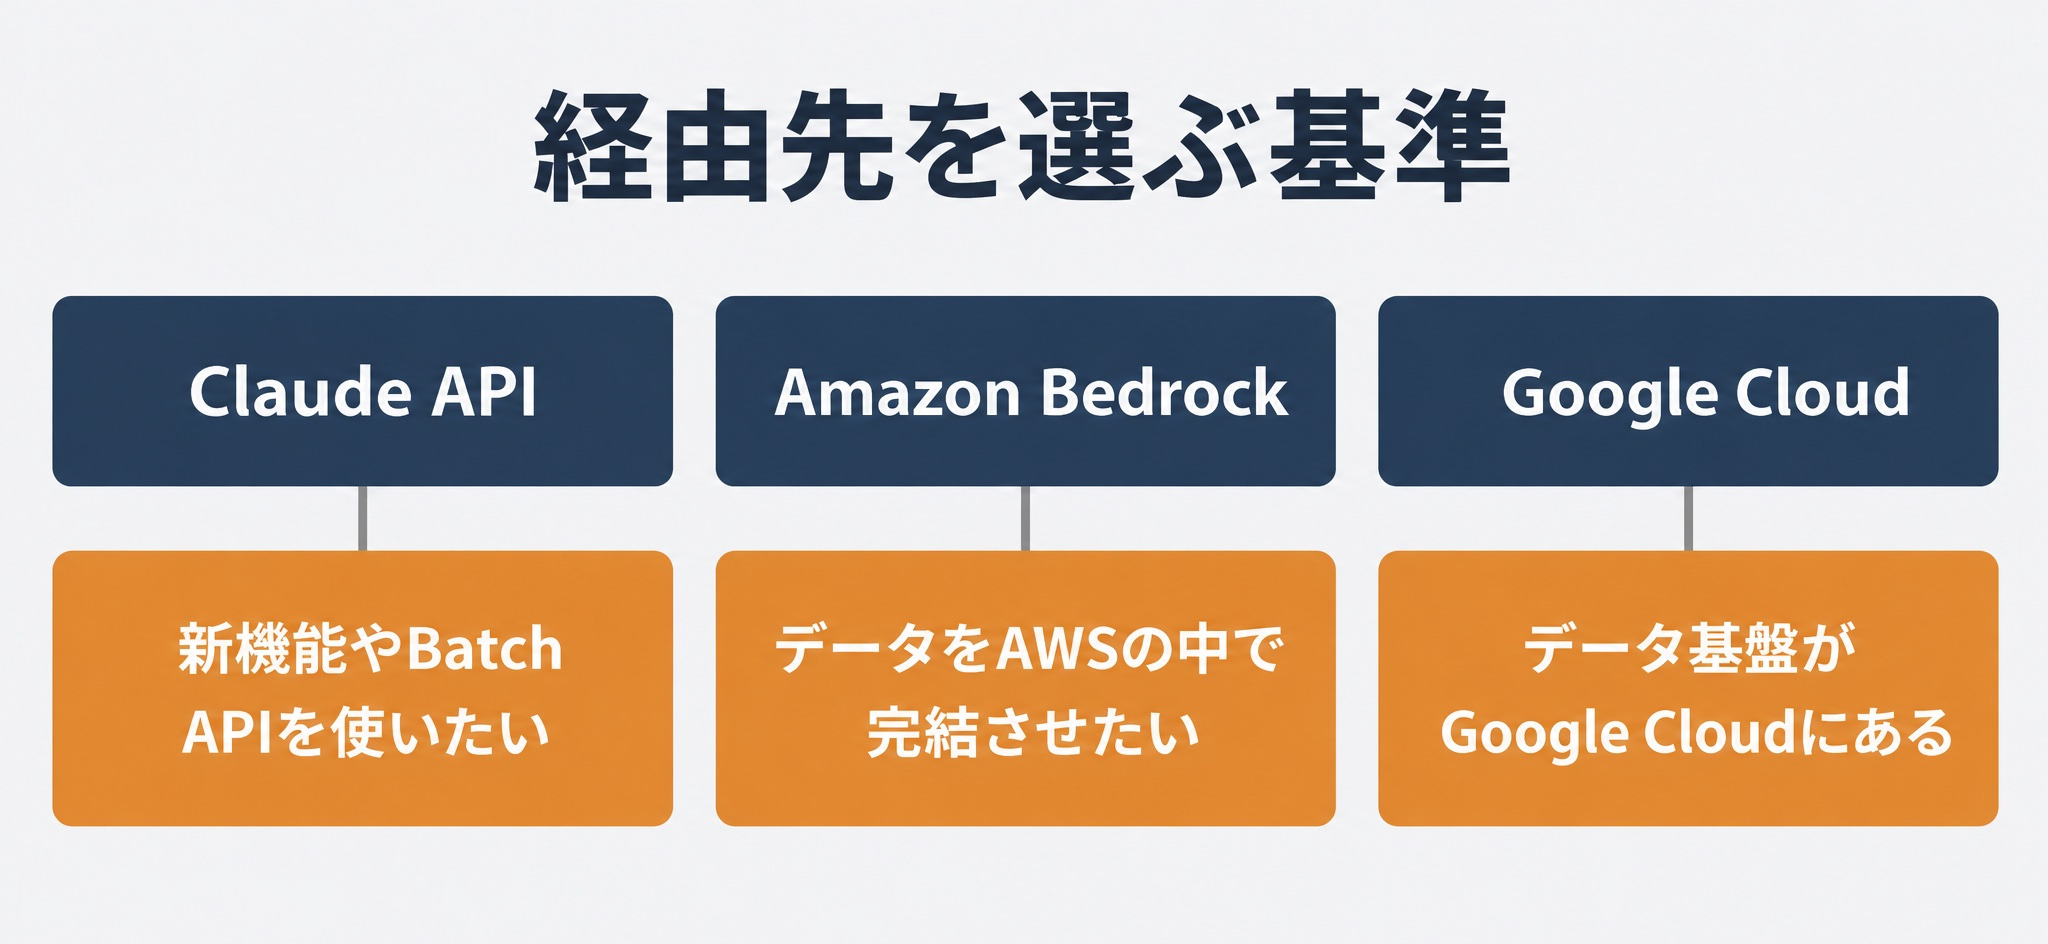
経由先を選ぶ基準
経由先は、機能の新しさとデータの置き場所のどちらを優先するかで選びます。
- Claude API:新機能をすぐ使いたい。Batch APIやWeb検索を使いたい。まずは小さく試したい
- Amazon Bedrock:データをAWSの中で完結させたい。IAMで権限を管理したい
- Google Cloud:既存のデータ基盤がGoogle Cloudにあり、請求をまとめたい
なお、AWSで請求をまとめつつAnthropicが運用する同じAPIを使える「Claude Platform on AWS」もあり、料金はClaude APIと同じ単価がAWS Marketplace経由で請求されます。
Claude API固有の機能。思考とツール使用
経由先が決まったら、Claude APIならではの機能をどう使うかを考えます。キャッシュは料金の章で扱ったので、ここでは思考とツール使用を取り上げます。
拡張思考は「effortで深さを決める思考」に変わった
「Extended Thinking(拡張思考)」は、budget_tokens で考える量の上限を指定する方式でした。公式の拡張思考の説明によると、この方式はClaude 4.6で非推奨になり、4.7以降のモデルでは400エラーで拒否されます。古い記事のコードを写すと動かないので注意が必要です。
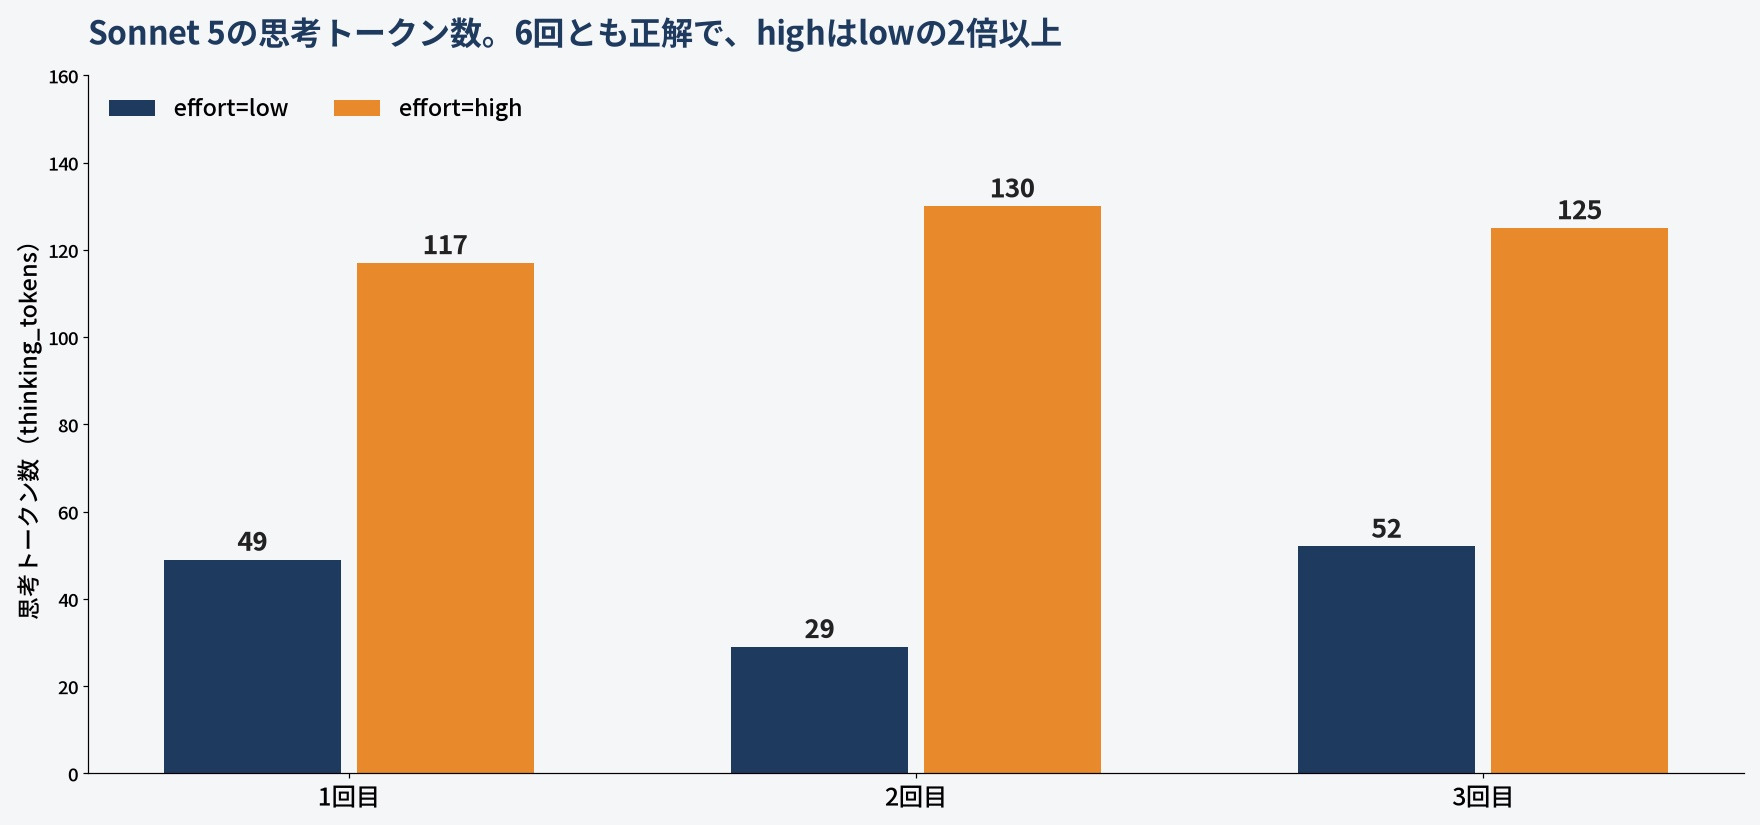
現行のモデルは、質問ごとに考えるかどうかと、どこまで考えるかをモデル自身が決める「adaptive thinking」を使います。深さは effort(low・medium・high・xhigh・max)で調整します。同じ在庫計算の問題を、Sonnet 5でeffortを変えて3回ずつ解かせました。
question = ("ある倉庫では、A品は1箱12個入りで1日に3箱、B品は1箱8個入りで1日に5箱出荷します。"
            "A品の在庫が540個、B品の在庫が600個のとき、先に在庫が尽きるのはどちらで、何日目ですか。"
            "答えだけを1行で書いてください。")

for effort in ["low", "high"] * 3:
    r = client.messages.create(model="claude-sonnet-5", max_tokens=8000, thinking={"type": "adaptive"},
                               output_config={"effort": effort},
                               messages=[{"role": "user", "content": question}])
    u = r.usage
    thinking = (u.model_dump().get("output_tokens_details") or {}).get("thinking_tokens")
    answer = "".join(b.text for b in r.content if b.type == "text").strip()
    print(f"effort={effort:4s} output_tokens={u.output_tokens} うち thinking_tokens={thinking} | {answer}")
effort=low output_tokens=70 うち thinking_tokens=49 | A品・B品ともに15日目で同時に尽きる
effort=high output_tokens=141 うち thinking_tokens=117 | A品とB品は同時に在庫が尽き、15日目です。
effort=low output_tokens=49 うち thinking_tokens=29 | A品とB品は同時に尽きる(15日目)
effort=high output_tokens=155 うち thinking_tokens=130 | A品・B品とも同時に15日目で在庫が尽きる。
effort=low output_tokens=77 うち thinking_tokens=52 | A品・B品ともに15日目で同時に在庫が尽きる
effort=high output_tokens=151 うち thinking_tokens=125 | A品・B品ともに15日目で同時に在庫が尽きる。思考トークンの数は usage の output_tokens_details に入っています。今回のSDK(anthropic 0.100.0)では型に定義されていない項目だったため、model_dump() で辞書に直して読み出しました。
6回とも正解(A品・B品とも15日目)でしたが、思考トークンはlowで29〜52、highで117〜130と、2倍以上の差が出ました。公式の思考の説明のとおり、思考のトークンは画面に表示されなくても出力トークンとして課金されます。この程度の問題ならlowで足り、設計レビューや多段の判断が要る処理だけeffortを上げる、という使い分けが費用に効きます。1問だけの測定なので、自社の処理ではeffortごとの正答率と費用を並べて決めてください。
ツール使用。社内システムを呼ぶ判断をClaudeに任せる
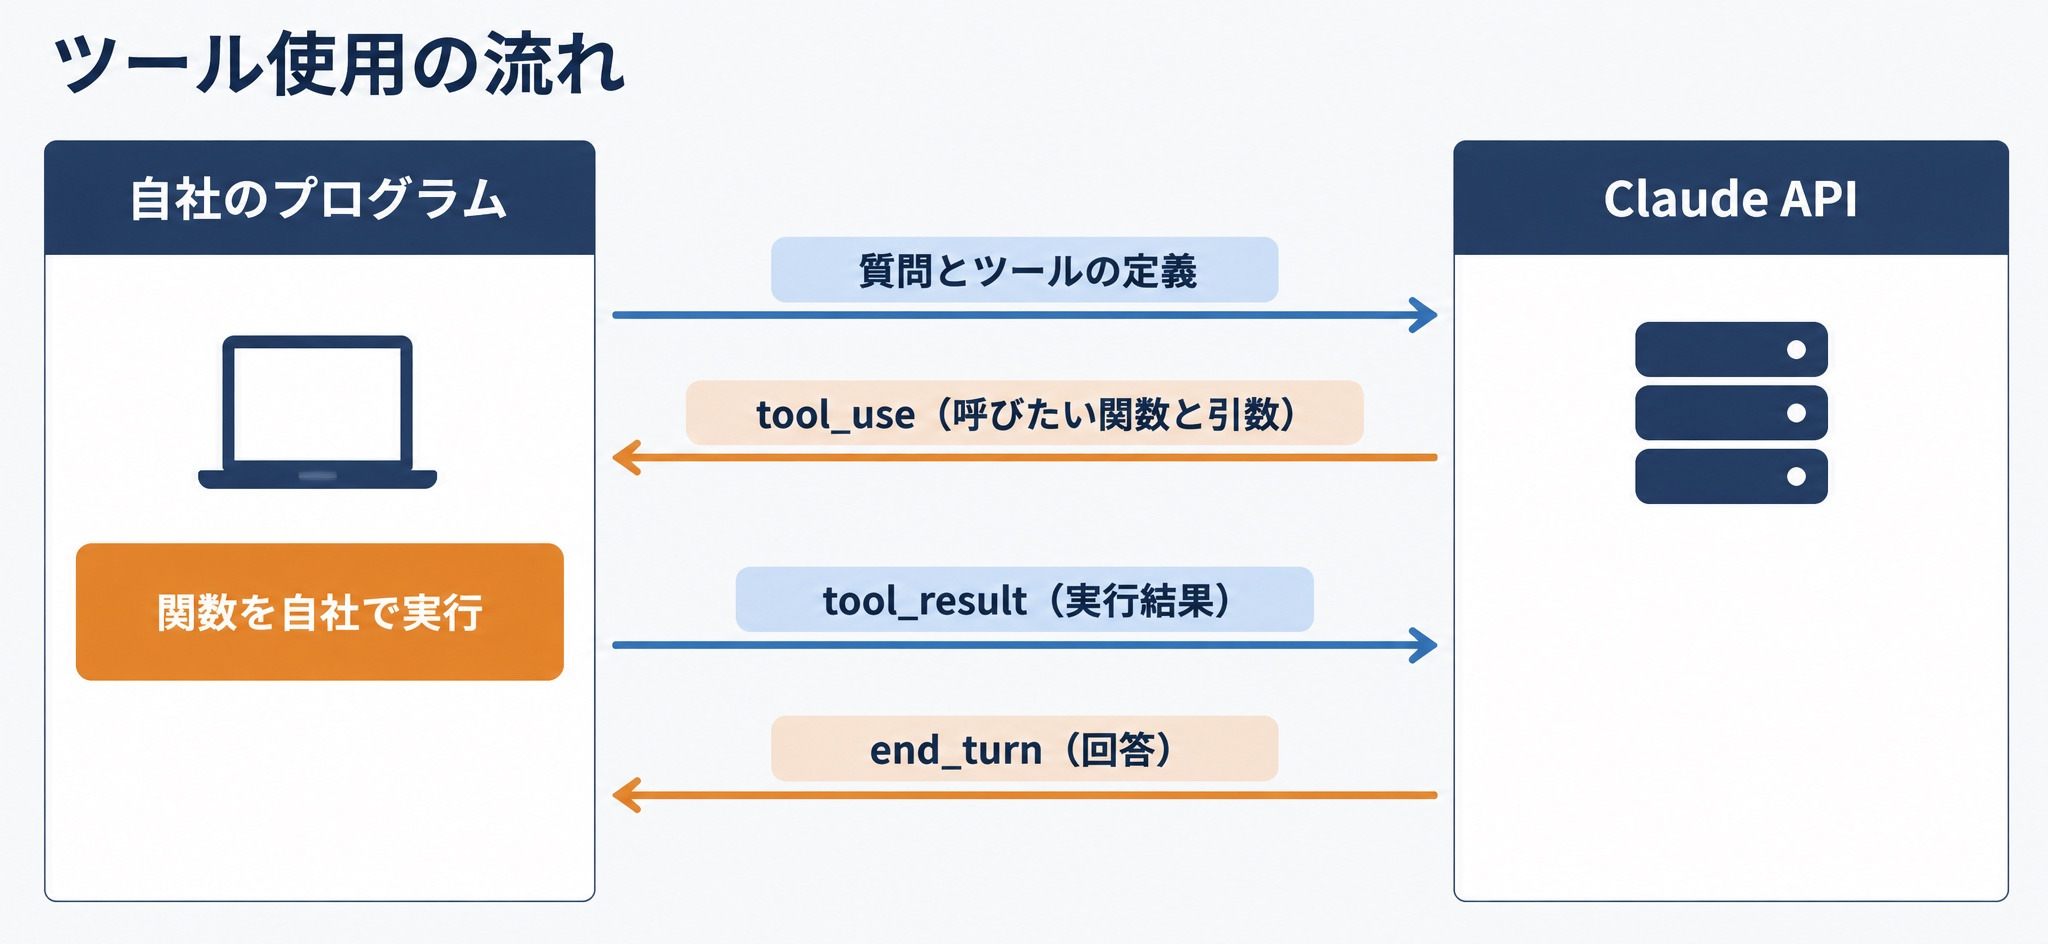
ツール使用は、Claudeに「この関数を、この引数で呼びたい」と判断させる機能です。関数そのものは自社のプログラムが実行し、結果を返すとClaudeが回答を仕上げます。受注番号から出荷状況を調べる関数を1つ渡して試しました。
import json

tools = [{"name": "lookup_order",
          "description": "受注番号から、社内の受注管理システムに登録された出荷状況を返す。",
          "input_schema": {"type": "object",
                           "properties": {"order_id": {"type": "string", "description": "受注番号(例:A-1024)"}},
                           "required": ["order_id"]}}]

def lookup_order(order_id: str) -> dict:  # 本来は社内DBを引く。ここでは固定値
    return {"order_id": order_id, "status": "出荷済み", "shipped_at": "2026-09-22"}

messages = [{"role": "user", "content": "受注番号A-1024の荷物はもう出ましたか?"}]
r1 = client.messages.create(model="claude-haiku-4-5", max_tokens=500, tools=tools, messages=messages)
print("1回目 stop_reason:", r1.stop_reason)
call = next(b for b in r1.content if b.type == "tool_use")
print("Claudeが求めた呼び出し:", call.name, json.dumps(call.input, ensure_ascii=False))

result = lookup_order(**call.input)  # 関数はこちら側で実行する
messages += [{"role": "assistant", "content": r1.content},
             {"role": "user", "content": [{"type": "tool_result", "tool_use_id": call.id,
                                           "content": json.dumps(result, ensure_ascii=False)}]}]
r2 = client.messages.create(model="claude-haiku-4-5", max_tokens=500, tools=tools, messages=messages)
print("2回目 stop_reason:", r2.stop_reason)
print("最終回答:", "".join(b.text for b in r2.content if b.type == "text"))
print("入力トークン:", r1.usage.input_tokens, "→", r2.usage.input_tokens)
1回目 stop_reason: tool_use
Claudeが求めた呼び出し: lookup_order {"order_id": "A-1024"}
2回目 stop_reason: end_turn
最終回答: 受注番号A-1024のご荷物は**出荷済み**です。
**出荷日:2026年9月22日**
荷物はすでに配送手配が済んでおります。追跡情報などのご確認が必要でしたら、お気軽にお知らせください。
入力トークン: 763 → 8901回目は stop_reason が tool_use になり、Claudeが質問文から受注番号を取り出して呼び出しを求めました。2回目に結果を返すと end_turn で回答が返ります。質問文自体は短いのに入力が763トークンあるのは、ツールの定義とツール用のシステムプロンプトが毎回加わるためです。ツールを増やすほど入力が膨らむので、ツール定義はキャッシュの対象に入れておくと費用を抑えられます。
このように自社で実行するツールのほかに、Web検索やコード実行のようにAnthropic側で実行する「サーバーツール」もあります。Web検索は1,000回あたり10ドルがトークン料金に加わります。社内の複数システムをまとめてつなぐ標準の方式は、MCPとは。AIを社内のデータ・ツールに安全につなぐ仕組みを解説で解説しています。
Claude APIで業務データを扱うときの確認手順
ツールで社内システムにつなぐと、Claude APIには顧客情報や社内文書が流れます。最後に、業務データを送る前に確認することを整理します。
学習と保持について公式が約束していること
公式のAPIとデータ保持の説明とプライバシーセンター(2026年7月1日更新)には、次のように書かれています。
- 保持したデータは、明示の許可なくモデルの学習に使わない
- APIの入力と出力は、受け取りまたは生成から30日以内にAnthropicのバックエンドで自動削除する
- 利用ポリシー違反の判定を受けた場合は、入力と出力を最長2年保持する
- Fable 5.1などの「Covered Models」は30日間のデータ保持が必須で、Anthropicが個別に認めた場合を除き、ゼロデータ保持(ZDR)の契約では使えない
- ZDRは営業窓口との契約で、組織ごとに有効にする
送る前に確認する5つの手順
- 送るデータを分類する:個人情報・機密情報・公開情報に分け、どの区分まで送るかを情報システム部門と決める
- 経由先を決める:データをAWSやGoogle Cloudの中で完結させる必要があるなら、Claude APIではなくBedrockかGoogle Cloudを選ぶ
- 保持の条件を合わせる:30日保持で問題ないかを確認し、足りなければZDRの契約を検討する。その場合、使うモデルがCovered Modelsでないかも確認する
- キーと権限を分ける:本番はサービスアカウントキーで発行し、ワークスペースごとに支出上限を設定する
- ログの残し方を決める:誰がいつ何を送ったかを自社側で記録し、定期的に見直す
LLMの利用で起きるリスクと対策の全体像は、LLMの利用で発生するセキュリティリスクとは?実施すべき5つの対策方法を解説で解説しています。
公表されている利用事例
国内企業の公表事例も、経由先の選び方の参考になります。
- 野村総合研究所(NRI):Amazon Bedrock経由でClaudeを使い、専門用語の多い日本語の業務文書のレビュー時間を50%短縮した(事例)
- 楽天:Claude Codeを開発に使い、新機能の市場投入までの期間を24日から5日へ79%短縮した(事例)
NRIは既存のAWSの枠組みの中でデータを扱い、楽天は開発の現場にClaude Codeを入れています。同じClaudeでも、経由先と使い方は目的に合わせて選ばれています。
Claude APIの要点まとめ
- Claude APIはAnthropic APIと同じもので、自社のプログラムからMessages APIを呼ぶ従量制のサービス。チャット版のProやMaxとは契約が別
- Consoleでキーを発行し、公式SDKを入れれば数行で呼べる。費用はレスポンスの
usageのトークン数から計算できる - 2026年9月時点の現行は、Fable 5.1・Opus 5.5・Sonnet 5・Haiku 4.5の4モデル。迷ったらOpus 5.5、件数の多い処理はSonnet 5かHaiku 4.5
- 同じ前提を繰り返し送る設計では、プロンプトキャッシュで前提部分の費用が約10分の1になり、レート制限にも数えられない。急がない処理はBatch APIで半額
- BedrockとGoogle Cloudでは、Message Batches APIなど一部の機能が使えない。データの置き場所を優先するならクラウド経由、機能を優先するならClaude API
- 業務データを送る前に、データの分類・経由先・保持の条件・キーの権限・ログの5点を決める
Claude APIを使ったAI開発は「リベルクラフト」へ
「APIの使い方は分かったが、キャッシュの設計やモデルの使い分けまで含めて、本番で費用と品質を両立させられるだろうか」と感じた方もいらっしゃるのではないでしょうか?
リベルクラフトが運営するCraft CollegeのDS ADVANCEDは、実務でデータやAIを扱う方に向けた12週の上級プログラムです。Agentic RAGやマルチエージェントの実装、Fine-tuning、W&BとMLflowを使った評価と精度改善を扱い、本記事のように「呼んで、測って、直す」進め方を自分の案件で回せるようになります。
リベルクラフト本体では、AI開発・データサイエンス開発の支援も行っています。次のようなご相談に対応しています。
- Claude APIを使った社内ナレッジ検索(RAG)やAIエージェントを開発したい
- Claude APIとBedrockのどちらで構築するか、データの扱いを含めて決めたい
- 既存のLLMアプリケーションの費用と精度を見直したい
⇨AI開発・データサイエンス開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。