ディープラーニングとは。機械学習との違いと仕組みをわかりやすく解説
ディープラーニング(深層学習)という言葉は、いろいろな場面で目にします。ただ、機械学習と何がどう違うのかを聞かれると、うまく答えられない方も多いのではないでしょうか?
別の技術なのか、それとも機械学習の一部なのか。ここが曖昧なままだと、社内で技術選定の話が出たときに判断の軸を持てません。
そこで本記事では、
- ディープラーニングとは何か。機械学習との違い
- 何が「深い」のか。仕組みの中身
- 従来の機械学習とディープラーニングの使い分け
- パーセプトロンからCNN、Transformerへという技術の流れ
- いま使っているChatGPTとのつながり
- 何から学び始めればよいか
を解説します。用語を並べるのではなく、機械学習との違いを軸に一本でたどります。
「ディープラーニングを自分で扱えるようになりたい」という方は、リベルクラフトへご相談ください。
ディープラーニングとは。機械学習との違いから理解する
ディープラーニングとは、ニューラルネットワークの層を深く重ねて、データから特徴を自動で学習する、機械学習の一手法です。日本語では深層学習と呼ばれます。
機械学習とディープラーニングの違いは「別物か、入れ子か」
最初に、いちばん多い誤解を解いておきます。機械学習とディープラーニングは、並列に並ぶ別々の技術ではありません。機械学習という大きな枠の中に、ディープラーニングがあります。
Google Cloudの解説ページ「Deep learning vs machine learning vs AI」も、深層学習を機械学習の一部(subset)と位置づけています。入力層と出力層の間に隠れ層を複数持つニューラルネットワークを使う点が、深層学習の条件だと説明しています。
つまり「機械学習を使うか、ディープラーニングを使うか」という問いの立て方自体が少しずれています。正しくは「機械学習のなかで、どの手法を使うか」であり、その選択肢のひとつがディープラーニングです。
AI・機械学習・ディープラーニング・生成AI・LLMの関係
この入れ子はさらに続きます。ディープラーニングの中に生成AIがあり、その中でテキストを扱うものがLLM(大規模言語モデル)です。
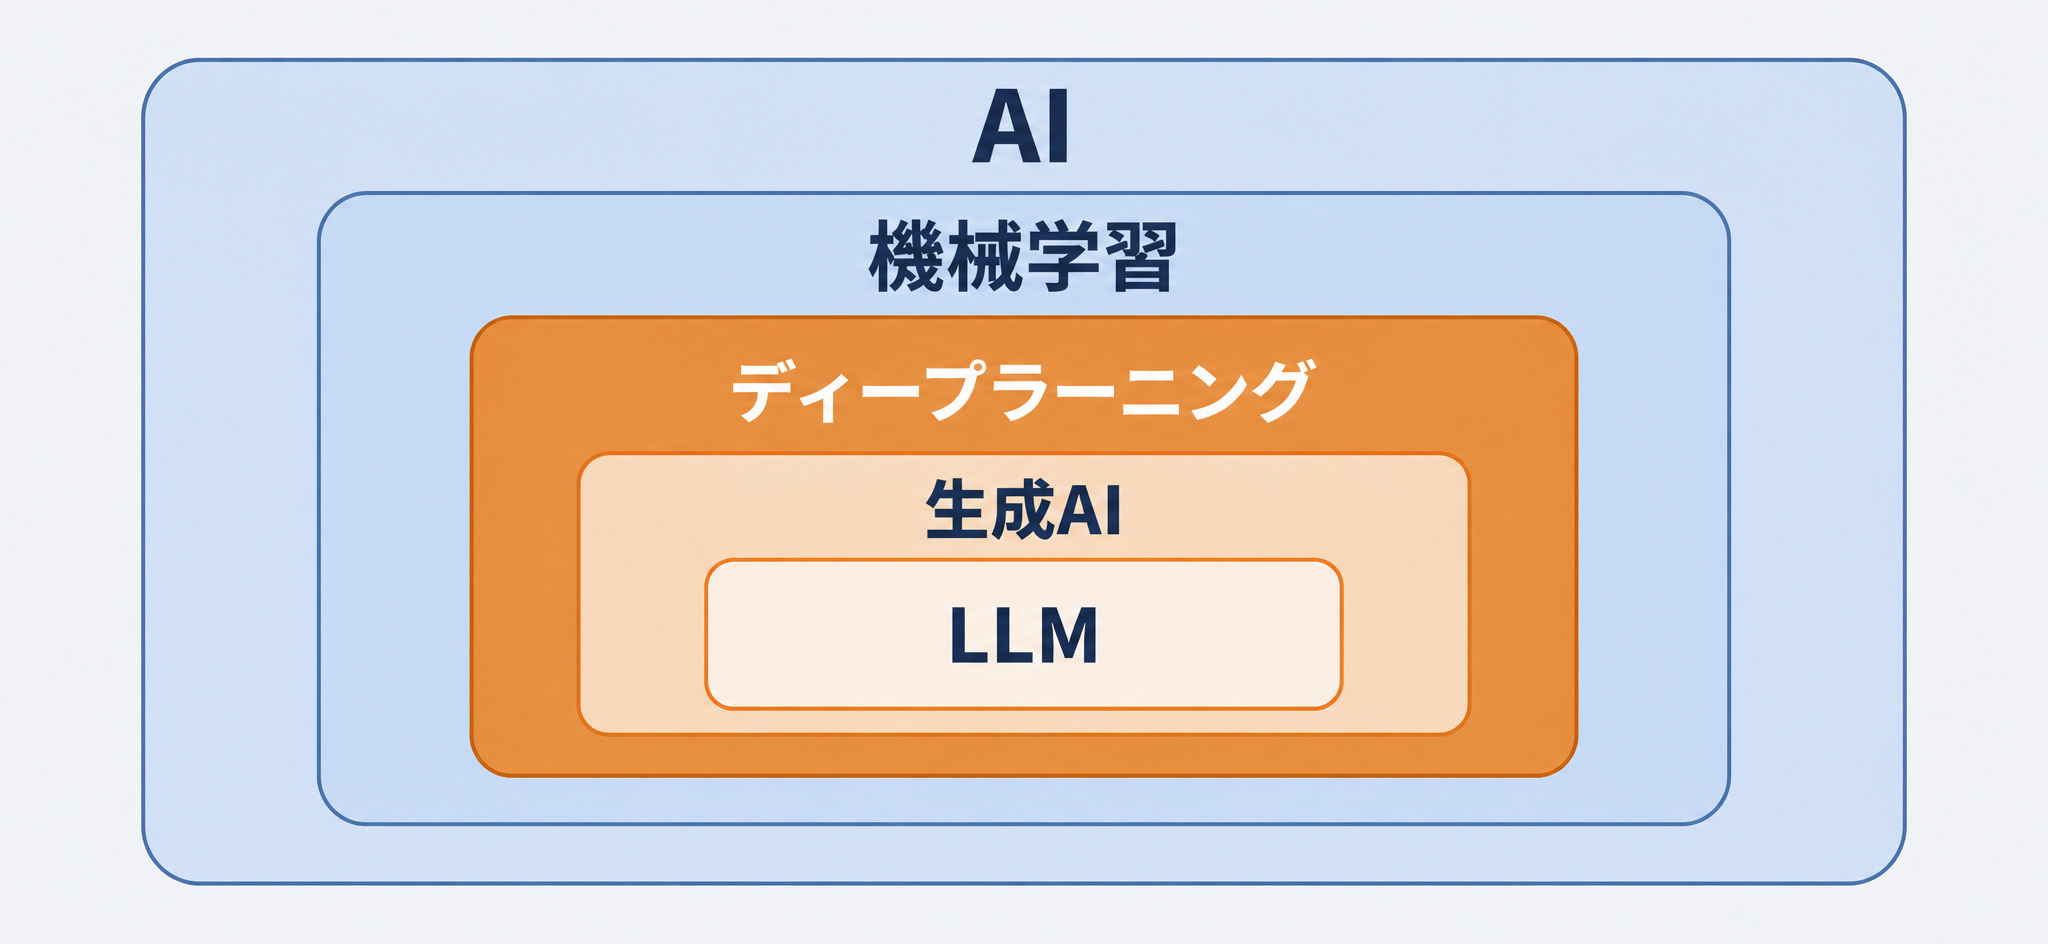
総務省の「令和7年版 情報通信白書」によれば、生成AIサービスを使ったことがある個人の割合は日本で26.7%、2023年度調査の9.1%から3倍近くに伸びています。多くの人が日常的に触れているものが、この図のいちばん内側にあります。
生成AIが文章を作る流れは生成AIの仕組みとは。データからテキストが生成されるまでをわかりやすく解説で、LLMそのものはLLMとは何か。仕組みと種類、企業での活用方法をわかりやすく解説で扱っています。
ディープラーニングの仕組み。何が「深い」のか
「深い」が何を指しているのかを見ていきます。
土台にあるのはニューラルネットワーク
ニューラルネットワークは、人間の神経細胞のつながりを模した計算の仕組みです。入力層、隠れ層、出力層があり、データが左から右へ流れていきます。
猫の画像を入力層に入れると、隠れ層で数値が変換されていき、出力層から「猫95%、犬3%」といった答えが出ます。この変換に使う重みの値を、大量の画像とその正解の組み合わせから調整していくのが学習です。
層を深くすると何が変わるのか
隠れ層が1層しかない構造を、何層にも重ねたものが深層です。これが「深い」の意味になります。
層を重ねると、前の層が見つけた特徴を次の層がさらに組み合わせられます。画像であれば、最初の層が線や角を捉え、次の層がそれを組み合わせて目や耳のような部分を捉え、さらに次の層が顔全体を捉える、という積み上がり方をします。
ただし、この中で何が起きているかを人が完全に追うことはできません。中の重みがどうなっているかは分からないまま、入力と出力の対応だけを見る。この割り切りを受け入れた設計だという点は、押さえておく必要があります。
機械学習との最大の違いは、特徴量を人が設計しなくてよくなったこと
ここが、従来の機械学習との決定的な差です。
従来の機械学習では、何を手がかりに判断するかを人が決めていました。猫と犬を見分けるなら、耳の形、ひげの本数、顔の輪郭といった項目を人が考えて数値化し、それをモデルに渡していました。この作業を特徴量の設計と呼びます。
ディープラーニングでは、この設計をモデル側がやります。生の画像をそのまま入れれば、どこを見るべきかを学習の過程で自分で見つけます。人が思いつかなかった手がかりを見つけることもあります。
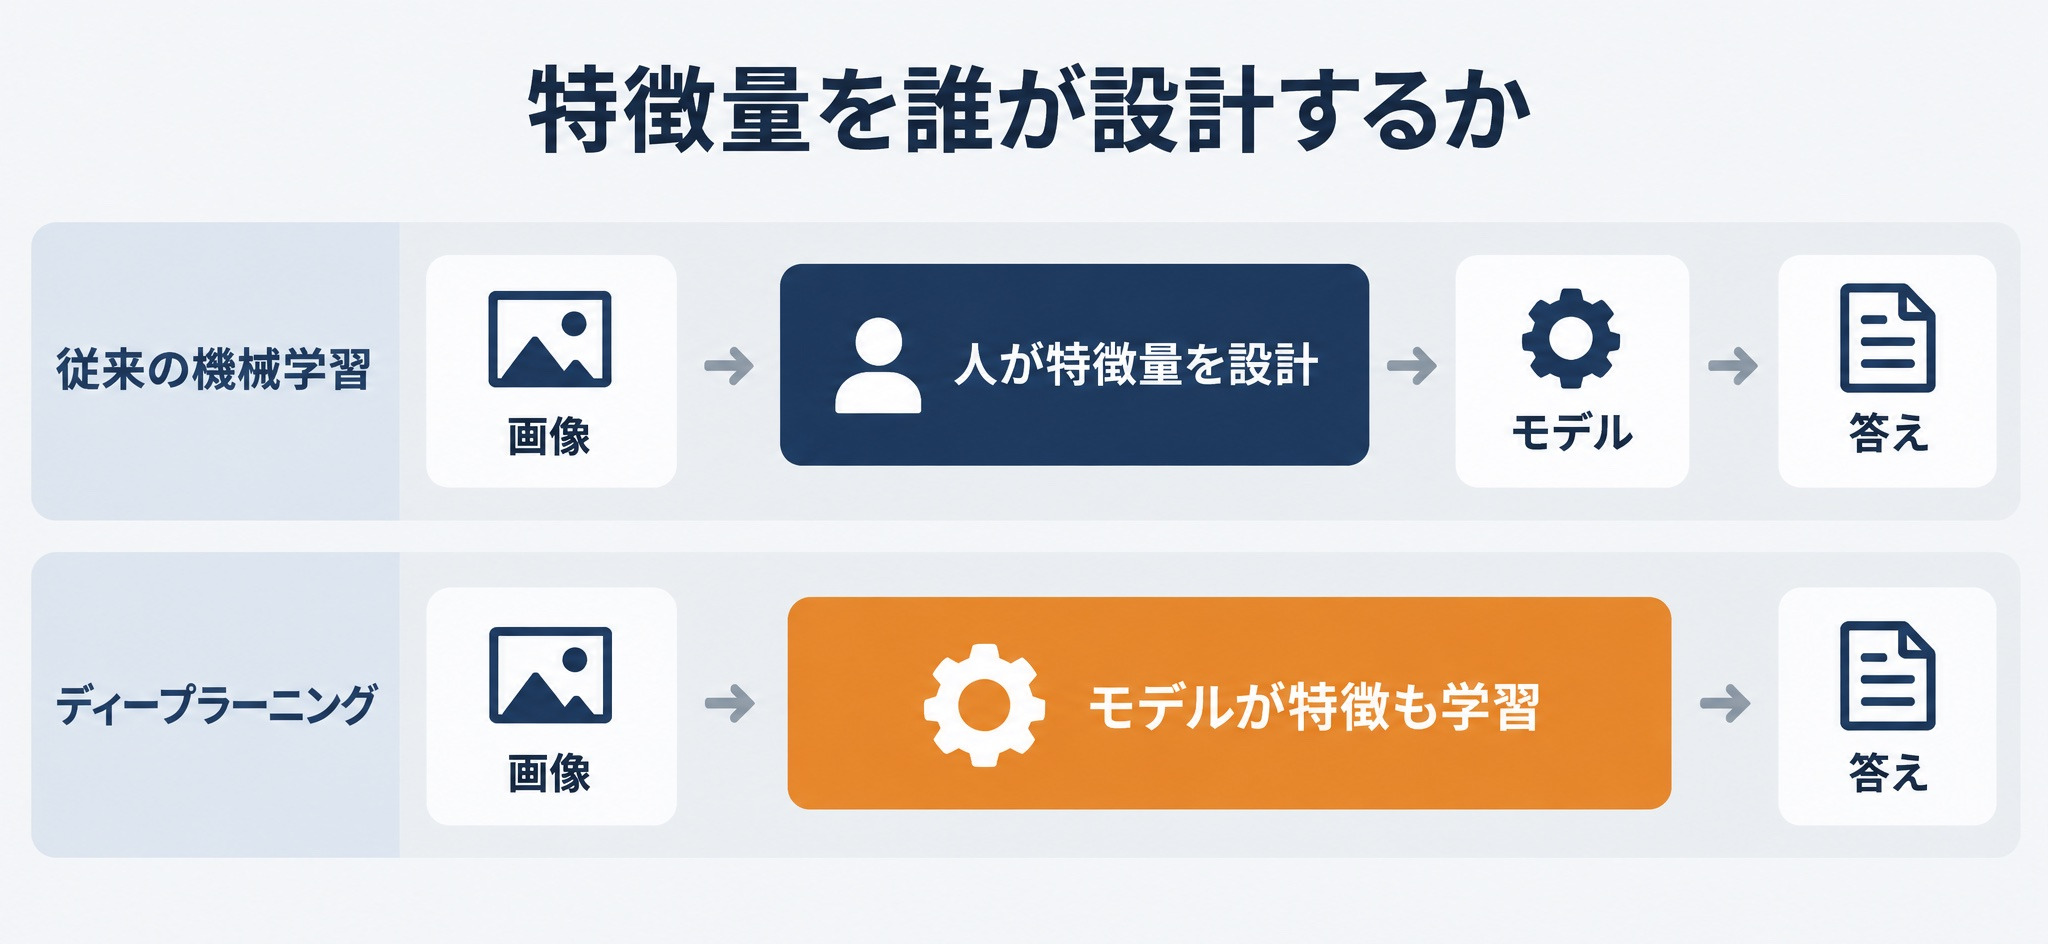
NVIDIAの用語集「What Is Deep Learning?」も、人間の専門知識を持ち込まずに、画像や動画、テキストから表現を自動で学習できる点を深層学習の違いとして挙げています。
その代わり、大量のデータと計算資源が必要になります。人が考える手間を、機械の計算量と交換していると捉えると分かりやすくなります。
この交換が成立するかどうかが、導入の分かれ目になります。手元に画像が500枚しかないのに、人が特徴量を設計する手間を省こうとしても、モデルは十分な手がかりを見つけられません。逆に、数万枚の画像があって、しかも何を見れば判別できるのかを人が言語化できない場合は、ディープラーニングのほうが早く着きます。
機械学習とディープラーニングはどう使い分けるのか
違いが分かったところで、この違いを技術選定の判断に変換します。どちらが優れているかではなく、向き不向きの話です。
| 比較軸 | 従来の機械学習 | ディープラーニング |
|---|---|---|
| 特徴量を誰が設計するか | 人 | モデル |
| 得意なデータ | 表形式 | 画像・テキスト・音声 |
| 必要なデータ量 | 少なくても成立する | 大量に要る |
| 計算資源 | 普通のパソコンでも動く | GPUが要ることが多い |
| 結果の説明しやすさ | 説明しやすい | 説明しにくい |
従来の機械学習が向いている場面
売上や解約率のように、項目が揃った表形式のデータを扱う場面です。件数が数千から数万程度でも成立します。
もうひとつ重要なのが、なぜその結果になったかを説明する必要がある場面です。与信審査、医療、品質保証のように、判断の根拠を示す責任がある領域では、精度が数ポイント低くても説明できる手法が選ばれます。
ディープラーニングが向いている場面
画像、テキスト、音声のように、人が手がかりを設計しにくいデータを扱う場面です。写真から不良品を見つける、文章を分類する、音声を文字にする、といった用途が当てはまります。
条件として、大量のデータと計算資源、そして運用する体制が要ります。ここが揃わないまま始めると、途中で止まります。
どちらを選ぶかを決める4つの問い
- 扱うデータは表形式か、画像・テキスト・音声か。表形式なら従来の機械学習から検討します
- 学習に使えるデータは何件あるか。数千件しかないなら、ディープラーニングは分が悪くなります
- 結果の理由を説明する必要があるか。必要なら説明しやすい手法を優先します
- 計算資源と運用体制を用意できるか。作って終わりではなく、動かし続けられるかを見ます
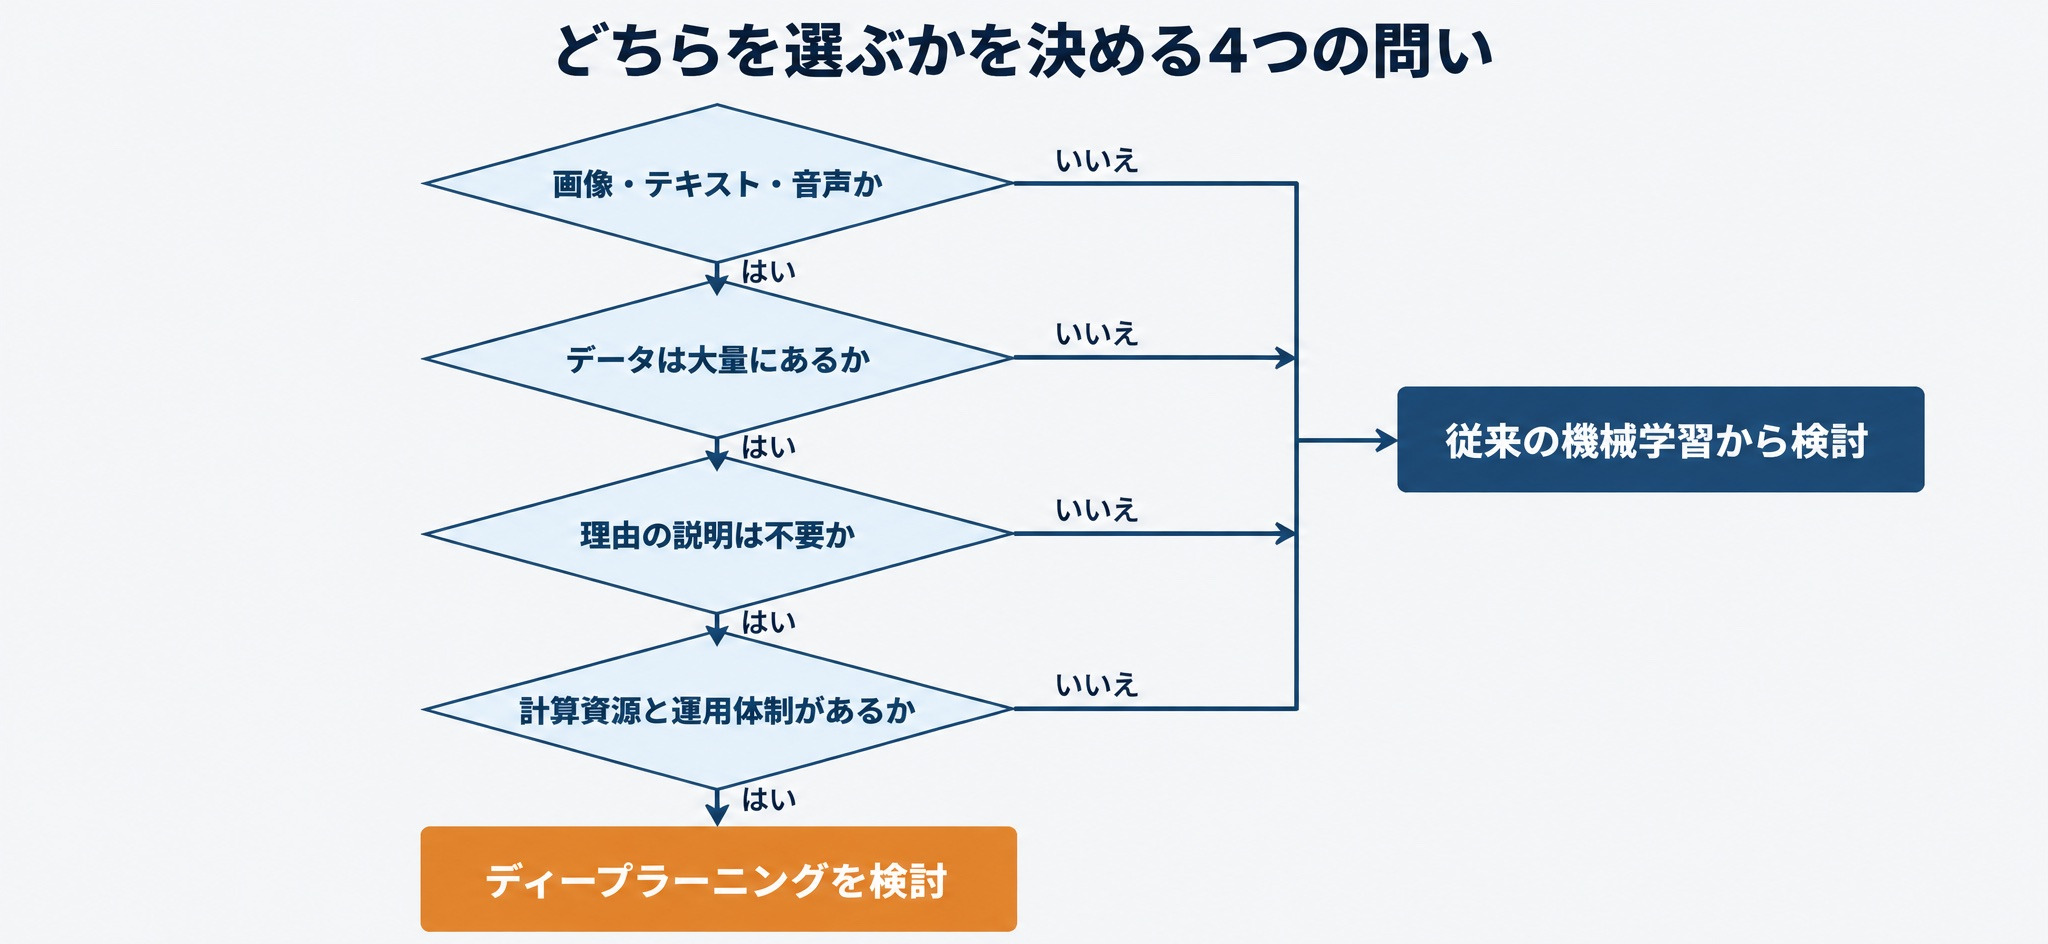
4つの問いを、よくある2つの題材に当ててみます。
1つ目は、会員の解約を予測したいという題材です。手元にあるのは会員ごとの利用回数や契約期間を並べた表で、件数は数万件です。しかも、解約しそうな会員に営業担当が連絡するため、「なぜこの会員が危ないのか」を説明できる必要があります。問い1と問い3の時点で、従来の機械学習から検討するのが妥当です。
2つ目は、製造ラインで撮った製品の写真から傷を見つけたいという題材です。データは画像で、撮りためた写真が数万枚あり、傷の見え方を人が言葉で定義しきれません。GPUを使える環境と、モデルを更新し続ける担当者を用意できるなら、4つの問いすべてがディープラーニングの側に振れます。
同じ会社の中でも、題材によって答えが変わります。「わが社はディープラーニングを使うか」ではなく、題材ごとに4つの問いを当てることが、使い分けの実際です。
機械学習とディープラーニングの違いでよくある3つの誤解
違いを学び始めた段階で、次の3つの思い込みにつまずく方が多くいます。
- 新しい手法のほうが精度が高い。表形式のデータでは、従来の機械学習のほうが少ない手間で同等以上の結果を出すことが珍しくありません。手法の新しさと、その題材での精度は別の話です
- データの件数さえ多ければよい。ディープラーニングが学ぶのは、入力と正解の組み合わせです。正解の付け方が担当者ごとにばらついていると、件数を増やしてもばらつきごと学習します
- 中身が分からないから業務には使えない。中身を追えないことが問題になるのは、判断の理由を示す責任がある用途です。不良品の候補を人の検査に回す、問い合わせの振り分け先を提案するといった用途では、最終判断を人が持つ形で使われています
データサイエンス全体の中でこれらがどう位置づくかはデータサイエンスとは。定義・活用事例・学び方をわかりやすく解説で扱っています。
ディープラーニングはなぜ今できるようになったのか。技術の系譜をたどる
いま使えるようになった理由は、アイデアが新しいからではありません。むしろ逆で、考え方自体は60年以上前からありました。
パーセプトロンから始まり、冬の時代があった
出発点は1958年、Rosenblattが発表したパーセプトロンです。ニューロンを模した計算の仕組みで、いまのニューラルネットワークの原型にあたります。
ただし、当時は計算資源もデータも足りませんでした。理論はあるのに実用にならない期間が長く続きます。層を深くすればよいことは分かっていても、深くすると学習がうまく進まない、という問題も残っていました。
重みを調整する仕組み自体は1986年に整理されています。誤差逆伝播法と呼ばれる方法で、出力と正解のずれを逆向きにたどりながら、各層の重みをどれだけ動かすべきかを計算します。層を深くしても学習を進める道具立ては、この時点で揃っていたわけです。それでも実用に届かなかったのは、計算できる量とデータの量が足りなかったためでした。
2012年、AlexNetとCNNが画像認識を変えた
転換点は2012年です。ImageNetという画像分類のコンペティションで、SuperVisionというチームが出したモデル(AlexNet)が誤り率0.15315を記録しました。次点のチームは0.26172でしたから、10ポイント以上の差です。この数値は主催者のILSVRC2012の公式結果で確かめられます。
AlexNetの原論文によると、このモデルは畳み込み層5層と全結合層3層からなり、パラメータは6,000万個あります。これだけの重みを大量の画像で調整できたのは、GPUで計算を並列に回したからでした。後の節で整理する3つの条件が、この1本の論文の中にすでに揃っています。
この差を生んだのがCNN(畳み込みニューラルネットワーク)です。CNNは画像を小さな領域ごとに見ていき、線や角のような局所的な特徴を自動で拾います。しかも、対象が画像の中で少しずれていても同じものとして扱えます。人が特徴量を設計しなくてよい、という性質がここではっきり示されました。
それまでの画像認識は、輪郭の抽出や色の分布といった手がかりを人が設計して組み合わせる方式でした。研究者が何年もかけて磨いてきた設計を、学習で得た重みが上回った。この出来事が、深層学習という方向へ一気に人と資金が動くきっかけになります。
2017年、Transformerが言葉の扱い方を変えた
次の転換点が2017年です。Googleの研究者らが発表した論文「Attention Is All You Need」で、Transformerという構造が提案されました。
それまで文章を扱うモデルは、単語を前から順番に処理していました。この方式だと、文の最初と最後のように離れた語の関係を捉えにくく、並列に計算することもできません。
Transformerは、文中のどの語とどの語が関係しているかを一度に見る仕組みを導入しました。これによって離れた語の関係を捉えられるようになり、同時に計算を並列化できるようになりました。扱える文章の長さと、学習の速さが同時に変わったのがこの構造の効き目です。
たとえば「その会社が昨年から準備してきた製品は、ようやく今月出荷された」という文で、「製品」と「出荷された」の関係を捉えるには、間にある語を飛び越えて参照する必要があります。順番に処理する方式では、この距離が離れるほど関係が薄れていきました。一度に全体を見る方式は、この制約を外しました。
並列化できるようになったことの意味も大きいところです。学習にかかる時間が短くなれば、同じ期間でより大きなモデルを、より多くのデータで学習させられます。いまのモデルの規模は、この構造の上に成り立っています。
今できるようになったのは、3つの条件が揃ったから
理論があっても実用にならなかったものが動き出したのは、次の3つが揃ったからです。
- 計算資源。GPUで並列計算ができるようになった
- データ量。インターネットの普及で、学習に使える大量のデータが集まるようになった
- アルゴリズム。層を深くしても学習が進むようにする工夫が積み上がった
どれか1つでも欠けていたら、いまの状況にはなっていません。
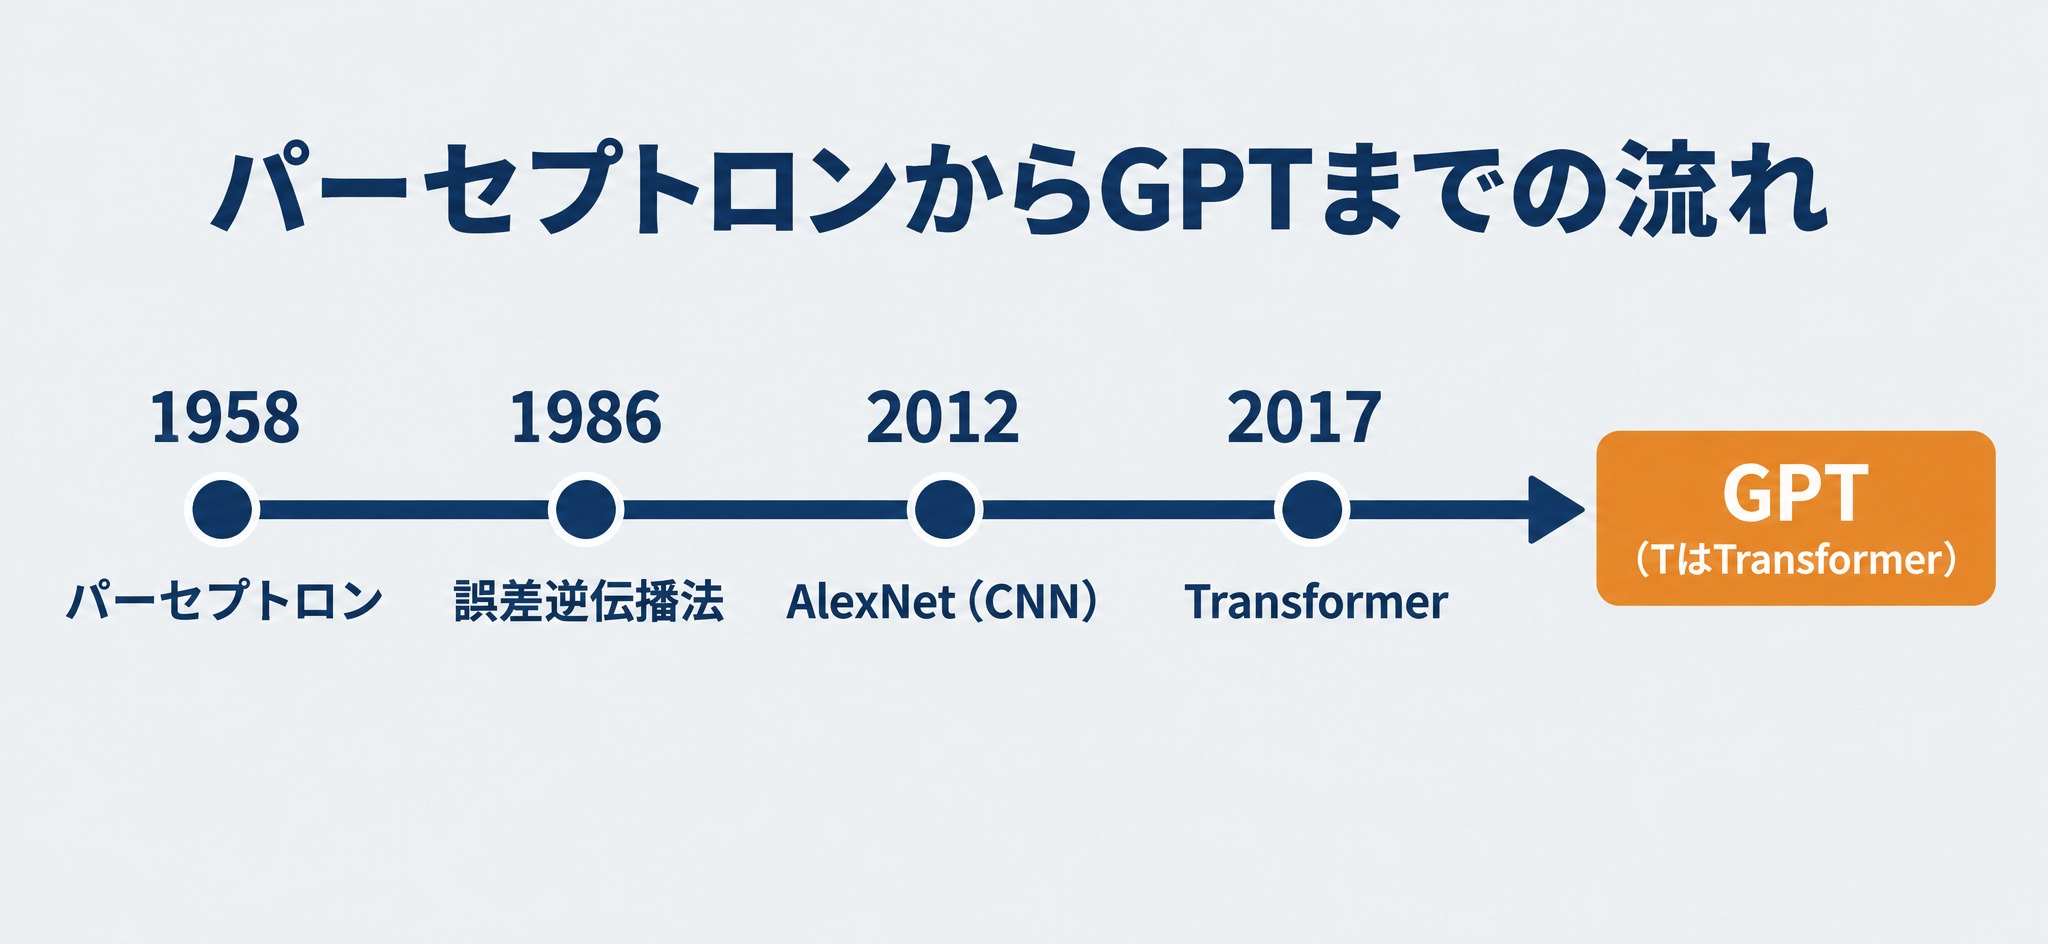
年代を並べると、アイデアの登場から実用までに長い時間がかかったことが分かります。誤差逆伝播法から画像認識の転換点までが26年、そこからTransformerまでは5年です。条件が揃ってからは、進む速さが大きく変わりました。
業務で使っているLLMも、ディープラーニングの延長線上にある
ここまでたどってきた流れの終着点が、いま毎日使っているツールです。
GPTの「T」はTransformerのT
ChatGPTのGPTは、3つの単語の頭文字です。Generative(生成する)、Pre-trained(事前学習済み)、そしてTransformer。前の節で出てきたTransformerが、そのまま名前に入っています。
つまり、2012年の画像認識から2017年のTransformer、そしていまの生成AIまでは、別々の話ではなく一本の線でつながっています。
画像・テキスト・音声でディープラーニングができること
| データの種類 | できること | 身近な例 |
|---|---|---|
| 画像 | 分類、物体検出、領域分割 | 不良品の検出、顔認証、医療画像の診断支援 |
| テキスト | 分類、翻訳、要約、生成 | 問い合わせの振り分け、翻訳、文章の作成 |
| 音声 | 音声認識、読み上げ | 議事録の文字起こし、音声案内 |
ゼロから作らずに、既存モデルを自社向けに調整する選択肢
実務では、ゼロからモデルを学習させる場面はあまりありません。公開されている学習済みモデルを持ってきて、自社のデータで調整する形が一般的です。
この調整の方法はファインチューニングとは。仕組み・種類・RAGとの違いをわかりやすく解説で詳しく扱っています。必要なデータ量も計算資源も、ゼロから作る場合とは桁が変わります。
ここまでディープラーニングの仕組みと系譜を解説しましたが、「理屈は追えたが、自分で手を動かして作れる気がしない」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeでは、Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを段階的に学べます。教材を進めるだけでなく、課題の添削と週1回の面談で詰まった箇所を確認できるため、作る側に回る力を身につけられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
ディープラーニングを学ぶには何から始めればよいか
最後に、学ぶ順番の話をします。
作りたいものを決めると、学ぶ順番が決まる
講座の科目名を上から順に追うより、作りたいものから逆算するほうが早く着きます。
画像を扱いたいのか、テキストを扱いたいのか、社内の数値データで予測をしたいのか。これによって最初に触る技術が変わります。画像ならCNN、テキストならTransformer系、表形式のデータなら、そもそもディープラーニング以外の手法のほうが向いている可能性があります。
ディープラーニングを学ぶ前に必要になる土台
- Pythonの基礎。文法と、配列やリストの扱い方まで
- 数値データの扱い。pandasで読み込み、集計し、整える作業
- 統計の基礎。平均や分散、確率分布のような、数字の読み方
この3つを飛ばしてフレームワークから入ると、動いているものの中で何が起きているか分からないまま進むことになります。エラーが出たときに、どこを直せばよいかの見当がつきません。
独学で止まりやすいのはどこか
- 環境構築。ライブラリのバージョンが噛み合わず、動かすまでに時間を使い切ってしまう
- 数式。論文や教科書の記号で止まり、意味が分からないまま読み飛ばすことになる
- 作りたいものが無いまま終わる。教材を最後までやったが、自分のデータで何かを作ったことがない
3つ目が、実はいちばん多いところです。手を動かす対象を先に決めておくと、途中で目的を見失いにくくなります。
対象は業務に関係するものでなくてもかまいません。自分が続けている趣味のデータでも、社内で誰も見ていない古いログでもよく、最後まで作り切った経験が1回あるかどうかで、次に取りかかる速さが変わります。
資格を学習の目標にする場合
学ぶ順番の目安として、日本ディープラーニング協会(JDLA)の資格を使う方法もあります。2つの資格は、測っているものが異なります。
- G検定。公式ページは「ディープラーニングの基礎知識を有し、適切な活用方針を決定して、事業活用する能力や知識を有しているかを検定する」と説明しています。受験資格の制限はありません。2026年第3回の結果では累計合格者数が148,885名です
- E資格。公式ページの説明は「ディープラーニングの理論を理解し、適切な手法を選択して実装する能力や知識を有しているかを認定する」です。受験には、試験日の過去2年以内にJDLA認定プログラムを修了している必要があります
本記事で扱った機械学習との違いや使い分けを説明できるようになりたいならG検定、自分でモデルを実装する側に回りたいならE資格が近い目標です。ただし、どちらも合格がゴールではありません。前の節で述べたとおり、自分のデータで1つ作り切った経験のほうが、実務では先に問われます。
まとめ
- ディープラーニングとは、ニューラルネットワークの層を深く重ねて、データから特徴を自動で学習する機械学習の一手法
- 機械学習とディープラーニングは並列の別技術ではなく、機械学習の中にディープラーニングがある入れ子の関係
- 最大の違いは、何を手がかりに判断するかを人が設計しなくてよくなったこと。その代わり大量のデータと計算資源が要る
- 表形式のデータ、件数が限られる場合、結果の説明が要る場合は、従来の機械学習のほうが向いている
- 2012年のCNNによる画像認識の飛躍と、2017年のTransformerが転換点。いまのGPTの「T」はそのTransformer
- 実務ではゼロから作らず、学習済みモデルを自社データで調整する形が一般的
ディープラーニングを学ぶなら「Craft College」へ
「ディープラーニングの全体像と流れは分かったが、自分が手を動かして作れるようになるには何から始めればいいのか」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- 用語の解説を読む段階から、自分で作れる段階へ進めたい方
- 独学で環境構築や数式で止まってしまっている方
- 自社のデータで何ができるのかを、手を動かしながら確かめたい方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。