LoRA・QLoRAでファインチューニングを実装する手順。環境構築からハイパーパラメータ設定まで
ファインチューニングの全体像は理解したものの、実際にLoRAやQLoRAでコードを動かそうとすると、ライブラリのバージョン不整合やメモリ不足、設定値の決め方でつまずく方が多いでしょう。概念や5ステップの流れではなく、実装段階で実際に手を止める要因を先回りして解消できれば、学習を無駄なく進められます。そこで本記事では、LoRA・QLoRAによるファインチューニングの環境構築、ハイパーパラメータの決め方、実際のコード例、よくあるエラーと対処法を解説します。すでに手法の全体像を押さえていて、これから実装に入りたい方はぜひ最後までご覧ください。
自社データを使って、手を動かしながら専用AIをつくりたいという方はリベルクラフトへご相談ください。
⇨リベルクラフトのローカルAI環境構築支援の詳細はこちら
ファインチューニングの目的・5ステップの全体像はこちら
ファインチューニングとは、学習済みのAIモデルに追加のデータを学習させ、特定の用途に合わせて内部のパラメータを調整する手法です。目的の定め方やベースモデルの選び方、5ステップの流れといった全体像は、LLMファインチューニングにおける実装5ステップで解説しています。本記事はその続きとして、LoRA・QLoRAによる実装フェーズだけを深掘りします。
LoRA・QLoRAとは何を効率化する手法か
モデル全体を調整するフルファインチューニングに対し、実務で主流なのはPEFT(Parameter-Efficient Fine-Tuning)です。その代表がLoRA(Low-Rank Adaptation)で、Microsoftの研究者らが2021年に発表しました。モデル本体の重みは凍結したまま、各層に小さな行列(アダプター)を追加し、そこだけを学習させます(論文:https://arxiv.org/abs/2106.09685)。
さらにメモリを節約したい場合は、モデルの数値表現を4ビットに圧縮する量子化とLoRAを組み合わせたQLoRAを使います。QLoRAを使うと、7B(70億パラメータ)規模のモデルを16GB程度のGPUで、より大きなモデルも48GB級のGPU1枚で調整できる場合があります(Hugging Face公式ドキュメント)。保有するGPUのメモリ量に合わせて、LoRAかQLoRAかを選びます。
LoRAの効果は、論文の実験で数値として示されています。GPT-3 175Bを最適化手法Adamで全体調整する場合と比べ、LoRAは学習するパラメータ数を約1万分の1に、GPUメモリの必要量を約3分の1に減らしました。RoBERTaやGPT-2などを使った比較では、フルファインチューニングと同等以上の品質を報告しています(上記のLoRA論文)。QLoRAの論文は、650億パラメータのモデルを48GBのGPU1枚で調整し、16ビットで調整した場合と同等の性能を保てたと報告しています(QLoRA論文)。
LoRAとQLoRAのどちらで始めるか
判断の材料になるのは、ベースモデルの重みがGPUのメモリに収まるかどうかです。16ビットの重みは1パラメータあたり2バイトなので、7Bのモデルでは重みだけで約14GBを使います。4ビットに量子化すると1パラメータあたり0.5バイトになり、同じ7Bのモデルが約3.5GBに収まります。実際の学習では、これに加えて学習中の途中計算(アクティベーション)やアダプターの勾配を置く領域が必要です。
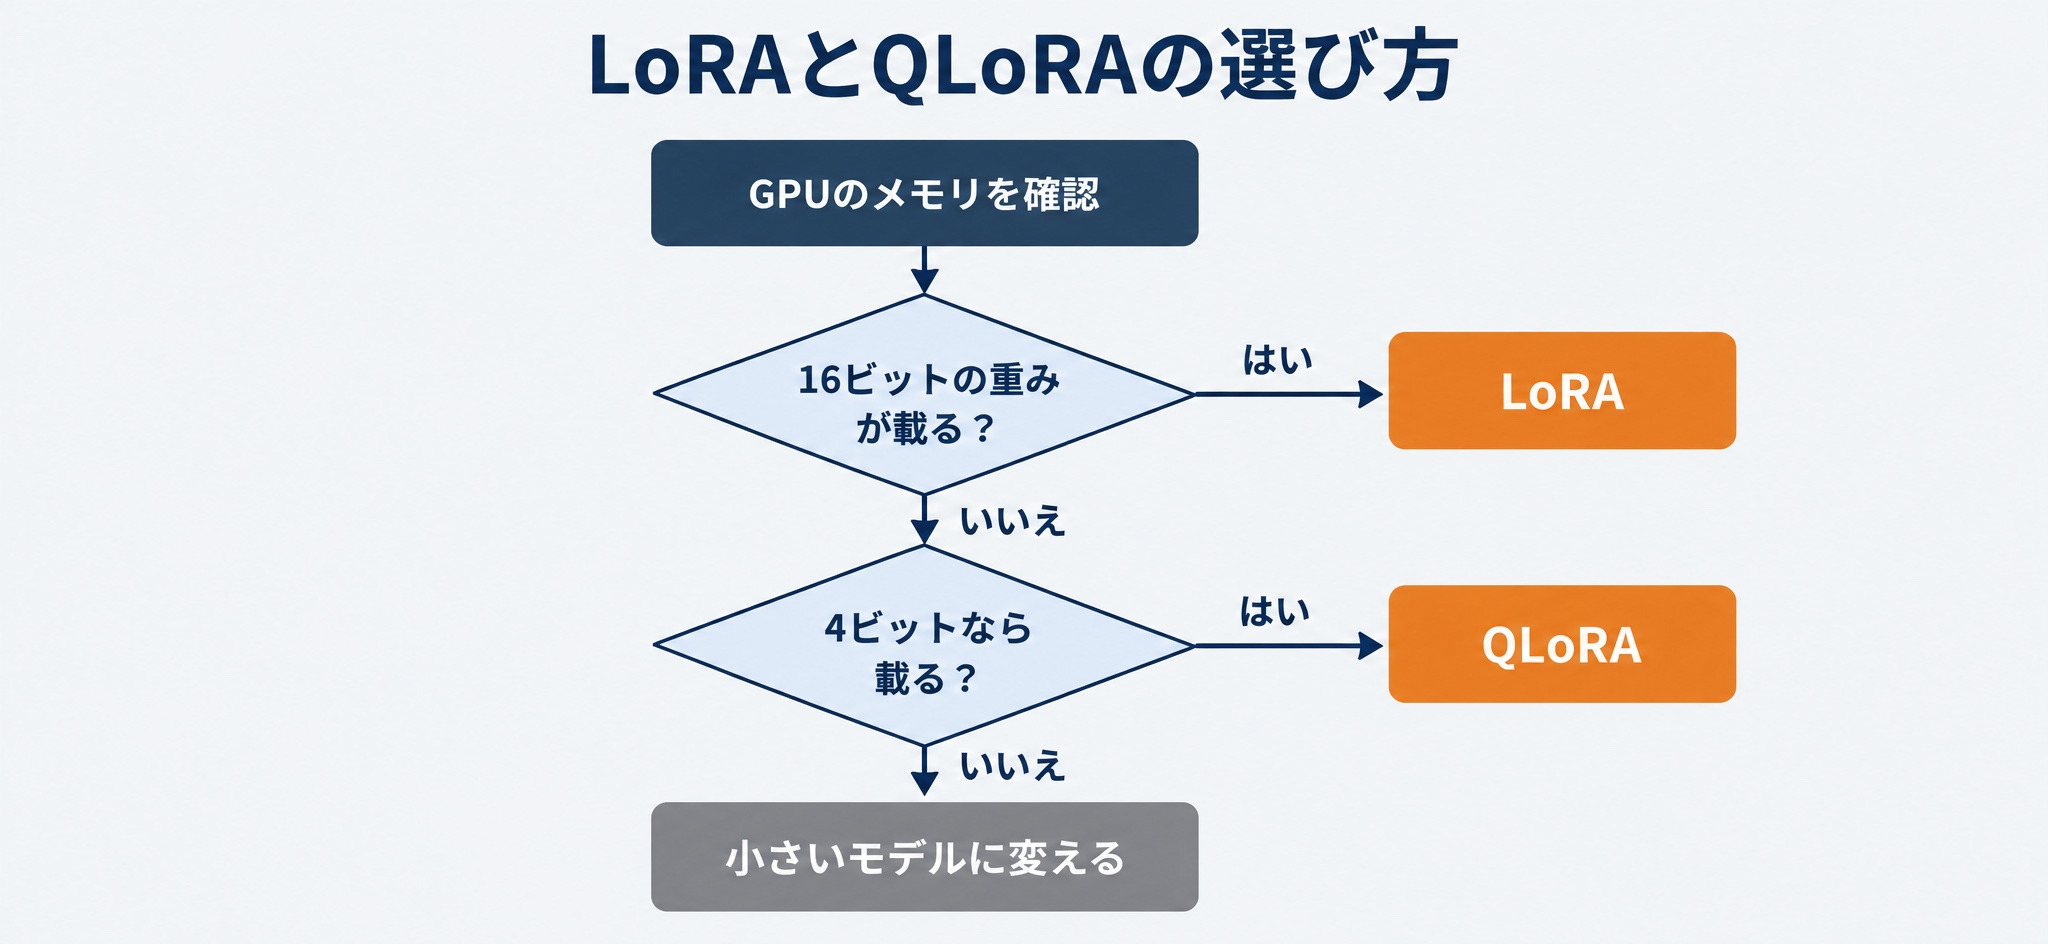
重みの大きさの目安をもとに、判断は次の順番で進めます。まず、16ビットの重みを載せてもメモリに余裕があるならLoRAを選びます。量子化による誤差を考えずに済むため、結果が期待どおりでないときに原因を切り分けやすくなります。16ビットでは収まらず、4ビットなら収まる場合はQLoRAを選びます。QLoRAでも収まらない場合は、パラメータ数の小さいモデルに変えるか、GPUを増やす構成を検討します。
環境構築でつまずきやすい点
オープンソースのモデルを扱う場合、次のライブラリを組み合わせて使うのが一般的です。
| ライブラリ | 役割 |
|---|---|
| Transformers | モデルの読み込みと推論の土台 |
| PEFT | LoRAなどの効率的な追加学習 |
| TRL(SFTTrainer) | 教師ありファインチューニングの実行 |
| bitsandbytes | 4ビット量子化(QLoRA)の実現 |
いずれもHugging Faceが公開しているライブラリです(PEFT、TRL)。環境構築でよくつまずくのが、CUDAのバージョンとbitsandbytesの組み合わせです。bitsandbytesはCUDAのバージョンに強く依存するため、pip installだけで済ませず、GPUドライバとCUDA Toolkitのバージョンに対応したビルドを確認してから導入します。Dockerを使う場合は、Hugging Face公式が配布するCUDA対応イメージを土台にすると、依存関係の食い違いを避けやすくなります。
コードを書かずに設定ファイルで学習を進めたい場合は、LLaMA-Factoryのような統合ツールを使う方法もあります。
環境は5つの順番で確かめる
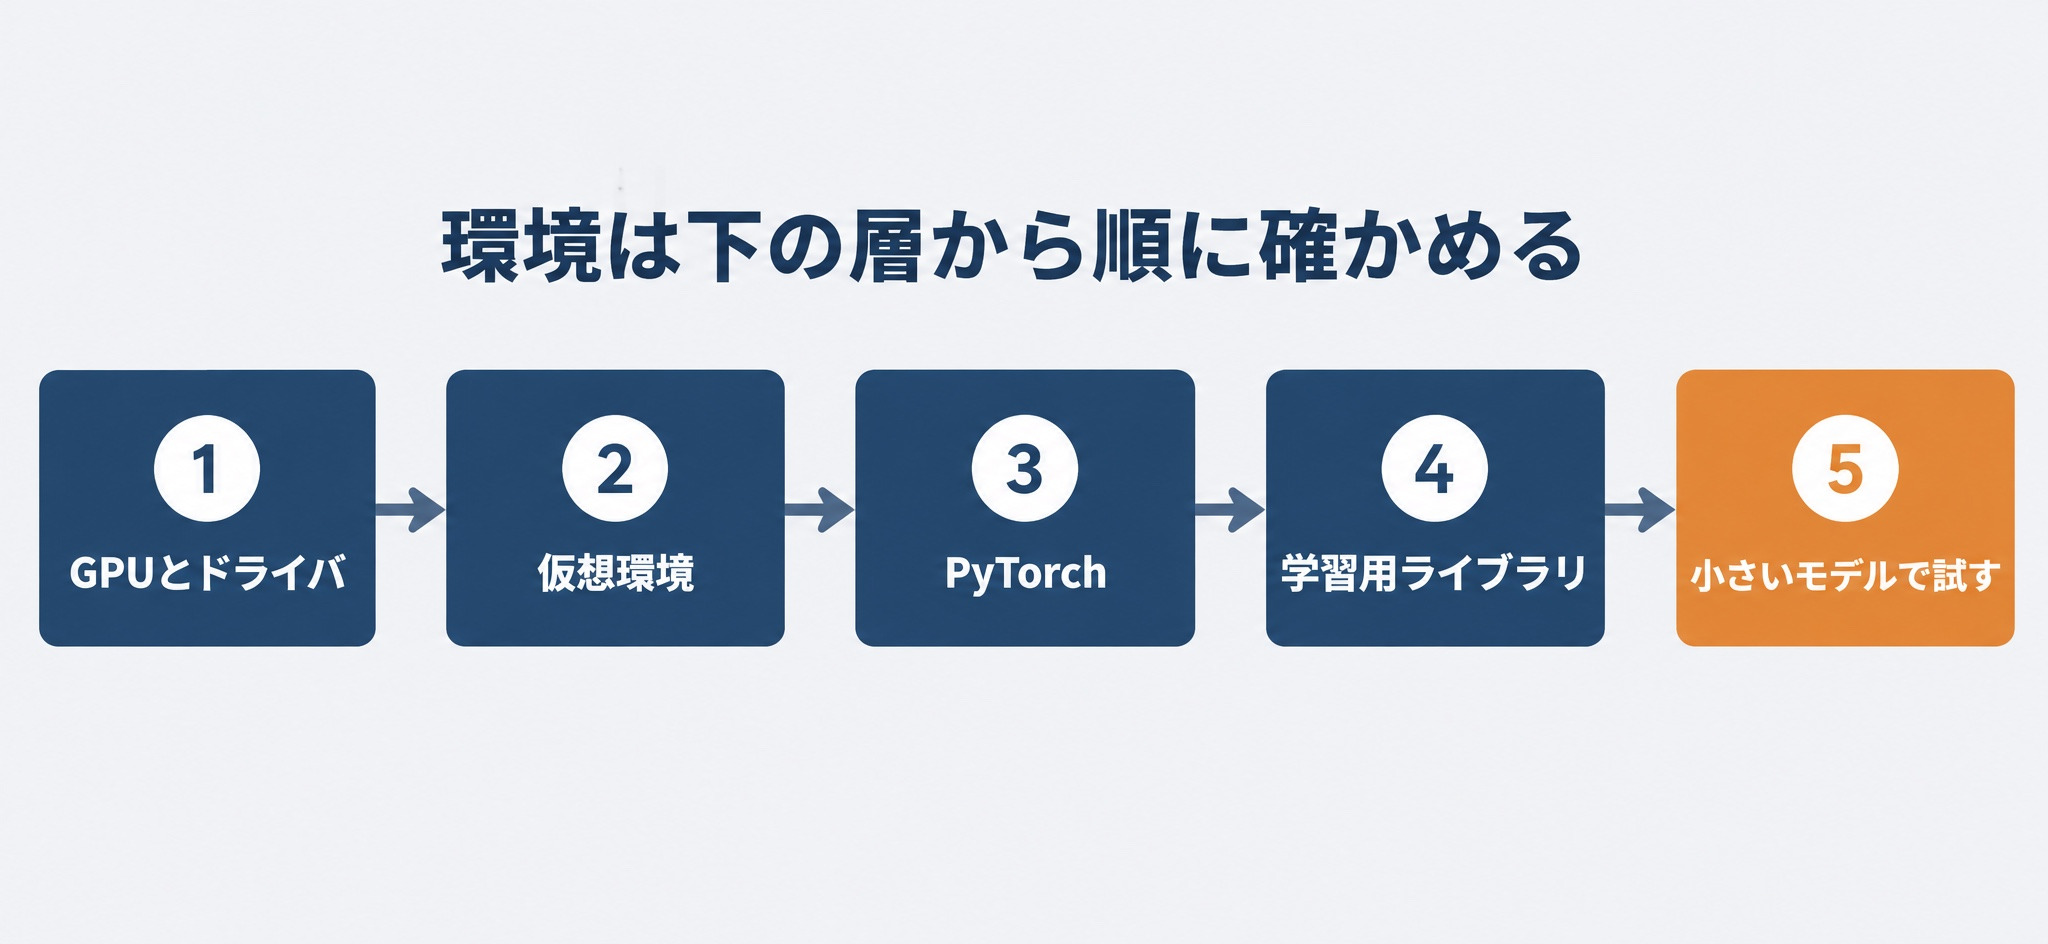
環境構築で時間を失う原因の多くは、どの層で食い違いが起きているかが分からないまま、ライブラリの入れ直しを繰り返すことです。下の層から1つずつ確かめると、問題の場所を絞り込めます。
- GPUとドライバを確かめる:
nvidia-smiを実行し、GPUの型番、ドライバのバージョン、そのドライバが対応するCUDAのバージョンを控えます。 - Pythonの仮想環境を作る:bitsandbytesはPython 3.10以上、PyTorch 2.4以上を要件にしています(bitsandbytesのインストール手順)。プロジェクトごとに仮想環境を分け、ほかの作業のライブラリと混ざらないようにします。
- PyTorchを入れて、GPUを認識するか確かめる:PyTorch公式サイトのインストール画面で、手元のCUDAに合うコマンドを選んで入れます。
python -c "import torch; print(torch.cuda.is_available())"がTrueを返すまで、次の手順に進みません。 - 学習用のライブラリを入れる:TRLの公式ドキュメントは、
pip install trl[peft]でPEFTと一緒に入れ、QLoRAを使う場合はpip install bitsandbytesを追加する手順を示しています(TRLのPEFT連携ガイド)。 - 小さいモデルで一度最後まで回す:0.5B程度の小さいモデルと数十件のデータで学習を1回通し、アダプターの保存まで終わることを確かめてから、本番のモデルに切り替えます。
bitsandbytesは、GPUの世代にも条件があります。4ビット量子化(NF4)は、NVIDIAが定める計算能力(Compute Capability)が6.0以上、つまりPascal世代以降のGPUで使えます。PyPIで配布されているLinuxとWindows向けの版は、CUDA 11.8〜12.6、12.8、13.0〜13.2でビルドされています(前掲のインストール手順)。手元のGPUが古い場合や、CUDAの版がこの範囲から外れる場合は、ソースからのビルドが必要になります。
動く組み合わせが見つかったら、pip freeze > requirements.txtで各ライブラリの版を記録しておきます。PEFTやTRLは更新が速く、数か月後に同じコードを動かすと引数の名前が変わっていることがあります。版を固定しておけば、学習をやり直すときや別のサーバーへ移すときに、同じ環境を作り直せます。
ファインチューニング用の学習データの作り方と形式
学習データに何を集めるか、どの程度の件数と品質が必要かは、LLMファインチューニングにおける実装5ステップで扱っています。ここでは、集めたデータをSFTTrainerに渡すときの形式と、実装で見落としやすい設定に絞って説明します。
SFTTrainerが受け付ける4つの形式
TRLのSFTTrainerは、データの形式を2つの軸で区別しています(SFTTrainerの公式ドキュメント)。1つ目の軸は、1件を1つの文章として扱う「言語モデル形式」か、入力と出力を分ける「プロンプトと回答の形式」かです。2つ目の軸は、プレーンな文字列で書く「標準形式」か、役割(system、user、assistant)ごとに発言を並べる「会話形式」かです。この組み合わせで4つの形式があります。
指示に従うように調整済みのモデル(Instructモデル)をベースにする場合は、会話形式を選ぶのが扱いやすい方法です。会話形式のデータを渡すと、SFTTrainerがモデルのチャットテンプレート(役割の区切りや特殊トークンを決める書式)を自動で当てはめます。推論時と同じ書式で学習できるため、学習と推論で書式が食い違う問題を避けられます。会話形式では、1行に1件を書くJSONL形式のファイルを次のように用意します。
{"messages": [{"role": "system", "content": "社内規程に沿って回答する担当者です。"}, {"role": "user", "content": "出張の精算期限はいつですか。"}, {"role": "assistant", "content": "帰着日から2週間以内に申請してください。"}]}どの部分を学習させるかを決める
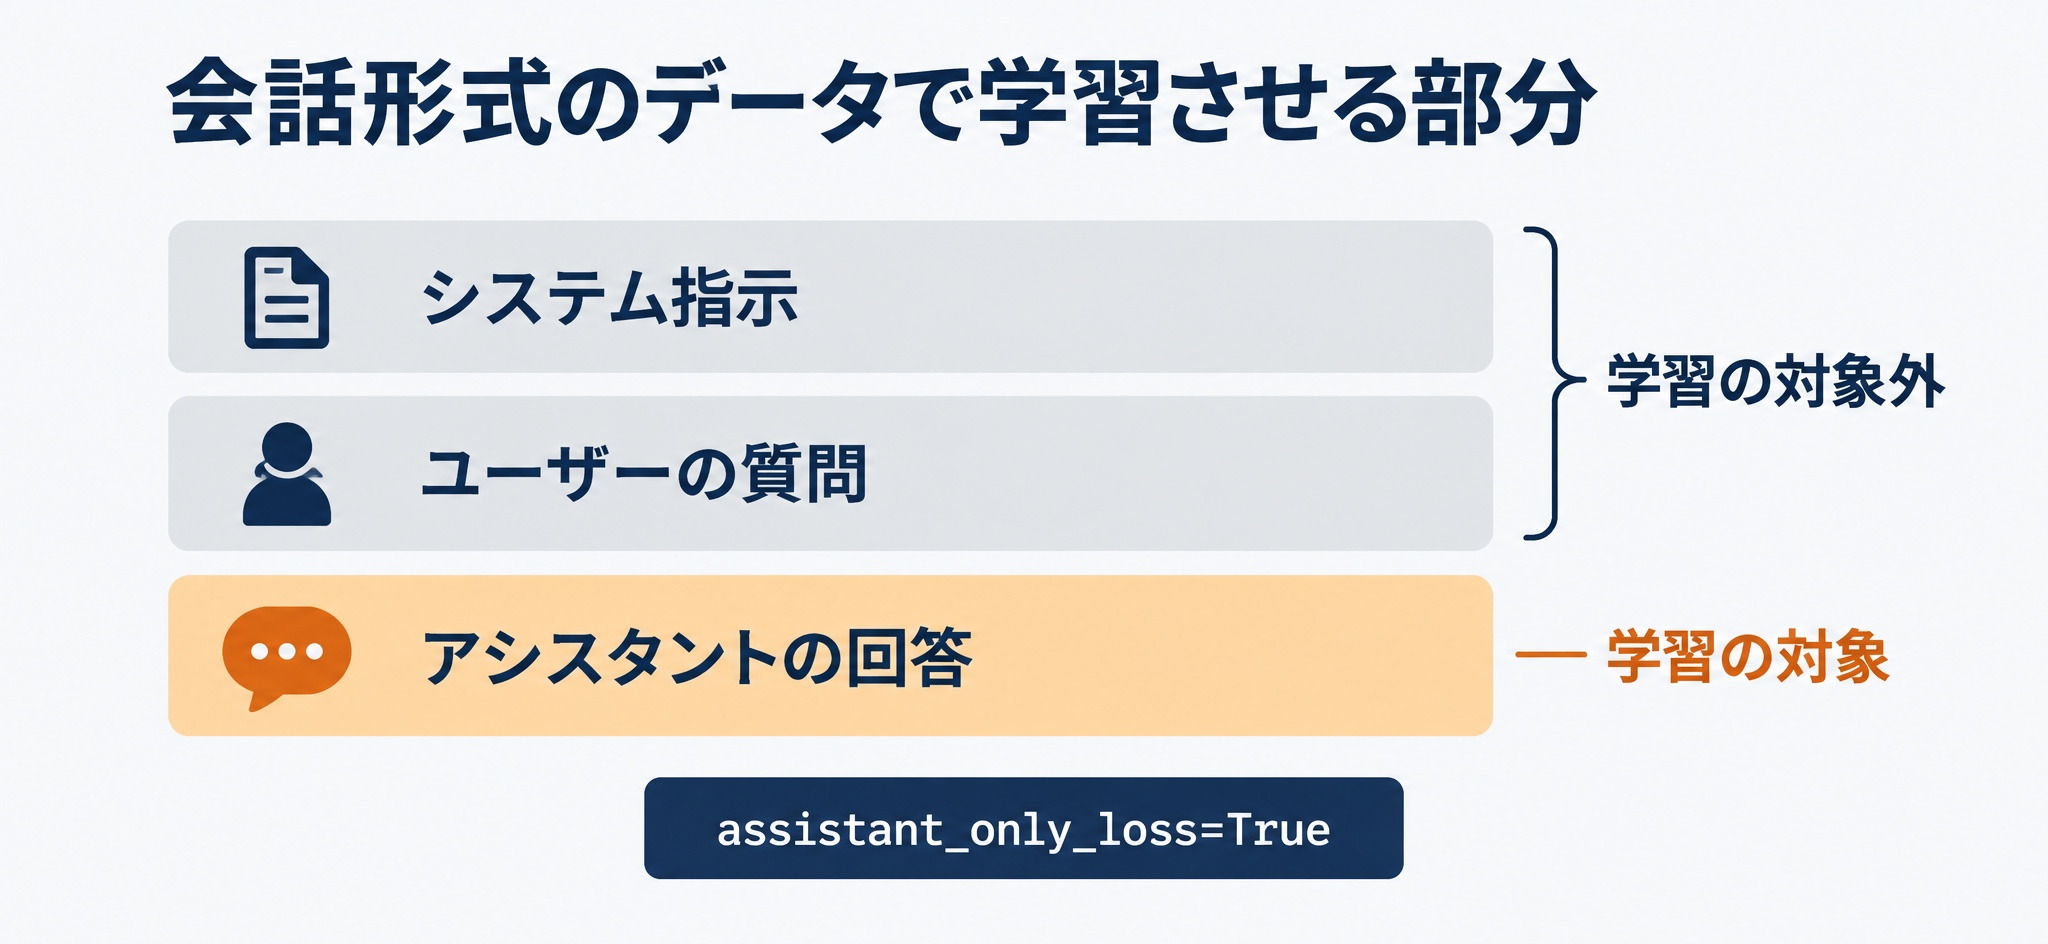
見落としやすいのが、損失(モデルの予測と正解のずれ)をどの部分で計算するかという設定です。プロンプトと回答の形式では、SFTTrainerは初期設定で回答の部分だけを学習の対象にします。一方、messagesで渡す会話形式では、初期設定のままだとシステム指示やユーザーの質問も含めた全体が学習の対象になります。回答の書き方だけを身につけさせたい場合は、SFTConfigでassistant_only_loss=Trueを指定します。
ただし、この設定はチャットテンプレートに回答部分の目印({% generation %}と{% endgeneration %})が含まれている必要があります。TRLの公式ドキュメントによると、Qwen3など既知のモデルではTRLがテンプレートを自動で補いますが、それ以外のモデルでは自分でテンプレートを確かめる必要があります。
長さの上限と、評価用データの切り分け
SFTTrainerは、1件あたりの長さの上限(max_length)を初期設定で1,024トークンにしています。上限を超えた部分は切り捨てられるため、長い回答を含むデータでは、回答の後半が学習されません。学習の前にトークナイザーで各データの長さを数え、上限を超える件数を確かめておきます。超える件数が多い場合は、上限を引き上げるか、データを分割します。上限を上げるとメモリの使用量も増えるため、次の節で扱うバッチサイズと合わせて調整します。
評価用のデータは、学習を始める前に切り分けておきます。同じ質問を言い換えただけのデータが学習用と評価用の両方に入ると、評価の点数が実力より高く出ます。似た質問は同じ側にまとめ、評価用のデータは学習中に一度も見せない状態を保ちます。
ハイパーパラメータの決め方
学習を実行する前に、次の設定値を決めます。初めての場合は、以下を出発点にして結果を見ながら調整するのが安全です。
| 設定項目 | 目安値 | 調整の考え方 |
|---|---|---|
| LoRAのランク(r) | 8〜16 | 大きいほど表現力は上がるが過学習・メモリ増のリスクも上がる |
| LoRAのalpha | ランクの2倍程度 | ランクとの比率でアダプターの影響度が決まる |
| 学習率 | 1e-4〜2e-4 | フルファインチューニングより高めが目安 |
| エポック数 | 2〜3 | 増やしすぎると過学習しやすい |
| バッチサイズ | GPUメモリに収まる最大値 | 収まらない場合は勾配累積で実質的なサイズを確保する |
実装は、TRLのSFTTrainerとPEFTのLoRAConfigを組み合わせるのが標準的な書き方です。
from peft import LoraConfig
from trl import SFTTrainer, SFTConfig

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    target_modules=["q_proj", "v_proj"],
    task_type="CAUSAL_LM",
)

training_args = SFTConfig(
    output_dir="./output",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    learning_rate=2e-4,
)

trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=lora_config,
    args=training_args,
)
trainer.train()target_modules(LoRAを適用する層)は、モデルのアーキテクチャによって名称が異なります。まずはq_proj・v_proj(Attention層の一部)から始め、精度が不足する場合に対象を広げると、メモリと精度のバランスを取りやすくなります。
ランクと対象層で、学習するパラメータ数はどれだけ変わるか
ランクと対象層の選び方が学習の規模にどう効くかを、Qwen2.5-7B-Instruct(総パラメータ数 約76億)を例に、PEFTで実際に数えました。モデルの構成ファイルだけを読み込み、重みは読み込まずに、LoRAを付けたときの学習対象のパラメータ数を数えています。
| 対象層 | r=8 | r=16 | r=32 | r=64 |
|---|---|---|---|---|
| q_proj・v_projのみ | 約252万(0.03%) | 約505万(0.07%) | 約1,009万(0.13%) | 約2,019万(0.26%) |
| 全線形層(all-linear) | 約2,019万(0.26%) | 約4,037万(0.53%) | 約8,074万(1.05%) | 約1億6,148万(2.08%) |
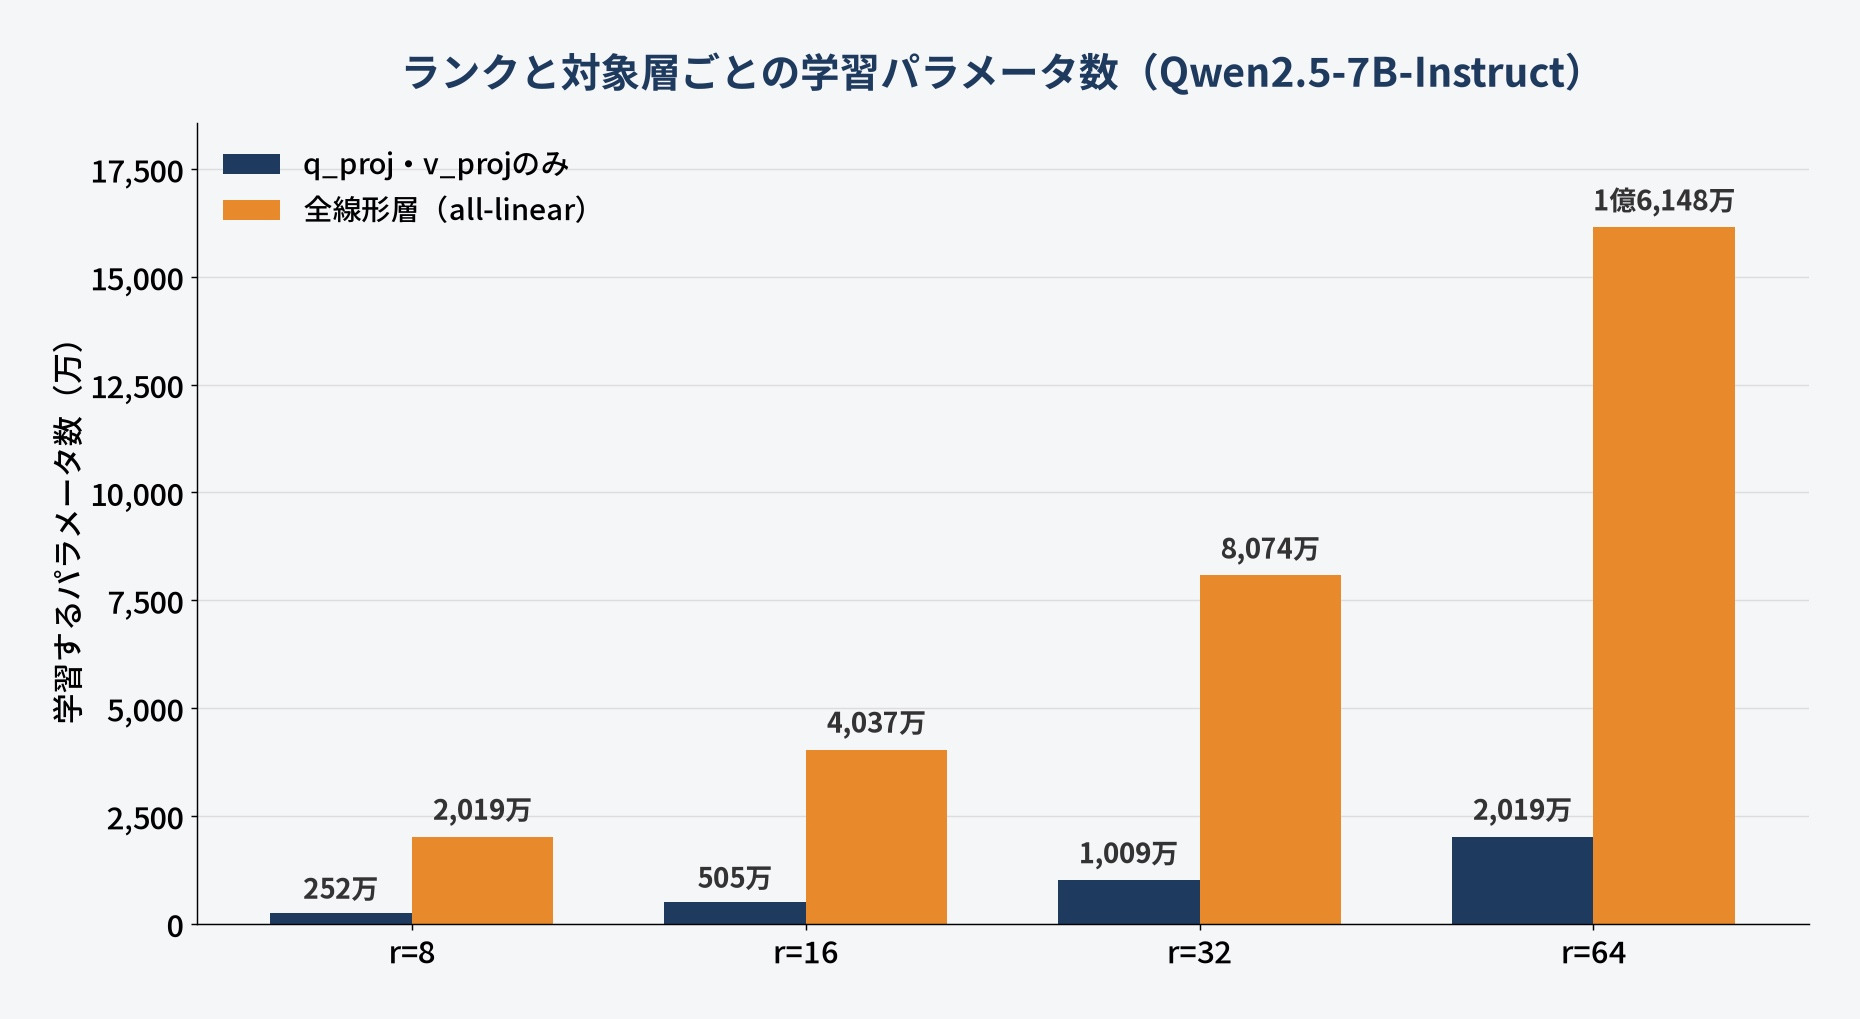
ランクを2倍にすると、学習するパラメータ数も2倍になります。対象層を全線形層に広げると、同じランクでもq_proj・v_projのみの8倍になります。全線形層でr=64にしても、学習するのはモデル全体の約2%です。アダプターを16ビットで保存すると、r=16の全線形層で約81MB(約4,037万パラメータ×2バイト)となり、モデル本体と比べてはるかに小さなファイルで済みます。
PEFTの公式ドキュメントは、target_modules="all-linear"と指定すると、モデルの構造ごとに異なる層の名前を調べなくても全線形層に適用できると説明しています。同じドキュメントは、QLoRA論文のように全線形層へアダプターを付けると、フルファインチューニングと同等の性能を得られる場合があるとも述べています(PEFTのLoRAガイド)。q_proj・v_projのみで精度が足りないときは、ランクを上げる前に対象層を広げる方法も試す価値があります。
学習率とステップ数は、初期値のままにしない
SFTConfigの学習率は、初期値が2e-5です。これはフルファインチューニングを想定した値で、TRLの公式ドキュメントは、LoRAでは学習するパラメータが少ないぶん、約10倍の2e-4を目安にするよう推奨しています(前掲のPEFT連携ガイド)。学習率の指定を忘れると、lossがほとんど下がらないまま学習が終わります。
学習を始める前に、実質的なバッチサイズと総ステップ数も計算しておきます。上のコードでは、1回の計算で4件を処理し(per_device_train_batch_size=4)、4回分の勾配をためてから重みを更新する(gradient_accumulation_steps=4)ため、実質的なバッチサイズは16件です。学習データが1,000件なら1エポックあたり約63ステップ、3エポックで190ステップ前後になります。
総ステップ数が分かると、途中経過の保存の設定を見直せます。SFTConfigの初期設定では、途中経過の保存が500ステップごとです。190ステップで終わる学習では途中の状態が1つも残らず、過学習が始まる前の状態に戻れません。小さなデータで学習する場合は、save_strategy="epoch"としてエポックごとに保存するなど、総ステップ数に合わせて設定します。
QLoRAで読み込むときの設定
QLoRAを使う場合は、量子化の設定をBitsAndBytesConfigで作り、SFTTrainerに渡します。
import torch
from transformers import BitsAndBytesConfig

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True,
)
# SFTTrainer(..., quantization_config=bnb_config, peft_config=lora_config)量子化の型には、QLoRA論文が提案したNF4(正規分布に従う重みに合わせた4ビットの型)を指定します。計算時の型は、学習が安定しやすいbfloat16にします。bnb_4bit_use_double_quant=Trueは、量子化に使う定数そのものも量子化する設定で、TRLの公式ドキュメントによると1パラメータあたり約0.4ビットを節約できます。
よくあるエラーと対処
実装段階では、次のようなエラーで手が止まることが多くあります。
CUDA out of memory(メモリ不足):バッチサイズを下げ、gradient_accumulation_stepsを増やして実質的なバッチサイズを維持します。それでも収まらない場合は、QLoRAへの切り替えや、モデルの層を分割して読み込むオフロードを検討します。
lossが下がらない、または発散する:学習率が高すぎることが多い要因です。1e-4程度まで下げて再実行します。逆にlossがほとんど変化しない場合は、学習率が低すぎるか、LoRAのランクが小さすぎる可能性があります。
学習後のアダプターが読み込めない:ベースモデルのバージョンと、アダプター学習時に使ったベースモデルが一致していないことが原因になりやすいです。base_model_name_or_pathをアダプターの設定ファイルで確認し、推論時に同じモデルを指定します。
量子化したモデルで学習が不安定になる:QLoRAでは、量子化による誤差の蓄積で学習が不安定になることがあります。学習率をさらに下げる、またはLoRAのランクを上げて表現力を補うことで改善する場合があります。
学習後のモデルが回答を終えずに話し続ける:回答の終わりを示すトークン(EOSトークン)を、モデルが学習できていないことが原因です。ベースモデル(指示調整前のモデル)にチャットテンプレートを付けて学習した場合に起きやすく、TRLの公式ドキュメントは、Qwen2.5-1.5Bではeos_token="<|im_end|>"のように、テンプレートの区切りに合わせてEOSトークンを指定するよう案内しています。学習データの回答の末尾に、このトークンが入っているかも確かめます。
学習したのに出力が学習前とほとんど変わらない:まず、学習率を初期値の2e-5のまま学習していないかを確かめます。次に、推論のときにアダプターを読み込めているかを確かめます。ベースモデルだけを読み込んで推論していると、学習の結果は反映されません。学習の前にprint_trainable_parameters()で学習対象のパラメータ数を表示しておくと、アダプターが意図した層に付いているかも確認できます。
学習後の評価チェックポイント
学習が終わったら、学習に使っていないテストデータで評価します。分類タスクなら正解率などの定量指標、対話や要約なら実際の質問を投げて回答のトーンや判断が意図どおりかを人が確認する定性評価の両方を行います。学習データに対する精度は高いのにテストデータで下がる場合は過学習が疑われるため、エポック数を減らす、学習データの多様性を増やすといった対処を行います。評価の設計や改善の反復プロセス全体は、LLMファインチューニングにおける実装5ステップでも扱っています。
学習前のモデルの回答と並べて比べる
評価では、同じ質問を学習前のベースモデルと学習後のモデルの両方に投げ、回答を表に並べて比べます。学習後の回答だけを見ると、良くなった点と、もともとできていた点の区別がつきません。質問は、学習データを作る前に評価用として決めておき、学習データの作成者とは別の担当者が回答を判定すると、判定の甘さを防げます。
回答の良し悪しを何で判定するかは、学習の目的に合わせて、回答を読む前に決めておきます。回答の書式をそろえたいなら書式を守れた件数を、社内用語を正しく使わせたいなら用語の誤りの件数を数えます。判定の基準を決めずに回答を読むと、印象の良い回答に引っ張られて判断がぶれます。
lossの推移から過学習を見つける
SFTTrainerにeval_datasetを渡し、eval_strategy="epoch"などで評価の間隔を指定すると、学習中に評価用データのlossも記録されます。学習用データのlossが下がり続けているのに、評価用データのlossが途中から上がり始めた場合は、その時点から過学習が始まっています。load_best_model_at_end=Trueとmetric_for_best_model="eval_loss"を指定すると、評価用データのlossが最も低かった時点の状態を最後に読み込めます。
もとの能力が落ちていないかを確かめる
特定の業務に合わせて学習させると、学習データと関係のない質問への回答の質が下がることがあります。評価用の質問には、学習の対象の業務だけでなく、一般的な質問や、社内で並行して使う別の業務の質問も数問ずつ混ぜておきます。これらの回答が学習前より明らかに悪くなっている場合は、エポック数を減らすか、学習率を下げて学習し直します。
学習したモデルをローカルLLMとして動かす手順
学習が終わると、手元にはアダプターのファイルだけが保存されます。trainer.save_model()で保存されるのはアダプターの重みで、モデル本体は含まれません(前掲のPEFT連携ガイド)。業務で使うには、このアダプターをどう配布し、どのツールで動かすかを決めます。
アダプターを分けたまま使うか、本体に統合するか
1つ目の方法は、ベースモデルを読み込んだうえで、PeftModel.from_pretrained()でアダプターを重ねて使う方法です。ベースモデルは1つのまま、用途ごとに別のアダプターを切り替えられます。
2つ目の方法は、merge_and_unload()でアダプターの重みを本体に統合し、1つのモデルとして保存する方法です。PEFTの公式ドキュメントは、本体とアダプターを別々に読み込むと推論に遅延が出る場合があり、統合するとその遅延をなくせると説明しています。この関数は元のモデルを書き換えず、統合後のモデルを戻り値として返すため、戻り値を変数に受けて保存します。QLoRAで学習した場合も、統合するときはベースモデルを16ビットで読み込み直してから統合するのが一般的です。
LM Studioで動かすときは、GGUFに変換する
LM Studioは、ローカルでモデルをダウンロードして動かすためのアプリで、公式ドキュメントに学習の機能は記載されていません(LM Studioの公式ドキュメント)。そのため、LM Studioでファインチューニングしたモデルを使いたい場合は、学習は本記事の手順で行い、LM Studioは推論の環境として使います。
LM Studioは、llama.cppが使うGGUF形式と、Apple Silicon搭載のMacではMLX形式のモデルに対応しています。GGUFで使う場合は、統合済みのモデルをllama.cppのconvert_hf_to_gguf.pyでGGUFに変換し、必要に応じて量子化します。アダプターだけを変換するconvert_lora_to_gguf.pyも用意されています(llama.cppのリポジトリ)。
変換と量子化のあとは、評価で使った質問をもう一度投げて、回答が学習直後と変わっていないかを確かめます。量子化の度合いによっては回答が変わるほか、チャットテンプレートが学習時と違う形で読み込まれると、回答の書式が崩れることがあります。
まとめ
本記事では、LoRA・QLoRAによるファインチューニングの実装面を解説しました。要点を整理します。
- LoRAはモデル本体を凍結し、小さなアダプターだけを学習する効率的な手法。QLoRAは量子化と組み合わせてさらにメモリを節約する。
- LoRAかQLoRAかは、ベースモデルの16ビットの重みがGPUのメモリに収まるかで決める。
- 環境構築では、CUDAとbitsandbytesのバージョン整合が最初のつまずきポイントになりやすい。GPU、PyTorch、学習用ライブラリの順に確かめ、小さいモデルで一度最後まで回す。
- 学習データは会話形式のJSONLで用意し、回答だけを学習させる設定と、長さの上限(初期値1,024トークン)を確かめる。
- ハイパーパラメータは、ランク8〜16・学習率1e-4〜2e-4・エポック2〜3を出発点に調整する。SFTConfigの学習率の初期値2e-5のまま学習しない。
- メモリ不足・loss不安定・アダプター読み込み失敗・EOSトークンの食い違いは、いずれも典型的なエラーで対処パターンが決まっている。
- 学習前のモデルと並べて評価し、LM Studioなどで動かす場合はGGUFに変換したあとにもう一度確かめる。
- 目的の定め方や5ステップの全体像は、あわせてLLMファインチューニングにおける実装5ステップを参照するとつながりが分かりやすい。
ファインチューニング実装の相談は「リベルクラフト」
ファインチューニングで成果を出すには、手法の選定だけでなく、自社データの整備からモデルの評価、運用までを見通した専門知識と経験が求められます。手順どおりに動かせても、業務に合った形に育てられなければ効果は出ません。
リベルクラフトでは、モデルを学習させるだけでなく、運用と改善まで一貫して支援します。社内データの整理から、LoRAやQLoRAによる追加学習の設計、RAGとの組み合わせ、業務システムへのつなぎ込み、閉域環境でのセキュリティ整備まで、お客様の業務に合わせて段階的に進めます。完全オンプレ・インターネット非接続の構成を標準で提供でき、扱ったデータを生成AIの学習に使わない構成も可能なため、機密性の高い現場でも導入いただけます。
- 自社のGPU環境で、機密データを外に出さずにファインチューニングを実行したい
- 環境構築やハイパーパラメータ設定でつまずいており、実装を伴走してほしい
- スモールスタートから段階的に自社専用AIを育てていきたい
⇨リベルクラフトのローカルAI環境構築支援の詳細はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。