LangChainとは。v1の構成と使い方、LangGraph・LlamaIndexとの使い分けを動くコードで解説
LLMを使ったアプリを作ろうとLangChainを調べると、LLMChain や ConversationBufferMemory を使うコード例がたくさん見つかります。ところが、いまの版でそのまま動かそうとすると import の段階で止まることがあります。さらに LangGraph・LangChain-core・LangChain-community と名前の似たパッケージが並び、どれを入れればよいのかも分かりにくくなっています。
LangChainは2025年10月に1.0になり、中心となる部品も、パッケージの分け方も変わりました。そこで本記事では、
- LangChainとは何か、2026年9月時点の版とパッケージ構成
- LangChainの主要な部品と、それぞれの役割
- APIキー無しで動かせる最小のコードと、その実行結果
- LangChainでRAGを組む流れ
- LangGraph・LlamaIndexとの違いと使い分け、使うべきでない場面
を解説します。
掲載したコードの出力は、2026年9月23日に実際に実行して得たものです。環境は Apple M1 Pro・Python 3.11.6・langchain 1.4.2・langchain-core 1.6.4・langgraph 1.2.12 です。LLMの呼び出しにはテスト用のモデルを、埋め込みにはローカルで動く多言語モデルを使ったので、APIキーが無くても同じ出力を再現できます。
「LangChainを使ったRAGやAIエージェントを、自社の業務データで作りたい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
LangChainとは。LLMアプリの部品を共通の書き方でつなぐフレームワーク
LangChainの定義。公式は「エージェントの土台」と説明している
LangChainとは、LLMを使ったアプリケーションやAIエージェントを作るための、オープンソースのフレームワークです。モデルの呼び出し、プロンプト、外部ツール、文書の検索といった部品を共通の書き方で提供し、それらをつないでアプリを組み立てます。
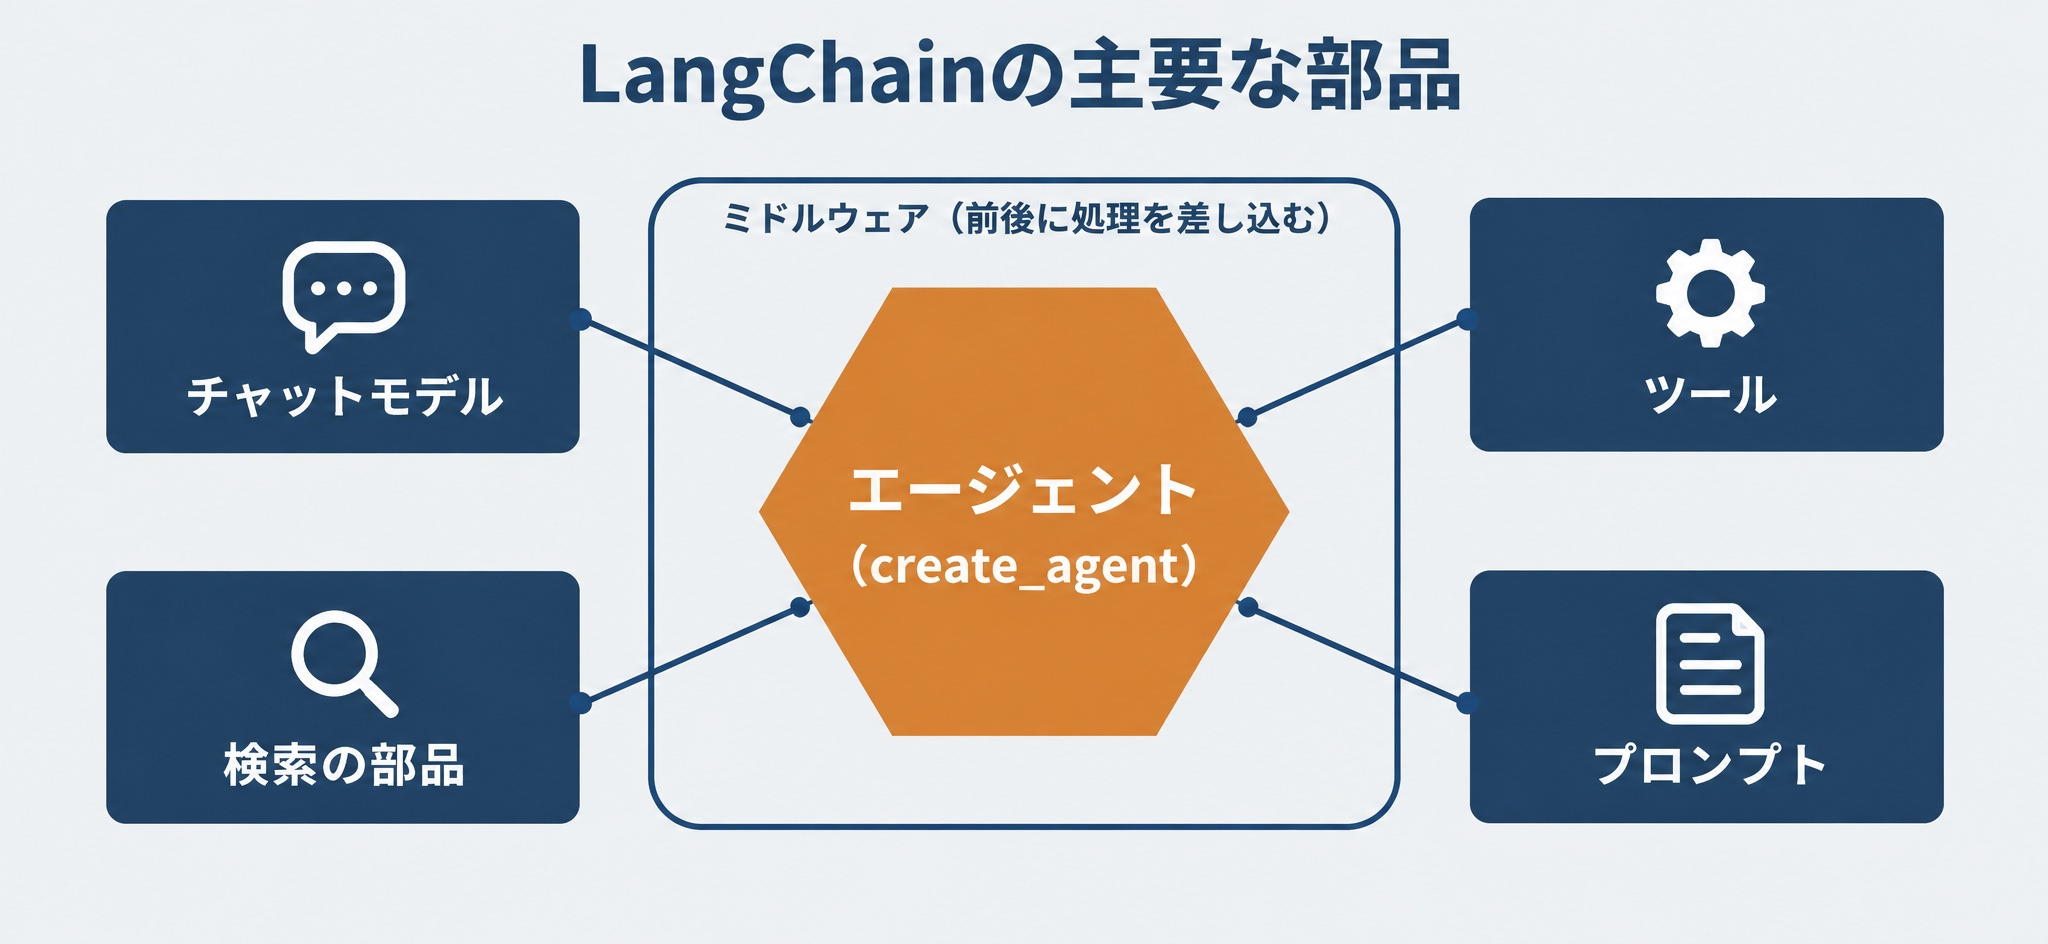
2026年9月時点の公式ドキュメントは、LangChainを create_agent という関数を中心に説明しています。create_agent の位置づけは「最小限で、設定を細かく変えられるエージェントの土台」です。エージェント自体は「モデル+その周りの仕組み(プロンプト・ツール・ミドルウェア)」と定義されています。以前のLangChainは「チェーン(処理をつなぐ部品)の集まり」として紹介されることが多く、説明の軸はそこから移りました。
Python版とJavaScript版があり、どちらもMITライセンスで公開されています。開発元はLangChain社で、同社は後述するLangGraph・Deep Agents・LangSmithも提供しています。
2026年9月時点のバージョンとパッケージ構成
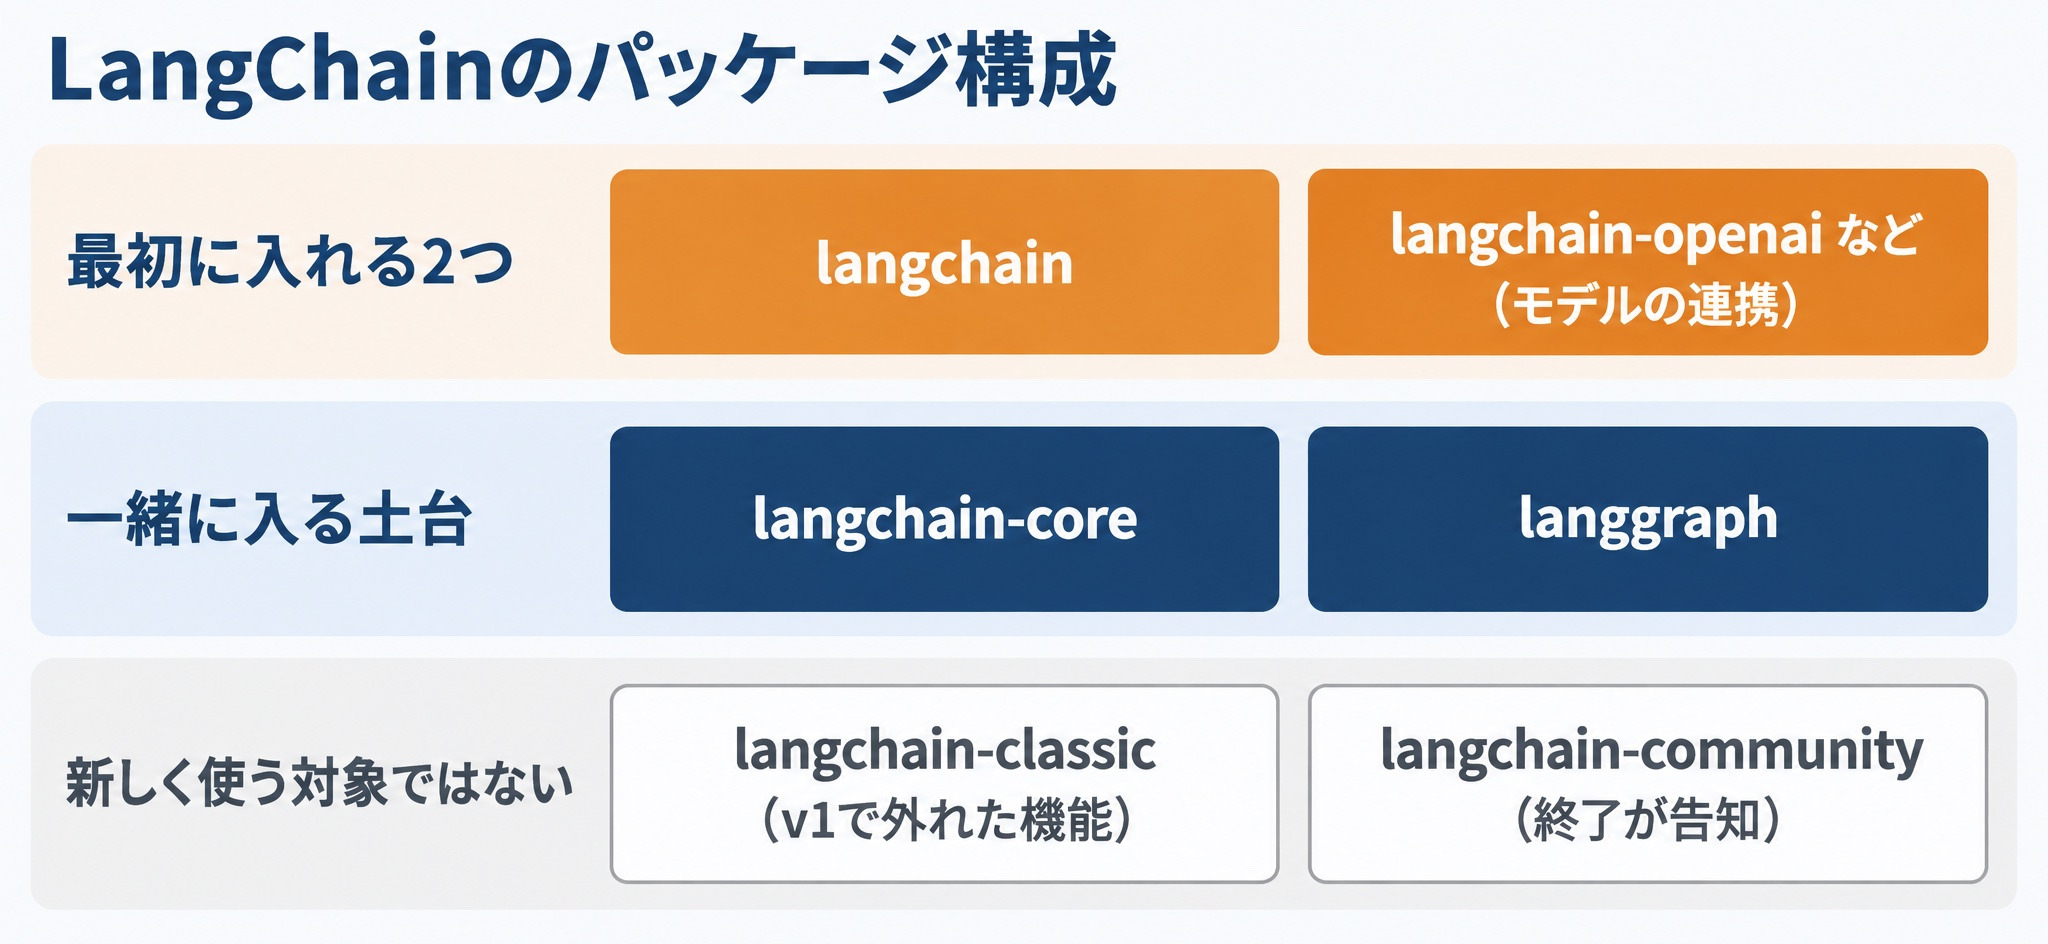
LangChainは1つのパッケージではなく、役割ごとに分かれたパッケージの集まりです。インストール手順では Python 3.10 以上が必要とされています。主なパッケージと、2026年9月23日時点のPyPIの最新版は次のとおりです。
| パッケージ | 役割 | 最新版(公開日) |
|---|---|---|
| langchain | エージェント作成(create_agent)・ミドルウェアなど、利用者が主に触る入口 | 1.4.2(2026-09-18) |
| langchain-core | メッセージ・プロンプト・ツール・埋め込みなどの共通の型 | 1.6.4(2026-09-21) |
| langgraph | エージェントを動かす実行基盤。langchainを入れると一緒に入る | 1.2.12(2026-09-21) |
| langchain-text-splitters | 文書を検索用の単位に切る分割器 | 1.1.2(2026-04-16) |
| langchain-openai・langchain-anthropic など | 各社のモデルとの接続。プロバイダごとに別パッケージ | 例:langchain-openai 1.6.4 |
| langchain-classic | 旧来のチェーン・リトリーバー・hubなど、v1で本体から外れた機能 | 1.0.8(2026-06-10) |
| langchain-community | 外部連携の寄せ集め。2026年5月に終了が告知された | 0.4.2(2026-05-22) |
この表から読み取れることは2つあります。1つは、利用者が最初に入れるのは langchain と、使うモデルの連携パッケージの2つで足りるという点です。もう1つは、古い記事でよく見かける langchain-community が、いまは新しく使う対象ではなくなっている点です。
版の方針は公式のバージョニングのページにまとまっています。LangChainとLangGraphの1.0は長期サポート版に指定され、旧版のLangChain 0.3とLangGraph 0.4は2026年12月まで保守のみの扱いです。
v1で変わったこと。古い記事のコードが動かない理由
PyPIに langchain 1.0.0 が公開されたのは2025年10月17日です。v1の変更点のうち、既存のコードや記事に影響する点は次の4つです。
- エージェントは
create_agentが標準になった。以前のlanggraph.prebuilt.create_react_agentを置き換える位置づけです - ミドルウェアが加わった。エージェントの処理の前後に、要約や承認などの処理を差し込めます
- 本体の名前空間が絞られた。旧来のチェーン、
langchain.retrieversにあったリトリーバー、indexing API、hubは langchain-classic に移りました - Python 3.9のサポートが終わった。すべてのパッケージが Python 3.10 以上を要求します
加えて、2026年5月22日にはlangchain-community の終了が公式に告知されました。告知によると、このパッケージは1年以上前から新しい連携を受け付けておらず、今後は各社が保守する個別のパッケージへ移っていきます。実際に1.4.2の環境で langchain-community から埋め込みの部品を読み込むと、「is being sunset and is no longer actively maintained」という警告が出ました。
検索で上位に出る解説記事にも、from langchain_community... のまま書かれたコード例が残っています。古い記事を参考にするときは、import の行を見て版を見分けてください。
LangChainの主要な部品。モデル・ツール・エージェント・検索の役割分担
ここまでで定義と版をそろえました。次は、LangChainが何を部品として持っているかを見ていきます。公式の部品の分類はモデル・ツール・エージェント・メモリ・リトリーバー・文書処理・ベクトルストアの7つですが、使う順に並べ直すと次の5つにまとまります。
チャットモデル。プロバイダを差し替えられる共通の窓口
チャットモデルは、OpenAI・Anthropic・Google などのLLMを同じ書き方で呼ぶための部品です。init_chat_model("openai:gpt-5.5") のように「プロバイダ名:モデル名」の文字列を渡すと、対応するクラスが選ばれます。
モデルを替えても呼び出し側のコードを書き直さずに済むのが、LangChainを使う大きな理由の1つです。PoCで複数のモデルを比べる段階では、この差し替えやすさが効きます。
プロンプトとチェーン。部品を「|」でつなぐ
プロンプトは、LLMに渡すメッセージのひな形です。ChatPromptTemplate に変数の入る場所を書いておき、実行時に値を埋めます。
プロンプト・モデル・出力の整形を prompt | model | parser のように | でつなぐ書き方は、LCEL(LangChain Expression Language)と呼ばれます。v1でもlangchain-coreに残っていて、決まった順番で処理を流すだけなら、この書き方が最も短く済みます。
ツールとエージェント。create_agentが中心になった
ツールは、LLMが呼び出せる関数です。Pythonの関数に型ヒントと説明文(docstring)を書くと、そのままツールとして渡せます。
エージェントは、モデルとツールを組み合わせて、課題が片づくまで処理を繰り返す仕組みです。公式の説明では「モデルがツールを繰り返し呼び、課題が終わるまで続けるもの」とされています。create_agent は、モデルを呼ぶ、モデルが選んだツールを実行する、結果をモデルに返す、という流れを、モデルがツールを呼ばなくなるまで回します。
外部のツールをつなぐ方法として、MCP(AIとツールをつなぐ共通規格)にも対応しています。langchain.mcp は langchain 1.4.0 以上で使え、2026年9月時点ではbeta扱いです。MCPそのものの仕組みはMCPとは。AIを社内のデータ・ツールに安全につなぐ仕組みを解説で解説しています。
ミドルウェア。エージェントの前後に処理を差し込む
ミドルウェアは、v1で加わった部品です。モデルを呼ぶ前後やツールを実行する前後に処理を差し込み、エージェントの振る舞いを変えます。組み込みのミドルウェアには、たとえば次のものがあります。
- 会話が長くなったら履歴を要約する(Summarization)
- 特定のツールを実行する前に人の承認を求める(Human-in-the-loop)
- 個人情報を検出して伏せる(PII detection)
- 失敗したモデル呼び出しやツール実行をやり直す(Model retry・Tool retry)
- モデルやツールの呼び出し回数に上限を設ける(Model call limit・Tool call limit)
本番運用で後から足したくなる処理が、部品として用意されている形です。
検索の部品。ローダー・分割・埋め込み・ベクトルストア・リトリーバー
RAGで使う部品は5つあります。
- ドキュメントローダー:PDFやWebページなどから文書を読み込む
- テキストスプリッター:文書を検索しやすい長さに切る
- 埋め込みモデル:文章を、意味の近さを測れる数値の並び(ベクトル)に変える
- ベクトルストア:ベクトルを保存して、近いものを探す
- リトリーバー:質問を受け取り、関連する文書を返す窓口
それぞれが同じ形の入出力を持つので、ベクトルストアだけを別の製品に替える、といった差し替えができます。組み立て方は後半のRAGの節で扱います。
LangChainの使い方。APIキー無しで動かす最小のコード
部品の役割を見たところで、実際に動かします。ここでは、LangChainの公式ドキュメントがテスト用に案内している GenericFakeChatModel を使います。渡した応答を順に返すだけのモデルなので、APIキーも課金も要りません。
実行環境とインストール
実行環境は Apple M1 Pro(メモリ32GB)・macOS 14.6.1・Python 3.11.6 です。新しい仮想環境に次の版を入れました。
python3 -m venv .venv
.venv/bin/pip install "langchain==1.4.2" "langchain-core==1.6.4" "langgraph==1.2.12" "langchain-text-splitters==1.1.2"
参考までに、空の仮想環境に langchain==1.4.2 だけを入れると、依存を含めて39個のパッケージが追加され、容量は49,744KB(duでの計測)増えました。langgraph・langsmith・pydantic・httpx などが一緒に入ります。from langchain.agents import create_agent の読み込みには、2回目以降で0.91〜0.96秒かかりました(初回はバイトコードの生成を含めて5.00秒)。
プロンプトとモデルをつないで動かす
最初に、プロンプト・モデル・出力の整形の3つを | でつなぎます。
from langchain_core.language_models.fake_chat_models import GenericFakeChatModel
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

# APIキー不要のテスト用モデル。渡した応答を順番に返すだけ
model = GenericFakeChatModel(messages=iter([
    "LangChainは、LLMアプリの部品を共通の書き方でつなぐフレームワークです。"
]))

prompt = ChatPromptTemplate.from_messages([
    ("system", "あなたは{role}です。1文で答えてください。"),
    ("user", "{question}"),
])

chain = prompt | model | StrOutputParser()

# モデルに渡る直前のメッセージを確認する
print(prompt.invoke({"role": "技術講師", "question": "LangChainとは?"}).to_messages())
# チェーン全体を実行する
print(chain.invoke({"role": "技術講師", "question": "LangChainとは?"}))
実行結果です。
[SystemMessage(content='あなたは技術講師です。1文で答えてください。', additional_kwargs={}, response_metadata={}), HumanMessage(content='LangChainとは?', additional_kwargs={}, response_metadata={})]
LangChainは、LLMアプリの部品を共通の書き方でつなぐフレームワークです。
1行目が、プロンプトの {role} と {question} に値が入り、システムメッセージと利用者のメッセージに変換された状態です。2行目が、モデルの応答を StrOutputParser で文字列に直した結果です。テスト用モデルは台本どおりに返しているだけですが、モデルに何が渡り、何が返るかという流れは、本物のモデルでも同じです。
ツールを呼ぶエージェントを動かす
次に、在庫を調べるツールを1つ持ったエージェントを create_agent で作ります。テスト用モデルには、1回目は「ツールを呼ぶ」、2回目は「最終回答を返す」という台本を渡します。
from langchain.agents import create_agent
from langchain.messages import AIMessage, ToolCall
from langchain_core.language_models.fake_chat_models import GenericFakeChatModel

class FakeToolModel(GenericFakeChatModel):
    # テスト用モデルはツールの登録を受け付けないので、登録だけ素通りさせる
    def bind_tools(self, tools, **kwargs):
        return self

def get_stock(item: str) -> str:
    """商品の在庫数を返す"""
    stock = {"ボルトM6": 120, "ナットM6": 0}
    return f"{item}の在庫は{stock.get(item, '不明')}個です"

# 1回目はツール呼び出し、2回目は最終回答を返すように台本を渡す
model = FakeToolModel(messages=iter([
    AIMessage(content="", tool_calls=[ToolCall(name="get_stock", args={"item": "ボルトM6"}, id="call_1")]),
    "ボルトM6の在庫は120個です。",
]))

agent = create_agent(model=model, tools=[get_stock], system_prompt="在庫の質問に答えるアシスタントです。")
result = agent.invoke({"messages": [{"role": "user", "content": "ボルトM6の在庫は?"}]})

for m in result["messages"]:
    print(type(m).__name__, "|", m.content or m.tool_calls)

# create_agentが返すのはLangGraphのグラフ
print(type(agent).__module__, type(agent).__name__)
print(list(agent.get_graph().nodes))
実行結果です。
HumanMessage | ボルトM6の在庫は?
AIMessage | [{'name': 'get_stock', 'args': {'item': 'ボルトM6'}, 'id': 'call_1', 'type': 'tool_call'}]
ToolMessage | ボルトM6の在庫は120個です
AIMessage | ボルトM6の在庫は120個です。
langgraph.graph.state CompiledStateGraph
['__start__', 'model', 'tools', '__end__']上の4行が、エージェントの1往復で積み上がったメッセージです。利用者の質問、モデルによるツール呼び出しの指示、ツールの実行結果、最終回答の順に並んでいます。3行目の「120個」は台本ではなく、get_stock 関数を実際に実行して得た値です。
1つ、実行して分かった注意点があります。GenericFakeChatModel をそのまま渡すと、ツールを登録する bind_tools の段階で NotImplementedError になりました。公式のテストの例はツールを持たないエージェントなので、この問題が表に出ません。ツール付きのエージェントを試験するときは、上のコードのように bind_tools だけを上書きしたクラスを使います。
最後の2行については、LangGraphとの違いを扱う節で改めて触れます。
本物のモデルに差し替える
実際のLLMにつなぐときは、テスト用モデルの代わりにモデルを指定する文字列を渡します。次のコードは公式ドキュメントのOpenAIの例に合わせたもので、APIキーが必要なため本記事では実行しておらず、出力も載せていません。
# pip install -qU langchain "langchain[openai]"
# 環境変数 OPENAI_API_KEY を設定しておく
from langchain.agents import create_agent

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[get_stock],
    system_prompt="在庫の質問に答えるアシスタントです。",
)
変わるのは model= の1行だけです。ツールとシステムプロンプトはそのまま使えます。
LangChainでRAGを組む流れ。検索までを最小コードで確かめる
エージェントの次は、LangChainの用途として最も多いRAGです。RAG(検索拡張生成)とは、質問に関連する文書を検索し、その内容を根拠にLLMに答えさせる仕組みを指します。LLM単体との違いはLLMとRAGの違いとは?LLM単体で利用する際の課題と実装の方法を解説で詳しく解説しています。
LangChainのRAGは5つの部品を順につなぐ
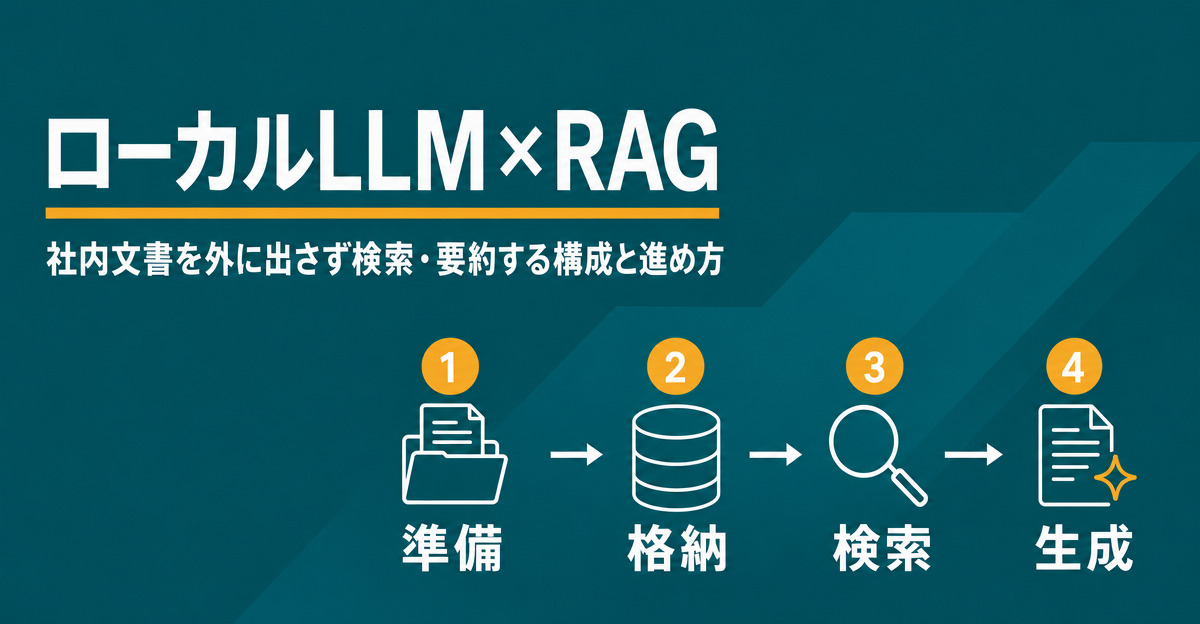
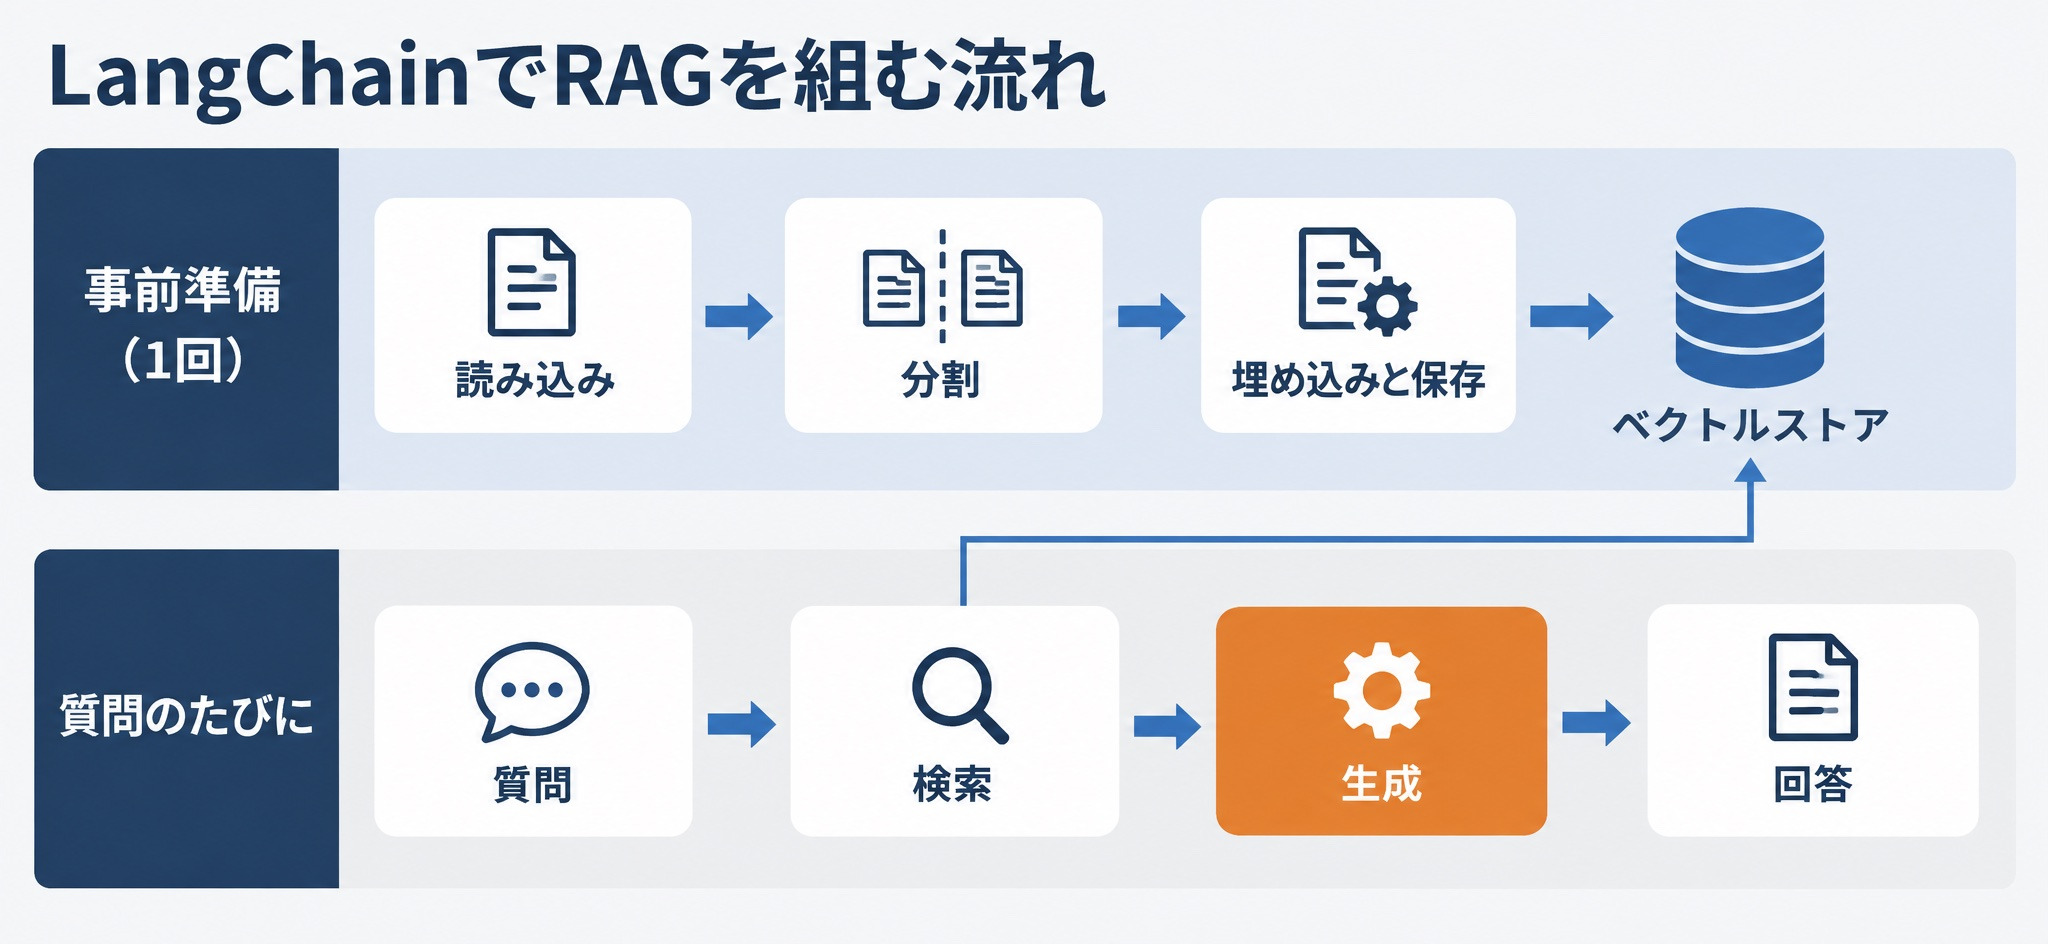
LangChainでRAGを組むときは、前半で見た検索の部品を次の順に並べます。
- 読み込み:ドキュメントローダーで文書を
Documentとして読み込む - 分割:テキストスプリッターで、検索の単位(チャンク)に切る
- 埋め込みと保存:埋め込みモデルでベクトルにし、ベクトルストアに入れる
- 検索:質問もベクトルにし、近いチャンクをリトリーバーで取り出す
- 生成:取り出したチャンクをプロンプトに入れ、チャットモデルに答えさせる
1から3は文書が増えたときに行う準備、4と5は質問のたびに行う処理です。
検索までを動かした結果
架空の社内規程3文書で、1から4までと、生成の直前までを動かします。埋め込みには、ONNX形式のモデルをローカルで動かす fastembed 0.8.1(onnxruntime 1.30.0)と、多言語対応の paraphrase-multilingual-MiniLM-L12-v2 を使いました。初回の実行時に約240MBのモデルファイルを取得します。
langchain-community にあった fastembed 用の部品は使わず、langchain-core の Embeddings を継承した小さなクラスを書いています。embed_documents と embed_query の2つを実装すれば、どの埋め込みモデルでもLangChainの部品として差し込めます。
from fastembed import TextEmbedding
from langchain_core.documents import Document
from langchain_core.embeddings import Embeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 埋め込みモデルの部品:Embeddingsの2つのメソッドを実装すれば、どのモデルでも差し込める
class LocalEmbeddings(Embeddings):
    def __init__(self, model_name):
        self.model = TextEmbedding(model_name=model_name)
    def embed_documents(self, texts):
        return [v.tolist() for v in self.model.embed(texts)]
    def embed_query(self, text):
        return self.embed_documents([text])[0]

# 1. 読み込み:本記事用に作った架空の社内規程(3文書)
docs = [
    Document(page_content="第1条 有給休暇は入社6か月後に10日付与する。\n第2条 有給休暇の申請は取得日の3営業日前までに上長へ行う。", metadata={"source": "就業規則"}),
    Document(page_content="出張旅費は実費精算とする。\n宿泊費の上限は1泊12,000円とし、領収書を経費システムに添付する。", metadata={"source": "旅費規程"}),
    Document(page_content="社外へのファイル送付は、パスワード付きではなく共有リンクで行う。\n共有リンクの有効期限は14日とする。", metadata={"source": "情報セキュリティ規程"}),
]

# 2. 分割
splitter = RecursiveCharacterTextSplitter(chunk_size=40, chunk_overlap=0, separators=["\n", "。", ""])
chunks = splitter.split_documents(docs)
print("チャンク数:", len(chunks))

# 3. 埋め込みと保存(ローカルで動く多言語モデル。APIキー不要)
emb = LocalEmbeddings("sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")
store = InMemoryVectorStore.from_documents(chunks, emb)
print("ベクトルの次元数:", len(emb.embed_query("テスト")))

# 4. 検索
question = "ホテル代はいくらまで精算できますか"
for doc, score in store.similarity_search_with_score(question, k=2):
    print(round(score, 3), doc.metadata["source"], "|", doc.page_content)

# 5. 生成の直前まで:検索結果をプロンプトに詰める
retriever = store.as_retriever(search_kwargs={"k": 2})
context = "\n".join(d.page_content for d in retriever.invoke(question))
prompt = ChatPromptTemplate.from_messages([
    ("system", "次の資料だけを根拠に答えてください。資料にないことは「分かりません」と答えてください。\n資料:\n{context}"),
    ("user", "{question}"),
])
print(prompt.invoke({"context": context, "question": question}).to_messages()[0].content)
実行結果です(モデル取得時の進捗表示は省いています)。
チャンク数: 6
ベクトルの次元数: 384
0.689 旅費規程 | 宿泊費の上限は1泊12,000円とし、領収書を経費システムに添付する。
0.555 旅費規程 | 出張旅費は実費精算とする。
次の資料だけを根拠に答えてください。資料にないことは「分かりません」と答えてください。
資料:
宿泊費の上限は1泊12,000円とし、領収書を経費システムに添付する。
出張旅費は実費精算とする。
3文書は改行の位置で6つのチャンクに分かれました。質問には「ホテル代」と書き、文書側は「宿泊費」と書いてありますが、類似度0.689で宿泊費の行が1位に来ています。言葉が一致しなくても、意味の近さで探せていることが分かります。
最後の4行が、5番目の生成でLLMに渡すシステムメッセージです。この先はチャットモデルを prompt | model | StrOutputParser() でつなぐだけですが、本物のモデルを使わないと意味のある回答にならないため、生成の出力は載せていません。
なお、ここでの chunk_size=40 は短い例文に合わせた値で、実務の文書にそのまま使う値ではありません。チャンクの長さや区切り文字は検索の精度を大きく左右するので、自分の文書と想定質問で検索結果を測ってから値を決めてください。
2-Step RAGとAgentic RAG。検索を毎回するか、エージェントに任せるか
公式ドキュメントのRetrievalのページは、RAGの組み方を3つに分けています。
1つ目の2-Step RAGは、上のコードのように、どの質問でも最初に検索し、その結果を使って生成する形です。LLMの呼び出し回数が決まっているので応答時間の見通しが立ちやすく、社内FAQや文書の質問応答に向きます。2つ目のAgentic RAGは、検索をツールとしてエージェントに渡し、いつ何を検索するかをLLMに判断させる形です。柔軟な反面、応答時間は質問によって変わります。3つ目のHybrid RAGは、質問の書き換えや検索結果の検証を途中に挟み、足りなければ検索し直す形です。
まずは2-Step RAGで検索の精度を確かめ、1回の検索では足りない質問が多いと分かってから、Agentic RAGに進む順番が扱いやすいでしょう。検索結果を評価して再検索するAgentic RAGの実装は、Agentic RAGの実装方法。LangGraphでCorrective RAG・Self-RAGを構築する手順で解説しています。
ここまでLangChainの部品と使い方、RAGの流れを見てきましたが、「最小のコードは動いたものの、自分の業務データで精度の出るRAGやエージェントに仕上げる手順が分からない」という方は、Craft Collegeの上級コースをご検討ください。
Craft CollegeのDS ADVANCEDは、データサイエンスやAI開発の実務者に向けた12週の上級プログラムです。Agentic RAGやマルチエージェントの実装に加えて、W&BとMLflowを使った評価と精度改善までを扱うため、本記事の最小コードを、測って直せる仕組みにまで育てる進め方が身につきます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft College DS ADVANCEDの詳細はこちら
LangChainとLangGraph・LlamaIndexの違いと使い分け
LangChainを調べると、LangGraphやLlamaIndexと比べる記事が多く見つかります。ここでは3つの関係を、公式ドキュメントの位置づけと、前の節で動かしたコードの結果から整理します。
LangGraphとの違い。LangChainのエージェントはLangGraphの上で動いている
LangGraphとは、状態を持つエージェントやワークフローを、ノード(処理)とエッジ(遷移)のグラフとして組み立てる実行基盤です。LangGraphの公式ドキュメントは、自らを「低レベルのオーケストレーションのフレームワーク兼ランタイム」と説明しています。
両者は別々の道具ではなく、層の上下の関係にあります。公式の整理では、LangChainは「フレームワーク」、LangGraphは「ランタイム」で、LangChain 1.0はLangGraphの上に作られています。前の節の出力でも、create_agent の戻り値は langgraph.graph.state の CompiledStateGraph で、中には model と tools の2つのノードがありました。create_agent は、LangGraphのグラフを決まった形で組み立てて返す関数だと言えます。
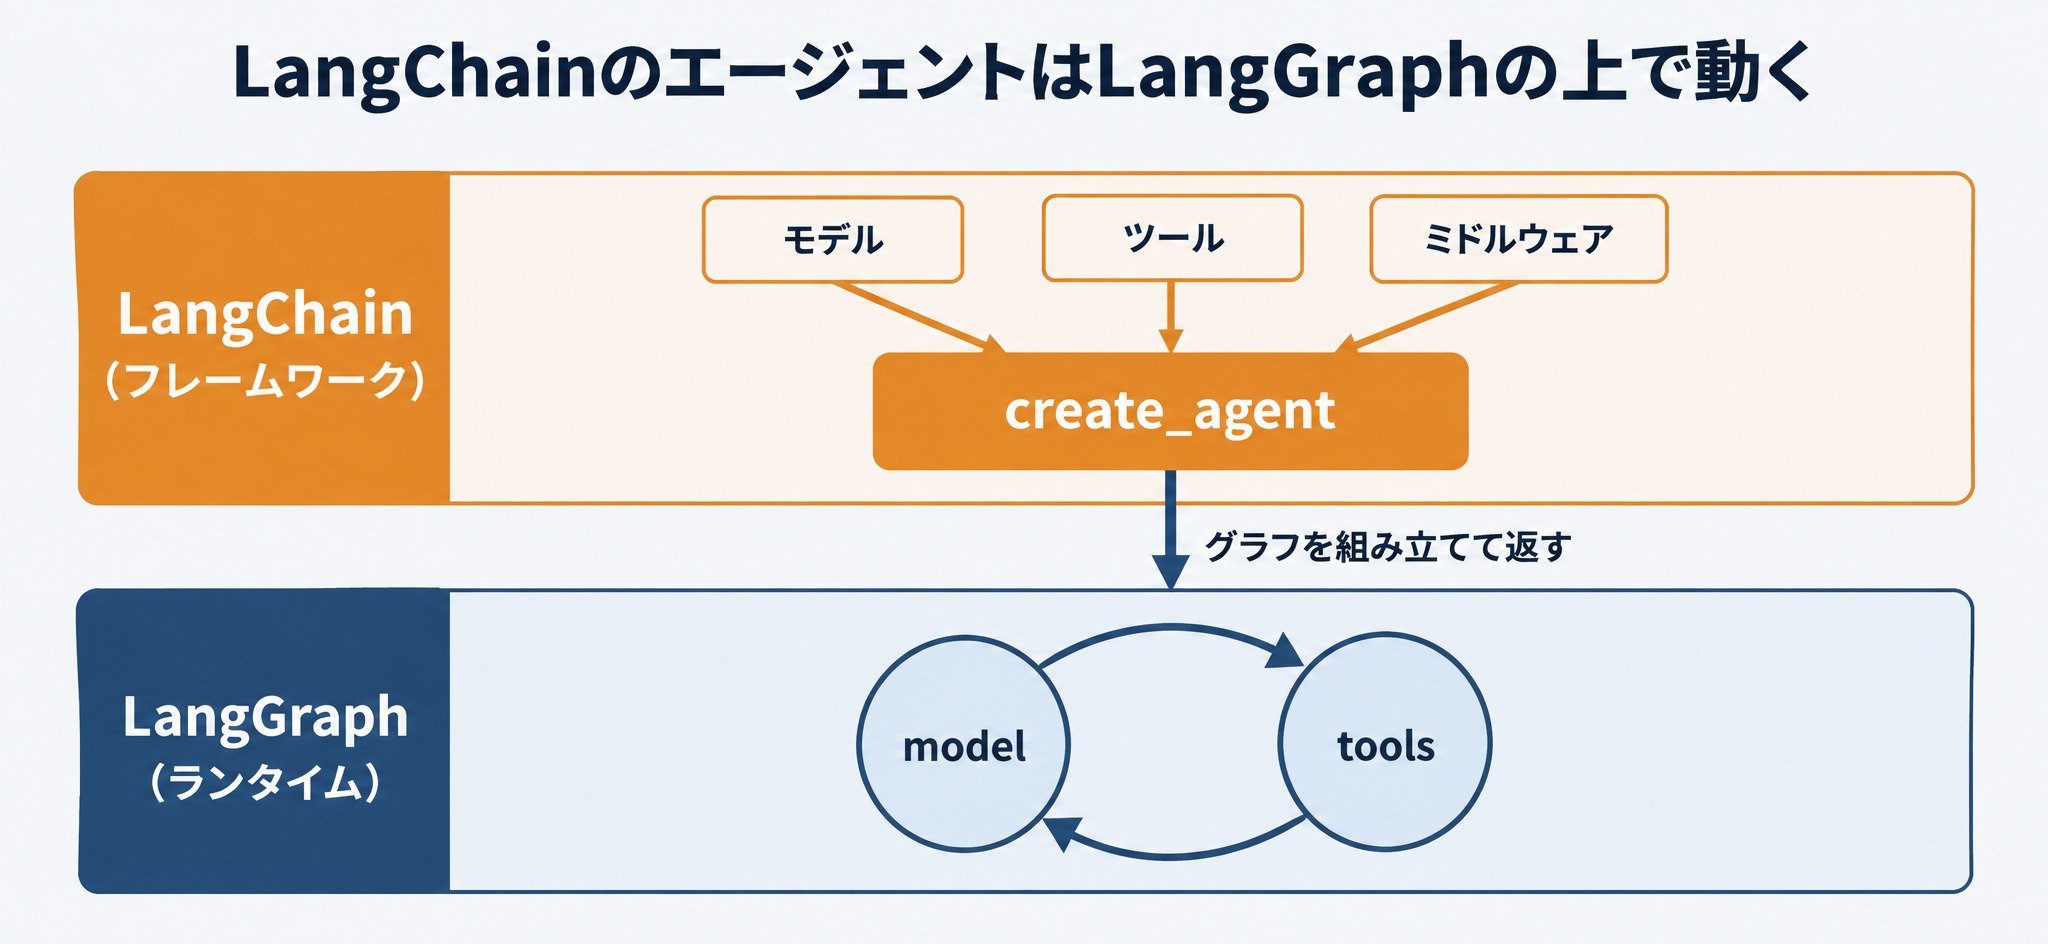
違いは、処理の流れを誰が決めるかに出ます。create_agent では「モデルを呼び、ツールを実行する」という繰り返しの形が決まっていて、利用者はモデル・ツール・ミドルウェアを選びます。LangGraphでは、どのノードをどの順に通るか、どこで分岐し、どこで人の承認を待つかを、利用者がグラフとして書きます。
LangGraphのStateやノード、エッジの書き方はLangGraphとは?AIエージェントの実装に最適なフレームワークを図解で解説で解説しています。
LlamaIndexとの違い。データの取り込みと検索に厚い
LlamaIndexとは、自社のデータをLLMから使えるようにすることに重点を置いたフレームワークです。公式ドキュメントは、自らを「データの上でLLMを使うエージェントを作るためのフレームワーク」と紹介しています。
LlamaIndexは、RAGを読み込み・インデックス化・保存・問い合わせ・評価の5段階で説明し、文書をNodeという単位に分けて扱います。PDFなどの文書の解析には、同社のクラウドサービスであるLlamaParseも用意されています。2026年9月時点の最新版は llama-index 0.14.25 で、MITライセンスです。
LangChainの公式の整理でも、LlamaIndexはLangChainと同じ「フレームワーク」の側に並べられています。つまり、どちらもLLMアプリを作る道具で、LangChainはエージェントとモデル・ツールの共通化に、LlamaIndexは文書の取り込みと検索の作り込みに、それぞれ説明の重心があるという違いです。検索の部分をLlamaIndexで作り、エージェントの部分をLangChainやLangGraphで作る、という組み合わせもできます。
Deep Agentsとの関係。3つ目の選択肢
LangChain社は、3つ目のオープンソースとしてDeep Agentsも公開しています。公式の整理では「ハーネス」と呼ばれ、計画を立てる機能、サブエージェントへの委任、ファイルシステムを使った文脈の管理などを最初から備えています。
公式の概要ページは、多機能なエージェントをすぐ使いたい場合はDeep Agentsから始め、細かく作り込みたい場合はLangChainの create_agent を使うよう案内しています。ただし2026年9月時点の deepagents は0.7.17で、1.0に達していません。公式のバージョニングのページも、1.0に達するまではマイナーバージョンの更新でAPIが変わりうると明記しています。
用途別の選び方
4つを、同じ項目で並べます。
| 項目 | LangChain | LangGraph | LlamaIndex | Deep Agents |
|---|---|---|---|---|
| 公式の位置づけ | フレームワーク | ランタイム | フレームワーク | ハーネス |
| 得意なこと | モデル・ツールの共通化と、エージェントの素早い組み立て | 分岐・ループ・承認待ちを含む処理の流れの制御 | 文書の取り込み・インデックス・検索の作り込み | 計画・サブエージェント・ファイル操作を備えた長時間の作業 |
| 向く用途 | ツールを呼ぶエージェント、2-Step RAG、モデルを比べるPoC | 業務手順が決まったワークフロー、Agentic RAG、マルチエージェント | 大量の文書を扱う質問応答 | 調査やコーディングなど、手順を自分で分解する作業 |
| 2026年9月の版 | 1.4.2 | 1.2.12 | 0.14.25 | 0.7.17 |
この表から読み取れるのは、4つが同じ役割を奪い合っているわけではない点です。エージェントを組み立てる入口としてLangChainを使い、流れを細かく決めたくなったらLangGraphへ降り、文書の取り込みが重いならLlamaIndexを併用する、と層で考えると選びやすくなります。
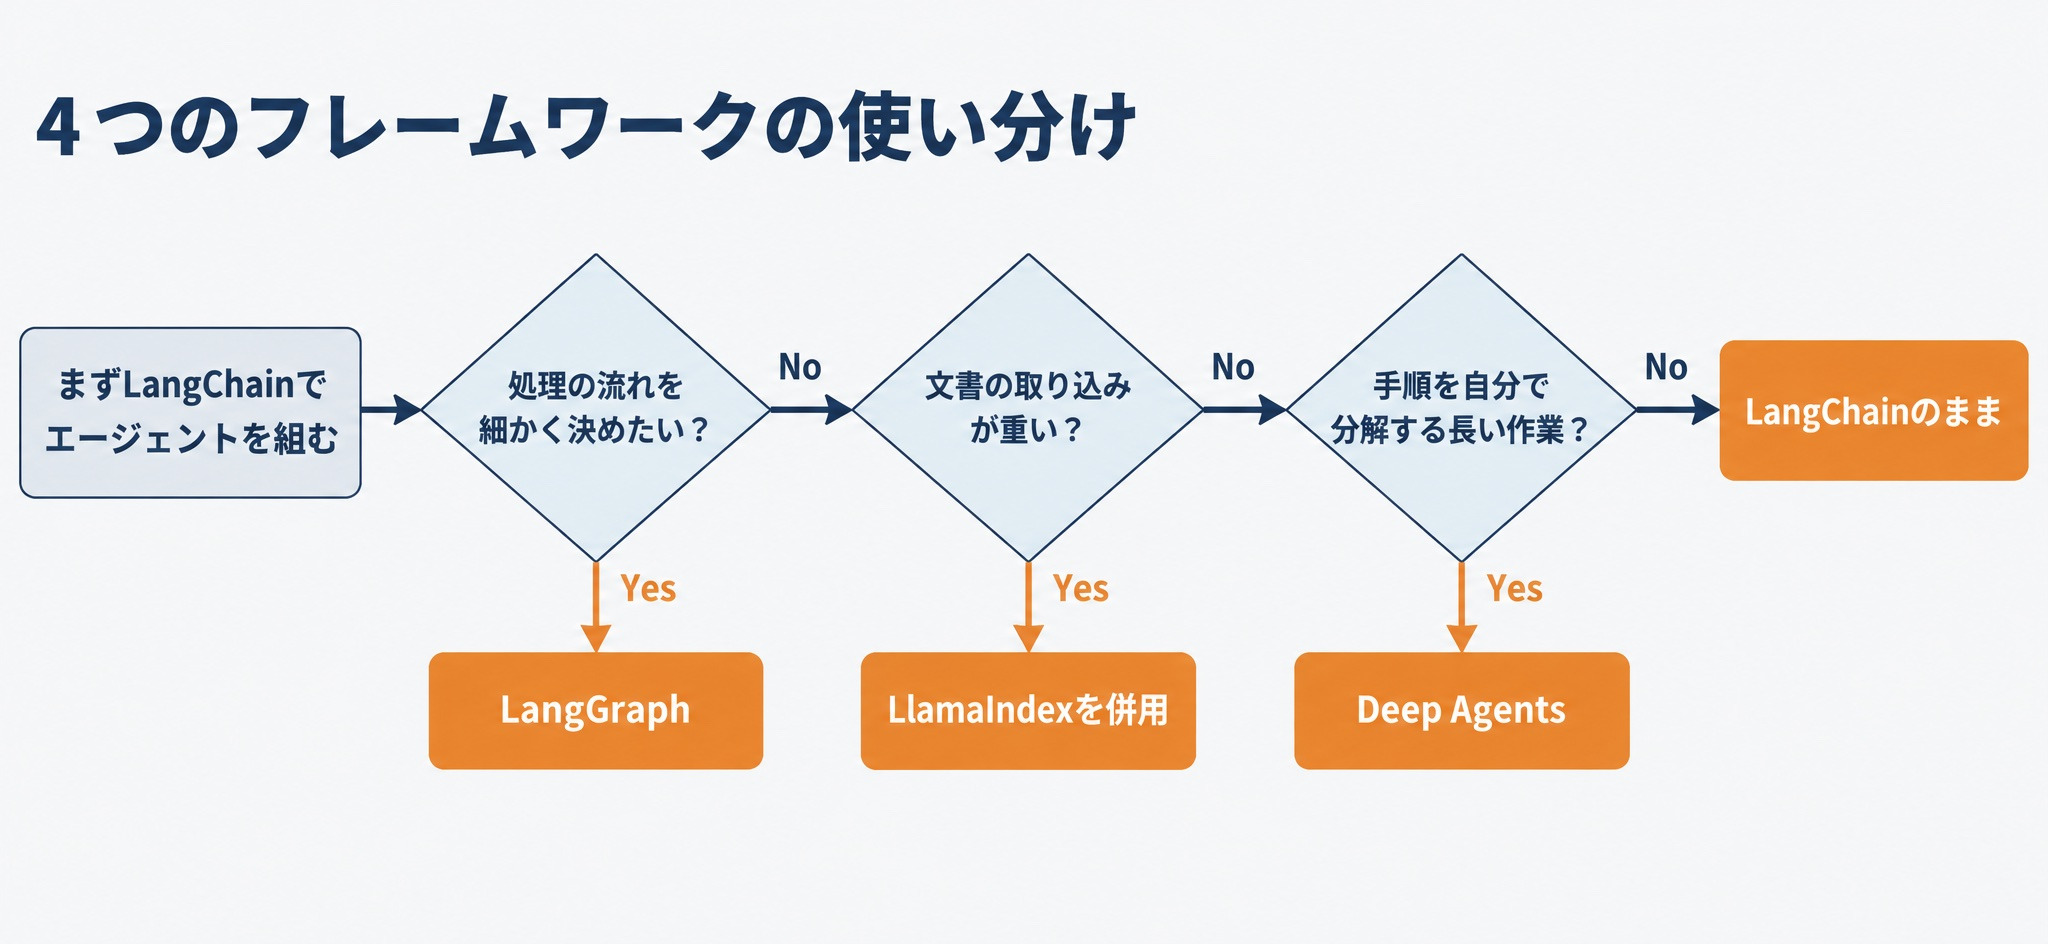
迷ったときは、まずLangChainの create_agent で動くものを作り、足りない点が見えてから層を移る進め方が無難です。
LangChainを使うべきでない4つの場面
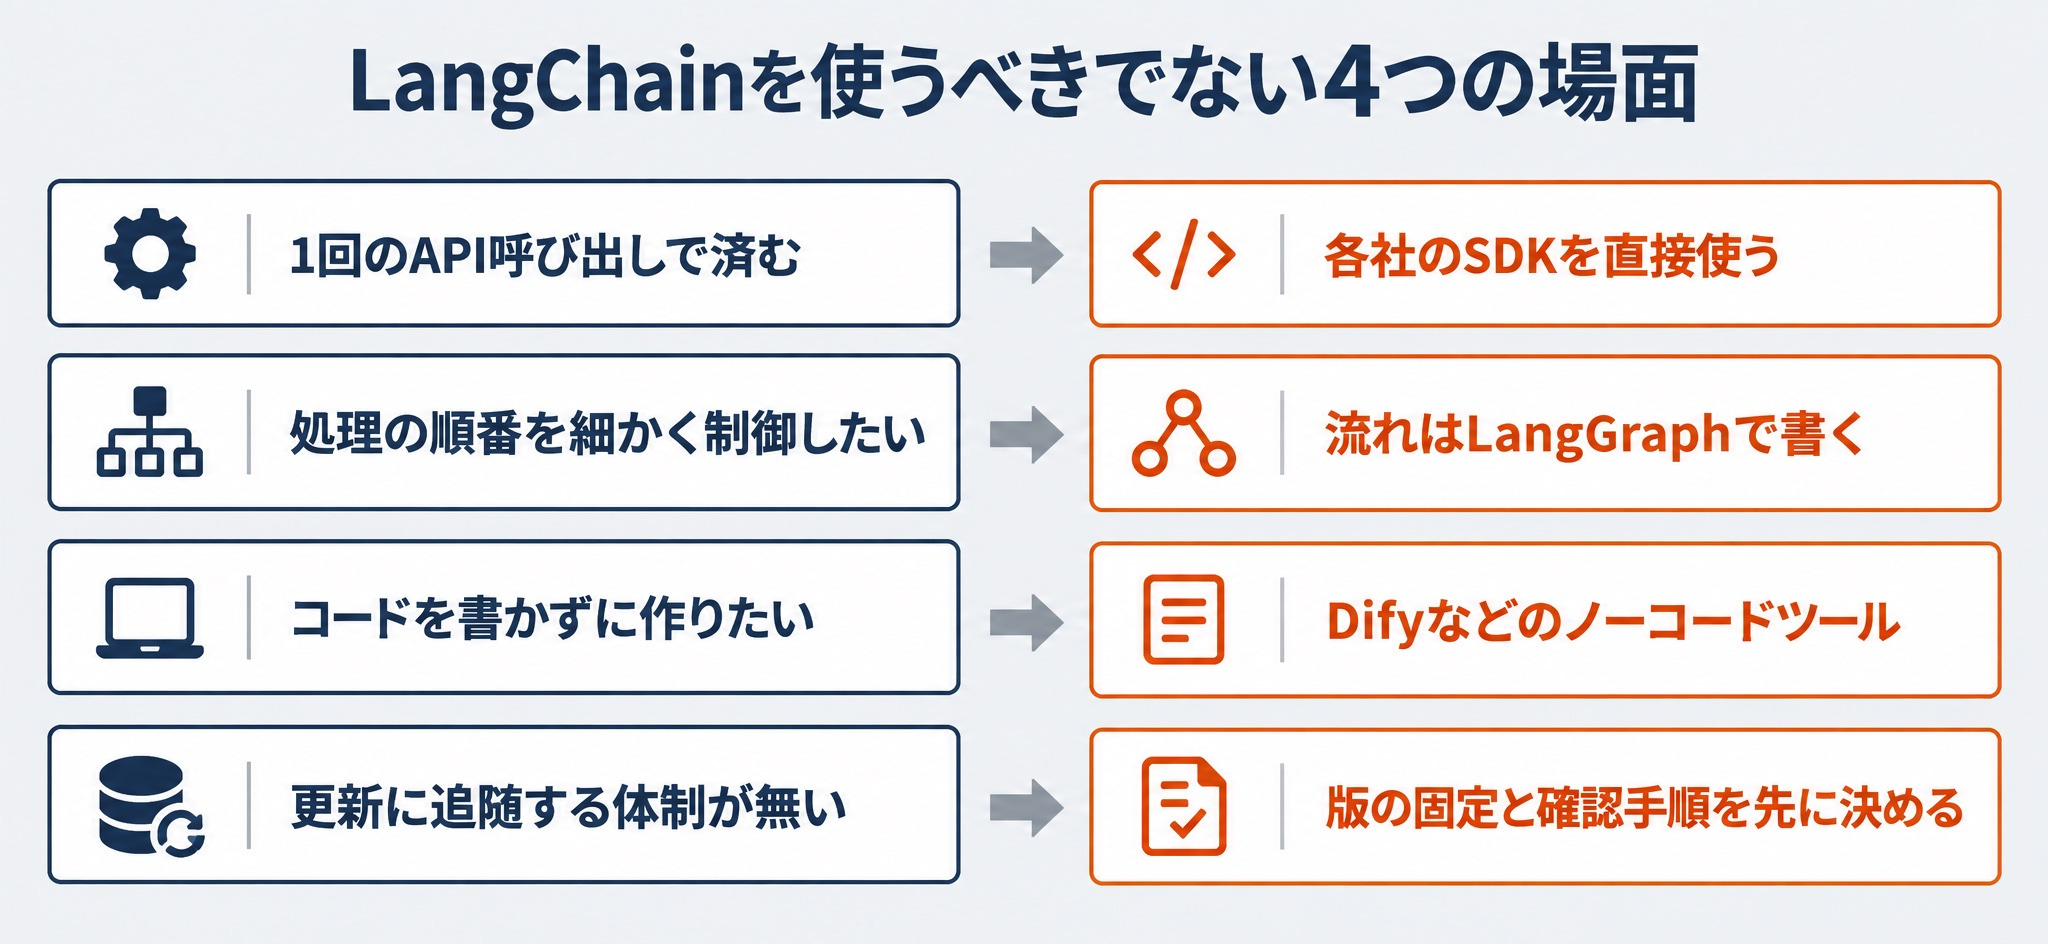
選び方の裏返しとして、LangChainを入れないほうがよい場面もあります。前の節までの公式の整理と実測を踏まえると、判断の分かれ目は次の4つです。
- 1回のAPI呼び出しで済む処理
- 処理の順番を固定して細かく制御したい処理
- コードを書かずに作りたい業務アプリ
- 依存と更新に追随する体制が無いプロジェクト
1回のAPI呼び出しで済む処理
要約や分類のように、決まったプロンプトでLLMを1回呼べば終わる処理には、各社が提供するSDKを直接使えば足ります。前述のとおり、langchain を入れると39個のパッケージが加わります。モデルを差し替える予定が無く、ツールもエージェントも使わないなら、この依存を抱える利点は小さいでしょう。
反対に、複数のモデルを比べる予定がある、あるいは将来エージェントに広げる予定があるなら、最初からLangChainで書いておく意味があります。
処理の順番を固定して細かく制御したい処理
「この順で確認し、この条件なら人に回す」といった業務手順が決まっている処理は、create_agent の繰り返しの形に収めにくくなります。LangChainの公式の整理でも、決まった手順とエージェント的な判断を組み合わせる処理にはLangGraphを使うよう案内しています。この場合はLangChainの部品を使いつつ、流れはLangGraphで書きます。
コードを書かずに作りたい業務アプリ
社内の問い合わせボットのように、画面の操作だけで作って運用担当者が直せる形にしたいなら、Difyのようなノーコードの開発ツールが向きます。LangChainはPythonやJavaScriptのコードを書く前提のフレームワークです。Difyでの作り方はDifyの使い方や特徴を徹底解説!環境構築からアプリ作成までで解説しています。
依存と更新に追随する体制が無いプロジェクト
LangChainは更新が速いフレームワークです。PyPIのリリース履歴を見ると、2026年6月23日から9月23日までの3か月で、langchainは14回、langchain-coreは13回の版を公開していました。この間にも、langchain-communityの終了が告知され、MCP対応の langchain.mcp はbetaのまま追加されています。
作って終わりではなく使い続けるシステムなら、次の3点を先に決めておきます。
- 使う版を requirements などに固定し、上げるときは差分を読んでから上げる
- langchain-community や langchain-classic に頼っている部分を洗い出し、移行先を決めておく
- 版を上げたときに、同じ質問集で回答や検索の結果が変わっていないかを確かめる手順を用意する
これを誰が担うかが決まらないまま採用すると、動かなくなったときに原因を切り分けられません。
LangChainの要点まとめ
- LangChainは、LLMアプリとAIエージェントを作るためのオープンソースのフレームワークで、2026年9月23日時点の最新版はlangchain 1.4.2です。Python 3.10以上が必要です
- v1では
create_agentとミドルウェアが中心になり、旧来のチェーンやリトリーバーはlangchain-classicへ移りました。langchain-communityは2026年5月に終了が告知されています - 主要な部品は、チャットモデル、プロンプトとチェーン、ツールとエージェント、ミドルウェア、検索の部品の5つです
- テスト用の
GenericFakeChatModelを使えば、APIキー無しでチェーンやエージェントの流れを確かめられます。ツール付きのエージェントではbind_toolsの上書きが要ります - RAGは読み込み、分割、埋め込みと保存、検索、生成の順に部品をつなぎます。今回の例では「ホテル代」の質問に「宿泊費」の行が類似度0.689で1位に来ました
create_agentの実体はLangGraphのグラフです。流れを細かく決めたいならLangGraph、文書の取り込みが重いならLlamaIndex、1回のAPI呼び出しで済むならSDKを直接使う、と用途で選びます
LangChainを使ったAI開発の相談は「リベルクラフト」へ
「LangChainで試作は動いたが、どの層まで使うべきか、本番でどう保守するかが決めきれない」と感じた方もいらっしゃるのではないでしょうか?
リベルクラフトでは、LLMを使ったAI開発の支援を、要件定義からPoC、本番運用まで一貫して行っています。モデルを後から選び直せる構成や、LangGraphを使ったワークフローの設計、社内文書を使ったRAGの検索精度の検証など、本記事で扱った判断を実際の業務データで一緒に進められます。
- 社内文書を検索して答えるRAGを、自社のデータで作りたい
- LangChainとLangGraphのどちらで組むべきかを、要件から決めたい
- 試作したエージェントを、監視や版の管理まで含めて本番に乗せたい
エンジニアとして実装を体系的に身につけたい方には、Agentic RAGやマルチエージェントを12週で実装するCraft College DS ADVANCEDもご用意しています。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。