Agentic RAGの実装方法。LangGraphでCorrective RAG・Self-RAGを構築する手順【Python】
「Basic RAGを実装してみたが、複雑な質問への精度に限界を感じている」「検索が1回では足りず、クエリを分解して再検索する仕組みが欲しい」という課題を抱えているエンジニア・データサイエンティストの方も多いでしょう。RAGは汎用的な仕組みですが、本番環境で使い込むほど単発検索の限界が顕在化します。
そこで本記事では、Agentic RAGの主要アーキテクチャ(Corrective RAG・Self-RAG・ReActループ型)を解説した上で、LangGraphを使ったCorrective RAGのPython実装、本番化の落とし穴と対策、RAGASによる品質評価フローまでを一気通貫で解説します。読み終える頃には、自分のRAGに「自律的な再検索ループ」を組み込む設計イメージが具体的につかめます。
LangGraphの基本については「LangGraph入門|グラフ型エージェント実装ガイド」を、RAGの活用事例については「RAG活用事例」を先にご覧いただくと、本記事の理解がより深まります。
⇨ Agentic RAG・LangGraph開発のご相談はリベルクラフトの無料相談へ
Agentic RAGとは?Basic RAGの限界から理解する
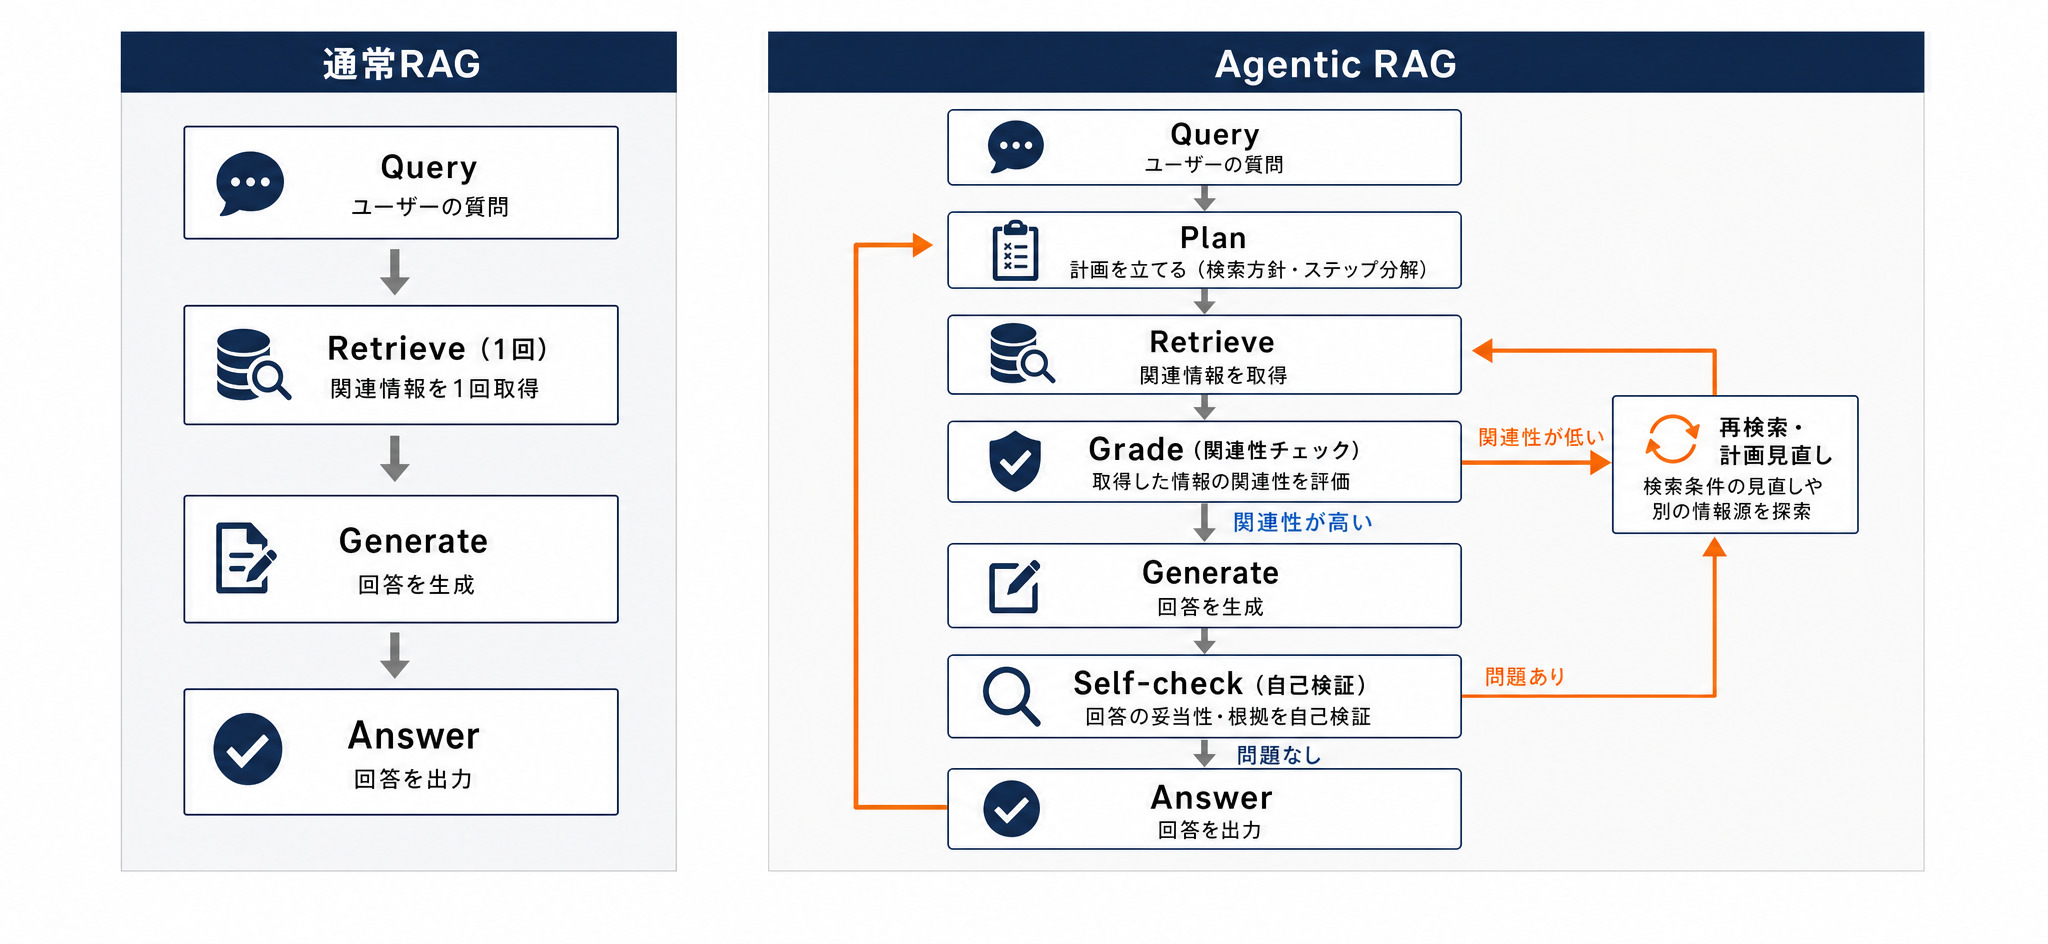
Agentic RAGとは、LLMをオーケストレーターとして配置し、検索・評価・再検索・生成を自律的にループさせるRAGの発展形です。Basic RAGが「1回の検索で得た文書をそのまま生成に使う」受動的な仕組みであるのに対し、Agentic RAGは「検索結果の品質を自己評価し、不十分であれば再検索する」能動的な仕組みを持ちます。
Native RAGが抱える4つの限界
Basic RAGを実装したことがある方なら、次のような課題に直面した経験があるはずです。
- シングルパス検索の限界:質問に対して1回だけベクトル検索を行い、得られたチャンクをそのまま使う。検索精度が低い場合でも手直しする機構がない
- クエリの曖昧さ:「最近の状況について教えて」のような抽象的なクエリは、意図と無関係なチャンクを取得してしまいやすい
- マルチステップ推論不可:「AとBを比較した上でCを判断して」という多段推論は、1回の検索・生成では完結しない
- 自己フィードバックなし:生成した回答の品質を評価する仕組みがなく、ハルシネーションが混入しても検知できない
これらの限界は、RAGを本番環境で使い込む段階になって初めて顕在化するケースが多いです。Agentic RAGはこれらの課題すべてをループ設計によって解決します。
Agentic RAGの定義と仕組み:Basic RAGとの比較表
Agentic RAGにおける最大の変化は、「検索を何度でも繰り返せること」と「その判断をLLM自身が行うこと」の2点です。
| 比較軸 | Basic RAG | Agentic RAG |
|---|---|---|
| 検索回数 | 1回(固定) | 1回以上(自律判断) |
| クエリ修正 | なし | Graderが不十分と判断すれば自動リライト |
| 自己評価 | なし | 取得文書・生成回答の両方を評価 |
| マルチステップ | 不可 | ループ設計で対応可能 |
| 実装難易度 | 低 | 中〜高(LangGraph等が必要) |
| APIコスト | 低 | 高め(評価・再検索の分が追加) |
精度を取るかコストを取るかは、ユースケースによって判断が必要です。単純な社内FAQ検索ならBasic RAGで十分ですが、技術仕様書への複雑な問い合わせや多段推論が必要なタスクではAgentic RAGの優位性が明確に出ます。
Agentic RAGの主要アーキテクチャパターン3選
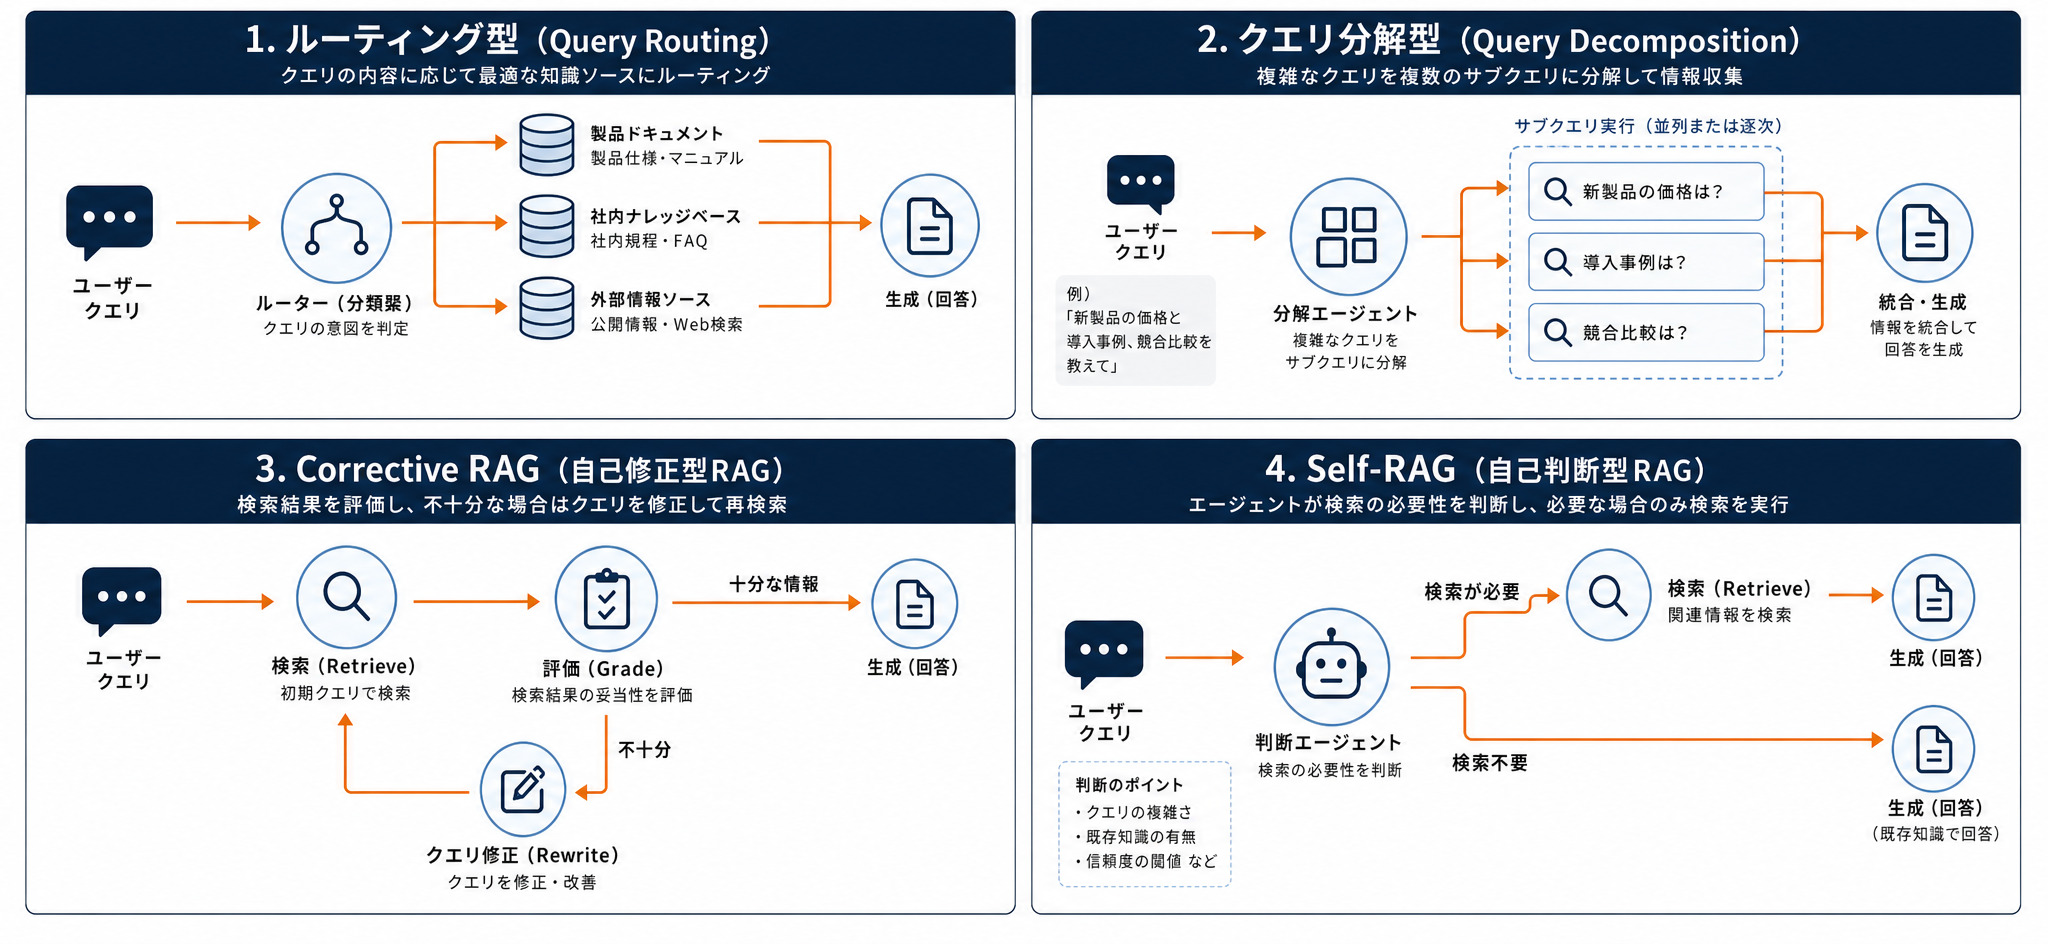
Agentic RAGには複数の設計パターンがあります。どのパターンを選ぶかはユースケースと精度要件によって異なります。実務でよく使われる3つを解説します。
Corrective RAG(CRAG):検索結果を自己評価して再検索する
Corrective RAGは、取得した文書の関連性をGraderノードで評価し、スコアが低ければクエリを書き換えて再検索するパターンです。フローは次の通りです。
Query → Retriever → Document Grader
  → [関連性あり: Generator → Answer]
  → [関連性なし: Query Rewriter → Retriever(再検索)]
最大の特徴はシンプルさです。ループを制御するロジックは「関連性の判断」だけであり、LangGraphによる実装との相性も良好です。本記事のH2-4でこのパターンを実装します。
Self-RAG:反復的自己評価で回答品質を担保する
Self-RAGは「必要なら検索する」「生成した回答を自己評価する」「根拠なき回答は棄却して再生成する」という3段階の自己修正ループを持つパターンです。
推論プロセスに埋め込まれた判断トークンが特徴です。「この質問には検索が必要か(Retrieve token)」「取得文書は質問に関連しているか(ISREL)」「回答は文書の内容に支持されているか(ISSUP)」「回答は質問に有用か(ISUSE)」という4種類の判断をLLM自身が行いながら推論を進めます。
ただし、この高度な自己評価にはモデルの推論能力が必要です。GPT-4oクラスのモデルで安定する実装であることを念頭に置いておく必要があります。
ReActループ型Agentic RAG:ツール呼び出しと推論を交互に繰り返す
ReActパターンは、LLMがReason(思考)とAct(ツール呼び出し)を交互に実行するフレームワークです。Agentic RAGに適用すると、Retrievalがツールの1つとして扱われます。
「まず関連文書を検索し(Act)、その内容を見て追加の情報が必要か判断し(Reason)、必要なら別のクエリで再検索し(Act)、十分な情報が揃ったら回答を生成する(Reason)」という流れを繰り返します。
LangGraphでのReActエージェント実装詳細は「LangGraph入門」のH2-3を参照してください。本記事ではRAGの文脈でReActを使う意味に絞って説明しました。
Single Agentic RAGとMulti Agentic RAGの違い
Agentic RAGはエージェントの構成によってSingle(単一)とMulti(複数)の2種類に分かれます。システム要件と目的に応じた使い分けが重要です。
Single Agentic RAGの構成と適用場面
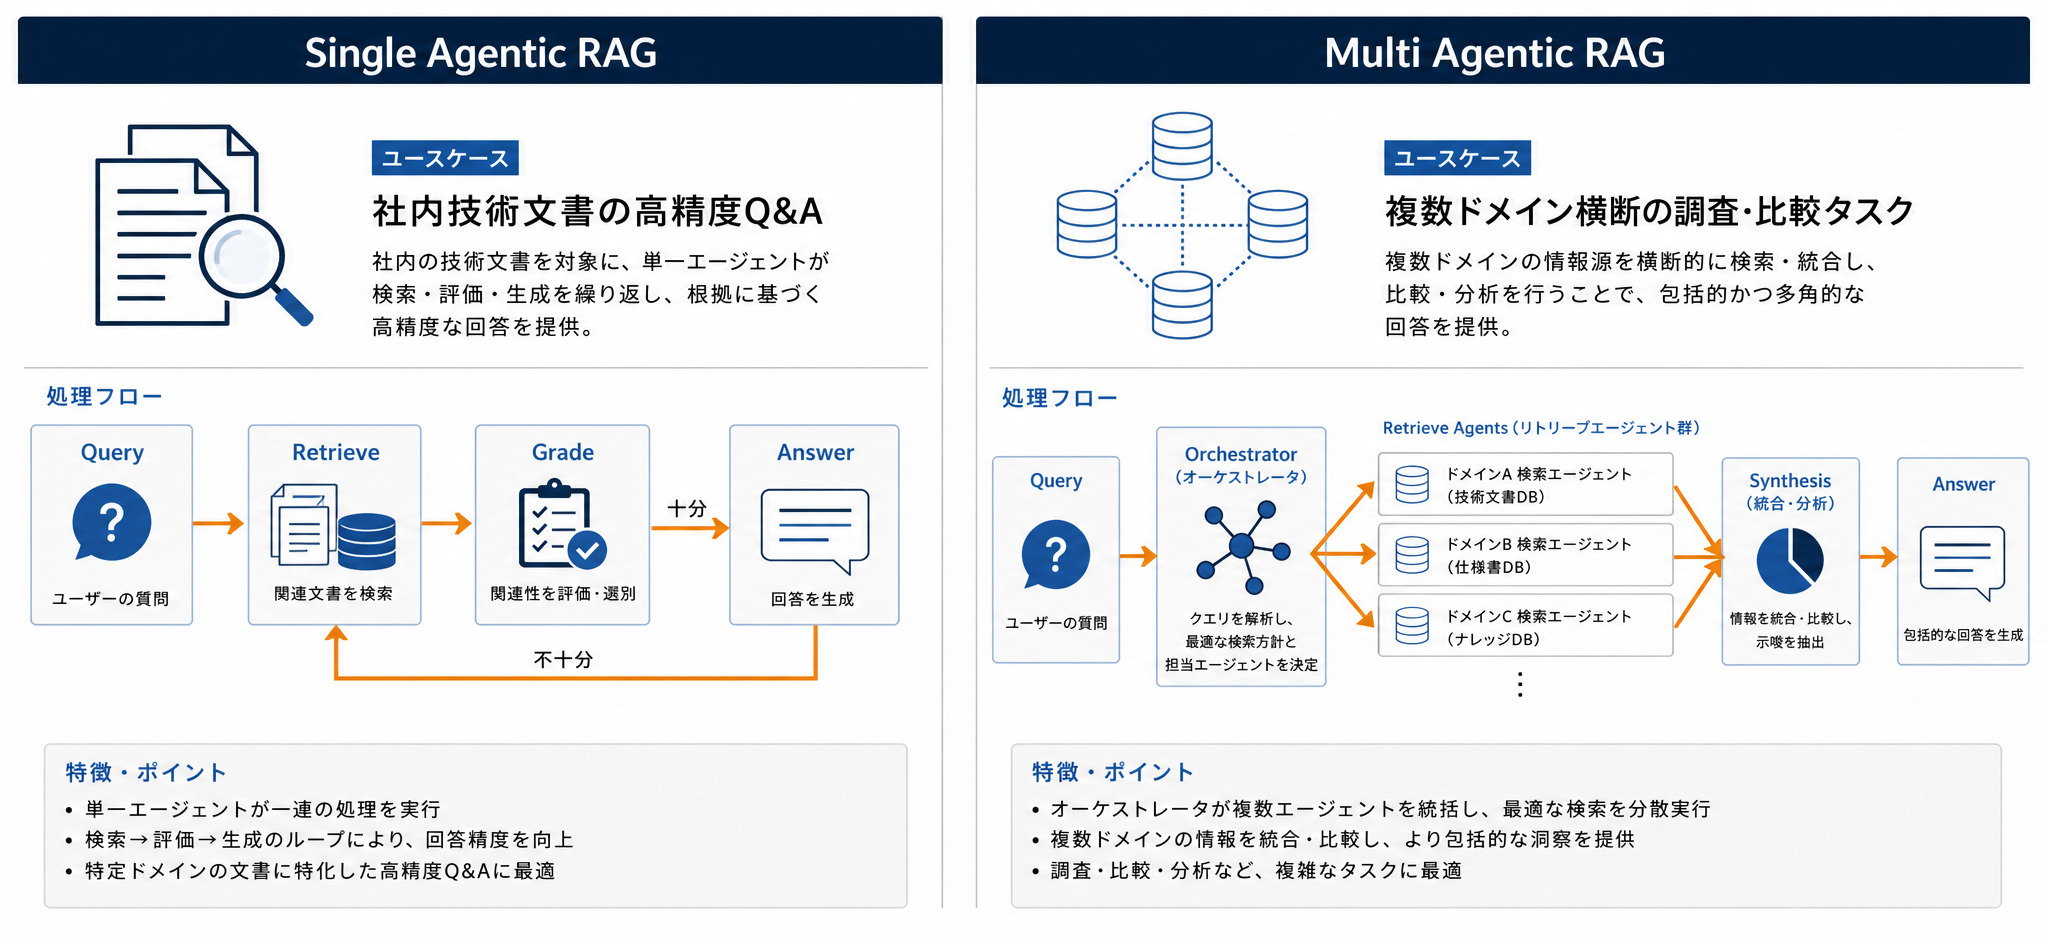
Single Agentic RAGは、1つのエージェントがRetriever・Grader・Generatorを一括制御する構成です。
- 特徴:設計がシンプル。状態管理・デバッグ・コスト管理がしやすい
- 適用場面:単一ドメインの質問応答(製品FAQ・技術仕様書・社内規定など)
- スケール:ドキュメント数が数万件程度までは十分対応可能
本記事のH2-4で実装するCorrective RAGはこの構成です。まず1エージェントで動く最小構成を作り、精度を確認してからMultiへ拡張する順序が現実的なアプローチです。
Multi Agentic RAGの構成とトレードオフ
Multi Agentic RAGは、SupervisorエージェントがドメインごとのWorkerエージェントに検索を委譲するパターンです。製品FAQエージェント・技術文書エージェント・社内規定エージェントがそれぞれのナレッジベースを検索し、Supervisorが統合して回答を生成するといった構成を取れます。
| 比較軸 | Single | Multi |
|---|---|---|
| 回答精度 | 単一ドメインで高い | 複数ドメイン横断で高い |
| コスト | 低 | 高め(エージェント分の追加呼び出し) |
| レイテンシ | 速い | 遅め(並列化で改善可能) |
| 実装難易度 | 中 | 高 |
| 保守性 | 高い | 要設計(エージェント間の依存管理が必要) |
Multi Agentic RAGの詳細な実装については「マルチエージェント実装ガイド」で解説しています。
LangGraphでCorrective RAGを実装する
ここからが本記事のメインセクションです。LangGraphを使ってCorrective RAGを実装する手順を解説します。
全体フローとグラフ設計の方針
実装前に、どのノードとエッジを設計するかを整理します。
START → retrieve → grade_documents
  → [relevance=yes: generate → END]
  → [relevance=no: rewrite_query → retrieve(ループ)]
必要なノードは4つです。
retrieve:クエリでベクトル検索し、チャンクのリストをStateに格納するgrade_documents:各チャンクの関連性を評価し、relevanceフラグを更新する(Corrective RAGの核心)rewrite_query:relevance=noのとき呼ばれ、元クエリをより具体的な検索クエリに書き換えるgenerate:関連文書をコンテキストに詰めて最終回答を生成する
また、grade_documentsの結果に応じてgenerateかrewrite_queryかに分岐する条件付きエッジがこのグラフの核心です。
環境構築とState定義
まずパッケージをインストールします。
pip install langgraph langchain-openai langchain-community chromadb tiktoken次に、グラフ全体で共有するStateクラスを定義します。
from typing import TypedDict, List

class RAGState(TypedDict):
    query: str            # 入力クエリ(書き換え後も更新される)
    documents: List[str]  # 取得チャンクのリスト
    generation: str       # 生成された回答
    relevance: str        # "yes" or "no"(graderの判定)
Agentic RAGのStateがBasic RAGと決定的に違うのは、relevanceフィールドの存在です。gradeノードがこのフィールドを更新し、条件付きエッジがこの値を読み取って分岐先を決めます。relevanceフィールドがCorrective RAGのループを成立させる設計上の核心です。
各ノードの実装:retriever・grader・rewriter・generator
4つのノードの役割と設計の考え方を説明します。実装は骨格のみ示し、詳細はユースケースに合わせて拡張してください。
retrieve:クエリでベクトル検索し、取得チャンクをdocumentsリストとしてStateに返します。ChromaDB・FAISS・PGVectorなどどのベクトルDBでも差し替え可能です。
grade_documents(Corrective RAGの核心ノード):各文書に対して「この文書は質問に答えるために有用か?yes/noで答えよ」というGraderプロンプトを呼び出します。関連ありの文書だけを残し、relevanceフラグを更新します。プロンプト設計がそのまま精度に直結するノードです。「ある程度の関連性があればyesを返す」という温度感に調整しないと、次節で説明する無限ループのリスクが上がります。実務上の重要な注意点として、全文書をループして評価するためtop_kを5以下に絞ることを推奨します。
rewrite_query:元クエリをLLMに渡し、「より具体的で検索しやすいクエリに書き換えてください」という指示で再解釈させます。質問が抽象的なほど効果が出やすいノードです。書き換えた新クエリでStateのqueryを上書きし、次のretrieveに渡します。
generate:関連文書のリストをコンテキストに詰め、最終回答を生成します。このノードはCorrective RAGでもBasic RAGと基本的な構造は変わりません。
グラフ組み立て・条件付きエッジ・実行
設計したノードをLangGraphのグラフに登録し、条件付きエッジで接続します。
from langgraph.graph import StateGraph, END

def decide_to_generate(state: RAGState) -> str:
    """grade_documents の結果に基づいて次のノードを返す"""
    if state["relevance"] == "yes":
        return "generate"
    return "rewrite_query"

# グラフ構築
workflow = StateGraph(RAGState)

workflow.add_node("retrieve", retrieve)
workflow.add_node("grade_documents", grade_documents)
workflow.add_node("rewrite_query", rewrite_query)
workflow.add_node("generate", generate)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
    "grade_documents",
    decide_to_generate,
    {"generate": "generate", "rewrite_query": "rewrite_query"}
)
workflow.add_edge("rewrite_query", "retrieve")  # 再検索ループ
workflow.add_edge("generate", END)

app = workflow.compile()
add_conditional_edges("grade_documents", decide_to_generate)がCorrective RAGの分岐ロジックの核心です。rewrite_query → retrieveのエッジが再検索ループを作っており、これがBasic RAGにない自律的な反復処理です。
動作確認はapp.stream()を使うと、各ノードを通過するたびにStateの変化がログとして確認できるためデバッグに便利です。ただし無限ループのリスクがあるためrecursion_limitの設定は必須です(次のH2-6で詳述)。
Agentic RAGをハンズオンで体系的に習得したい方へ
Craft College Advancedでは、Agentic RAG・LangGraph実装・マルチエージェントをハンズオン形式で学べるカリキュラムを提供しています。
Agentic RAGの活用事例:業務への適用パターン
Corrective RAGやReActループ型をどの業務に適用するかの実践的なパターンを紹介します。大企業事例ではなく「実装チームが現実的に取り組める規模」に絞りました。
社内技術文書への高精度質問応答(Corrective RAG適用)
技術仕様書・API仕様・社内開発ルールなど、長文かつ構造が複雑なドキュメントが多い環境では、Corrective RAGが効果を発揮します。単純なキーワードマッチングでは仕様の細部が取得できないケースが多く、Graderによる関連性評価と再検索ループが回答精度を底上げします。
ある製造業のお客様では、設計仕様書への問い合わせにCorrective RAGを適用した結果、1回の検索では取りこぼしていた仕様情報の取得率が改善し、エンジニアが仕様書を読み返す時間が大幅に削減されました。まずは社内に蓄積された技術ドキュメントのPoCから始めるのが取り組みやすい入口です。
マルチドメイン横断の調査・比較タスク(Multi Agentic RAG適用)
法規制文書・業界レポート・自社データなど、複数の独立したナレッジベースを横断して調査するタスクにはMulti Agentic RAGが有効です。「競合他社の動向と自社製品の比較」「法令改正が自社業務に与える影響の整理」のような、複数ソースを参照しながら答えを組み立てる質問は、Single RAGでは精度に限界があります。
ドメインごとにWorkerエージェントを割り当て、Supervisorが統合回答を生成する構成を取ると、各ナレッジベースに特化したチューニングが可能になります。
本番運用の落とし穴と対策
Agentic RAGは「動くPoCが作れた」段階から本番化するまでに、特有の落とし穴があります。競合記事ではほとんど扱われていない実装観点のポイントを3点まとめます。
無限ループ:Graderが常にNGを返し再検索を繰り返す
症状:rewrite_query → retrieve → grade_documents → rewrite_query → ...が終わらず、RecursionErrorまたは処理タイムアウトが発生する。
原因:①Graderプロンプトが厳格すぎて常にrelevance=noを返す、②ベクトルDB自体に質問への回答となる情報が存在しない。
対策:
app.invoke()のconfig={"recursion_limit": 5}でループ回数に上限を設ける(LangGraphの標準機能)- StateにRetryCountフィールドを追加し、閾値超過時に「関連情報が見つかりませんでした」というフォールバック回答を返すよう設計する
- Graderプロンプトに「ある程度の関連性があればyesを返す」という温度感を持たせ、完璧な一致を求めない
recursion_limitの設定は見落としがちですが、本番前に必ず確認してください。
コスト爆発:全チャンクをGraderで評価してしまう
症状:top_k=20で検索し、20チャンク分のGrader呼び出しを毎クエリ実行してしまい、API費用が想定の数倍に膨らむ。
対策:
top_kを5以下に絞る(通常3〜5で精度と費用のバランスが取れる)- GraderにGPT-4oではなく
gpt-4o-miniなど安価なモデルを使う - クロスエンコーダーや軽量な類似度スコアで事前フィルタリングし、Grader呼び出し回数を削減する
Corrective RAGのコストはBasic RAGの2〜5倍になるケースが多いです。PoC段階でコスト試算を行い、本番化判断の材料にすることを推奨します。
レイテンシ増大:検索・評価・再生成が直列で遅い
症状:Corrective RAGは最低3ステップ(retrieve → grade → generate)を経るため、Basic RAGより応答が1〜3秒遅くなる。再検索が発生するとさらに遅延が増す。
対策:
astream()でトークンをストリーミング出力し、UXの体感速度を改善する(回答が出始めるまでの待ち時間を隠す)- Graderを非同期バッチ処理にして複数文書の評価を並列化する
- LangGraph公式の
SendAPIでretrieve・gradeを並列実行する
レイテンシ許容値がシビアな用途では、Agentic RAGよりもハイブリッド検索+リランキングによるAdvanced RAGを選択する判断基準も持っておくことを推奨します。
Agentic RAGの品質評価:RAGASで定量測定する
「動いている」だけでは本番化の根拠になりません。RAGASを使った定量評価フローを整備することで、継続的な品質改善が可能になります。
Agentic RAGで監視すべき4つのRAGASメトリクス
全メトリクスを測る必要はありません。Agentic RAGに特に重要な4指標に絞って監視するのが現実的です。
| メトリクス | 意味 | 推奨閾値目安 |
|---|---|---|
| faithfulness | 回答がコンテキストに忠実か(ハルシネーション検知) | 0.85以上 |
| answer_relevancy | 回答が質問に適切に答えているか | 0.80以上 |
| context_precision | 取得チャンクに本当に必要な情報が含まれているか | 0.75以上 |
| context_recall | 必要な情報がチャンクに漏れなく含まれているか | 0.70以上 |
閾値はあくまで目安であり、ドメインや用途に応じて調整が必要です。「閾値はプロジェクトの実態値をベースに設定すること」という点は忘れずに念頭に置いてください。
LangGraphとRAGASを組み合わせた評価パイプラインの構成
LangGraphで実装したAgentic RAGの出力をRAGASで評価する最小パイプラインの流れは次の通りです。
app.invoke()の結果からquestion・answer・contexts・ground_truthの4フィールドを抽出する- HuggingFaceの
Dataset形式に変換する(RAGASが要求するフォーマット) ragas.evaluate()にfaithfulness・answer_relevancyを渡してスコアを取得する- スコアをログ・スプレッドシートに記録し、閾値割れの場合に原因を分析する
改善の方向性は「スコア→原因ノード→チューニング」の対応で整理できます。
faithfulnessが低い → Generatorプロンプトを修正し、コンテキスト外の情報を生成しないよう制約するcontext_precisionが低い → GraderのNGしきい値を下げるか、top_kを増やす
実際のコードはRAGAS公式ドキュメント(docs.ragas.io)のQuickstartが最も信頼できる一次情報です。
まとめ
本記事で解説した内容を整理します。
- Agentic RAGの本質:LLMをオーケストレーターとして検索・評価・再検索・生成をループさせるRAGの発展形。Basic RAGの「1回限り」の限界を自律的な反復で突破する
- 3つのアーキテクチャパターン:Corrective RAG(検索結果を評価して再検索)・Self-RAG(3段階の自己修正ループ)・ReActループ型(思考と行動の交互実行)をユースケースで使い分ける
- LangGraphでの実装ポイント:StateにRelevanceフィールドを持たせ、
add_conditional_edgesで再検索ループを制御する。recursion_limitの設定は必須 - 本番化の3大落とし穴:無限ループ(
recursion_limitで対処)・コスト爆発(top_k絞り込みと安価Graderモデル)・レイテンシ増大(ストリーミングと並列化) - 品質評価:RAGASのfaithfulness・answer_relevancyを閾値監視し、スコア→原因ノード→チューニングのサイクルで継続改善する
まず取り組む第一歩としては、Corrective RAGの最小構成(Grader 1つ・top_k=3・recursion_limit=5)を動かし、RAGASで初期スコアを測ってから本番化の判断をする流れをお勧めします。
LangGraphの基本からやり直したい方は「LangGraph入門」を、マルチエージェント構成に発展させたい方は「マルチエージェント実装ガイド」をご覧ください。
Agentic RAG・LangGraph実装の相談は「リベルクラフト」
リベルクラフトでは、Agentic RAG・LangGraphを活用したAI開発の支援実績があります。「社内ドキュメントへの高精度な質問応答を作りたい」「Basic RAGで精度に限界を感じている」という方は、まずは現状の課題をお気軽にご相談ください。Craft College Advancedのカリキュラム(Agentic RAG・LangGraph・マルチエージェントをハンズオンで学べる内容)もご用意しています。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。