ナレッジ管理とは?AI時代に差がつく社内知識の活用と整備の進め方
「ChatGPTを導入したのにAIの精度が上がらない」「ベテラン社員が退職したら業務が止まりそうだ」と感じている方も多いでしょう。
しかし、どちらの課題もAIツールを追加するだけでは解決しません。根本にあるのは、社内のナレッジが整備されていないことです。そこで本記事では、
- ナレッジ管理の定義とSECIモデルの仕組み
- AI時代にナレッジ管理が特に重要な理由
- 具体的な進め方の4ステップ
- AIをナレッジ管理に組み込む3つのアプローチ
についてデータサイエンティストの視点で解説します。DX推進やAI活用の次の一手を探しているご担当者の方は、ぜひ最後までご覧ください。
ナレッジ整備とAI活用を合わせて推進したいという方は、リベルクラフトへご相談ください。 ⇨リベルクラフトへの無料相談はこちら
ナレッジ管理とは
ナレッジ管理とは、組織の中に散在する「業務で役立つ知識・ノウハウ」を体系的に収集・整理・共有・活用する仕組みのことです。単なるマニュアル整備や情報共有ツールの導入に留まらず、組織全体でナレッジを循環させ、業務に活かし続けることを目的とします。
特に近年は、ChatGPT等の生成AIが急速に普及したことで、「社内のナレッジをAIに読み込ませて活用する」ニーズが高まっています。ナレッジ管理は単なる情報整理の話ではなく、AI時代の競争力の基盤として重要性を増しています。
データ・ナレッジ・ノウハウの違い
ナレッジ管理を正しく理解するために、まず混同されやすい基本用語を整理します。
| 用語 | 意味 | 具体例 |
|---|---|---|
| データ | 事実をデジタル化したもの。それ自体では業務判断には使いにくい | 売上数値・アクセスログ・顧客リスト・センサー計測値 |
| ナレッジ(形式知) | 業務で使える形に変換・言語化された知識 | 成功事例集・マニュアル・過去の提案書・FAQ |
| 暗黙知・ノウハウ | ベテランの頭の中にあり、まだ言語化されていない経験知 | 熟練工のカン・営業担当の判断基準・長年培ったトラブル対応の勘所 |
ナレッジ管理のポイントは、この「暗黙知(ノウハウ)」をいかに形式知(ナレッジ)に変換し、組織全体で活用できる状態にするかです。ベテランしか知らない情報が組織に共有されていない状態は、退職リスク・引き継ぎ失敗・業務品質のばらつきに直結します。
SECIモデル:暗黙知を組織全体で循環させる仕組み
ナレッジ管理を語る上で欠かせないのが、知識経営の第一人者である野中郁次郎・竹内弘高が1995年に提唱した「SECIモデル」です。SECIとは、Socialization(共同化)・Externalization(表出化)・Combination(連結化)・Internalization(内面化)の頭文字で、知識が組織の中でどのように生まれ・広がっていくかを4段階で示します。
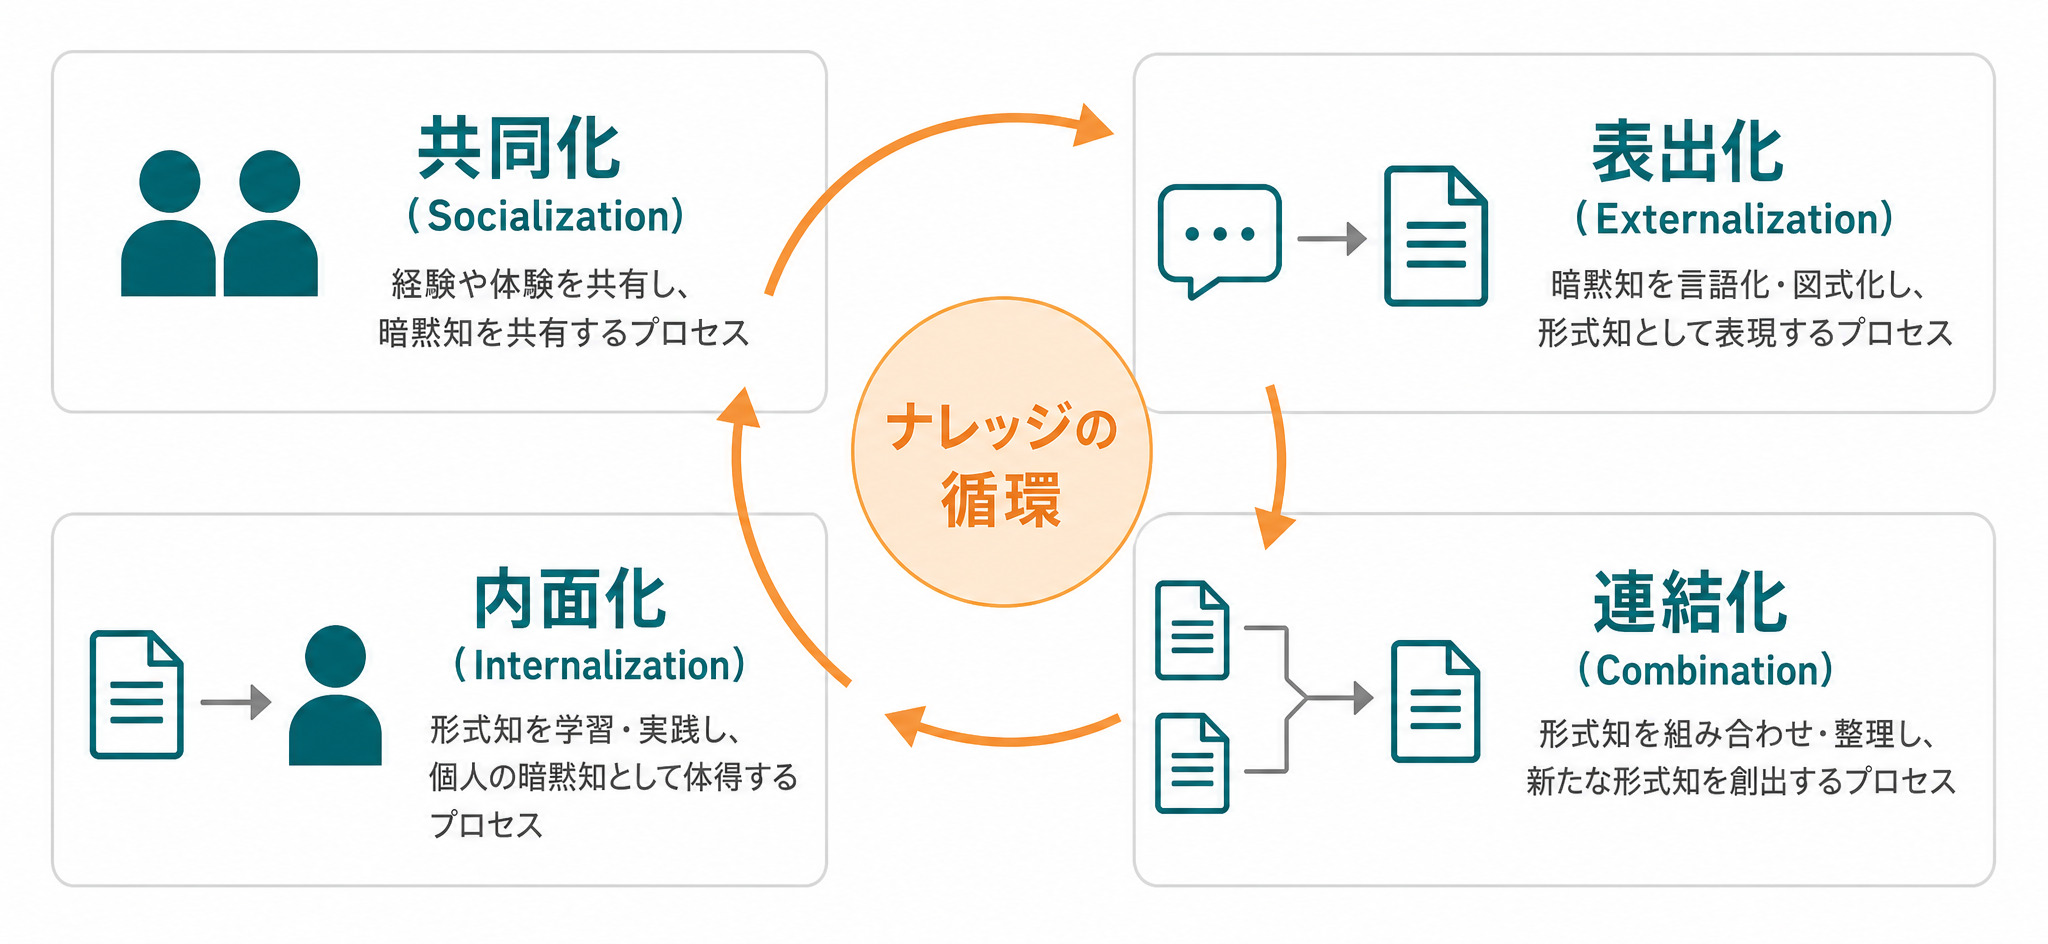
- 共同化(Socialization):ベテランと新人が一緒に作業することで、暗黙知が経験として伝わる段階。OJT・現場での見習いがこれにあたります。
- 表出化(Externalization):暗黙知を言語化・文書化し、形式知に変換する段階。マニュアル作成・ヒアリングによる事例集の編纂がこの活動です。
- 連結化(Combination):個々の形式知を組み合わせ、新しいナレッジを生み出す段階。複数の報告書を統合してノウハウ集を作ったり、部門をまたいだ知識を結び付けたりするイメージです。
- 内面化(Internalization):形式知を実践を通じて吸収し、個人の新たな暗黙知となる段階。マニュアルを読んで実際に動かしてみることで身についていくプロセスです。
このサイクルが組織の中で繰り返されることで、ナレッジが継続的に蓄積・進化していきます。ナレッジ管理とは、このSECIサイクルを組織として意図的に回し続ける取り組みといえます。
ナレッジマネジメント・ナレッジベースとの違い
「ナレッジマネジメント」や「ナレッジベース」といった言葉と混同されることがありますが、それぞれ異なるレイヤーの話です。
- ナレッジマネジメント:SECIモデルを含む、組織的な知識創造・活用の経営理論・概念全体を指す言葉。野中・竹内の理論に代表される学術的・経営戦略的な文脈で使われます。
- ナレッジ管理:業務現場で実務的に知識を整理・共有する実践活動を指すことが多い表現です(本記事はこの実務的な意味で使用しています)。
- ナレッジベース:ナレッジを蓄積・検索できるデータベースやシステムのこと。Notion・SharePoint・Confluence等のツールがナレッジベースとして機能します。
AI時代にナレッジ管理が重要な理由
ナレッジ管理の定義・意味を押さえたところで、「なぜ今この時期に特に取り組む必要があるのか」を説明します。AI活用が急速に広がる現在だからこそ、社内ナレッジの整備が競争優位の分岐点になっています。
「隣の会社も同じAIを使っている」時代の現実
ChatGPT・Claude・Copilotといった汎用AIは、月額数千〜数万円で誰でも利用できます。同じツールを同じプロンプトで使えば、得られる回答の質は同水準です。
つまり、汎用AIの知能はすでに社会に広く共有されており、「AIを導入した」だけでは競合との差は生まれません。差がつくのは「自社ならではの情報」との掛け算です。
自社の事例・ノウハウ・製品知識・顧客データをAIに正しく参照させることで、初めて「自社専用のAI活用」が実現します。「隣の会社と同じAIでも、自社データを持っているリベルクラフトのAIのほうが自社業務に詳しい」という状態を作ることが、AI時代の競争優位の源泉です。そのための前提が、社内ナレッジの整備にほかなりません。
AIが知らない2つの情報:学習時点以後と社内の非公開情報
汎用AIが答えられない情報には、構造的に2つの種類があります。
① 学習データのカットオフ以後の情報
ChatGPT等のAIモデルは、ある時点のデータで学習を打ち切っています。それ以降に起きたこと(新製品のリリース・最新の法改正・直近の市場動向・自社の新しい取り組み等)はAIは知りません。Web検索機能付きのAIでも「検索して補完している」に過ぎず、常時学習し直すわけではありません。自社の最新情報を正確に答えさせるには、自社で情報を提供する仕組みが必要です。
② 社内の非公開情報
社内マニュアル・過去の提案書・クレーム対応の事例・設計図面・会議の議事録・商談記録など、インターネット上に公開されていない情報は、汎用AIが学習していません。どれだけ高性能なAIを使っても、これらは「知らない」状態です。これが「社内でAIを使ってみたが業務に使える回答が返ってこない」の主な原因です。
ハルシネーションが起きる構造と、ナレッジ管理による対策
AIが誤った情報を自信をもって答えてしまう現象を「ハルシネーション(幻覚)」と呼びます。ハルシネーションは、AIが正しい情報を持っていないまま回答しようとするときに起きやすいことが、OpenAI等の研究で指摘されています。
言語モデルは「わからない」と答えるより「それらしい回答を生成する」方向に最適化されている面があります。正確な情報基盤が与えられていないほど、この傾向は強まります。
社内ナレッジを整備してAIに正確な情報を参照させることは、ハルシネーション対策にも直結します。正しいナレッジ基盤を持つAIは、根拠に基づいた回答を返しやすくなり、「自信満々の誤回答」のリスクを下げられます。ナレッジ管理とAI精度向上は、切り離せないテーマです。
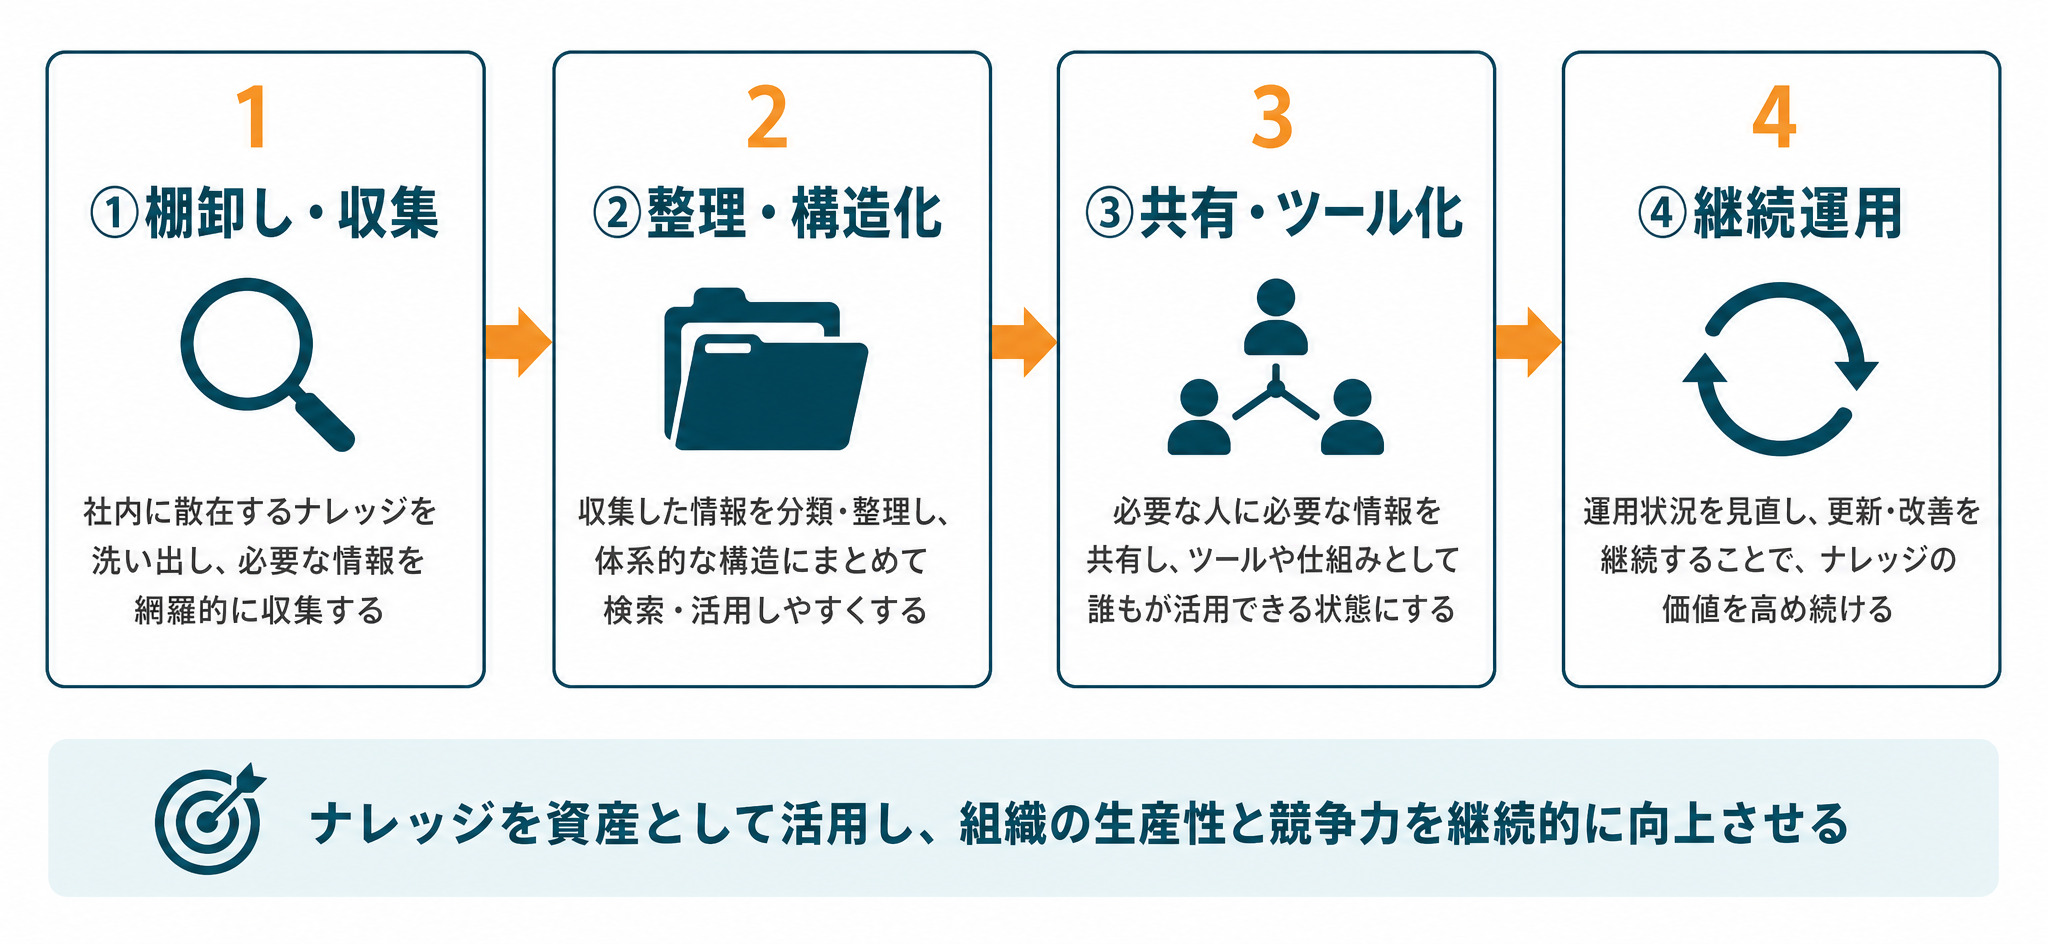
ナレッジ管理の進め方:4つのステップ
ナレッジ管理が必要な理由が分かったところで、具体的にどう進めるかのステップに入ります。全社一斉に始める必要はありません。インパクトの大きい領域から小さく始めて、徐々に広げていくアプローチが現実的です。
ステップ1. 社内のナレッジを棚卸し・収集する
最初にやることは「社内のどこに何があるか」を把握することです。担当者・部署・業務領域ごとに散在しているナレッジを洗い出します。
始める順序:属人化が激しい部署・退職リスクの高い担当者・業務インパクトの大きい工程から優先します。全部署を一度に対象にすると動かなくなるため、まず1〜2部門で実績を作ることを推奨します。
収集対象の例:
- ベテラン社員への構造化インタビュー(「どういうときに問題が起きるか」「どう判断しているか」)
- 過去の報告書・提案書・クレーム対応の記録
- 既存のマニュアル・手順書(整備されているものも棚卸しの対象)
- 社内Wikiや共有フォルダに既に入っているドキュメント
- 業務メールやチャットの中の有用なやり取り(Slack・Teams等)
収集の段階では、完璧な形式でなくて構いません。まず「何があるか」を可視化することが目的です。
ステップ2. 業務で使える形に整理・構造化する
収集したナレッジを、実際に業務で検索・参照できる形に整えます。このステップが後工程の品質を左右する最重要フェーズです。
整理のポイント:
- タグ・カテゴリを設計して分類する:タグ設計は後工程の検索性に直結します。「誰が・どんな場面で・何を調べるか」を想定して設計します
- 粒度を揃える:1ドキュメントに1テーマを原則にします。長すぎる文書は実際には参照されません
- テキスト化を優先する:PDFやスキャン画像より、全文検索できる形式(Word・Google Doc・Notion等)で保存します。AI活用を見据えると特に重要です
- メタ情報を付ける:作成者・作成日・対象業務・バージョンを必ず記録します。鮮度管理と信頼性評価のために不可欠です
特にAIとの連携を想定している場合は、この構造化が精度を決定的に左右します。情報が断片的・非構造的なままでは、AIは正確に参照できません。
ステップ3. 全員が参照・更新できる仕組みで共有する
整理したナレッジを、誰でも検索・参照でき、必要に応じて更新もできるナレッジ管理ツールで共有します。ツール選定は組織の規模・既存環境・予算によって異なります。
主なナレッジ管理ツールの比較:
| ツール | 特徴 | 向いているケース |
|---|---|---|
| Notion | 柔軟なページ構造・データベース連携・検索性が高い | スタートアップ・中小企業・部門単位の導入 |
| SharePoint(Microsoft 365) | 権限管理が細かい・Teams・Copilotとの連携が強み | Microsoft環境の中堅・大企業 |
| Confluence(Atlassian) | Jiraと連携・エンジニアチームでの人気が高い | エンジニア組織・IT企業 |
| Google Drive+Docs | Google WorkspaceのGeminiとシームレスに連携 | Google環境の企業・コスト優先 |
ツール選定よりも重要なのは「全員が実際に使う」ための設計です。特定の人しか編集できない仕組みにすると更新が滞る原因になります。部門ごとのアクセス権の設計と、更新フローの明確化をセットで考えます。
生成AIの活用事例については「生成AI活用事例30選:製造業・金融・公共機関の具体例」も参考にしてください。
ステップ4. AI活用も見据えて継続的に運用する
整備したナレッジは、一度作れば終わりではありません。業務が変われば内容も変わるため、定期的な棚卸しと更新が必要です。また、AI活用を見据えた場合、ナレッジの鮮度と品質が直接AIの回答精度に影響します。
継続運用のポイント:
- 更新のトリガーを事前に定義する(新しい事例が出たとき・社内ルールが変わったとき・四半期ごとの棚卸し等)
- ナレッジオーナー(部門ごとの管理責任者)を設置し、更新の責任を明確にする
- 定期的に「使われているか」を確認し、アクセスのないコンテンツは削除・統合する
- AI連携後は「AIが誤答しているケース」から逆引きで不足ナレッジを補充するサイクルを作る
ここまでナレッジ管理の進め方を解説しましたが、「自社のナレッジを整備してAIに読み込ませたいが、どこから手を付ければよいかわからない」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、社内ナレッジの棚卸し・構造化設計からRAGシステムの構築まで一気通貫で支援が可能です。ただ構築するだけでなく、自社の業務フローに合わせたナレッジ更新ルールの設計まで伴走できるため、「構築したが使われない」というリスクを最小化した導入が可能です。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
AIをナレッジ管理に組み込む3つのアプローチ
4ステップで整備したナレッジを、次にどうAIと組み合わせるかを説明します。「AIとナレッジ管理の連携」といっても、組織の規模・目的・IT環境によって適切なアプローチは異なります。弊社での支援経験をもとに、3段階に整理しました。
社内AIを活用した業務改善の全体像については「社内AIの導入方法と実践事例」も参考にしてください。
アプローチ1. ファイル渡し型(NotebookLM・Copilot等)
社内文書(PDF・Word・スプレッドシート等)をAIツールに直接読み込ませて質問に答えさせる方法です。Google のNotebookLMやMicrosoft Copilotの「ファイルアップロード機能」がこれにあたります。
特徴と向いているケース:
- 初期コストが低く、すぐに試せる
- プロジェクト単位・個人のナレッジ活用に適している
- ファイルのアップロードが手動のため、全社共通での精度保証には向かない
- 「まずは試してみたい」「特定部門でパイロット的に動かしたい」フェーズに最適
一方、全社で同一精度を担保したい・アクセス権や更新を自動化したいという場合は、次のアプローチが適しています。
アプローチ2. ワークスペース連携型(Microsoft 365・Google Workspace)
Microsoft 365(Copilot for Microsoft 365)やGoogle Workspace(Gemini for Workspace)を通じて、SharePoint・Drive・メール・Teamsの情報にAIがアクセスできる形です。
特徴と向いているケース:
- 既存のファイルサーバーやコミュニケーションツールとシームレスに連携できる
- 個別にファイルをアップロードする手間がなく、情報の鮮度が保たれやすい
- 権限設定により、見せてよい情報だけをAIに参照させられる
- Microsoft 365またはGoogle Workspaceをすでに全社で使っている企業に向く
ただし、社内の文書整理が不十分な状態でAI検索を有効化すると、古い情報や関係のないドキュメントも参照されてしまう問題が起きます。アプローチ1・2どちらを選ぶ場合でも、ステップ1〜3での整理は前提として必要です。
アプローチ3. 自社ナレッジ基盤型(RAGシステムの構築)
社内専用のRAG(Retrieval-Augmented Generation)システムを構築し、自社ナレッジベースをAIの参照源として整備する方法です。3つのアプローチの中で最も本格的かつ、精度・セキュリティの面で優れています。
特徴と向いているケース:
- 全社共通で同一精度のAI回答が得られる
- ナレッジの更新が自動でAIに反映される設計にできる
- 外部クラウドに社内データを渡さずに完結できる(オンプレミス・プライベートクラウド対応)
- 業種・業務に特化したチューニングが可能
- AI活用を本格的に組織戦略に組み込みたい企業向け
弊社が支援したある製造業のお客様では、設計部門の暗黙知(ベテランエンジニアの判断基準・過去の設計事例・トラブル対応の事例集)をRAGシステムで参照可能にしました。新入社員でも経験年数に関わらず設計判断の参考情報を引き出せる環境が整い、属人化解消と技術継承の両方を同時に実現した事例です。
RAGを活用した社内データ連携の詳細については「RAGで社内データを活用する方法」をご覧ください。
3アプローチの比較:
| アプローチ | 初期コスト | AI精度の安定性 | 全社展開 | セキュリティ |
|---|---|---|---|---|
| ファイル渡し型 | 低 | 中(更新は手動) | 難しい | ツール依存 |
| ワークスペース連携型 | 中(ライセンス費) | 中〜高 | しやすい | 比較的高い |
| 自社ナレッジ基盤型(RAG) | 高 | 高(自動更新可) | しやすい | 高い |
「まず小さく始めたい」ならアプローチ1・2から、「本格的なAI活用を組織の競争力にしたい」ならアプローチ3が適しています。組織の現状に合わせて段階的に移行していくことが現実的な道筋です。
ナレッジ管理を定着させるための注意点
アプローチを選んだ後、実際に定着させるために気をつけるべき点を整理します。多くの組織がつまずくポイントは共通しています。
「ツール導入で止まる」DXと同じ轍を踏まない
DX(デジタルトランスフォーメーション)の本来の意味は「データとデジタル技術を活用して業務プロセスや組織文化を変革し、競争優位を確立すること」です。しかし実際には、「ITツールを入れた」だけで業務が変わらないまま終わっている企業が少なくありません。
ナレッジ管理でも同じパターンが起きます。「Notionを導入した」「SharePointにフォルダを作った」だけで誰も使わなければ意味がありません。ツール導入の直後だけ盛り上がり、3か月後には誰も更新していないという状況は、ナレッジ管理でよく見られる失敗事例です。
重要なのは、ツールの導入よりも「業務の中でナレッジを更新・参照することが当たり前になる」組織文化の醸成です。AI活用を本格的に進めるAX(AIトランスフォーメーション)を目指す場合も、ツール選定より先に「誰が・どのタイミングで・どのようにナレッジを更新するか」を決めることが先決です。
更新ルールと担当者を最初に決める
ナレッジ管理が失敗する最も多い原因は「誰も更新しない」ことです。立ち上げ時は整理されていても、業務の変化とともに古いナレッジが放置されます。更新ルールを後から決めようとすると、そのタイミングで誰も動かないことが多いため、立ち上げと同時に決める必要があります。
立ち上げ時に決めておくべき4つのこと:
- ナレッジオーナーの設置:部門ごとに管理責任者を1名以上設け、「この領域はこの人が管理する」を明確にする
- 更新のトリガー定義:「新しい事例が出たとき」「社内ルールが変わったとき」「四半期ごとの棚卸し時」など、いつ更新するかを事前に決める
- 更新フローの設計:誰がどのように追記・修正するか、レビューが必要かどうかを決める
- 削除・アーカイブのルール:古くなったナレッジをどのタイミングで整理するかを定める
この4つをドキュメント化し、ナレッジ基盤の中に「ナレッジ管理のナレッジ」として置いておくと、新しく担当者が変わっても引き継ぎやすくなります。
検索性と鮮度を両立させる設計
ナレッジが増えると「多すぎて探せない」問題が発生します。タグ設計・カテゴリ構造・全文検索の組み合わせで検索性を担保しつつ、鮮度を保つための仕組みも同時に設計する必要があります。
鮮度管理の実践例:
- 各ドキュメントに「最終更新日」と「次回レビュー予定日」を記載する
- 1年以上更新されていないコンテンツを定期棚卸しで確認し、削除・統合・更新を判断する
- AI参照用のナレッジベースは、古い情報が混在しないよう「有効ドキュメント」の範囲を管理する
ナレッジの鮮度はAI精度に直結します。古い情報を参照したAIは古い回答を返します。「整備したが古くなって誰も使わなくなった」という状態が最も費用対効果を下げるため、鮮度管理は最初から設計に組み込むことを推奨します。
まとめ
本記事のポイントを整理します。
- ナレッジ管理とは:暗黙知を形式知に変換し、組織全体で活用できる状態を維持する仕組み。SECIモデル(共同化→表出化→連結化→内面化)が理論的な基盤
- AI時代に特に重要な理由:汎用AIはみんなが同じものを使える時代で、差がつくのは自社ナレッジとの掛け算。AIが知らない2つの情報(学習カットオフ以後・社内非公開情報)を補い、ハルシネーション対策にもなる
- 進め方の4ステップ:①棚卸し・収集 → ②整理・構造化 → ③共有の仕組み化 → ④継続運用。小さく始めてインパクトの大きい領域から先行する
- AIとの連携3アプローチ:ファイル渡し型(手軽・パイロット向け)→ ワークスペース連携型(既存環境活用)→ 自社ナレッジ基盤型・RAG(本格的・高精度・高セキュリティ)の段階がある
- 定着のカギ:ツール導入で止まらず、更新ルール・ナレッジオーナー設計・検索性と鮮度管理を立ち上げ時から決める
自社のナレッジ管理・AI活用は「リベルクラフト」へ
「社内のナレッジが属人化しており、退職が怖い」「AIを導入したが精度が上がらず、社内情報との連携方法がわからない」「ナレッジ基盤を整備してAI活用を本格化したいが、何から始めればよいかわからない」という方は、ぜひリベルクラフトにご相談ください。
弊社では、ナレッジの棚卸し・構造化設計から、RAGを活用した自社ナレッジ基盤の構築まで、コンサルティングと技術実装を一気通貫で支援しています。製造業・金融・公共機関など、多様な業種での実績をもとに、自社の規模・体制に合った最適なアプローチをご提案します。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。