物流AIの活用事例6選と導入の進め方。2024年問題と物流効率化法から考えるAI物流の使いどころ
「同業他社がAIで配車や需要予測を効率化していると聞くが、自社ではどの業務から手を付ければよいか分からない」という方も多いでしょう。2026年4月には改正物流効率化法が全面施行され、一定規模以上の荷主と物流事業者は、荷待ち時間の短縮や積載効率の向上に向けた中長期計画を国へ提出することになりました。
しかし、物流AIの事例を眺めるだけでは、自社のどのデータで、どの業務の何を減らすのかは決まりません。需要予測や配送ルートの最適化が何を計算しているのかが分からないまま製品を選ぶと、現場の制約に合わずに使われなくなることもあります。
そこで本記事では、
- 物流AIの活用領域と、AIが求められる背景(2024年問題・物流効率化法・総合物流施策大綱の2026年9月時点の状況)
- 公表された物流AIの活用事例6件と、需要予測と配送ルートの考え方を示す小さなデモ
- 導入時の注意点と、導入を進める6つのステップ
についてわかりやすく解説します。荷主企業の物流部門や、運送・倉庫・3PL(物流業務の一括受託)事業者のDX担当の方は、ぜひ最後までご覧ください。
「自社の出荷データや配送データで、AIがどこまで使えるかを確かめたい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
物流AIとは。AI物流の活用領域と使われる技術
物流AIとは、需要の予測、配車や配送ルートの計画、倉庫での作業、伝票や問い合わせの処理など、物流の業務にAI(人工知能)を使う取り組みの総称です。「AI物流」と呼ばれることもあります。まず、物流AIで使われる技術と活用領域を押さえます。
物流AIで使われる4つの技術
物流AIの中身は、次の4つの技術に分けて考えると整理しやすくなります。
- 予測(機械学習):過去の出荷実績や曜日、天候、販促の予定などから、将来の出荷量や配送の業務量を予測します
- 最適化(数理最適化):配送先・車両・時間指定などの条件を満たしながら、走行距離や必要な台数が小さくなる計画を計算します
- 認識(画像認識・AI-OCR):カメラ画像から荷物や商品を見分けたり、手書きの伝票から文字を読み取ったりします。AI-OCRとは、AIを使って画像の文字をデータに変換する技術を指します
- 生成AI:文章の理解と生成が得意なAIで、問い合わせへの回答案の作成や、社内の物流データへの質問応答に使われます
同じ「物流AI」でも、予測と最適化は「計画を立てる」業務、認識は「現場の作業」、生成AIは「事務と問い合わせ」に効く技術です。自社の課題がどれに当たるかを先に決めると、選ぶべき仕組みが絞れます。
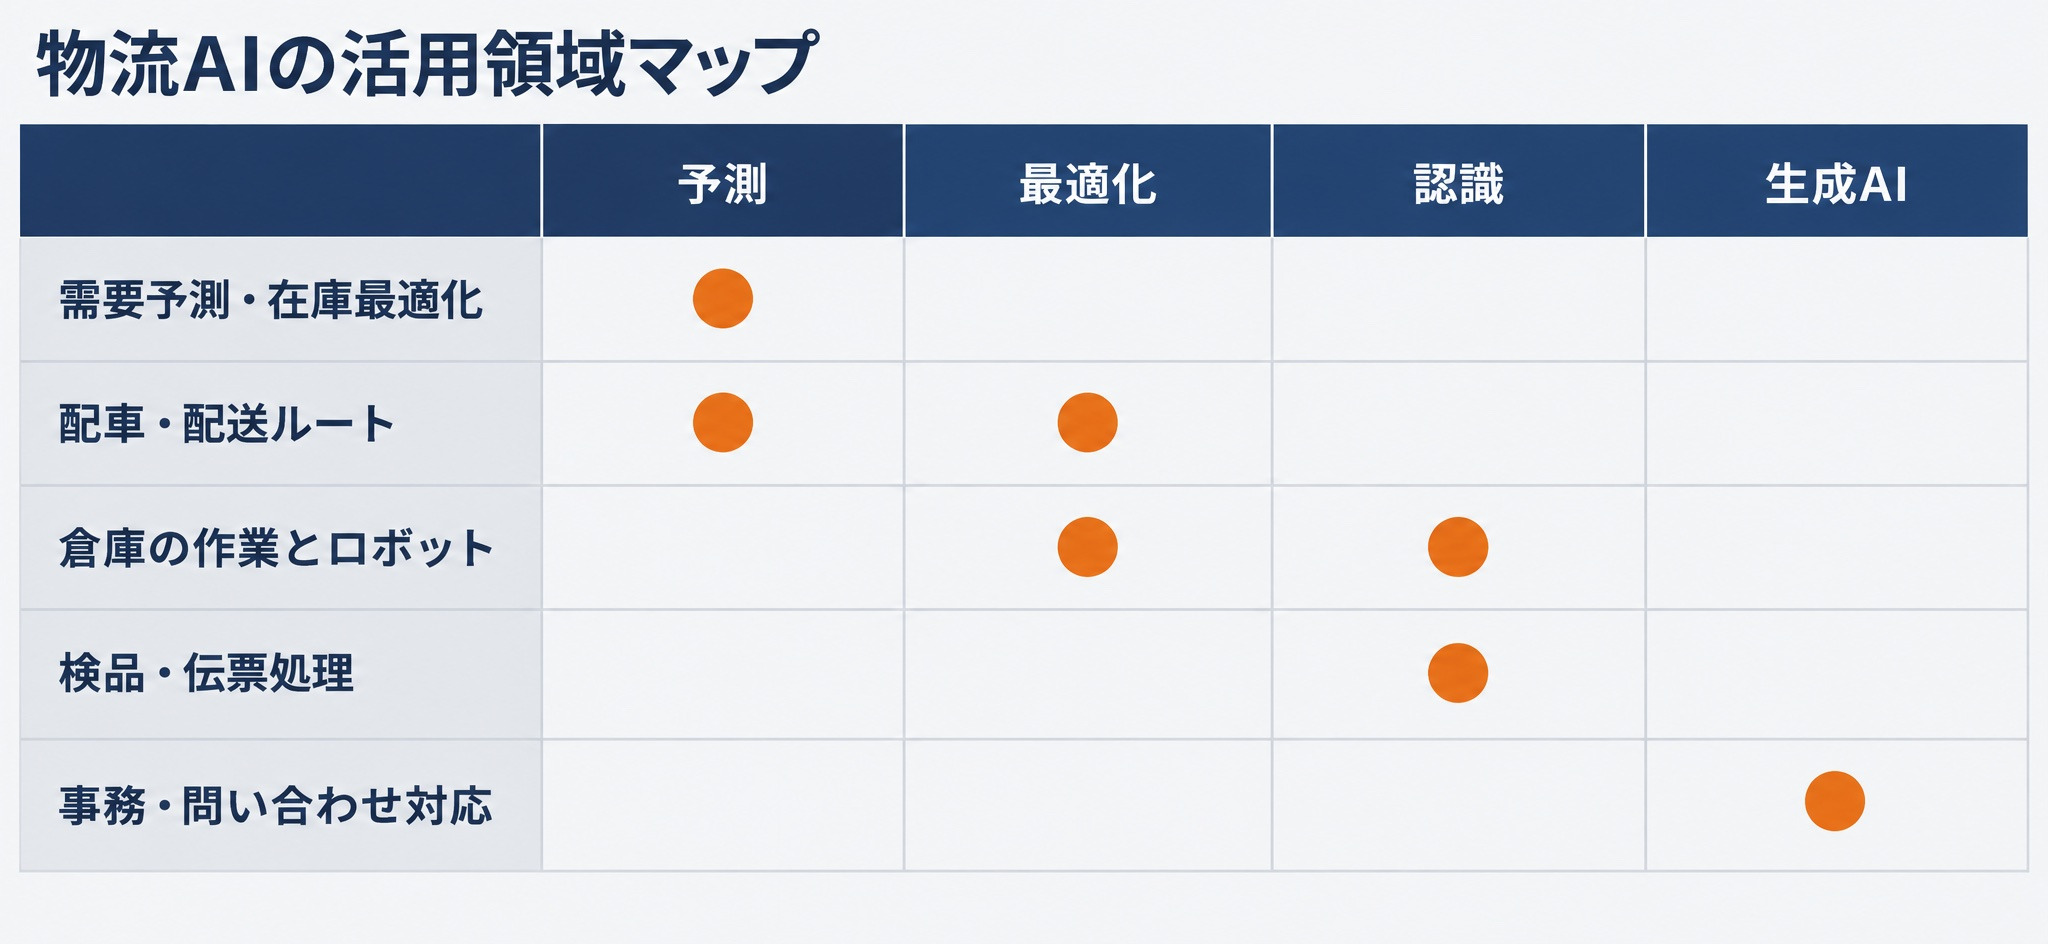
物流AIの主な活用領域
物流AIの代表的な活用領域を、AIが担うことと使うデータで整理しました。
| 活用領域 | AIが担うこと | 主に使うデータ | 主な技術 |
|---|---|---|---|
| 需要予測・在庫最適化 | 商品や拠点ごとの出荷量を予測し、在庫の配置や補充を決める | 出荷実績・在庫・販促予定・カレンダー | 予測 |
| 配車・配送ルート | 車両への荷物の割り当てと回る順番を決める | 配送先・荷量・時間指定・車両・道路情報 | 予測・最適化 |
| 倉庫の作業とロボット | ピッキングの順番の提示や、搬送ロボットの制御を行う | 受注明細・棚の位置・作業実績 | 最適化・認識 |
| 検品・伝票処理 | 商品の数量や外観を確かめ、伝票の文字を読み取る | 画像・帳票 | 認識 |
| 事務・問い合わせ対応 | 問い合わせへの回答案を作り、社内データを要約する | FAQ・問い合わせ履歴・物流データ | 生成AI |
この表から読み取れるのは、どの領域でも「その業務のデータが日々たまっているか」が出発点になるという点です。たとえば配送ルートの最適化には、配送先の住所だけでなく、時間指定や荷量のデータが要ります。
物流でAIが求められる背景。2024年問題と法改正の現状(2026年9月時点)
ここまで物流AIの範囲を整理しました。次に、なぜ今、物流でAIが求められているのかを、2026年9月時点の制度と政府の方針から確認します。
物流の2024年問題の現在地
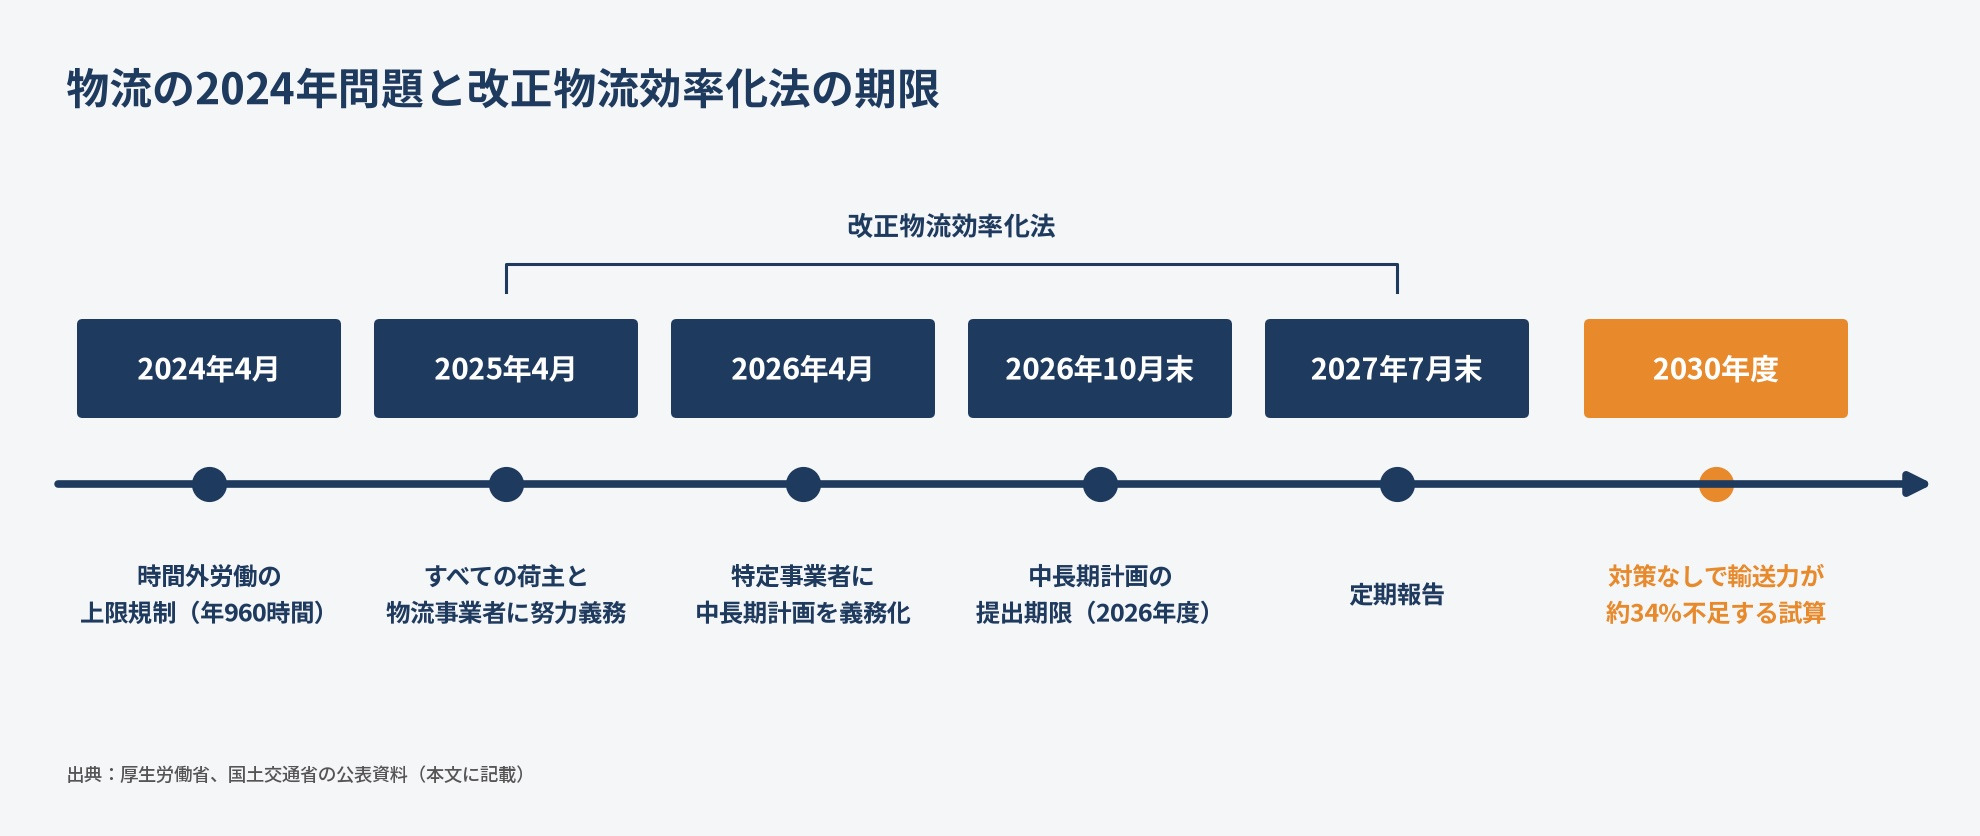
物流の2024年問題とは、2024年4月からトラックドライバーなど自動車運転の業務に時間外労働の上限規制が適用され、運べる量が減るおそれがあるという問題を指します。上限は、特別条項付きの36協定を結ぶ場合でも年960時間です(厚生労働省「建設業・ドライバー・医師等の時間外労働の上限規制」)。
国土交通省は、何も対策を講じなければ、輸送力が2024年度に約14%、2030年度に約34%不足する可能性があると試算していました(国土交通省「物流を取り巻く動向と物流施策の現状・課題」)。このうち2024年度の不足については、国土交通白書2025が、官民の取り組みにより概ね解消でき、2025年度に入っても物流の機能を維持できていると整理しています(国土交通白書2025)。
一方で、2030年度の34%の不足は残っています。2024年問題は「2024年を乗り切れば終わる問題」ではなく、2030年度に向けて輸送の効率を上げ続ける必要がある問題だといえます。
改正物流効率化法で特定事業者に中長期計画が義務に
2024年5月に公布された改正物流効率化法(流通業務の総合化及び効率化の促進に関する法律)は、2段階で施行されました(国土交通省「物流効率化法に基づく中長期計画に関する説明会」資料 令和8年9月)。
- 2025年4月1日:すべての荷主と物流事業者に、積載効率の向上、荷待ち時間の短縮、荷役等時間の短縮に取り組む努力義務
- 2026年4月1日:一定規模以上の事業者を「特定事業者」に指定し、中長期計画の作成と定期報告を義務化。特定事業者のうち荷主には、役員などの経営幹部から物流統括管理者(CLO)を選ぶ義務
国が示した判断基準(取り組むべき措置の例)には、「配車システムの導入等を通じた配車・運行計画の最適化」や「トラック予約受付システムの導入」が挙がっています。物流AIや物流のデータ基盤は、この法律への対応手段の1つとして位置づけられます。
特定事業者の指定基準と、2026年8月27日時点の指定件数は次のとおりです。
| 区分 | 指定基準 | 国の事前想定 | 指定件数(2026年8月27日時点) |
|---|---|---|---|
| 荷主・連鎖化事業者 | 取扱貨物の重量9万トン以上 | 3,200社程度 | 3,257件(重複を除いた実事業者数は2,142社) |
| トラック事業者 | 保有車両台数150台以上 | 790社程度 | 877社 |
| 倉庫業者 | 貨物の保管量70万トン以上 | 70社程度 | 56社 |
出典:国土交通省「物流効率化法に基づく中長期計画に関する説明会」資料 令和8年9月
この表のとおり、荷主側だけで2,000社を超える企業が指定を受けています(発荷主と着荷主の両方で指定された企業を1社と数えた場合)。中長期計画の提出期限は、2026年度に限って10月末です(2027年度以降は7月末)。2027年7月末には定期報告が控えており、その中で荷待ち時間等の状況を報告します。荷待ち時間を計測し、配車や入出荷の計画を見直す仕組みが、これから多くの企業で必要になります。
総合物流施策大綱(2026〜2030年度)が示す物流AIの方向
政府は2026年3月31日に「総合物流施策大綱(2026年度~2030年度)」を閣議決定し、2030年度までを物流革新の「集中改革期間」と位置づけました(国土交通省 報道発表)。
大綱の本文は、生成AIをはじめとするAIやデジタルツインなどの新技術を踏まえ、配車・運行計画の最適化や、異なる荷姿・重量の貨物の積合せといったユースケースの創出を支援するとしています。倉庫については、入場ゲートや入出荷バースに置いたAIカメラでトラックの荷待ち・荷役時間を把握する取り組みも挙げています(総合物流施策大綱(2026年度~2030年度)本文)。法律による義務と政府の方針の両方が、物流のデータ化とAIの活用を後押ししている状況です。
物流AIの活用事例6選
ここまでの背景を踏まえ、実際に導入が公表された物流AIの活用事例を、活用領域ごとに6件見ていきます。いずれも企業の公式発表から引いています。
1. 需要予測で在庫移動の指示を自動化(アスクル)
アスクルは、物流センターとその近くの補充倉庫の間で商品を移す「横持ち」の計画に、自社開発のAI需要予測モデルを導入しました。「いつ・どこからどこへ・何を・いくつ運ぶべきか」をAIが指示します。
- 従来は、各拠点の担当者が経験をもとに手作業で計画していた
- ALP横浜センターで、横持ち指示の作成工数が1日あたり約75%減、入出荷作業が約30%減、フォークリフト作業が約15%減
- 全国の物流拠点に展開
出典:アスクル「物流センターと補充倉庫間の商品横持ち計画にAI需要予測モデルを活用」(2023年11月29日)
予測の精度が上がったことで臨時の横持ちが減り、入出荷やフォークリフトの作業まで減った点が特徴です。需要予測の効果は、計画を作る時間だけでなく、下流の作業量にも表れます。
2. 配送業務量の予測と配車計画(ヤマト運輸とアルフレッサ)
ヤマト運輸と医薬品卸のアルフレッサは、ヘルスケア商品の共同配送に向けて、配送業務量を予測するシステムと配車計画のシステムを開発しました。
- アルフレッサの販売・物流・商品・需要トレンドのデータをAIで分析し、顧客ごとの注文数や配送の発生確率、納品時の滞在時間を予測
- 予測をもとに、渋滞などの道路情報も使って配車計画を自動で作成
- 2021年8月から首都圏の支店で導入。効果は両社の予想値として、配送生産性の最大20%向上、走行距離とCO2排出量の最大25%削減を示した
ヤマトホールディングスは統合レポート2025でも、機械学習のモデルで日々の業務量を予測して人員と車両を配置し、AIが配送ルートを提示することで、経験にかかわらず効率よく配達できるようにしたと説明しています(ヤマトホールディングス 統合レポート2025 デジタル戦略)。
3. ピッキングを支援するロボット(日本通運とラピュタロボティクス)
日本通運のNX小牧流通センターは、ラピュタロボティクスの協働型ピッキングアシストロボット「ラピュタPA-AMR」を導入しました。AMR(自律走行搬送ロボット)とは、地図とセンサーで自ら経路を判断して走るロボットを指します。
- 従来の台車を押して回るピッキングから、ロボットと人が協働する方式に変更
- 稼働開始から3か月で、出荷工程の生産性が1時間あたり42.9件から110.8件へ(約2.5倍)
- 新人とベテランの作業スピードと精度の差が縮まった
- 今後、倉庫管理システム(WMS)を改修し、対象業務を1日500行から1,000行へ広げる予定
出典:ラピュタロボティクス プレスリリース(2025年10月1日)
倉庫の自動化は、ロボットの導入だけでなく、WMSとの連携範囲を広げる段階で効果が伸びます。
4. 配送伝票の読み取りを自動化(佐川急便)
佐川急便、SGシステム、フューチャーアーキテクトは、配送伝票の入力作業をAIで自動化するシステムを開発し、2019年7月に本稼働させました。
- 深層学習による文字認識で、手書きのサイズと重量の数字を読み取り、既存システムへの連携まで自動化
- 作業時間を月間約8,400時間短縮
- 手書き数字の認識精度は99.995%以上。丸で囲んだ数字や取り消し線で直した数字も読み取る
- 繁忙期には1日に100万枚の配送伝票を人が入力していた
紙の伝票が残る業務では、AI-OCRのように「読み取って既存システムに入れる」までをつなげると、入力作業そのものを減らせます。
5. 生成AIで問い合わせ対応を効率化(ヤマトコンタクトサービス)
ヤマトグループのコンタクトセンターを担うヤマトコンタクトサービスは、日本オラクルの生成AIサービスとデータベースを使い、メールでの問い合わせ対応を効率化しました。
- 問い合わせの内容に合うFAQを、キーワード検索と意味の近さによる検索を組み合わせて探し、RAG(検索拡張生成)で回答に使う
- 自己解決できる問い合わせへのFAQの提案が合う割合(マッチ率)を、従来の約2倍の85%に向上
- 宅急便の配送に関するメール問い合わせ対応業務のうち、約20%をAIで自動処理・抑制
RAGとは、AIが回答を作る前に社内の文書やFAQを検索し、その内容をもとに答える仕組みを指します。物流特有の言い回しが多い問い合わせでは、FAQの探しやすさが効果を左右します。
6. 出荷予測と、生成AIによる物流データの分析(日本通運)
日本通運は、倉庫の在庫や作業の状況を見られる物流Webアプリ「DCX」に、AIの機能を段階的に加えています。
- 2025年4月にAIを使った出荷予測のサービスを開始
- 2026年5月の強化で、1アイテムあたり1〜2時間かかっていた予測の算出が約5分に短縮。最大半年先まで予測でき、統計的な確率にもとづく10段階の予測値から、欠品を避けたいか過剰在庫を抑えたいかに応じて選べる
- 2026年8月には、生成AIで物流データに自然言語で質問できる「BI LLM Chat」を開始。数日かかっていたレポート作成や要因分析の工数削減を狙う。入力データや対話内容は外部のAIの学習に使われない設計
出典:日本通運 ニュースリリース(2026年5月14日)、日本通運 ニュースリリース(2026年8月19日)
予測値を1つだけ出すのではなく、幅を持った複数の値から選べる形にしている点は、在庫の判断を人が行う前提の設計です。
製造や金融など、物流以外の業界のAI活用事例は「業界別AI活用事例10選」で解説しています。
物流AIの需要予測と配送ルート最適化をデモで確かめる
事例の多くは、需要の予測と、配車や作業の順番の最適化でした。ここでは、その考え方を生成データの小さなデモで確かめます。数値は生成データの計算結果で、実在の企業の効果ではありません。
測定条件:Apple M1 Pro、Python 3.13.13、NumPy 2.5.3、pandas 3.0.6、scikit-learn 1.9.1、2026年9月23日に実行。乱数シードは固定しています。
需要予測のデモ。事前に分かる情報が予測を変える
ある物流センターの1日の出荷量(ケース数)を2年分生成し、直近8週間の出荷量を4つの方法で予測しました。出荷量には、曜日の波(月曜が多く日曜が少ない)、12月の繁忙期、緩やかな増加、荷主のセール日(約6%の日、出荷が35%増える)を入れています。セール日は、荷主から事前に知らされる想定です。
# 生成データで「出荷量の予測」を4つの方法で比べる
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingRegressor

rng = np.random.default_rng(42)
days = pd.date_range("2024-09-01", periods=730, freq="D")
dow = days.dayofweek.to_numpy()                      # 0=月曜
weekday_factor = np.array([1.25, 1.10, 1.05, 1.00, 1.15, 0.70, 0.45])[dow]
season = 1 + 0.15 * np.cos(2 * np.pi * (days.dayofyear.to_numpy() - 350) / 365)  # 12月が山
promo = (rng.random(730) < 0.06).astype(int)          # 荷主のセール日(事前に分かる)
trend = np.linspace(1.0, 1.08, 730)
qty = 1000 * weekday_factor * season * trend * (1 + 0.35 * promo) * rng.normal(1, 0.06, 730)
df = pd.DataFrame({"date": days, "qty": qty.round(), "dow": dow,
                   "month": days.month, "promo": promo})

df["lag7"] = df["qty"].shift(7)                       # 前週同曜日
df["lag14"] = df["qty"].shift(14)
df["mean4w"] = (df["qty"].shift(7) + df["qty"].shift(14)
                + df["qty"].shift(21) + df["qty"].shift(28)) / 4
df = df.dropna().reset_index(drop=True)

test = df.tail(56)                                    # 直近8週間を評価に使う
train = df.iloc[: len(df) - 56]

feats = ["dow", "month", "promo", "lag7", "lag14", "mean4w"]
model = GradientBoostingRegressor(random_state=0).fit(train[feats], train["qty"])
feats_np = ["dow", "month", "lag7", "lag14", "mean4w"]  # セール予定を使わない版
model_np = GradientBoostingRegressor(random_state=0).fit(train[feats_np], train["qty"])

preds = {
    "前週同曜日の実績をそのまま使う": test["lag7"],
    "過去4週の同曜日平均": test["mean4w"],
    "機械学習(セール予定なし)": model_np.predict(test[feats_np]),
    "機械学習(セール予定あり)": model.predict(test[feats]),
}
print(f"評価期間: {test['date'].min().date()}〜{test['date'].max().date()}(56日)")
print(f"評価期間の平均出荷量: {test['qty'].mean():.0f} ケース/日")
for name, p in preds.items():
    err = np.abs(test["qty"].to_numpy() - np.asarray(p))
    print(f"{name}: 平均絶対誤差 {err.mean():.0f} ケース"
          f"(平均比 {err.mean() / test['qty'].mean() * 100:.1f}%)、"
          f"誤差が15%を超えた日 {int((err / test['qty'].to_numpy() > 0.15).sum())}日")
実行結果は次のとおりです。
評価期間: 2026-07-07〜2026-08-31(56日)
評価期間の平均出荷量: 957 ケース/日
前週同曜日の実績をそのまま使う: 平均絶対誤差 97 ケース(平均比 10.2%)、誤差が15%を超えた日 10日
過去4週の同曜日平均: 平均絶対誤差 80 ケース(平均比 8.4%)、誤差が15%を超えた日 6日
機械学習(セール予定なし): 平均絶対誤差 70 ケース(平均比 7.3%)、誤差が15%を超えた日 5日
機械学習(セール予定あり): 平均絶対誤差 59 ケース(平均比 6.1%)、誤差が15%を超えた日 2日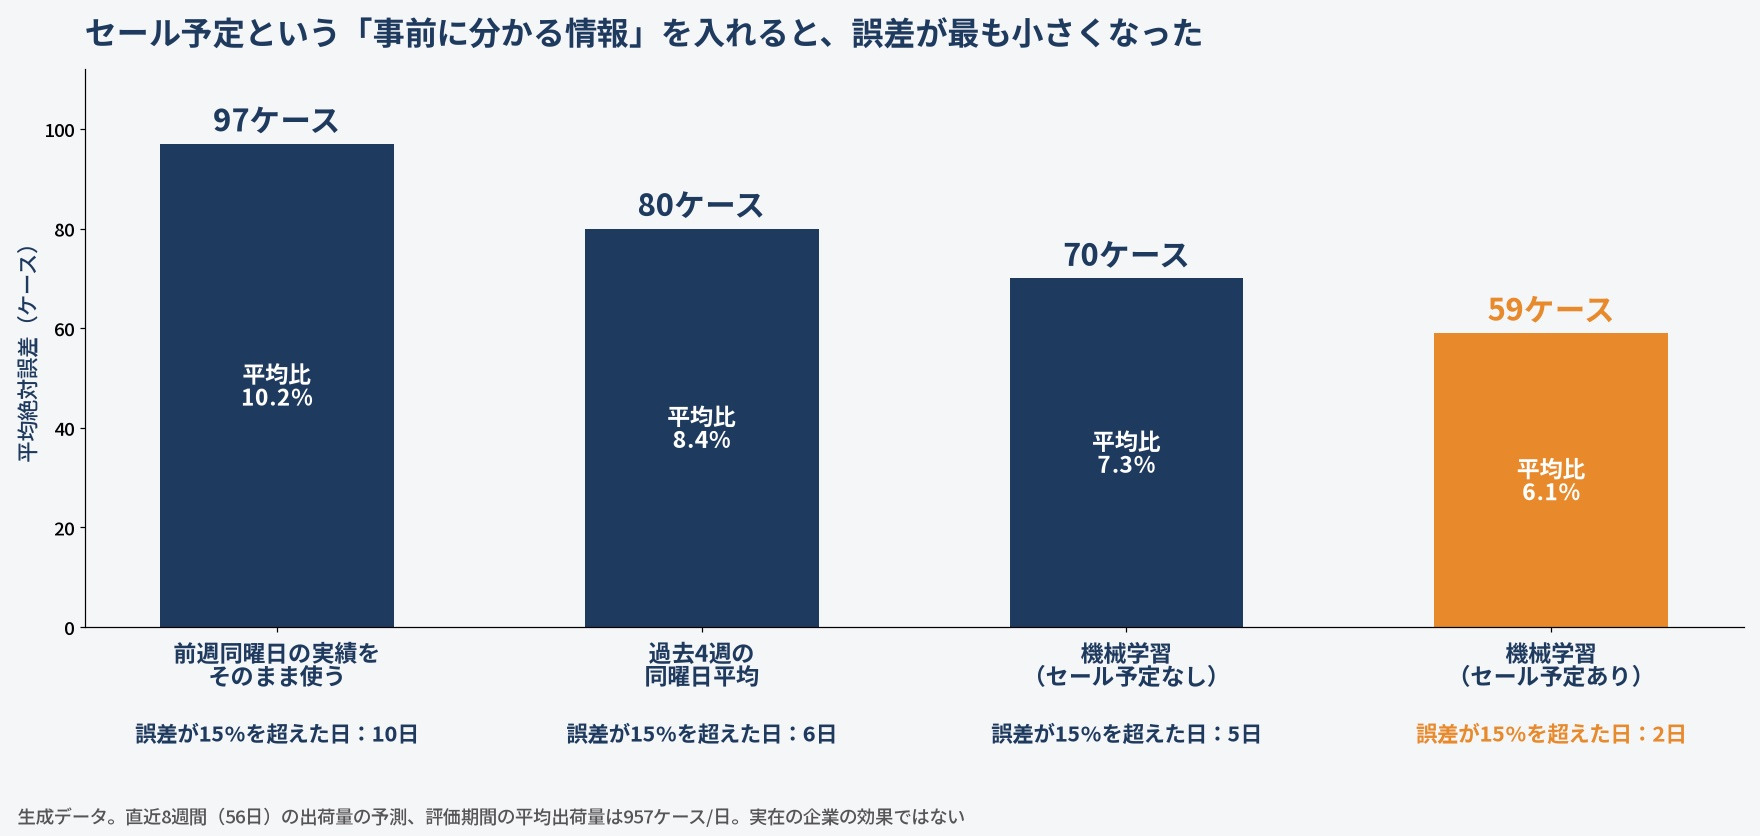
平均絶対誤差とは、予測と実績の差の大きさを日ごとに測って平均した値です。前週の同じ曜日の実績をそのまま使う方法は97ケースずれましたが、機械学習にセール予定を入れると59ケースまで下がり、誤差が15%を超えた日は10日から2日に減りました。
このデモで注目したいのは、機械学習の手法そのものより、セール予定という「事前に分かる情報」を入れたときの差です。同じ機械学習でも、セール予定がないと誤差は70ケースでした。実務でも、荷主の販促計画や入荷予定を物流側が受け取れるかどうかが、予測の精度を左右します。ヤマト運輸とアルフレッサの事例も、荷主であるアルフレッサの販売や需要トレンドのデータを配送業務量の予測に取り込んでいます。
配送ルートのデモ。回る順番の決め方で走行距離が変わる
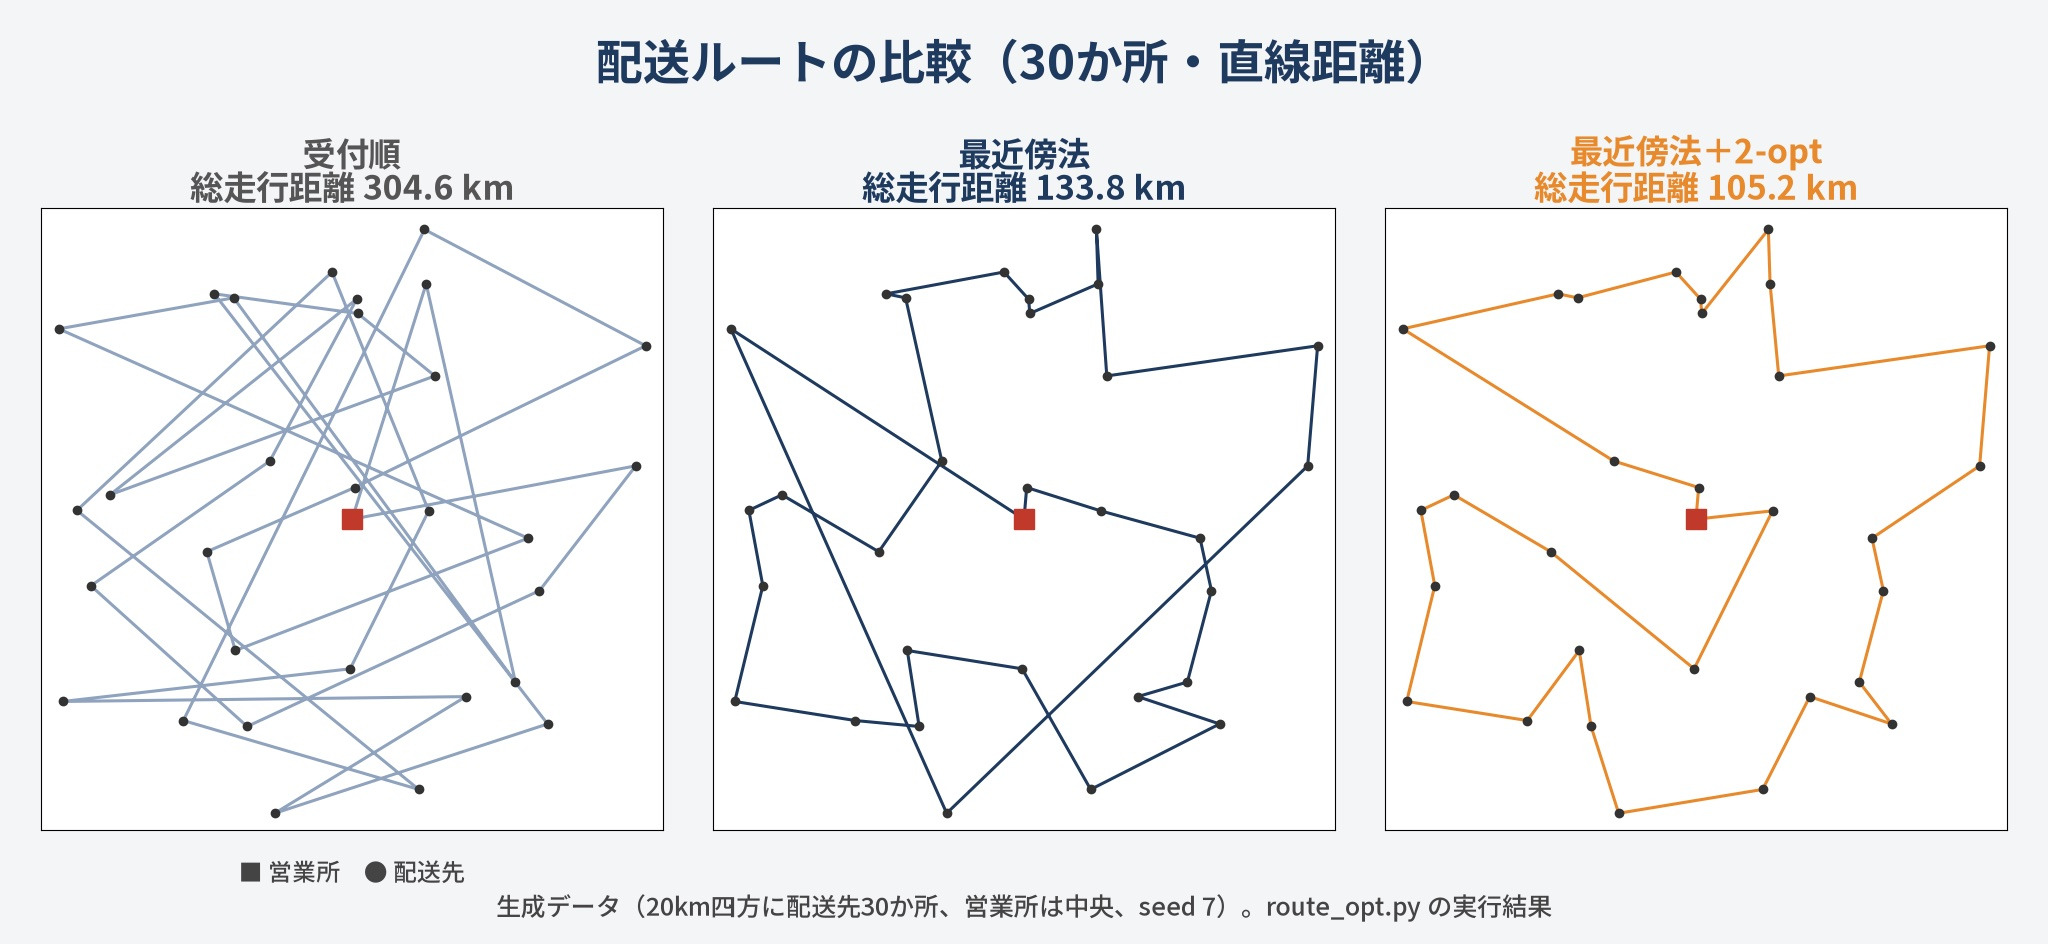
次に、20km四方に置いた30か所の配送先を、中央の営業所から1台で回る場合の総走行距離を、3つの決め方で比べました。距離は直線距離で計算しています。
# 生成データで「配送ルート」を3つの決め方で比べる(直線距離で計算)
import numpy as np

rng = np.random.default_rng(7)
n = 30                                               # 配送先の数
pts = rng.uniform(0, 20, size=(n, 2))                # 20km四方に配送先を置く
depot = np.array([10.0, 10.0])                       # 営業所は中央
xy = np.vstack([depot, pts])
d = np.linalg.norm(xy[:, None, :] - xy[None, :, :], axis=2)

def length(route):                                    # 営業所→配送先→営業所
    path = [0] + route + [0]
    return sum(d[a, b] for a, b in zip(path[:-1], path[1:]))

# 1. 伝票の受付順に回る
order_received = list(range(1, n + 1))

# 2. 最近傍法:いちばん近い未訪問の配送先へ進む
def nearest(start=0):
    left, route, cur = set(range(1, n + 1)), [], start
    while left:
        nxt = min(left, key=lambda j: d[cur, j])
        route.append(nxt); left.remove(nxt); cur = nxt
    return route

# 3. 2-opt:経路の一部を逆順にして、短くなる限り改善を繰り返す
def two_opt(route):
    best, improved = route[:], True
    while improved:
        improved = False
        for i in range(len(best) - 1):
            for k in range(i + 1, len(best)):
                cand = best[:i] + best[i:k + 1][::-1] + best[k + 1:]
                if length(cand) < length(best) - 1e-9:
                    best, improved = cand, True
    return best

r1, r2 = order_received, nearest()
r3 = two_opt(r2)
base = length(r1)
for name, r in [("受付順", r1), ("最近傍法", r2), ("最近傍法+2-opt", r3)]:
    print(f"{name}: 総走行距離 {length(r):.1f} km(受付順比 {length(r) / base * 100:.0f}%)")
実行結果は次のとおりです。
受付順: 総走行距離 304.6 km(受付順比 100%)
最近傍法: 総走行距離 133.8 km(受付順比 44%)
最近傍法+2-opt: 総走行距離 105.2 km(受付順比 35%)
最近傍法とは、今いる場所からいちばん近い配送先へ順に進む決め方です。2-optとは、経路の途中の区間を逆順にしてみて、距離が短くなる限りそれを繰り返す改善の手法を指します。このデータでは、最近傍法の133.8kmに対し、2-optで改善すると105.2kmになり、さらに約2割短くなりました。
受付順との差が大きく出ているのは、生成データの受付順が場所と無関係に並んでいるためです。実際のドライバーは経験で回る順番を工夫しているので、差はこれほど大きくありません。比べるべきは、熟練者が組んだルートとAIが計算したルートです。
実務では制約条件の聞き取りが結果を左右する
2つのデモは、条件を大きく単純にしています。実際の配車計画では、次のような制約を同時に満たす必要があります。
- 午前中指定などの時間指定と、納品先ごとの荷受け可能な時間
- 車両ごとの積載量と、冷蔵・冷凍などの温度帯
- ドライバーの労働時間の上限と、休憩の取り方
- 納品先での荷待ちや、荷下ろしにかかる時間
制約が1つ抜けているだけで、計算上は短いのに現場では守れないルートになります。複数の車両で配送先を分け合う計画は「配送計画問題」と呼ばれ、制約を入れた最適化の計算には専用の手法やソルバー(最適化の計算ソフト)を使うのが一般的です。物流AIの導入では、計算手法を選ぶ前に、現場のルールをどこまで言葉とデータにできるかが結果を決めます。
物流AIのメリットと導入時の注意点
デモから分かったのは、物流AIの結果を決めるのは、手法よりもデータと制約条件だという点でした。ここでは、事例とデモを踏まえて、物流AIのメリットと、導入でつまずきやすい点を整理します。
物流AIのメリット
公表事例から確認できる物流AIのメリットは、次の3つです。
- 計画を作る時間を減らせる:横持ち指示の作成工数を約75%減らした例(アスクル)や、出荷予測の算出を1〜2時間から約5分にした例(日本通運)があります
- 経験に頼る業務を標準化できる:AIが配送ルートを提示することで経験にかかわらず効率よく配達できるようにした例(ヤマトホールディングス)や、ロボットで新人とベテランの差が縮まった例(日本通運)があります
- 現場の作業量を減らせる:伝票の入力作業を月間約8,400時間減らした例(佐川急便)や、臨時の横持ちが減って入出荷作業が約30%減った例(アスクル)があります
浮いた時間を、ドライバーの荷待ちの削減や、荷主との調整といった人にしかできない業務に回すことが、2030年度に向けた輸送力の確保にもつながります。
注意点1. データが揃っていないと予測できない
需要予測には、商品・拠点・日付の単位でそろった出荷実績が要ります。システムごとに商品コードが違う、返品や欠品の記録が混ざっているといった状態では、AIは正しく学習できません。日本通運のAI出荷予測も、一定以上の出荷実績データがあることを利用の条件にしています。
注意点2. 現場の制約を入れないと計画が使われない
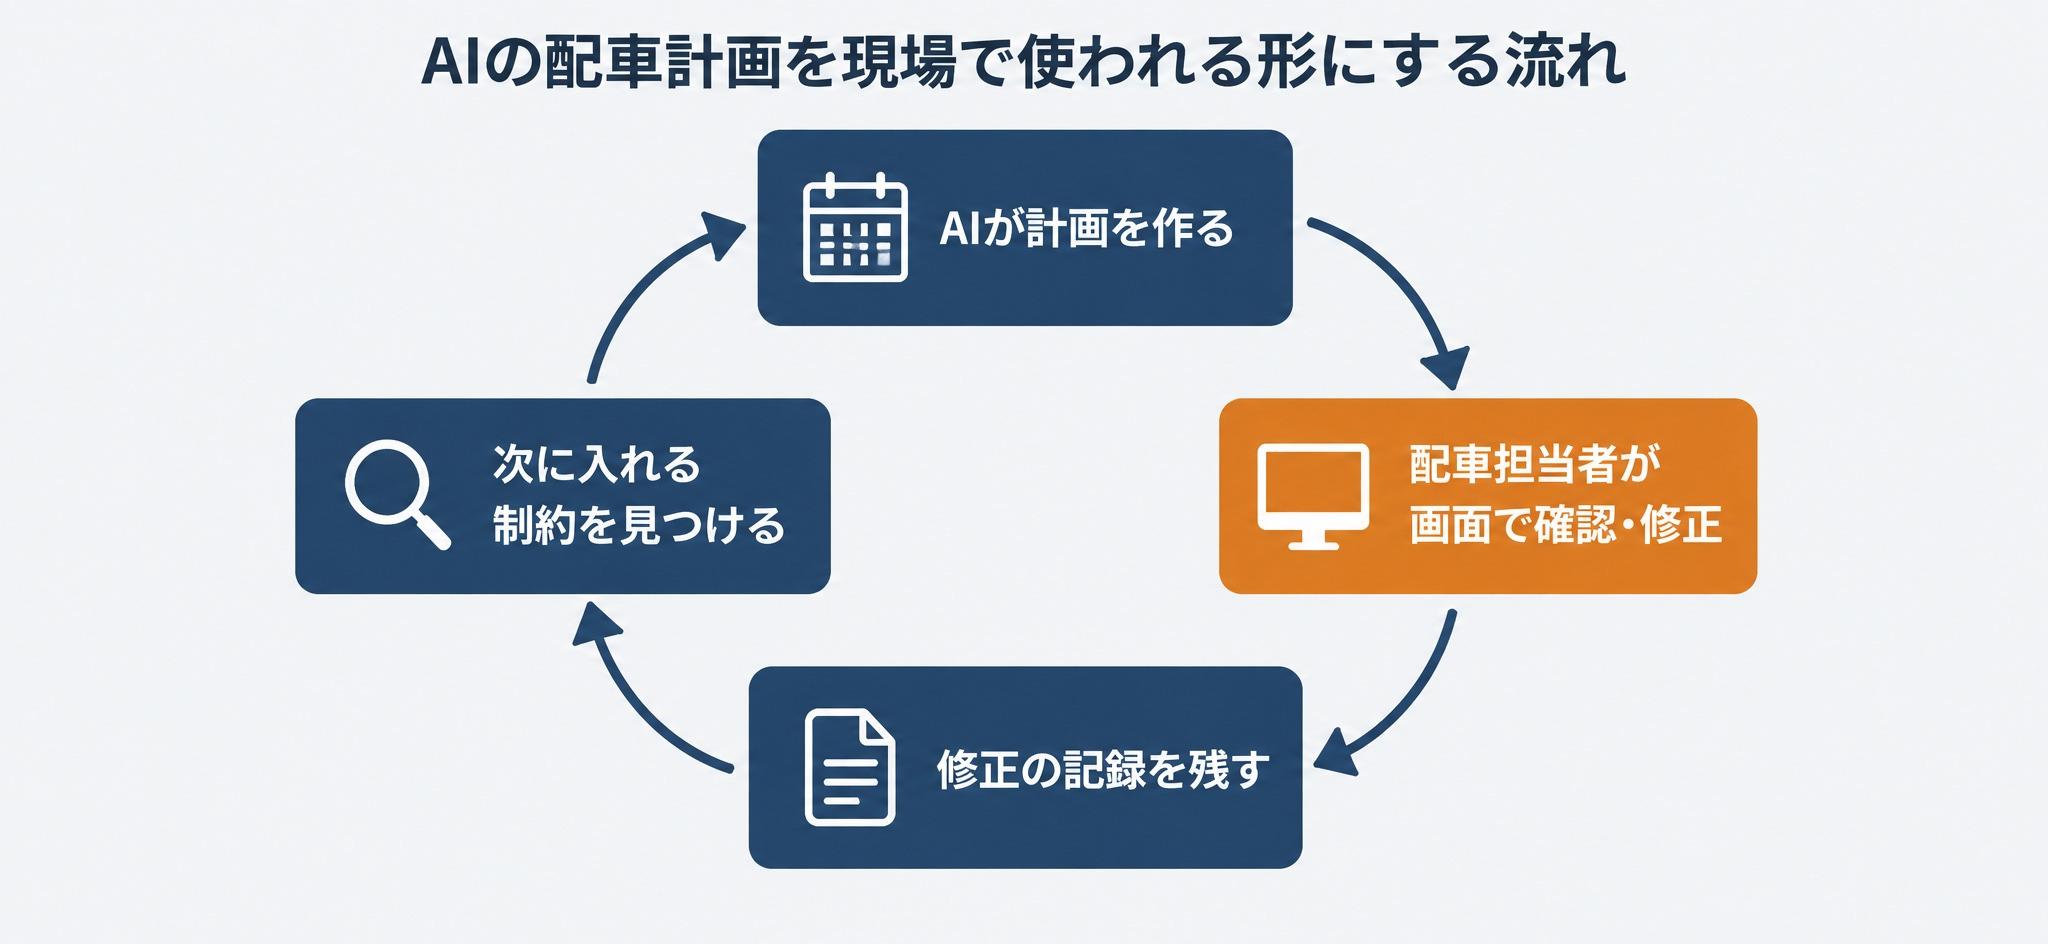
配車や作業の計画は、時間指定や積載量、納品先ごとの細かなルールを満たして初めて現場で使われます。AIの計画をそのまま押し付けるのではなく、配車担当者が画面で確認し、修正できる流れを用意しておくと定着しやすくなります。修正の記録は、次に入れるべき制約を見つける手がかりにもなります。
注意点3. 1つの工程だけの最適化で終わらせない
配送ルートだけを短くしても、倉庫の出荷が遅れれば車両は待たされます。アスクルの事例では、需要予測の改善が入出荷やフォークリフトの作業の削減にまで広がりました。物流効率化法の中長期計画でも、荷待ち時間や積載効率といった複数の工程にまたがる指標が問われます。効果は、工程をまたいだ指標で測ります。
注意点4. 生成AIに渡すデータの範囲を決める
問い合わせ対応や社内の物流データの分析に生成AIを使う場合は、荷主の出荷情報や届け先の個人情報をどこまでAIに渡すかを先に決めます。日本通運の「BI LLM Chat」は、外部から隔離した環境で動かし、入力データを外部のAIの学習に使わない設計にしています。社内データを検索して回答に使う仕組みの作り方は、「ChatGPTとRAGで社内データを活用する5つの手順」で解説しています。
ここまで物流AIの事例や注意点を解説しましたが、「自社の出荷データで需要予測や配車計画をAI化できるか確かめたい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、自社の出荷・配送データを使った需要予測モデルや配車計画の検証が可能です。ただ、モデルを作るだけでなく、時間指定や積載量などの現場の制約を組み込み、問い合わせ対応のRAGまで同じデータ基盤で設計できるため、現場で使われ続ける物流AIの構築支援が可能です。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
物流AIの導入を進める6つのステップ
注意点を踏まえ、物流AIの導入を進める順番を6つのステップで示します。荷主企業の物流部門や物流事業者のDX担当が、現場と情報システム部門を巻き込んで進める場合を想定しています。
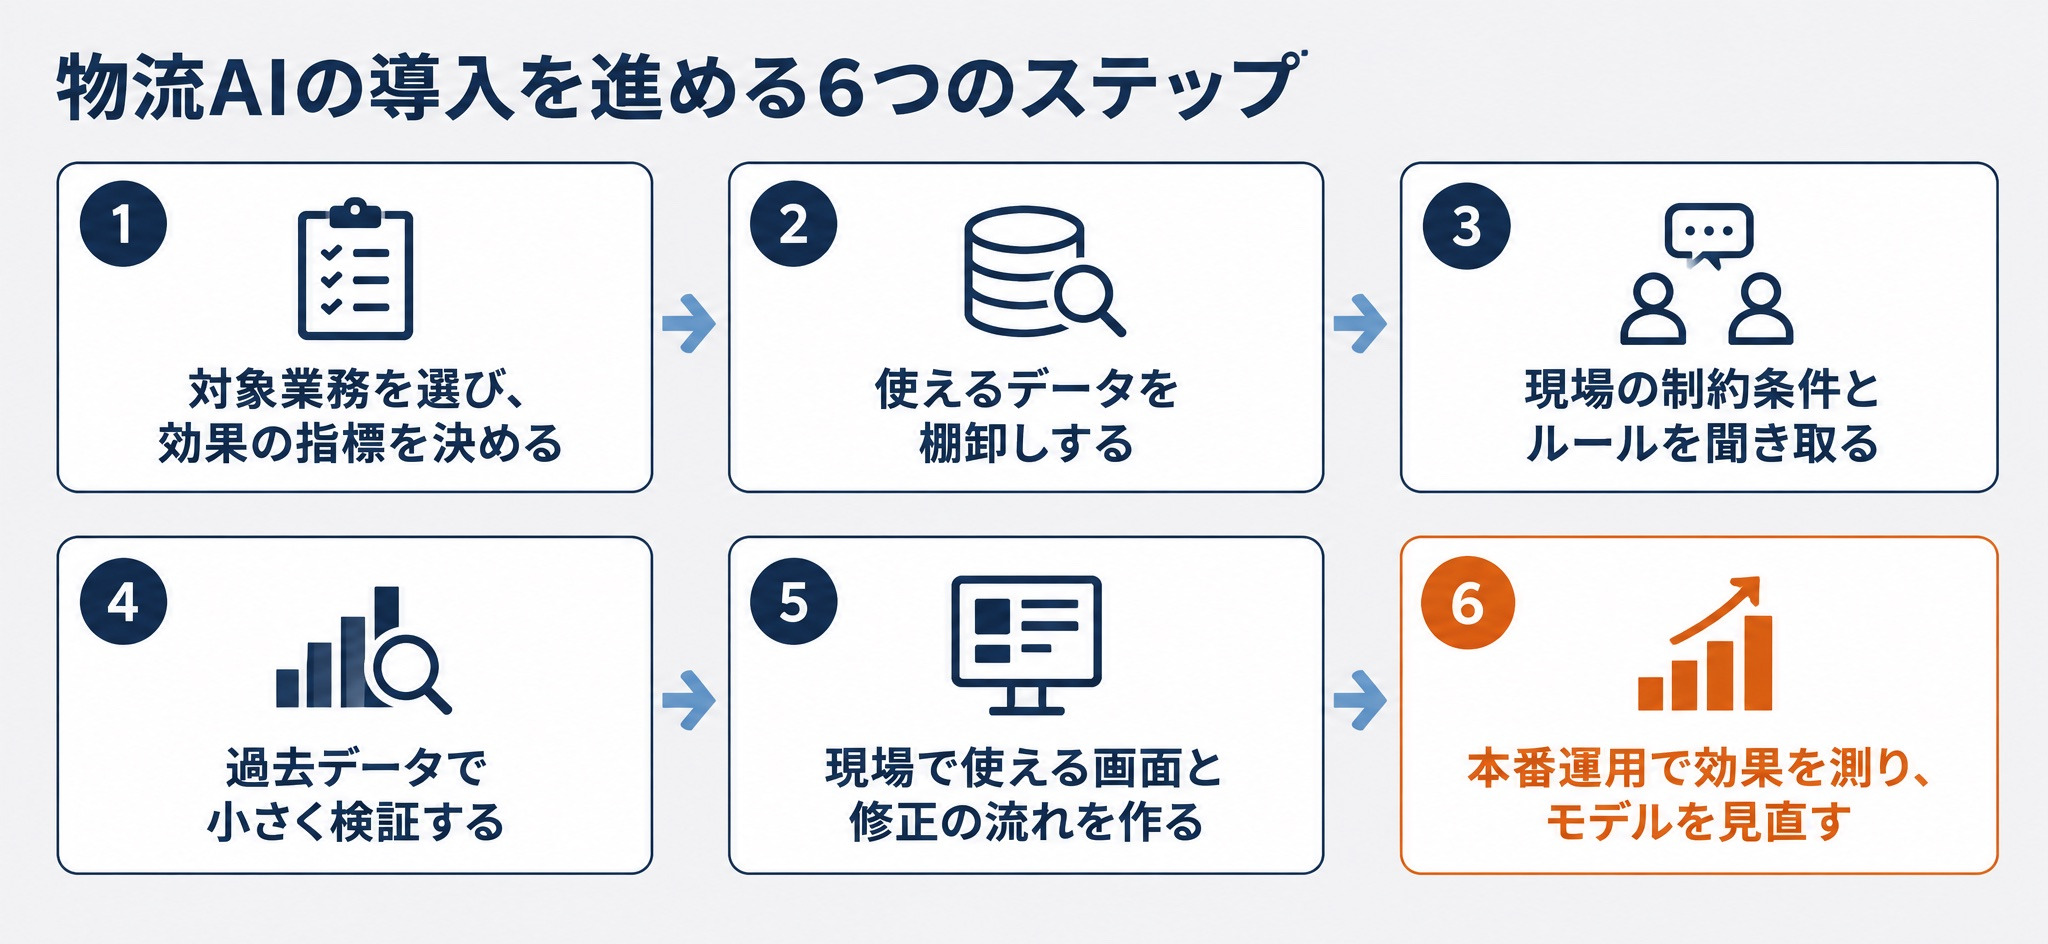
1. 対象業務を選び、効果の指標を決める
DX担当が配車・倉庫・受注・顧客対応の各担当に聞き取りを行い、時間がかかっている業務と、人によって結果が変わる業務を洗い出します。そのうえで、「配車計画の作成時間」「1台あたりの走行距離」「荷待ち時間」「横持ちの回数」など、効果を測る指標を1つか2つに絞ります。特定事業者の場合は、中長期計画に書く目標とそろえておくと、定期報告にもそのまま使えます。対象業務と指標の決め方は、「AI要件定義とは」が参考になります。
2. 使えるデータを棚卸しする
情報システム部門が中心となり、出荷実績・在庫・受注・配送先・車両・作業実績のデータが、どのシステムに、どの単位で、何年分あるかを一覧にします。商品コードや拠点コードの不一致、欠けている期間もこの段階で確かめます。データの棚卸しの進め方は、「AI導入前に必要な社内データ棚卸しの5ステップ」で解説しています。
3. 現場の制約条件とルールを聞き取る
配車担当や倉庫の現場リーダーに、時間指定、積載量、温度帯、納品先ごとのルール、休憩の取り方などを聞き取り、文章と表にまとめます。「この納品先は大型車が入れない」のように、担当者の頭の中にしかないルールほど、ここで拾っておく必要があります。
4. 過去データで小さく検証する
1つの拠点や1つの配送エリアに絞り、過去1〜3か月のデータでAIの予測や計画を作り、実際の実績や熟練者の計画と比べます。デモのように、今の方法と比べてどれだけ差が出るかを数字で確かめてから、現場での試行に進みます。検証の進め方は「AI PoCの進め方」で詳しく解説しています。
5. 現場で使える画面と修正の流れを作る
検証で効果が見えたら、配車担当や倉庫の作業者が日々使う画面と、AIの計画を人が修正して確定する流れを作ります。WMSや配車システムなど既存システムとのデータ連携も、この段階で設計します。
6. 本番運用で効果を測り、モデルを見直す
本番運用では、ステップ1で決めた指標を毎週確認し、予測が外れた日や計画が修正された理由を記録します。荷主の販促のやり方や配送先が変われば、予測モデルも古くなります。3か月から半年ごとに、データと制約条件を見直してモデルを更新します。
まとめ
本記事では、物流AIの活用領域、AIが求められる背景、公表事例、需要予測と配送ルートのデモ、注意点、導入の手順を解説しました。要点は次のとおりです。
- 物流AIは、予測・最適化・認識・生成AIの4つの技術で、需要予測から配車、倉庫、検品、問い合わせ対応までを支える
- 2024年度の輸送力不足は概ね解消されたが、2030年度の34%の不足は残る。2026年4月からは特定事業者に中長期計画と定期報告が義務付けられ、2026年度の中長期計画は10月末が提出期限
- アスクル、ヤマト運輸、日本通運、佐川急便、ヤマトコンタクトサービスの事例では、計画作成の工数や入力作業、問い合わせ対応の負担を減らした効果が公表されている
- デモでは、事前に分かるセール予定を入れると予測誤差が下がり、回る順番の決め方で総走行距離が大きく変わった。結果を決めるのは、データと現場の制約条件
- 導入は、指標を決め、データと制約を整理し、過去データで小さく検証してから、現場で修正できる形で運用に乗せる
物流AIは、大手企業だけのものではありません。自社にたまっているデータと、現場のルールを整理するところから始めてみてください。
業界別AI活用事例のお役立ち資料(ホワイトペーパー)のダウンロード
物流を含む業界別のAI活用事例を、「課題・データ・AI・導入前後の変化」の枠組みで整理したウェビナー資料を配布しています。自社の業務にAIを当てはめる視点を、スライドでまとめて確認したい方はご活用ください。
⇨お役立ち資料のダウンロードはこちら
物流AIの開発・導入の相談は「リベルクラフト」へ
ここまで、物流AIの事例から制度、導入の手順までを解説してきました。進め方は整理できても、自社のデータで予測や配車の計画がどこまで良くなるのか、現場の細かなルールをどう組み込むのかで迷う場面は多いのではないでしょうか?
リベルクラフトは、AI開発の要件定義からPoC、本番運用までを一貫して支援しています。需要予測や最適化のモデル開発に加え、社内の文書やデータを検索して回答に使うRAGの構築や、データを外部に出さない閉域環境の構築にも対応しています。
- 出荷データを使った需要予測で、在庫配置や人員計画を見直したい
- 配車計画の作成を、現場の制約を入れたAIで効率化したい
- 問い合わせ対応や物流データの分析に、生成AIを安全に組み込みたい
という方は、リベルクラフトへお気軽にご相談ください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。