プロンプトインジェクションとは。間接型の仕組みと公表事例、4層の対策を解説
社内でRAG(検索拡張生成)やAIエージェントの導入を進めるなかで、「プロンプトインジェクションへの対策はできているのか」と聞かれ、答えに詰まった方も多いでしょう。チャット画面に悪意のある文章を打ち込む攻撃だと理解していると、入力欄を見張れば済むように思えます。
しかし実際には、AIが読み込むWebページやメール、社内文書に仕込まれた指示でも同じ被害が起こります。AIに渡している権限が大きいほど、1通のメールが情報流出や不正な操作につながります。
そこで本記事では、
- プロンプトインジェクションとは何か、なぜモデル側で防ぎきれないのか
- 直接型と間接型の違いと、RAGやメールが攻撃経路になる仕組み
- OWASP Top 10 for LLM Applications 2026での位置づけと、公表された事例
- 入力・添付・出力・権限の4層で組む対策と、社内で確認する手順
についてわかりやすく解説します。生成AIやAIエージェントの導入を担当するDX推進・情報システム部門の方は、ぜひ最後までご覧ください。なお、本記事は概念と対策に絞り、攻撃を再現できる文例や手順は載せていません。
「自社のRAGやAIエージェントがプロンプトインジェクションに耐えられる設計か確認したい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
プロンプトインジェクションとは
プロンプトインジェクションとは、大規模言語モデル(LLM)に細工をした入力を与え、開発者が意図していない出力や動作をさせる攻撃です。総務省が2026年3月に公表したガイドラインは、「LLMに細工をした入力を行うことで、不正な出力をさせる攻撃」と定義しています。不正な出力には、本来は見せない社内文書を答えさせる、連携先のデータベースを操作させる、といった被害が含まれます。
参照:AIのセキュリティ確保のための技術的対策に係るガイドライン(総務省・令和8年3月)
LLMが「指示」と「データ」を区別できないことが原因
根本の原因は、LLMが開発者の指示と処理対象のデータを区別できない点にあります。システムプロンプト(開発者が役割や禁止事項を設定する指示文)、利用者の入力、検索で取ってきた文書、ツールの応答は、すべて1本の文字列としてLLMに渡されます。
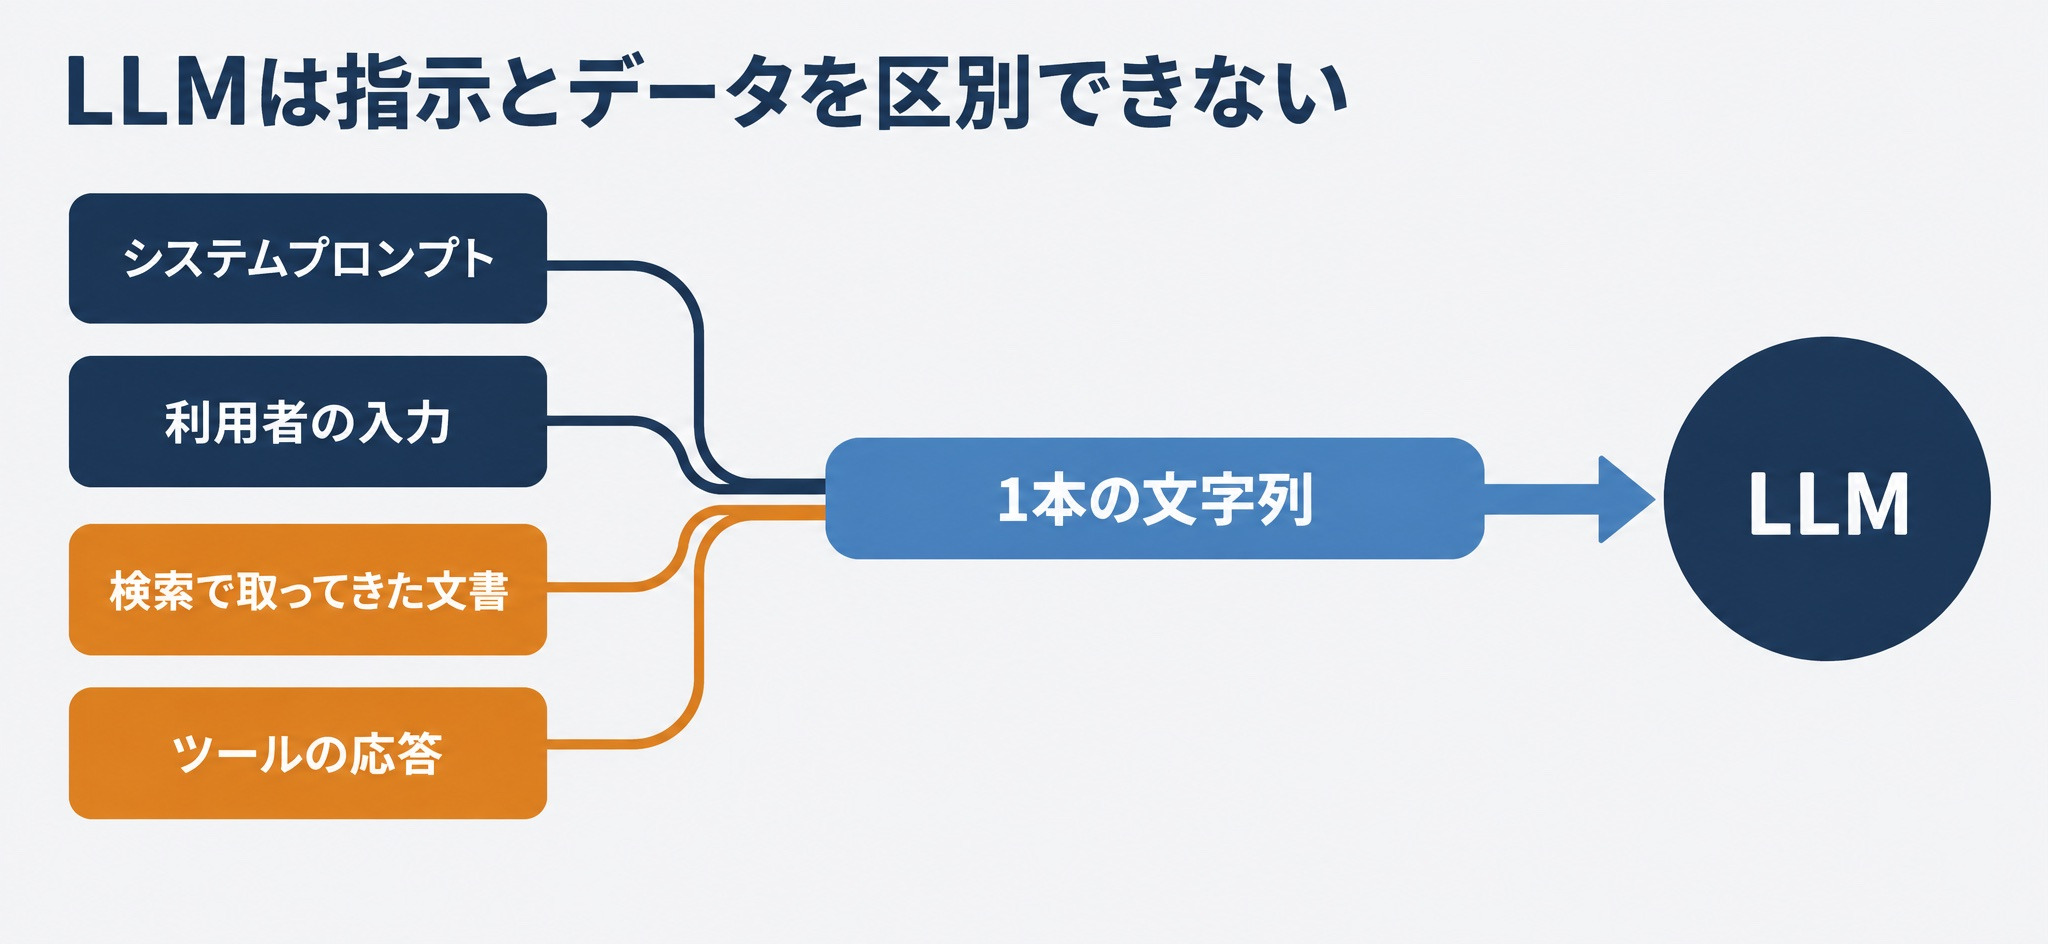
OWASP(Webアプリケーションの安全性に取り組む国際的な非営利団体)の「OWASP Top 10 for LLM Applications 2026」も、このため確実な予防策は現時点で存在しないとしています。そのうえでOWASPは、モデルがだまされる前提でシステムを設計し、だまされても実害が出ないようにすることを求めています。
参照:OWASP GenAI LLM Top 10 2026(OWASP GenAI Security Project)
SQLインジェクションとの違い
SQLインジェクションは、データベースへの命令と入力値を分けて渡す仕組み(パラメータ化クエリ)で構造的に防げます。LLMにはこの仕組みがありません。英国の国家サイバーセキュリティセンター(NCSC)は2025年12月、プロンプトインジェクションは同じ方法では解消できない可能性があるとして、残るリスクとして扱い、被害を抑える設計を重視するよう勧めています。
参照:Prompt injection is not SQL injection (it may be worse)(NCSC・2025年12月8日)
ジェイルブレイクとの関係
ジェイルブレイクとは、モデルの安全上の制約を外させ、本来は拒否する内容を出力させる攻撃です。OWASPはジェイルブレイクをプロンプトインジェクションの一部と位置づけ、総務省のガイドラインもこの語法に沿っています。企業のAIシステムで被害が大きくなりやすいのは、制約を外されることより、社内データを読まれたり外部へ送られたりすることのほうです。
プロンプトインジェクションの2つの型(直接型と間接型)
原因が分かったところで、細工をした指示がどこから入り込むのかを整理します。総務省のガイドラインは、細工をしたプロンプトを入力する攻撃を直接プロンプトインジェクション、細工をしたデータを参照させる攻撃を間接プロンプトインジェクションと呼んでいます。
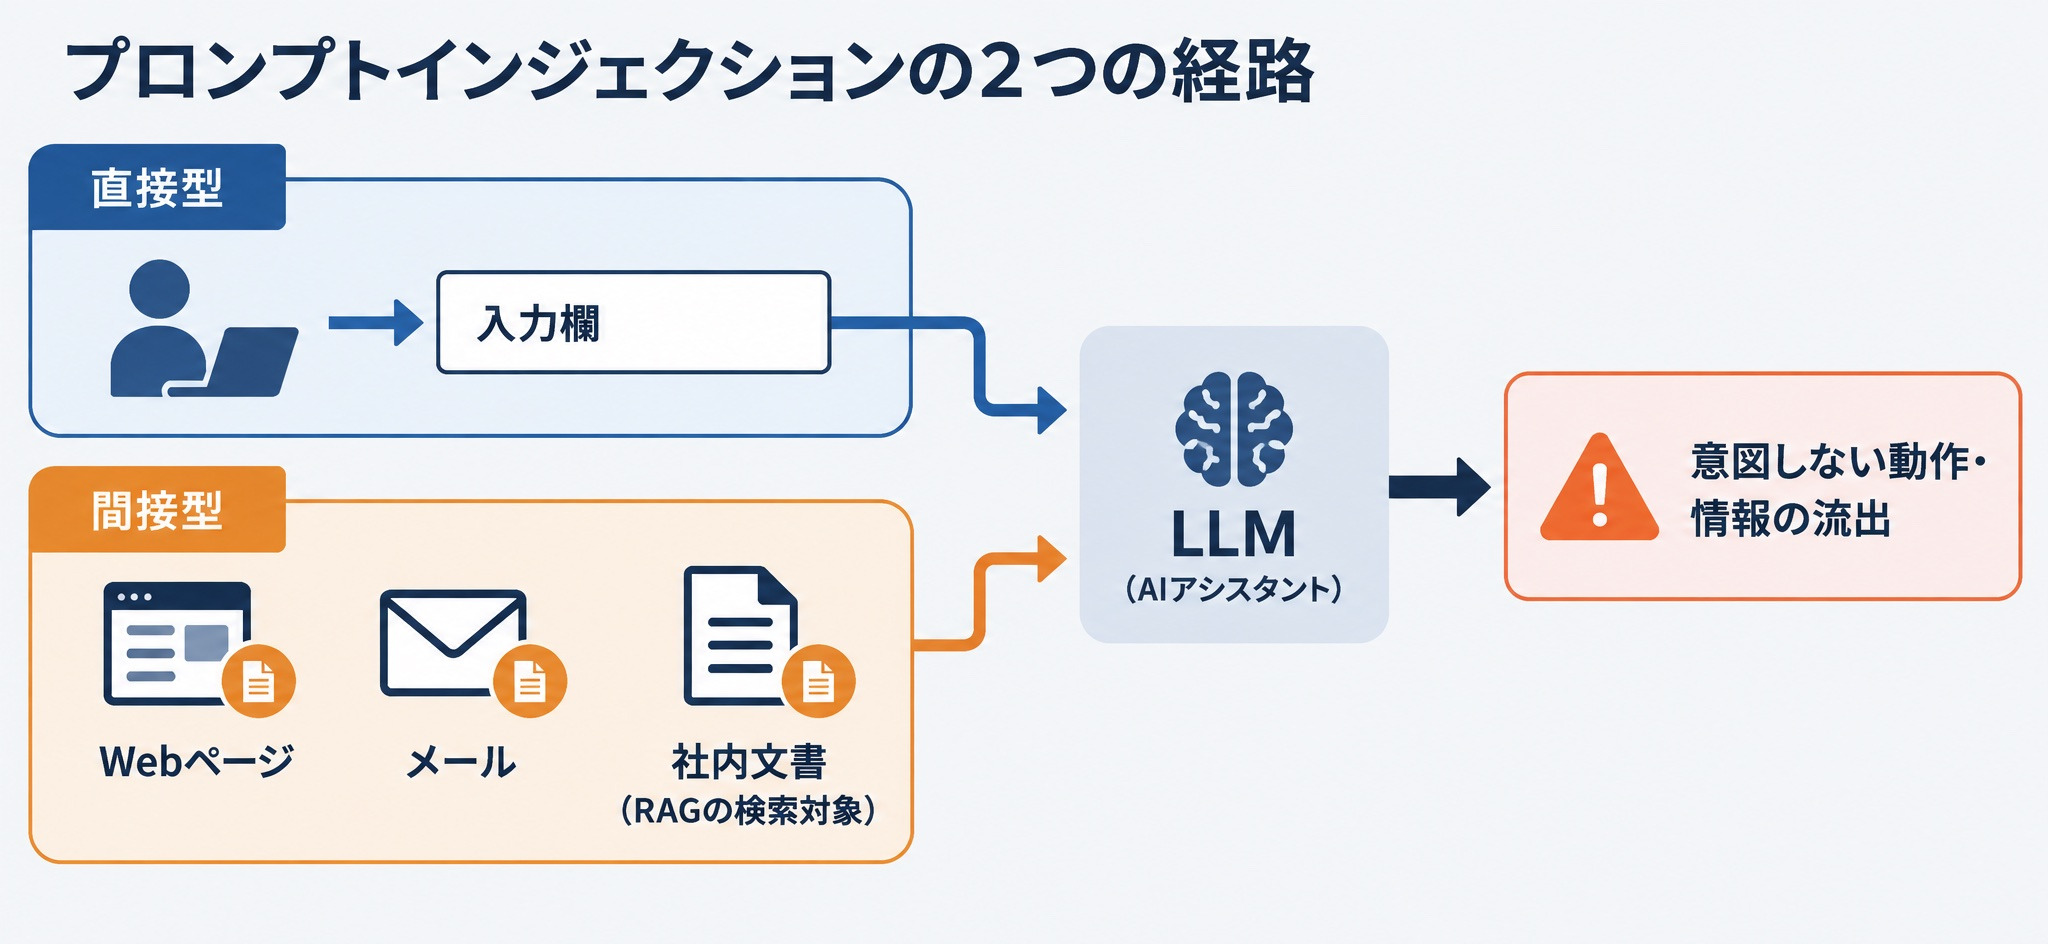
図のように、2つの型では、指示を仕込む人とAIを使う人の関係が異なります。
直接プロンプトインジェクション
直接型は、利用者がAIの入力欄から細工をした文章を入れる攻撃です。総務省のガイドラインは「指示の上書き」「ロールプレイ」「特殊な入力形式」「別のタスクへの置き換え」といった類型を挙げています。社外から受け取った文章を要約のために貼り付けたら別の指示が含まれていた、というように、悪意のない利用者が原因になる場合もあります。
間接プロンプトインジェクション
間接型は、AIが読み込む外部の情報に指示を仕込んでおく攻撃です。Webページ、メール、PDF、ツールの応答、RAGの検索結果、画像などが経路になり、利用者は仕込まれた指示を目にしません。OWASPの2026年版は、仕込まれる場所を信頼の度合いで3つに分けています。
- 信頼していない場所:公開Webページ、知らない送信者からのメール、検索結果
- 半分信頼している場所:公開された課題管理のチケット、外部パッケージの説明文、外部APIの応答
- 信頼している場所:自社のリポジトリ、データベース、社内文書、社内メール
注意したいのは3つ目です。問い合わせフォームのように誰でも書き込める経路があれば、攻撃者は社内の「信頼している場所」へ文章を入れられます。システムに侵入しなくても、AIがその文章を利用者の権限で読めば攻撃が成立します。
| 観点 | 直接プロンプトインジェクション | 間接プロンプトインジェクション |
|---|---|---|
| 指示が入る場所 | AIの入力欄 | Webページ・メール・文書・RAGの検索結果・ツールの応答 |
| 指示を入れる人 | 利用者本人(悪意がない場合を含む) | 利用者とは別の第三者 |
| 利用者が気づけるか | 自分で入力するため気づける | 画面に出ないことが多く、気づきにくい |
| 主な被害 | システムプロンプトや参照データの持ち出し | 利用者の権限を使った外部送信や連携システムの操作 |
この表のとおり、間接型は利用者に落ち度がなくても成立し、被害はAIに渡した権限の範囲まで広がります。入力欄の監視だけでは足りない理由がここにあります。
RAGの検索対象が経路になる理由
RAGでは、検索対象の文書に仕込まれた指示が、検索でヒットした時点でLLMへの入力に混ざります。総務省のガイドラインも、RAGを使う内部向けチャットボットの想定事例で、データストアのファイルを経由した間接型を主な攻撃シナリオに挙げています。汚染された文書は、それを検索するすべての利用者に影響します。OWASPの2026年版は、数百万件の知識ベースに細工をした文書を5件入れるだけで約9割の攻撃が成功した研究(W. Zou et al., 2025)を紹介しています。
もう1つの論点は閲覧権限です。検索用のデータベースに登録する段階で「部署内だけ」といった元文書の閲覧権限が落ちると、権限のない利用者の質問にも機密文書の内容が返ります。総務省のガイドラインは、RAG用データへの参照権限を利用者や役割に応じて設定することを対策に挙げています。RAG構築全体の対策はRAG構築におけるセキュリティリスクと5つの対策方法で解説しています。
OWASP Top 10 for LLM Applications 2026でのプロンプトインジェクションの位置づけ
経路を押さえたところで、業界の基準と国の指針での扱いを確認します。社内で対策の優先度を説明するときの根拠になります。
OWASP Top 10 for LLM Applications(いわゆるOWASP LLM Top10)は、LLMを組み込んだアプリケーションの主要なリスクを10項目に整理した文書です。2023年8月の初版、2024年11月の2025年版に続き、2026年8月に2026年版(v1.0)が公開されました。
| リスク | 2025年版 | 2026年版 |
|---|---|---|
| Prompt Injection(プロンプトインジェクション) | 1位 | 1位 |
| Sensitive Information Disclosure(機密情報の漏えい) | 2位 | 2位 |
| Excessive Agency(過剰な権限) | 6位 | 3位 |
| Supply Chain(サプライチェーン) | 3位 | 4位 |
| Data and Model Poisoning(データとモデルの汚染) | 4位 | 5位 |
| Unbounded Consumption(無制限な資源消費) | 10位 | 6位 |
| Misinformation(誤情報) | 9位 | 7位 |
| System Prompt Leakage(2026年版は Hidden Context Exposure に改称) | 7位 | 8位 |
| Vector and Embedding Weaknesses(ベクトルと埋め込みの弱点) | 8位 | 9位 |
| Improper Output Handling(不適切な出力処理) | 5位 | 10位 |
プロンプトインジェクションは1位を維持し、過剰な権限が6位から3位へ上がりました。この2つの動きが、2026年版を読むときの要点です。
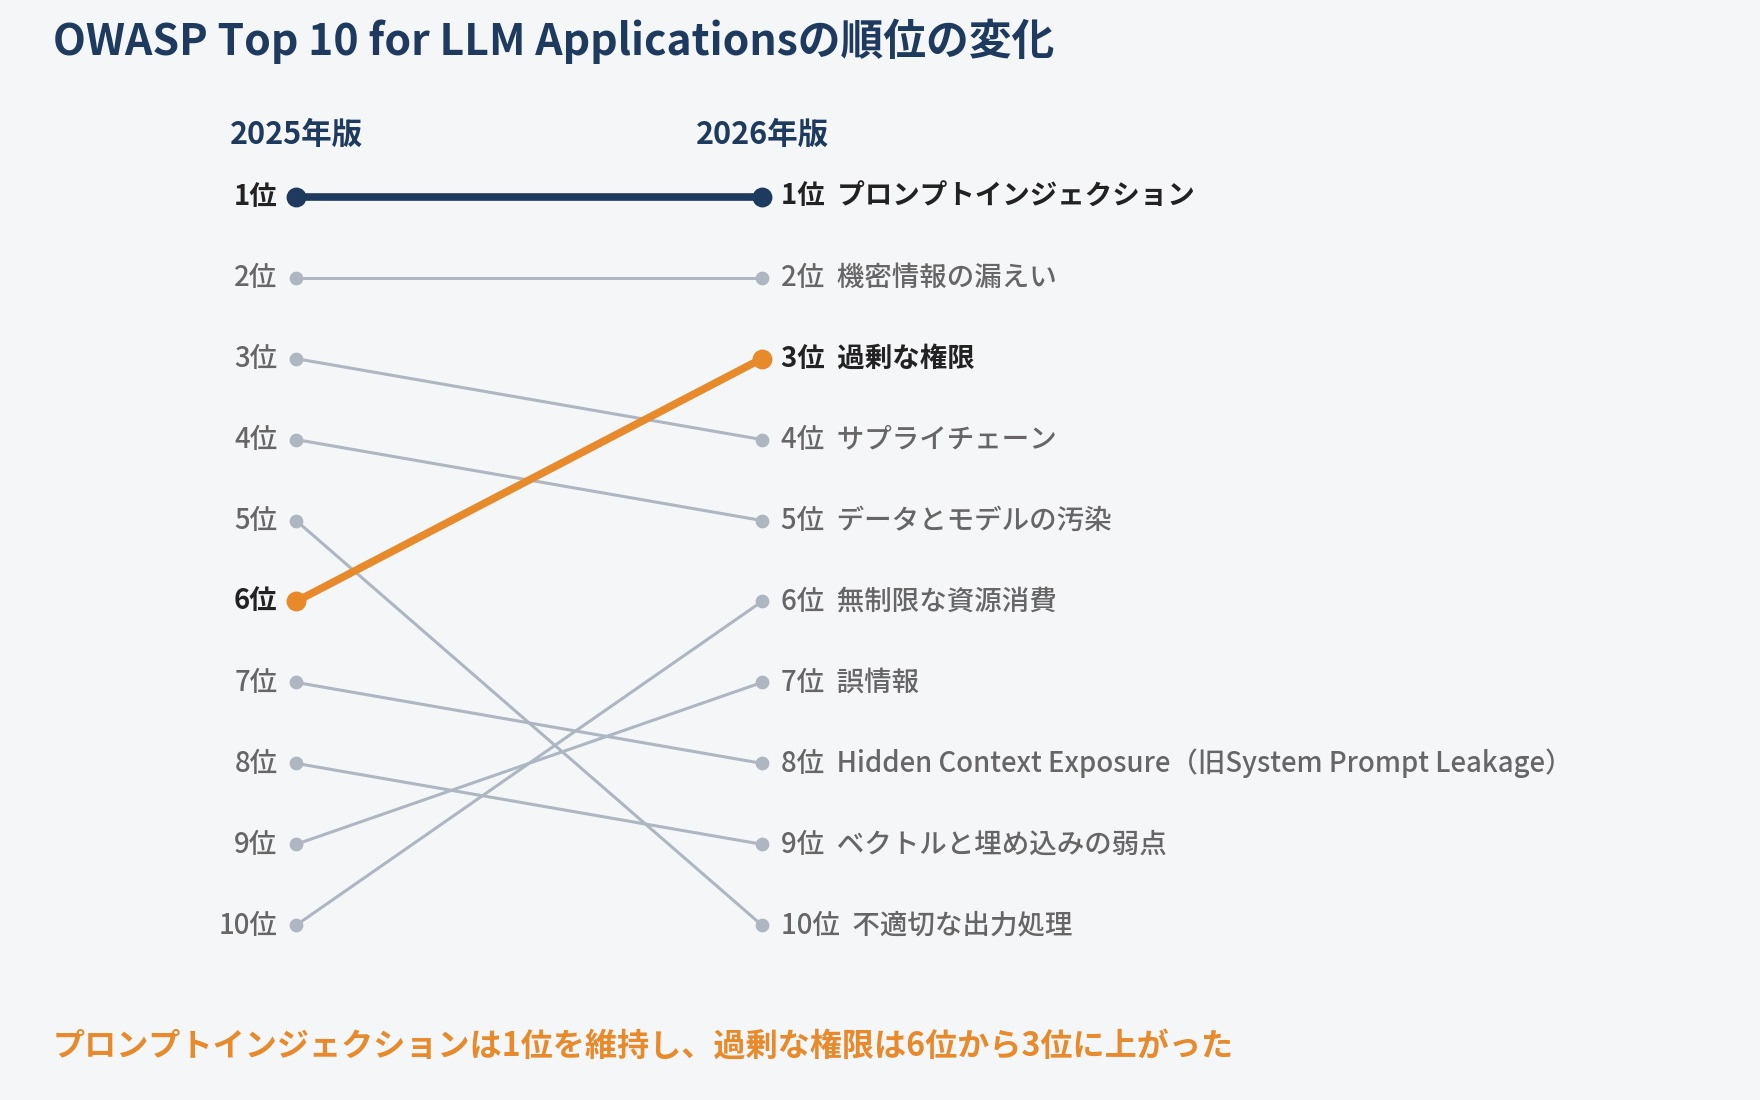
参照:OWASP GenAI LLM Top 10 2026、OWASP Top 10 for LLM Applications 2025(一覧)
2026年版でも1位を維持した理由
2026年版は初めて、実務家の投票に加えて事故の記録を順位づけに使いました。公開の脆弱性データベースなどから集めた7,714件のうち、分類できた6,639件を使い、投票に75%、事故データに25%の重みを置いています。
事故データだけで並べると、プロンプトインジェクションは10位圏外でした。OWASPはこれを、対策が進んだ結果、成功した攻撃が公開データベースに載りにくくなった「防御の効果」と説明し、1位を維持しています。また2026年版では、画像や音声に指示を埋め込む手口もこの項目に含めました。
過剰な権限(Excessive Agency)が3位に上がった
過剰な権限とは、LLMに不要な機能、不要な権限、確認なしで動ける自律性を与えている状態です。OWASPは、被害の大きいプロンプトインジェクションの多くは、乗っ取られたモデルが利用者の権限で使えるツールを持っていたために深刻化したとしています。プロンプトインジェクションは入口の問題、過剰な権限は被害の広がりの問題で、2つは組にして対策します。
なお、AIが自律的にツールを使うエージェントのリスクは、2025年12月に公開された「OWASP Top 10 for Agentic Applications」で扱われています。LLMのセキュリティリスク全体はLLMの利用で発生するセキュリティリスクと5つの対策方法で整理しています。
国内では総務省がガイドラインで対策を整理
総務省は2026年3月27日、「AIのセキュリティ確保のための技術的対策に係るガイドライン」を公表しました。LLMを組み込んだAIシステムの開発者と提供者を対象に、プロンプトインジェクションとDoS攻撃(サービス拒否攻撃)への対策を示しています。
対策は、学習による耐性の向上、システムプロンプトによる耐性の向上、ガードレールによる入出力と外部参照データの検証、オーケストレータ(LLMと外部システムの連携を制御する仕組み)やRAGの権限管理、の4つに整理されています。AIエージェントは、特有の脅威と対策を確定しにくいとして現時点では対象外です。
参照:総務省 報道資料「AIのセキュリティ確保のための技術的対策に係るガイドライン」の公表(令和8年3月27日)
公表されたプロンプトインジェクションの事例
基準の上で重く扱われていることを確認したので、実際に公表された事例を見ます。最初の3件はベンダーが修正を公表した脆弱性、4件目は報道で明らかになった事例です。攻撃の文面は載せず、経路と原因に絞ります。
Microsoft 365 Copilotの「EchoLeak」(CVE-2025-32711)
Aim Securityの研究者は、Microsoft 365 Copilotに細工をしたメールを1通送るだけで、利用者の操作なしに組織内の情報を持ち出せる脆弱性を報告しました。Copilotがメールを参照したときに指示が実行される間接型で、導入済みのプロンプトインジェクション検知もすり抜けたとされています。Microsoftは2025年6月11日に公表し、深刻度をCVSS 3.1の基本値9.3(Critical)としました。サービス側で修正済みで、利用者の対応は不要、悪用は確認されていないとしています。
参照:CVE-2025-32711(Microsoft Security Response Center)、EchoLeak(arXiv)
GitHub MCPサーバー経由で非公開リポジトリの情報が流出
Invariant Labsは2025年5月26日、GitHubのMCPサーバー(AIエージェントとGitHubをつなぐ連携部品)を使うエージェントの問題を公表しました。誰でも投稿できる公開リポジトリのissueに指示を仕込むと、issueの確認を頼まれたエージェントが非公開リポジトリを読み、その内容を公開リポジトリのプルリクエストに書き出しました。Invariant Labsは特定モデルの不具合ではなく構成の問題だとし、1回のセッションで扱うリポジトリを1つに絞る権限設定と監視を勧めています。
参照:GitHub MCP Exploited: Accessing private repositories via MCP(Invariant Labs)
GitHub Copilotが自分の設定を書き換えられた脆弱性(CVE-2025-53773)
研究者のJohann Rehberger氏は、ソースコードのコメントなどに仕込んだ指示で、GitHub Copilotのエージェントが設定ファイルを書き換え、ツール実行時の確認を省く状態にできる脆弱性を報告しました。確認なしでコマンドを実行できる状態になるものです。Microsoftは2025年8月12日に公表し(CVSS 3.1の基本値7.8、High)、同月の定例更新で修正しました。Rehberger氏は、エージェントが安全に関わる設定を人間の承認なしに変えられてはいけないと指摘しています。
参照:CVE-2025-53773(Microsoft Security Response Center)、GitHub Copilot: Remote Code Execution via Prompt Injection(Embrace The Red)
論文に隠された査読AI向けの指示
日経アジアは2025年7月1日、arXivに投稿された17本の論文に、AIで査読する人に向けた隠し指示が埋め込まれていたと報じました。著者の所属は8か国の14機関で、白い文字や極小の文字で好意的な評価を求めていました。契約書や応募書類をAIに要約・評価させる業務でも、人間に見えない指示が紛れ込む可能性を示した事例です。
参照:‘Positive review only’: Researchers hide AI prompts in papers(Nikkei Asia)
事例に共通する3つの条件
最初の3件では、次の3つの条件が同時にそろっていました。
- AIが、外部の人が書いた文章(メール・issue・コードのコメント)を読む
- AIが、機密データや重要なシステムにアクセスできる
- AIが、外部への送信や設定の変更を、人間の確認なしにできる
どれか1つが欠けていれば、指示が読まれても被害は限られていました。この共通点が、対策を組み立てる出発点になります。
プロンプトインジェクション対策は4つの層で組む
事例の共通点を踏まえ、どこで止めるかを4つの層に分けます。総務省のガイドラインは、対策を講じても脅威の要因を完全には排除できないと明記し、複数の対策を重ねるよう求めています。前の2層で指示の侵入を減らし、後ろの2層で被害の広がりを抑える、という組み合わせで考えます。
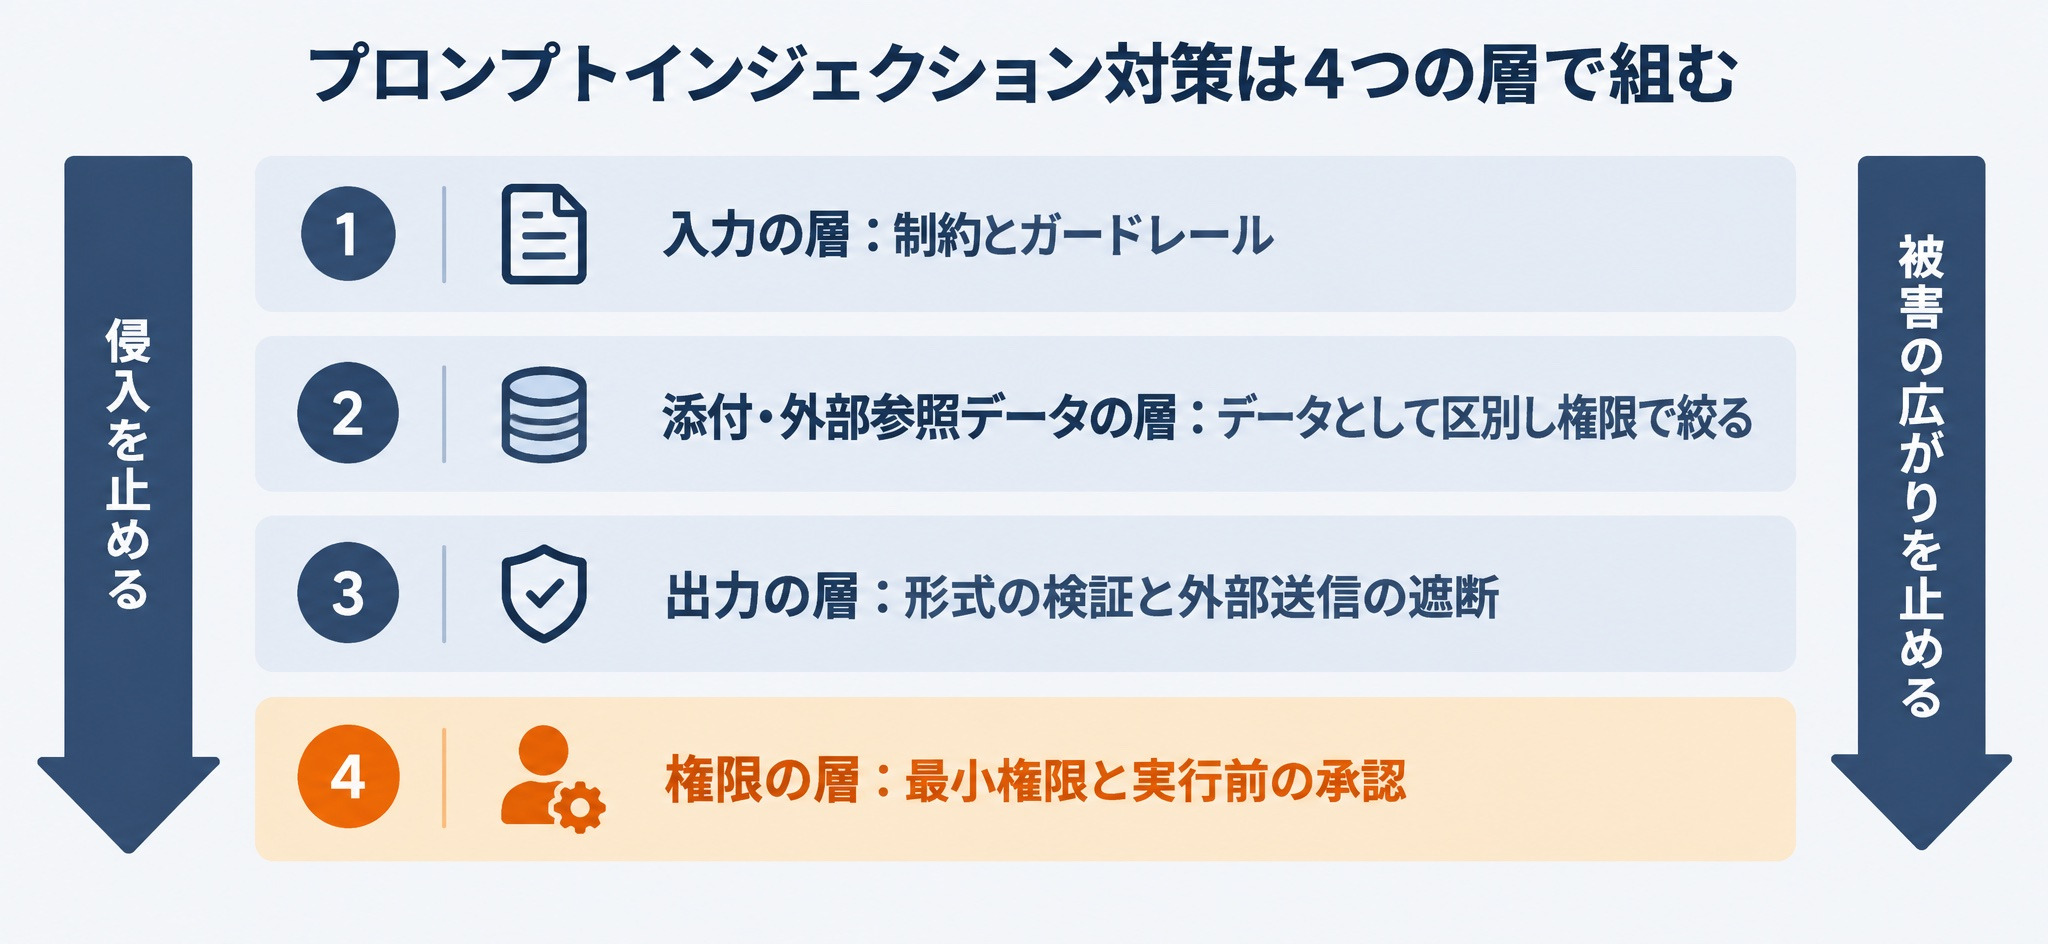
図の4層ごとに、主な対策を順に説明します。
1. 入力の層:システムプロンプトの制約とガードレール
- システムプロンプトに、担当する業務と禁止事項を具体的に書く(例:「社内規程の質問にだけ答える」「外部のアドレスに情報を送らない」)
- システムプロンプトにAPIキーなどの機密情報を書かず、別に管理する
- ガードレールで入力を検証する。ガードレールとは、入力、外部参照データ、出力を検証し、不正な指示や出してはいけない情報を検知したら処理を拒否する保護の仕組みです(総務省ガイドラインの定義)
2. 添付・外部参照データの層:データとして区別し、検索前に権限で絞る
- 外部から取ってきた情報は、利用者の指示とは別の枠に入れ、出どころを付けて渡す
- 画面に表示されない文字を、取り込むときと表示するときに取り除く
- 画像や音声、PDFも、文字を読み取ってから検査する
- RAGは、検索する前に利用者の権限で対象文書を絞り、権限のない文書を検索結果に入れない
3. 出力の層:形式の検証と外部送信経路の遮断
- 応答の形式を決め、LLMではなく通常のプログラムで検証してから後続の処理に渡す
- 応答に含まれる外部のURLや画像リンクは、許可した宛先以外は表示しない。画像の読み込みに見せかけて情報を外部へ送る手口を塞ぐためです
- 個人情報や社外秘の情報が応答に含まれていないかを検知する
4. 権限の層:最小権限と実行前の承認
- ツールとデータベースの権限を業務に必要な最小限にする(読むだけなら読み取り権限だけ)
- 認証情報はLLMに渡さずアプリケーション側で持ち、権限の判断はプログラムで行う
- 削除や社外へのメール送信など取り消せない操作は、実行内容をそのまま人間に見せて承認を得る
- ツールの呼び出しと応答のログを残す
| 層 | 主な対策 | 残る限界 |
|---|---|---|
| 入力 | システムプロンプトの制約、ガードレール | 言い換えや別の言語、符号化ですり抜けられる |
| 添付・外部参照データ | データの区別、見えない文字の除去、検索前の権限フィルタ | 区別の方法を知られると真似される |
| 出力 | 形式の検証、外部リンクの制限、機密情報の検知 | 形式に沿った悪意のある内容は通る |
| 権限 | 最小権限、認証情報の分離、承認、ログ | 承認が多すぎると確認が形だけになる |
この表のように、どの層にも限界があります。OWASPは、攻撃者が防御を調べ尽くした後も効果が残るのは被害を抑える側の対策だとしており、権限の層を後回しにしないことが要点です。国内完結のクラウドで多層防御を組む例はAIセキュリティとは。生成AI利用の5つのリスクと国内完結クラウドでの守り方、利用者側の対策は生成AIで発生する7つのセキュリティリスクで解説しています。
AIエージェントに権限を渡すときのプロンプトインジェクション対策
4つの層のうち、被害の大きさを決めるのは権限の層でした。メール送信やファイル操作を自律的に行うAIエージェントでは、この層の設計が最も問われます。
3つの条件を同時に持たせない(Agents Rule of Two)
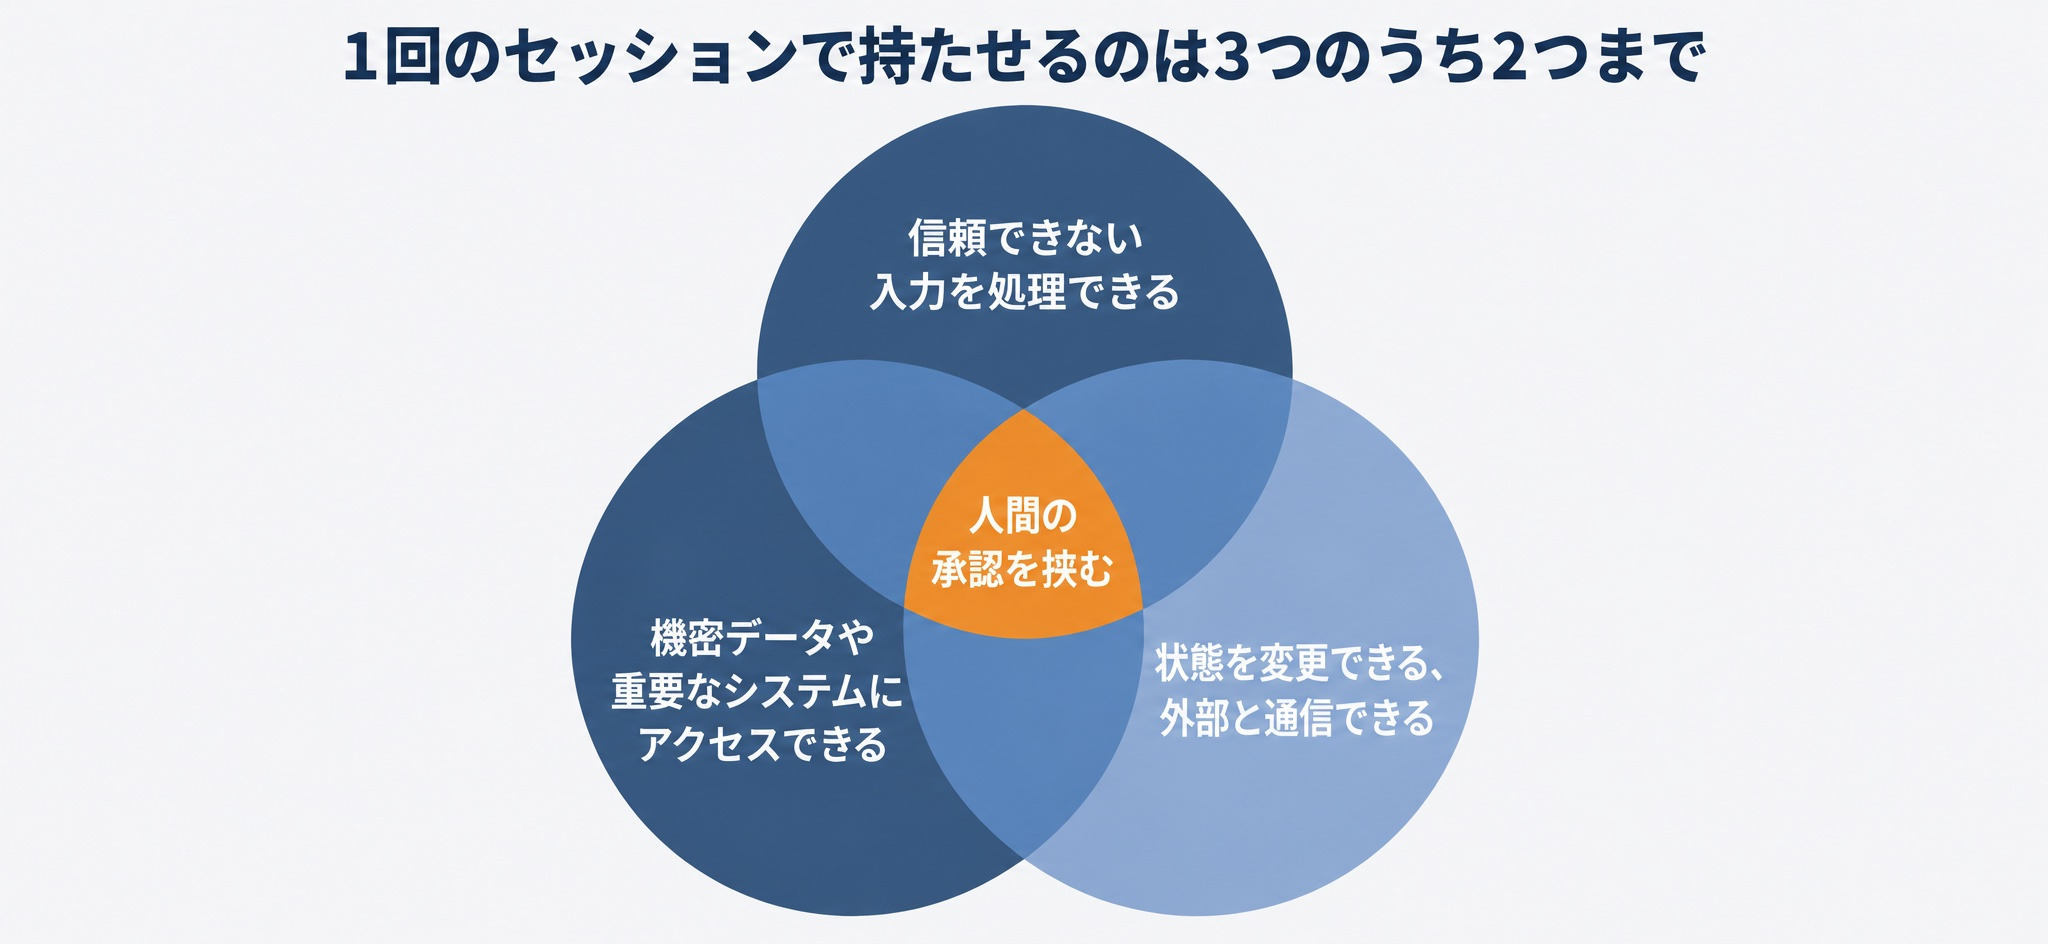
Metaは2025年10月31日、AIエージェントの安全設計の目安として「Agents Rule of Two」を公表しました。1回のセッションで、次の3つの性質のうち2つまでしか持たせないという目安です。
- 信頼できない入力を処理できる
- 機密データや重要なシステムにアクセスできる
- 状態を変更できる、または外部と通信できる
3つすべてが必要な業務では、人間による承認を挟みます。前の章の3件の事例は、いずれも3つの性質がそろっていました。OWASPの2026年版もRule of Twoを最低限の基準として引用しています。
参照:Agents Rule of Two: A Practical Approach to AI Agent Security(Meta AI)
例えば、社外からの問い合わせメールを読んで返信文を作るエージェントは、信頼できない入力を避けられません。そこで設計の段階で、顧客データベースへのアクセスを該当する1件に絞る方法と、返信の送信を担当者の承認後にする方法のどちらを採るかを決めます。
エージェント専用の権限と、取り消せない操作の承認
エージェントには人間の担当者の権限を引き継がせず、専用のアカウントで動かします。OWASPは、利用者の代わりに動くツールは、その利用者の認可の範囲内で最小限の権限で実行すべきだとしています。
- 専用アカウントに、必要な操作と有効期限だけを与える
- 取り消せる操作は自動で実行し、取り消せない操作は人間の承認に回す
- エージェントが自分の設定や権限を変更できないようにする
3つ目は、GitHub Copilotの事例への直接の対策です。
MCPサーバーと外部ツールを取り込むときの確認
エージェントに外部ツールをつなぐMCP(Model Context Protocol)サーバーも経路になります。OWASPの2026年版は、利用するMCPサーバーとツールの版を固定して提供元を確認すること、ツールの説明文に隠れた指示がないか確認することを求めています。MCPの仕組みはMCPとは。AIを社内のデータ・ツールに安全につなぐ仕組みを解説で解説しています。
ここまでプロンプトインジェクションの仕組みと対策を解説しましたが、「社内のRAGやAIエージェントを、プロンプトインジェクションを前提にした設計で作りたい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、RAGやAIエージェントを開発する段階から、検索前の権限フィルタ、エージェント専用の権限、取り消せない操作の承認フローを組み込むことが可能です。後からフィルタ製品を追加するだけでなく、AIが読み込む情報源と持たせる権限を設計の段階で絞れるため、被害が広がりにくいAIシステムを構築できます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
社内でプロンプトインジェクション対策を確認する手順
対策の組み立て方が分かったところで、自社で何から確認するかを手順にします。運用中のシステムにも、これから導入するシステムにも同じ順番で使えます。
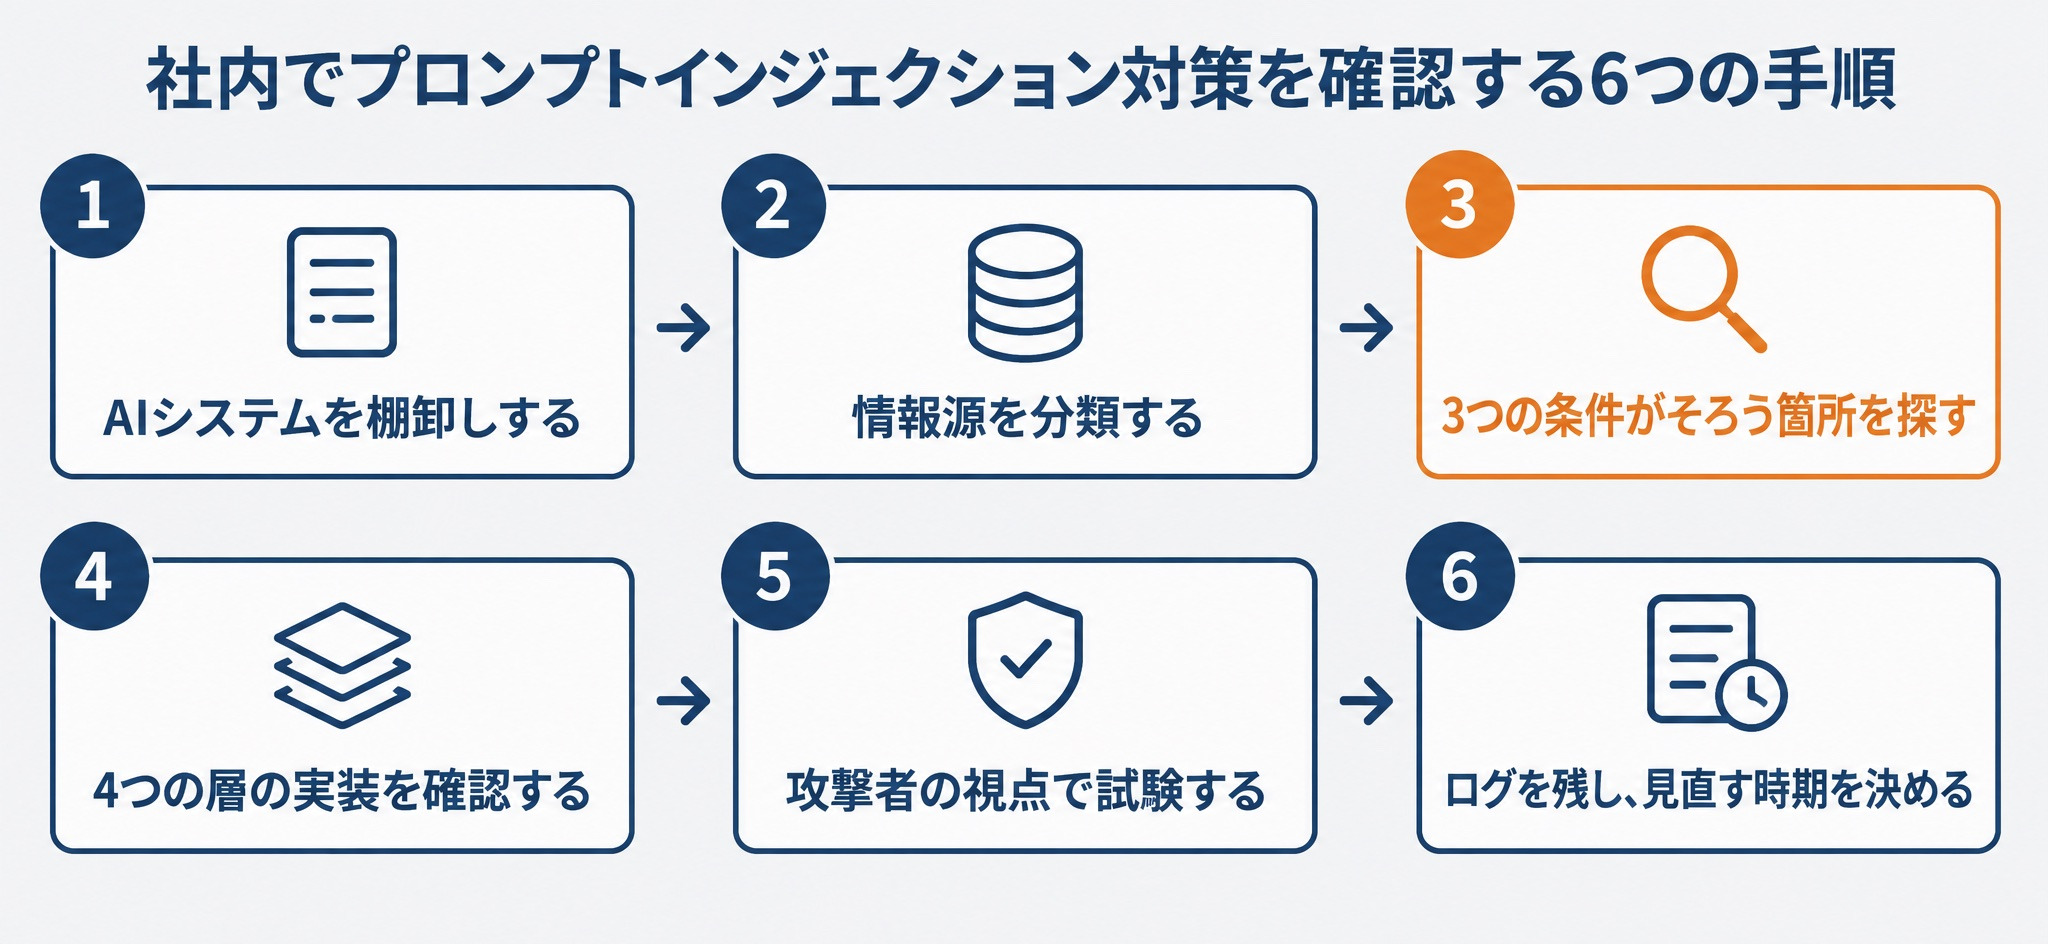
- AIシステムを棚卸しする:情報システム部門が、社内の生成AI、RAG、AIエージェントを一覧にし、それぞれ「何を読むか」と「何ができるか」を書き出します。
- 読み込む情報源を分類する:書き出した情報源が、信頼していない場所、半分信頼している場所、信頼している場所のどれに当たるかを決めます。外部の人が書き込める社内文書は、半分信頼している場所として扱います。
- 3つの条件がそろう箇所を探す:信頼できない入力、機密データへのアクセス、外部送信や更新の3つがそろうシステムを探し、権限を削るか承認を入れるかの方針を、システムの担当者と業務部門が話し合って決めます。
- 4つの層の実装を確認する:開発担当者が層ごとに対策の有無を確認します。RAGは、検索前に利用者の権限で文書を絞れているかを優先して確認します。
- 攻撃者の視点で試験する:レッドチーミング(攻撃者の視点で対策の効果を確かめる試験)を行います。AIセーフティ・インスティテュート(AISI)の手法ガイド第1.10版には、RAGを実装したシステムへの実施例があります。
- ログを残し、見直す時期を決める:入力、出力、ツールの呼び出しのログを保存します。総務省のガイドラインは、基盤モデルの変更時を見直しの契機に挙げています。RAGの対象文書を追加したときも見直します。
参照:AIセーフティに関するレッドチーミング手法ガイド(AISI)
最後に、次の項目で抜けがないかを確認します。
- システムプロンプトに機密情報が書かれていない
- RAGの検索結果に、利用者の閲覧権限を超える文書が含まれない
- 応答に含まれる外部リンクが、許可した宛先に限られている
- AIエージェントが専用のアカウントと最小限の権限で動いている
- 取り消せない操作の前に、人間の承認が入っている
すべてを一度に満たす必要はありません。手順3で見つけた箇所から手を付けると、限られた工数で被害の大きい経路を先に塞げます。
まとめ
本記事の要点を整理します。
- プロンプトインジェクションとは、LLMに細工をした入力を与えて不正な出力や動作をさせる攻撃で、LLMが指示とデータを区別できないため、モデル側だけでは防ぎきれない
- 直接型は入力欄から、間接型はWebページ・メール・社内文書・RAGの検索結果から指示が入り込み、間接型は利用者に落ち度がなくても成立する
- OWASP Top 10 for LLM Applications 2026で1位を維持し、被害の広がりを決める過剰な権限が3位に上がった
- 公表事例では、外部の文章を読む、機密データにアクセスできる、外部送信や操作ができる、の3条件がそろっていた
- 対策は入力・添付・出力・権限の4層で重ね、AIエージェントには3条件を同時に持たせない
入口を完全に塞ぐより、入られても被害が広がらない設計にすることが対策の中心です。まずは自社のAIシステムが何を読み、何ができるのかを棚卸しするところから始めてみてください。
プロンプトインジェクション対策の相談は「リベルクラフト」へ
ここまで、プロンプトインジェクションの仕組みと事例、4層の対策、社内で確認する手順を解説してきました。ただ、自社のRAGやAIエージェントのどこに権限フィルタや承認を入れるべきかは、システムの構成によって答えが変わります。
リベルクラフトでは、RAGやAIエージェントの要件定義から、検索前の権限フィルタ、エージェント専用の権限設計、承認フローの実装、PoC、本番運用までを一気通貫で支援しています。JAXA・防衛省情報本部など、機密性の高いデータを扱う現場でのAI開発の支援実績があります。
- 運用中のRAGやAIエージェントが、プロンプトインジェクションに耐えられる設計か確認したい
- 社内文書やメールを読むAIエージェントを、権限を絞った形で開発したい
- 生成AIのセキュリティ対策を、社内に説明できる状態にしたい
という方は、リベルクラフトへお気軽にご相談ください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。