Transformerとは。Self-Attentionの仕組みと3系統のモデル
Transformerの解説は数多くありますが、たいてい「関連する単語に注目する仕組み」という比喩で止まります。Self-Attentionが実際に何を計算しているのか、なぜ√d_kで割るのか、そしてBERTとGPTが同じ構造のどこを使い分けているのかまで踏み込んだものは多くありません。
そこで本記事では、
- Transformerとは何か。原論文が2017年に示したこと
- CNNからTransformerへ。画像認識の系譜が言語に渡るまで
- Self-Attentionが計算していること。Query・Key・Valueと式の意味
- Attention以外の部品(位置エンコーディング・残差接続・マスク)が担うもの
- Encoder only・Decoder only・Encoder-Decoderの3系統と、選び方
- 計算量の限界と、画像へ戻ってきた系譜
を解説します。すでに生成AIを業務で扱っていて、その中身を構造から理解したい方に向けた内容です。
「自社のデータでモデルを調整したいが、構成の設計から相談したい」という方は、リベルクラフトへご相談ください。
Transformerとは。再帰も畳み込みも使わないアーキテクチャ
Transformerとは、系列(単語の並びなど)を別の系列に変換するためのアーキテクチャで、再帰も畳み込みも使わず、Attentionだけで構成されている点に特徴があります。
論文「Attention Is All You Need」が2017年に示したこと
出典は Vaswani らの論文「Attention Is All You Need」です。arXivへの初回投稿は2017年6月12日、発表は NIPS 2017(当時の名称)でした。
著者は8名で、論文の脚注に「Equal contribution. Listing order is random.」と明記されています。所属も Google Brain と Google Research、そして当時 University of Toronto に在籍していた著者が混在しています。「第一著者が主著者」「全員がGoogle Brain」という説明はどちらも誤りです。
示された結果は次のとおりです。WMT 2014 の英独翻訳で Transformer (big) が 28.4 BLEU を記録し、アンサンブルを含む既存最良を2.0 BLEU以上上回りました。英仏翻訳では 41.8 BLEU に到達し、しかも従来の最高水準の4分の1未満の学習コストでこれを達成しています。
学習に使ったのは、NVIDIA P100 を8基積んだ1台のマシンです。baseモデルは約12時間、bigモデルでも3.5日で学習を終えています。英仏の数値はarXiv版の論文のAbstractと表によるもので、学会発表時の版では41.0と記載されている点に注意が要ります。
精度と学習コストの両方が同時に動いた点が、この論文の効き目でした。
CNNからTransformerへ。画像認識の系譜が言語に渡るまで
Transformerは突然現れたものではありません。画像認識で起きたことが、テキストに渡ってくる流れの先にあります。
CNNが画像認識で何をしたか。特徴量の設計を人手から外した
それまでの画像認識は、輪郭の抽出や色の分布といった手がかりを人が設計し、組み合わせる方式でした。CNN(畳み込みニューラルネットワーク)は、画像を小さな領域ごとに見ていき、線や角のような局所的な特徴を学習で自動的に拾います。
転機になったのが2012年です。Krizhevsky・Sutskever・Hinton の3名による畳み込みネットワークの論文(後にAlexNetと呼ばれるモデル)が、画像分類の競技会ILSVRC-2012で上位5候補の誤り率15.3%を記録しました。2位は26.2%で、差は10.9ポイントです。畳み込み5層と全結合3層、パラメータ6,000万という構成で、GPUで学習させた点も後の流れを決めました。
同じフィルタを画像全体で使い回すため重みの数が抑えられ、対象が少しずれても同じものとして扱えます。人が特徴量を設計しなくてよいという性質が、ここではっきり示されました。
CNNの設計思想が、テキストでは足りなかった理由
CNNの前提は「近いものは関係が強い」です。画像では妥当ですが、文章ではそうとは限りません。
テキストには、語順そのものが意味を決めるという難しさもあります。「私は魚が好き」と「魚は私が好き」は、使っている語がほぼ同じで意味はまったく違います。
「その会社が昨年から準備してきた製品は、ようやく今月出荷された」という文で、「製品」と「出荷された」の関係を捉えるには、間の語を飛び越える必要があります。畳み込みで距離を詰めるには層を重ねるしかなく、離れるほど層が必要になります。
RNNの限界を3つの軸で見る。計算量・逐次操作数・最大経路長
文章を扱うモデルとして使われていたのが RNN です。前の時点の出力を次の時点の入力に回す構造で、順番を扱えます。
原論文は、層の種類を3つの軸で比較しています。
| 軸 | 意味 | RNNの場合 |
|---|---|---|
| 層あたりの計算量 | 1層で何回の演算が要るか | 系列長に比例 |
| 逐次操作数 | 並列化できない処理が何段あるか | 系列長に比例(ここが致命的) |
| 最大経路長 | 離れた2語の情報が届くまでの距離 | 系列長に比例 |
問題は2つ目です。前から順に処理する以上、系列が長いほど並列化できない処理が増えます。計算資源を足しても学習時間が縮まりません。
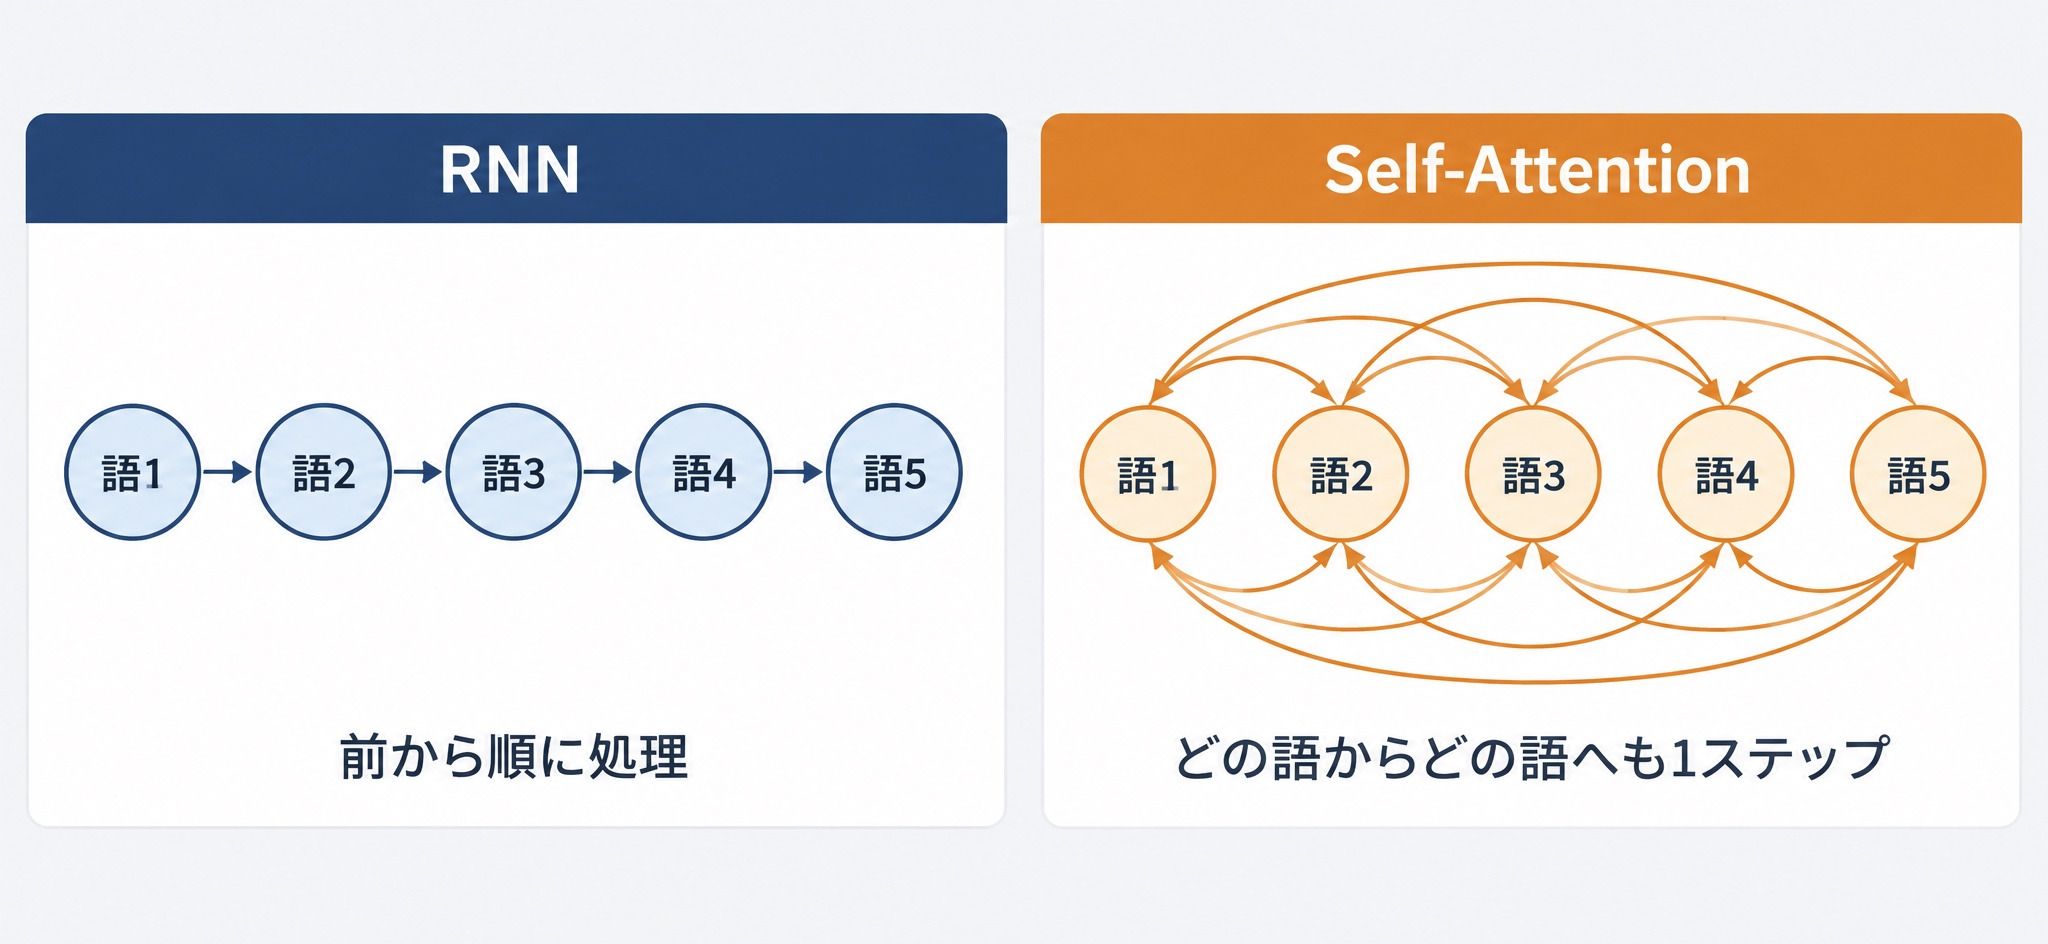
Self-Attention はこの3つの軸のうち、逐次操作数と最大経路長を定数まで落とします。どの語からどの語へも1ステップで届くためです。100語の文の1語目と100語目の関係も、RNNなら99回の受け渡しを経て届くところを、Self-Attentionでは1回の計算で直接結びつけます。受け渡しの途中で情報が薄まることがなく、全位置の計算を同時に行えるため、GPUの並列計算がそのまま学習時間の短縮につながります。
TransformerのSelf-Attentionは何を計算しているのか
「関連する単語に注目する」という比喩を、式に戻して見ていきます。
Query・Key・Valueが、それぞれ何を表しているのか
Self-Attention では、各語の表現から Query・Key・Value という3つのベクトルを作ります。検索の比喩で捉えると分かりやすくなります。
- Query:その語が「何を探しているか」
- Key:その語が「何として見つけられるか」
- Value:その語が「見つかったときに渡す中身」
ある語の Query と、文中すべての語の Key を照合して、どの語をどれだけ参照するかの重みを決めます。その重みで Value を足し合わせたものが、その語の新しい表現になります。
Self-Attention と呼ばれるのは、Query・Key・Value のすべてが同じ入力から作られるためです。
Scaled Dot-Product Attentionの式を分解する
原論文の式はこうです。
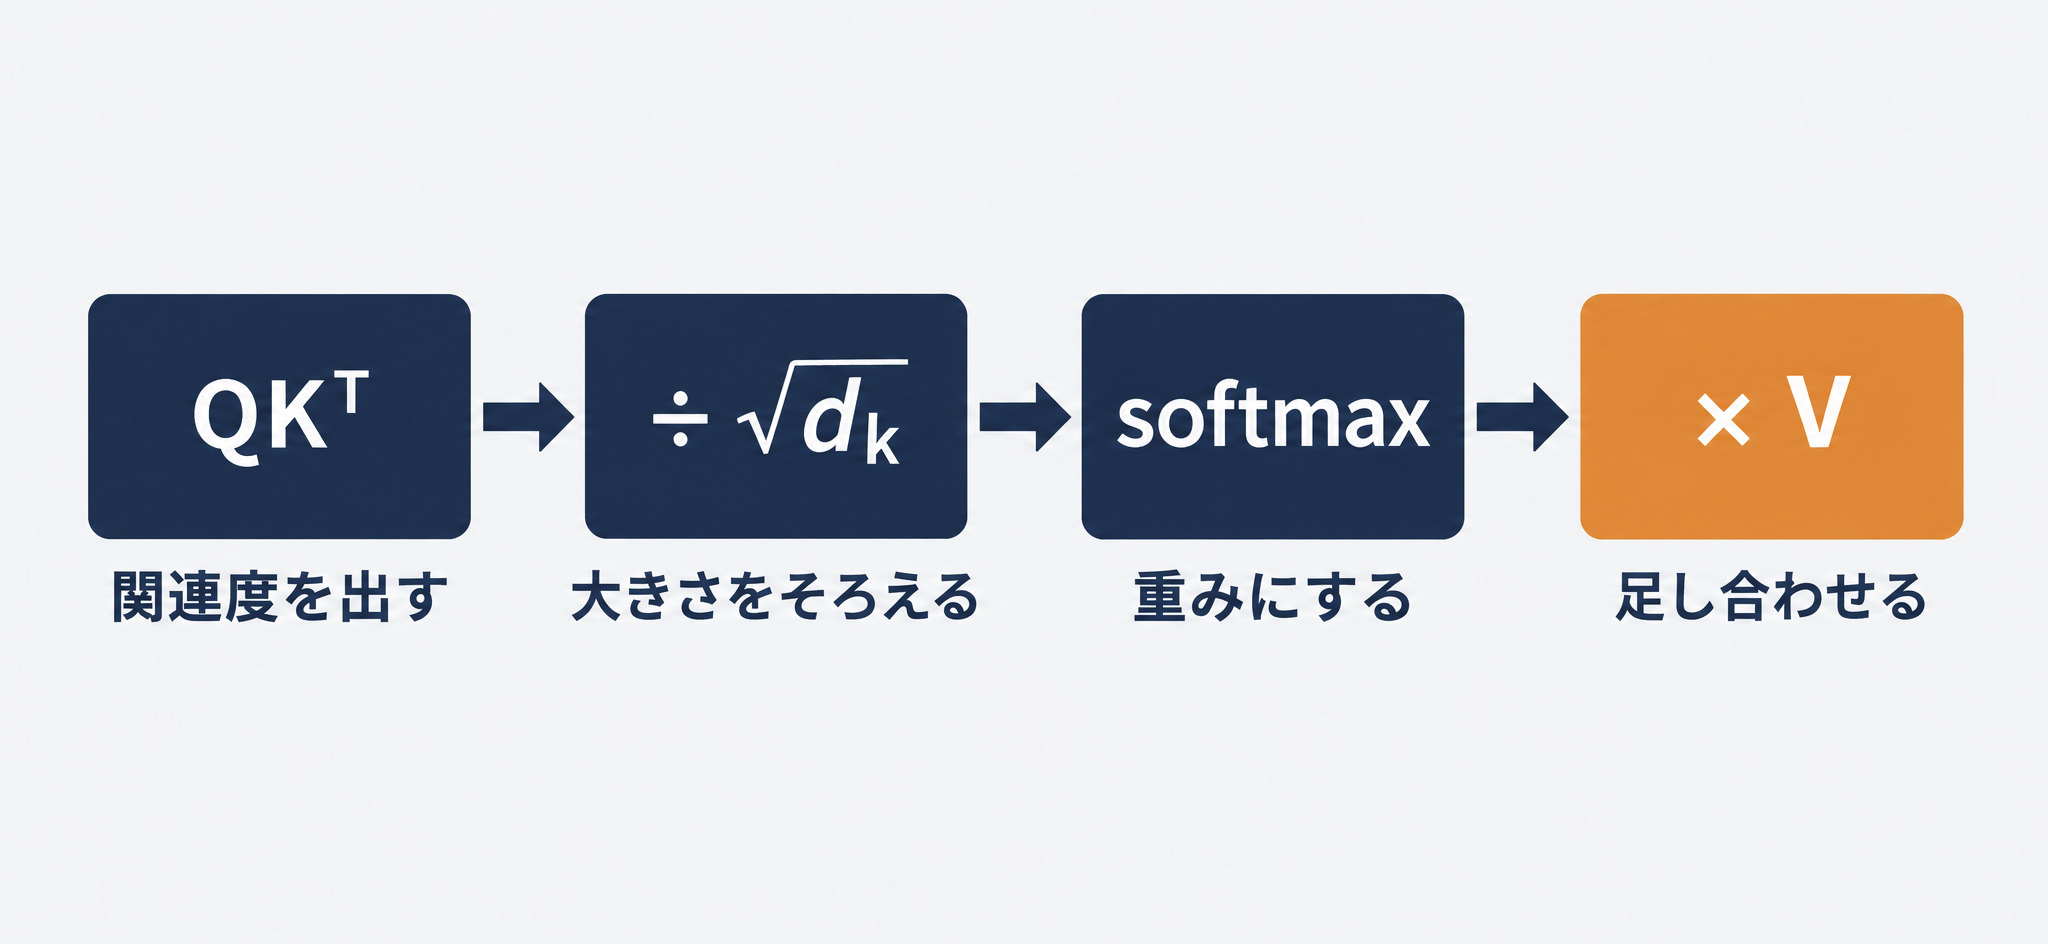
Attention(Q, K, V) = softmax(QK^T / √d_k) V分解すると4段階です。
- QK^T:Query と Key の内積を取る。向きが近いほど大きな値になり、これが関連度の生の点数になる
- √d_k で割る:点数の大きさをそろえる(理由は次で説明します)
- softmax:点数を合計が1になる重みに変換する
- V を掛ける:その重みで Value を足し合わせる
やっているのは、関連度で重みづけした平均です。特別な演算は入っていません。
なぜ内積を√d_kで割るのか
d_k は Key ベクトルの次元数です。原論文は、d_k が大きいと内積の値も大きくなり、softmax が勾配の小さい領域に押し込まれてしまうと説明しています。
softmax は、入力の差が大きいと出力がほぼ0か1に張り付きます。その状態では勾配がほとんど流れず、学習が進みません。√d_k で割るのは、この張り付きを避けて学習を安定させるための処理です。
性能を上げるための工夫ではなく、学習を成立させるための処理という位置づけです。
なぜ√d_kなのかも、原論文の脚注に書かれています。Query と Key の各成分が平均0・分散1の独立な値だとすると、内積の分散は d_k になります。成分1つどうしの積なら標準偏差は1ですが、d_k 個を足し合わせた内積では標準偏差が√d_k まで広がります。√d_k で割れば、次元数に関係なく標準偏差を1にそろえられる、という計算です。
実際に確かめてみます。d_k=64 として、Query を1つ、Key を10個、各成分を平均0・分散1の乱数で作り、softmax の重みを1万回計算しました。割らない場合、内積の標準偏差は約8になり、10個のうち1位の語に配られる重みは平均0.864でした。1万回の試行の34.2%では、1位の語が重みの0.99超を独占しています。√d_k で割った場合、1位の重みは平均0.320で、0.99を超えた試行はありませんでした。
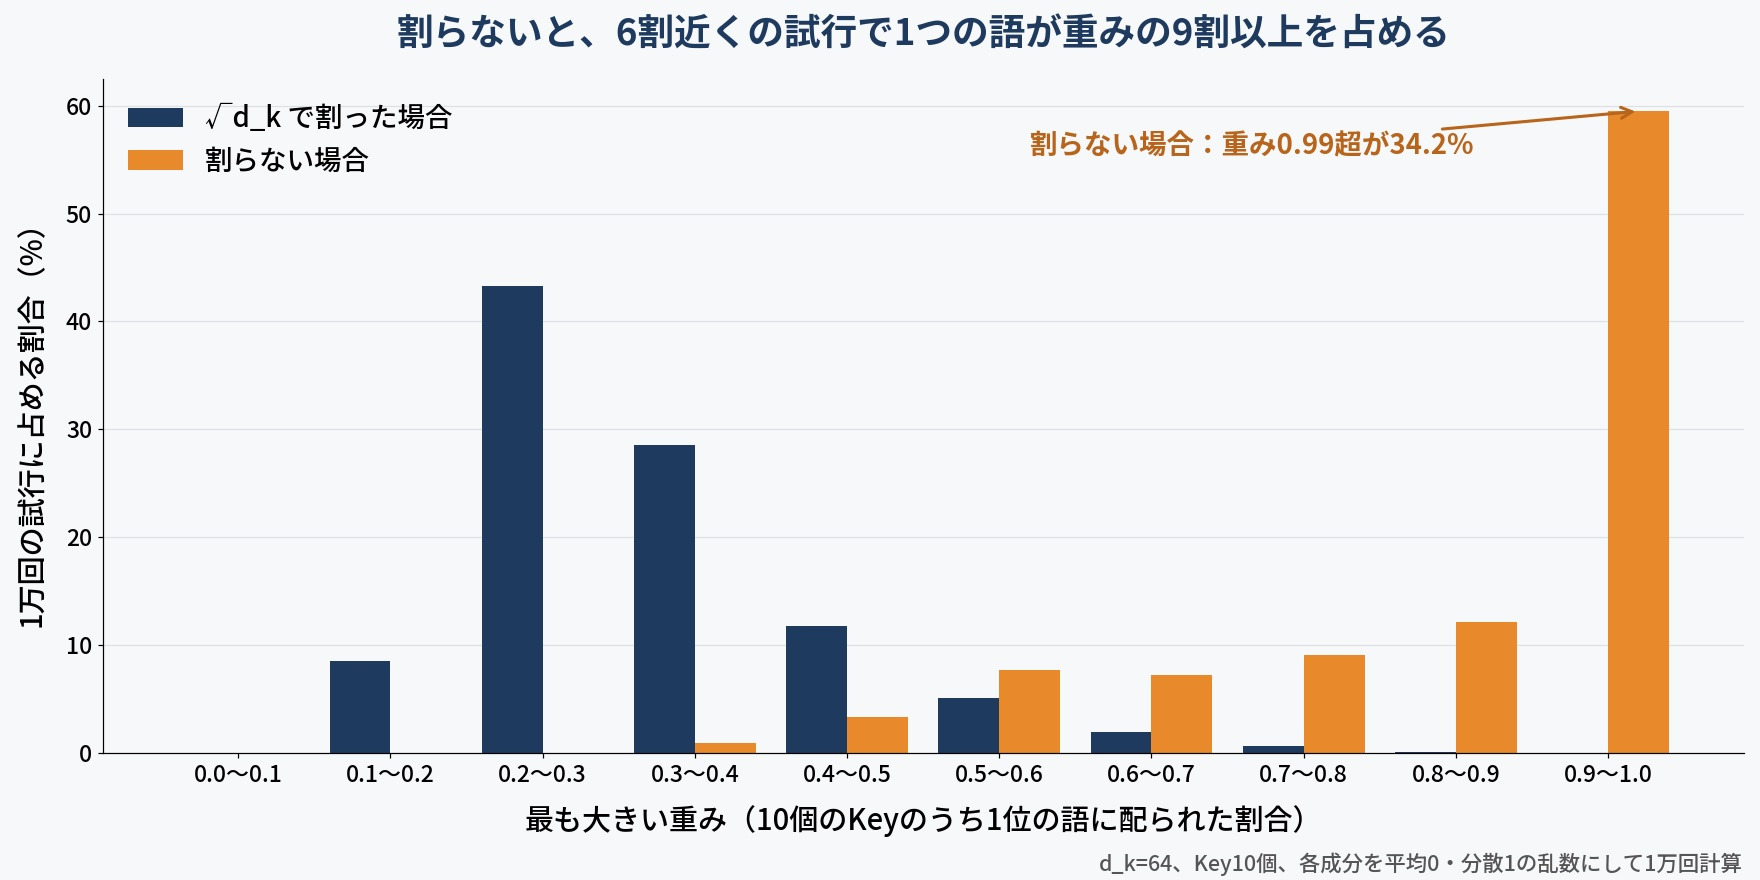
割らない場合は、6割近くの試行で1つの語が重みの9割以上を占めます。重みがほぼ0か1に固まると、どの語を参照するかを学習で少しずつ調整する余地がなくなります。
Multi-Head Attentionが分けているもの
Attention を1回だけ行うのではなく、複数の組(ヘッド)に分けて並行して行い、最後に結合します。
各ヘッドの次元を下げているため、総計算コストは全次元で1回行う場合と同程度です。コストを増やさずに、異なる観点の関係を同時に捉えられます。
原論文のbase設定は、N=6層、d_model=512、d_ff=2048、ヘッド数 h=8、d_k=d_v=64、ドロップアウト0.1です。パラメータ数はbaseが6,500万、bigが2億1,300万でした。
ヘッド数については、1ヘッドだと最良設定より 0.9 BLEU 劣り、逆に多すぎても品質が落ちると報告されています。増やせば良くなるわけではありません。
Transformerブロックの構造。Attention以外の部品が担うもの
Attention だけでは動きません。周辺の部品にもそれぞれ役割があります。
位置エンコーディング。並列化と引き換えに失った語順を足す
Self-Attention は全語を一度に見るため、そのままでは語の順番の情報がありません。「犬が猫を追う」と「猫が犬を追う」を区別できなくなります。
そこで、各位置に対応する値を入力の表現に足します。これが位置エンコーディングです。並列化を得た代わりに失った語順を、別の形で戻していることになります。
位置ごとの全結合層・残差接続・層正規化の役割
Attention の後には、各位置に独立して適用される全結合層が入ります。Attention が語どうしの関係を扱うのに対し、こちらは各位置の表現そのものを変換します。
そして、各サブ層の入出力を足し合わせる残差接続と、層正規化が入ります。層を深く重ねても勾配が流れるようにするための構造で、Transformerが6層、12層と重ねられるのはこの2つがあるためです。
Decoder側のマスク。まだ生成していない位置を見せない
Decoder は続きを生成する側です。学習時に正解の文全体を入力すると、これから生成すべき語がすでに見えてしまいます。
これを防ぐために、自分より後ろの位置への Attention を遮断します。これがマスクです。推論時と同じ条件で学習させるための仕組みと理解すると迷いません。
現在のLLMで、原論文から差し替えられた部品
ここまでの説明は2017年の原論文の構成です。現在の大規模言語モデルは、骨格を保ったまま部品のいくつかを差し替えています。たとえばMetaのLlama 2の論文は、原論文の標準的なTransformerを使ったうえで、次の変更を加えたと明記しています。
- 層正規化を各サブ層の前に置く(Pre-LN)。 原論文は残差接続の後に正規化していました。Xiongらの論文は、後に置く方式では出力に近い層の勾配が初期に大きくなり、学習率を徐々に上げる準備段階が要ると示しています。前に置くと、この準備段階がなくても学習が安定します
- 正規化の計算をRMSNormに簡略化する。 平均を引く処理を省き、値の大きさだけをそろえます
- 位置の情報を回転で与える(RoPE)。 RoFormerの論文が提案した方式で、入力に位置の値を足すのではなく、Query と Key を位置に応じて回転させます。これにより、2語の相対的な距離が内積に直接反映されます
- Key と Value のヘッドを共有する(GQA)。 GQAの論文は、複数の Query のヘッドで1組の Key と Value を共有することで、Multi-Head に近い品質のまま推論を速くできると報告しています。Llama 2 では34Bと70Bの大きなモデルに使われています
どれも Attention で関連度を計算し、重みで足し合わせるという本質は変えていません。学習を安定させる、長い入力に対応する、推論を軽くするという実務上の要求に合わせて、周辺の部品が差し替えられてきたと捉えると整理しやすくなります。
Transformerの3系統。Encoder only・Decoder only・Encoder-Decoder
派生モデルの名前を並べた解説は多くありますが、構造で分けると3つしかありません。ここが選定の判断軸になります。
| 系統 | 代表 | 入力の読み方 | 向いているタスク |
|---|---|---|---|
| Encoder only | BERT型 | 文全体を両方向から読む | 分類、固有表現抽出、検索の埋め込み |
| Decoder only | GPT型 | 左から右へ、前だけを見る | 文章生成、対話、要約 |
| Encoder-Decoder | 原論文型・T5型 | 入力を読んでから別の系列を出す | 翻訳、入力に忠実な変換 |
Encoder only(BERT型)。文全体を両方向から読む
マスクをかけず、文全体を見ます。ある語の表現に、その語より後ろの情報も入ります。
代表のBERTは2018年にGoogleが発表したモデルで、名前は Bidirectional Encoder Representations from Transformers(Transformerによる双方向のエンコーダ表現)の略です。名前のとおり、Transformer の Encoder 側だけを取り出しています。
文の意味を掴む用途に向いており、分類や、検索のための埋め込みを作る場面で使われます。一方で、続きを生成する用途には構造的に向きません。
Decoder only(GPT型)。左から右へ続きを生成する
マスクをかけ、前の語だけを見ます。次の語を予測する形で学習するため、そのまま生成に使えます。
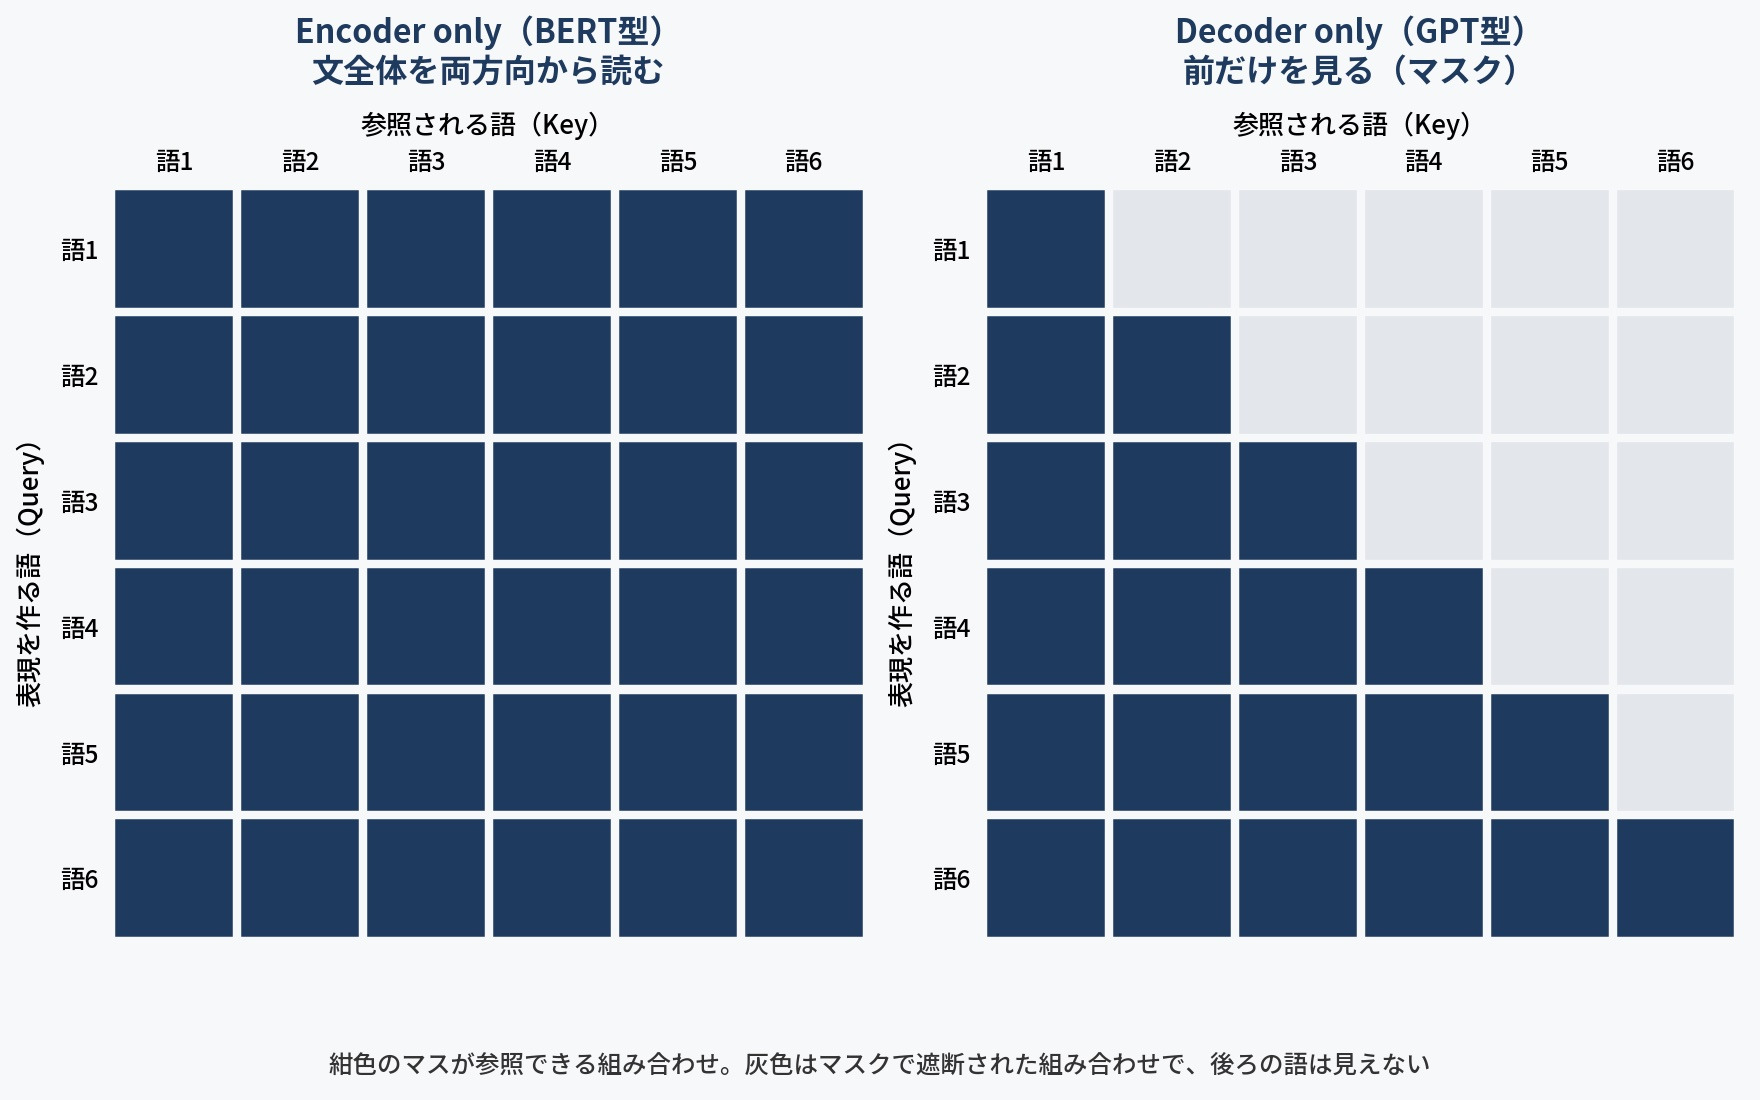
2つの系統の違いは、この参照できる範囲の差だけです。図の左は6語すべてが互いを参照でき、右は語3の表現を作るときに語1から語3までしか使えません。2018年にOpenAIが公開した最初のGPTの論文も、マスクをかけたSelf-Attentionを持つ12層のDecoderだけで構成したと記しています。
GPTの3文字は Generative(生成する)、Pre-trained(事前学習済み)、Transformer です。名前の最後の文字が、ここまで見てきた構造そのものを指しています。
いま業務で使われている大規模言語モデルの多くがこの系統です。LLM全体の位置づけはLLMとは何か。仕組みと種類、企業での活用方法をわかりやすく解説で、文章が生成される流れは生成AIの仕組みとは。データからテキストが生成されるまでをわかりやすく解説で扱っています。
Encoder-Decoder(原論文型・T5型)。入力を別の系列に変換する
原論文の構成です。Encoder が入力を読み、Decoder がそれを参照しながら出力を生成します。後継の代表であるT5は、翻訳も要約も分類も「テキストを入れてテキストを出す」形にそろえて1つのモデルで扱いました。T5は Text-To-Text Transfer Transformer の略です。
入力に忠実な変換が要る翻訳のようなタスクに向きます。ただし、Decoder only のモデルが十分に大きくなった結果、多くのタスクがそちらで解けるようになったため、新規に選ぶ場面は減っています。
自分のタスクでどの系統のTransformerを選ぶか。3ステップで絞る
- 出力は何か。ラベルや埋め込みなら Encoder only、文章なら Decoder only を先に検討します
- 入力と出力の対応はどれだけ厳密か。入力を落とさず変換する必要があるなら Encoder-Decoder が候補に入ります
- 調達できるモデルはどれか。実務ではここが効きます。使いたい日本語モデルがどの系統で配布されているかで、選択肢は絞られます
ここまで3系統の違いと選び方を解説しましたが、「構造の違いは分かったが、自社のデータとGPUで本当に回しきれるのか」という方は、リベルクラフトへご相談ください。
リベルクラフトは、ファインチューニングとローカルLLM構築の受託実績があります。どの系統のモデルを選ぶか、更新するパラメータをどこまで絞るか、学習環境と推論環境をどう分けるかを、実際の案件で組み立ててきました。実務者がご自身のチームで回せる状態を目指す場合は、Craft CollegeのDS ADVANCEDという進め方もあります。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
Transformerの限界と、画像へ戻ってきた系譜
万能ではありません。構造から来る制約があります。
系列長に対して、計算量とメモリが2乗で増える
Self-Attention は、すべての語の組み合わせで関連度を計算します。語がn個あれば n×n の計算が要ります。
つまり系列長が2倍になると、計算量もメモリも4倍になります。1,000トークンなら関連度の組み合わせは100万通りですが、8,000トークンでは6,400万通りに増えます。長い文書をそのまま入れると、GPUのメモリが先に尽きます。長文を扱う手法が次々に提案されているのは、この制約が理由です。
実際に動かすときのGPUの見積りはローカルLLMに必要なGPUスペックで扱っています。
Transformerを選ばない判断もある
表形式のデータで数値を予測する、といった用途では、勾配ブースティングのような決定木系の手法のほうが精度でも学習時間でも上回ることが少なくありません。
データ件数が少ない場合も同じです。Transformerは大量のデータを前提に設計されています。何でもTransformerにする必要はありません。
自社のデータでモデルを調整する方法はファインチューニングとは。仕組み・種類・RAGとの違いをわかりやすく解説とLLMファインチューニングの実装5ステップで、自社環境に置く場合の構成はローカルLLMで整理しています。
Vision Transformer。画像パッチを単語として扱う
最後に、系譜が一周します。
Vision Transformer は、画像を一定サイズのパッチに分割し、各パッチを単語のように扱って Transformer に入力します。CNNの畳み込みを使わずに画像を扱う構造です。
2020年に発表された原論文のタイトル「An Image is Worth 16×16 Words」は、16×16画素のパッチを1語として扱うことを指しています。この論文は、条件によってはCNNに負けることも正直に報告しています。ImageNet規模のデータで強い正則化なしに学習すると、同程度の規模のCNNより数ポイント劣りました。Transformerは「近いものは関係が強い」というCNNの前提を持たず、データが少ないとうまく一般化できないことが理由です。1,400万枚から3億枚の規模で学習すると結果が逆転し、論文はこれを「大規模な学習が、帰納バイアス(モデルに組み込まれた前提)に勝る」と表現しています。先に述べた「データ件数が少ないならTransformerにこだわらない」という判断は、画像でも同じように成り立ちます。
CNNの設計思想がテキストで足りなかったところからTransformerが生まれ、そのTransformerが画像へ戻ってきた。この往復が、いまのマルチモーダルなモデルの土台になっています。
まとめ
- Transformerとは、再帰も畳み込みも使わず、Attentionだけで系列を扱うアーキテクチャ
- 原論文はWMT 2014の英独で28.4 BLEU、英仏で41.8 BLEUを記録し、学習コストも従来の4分の1未満だった
- Self-Attentionがやっているのは、Query と Key の内積で関連度を出し、その重みで Value を足し合わせる処理。特別な演算は入っていない
- √d_k で割るのは性能向上のためではなく、softmaxが勾配の小さい領域に入るのを避けて学習を成立させるため
- Multi-Head は各ヘッドの次元を下げているため、総計算コストは1回分と同程度。ヘッドは増やせば良いわけではない
- 派生モデルは構造で見ると Encoder only・Decoder only・Encoder-Decoder の3系統しかない
- 系列長に対して計算量とメモリが2乗で増える。長文をそのまま入れるとGPUが先に尽きる
Transformerを使ったモデル開発は「リベルクラフト」へ
「構造は理解できたが、自社のデータで実際に動かすところまでは設計が見えない」と感じた方も多いのではないでしょうか?
リベルクラフトは、ファインチューニングとローカルLLM構築の受託開発を行っています。どの系統のモデルを選ぶか、限られたGPUで学習と推論を成立させる構成、社外に出せないデータを前提とした環境設計、評価データの作り方まで、要件定義から本番運用まで一貫してお手伝いしています。
⇨AI開発・ファインチューニングのご相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。