回帰分析とは。単回帰と重回帰の違いから決定係数の読み方までわかりやすく解説
「売上を左右しているのは、広告費なのか、店舗数なのか、それとも気温なのか」。「来月の数字を、根拠を持って見積もりたい」。こうした場面で使われるのが回帰分析です。
統計の教科書に出てくる古い手法、という印象があるかもしれません。ただ、いま業務で使われている予測モデルの多くは、この回帰分析を土台にしています。機械学習の入口でもあります。
そこで本記事では、
- 回帰分析とは何か。何が分かる手法なのか
- 単回帰分析・重回帰分析・ロジスティック回帰分析の違い
- 最小二乗法で回帰直線が決まる仕組み
- Excelで実行する5つの手順
- 決定係数・p値・回帰係数の読み方
- 実務でつまずく4つの注意点
- Pythonの予測モデルへ広げる進み方
を解説します。出力された表の読み方が分からず止まっている方にも役立つ内容です。
「自分のデータで予測モデルを作れるようになりたい」という方は、リベルクラフトへご相談ください。
回帰分析とは。目的変数と説明変数の関係を式にする手法
回帰分析とは、結果にあたる数値と、その要因にあたる数値の関係を式で表し、要因の影響度を調べたり、将来の数値を予測したりする手法です。
総務省統計局の「なるほど統計学園」では「回帰分析は、複数の変数の関係を表す、最も適した線を作成して数式化する分析手法です」と説明されています。
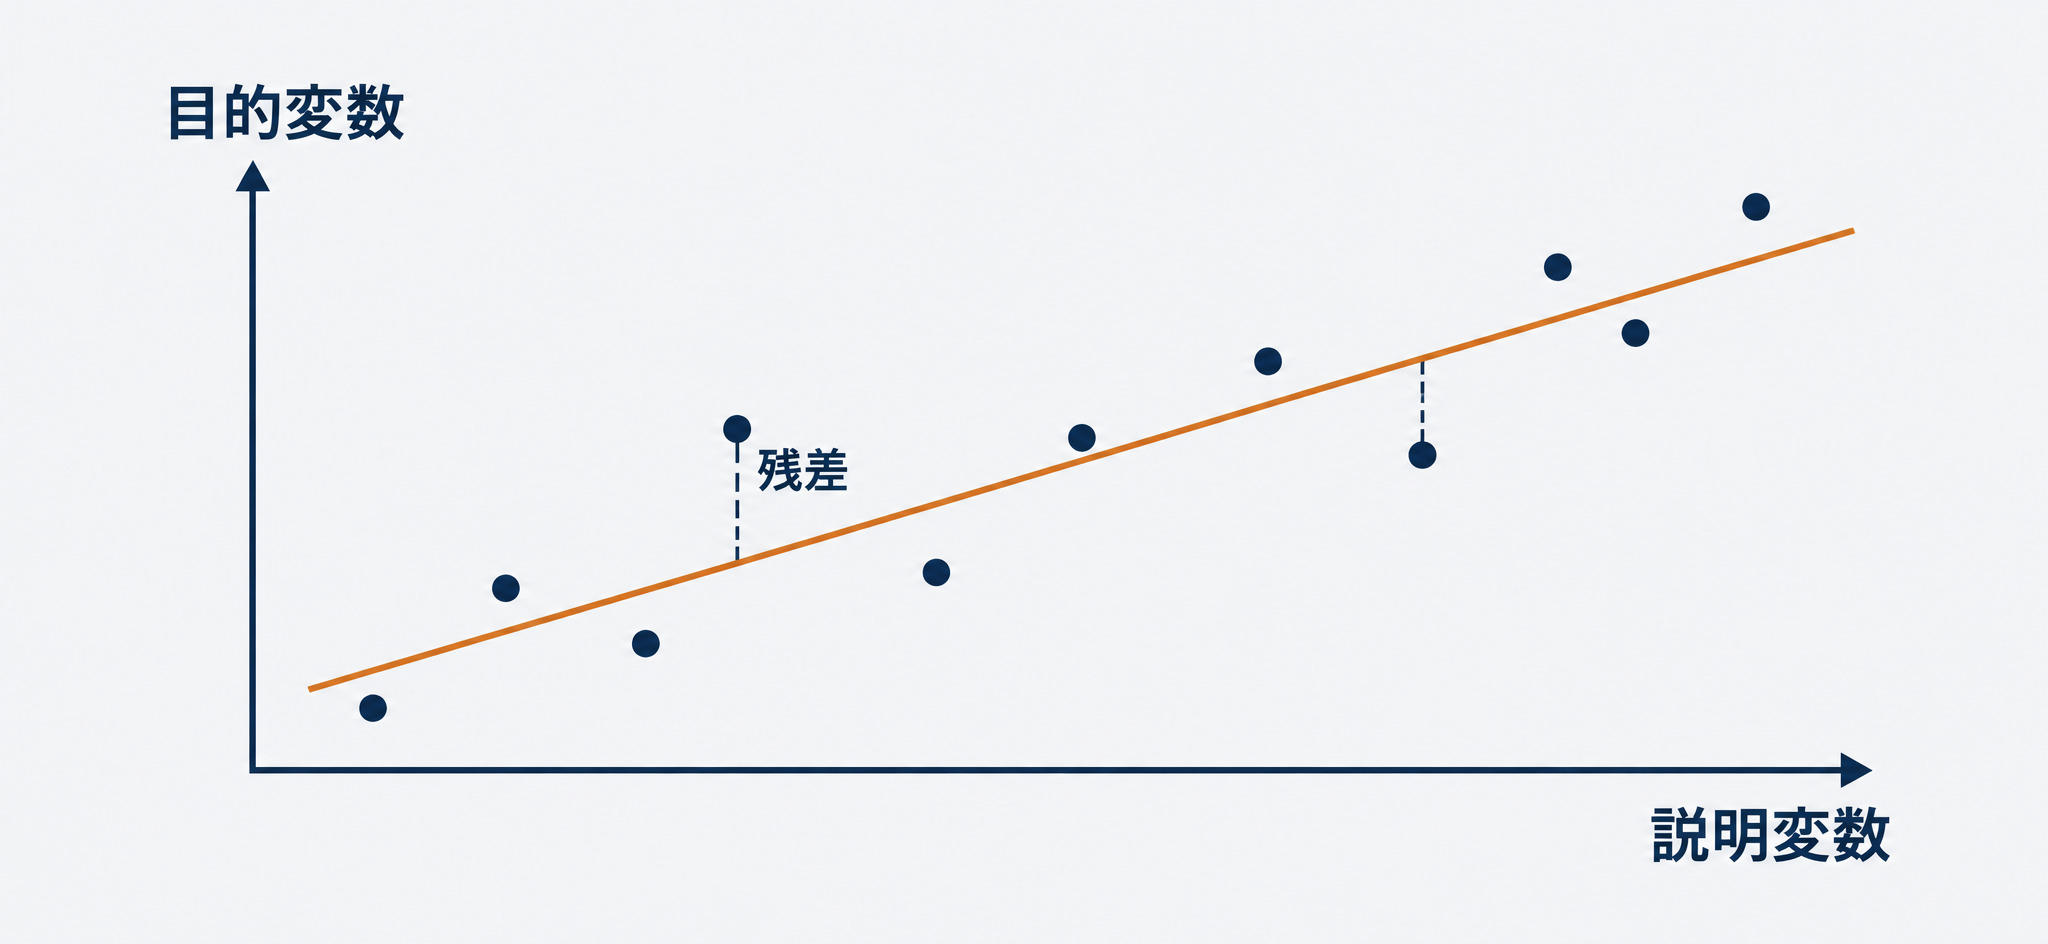
用語を先にそろえておきます。予測したい結果のほうを目的変数(被説明変数ともいいます)、その要因になる数値のほうを説明変数(独立変数ともいいます)と呼びます。本記事ではこの2語で統一します。
回帰分析でわかる2つのこと。要因の影響度と、将来の予測
回帰分析から得られるものは2つあります。
ひとつは影響度です。広告費を10万円増やすと売上がいくら増えるのか、という形で、どの要因がどれだけ効いているかが数値で出ます。
もうひとつは予測値です。できあがった式に来月の広告費や気温を入れれば、売上の見込みが出ます。
業務でよく使われるのは、次のような場面です。
- 売上の見込み。広告費や店舗数、季節から、来月や来期の売上を見積もる
- 需要の見込み。気温や曜日、販促の有無から、商品の出荷数を見積もり、在庫や人員の計画に使う
- 価格の見積もり。広さや駅からの距離、築年数から、不動産の価格の相場を出す
- 施策の効果の確認。どの広告媒体に使った費用が、問い合わせ件数と一緒に動いているかを比べる
いずれも「結果を表す数値が1つあり、それに関わりそうな数値が過去の分だけ記録されている」という点が共通しています。この2つが揃っていれば、回帰分析の題材になります。
回帰分析は機械学習の「教師あり学習」の回帰そのもの
ここが本記事でいちばん押さえてほしいところです。
機械学習には、正解つきのデータから学ぶ教師あり学習という型があります。その中で、数値を当てるタスクを回帰と呼びます。回帰分析は、この回帰タスクそのものです。
過去の実績という正解つきのデータから関係を学び、新しいデータに対して数値を出す。この流れは、機械学習でやっていることと同じです。つまり回帰分析を理解すれば、機械学習の入口に立っていることになります。
相関分析との違い。関係の強さを測るか、予測の式を作るか
よく混同されるのが相関分析です。
相関分析が出すのは、2つの変数の関係の強さを表す1つの数値(相関係数)です。強い関係があるかどうかは分かりますが、どちらが原因かは分かりませんし、予測値も出ません。
回帰分析は、予測に使える式を作ります。この違いは大きいところです。ただし、関係の強さが分かることと、原因が分かることは別という点は、回帰分析でも同じです。この論点は注意点のところで改めて扱います。
回帰分析を含むデータ分析の手法全体はデータ分析の手法とは。代表的な8つの手法と選び方をわかりやすく解説で整理しています。
回帰分析の種類。単回帰分析・重回帰分析・ロジスティック回帰分析
回帰分析には型があります。説明変数の数と、目的変数の種類で分かれます。
| 種類 | 説明変数 | 目的変数 | 使う場面 |
|---|---|---|---|
| 単回帰分析 | 1つ | 数値 | 要因を1つに絞って関係を見たいとき |
| 重回帰分析 | 複数 | 数値 | 複数の要因が絡む結果を予測したいとき |
| ロジスティック回帰分析 | 1つ以上 | 2択 | 買うか買わないか、解約するかしないかを予測したいとき |
単回帰分析。説明変数が1つのとき
説明変数を1つに絞る型です。回帰式は y=a+bx という形になります。
広告費と売上、気温とアイスの販売数のように、関係が目で見て分かりやすいのが利点です。散布図に直線を1本引くだけなので、人に説明するときも伝わります。
一方で、現実の結果はたいてい複数の要因で決まります。広告費だけで売上が決まることはありません。そこで次の重回帰分析が要ります。
重回帰分析。説明変数が複数のとき
説明変数を複数にした型です。y=a+b1x1+b2x2+… という形になります。
広告費、店舗数、気温、曜日といった複数の要因を同時に扱えるので、現実の業務ではこちらを使う場面のほうが多くなります。
その代わり、説明変数を増やせば増やすほど良くなるわけではありません。似た意味の変数を入れると結果が不安定になります。これは注意点のところで扱います。
ロジスティック回帰分析。結果が2択のとき
目的変数が数値ではなく、「買う・買わない」「解約する・しない」のような2択のときに使う型です。
出てくるのは0から1の間の確率で、「この顧客が解約する確率は0.73」という形で答えが返ります。名前に回帰と付いていますが、解いているのは分類の問題です。
回帰分析の仕組み。最小二乗法で回帰直線が決まる
散布図に直線を引くとき、どんな線でも引けます。では、どの線が「最もよく当てはまる」のでしょうか?
残差の二乗和が最も小さくなる線を選ぶ
実際のデータの点と、引いた直線との縦方向の差を残差と呼びます。この残差が全体として小さい線ほど、よく当てはまっていることになります。
ただし、残差をそのまま足すと、プラスとマイナスが打ち消し合ってしまいます。そこで残差を二乗してから合計します。この合計が最も小さくなる直線を選ぶ方法が、最小二乗法です。
二乗するのは、符号をそろえるためだけではありません。大きく外れた点ほど二乗で効いてくるので、大外れを避ける線が選ばれるという性質もあります。
回帰係数と切片が意味していること
できあがった式の b にあたる部分を回帰係数、a にあたる部分を切片と呼びます。
回帰係数は「説明変数が1増えたとき、目的変数がいくつ増えるか」を表します。広告費の係数が0.8なら、広告費を1万円増やすと売上が0.8万円増える見込み、という読み方になります。
切片は、すべての説明変数が0のときの値です。業務上ありえない値になることもありますが、線の位置を決めるための数値なので、無理に意味づけしなくてかまいません。
この計算が、機械学習でいう「学習」にあたる
残差の二乗和が最小になるように係数を決める。この計算が、機械学習でいう学習そのものです。
データを与えて、誤差が小さくなるようにパラメータを調整する。深層学習でも同じことをしています。違いは、調整するパラメータの数と、関係の複雑さだけです。
回帰分析のやり方。Excelで実行する5つの手順
Excelの分析ツールで実行できます。手順そのものより、どう設計して、出た表をどう読むかのほうが重要なので、そちらに重心を置いて説明します。
手順1から手順3。目的変数を決め、説明変数を選び、データを整える
- 目的変数を決める。予測したい数値、説明したい結果を1つに決めます。主観的な評価より、実際に測れている数値を選びます
- 説明変数の候補を出す。結果に影響していそうな要因を、業務の知識から挙げます。ここでデータが取れるか、そして目的変数より先に決まる値かを確認します。結果が出たあとに決まる数値を入れてはいけません
- データを整える。行が1件のデータ、列が変数になるように並べます。欠損、表記ゆれ、単位の混在を直します。カテゴリの項目は数値に置き換えます
実務では3番目に最も時間がかかります。ここの作り込みが精度を左右します。
手順4。Excelの分析ツールで回帰分析を実行する
- 回帰分析を実行する。分析ツールを有効にし、回帰を選び、入力Y範囲に目的変数、入力X範囲に説明変数を指定して実行します
分析ツールの有効化やデータの整え方といった基本操作はExcelでデータ分析をする方法。分析ツールの使い方と限界をわかりやすく解説で扱っています。Excel以外の選択肢はデータ分析ツールのおすすめ。目的別の選び方をわかりやすく解説を参照してください。
手順5。出力された3つの表を上から読む
- 出力を読む。「回帰統計」「分散分析表」「係数の表」の3つが出ます
この3つは上から順に見ます。何を見るかは次の章で扱います。
回帰分析の結果の読み方。決定係数・p値・回帰係数
ここでつまずく人がいちばん多いところです。指標を個別に覚えるのではなく、見る順番で理解すると迷わなくなります。
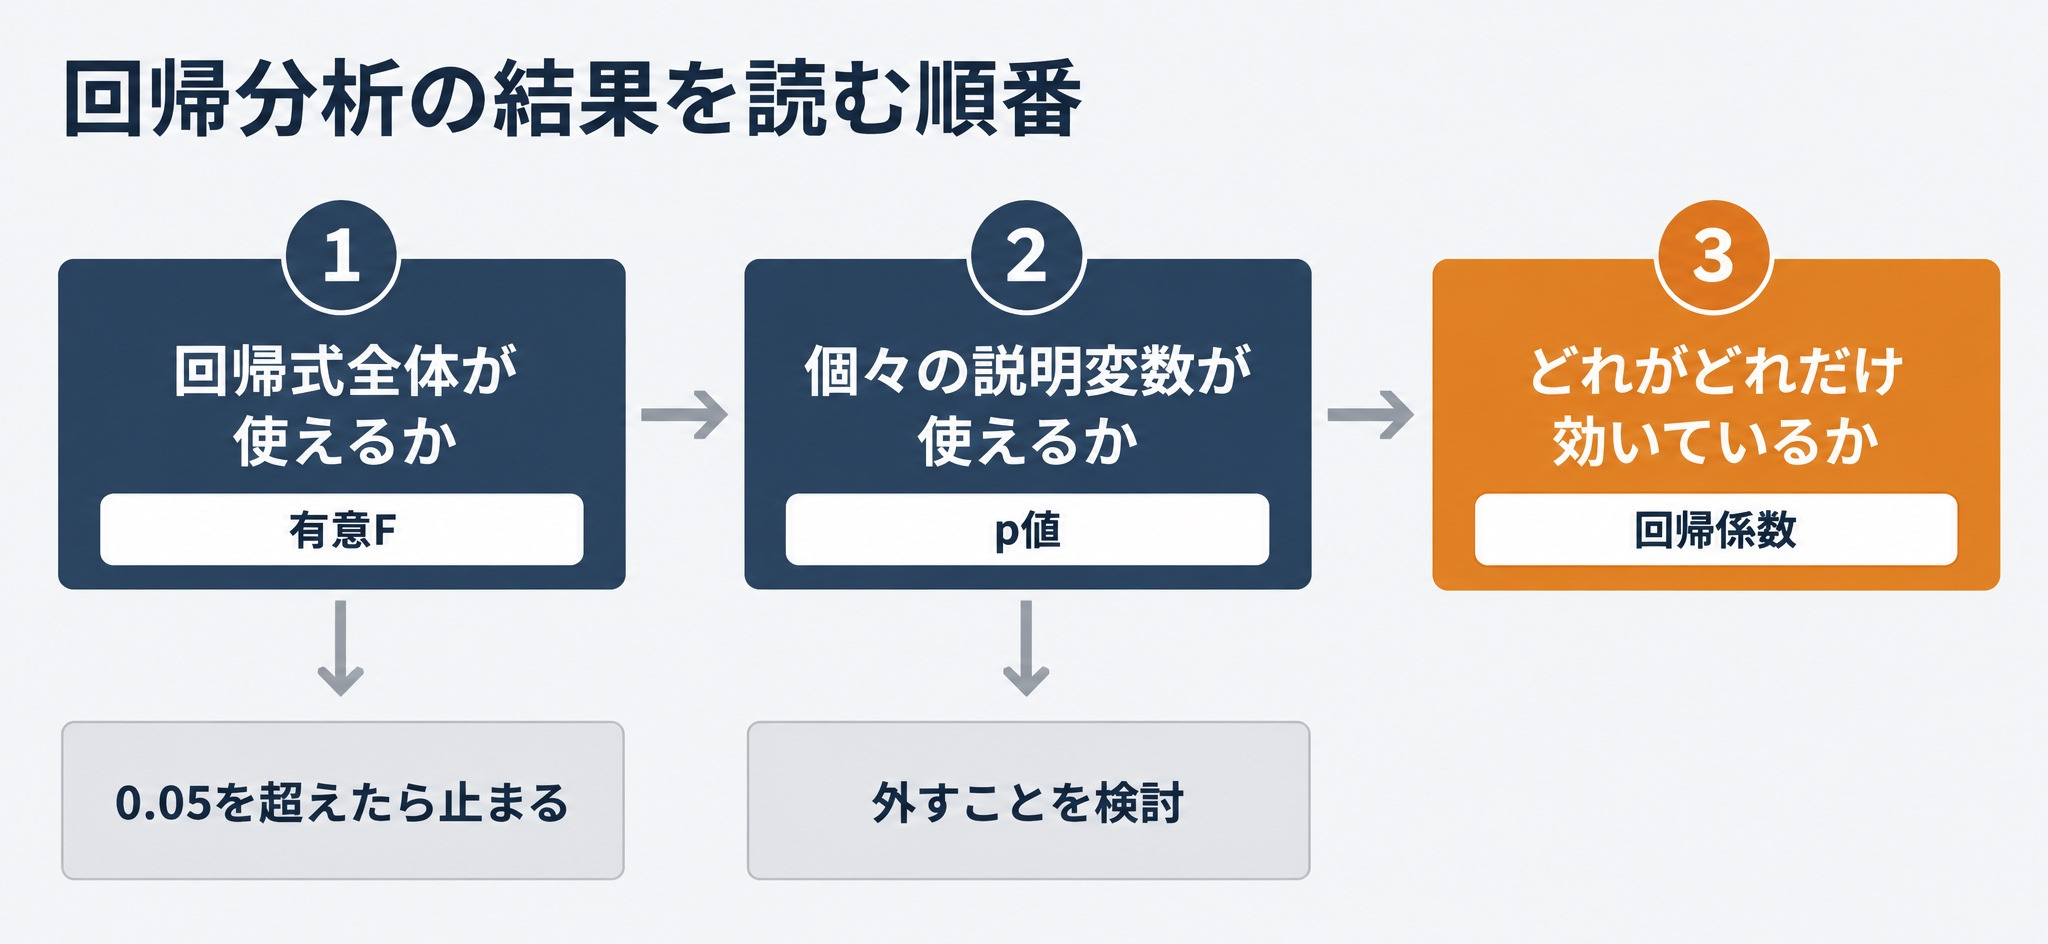
順番は「回帰式全体が使えるか → 個々の説明変数が使えるか → どれがどれだけ効いているか」です。
決定係数と自由度調整済み決定係数。当てはまりの良さを見る
決定係数(R2)は0から1の値で、目的変数のばらつきのうち、回帰式で説明できた割合を表します。1に近いほど当てはまりが良いことになります。
重回帰分析では自由度調整済み決定係数のほうを見ます。決定係数は、意味のない説明変数を足しても数値が上がってしまう性質があるためです。自由度調整済みのほうは、変数を増やした分の罰則が入っています。
F値とp値。その回帰式と説明変数に意味があるか
分散分析表に出る有意Fは、回帰式全体に意味があるかを見る数値です。ここが大きい(一般には0.05を超える)場合、そもそもこの式は使えません。次に進む前にここで止まります。
係数の表のp値は、個々の説明変数について「効いていないとは言えない」かどうかを見ます。0.05より大きい説明変数は、効いていると言い切れないので、外すことを検討します。
係数の表には、p値の隣にt値も出ます。t値は、係数をその標準誤差(推定の揺れ幅)で割った値です。係数が揺れ幅に比べて十分に大きければt値の絶対値が大きくなり、p値は小さくなります。p値とt値は同じことを別の尺度で表していると考えてかまいません。
回帰係数。どの説明変数がどれだけ効いているか
ここまで確認してから、ようやく係数を読みます。
具体的な数字で読んでみます。ある店の10か月分の広告費と売上(どちらも万円)が次のとおりだったとします。
| 月 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 広告費 | 100 | 120 | 140 | 160 | 180 | 200 | 220 | 240 | 260 | 280 |
| 売上 | 1210 | 1260 | 1330 | 1350 | 1420 | 1480 | 1500 | 1570 | 1610 | 1680 |
このデータで単回帰分析を実行すると、回帰係数は約2.54、切片は約958、決定係数は約0.99になります。広告費を1万円増やすと、売上が約2.54万円増える関係にあると読めます。来月の広告費を200万円にする計画なら、958+2.54×200で、売上の見込みは約1,466万円です。
注意したいのは、係数の大きさをそのまま影響度の大小として比べられないことです。広告費(万円)と店舗数(店)では単位が違うので、数値の大きさだけでは比べられません。比べたいときは、標準化した係数を使います。
決定係数が高いモデルが、使えるモデルとは限らない
決定係数が0.95と出ると、良いモデルができたように見えます。ただし、手元のデータによく当てはまることと、これから来るデータを当てられることは別です。
説明変数を増やせば決定係数は上がります。極端にいえば、データ件数と同じ数の変数を入れれば1.0になります。それは当たっているのではなく、覚えているだけです。
もうひとつ、目的変数を作るのに使った数値が説明変数に混ざっていないかを確認してください。売上を予測したいのに、説明変数に売上原価が入っていれば、決定係数は跳ね上がりますが、予測には使えません。
ここまで回帰分析の読み方を解説しましたが、「自分のデータで予測モデルを作って、Pythonでも動かせるようになりたい」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeでは、Excelでの分析からPythonでのデータ処理、scikit-learnでのモデル構築と評価までを、順番に学べます。教材を進めるだけでなく、課題の添削と週1回の面談で詰まった箇所を確認できるため、自分のデータで一周できる力を身につけられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
回帰分析でつまずく4つの注意点
実務で実際に問題になる順に並べます。それぞれ「何が起きるか」「どう確かめるか」「どう直すか」で書きます。
多重共線性。説明変数どうしが似ていると係数が不安定になる
何が起きるか。説明変数どうしが強く相関していると、どちらがどれだけ効いているのかを式が決められなくなります。結果として、係数の符号が業務の感覚と逆になったり、データを少し変えただけで係数が大きく動いたりします。
どう確かめるか。説明変数どうしの相関係数を見ます。0.8を超えるような組み合わせがあれば疑います。
どう直すか。似ている変数のどちらかを外すか、2つをまとめた1つの変数にします。
外れ値が回帰直線を引っぱる
何が起きるか。最小二乗法は残差を二乗するため、大きく外れた点の影響を強く受けます。1件の異常なデータで直線の傾きが変わることがあります。
どう確かめるか。散布図を描きます。数値を見る前に図を見るほうが早く気づけます。
先ほどの10か月分のデータで試してみます。10か月目の売上1680を、桁を1つ落として「168」と入力したとします。この1件だけで、回帰係数は約2.54から約マイナス1.58に変わり、決定係数は約0.99から約0.05に下がります。広告費を増やすほど売上が減る、という業務の感覚と逆の式ができあがります。
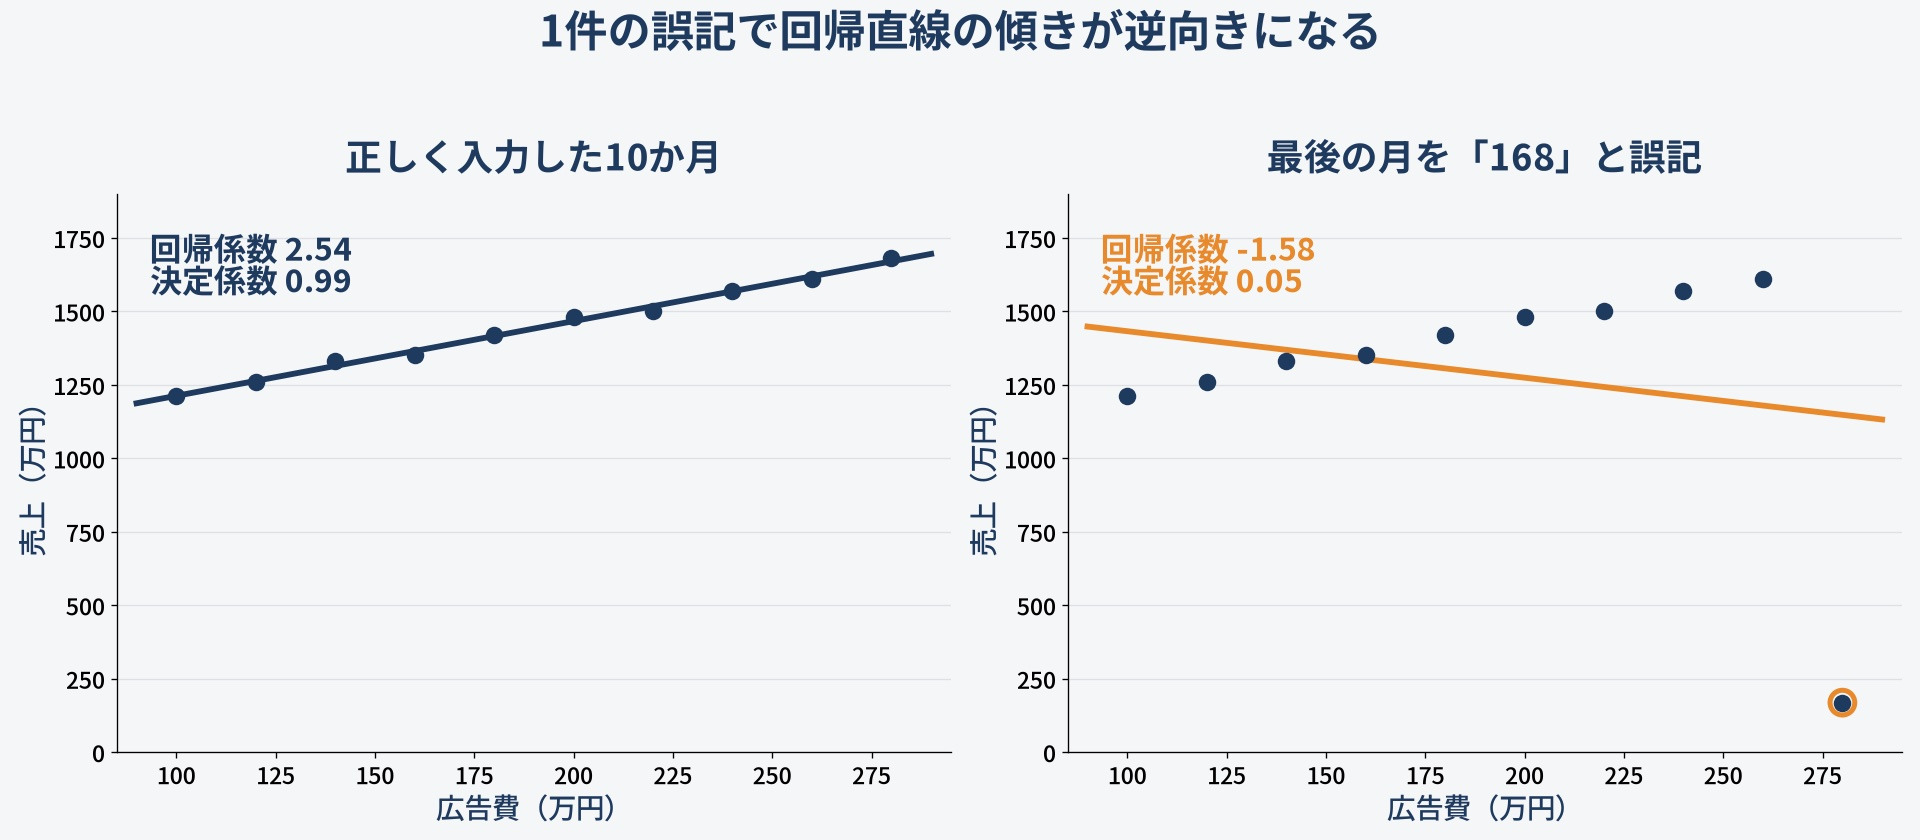
係数の表だけを見ていると、この誤記には気づけません。散布図にすれば、右下に1点だけ離れた点があることが一目で分かります。残差を並べて、1件だけ極端に大きいものがないかを確認する方法もあります。
どう直すか。そのデータが記録ミスなら直します。実際に起きた例外的な出来事なら、外すかどうかを業務の判断で決め、外した場合はその旨を残します。
回帰係数を因果関係として読まない
ここがいちばん多い誤解です。回帰分析は、説明変数と目的変数の間にどんな関係があるかを式にしますが、どちらが原因かは教えてくれません。
アイスの売上と水難事故の件数には正の関係が出ますが、アイスを売るのをやめても事故は減りません。どちらも気温という別の要因で動いているだけです。
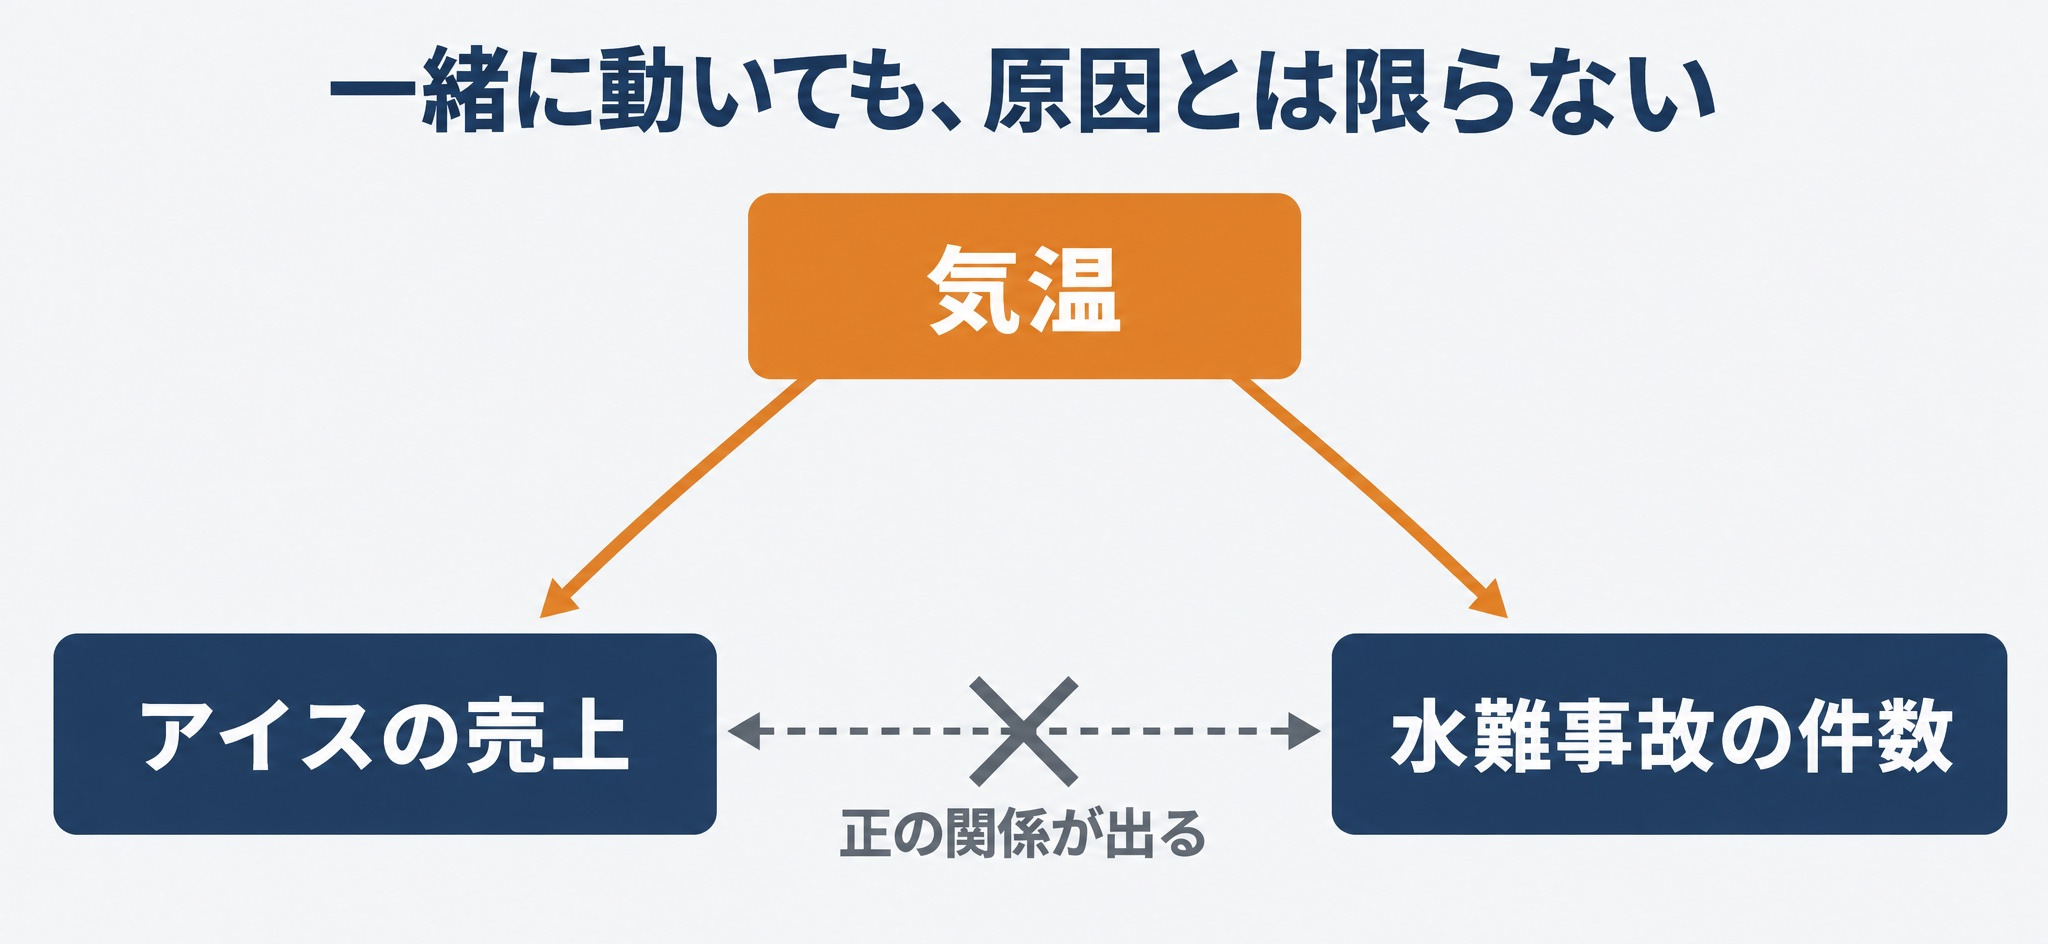
月ごとのデータを使うときは、時間の流れにも注意が要ります。会社が成長している期間は、売上も広告費も人員も、月を追うごとにそろって増えます。この場合、どの変数を入れても強い関係が出ますが、それは「同じ期間に一緒に増えた」ことを示しているだけです。月の番号や前年同月の値を説明変数に加えて、時間の影響を分けて見ることを検討します。
回帰分析で分かるのは「一緒に動いている」ことまでです。原因と結果を確かめたいなら、実験や、そのための別の手法が要ります。
過去のデータの範囲の外側は予測できない
先ほどの10か月分の例でいえば、広告費は100万円から280万円の範囲にしかありません。この範囲の外にある広告費を式に入れても、計算上は数字が出てしまいます。
学習に使ったデータが広告費100万円から300万円の範囲なら、その式は1000万円のときの売上を当てられません。範囲の外では関係の形が変わっている可能性があるためです。
予測値を出したら、その説明変数の値が学習データの範囲に入っているかを必ず確認してください。
回帰分析からPythonの予測モデルへ。機械学習に広げる
最後に、次の一歩の話をします。
Excelの回帰分析とPythonの線形回帰は、同じ最小二乗法
Excelの分析ツールで作った回帰式と、Pythonのscikit-learnで作る線形回帰モデルは、同じ最小二乗法で係数を求めています。結果も一致します。scikit-learnの線形モデルのドキュメントも、LinearRegression が残差の二乗和を最小にする係数を求めると説明しています。p値やt値まで含めた表が欲しい場合は、statsmodelsのOLSを使うと、Excelの出力に近い形で一覧できます。
Excelのままで続けたい場合は、分析ツールを使わずにLINEST関数で回帰係数や決定係数を求める方法もあります。関数にしておくと、データを追加したときに結果が自動で更新されます。
| 見たいもの | Excelの出力 | Pythonでの取得方法 |
|---|---|---|
| 決定係数 | 回帰統計の「重決定 R2」 | モデルのスコア |
| 回帰係数と切片 | 係数の表 | モデルの係数と切片 |
| p値・F値 | 分散分析表と係数の表 | statsmodelsのOLSサマリ |
Pythonに移ると変わるのは3点あります。
- 同じ処理を繰り返し実行できるため、データが増えても手作業が増えない
- 学習用と検証用の分け方や交差検証が、標準で用意されている
- 線形回帰から他の手法へ、同じ書き方のまま差し替えられる
直線で説明しきれないときに進む先
説明変数と目的変数の関係が曲がっている場合や、説明変数どうしの組み合わせで効き方が変わる場合は、直線では追いきれません。
その先には、条件で枝分かれする決定木、複数の決定木を束ねるランダムフォレスト、誤差を順に埋めていく勾配ブースティングといった手法があります。
ただし、最初から複雑な手法を使わないでください。回帰分析で基準となる精度を作り、それを超えるかどうかで次の手法を選びます。基準が無いまま複雑なモデルを回すと、出た数字が良いのか悪いのか判断できません。
回帰分析から機械学習へ進む5つのステップ
- Excelで回帰分析を一通り実行し、出力の読み方を身につける
- Pythonの基本文法と、pandasでのデータの読み込み・集計を覚える
- scikit-learnで同じデータを線形回帰にかけ、Excelと同じ結果が出ることを確かめる
- 学習用と検証用に分けて、未知のデータでの精度を測る
- 決定木系の手法に差し替えて、精度が上がるかを比べる
教科書の順に学ぶより、いま手元にあるデータで一周してから次に進むほうが早く身につきます。
学習の進め方はデータ分析の勉強方法。未経験から始める手順をわかりやすく解説で、必要なスキルの全体像はデータ分析に必要なスキル。求められる能力と身につけ方を解説で扱っています。データサイエンス全体の中での位置づけはデータサイエンスとは。定義・活用事例・学び方をわかりやすく解説を参照してください。
まとめ
- 回帰分析とは、結果にあたる数値と要因にあたる数値の関係を式で表し、影響度を調べたり将来の数値を予測したりする手法
- 説明変数が1つなら単回帰分析、複数なら重回帰分析。結果が2択ならロジスティック回帰分析
- 残差の二乗和が最も小さくなる直線を選ぶ最小二乗法で係数が決まる。これは機械学習でいう学習そのもの
- 出力は「回帰式全体が使えるか → 個々の説明変数が使えるか → どれがどれだけ効いているか」の順に読む
- 決定係数が高いだけでは使えるモデルとは限らない。手元のデータに当てはまることと、これから来るデータを当てられることは別
- 回帰係数は因果関係ではない。一緒に動いていることまでしか分からない
回帰分析と機械学習を学ぶなら「Craft College」へ
「回帰分析の読み方は分かったが、自分のデータでモデルを作って、その先の機械学習まで進むには何から始めればいいのか」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- Excelでの分析から、Pythonでの予測モデル作成へ進みたい方
- 出力された数値の読み方は分かったが、自分のデータで一周できていない方
- 独学で何から手をつければいいか分からず、止まってしまっている方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。