vLLMとは。Ollamaとの違いと、複数人で使うためのGPUメモリの見積もり方
Ollamaで動かしたモデルを社内で共有した途端、2人目以降の応答が遅くなった、という経験をお持ちの方も多いでしょう。そこで「本番ならvLLM」と聞いて調べ始めても、何が違うのか、手持ちのGPUで何人が同時に使えるのかまでは、なかなか分かりません。
しかも、vLLMの紹介では「最大24倍速い」という数字がよく引かれますが、どのモデルを、どのGPUで、何と比べた値なのかは、ほとんど書かれていません。
そこで本記事では、
- vLLMが速い理由(PagedAttentionと連続バッチング)
- Ollama・llama.cpp・TGI・SGLangとの違いと、推論エンジンの選び方
- vLLMの対応ハードウェアと導入手順
- OpenAI互換サーバーとしての使い方と、バッチ推論
- KVキャッシュから同時処理数を逆算する、GPUメモリの見積もり方
を解説します。速さの数字は、論文と公式ブログにある値だけを、実験の条件と一緒に引用します。メモリの見積もりは、公式のモデル設定値を使ってPythonで計算した結果を載せます。社内でLLMの推論サーバーを立てようとしている実務者の方は、ぜひ最後までご覧ください。
「社内で複数人が使える推論サーバーを、GPUの選定から設計したい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
vLLMとは。PagedAttentionと連続バッチングで同時処理を増やす推論エンジン
vLLMとは、大規模言語モデル(LLM)の推論とサービングを高速に行うための、オープンソースの推論エンジンです。カリフォルニア大学バークレー校の研究から生まれ、ライセンスはApache-2.0です。2026年9月22日に v0.30.0 が公開されています(出典:vLLM GitHub Releases)。
推論エンジンとは、学習済みモデルの重みを読み込み、入力に対して文章を生成する処理を受け持つソフトウェアを指します。vLLMの特徴は、1人の応答を速くすることより、多くのリクエストを同じGPUで同時に処理する効率を上げる設計にあります。
vLLMが解いた問題は、KVキャッシュの無駄だった
LLMは1トークンずつ文章を生成します。そのたびに前のトークンの計算をやり直さないよう、途中の計算結果をGPUメモリに保存しておきます。これをKVキャッシュと呼びます。Transformerの注意機構が使うKey(K)とValue(V)のベクトルを、トークンごとに溜めておく領域です。
KVキャッシュは会話が長くなるほど膨らみます。vLLMの論文は、130億パラメータのOPT-13Bでは1トークンあたり800KB、最大の2,048トークンでは1リクエストで1.6GBになると計算しています。同じ論文によると、13BのモデルをNVIDIA A100(40GB)で動かすと、メモリの約65%を重みが、約30%をKVキャッシュが占めます。
問題は、このKVキャッシュの使い方でした。従来のシステムは、会話が最終的に何トークンになるか分からないため、最大長の分を先に予約していました。論文の計測では、既存システムが確保したKVキャッシュのうち、実際のトークンの保存に使われていたのは20.4〜38.2%にとどまっていました(出典:Kwon et al. “Efficient Memory Management for Large Language Model Serving with PagedAttention”, SOSP 2023)。
PagedAttention:KVキャッシュを小さなブロックで貸し出す
PagedAttentionは、OSの仮想メモリと同じ考え方をKVキャッシュに持ち込んだ仕組みです。KVキャッシュを固定長のブロックに分け、会話が伸びた分だけブロックを割り当てます。ブロックはメモリ上で連続している必要がありません。
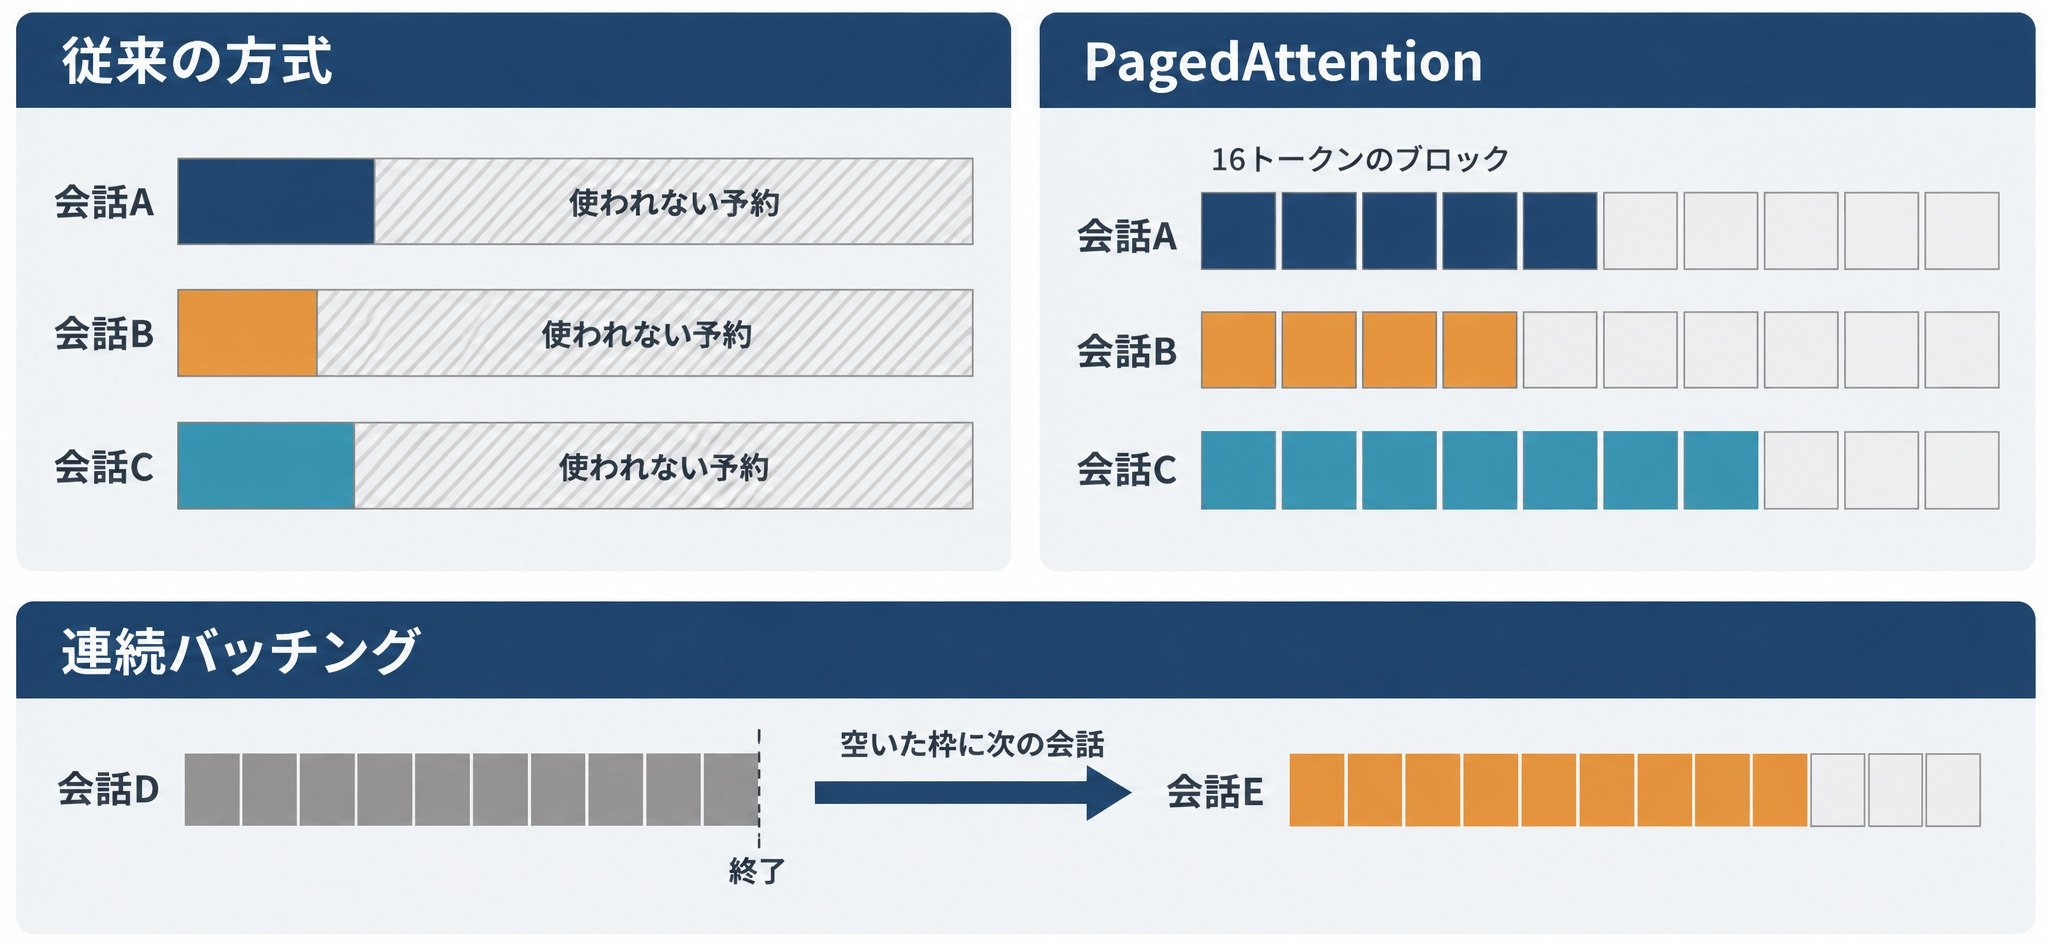
vLLMの既定のブロックサイズは16トークンです。最大長を先に予約しないため、余りが出るのは各会話の最後のブロックだけになります。公式ブログは、従来のシステムが断片化と過剰な予約でメモリの60〜80%を無駄にしていたのに対し、vLLMでは無駄が4%未満になると説明しています(出典:vLLM Blog “vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention”)。
同じ前置きを持つリクエストどうしでは、ブロックを共有することもできます。1つの質問から複数の回答を生成する場合などに効き、公式ブログではメモリ使用量が最大55%減ったとしています。
連続バッチング:終わった会話から入れ替える
もう1つの柱が、連続バッチング(continuous batching)です。複数のリクエストをまとめて処理するとき、従来の静的なバッチでは、最も長い応答が終わるまで次のリクエストを入れられませんでした。
連続バッチングでは、1トークンを生成する反復ごとに、終わったリクエストをバッチから外し、待っているリクエストを加えます。新しいリクエストは、バッチ全体の完了ではなく、1反復分を待つだけで処理に入れます。この反復単位のスケジューリングは、vLLMより前にOrcaというシステムが提案したものです。
論文は、Orcaの反復単位のスケジューリングとPagedAttentionを「補完関係」と位置づけています。スケジューリングで同時に処理する数を増やしても、KVキャッシュが入りきらなければ数は増えません。PagedAttentionで空いたメモリに次の会話を入れられるから、連続バッチングの効果が出る、という関係です。
「最大24倍」のスループットは、どういう条件の数字か
vLLMの紹介でよく引かれる倍率には、2つの出典があり、条件がそれぞれ違います。スループットとは、一定時間に処理できるリクエストやトークンの量を指します。
- 論文(SOSP 2023):同じ水準のレイテンシで、FasterTransformerとOrcaに比べてスループットが2〜4倍。系列が長いほど、モデルが大きいほど、デコードの方法が複雑なほど差が広がる
- 公式ブログ(2023年6月20日):Hugging Face Transformersに比べて14〜24倍、TGIに比べて2.2〜2.5倍(1リクエストに1回答の場合)。LLaMA-7BをNVIDIA A10Gで、LLaMA-13BをA100(40GB)で動かし、入出力の長さはShareGPTのデータから取った条件
「24倍」は、2023年時点のHugging Face Transformersを相手にした、特定のモデルとGPUでの値です。比べる相手もvLLM自身も当時から大きく変わっているため、今の製品選定の根拠には使えません。本記事では、NVIDIA GPUを使った独自のベンチマークは取っていません。自社の条件での測り方は、後半の運用の章で紹介します。
vLLMとOllama・llama.cpp・TGI・SGLangの違い(推論エンジン比較)
ここまでで、vLLMの速さが「同時に何本の会話を抱えられるか」から来ていることを見ました。次に、同じ軸で他の推論エンジンと比べます。
5つの推論エンジンを同じ項目で比べる
2026年9月時点の公式ドキュメントとGitHubの情報で、主な推論エンジンを並べると次のようになります。
| 推論エンジン | 主な用途 | 同時リクエストの扱い | 主な動作環境 | ライセンス | 2026年9月の状況 |
|---|---|---|---|---|---|
| vLLM | 複数人で使うサーバー、大量のバッチ処理 | 連続バッチング、PagedAttention | Linux(NVIDIA・AMD・Intel GPU、CPU)。MacはvLLM-Metal | Apache-2.0 | v0.30.0(9月22日) |
| SGLang | 複数人で使うサーバー、共通の前置きが長い処理 | 連続バッチング、RadixAttentionによる前置きの再利用 | Linux(GPU中心) | Apache-2.0 | v0.5.20(9月18日) |
| Ollama | 個人のPCでの試用、小規模な共有 | 1モデルあたりの並列数は既定で1 | macOS・Windows・Linux | MIT | v0.34.3(9月19日) |
| llama.cpp | CPUやMacを含む手元の環境 | 連続バッチング(既定で有効)、スロット数は既定で自動 | macOS・Windows・Linux | MIT | 開発継続中 |
| TGI | かつてのHugging Faceの推論サーバー | 連続バッチング | Linux(GPU) | Apache-2.0 | メンテナンスモード。最終リリース v3.3.7(2025年12月) |
出典:vLLM、SGLang、Ollama FAQ、llama.cpp server、TGI(いずれも2026年9月23日確認)
この表から分かるのは、同時リクエストを前提に作られているのがvLLMとSGLangで、Ollamaとllama.cppは手元の環境で動かすことに重心がある、という違いです。5つともOpenAI互換のAPIを持つため、アプリ側のコードは大きく変えずにエンジンを入れ替えられます。
vLLMとOllamaの違いは「同時に何人を受けるか」
vLLMとOllamaの違いは、速さの差として語られがちです。ただ、設計の出発点を見ると、差はもっと手前にあります。
Ollamaの公式FAQでは、1つのモデルが同時に処理するリクエスト数を決める OLLAMA_NUM_PARALLEL の既定値は1です。あふれたリクエストは、既定で512件までキューに入って順番を待ちます。並列数を上げることはできますが、FAQには、必要なメモリが並列数とコンテキスト長の積に比例して増えると書かれています。並列数の分だけ、コンテキスト長いっぱいの領域を用意する作りだと読めます。
vLLMは、最初からGPUメモリの大半をKVキャッシュ用に確保し、ブロック単位で会話に貸し出します。何本の会話を同時に抱えられるかは、会話の実際の長さで決まります。
つまり、1人で試すならOllamaの手軽さが勝ち、社内の10人、20人が同時に使う段階で設計の差が表に出ます。Ollamaの導入と基本操作は、以下の記事で解説しています。
参照記事:Ollamaの使い方。ローカルLLMを自分のPCで動かす手順を解説
TGIは2026年時点でメンテナンスモードに入っている
TGI(Text Generation Inference)は、Hugging Faceが開発した推論サーバーです。vLLMの比較相手として名前が挙がることの多いツールですが、2026年9月時点で状況が変わっています。
TGIのGitHubのREADMEには、「text-generation-inference is now in maintenance mode」と書かれています。今後受け付けるのは軽微なバグ修正と文書の改善などに限られ、今後の推奨先として、vLLMとSGLang、ローカル向けにはllama.cppとMLXが挙げられています。リポジトリはアーカイブ(読み取り専用)されており、最後のリリースは2025年12月19日の v3.3.7 です(出典:huggingface/text-generation-inference)。
すでにTGIで動いているシステムを急いで止める理由にはなりませんが、新しく推論基盤を組むなら、TGIは候補から外してよいでしょう。
用途から推論エンジンを選ぶ4つの問い
どの推論エンジンを選ぶかは、次の4つの問いに順番に答えると決まります。
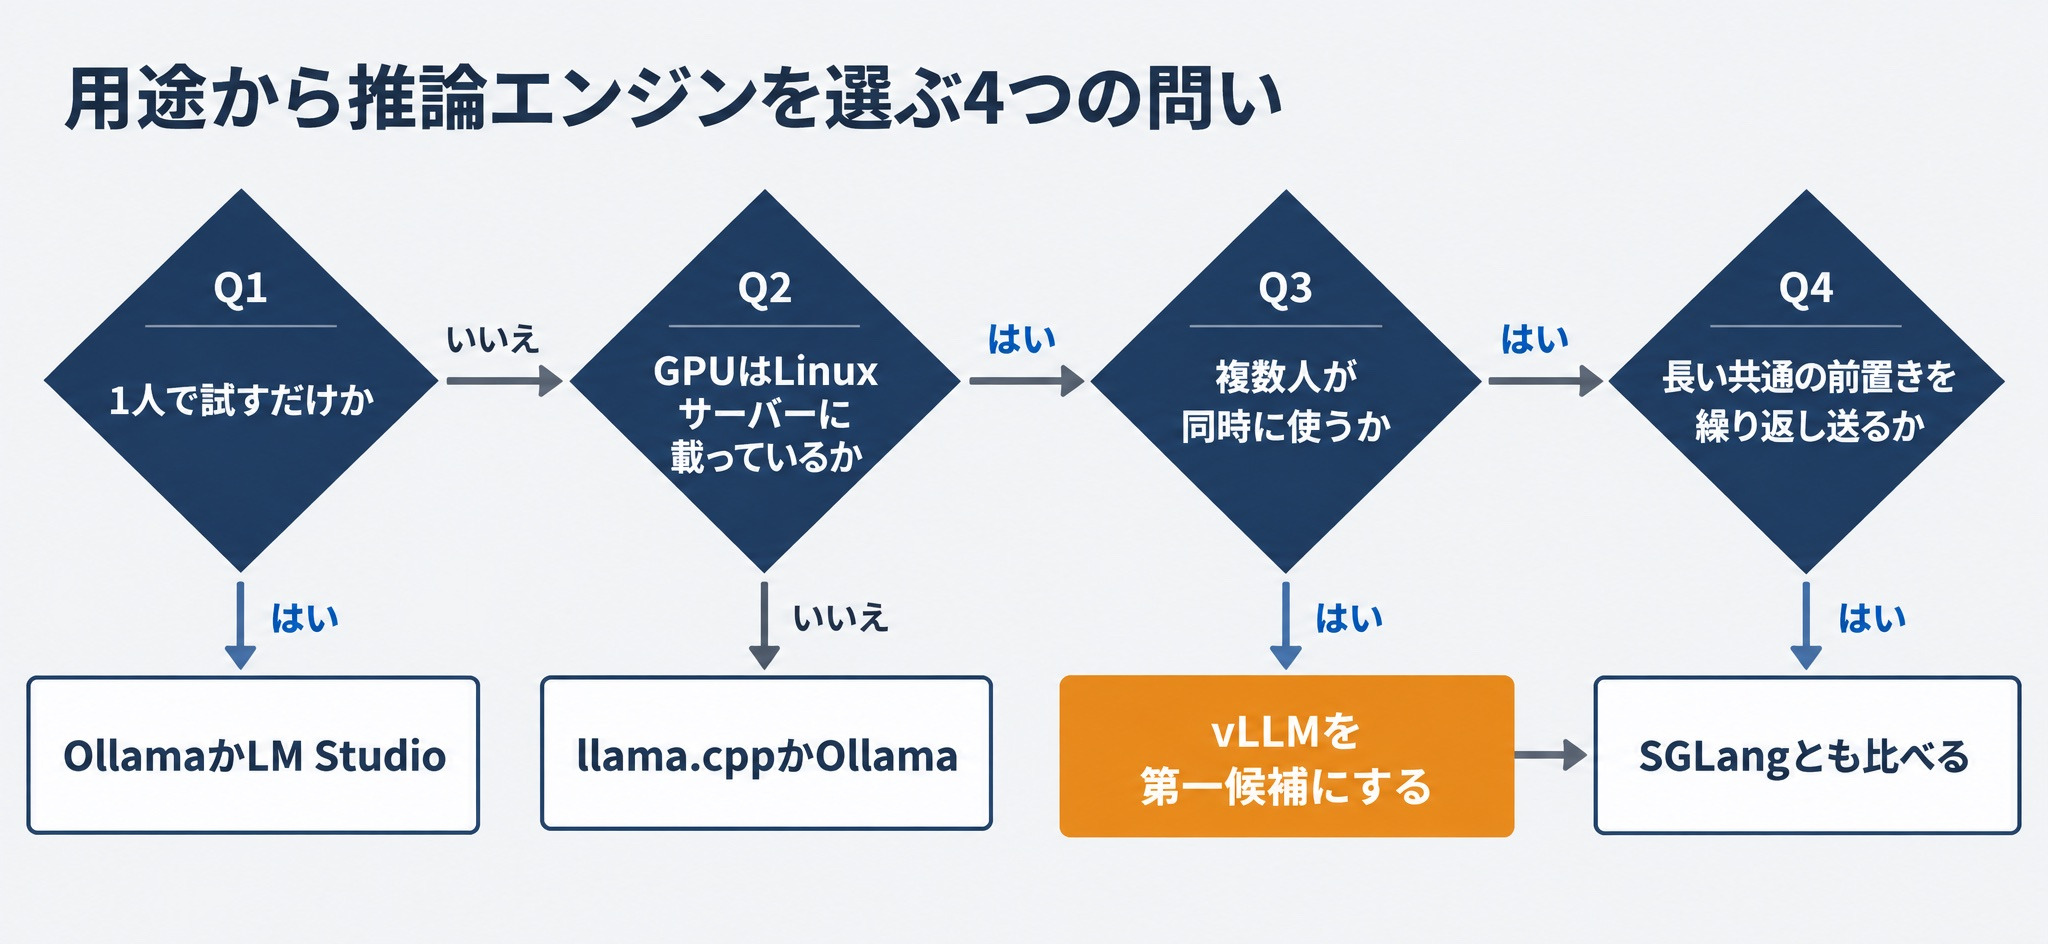
- 1人で試すだけか。個人のPCで動作やプロンプトを確かめる段階なら、OllamaかLM Studioで十分です。GUIで試したい場合はLM Studioの使い方を参考にしてください
- GPUはLinuxサーバーに載っているか。MacやWindowsのPCだけで動かすなら、llama.cppかOllamaが現実的です。vLLMのGPU版はLinuxが前提です
- 複数人が同時に使うか。社内の共有サーバーとして置く、アプリから並列に呼ぶ、という用途なら、vLLMかSGLangを選びます
- 長い共通の前置きを繰り返し送るか。同じシステムプロンプトや同じ社内文書を、多くのリクエストに付けて送る処理が中心なら、SGLangも比べる価値があります。ただしvLLMも、前置きのKVキャッシュを再利用する自動プレフィックスキャッシュが既定で有効です
複数人での利用が決まった時点で、vLLMを第一候補にし、共通の前置きが長い処理ではSGLangと比べる、という順番が選びやすいでしょう。
vLLMの対応ハードウェアと導入手順
推論エンジンをvLLMに決めたら、次は動かす環境が要件を満たしているかを確認します。
対応するGPU・OS・Pythonのバージョン
2026年9月時点のvLLM公式ドキュメントでは、GPU版の要件は次のとおりです(出典:vLLM Installation GPU)。
- OS:Linux。Windowsはネイティブでは動かず、WSL(Windows Subsystem for Linux)を使う
- Python:3.10〜3.13
- NVIDIA GPU:compute capability 7.5以上(T4、RTX 20シリーズ、A100、L4、H100、B200など)
- NVIDIA以外:AMD GPU(ROCm 6.3以上。MI300系やRadeon RX 7900系など)、Intel GPU(Data Center GPU・Arc)、CPU(x86・ARM・Apple silicon・IBM Z)にも対応
- Apple SiliconのGPU:本体ではなく、コミュニティが保守するプラグインのvLLM-Metalを使う
手元のMacで試すだけならvLLMを選ぶ理由は薄く、社内のLinuxサーバーにNVIDIAかAMDのGPUを載せる構成が、vLLMの力を引き出す標準的な形です。
vLLMをインストールしてモデルを起動する4ステップ
NVIDIA GPUを積んだLinuxサーバーでは、次の4ステップで起動できます。以下のコマンドは公式のクイックスタートに沿ったものです。本記事では実行していないため、出力は載せていません。
- 新しいPython環境を作る。vLLMはCUDAやPyTorchのバージョンに強く依存するため、公式は新しい環境へのインストールを勧めています
- vLLMを入れる。
--torch-backend=autoを付けると、ドライバに合うPyTorchを自動で選びます - モデルを指定してサーバーを起動する。Hugging Face上のモデル名を渡すと、重みをダウンロードして読み込みます
- モデル一覧を取得して、応答を確認する。
# 1. 新しいPython環境を作る
uv venv --python 3.12 --seed
source .venv/bin/activate

# 2. vLLMを入れる
uv pip install vllm --torch-backend=auto

# 3. モデルを指定してOpenAI互換サーバーを起動する
vllm serve Qwen/Qwen3-8B

# 4. 別のターミナルから、モデル一覧を取得する
curl http://localhost:8000/v1/models
コンテナで動かす場合は、公式のDockerイメージ vllm/vllm-openai が使えます(出典:vLLM Using Docker)。
vLLMをOpenAI互換サーバーとして使う
vLLMが起動したら、社内のアプリや既存のスクリプトから呼び出します。
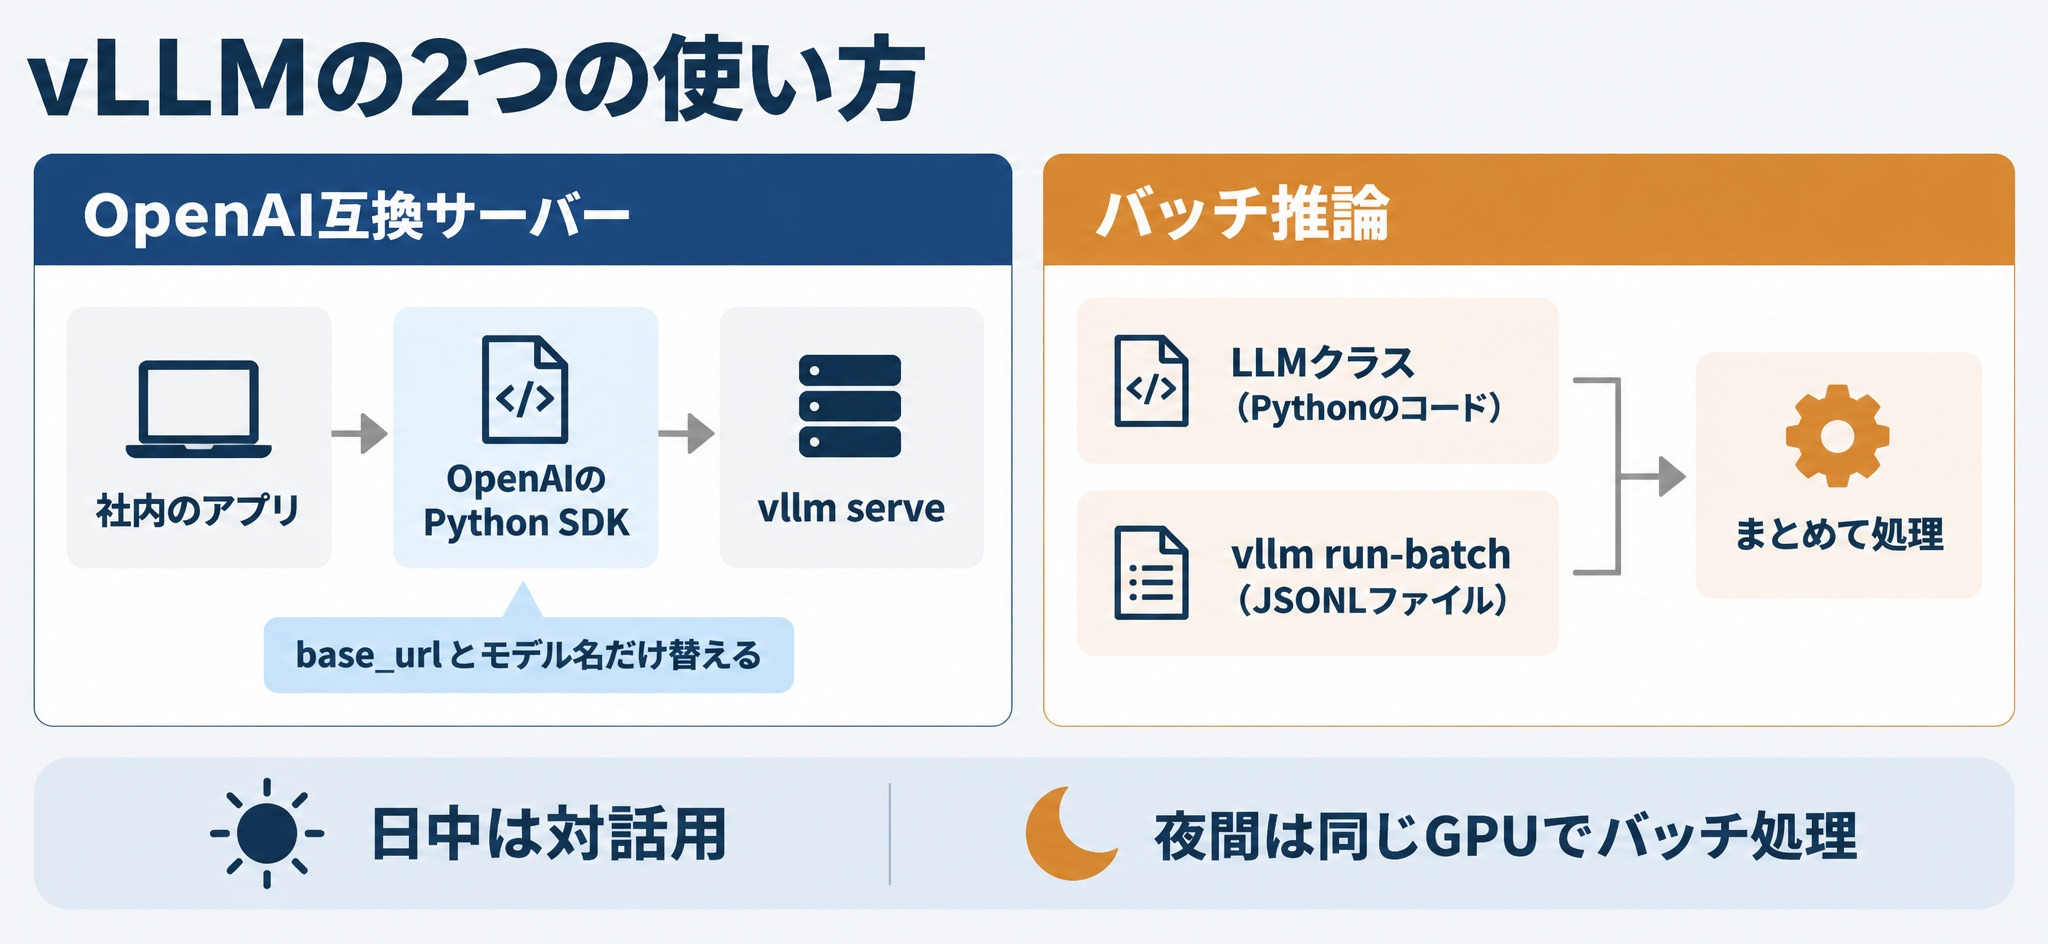
vllm serveで立ち上がるAPIと、APIキーの設定
vllm serve は、OpenAIのAPIと同じ形式でリクエストを受けるサーバーを立ち上げます。既定の待ち受け先は http://localhost:8000 で、--host と --port で変えられます。1つのサーバーが扱うモデルは1つです(出典:vLLM Quickstart)。
受け付けるAPIは、Chat Completions(/v1/chat/completions)、Completions、Responses のほか、埋め込みモデルを起動した場合は Embeddings(/v1/embeddings)もあります(出典:vLLM OpenAI-Compatible Server)。
起動時に --api-key を渡すか、環境変数 VLLM_API_KEY を設定すると、リクエストのヘッダーでAPIキーを確認するようになります。ただし、このキーが守る範囲には限りがあります。詳しくは後半の運用の章で扱います。
OpenAIのPython SDKから、接続先だけ替えて呼ぶ
OpenAI互換なので、OpenAIの公式Python SDKがそのまま使えます。変えるのは接続先の base_url と、モデル名だけです。
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",  # vLLMサーバーの場所
    api_key="EMPTY",                       # --api-key を付けたらその値
)

response = client.chat.completions.create(
    model="Qwen/Qwen3-8B",
    messages=[
        {"role": "system", "content": "社内規程に沿って簡潔に答えてください。"},
        {"role": "user", "content": "出張旅費の精算期限を教えてください。"},
    ],
)
print(response.choices[0].message.content)
クラウドのAPIで作った試作品を、社内のGPUサーバーに移すときの書き換えは、ほぼこの2か所で済みます。
バッチ推論:大量の文書をまとめて処理する2つの方法
問い合わせ履歴の分類や、社内文書の要約のように、応答を待つ人がいない処理には、バッチ推論が向いています。vLLMには2つの方法があります。
1つ目は、Pythonのコードの中で LLM クラスを使う方法です。サーバーを立てずに、プロンプトのリストを渡すと、vLLMが内部で連続バッチングを行いながらまとめて処理します(出典:vLLM Offline Inference)。
from vllm import LLM, SamplingParams

llm = LLM(model="Qwen/Qwen3-8B")
params = SamplingParams(temperature=0, max_tokens=256)

# inquiries は問い合わせ本文のリスト
prompts = [f"次の問い合わせを3行で要約してください。\n{text}" for text in inquiries]
outputs = llm.generate(prompts, params)2つ目は、vllm run-batch コマンドです。OpenAIのバッチAPIと同じ形式のJSONLファイルを入力に取り、結果をファイルに書き出します(出典:vLLM CLI)。
vllm run-batch -i requests.jsonl -o results.jsonl --model Qwen/Qwen3-8B日中は対話用のサーバーとして使い、夜間に同じGPUで大量の文書をまとめて処理する、という使い分けもできます。
vLLMのGPUメモリの見積もり方。KVキャッシュから同時処理数を逆算する
アプリから呼べるようになったら、次に決めるのは「このGPUで何人が同時に使えるか」です。GPUの購入や稟議では、ここが最初に問われる数字になります。
GPUメモリは「重み・KVキャッシュ・作業領域」に分かれる
vLLMは起動時に、GPUメモリのうち gpu_memory_utilization で指定した割合を確保します。v0.30.0の既定値は0.92で、残りの8%には手を付けません。確保した領域は、次の3つに分かれます。
- モデルの重み:パラメータ数×1パラメータあたりのバイト数。BF16なら2バイト
- KVキャッシュ:同時に処理する会話のトークンを溜める領域。ここが同時処理数を決める
- 作業領域:計算途中の値やCUDAグラフなど。起動時の計測で決まる
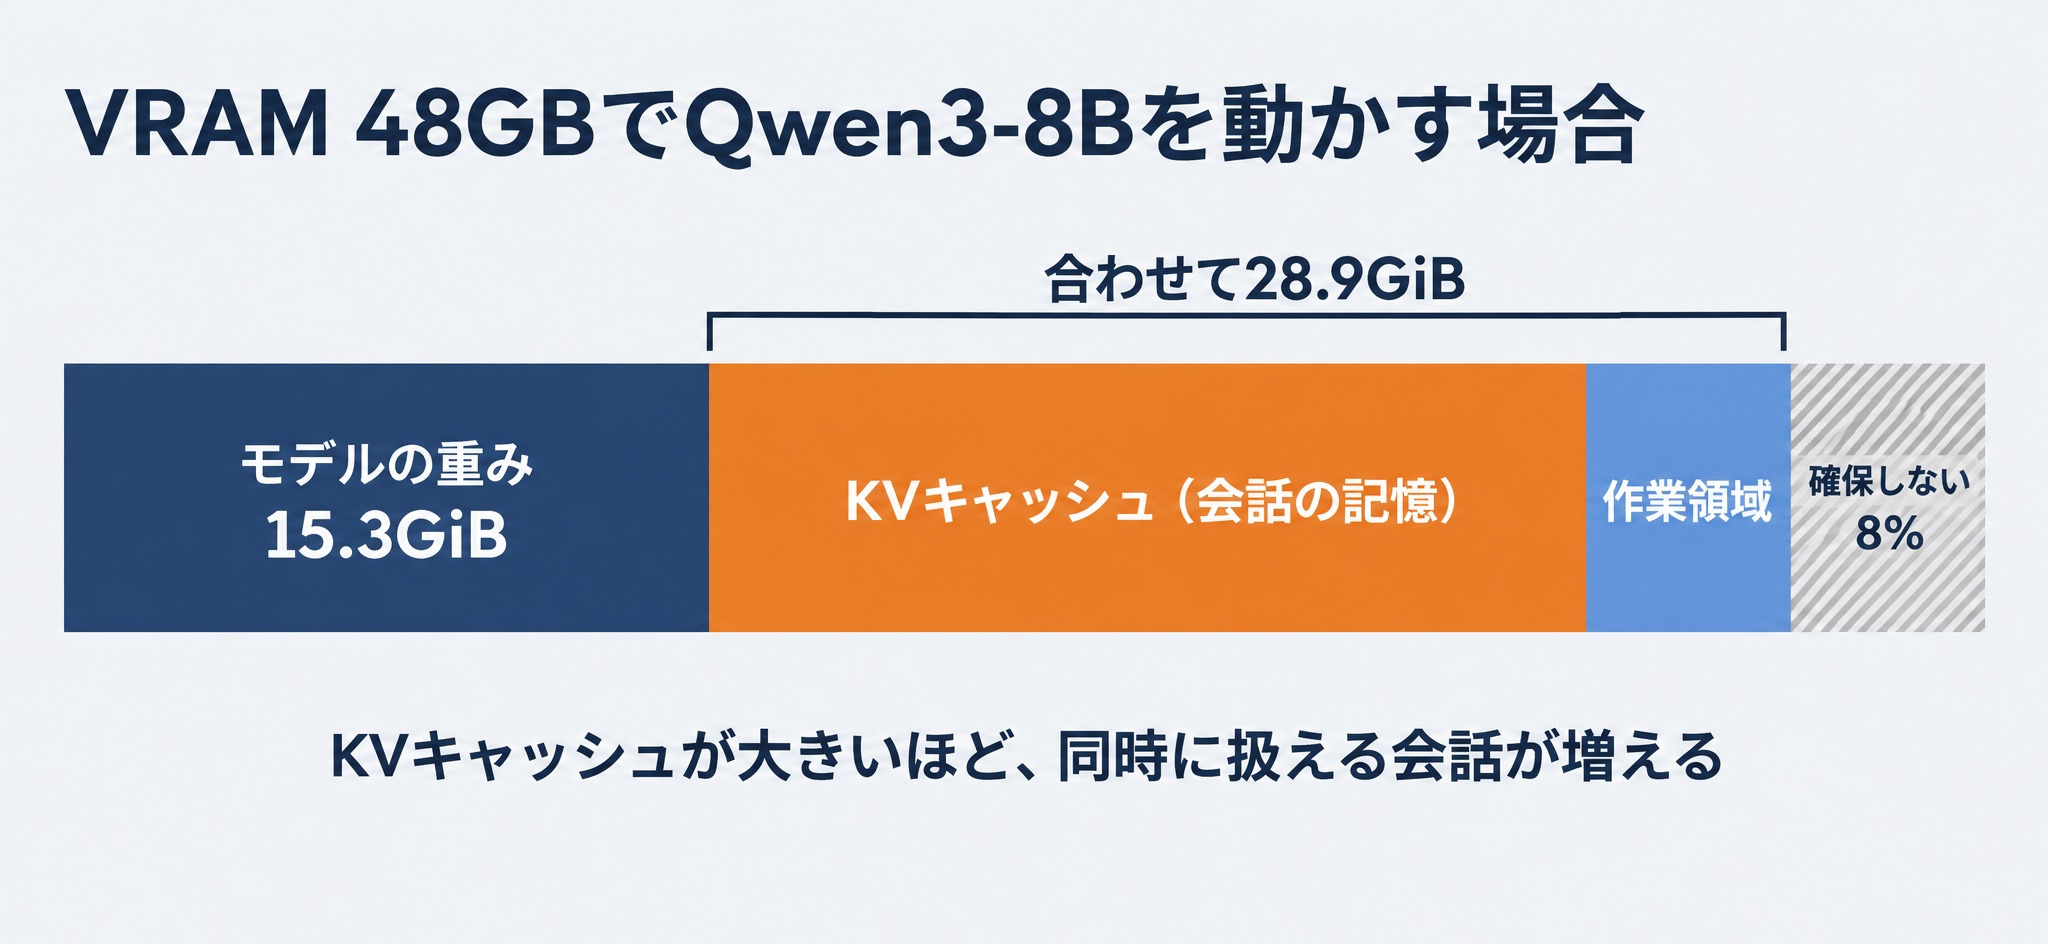
KVキャッシュの1トークンあたりの大きさは、モデルの設定値から次の式で計算できます。
KVキャッシュ(1トークン)= 2(KとV)× 層数 × KVヘッド数 × ヘッド次元 × 1要素のバイト数
モデル規模と量子化から「そのモデルが1人で動くか」を見る方法は、ローカルLLMに必要なスペック早見で整理しています。本記事で扱うのは、その先の「何本の会話を同時に抱えられるか」です。
Qwen3で計算すると、VRAM 48GBで8,192トークンの会話は約25本
Alibabaが公開しているQwen3(Apache-2.0)の設定値を、Hugging Faceの config.json から読み、上の式で計算しました。どのモデルも、KVヘッド数は8、ヘッド次元は128です。
import json

GiB = 1024**3
UTIL = 0.92   # vLLM v0.30.0 の gpu_memory_utilization の既定値
CTX = 8192    # 1本の会話が使い切るトークン数(入力+出力)

# Hugging Face の config.json(Qwen3)を事前に保存したファイルと、公開されているパラメータ数
models = {
    "Qwen3-8B":  ("Qwen_Qwen3-8B.json",  8_190_735_360),
    "Qwen3-14B": ("Qwen_Qwen3-14B.json", 14_768_307_200),
    "Qwen3-32B": ("Qwen_Qwen3-32B.json", 32_762_123_264),
}

def kv_per_token(cfg, nbytes=2):
    # K と V の2つ × 層数 × KVヘッド数 × ヘッド次元 × 1要素のバイト数
    return 2 * cfg["num_hidden_layers"] * cfg["num_key_value_heads"] * cfg["head_dim"] * nbytes

for name, vram in [("Qwen3-8B", 24), ("Qwen3-8B", 48), ("Qwen3-14B", 48), ("Qwen3-32B", 80)]:
    path, params = models[name]
    cfg = json.load(open(path))
    weights = params * 2                      # BF16 は1パラメータ2バイト
    kv_budget = vram * GiB * UTIL - weights   # 作業領域を差し引く前の上限
    kv = kv_per_token(cfg)
    n_bf16 = kv_budget / kv / CTX
    print(f"{name:9s} VRAM {vram}GB | 重み {weights/GiB:4.1f}GiB | KV {kv//1024}KiB/トークン"
          f" | KV用 {kv_budget/GiB:4.1f}GiB | 会話 {n_bf16:4.1f}本 (FP8なら {n_bf16*2:4.1f}本)")
実行結果です(Apple M1 Pro、Python 3.13.13、標準ライブラリのみ、2026年9月23日実行)。
Qwen3-8B  VRAM 24GB | 重み 15.3GiB | KV 144KiB/トークン | KV用  6.8GiB | 会話  6.1本 (FP8なら 12.1本)
Qwen3-8B  VRAM 48GB | 重み 15.3GiB | KV 144KiB/トークン | KV用 28.9GiB | 会話 25.7本 (FP8なら 51.4本)
Qwen3-14B VRAM 48GB | 重み 27.5GiB | KV 160KiB/トークン | KV用 16.7GiB | 会話 13.3本 (FP8なら 26.6本)
Qwen3-32B VRAM 80GB | 重み 61.0GiB | KV 256KiB/トークン | KV用 12.6GiB | 会話 6.3本 (FP8なら 12.6本)出典:Qwen3-8B、Qwen3-14B、Qwen3-32B の config.json(2026年9月23日取得)
結果を表にまとめると、次のようになります。
| モデル(BF16) | VRAM | KVキャッシュに回せる量 | 8,192トークンの会話を同時に何本 | KVキャッシュをFP8にした場合 |
|---|---|---|---|---|
| Qwen3-8B | 24GB | 6.8GiB | 6.1本 | 12.1本 |
| Qwen3-8B | 48GB | 28.9GiB | 25.7本 | 51.4本 |
| Qwen3-14B | 48GB | 16.7GiB | 13.3本 | 26.6本 |
| Qwen3-32B | 80GB | 12.6GiB | 6.3本 | 12.6本 |
この表から読み取れるのは、同じ48GBでも、モデルを8Bから14Bに上げると同時処理数がほぼ半分になることです。重みが増えた分だけKVキャッシュに回せる量が減るためです。32Bを80GBで動かすと、GPUは大きくても会話は6本しか抱えられません。
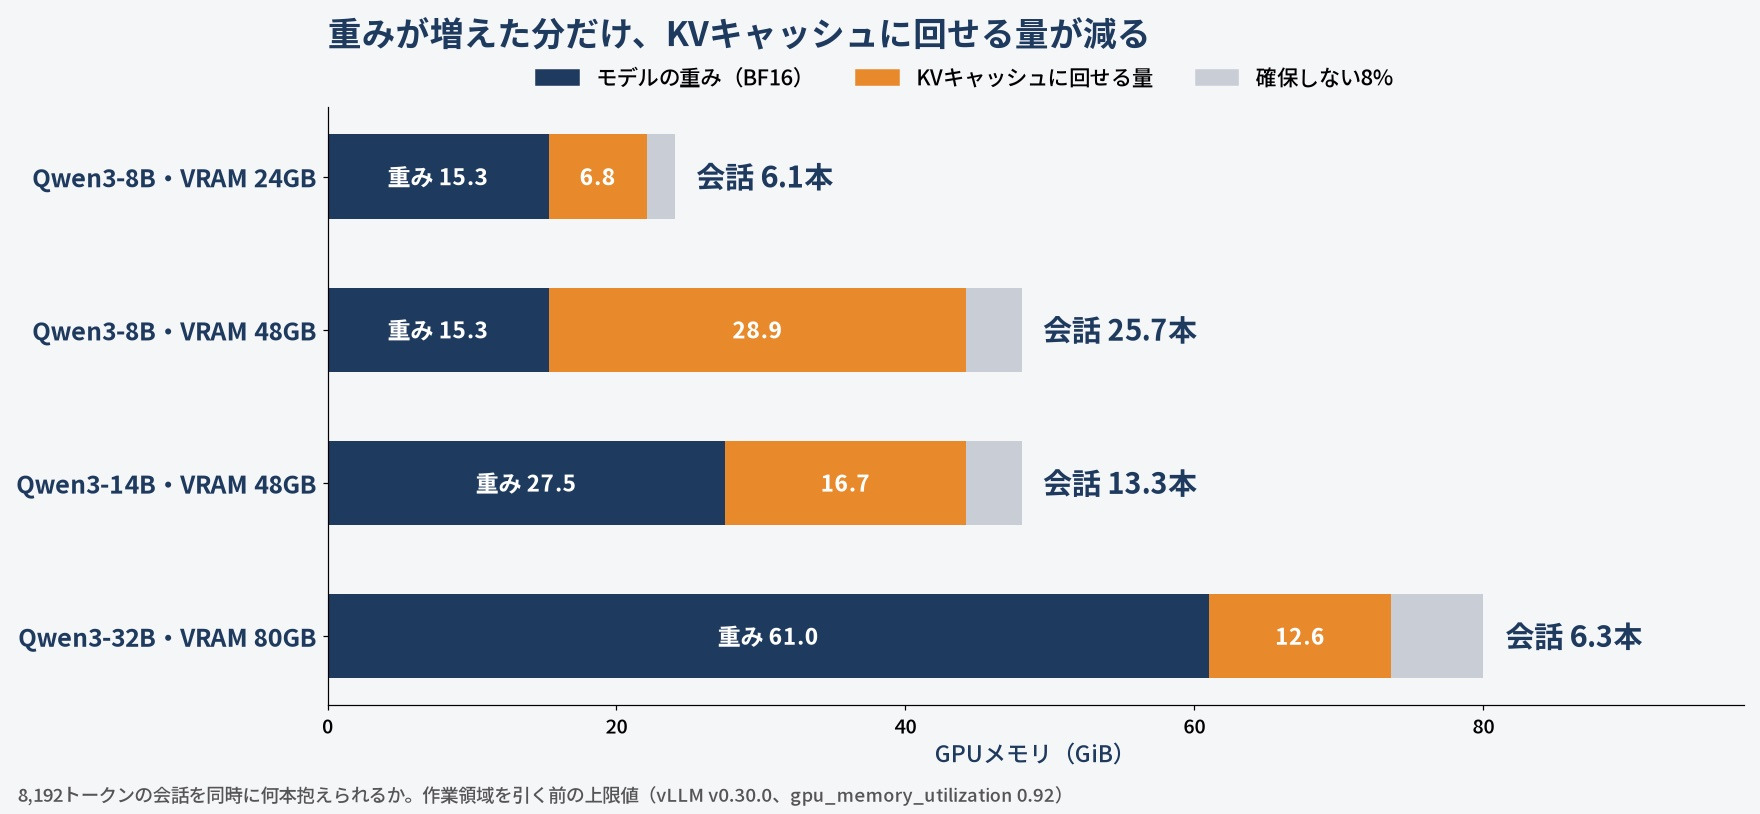
数字の読み方には、3つの注意があります。
- 作業領域を引く前の上限値です。実際の値は、vLLMの起動ログに出るKVキャッシュの容量で確かめてください。VRAMの「GB」はGiBとして計算しています
- 全員が8,192トークンを使い切る、厳しめの前提です。実際の会話はもっと短いことが多く、平均2,000トークンなら同時に抱えられる本数は約4倍になります
- 同時に抱えられる本数と、快適に応答できる人数は別です。本数が足りていても、生成速度は同時処理数が増えるほど1人あたりでは遅くなります
PagedAttentionの効き目も、この計算で見えます。Qwen3-8Bと48GBで無駄なく使えれば25.7本ですが、論文が既存システムで計測した「実際に使われていたのは20.4〜38.2%」を仮に当てはめると、同じGPUで5.2〜9.8本にとどまる計算です。Qwen3がKVヘッドを8つに絞るGQA(Grouped Query Attention)を使っている効果も大きく、注意ヘッド32個すべての分を保存する作りなら、1トークンあたり576KiBと4倍になります。
メモリが足りないときに調整する5つのパラメータ
KVキャッシュが足りないと、vLLMは処理中のリクエストを一時的に外し、空いたときに計算し直します。これをプリエンプションと呼びます。ログに「is preempted」という警告が出始めたら、次の順に見直します(出典:vLLM Optimization and Tuning、Conserving Memory)。
--max-model-lenを業務に合わせて下げる。Qwen3-8Bの設定上の最大長は40,960トークンです。社内の問い合わせ対応で8,192トークンあれば足りるなら、そこで上限を切ります--max-num-seqsで同時に処理する本数を抑える。v0.30.0では、H100級のGPUでは1024、それ以外では256が既定です。1回のバッチに入る本数が減るぶん必要なKVキャッシュも減り、入りきらないリクエストは順番待ちに回ります--kv-cache-dtype fp8でKVキャッシュを8ビットにする。上の計算のとおり、抱えられる本数はおよそ2倍になります。精度への影響は、自社の評価データで確かめてから本番に入れます--tensor-parallel-sizeで複数のGPUに重みを分ける。GPUを2枚にすれば、1枚あたりの重みが減り、KVキャッシュに回せる量が増えます- 量子化済みのモデルを使う。重みを8ビットや4ビットにしたモデルを読み込むと、重みの分が減ります。vLLMはAWQ、GPTQ、FP8、GGUFなど多くの形式に対応しています
--gpu-memory-utilization を上げる手もありますが、同じGPUで他のプロセスが動いている場合は、そちらのメモリを奪わないよう注意します。
ここまでvLLMのGPUメモリの見積もり方について解説しましたが、「社内で複数人が同時に使える推論サーバーを、GPUの選定から組みたい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、利用する人数や扱う文書の長さから、必要なGPUとvLLMの設定を逆算し、社外にデータを出さない閉域の推論基盤として構築することが可能です。ただ、サーバーを立てるだけでなく、社内の規程や手順書を参照して答えるRAGまでつなげられるため、自社の業務で実際に使われる状態まで仕上げることが可能です。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
vLLMを社内の推論サーバーとして運用するときの注意点
GPUとパラメータが決まったら、最後に、社内のサーバーとして置いたあとに起きやすい問題を押さえます。次の5点は、本番に入る前に確認しておきます。
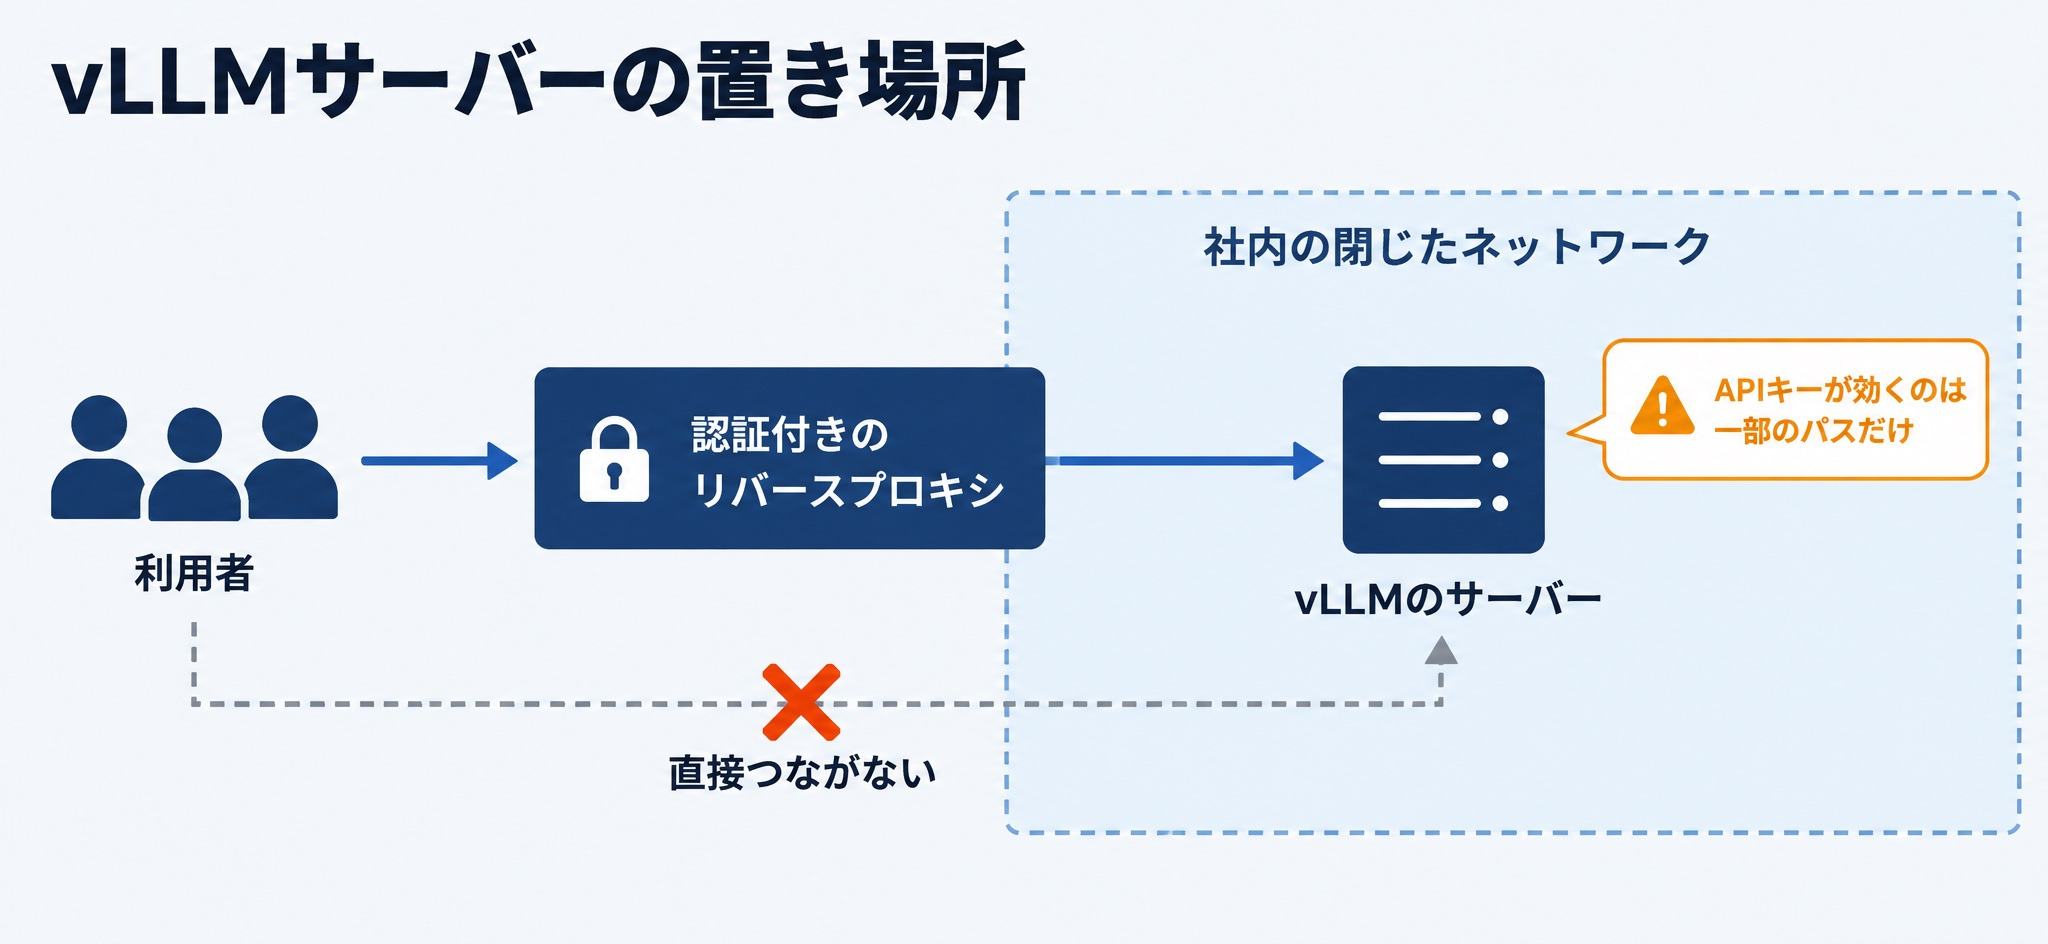
- APIキーだけで守らない。vLLM公式のセキュリティ文書によると、
--api-keyが効くのは/v1など一部のパスだけです。/invocationsなどのエンドポイントは、キーを設定しても認証なしで呼べます。vLLMのサーバーは社内の閉じたネットワークに置き、外からの入口は認証付きのリバースプロキシに限定します(出典:vLLM Security) - 1つのサーバーに1つのモデルと考える。チャット用と埋め込み用のように複数のモデルが要る場合は、GPUを分けるか、
--gpu-memory-utilizationを分け合って複数のサーバーを立てます - プリエンプションの回数を監視する。vLLMはPrometheus形式で指標を出しており、プリエンプションの発生回数も取れます。回数が増えてきたら、利用者が見積もりを超えて増えた合図です
- 自社の入力の長さで負荷を測る。公開されているベンチマークの数値は、入力と出力の長さが自社とは違います。
vllm bench serveを使い、実際の問い合わせに近い長さのリクエストを、想定する同時人数で流して確かめます - バージョンを固定して更新する。vLLMは開発が速く、既定値もバージョンによって変わります。本記事で使った
gpu_memory_utilizationの既定値0.92も v0.30.0 時点の値です。本番のバージョンは固定し、検証環境で試してから上げます
そもそも社内のサーバーで動かすべきか、クラウドのAPIで足りるかの判断はローカルLLMの構築ガイドで、推論サーバーに社内文書を参照させる構成はローカルLLM×RAGとはで解説しています。
まとめ
- vLLMとは、LLMの推論とサービングを行うオープンソースの推論エンジン。強みは1人の応答速度より、同じGPUで同時に処理できる本数にある
- PagedAttentionは、KVキャッシュを16トークンのブロックで必要な分だけ割り当てる仕組み。論文では、既存システムが実際のトークンの保存に使えていたKVキャッシュは20.4〜38.2%だった
- 連続バッチングは、反復ごとに終わった会話を外して次の会話を入れる仕組みで、PagedAttentionと組み合わさって効果が出る
- 「最大24倍」は2023年のHugging Face Transformers比の値。論文の主張は同レイテンシでFasterTransformer・Orca比2〜4倍
- 1人で試すならOllamaかLM Studio、複数人が同時に使うならvLLMかSGLang。TGIはメンテナンスモードに入っており、新規の候補から外せる
- 同時処理数は「VRAM×0.92−重み」をKVキャッシュの1トークンあたりの大きさで割れば見積もれる。Qwen3-8BとVRAM 48GBなら、8,192トークンの会話で約25本が上限の目安
vLLMを使った推論基盤の構築と学習は「リベルクラフト」へ
「vLLMの仕組みと見積もり方は分かったが、自社の用途に合わせてモデルを選び、評価しながら推論基盤を組み上げるところまで、自分でできるようになりたい」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced を提供しています。Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムで、RAG、評価とLLM-as-a-Judge、AIエージェント、LLMセキュリティ、ローカルLLM、ファインチューニングまでを扱います。既製のフレームワークに寄せず、生のAPIと自作のコードで骨格を実装するのが方針で、毎週の実装課題には現役データサイエンティストのコードレビューが付きます。以下のようなニーズをお持ちの方に向いています。
- 社内でローカルLLMの推論サーバーを立て、アプリから呼ぶところまで自分で組みたい方
- モデルと設定を変えたときの精度と速度を、自社のデータで評価できるようになりたい方
- RAGやAIエージェントの実装を、既製のツール頼みでなく中身から理解したい方
リベルクラフト本体では、ローカルLLMの推論基盤の構築も支援しています。GPUの選定とvLLMの設定、閉域のネットワーク構成、社内文書を使うRAGまで、要件定義から本番運用までを一貫してお手伝いしています。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。