embeddingとは。ベクトル化の仕組みと埋め込みモデルの選び方を実測で解説
社内文書のRAGを作って、検索が思ったように当たらない。このとき疑う先は、embeddingか、チャンクの切り方か、検索の仕組みか、そのどれかです。切り分けができないまま、類似度のしきい値を0.7にしたり0.8にしたりして様子を見ている、という状態に心当たりのある方は多いと思います。
類似度スコアの値そのものは、それだけでは高いか低いかを判断できません。無相関なベクトル同士のコサイン類似度は、次元数が決まれば分布も決まります。1,536次元では、まったく無関係なベクトル同士の99パーセンタイルが0.0574でした。ところが学習済みの埋め込みモデルでは、無関係な文同士でも、この値よりはるかに高い類似度が出ます。この差がどこから来るのかを知らないまま、他社の記事に書かれたしきい値を持ち込んでも合いません。
本記事に出てくる数値は、すべて実際にコードを実行して得た出力です。実行環境は Python 3.13.13・numpy 2.5.3・scikit-learn 1.9.1、実行日は2026年9月21日で、乱数シードはコード中に固定しています。
そこで本記事では、
- embeddingとは何か。分散表現・埋め込み表現・ベクトル化はどう違うのか
- 分散表現がどうやって意味を持つのか。word2vecから文のembeddingまで
- コサイン類似度・内積・ユークリッド距離の使い分けと、正規化の有無で変わること
- 類似度スコアにしきい値を置けない理由
- embeddingが効かないときに疑う3つのこと
- 埋め込みモデルの選び方と、次元の切り詰め・量子化の実測
を解説します。
embeddingとは。テキストをベクトル化して意味の近さを測れるようにする技術
embeddingの定義。分散表現・埋め込み表現・ベクトル化は同じものを指す
embeddingとは、テキストなどのデータを、意味の近さがベクトル同士の近さとして表れるように、固定長の数値の並びへ変換したもの、またはその変換のことです。
日本語では文脈によって呼び分けられますが、指しているものは同じです。
- 分散表現:意味が1つの次元ではなく、多数の次元に分かれて表される、という性質に着目した呼び方
- 埋め込み表現・埋め込み:語や文をベクトル空間の1点に「埋め込む」という操作に着目した呼び方
- ベクトル化:テキストを数値ベクトルに変える工程を指す、より広い言い方。ワンホット表現やTF-IDFもベクトル化ですが、これらはembeddingとは呼びません
大事なのは固定長だという点です。sentence-transformersの公式ドキュメントでは、all-MiniLM-L6-v2 に3文を渡した出力の形状が [3, 384] になる例が示されています(Sentence Transformers 公式ドキュメント)。3語の文でも300語の文書でも、同じ384個の数値になります。長さが揃っているから、あとの計算が行列の掛け算1回で済みます。
なお画像・音声・グラフにも同じ枠組みがありますが、本記事ではテキストのembeddingだけを扱います。
キーワード一致では言い換えを拾えない。10文書で確かめる
embeddingが要る理由は、文字の一致では意味が拾えないからです。例え話ではなく、実際に検索を1回動かしてみます。
社内規程を模した10文書に対して、文字の2〜3gramでTF-IDFを作り、質問との類似度で並べます。文字n-gramは、日本語で形態素解析を使わずにキーワード一致を近似するときの定番の方法です。
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer

docs = [
    "旅費の立替分は、帰着後14日以内に精算書を提出してください",
    "返却が遅れた備品は、後から追加でお金がかかる場合があります",
    "有給休暇は取得の2週間前までに勤怠システムで届け出ます",
    "健康診断の受診案内は毎年4月に総務部から配布されます",
    "社用車の利用は、前日までに車両管理台帳へ記入します",
    "名刺の追加発注は、総務部の発注フォームから行います",
    "備品の購入依頼は、金額にかかわらず所属長の承認が必要です",
    "在宅勤務の申請は、前週の金曜日までに上長へ提出します",
    "慶弔見舞金の支給条件は、就業規則の第8章に記載があります",
    "研修費用の会社負担分は、受講修了後に経理部が処理します",
]
query = "出張でかかったお金を後から返してもらうには"

vec = TfidfVectorizer(analyzer="char_wb", ngram_range=(2, 3))
X = vec.fit_transform(docs)
score = (X @ vec.transform([query]).T).toarray().ravel()
for rank, i in enumerate(np.argsort(-score)[:3], 1):
print(f"{rank}位 {score[i]:.3f} {docs[i]}")1位になったのは「返却が遅れた備品は、後から追加でお金がかかる場合があります」でスコアは0.256でした。質問に答えている0番の文書「旅費の立替分は、帰着後14日以内に精算書を提出してください」は0.058で2位です。無関係な文書のほうが、正解の4倍以上高いスコアになっています。
理由は単純で、「後から」「お金」という文字列が備品の文書に入っている一方、質問の「出張」「返してもらう」と、正解の「旅費」「立替」「精算」には共通する文字がほとんどないからです。社内文書では、同じ手続きが「申請」と「届出」、「精算」と「払い戻し」のように別の語で書かれていることが珍しくありません。キーワード一致の検索は、この差で空振りします。
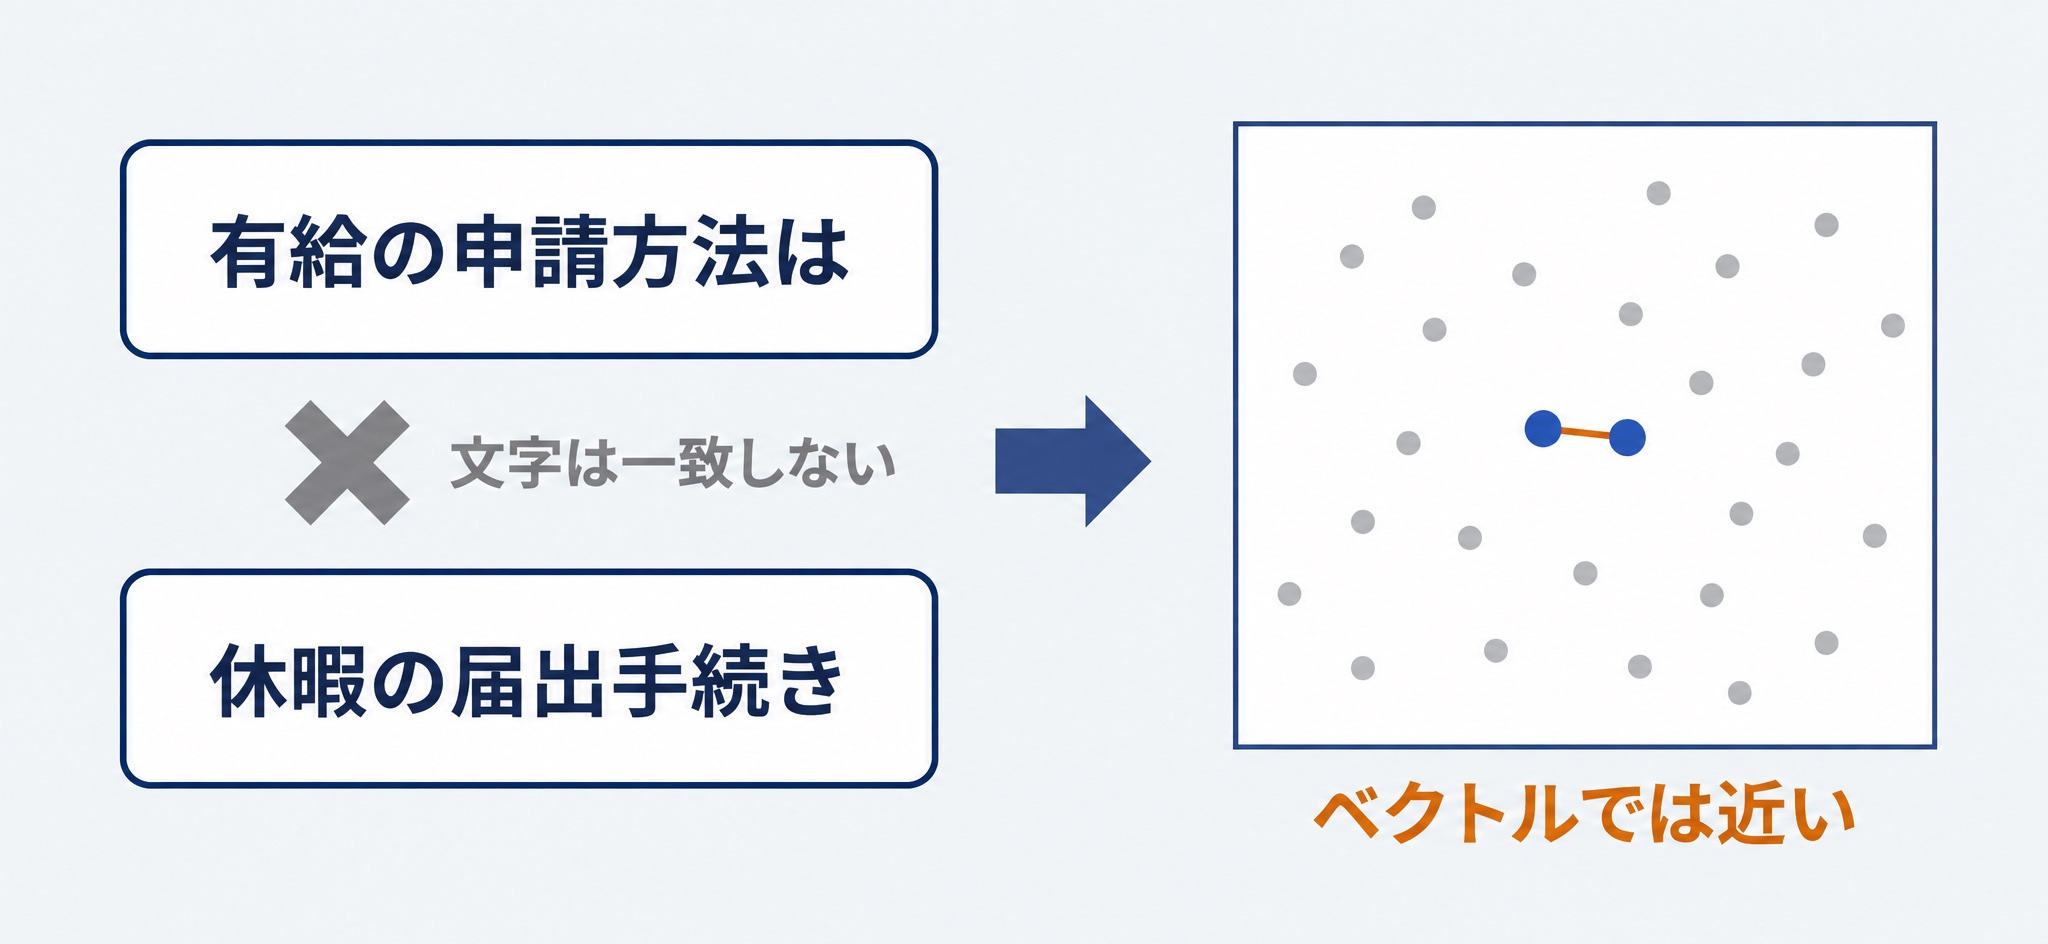
embeddingは、この2つの文を近いベクトルに変換します。文字が重なっているかではなく、似た文脈で使われる語かどうかで近さが決まるためです。
embeddingはLLMとは別のモデル。RAGのどこで動いているか
RAGの中でembeddingが働くのは、LLMが動く前の段階です。
- 文書をチャンクに分け、埋め込みモデルでベクトルにして保存する(事前の処理)
- 質問を同じ埋め込みモデルでベクトルにする(問い合わせのたび)
- 保存済みのベクトルの中から、質問のベクトルに近いものを取り出す
- 取り出した文書を質問と一緒にLLMへ渡し、回答を生成させる
LLMが登場するのは4だけです。1から3で使う埋め込みモデルは、生成モデルとは別に学習された別のモデルで、出力も文章ではなく数値の並びです。RAGとLLMの関係そのものはRAGとLLMの違いを整理した記事に、社内文書を対象にしたRAGの全体像は社内データをRAGで扱うときの進め方をまとめた記事にまとめています。
検索が外れているとき、原因の大半は1から3にあります。にもかかわらずLLMのプロンプトを直しにいく、という順序の取り違えが起きやすい場所です。
embeddingの仕組み。分散表現はどうやって意味を持つのか
embeddingが必要な理由は確かめました。次に、ベクトルの中にどうやって意味が入るのかに進みます。
分散仮説とword2vec。周りに出てくる語が意味を決める
出発点にあるのは、語の意味は、その語の周りに現れる語によって決まるという考え方です。分散仮説と呼ばれます。「精算」と「払い戻し」は、どちらも「経費」「申請書」「経理部」といった語と一緒に出てきます。だから近い意味を持つ、と扱います。
これを大規模に実行したのがword2vecです。Mikolovらの原論文「Efficient Estimation of Word Representations in Vector Space」は2013年1月16日に投稿され、”We propose two novel model architectures for computing continuous vector representations of words from very large data sets.” と書いています。16億語のデータから1日未満で高品質なベクトルを学習できる、というのが当時の主張でした(arXiv:1301.3781)。
word2vecの限界は、1つの語に1本のベクトルしか割り当てないことです。「機械学習のモデル」と「ファッションモデル」の「モデル」が同じベクトルになります。
文脈で変わるembeddingへ。BERTとSentence-BERTが変えたこと
この限界を解いたのが、文脈を見てベクトルを変える方式です。BERTでは、同じ「モデル」でも周囲の語によって違うベクトルが出ます。
ただしBERTをそのまま類似度計算に使うと、2文を同時に入力して1つのスコアを出す形になるため、組み合わせの数だけ推論が必要になります。Sentence-BERTの論文は “Finding the most similar pair in a collection of 10,000 sentences requires about 50 million inference computations (~65 hours) with BERT.” と書いています。1万文から最も似た組を見つけるのに約65時間かかる、という意味です。同じ論文は、文を先に1本のベクトルにしておく方式で “from 65 hours with BERT / RoBERTa to about 5 seconds with SBERT” と報告しています(arXiv:1908.10084)。
いまのRAGが「文書を事前にベクトル化して保存しておく」構成になっているのは、この65時間と5秒の差が理由です。
文のembeddingは、トークンのベクトルをまとめて作られる
文を1本のベクトルにする工程は、多くのモデルで次の流れになっています。
- 入力テキストをトークンに分ける
- 各トークンに、文脈を反映したベクトルを割り当てる
- トークンごとのベクトルをまとめて、1本の固定長ベクトルにする
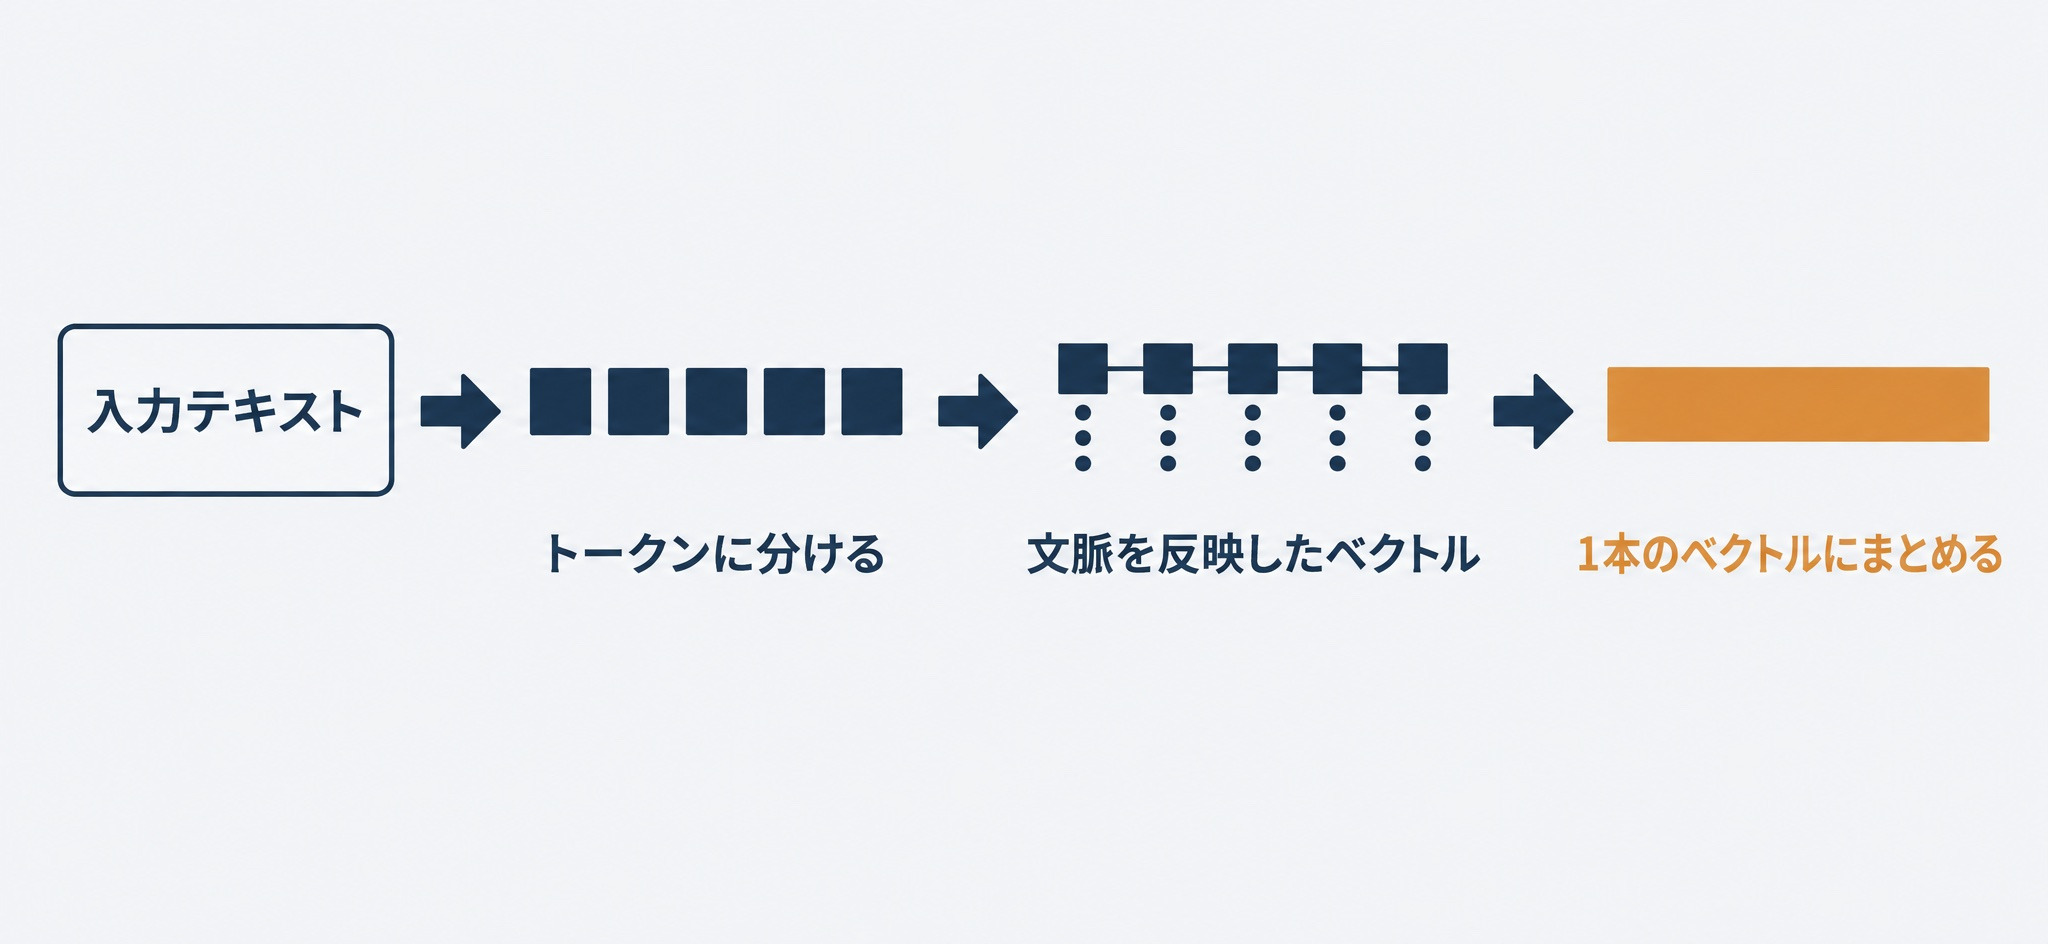
3のまとめ方は平均を取る方式(平均プーリング)が広く使われています。この「平均を取る」という構造が、後半で扱うチャンク長の問題の原因になります。長い文章を1本のベクトルに押し込むと、含まれている話題が平均されて薄まるためです。
embeddingの類似度の測り方。コサイン類似度・内積・ユークリッド距離
ベクトルができました。次は、その近さをどう測るかに進みます。
候補は3つあります。コサイン類似度(ベクトル同士の角度)、内積、ユークリッド距離です。OpenAIの公式ドキュメントは “We recommend cosine similarity. The choice of distance function typically doesn’t matter much.” と書いています(OpenAI Embeddings ガイド)。なぜ「たいして変わらない」のかを、手元で確かめます。
正規化されていれば、3つの順位は一致する
512次元のベクトル1,000件とクエリ1件を用意し、長さを1に揃えて(正規化して)から3つの測り方を比べます。
import numpy as np
rng = np.random.default_rng(0)

V = rng.normal(size=(1000, 512))          # 文書ベクトル1,000件
q = rng.normal(size=512)                  # クエリ1件
unit = lambda a: a / np.linalg.norm(a, axis=-1, keepdims=True)
Vn, qn = unit(V), unit(q)

cos = Vn @ qn
euc = np.linalg.norm(Vn - qn, axis=1)
print("コサイン類似度の上位5件:", np.argsort(-cos)[:5])
print("ユークリッド距離の下位5件:", np.argsort(euc)[:5])
print("euc^2 と 2-2cos の最大差:", float(np.max(np.abs(euc**2 - (2 - 2 * cos)))))
コサイン類似度の上位5件もユークリッド距離の下位5件も [882 897 291 88 377] で、順序まで同じでした。ユークリッド距離の2乗と 2 - 2 × コサイン類似度 の差は最大 8.9e-16 で、これは浮動小数点の誤差の範囲です。長さが1に揃っていれば、2つは同じものを別の形で書いているだけになります。
OpenAIの公式ドキュメントも “OpenAI embeddings are normalized to length 1, which means that: Cosine similarity can be computed slightly faster using just a dot product” と書いています。正規化済みのベクトルなら、割り算を省いて内積だけで済みます。
正規化していないベクトルで内積を使うと、上位が入れ替わる
問題は、正規化されていないベクトルを内積で比べたときです。同じ1,000件のベクトルについて、向きはそのままに長さだけを0.5倍から3倍の範囲でばらつかせ、内積で文書をもう一度並べ替えてみます。
Vraw = Vn * rng.uniform(0.5, 3.0, size=(1000, 1))
dot_raw = Vraw @ qn
print("正規化なしの内積の上位5件:", np.argsort(-dot_raw)[:5])
print("上位10件の一致数:", len(set(np.argsort(-cos)[:10].tolist()) & set(np.argsort(-dot_raw)[:10].tolist())))
上位5件は [88 606 882 260 155] に変わり、上位10件のうち一致したのは5件だけでした。向きが同じでも、長いベクトルのほうが内積で上に来ます。Microsoft Learnの解説も、「2 つのドキュメントのサイズが原因でユークリッド距離によって離れている場合でも、それらの間の角度が小さくなり、コサインの類似性が高くなる可能性がある」と書いています(Azure OpenAI の埋め込み)。
実務での手順は3つです。
- 使う埋め込みモデルの出力が正規化済みかを、モデルカードか公式ドキュメントで確認する
- 正規化されていなければ、ベクトルデータベースに入れる前に自分で正規化する
- 正規化したあとは内積を使う。割り算が消えるぶん速く、結果はコサイン類似度と同じです
類似度スコアにしきい値を置けない理由。分布は次元数で決まる
次に、出てきたスコアの読み方です。「0.8以上なら関連あり」という運用が壊れやすいのは、0.8という数字が何と比べて高いのかが決まっていないからです。
比較の基準になるのは、まったく無関係なベクトル同士がどのくらいの値を取るかです。次元数を変えて実際に測ります。
import numpy as np
rng = np.random.default_rng(0)
for d in [64, 384, 768, 1536, 3072]:
    unit = lambda a: a / np.linalg.norm(a, axis=1, keepdims=True)
    A, B = unit(rng.normal(size=(2000, d))), unit(rng.normal(size=(2000, d)))
    s = np.sum(A * B, axis=1)
    print(f"{d:5d}次元 平均{s.mean():+.4f} 標準偏差{s.std():.4f} "
f"99パーセンタイル{np.percentile(s, 99):.4f} 1/sqrt(d)={1/np.sqrt(d):.4f}")| 次元数 | 平均 | 標準偏差 | 99パーセンタイル | 次元数の平方根の逆数 |
|---|---|---|---|---|
| 64 | +0.0031 | 0.1234 | 0.2876 | 0.1250 |
| 384 | +0.0013 | 0.0522 | 0.1197 | 0.0510 |
| 768 | +0.0012 | 0.0354 | 0.0826 | 0.0361 |
| 1,536 | -0.0005 | 0.0253 | 0.0574 | 0.0255 |
| 3,072 | -0.0000 | 0.0183 | 0.0414 | 0.0180 |
この表から読み取れることは2つです。標準偏差が次元数の平方根の逆数とほぼ一致しており、無関係なもの同士の類似度の散らばりは次元数だけで決まります。そして64次元では無関係でも0.2876まで出るのに対し、1,536次元では0.0574止まりです。同じ「0.2」でも、64次元なら誤差の範囲、1,536次元なら極めて近い、という正反対の意味になります。
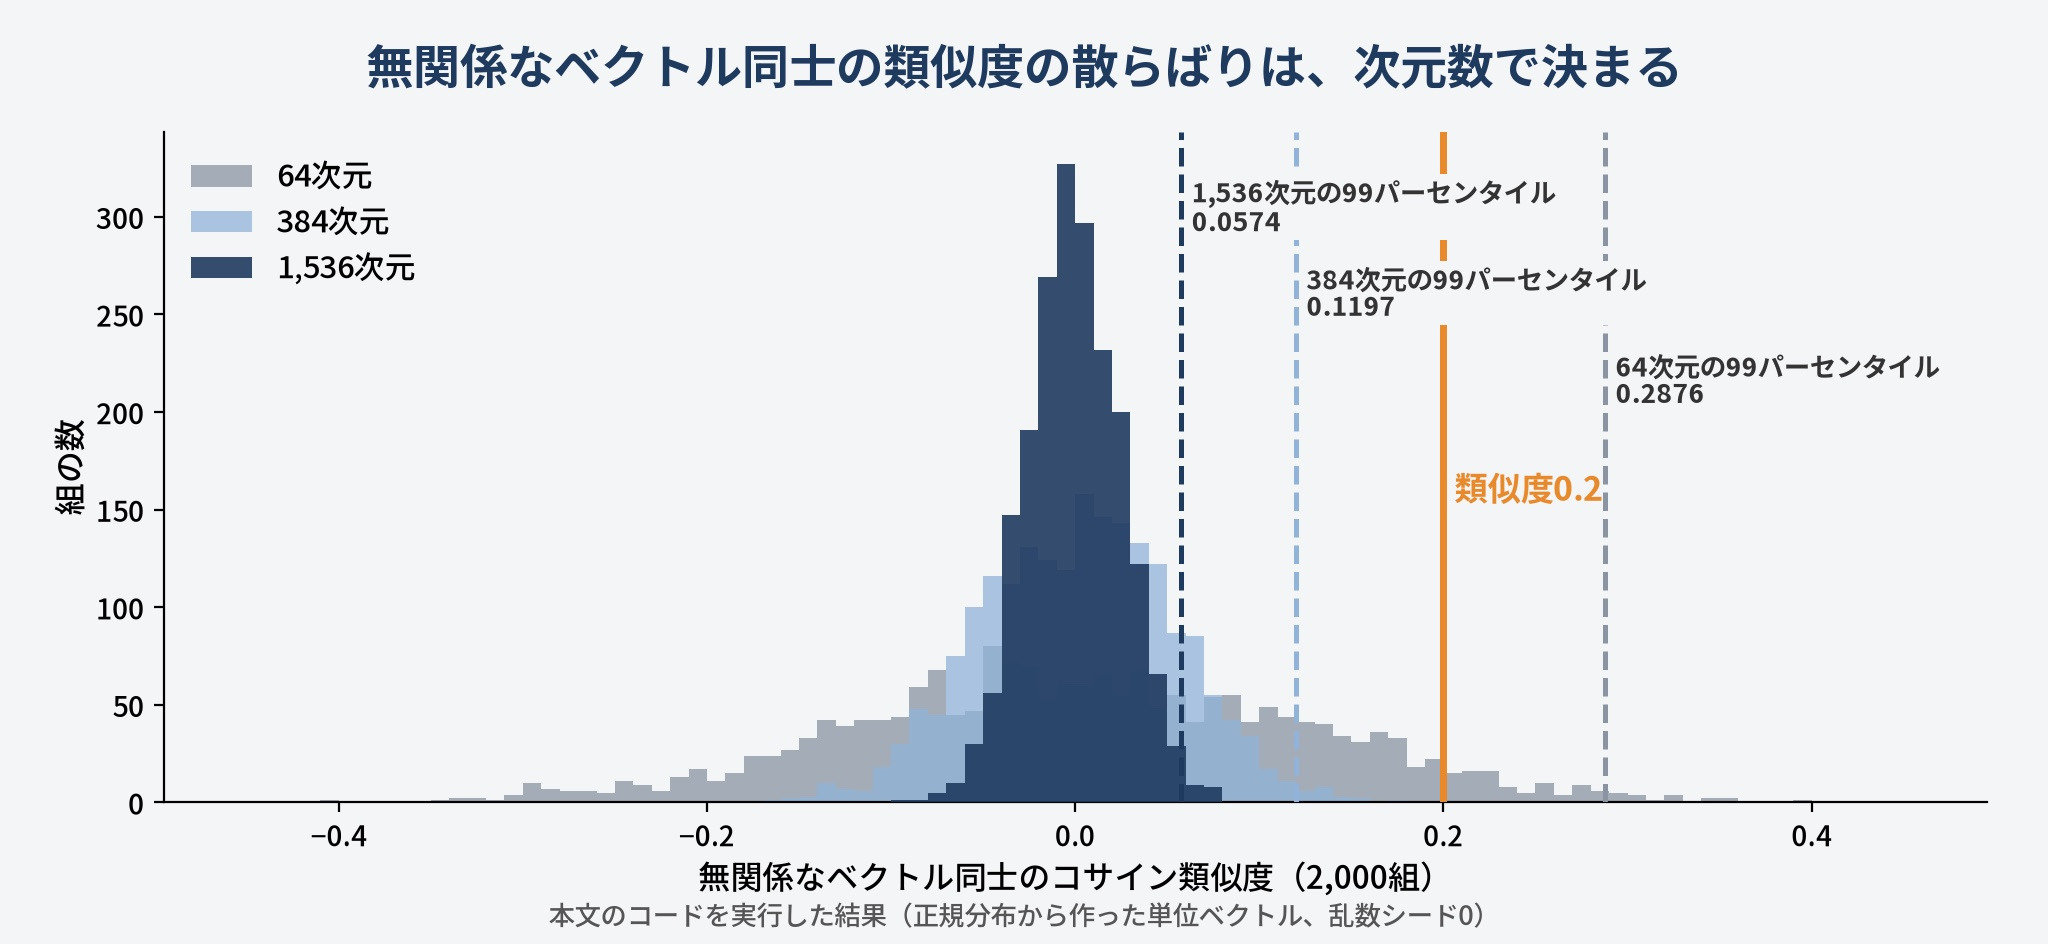
ところが学習済みの埋め込みモデルでは、無関係な文同士でも、この表の値よりはるかに高い類似度が出ます。理由は次のとおりです。学習済みモデルのベクトルは空間全体に均等に散らばっておらず、特定の方向に偏っているためです。Ethayarajhの論文は “the contextualized representations of all words are not isotropic in any layer” と報告しています(arXiv:1909.00512)。全体が一方向に寄っていれば、無関係な2つでも角度は小さくなります。
したがって、しきい値は次の手順で決めます。
- 自分のコーパスから、関係のない文書の組を1,000組ほど無作為に取り出し、類似度の分布を測る
- その分布の上位1%にあたる値を出発点にして、しきい値の候補を置く
- 評価用の質問セットで、そのしきい値のときのRecallと誤検出の数を確認する
- 埋め込みモデルを差し替えたら、1から測り直す
他社の記事やサンプルコードに書かれたしきい値は、そのモデルとそのコーパスでの値です。持ち込んでも合いません。
ここまでembeddingの測り方を整理しましたが、「検索が外れたときに、embeddingとチャンクと検索のどこが原因かを自分で切り分けられるようになりたい」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座 Advanced は、Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムです。RAGの検索基盤と生成・運用、コンテキストエンジニアリング、評価とLLM-as-a-Judgeまでを扱い、既製のフレームワークに寄せず生のAPIと自作のコードで骨格を実装します。毎週の実装課題には現役データサイエンティストのコードレビューが付くため、本記事で行ったような「測って比べ直す」作業を、判断の妥当性を確かめてもらいながら進められます。
まずは講座の内容を確認してみてください。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
embeddingが効かないときに疑う3つのこと
測り方としきい値の決め方は固まりました。次は、正しく測っても検索が外れるときに、どこを疑うかに進みます。RAGの精度を検索と生成に分けて数値で測る方法はRAGASを使った評価方法の記事にまとめてあるので、切り分けの前にそちらで検索側の数字を出しておくと判断が速くなります。
チャンクが長いと、どの質問にも中くらい似てしまう
最初に疑うのはチャンクの長さです。前半で触れたとおり、文のembeddingは多くの場合トークンごとのベクトルの平均で作られます。質問に関係する記述が1文しか入っていないチャンクを長くすると、その1文の寄与が薄まります。
どのくらい薄まるのかを測ります。768次元で、質問の話題に対応する1文と、無関係な文を混ぜたチャンクを作り、平均プーリングしたベクトルと質問との類似度を見ます。
import numpy as np
rng = np.random.default_rng(0)
d, noise = 768, 1.0 / np.sqrt(768)
unit = lambda v: v / np.linalg.norm(v)
topic = unit(rng.normal(size=d))          # 質問が求めている話題

def chunk(n_sent):
    """n_sent文を平均プーリングしたチャンク。質問に関連するのは1文だけ"""
    vs = [unit(topic + rng.normal(scale=noise, size=d))]
    vs += [unit(rng.normal(size=d)) for _ in range(n_sent - 1)]
    return unit(np.mean(vs, axis=0))

for n in [1, 2, 4, 8, 16, 32]:
print(f"{n:2d}文のチャンク: 平均コサイン類似度 {np.mean([float(chunk(n) @ topic) for _ in range(300)]):.3f}")1文のチャンクでは0.707だった類似度が、2文で0.501、4文で0.354、8文で0.250、16文で0.178、32文で0.122まで下がりました。減り方は、文数の平方根の逆数に比例する形です。8文にしただけで、1文のときの3分の1近くになっています。
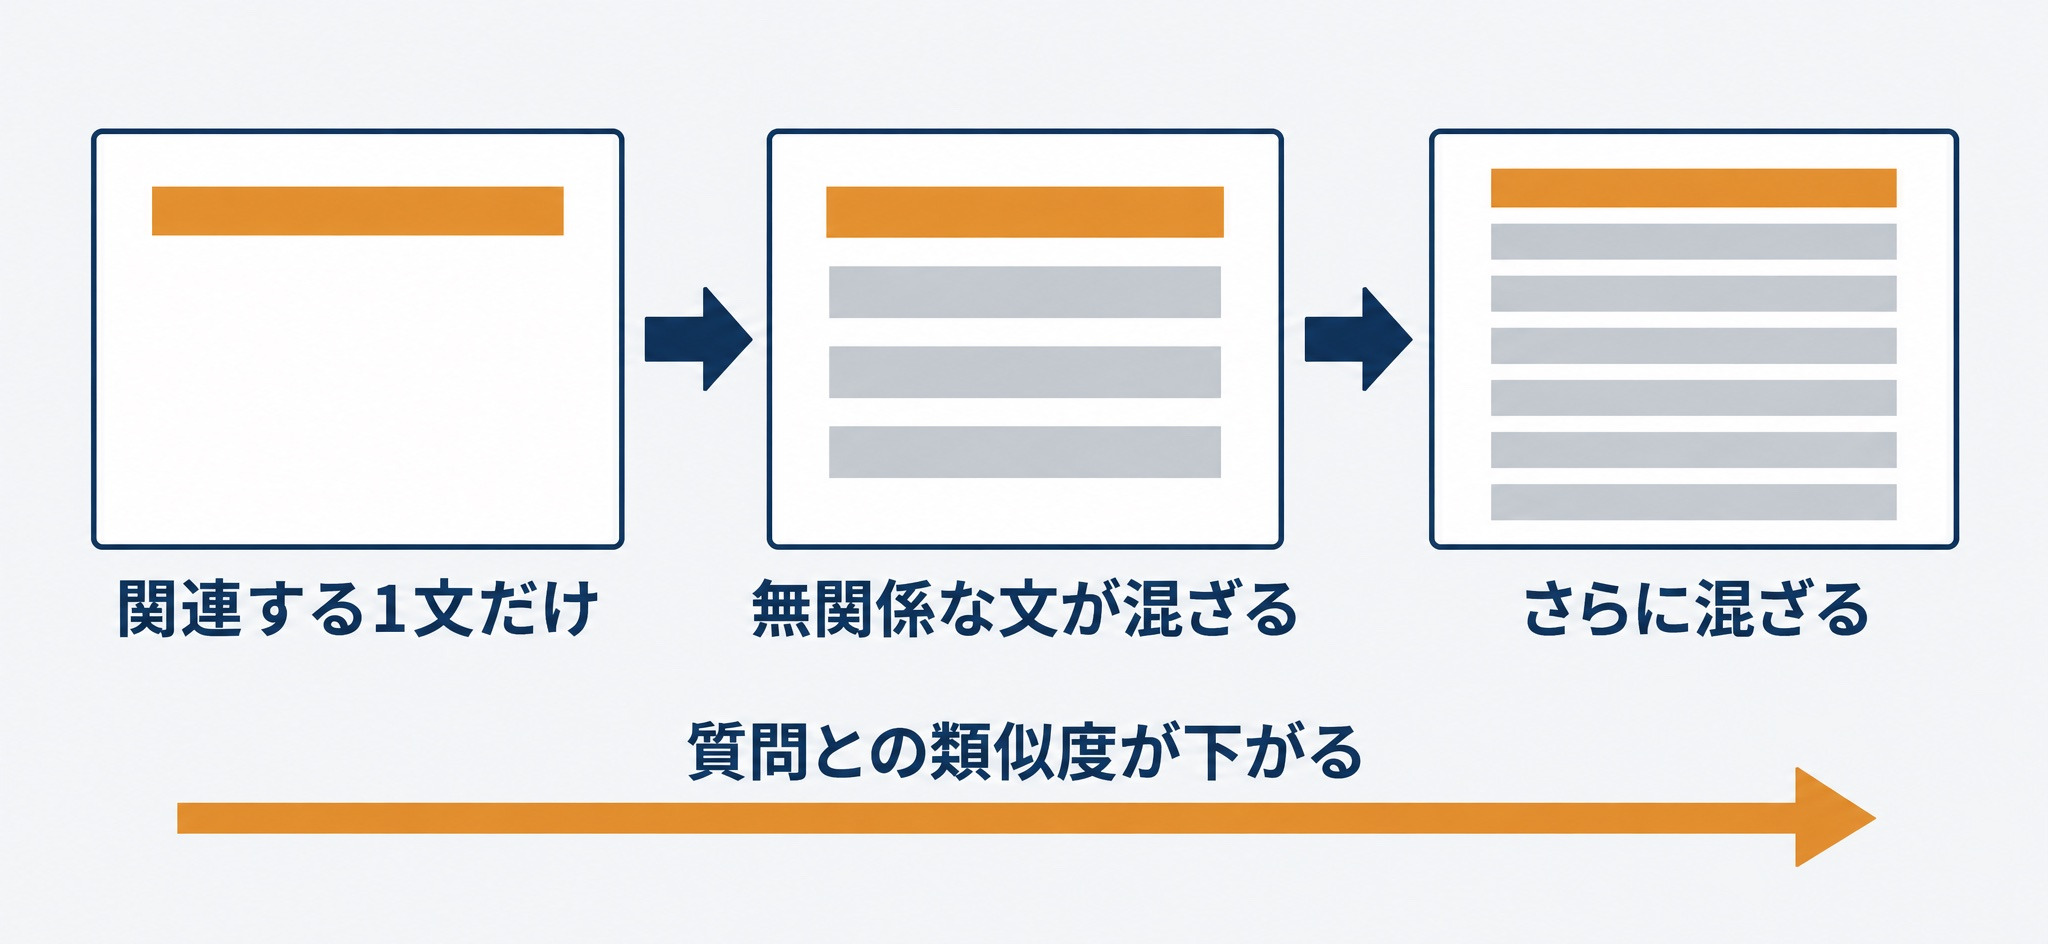
これは平均プーリングという構造から出てくる現象なので、モデルを変えても向きは変わりません。取れる手は3つです。
- 1つのチャンクに1つの論点だけを入れる。規程や手順書なら、条・項の単位で切ります
- 見出しや章のタイトルを各チャンクの先頭に付け直す。長さを増やさずに文脈を戻せます
- 検索する単位と、LLMに渡す単位を分ける。小さいチャンクで検索し、ヒットしたら前後を含む大きい範囲を取り出してLLMに渡します
なお、測定条件は768次元・各条件300回・乱数シード0です。実際のモデルでは文同士が完全に無関係になることはないため、減り方はこれより緩やかになります。
型番・日付・否定は苦手。語彙一致の検索と組み合わせる
2つ目は、embeddingが構造的に弱い入力です。
- 型番・品番・法令の条番号:「ABC-100」と「ABC-1000」は文字がほぼ同じなので、ベクトルも近くなります。違うものを区別したいのに、近いと判定されます
- 日付・年度・バージョン:「2024年度」と「2025年度」も同様です。規程の改訂前後を取り違える原因になります
- 否定:「本制度は契約社員を対象とします」と「本制度は契約社員を対象としません」は、語がほとんど共通するため高い類似度になります
いずれも、意味の近さを角度で測るという仕組みそのものから来る弱点です。埋め込みモデルを変えても解消しません。型番や日付が効く検索では、語彙の一致を見る検索(BM25など)を併用し、両方のスコアを統合します。否定については、検索で取り出した文書をLLMが誤って読むケースが重なるため、AIハルシネーションの原因と対策をまとめた記事の観点も合わせて確認しておくと見落としが減ります。
質問と文書は形が違う。前置き文と埋め込む単位を揃える
3つ目は、質問と文書の形の違いです。質問は「経費の精算はいつまで」のように短い疑問形、文書は「旅費の立替分は、帰着後14日以内に」のように長い説明文です。同じモデルにそのまま入れると、形の違いのぶんだけ距離が開きます。
そのため多くの検索向け埋め込みモデルは、質問と文書に別々の前置き文(prefix)を付けることを前提に学習されています。「query:」と「passage:」のように指定されているモデルでは、この前置きを付け忘れると精度が落ちます。質問と文書に同じ前置きを付けるのも、学習時の使い方と違うため同じく精度が落ちます。
確認する順序は次のとおりです。
- モデルカードに前置き文の指定があるかを読む
- 指定があれば、質問側と文書側それぞれに指定どおりの前置きを付ける
- 文書を保存するときと質問を投げるときで、前処理(全角半角の統一・改行の扱い・記号の除去)を同じにする
- 評価用の質問セットで、前置きの有無による差を実際に測る
埋め込みモデルの選び方。ベンチマーク・次元数・APIとローカル
原因の切り分け方は揃いました。そのうえで、土台になる埋め込みモデルをどう選ぶかに進みます。
MTEBとJMTEBを出発点にして、自分のデータで測り直す
出発点になるのは公開ベンチマークです。
MTEB(Massive Text Embedding Benchmark)は、”MTEB spans 8 embedding tasks covering a total of 58 datasets and 112 languages.” と説明されています。同じ論文は “no particular text embedding method dominates across all tasks” とも書いており、全タスクで勝つモデルは無いという結論を出しています(arXiv:2210.07316)。
日本語では、SB Intuitionsが公開しているJMTEBがあります。データセットカードでは “5 tasks” と “28 datasets in total” とされ、Clustering・Classification・STS・Retrieval・Reranking の5種類を扱います(JMTEB データセットカード)。
ここで気をつけたいのは、ベンチマークの総合順位は、自分の用途での順位ではないという点です。MTEBの8タスクには分類・クラスタリング・要約なども含まれており、RAGで効くのはRetrievalの成績です。手順としては、ベンチマークで候補を3つ程度に絞り、そのあとは自分のデータで測ります。
- 自社の文書から、想定される質問と正解チャンクの組を50問から100問作る
- 候補モデルそれぞれでベクトルを作り直し、Recall@5やRecall@10を比べる
- 差が誤差の範囲なら、精度ではなく運用条件(次元数・レイテンシ・閉域で動くか)で決める
次元数は大きいほど良いわけではない
次元数は、モデルによって既定値が違います。OpenAIの公式ドキュメントは “By default, the length of the embedding vector is 1536 for text-embedding-3-small or 3072 for text-embedding-3-large.” と書いています。Cohereの公式ドキュメントでは、embed-v4.0 の出力次元が [256,512,1024,1536] から選べるとされています(Cohere Embed ドキュメント)。
次元数を増やすと、表現できる情報は増えますが、費用も増えます。100万チャンクを1,536次元のfloat32で保存すると、ベクトルだけで約6.1GBです(1,000,000 × 1,536 × 4バイト)。3,072次元にすれば約12.3GBになり、検索1回あたりの計算量も倍になります。前節の手順2でRecallに差が出ないなら、小さいほうを選ぶ理由のほうが強くなります。
APIか、自前で動かすか。判断の分かれ目
もう1つの分かれ目は、APIで呼ぶか、自社の環境でモデルを動かすかです。
| 判断軸 | APIで呼ぶ | 自前で動かす |
|---|---|---|
| 文書の持ち出し | 外部へ送る。契約と規程の確認が要る | 閉域で完結できる |
| 初期の手間 | 鍵を発行すれば動く | GPUの用意とモデルの配置が要る |
| 費用の形 | 処理したトークン量に応じて増える | 設備と運用の固定費 |
| 全件の作り直し | 100万チャンク規模だと費用とレート制限が効いてくる | 時間はかかるが追加費用は小さい |
| モデルの固定 | 提供側の都合で新旧が入れ替わる | 自分でバージョンを固定できる |
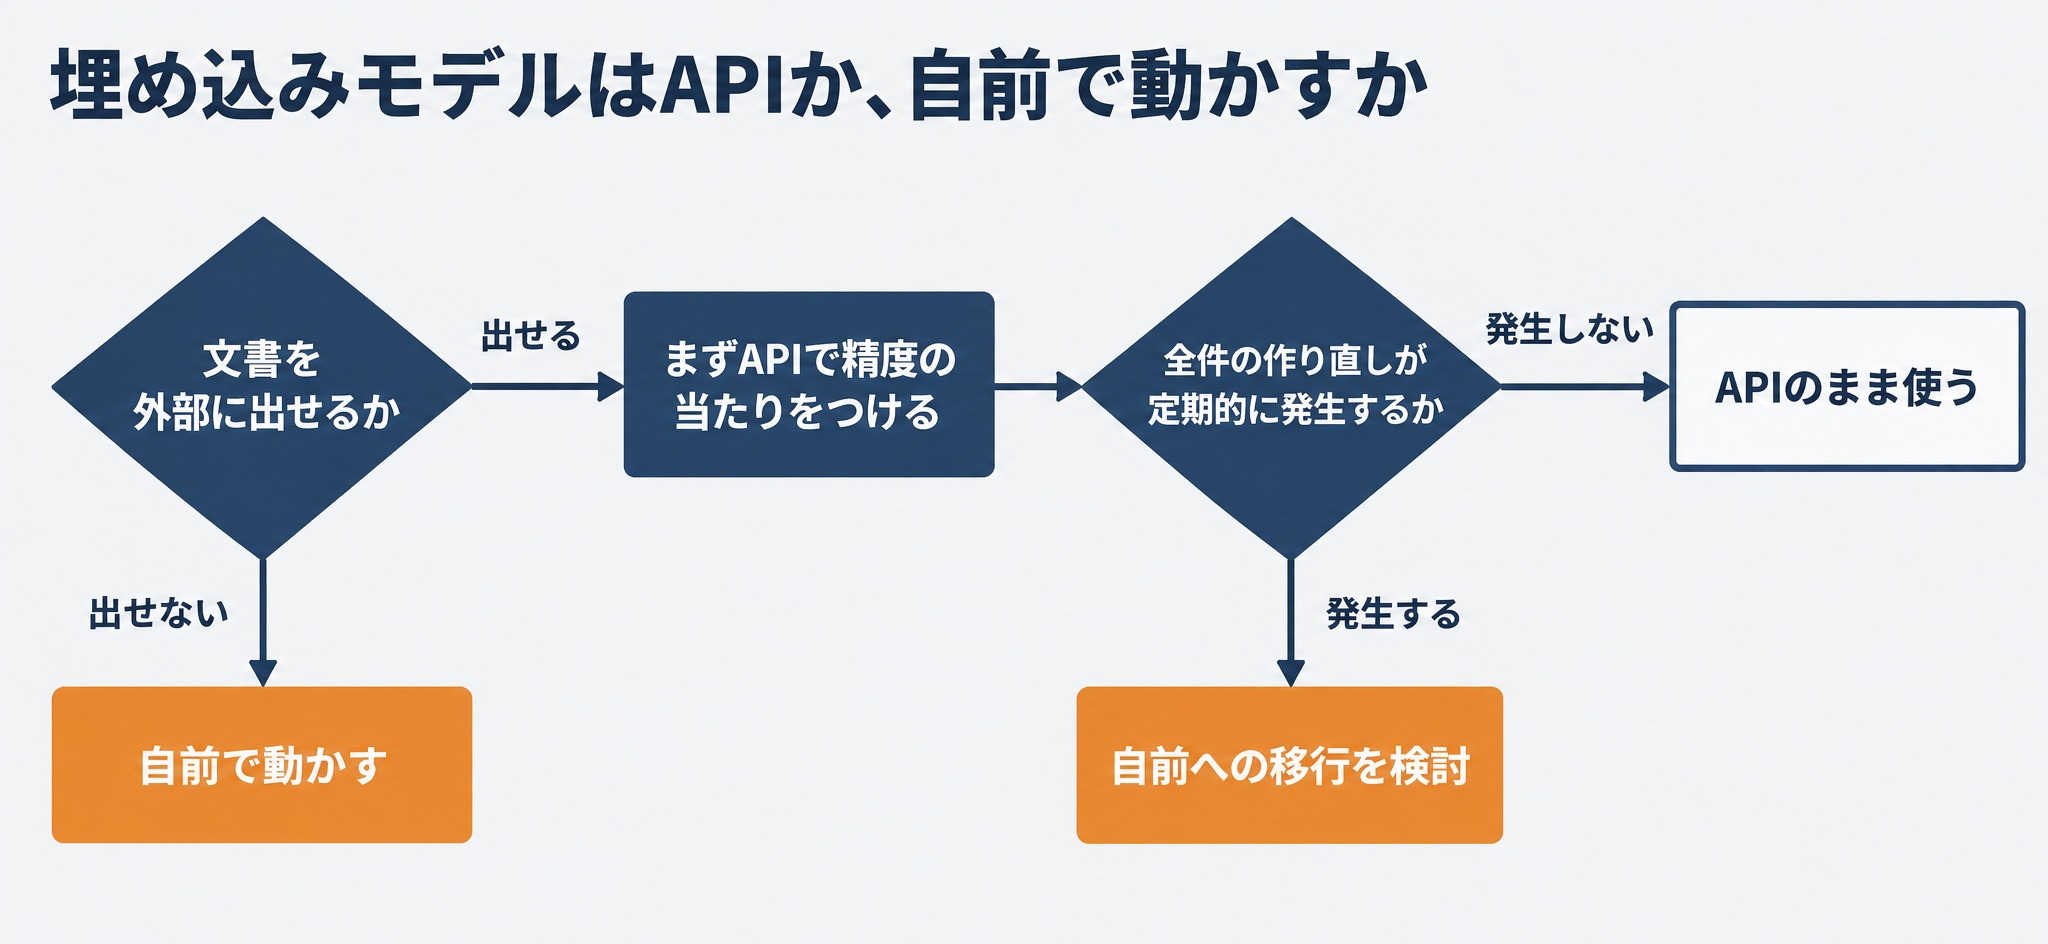
判断の順序としては、文書を外部に出せるかどうかを先に確定させます。出せないなら自前一択です。出せる場合は、まずAPIで精度の当たりをつけ、全件の作り直しが定期的に発生する見込みが立った時点で自前への移行を検討する、という進め方が現実的です。閉域でLLMとRAGを組む構成はローカルLLMとRAGを組み合わせる進め方の記事で扱っています。
embeddingの保存と検索のコスト。次元の切り詰めと量子化を実測する
モデルを決めたら、本番に載せるときの容量と速度が次の問題になります。5万件・1,024次元のベクトルを作り、全件をfloat32で総当たりしたときの上位10件を正解として、圧縮したときにどれだけ一致するか(recall@10)を測ります。
import numpy as np
rng = np.random.default_rng(0)
N, d, K = 50_000, 1024, 500
unit = lambda a: a / np.linalg.norm(a, axis=-1, keepdims=True)

centers = unit(rng.normal(size=(K, d)))                                  # 500個の話題
V = unit(centers[rng.integers(0, K, N)] + rng.normal(scale=1/np.sqrt(d), size=(N, d)))
Q = unit(centers[rng.integers(0, K, 200)] + rng.normal(scale=1/np.sqrt(d), size=(200, d)))
top10 = lambda S: [set(r.tolist()) for r in np.argpartition(-S, 10, axis=1)[:, :10]]
exact = top10(Q @ V.T)
recall = lambda idx: float(np.mean([len(a & b) / 10 for a, b in zip(exact, idx)]))

for k in [512, 256]:                                                      # 先頭k次元だけ使う
    Vt, Qt = unit(V[:, :k]), unit(Q[:, :k])
    print(f"先頭{k}次元: recall@10 = {recall(top10(Qt @ Vt.T)):.3f}  {Vt.nbytes/1e6:.1f} MB")

lo, hi = V.min(), V.max()                                                 # int8スカラー量子化
Vq = np.round((V - lo) / (hi - lo) * 255).astype(np.uint8)
Vdq = Vq.astype(np.float32) / 255 * (hi - lo) + lo
print(f"int8量子化: recall@10 = {recall(top10(Q @ Vdq.T)):.3f}  {Vq.nbytes/1e6:.1f} MB")

Vb, Qb = np.packbits(V > 0, axis=1), np.packbits(Q > 0, axis=1)           # 1bit量子化
tbl = np.unpackbits(np.arange(256, dtype=np.uint8)[:, None], axis=1).sum(1).astype(np.int16)
ham = np.stack([tbl[np.bitwise_xor(Vb, qb)].sum(1) for qb in Qb])
print(f"1bit量子化のみ: recall@10 = {recall([set(np.argpartition(h,10)[:10].tolist()) for h in ham]):.3f}  {Vb.nbytes/1e6:.1f} MB")

cand = np.argpartition(ham, 100, axis=1)[:, :100]                         # 100件に絞ってfloat32で並べ直す
res = [set(c[np.argpartition(-(V[c] @ Q[i]), 10)[:10]].tolist()) for i, c in enumerate(cand)]
print(f"1bit量子化 + 上位100件をfloat32で並べ直す: recall@10 = {recall(res):.3f}")| 圧縮のしかた | recall@10 | ベクトルの容量 |
|---|---|---|
| float32のまま(基準) | 1.000 | 409.6 MB |
| 先頭512次元だけ使う | 0.458 | 204.8 MB |
| 先頭256次元だけ使う | 0.299 | 102.4 MB |
| int8に量子化 | 0.976 | 51.2 MB |
| 1bitに量子化 | 0.355 | 6.4 MB |
| 1bitで100件に絞り、float32で並べ直す | 0.998 | 6.4 MB(並べ直しに元データが要る) |
この表から読み取れることは2つです。同じ「容量を減らす」でも、次元を切るのと値の精度を落とすのでは結果がまったく違います。そして1bitまで落としても、並べ直しを入れれば精度は戻ります。測定条件は5万件・1,024次元・500クラスタ・クエリ200件・乱数シード0での1回の測定で、実際のモデルの出力とは分布が違います。
次元を自分で切り詰めてよいのは、そう学習されたモデルだけ
先頭512次元だけを使うとrecall@10が0.458まで落ちました。これは情報が先頭の次元に集まるようには作られていないベクトルを、後ろから切り捨てた場合の数値です。
一方でOpenAIの公式ドキュメントは、”developers can shorten embeddings (i.e. remove some numbers from the end of the sequence) without the embedding losing its concept-representing properties by passing in the dimensions API parameter” と書いています。末尾を削っても概念を表す性質が失われない、という記述です。この2つは矛盾しません。切り詰めが成立するのは、モデルがそう学習されている場合だけだからです。
その学習方法がMatryoshka Representation Learning(MRL)です。2022年5月に投稿された論文は、手法が “encodes information at different granularities and allows a single embedding to adapt to the computational constraints of downstream tasks” だと述べています(arXiv:2205.13147)。粒度の違う情報を1本のベクトルに入れ子で詰めるので、前から必要なぶんだけ使えます。
判断はこうなります。
- モデルがMRLで学習されているか、
dimensionsのような短縮の仕組みを公式に提供しているかを確認する - 提供されていれば、短縮後の次元で自分の評価セットのRecallを測り、落ちなければ採用する
- 提供されていないモデルのベクトルを、自分の判断で後ろから切り捨てない
int8量子化とバイナリ量子化。float32で並べ直せば戻せる
次元を触らずに容量を減らすなら、1つ1つの数値の精度を落とす方向が効きます。
int8への量子化は、recall@10が0.976でメモリが409.6MBから51.2MBへ、8分の1になりました。Cohereの公式ドキュメントでも、出力形式として float・int8・unint8・binary・ubinary が選べるとされています。
1bit(符号だけを残すバイナリ量子化)は、それだけで使うとrecall@10が0.355まで落ちます。ただし、バイナリで候補を100件に絞ってから、その100件だけを元のfloat32で並べ直すと0.998まで戻りました。バイナリの索引は6.4MBです。sentence-transformersの公式ドキュメントも、この並べ直し(rescoring)を前提に “32x reduction in memory and storage usage” と “we are able to preserve up to ~96% of the total retrieval performance” と書いています(Embedding Quantization)。
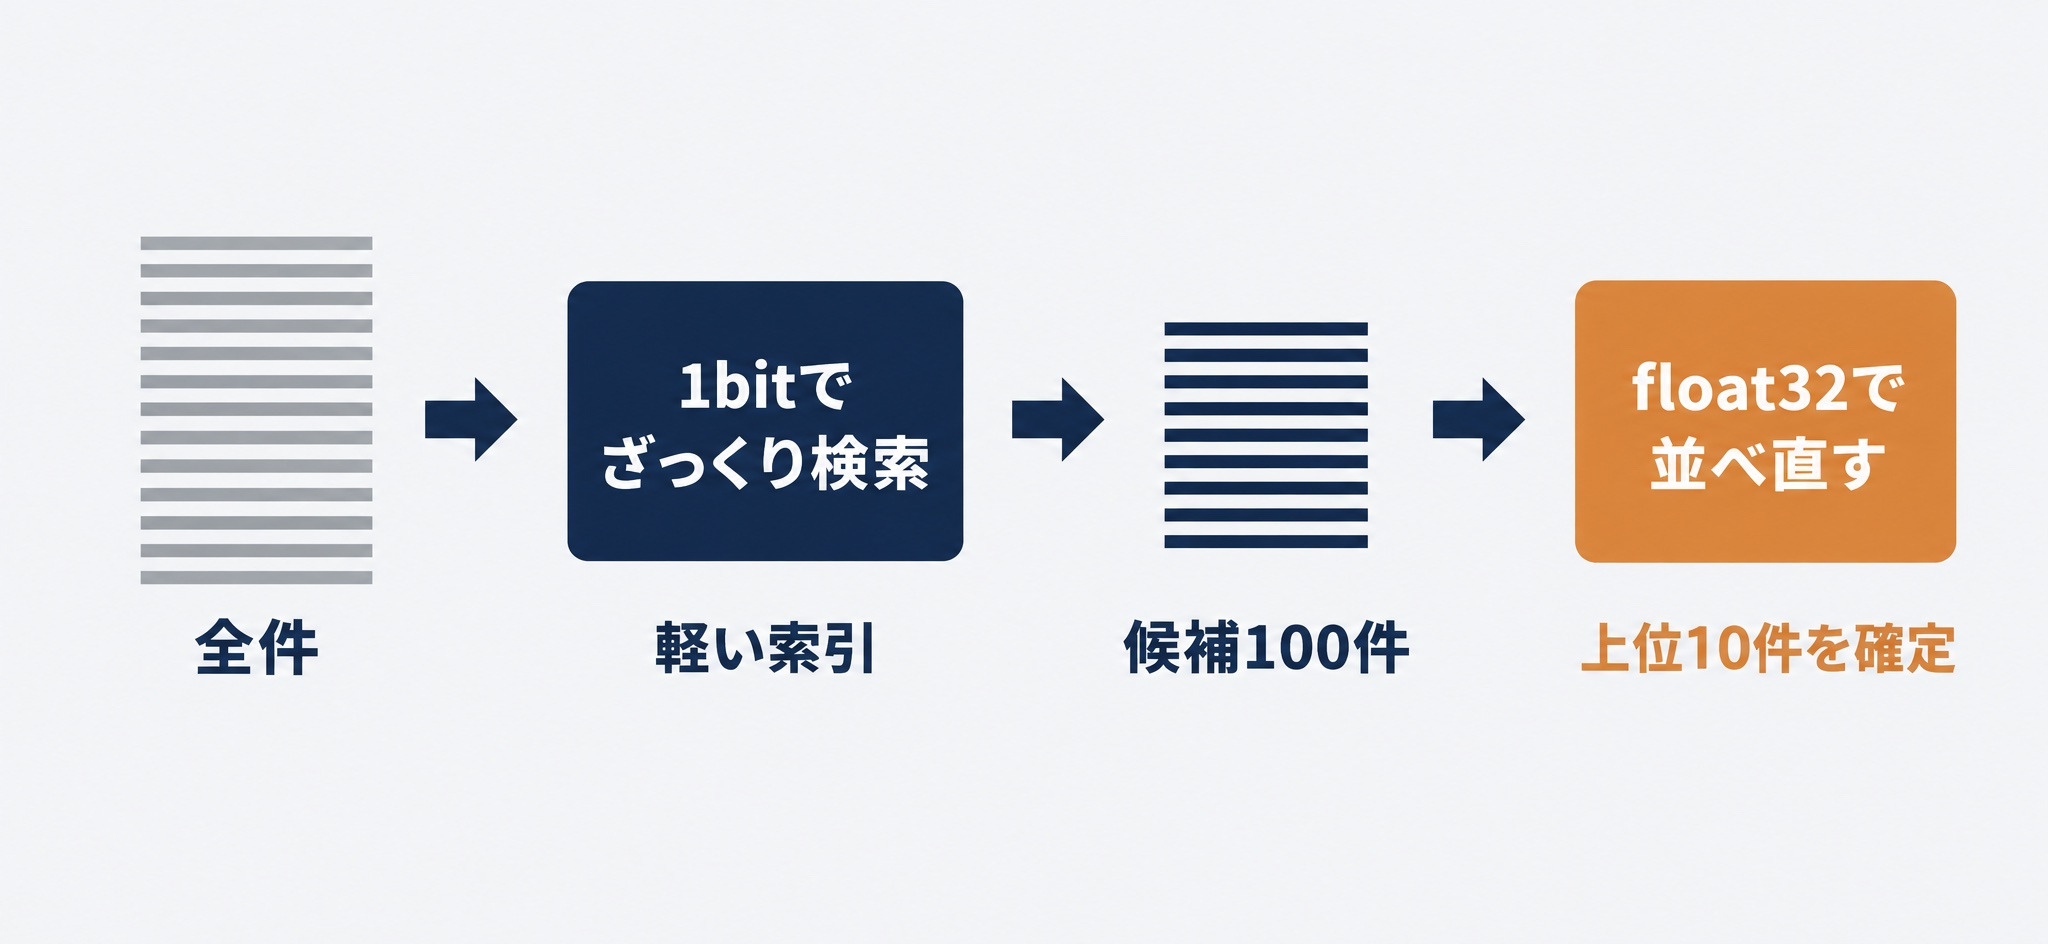
この並べ直しは、別のモデルでスコアを付け直すリランキングとは別物です。同じベクトルを使って、精度を落とした分を戻しているだけなので、追加のモデルも推論コストもかかりません。
埋め込みモデルを変えたら全件作り直す。だから選定は寿命で決める
最後に運用です。異なる埋め込みモデルが作ったベクトルは、同じ空間にありません。次元数が同じでも比較できません。したがってモデルを差し替えるときは、保存済みのチャンクを全件ベクトル化し直すことになります。
100万チャンクあれば、APIなら費用とレート制限、自前なら計算時間が丸ごとかかります。「いま一番精度が高いモデル」ではなく「当面動かさずに済むモデル」で選ぶほうが、総額では安くなるのはこのためです。
運用では次の3つを決めておきます。
- ベクトルと一緒に、使った埋め込みモデル名・バージョン・次元数・前置き文の有無をメタデータとして保存する
- モデルを入れ替えるときは、既存の索引を上書きせず、新しい索引を別に作ってから切り替える
- 切り替えの前に、評価用の質問セットで新旧のRecallを測り、数字で比べてから判断する
embeddingの要点整理
- embeddingとは、テキストを、意味の近さがベクトルの近さとして表れる固定長の数値の並びに変換したもの。分散表現・埋め込み表現はいずれも同じものを指します
- 文字の一致では言い換えを拾えない。10文書の実測では、無関係な文書が0.256、答えの書かれた文書が0.058で、無関係なほうが4倍以上高く出ました
- 正規化済みなら、コサイン類似度・内積・ユークリッド距離の順位は一致する。正規化していないベクトルで内積を使うと、上位10件のうち5件が入れ替わりました
- 類似度スコアの値そのものにしきい値は置けない。無相関なベクトルの散らばりは次元数の平方根の逆数で決まり、学習済みモデルではさらに偏りが乗ります。自分のコーパスで分布を測ってから決めます
- チャンクを長くすると類似度が薄まる。関連が1文だけのチャンクでは、1文の0.707が8文で0.250まで下がりました
- 容量を減らすなら、次元を切るのではなく値の精度を落とす。int8でrecall@10は0.976、1bitでも並べ直しを入れれば0.998でした
embeddingを含むRAGの設計を体系的に学ぶなら「Craft College」へ
本記事で扱ったのは、検索が外れたときに何を疑い、どの数値を自分で測って確かめるかという作業でした。実務でこの次に来るのは、その判断を一度きりで終わらせず、評価セットを持って記録しながら改善を積み上げる仕組みです。
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced を提供しています。Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムで、LLMアプリケーション設計基礎、コンテキストエンジニアリング、RAG、マルチモーダルAI、評価とLLM-as-a-Judge、AIエージェントとマルチエージェント、LLMセキュリティ、ローカルLLM、ファインチューニング、卒業制作までを扱います。既製のフレームワークに寄せず、生のAPIと自作のコードで骨格を実装するのが方針です。毎週の実装課題には現役データサイエンティストのコードレビューが付き、少人数のコホートで進みます。
機械学習の基礎から始めたい方には、9ヶ月36週のデータサイエンティスト養成講座があります。AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に進む構成です。経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座で、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。支給の可否は最終的にハローワーク等が判断します。
リベルクラフトでは、AI開発・データサイエンス開発の支援も行っています。要件定義からPoC、本番運用までを一貫して支援しており、本記事で扱った埋め込みモデルの選定、チャンク設計、検索の評価設計もその対象です。自社のデータで何から手をつけるかを決める段階からご相談いただけます。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
⇨AI開発・データサイエンス開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。