自然言語処理とは。形態素解析からLLMまでの流れと業務での使い方を解説
自然言語処理の解説を読むと、形態素解析・構文解析・意味解析・文脈解析という4つの工程が並んでいます。一方で、いま使っているChatGPTがこの4工程を順番に実行しているのかというと、そうではありません。
用語を並べた記事は多いのですが、なぜ技術がそう変わってきたのかを説明したものは多くありません。単語を数える方法の何が足りなくて分散表現が要ったのか。1語ずつ処理する方法の何が問題でアテンション機構が出てきたのか。ここが分かると、いまのLLMが何をしているのかも見えてきます。
そこで本記事では、
- 自然言語処理とは何か。機械学習・生成AIとの関係
- 解こうとしてきた4つの課題
- ルールと統計から分散表現へ、という手法の変化
- Transformer以降、LLMで何が変わったか
- 業務での4つの使い方
- 社内文書を検索可能にする進め方
を、一本の流れとして解説します。
「社内の文書をAIで検索できるようにしたい」という方は、リベルクラフトへご相談ください。
自然言語処理とは。人が使う言葉をコンピュータが扱う技術
自然言語処理とは、人が日常的に使う言葉をコンピュータが扱えるようにする技術です。英語では Natural Language Processing、略してNLPと呼ばれます。
自然言語の定義。自然言語と人工言語は何が違うのか
自然言語とは、日本語や英語のように、人が自然に使ってきた言葉を指します。対して、プログラミング言語のように人が設計した言葉を人工言語と呼びます。
この2つの違いは、曖昧さを許すかどうかです。人工言語は、同じ書き方をすれば必ず同じ意味になるように設計されています。自然言語はそうではありません。同じ言葉が文脈で意味を変え、主語が省略され、指示語が前の文を指します。
この曖昧さをどう扱うかが、自然言語処理という分野の中心にある課題です。
自然言語処理と機械学習・AIの関係
自然言語処理は、AIの応用分野のひとつです。そして現在の自然言語処理は、そのほとんどが機械学習の手法で実現されています。
かつてはルールと辞書で解いていましたが、いまはデータから学習させる方式が主流です。つまり、自然言語処理は「何を解くか」を指す言葉で、機械学習は「どう解くか」を指す言葉、と整理すると混乱しません。
自然言語処理と生成AI・LLMの関係
生成AIのうち、文章を扱うものがLLM(大規模言語モデル)です。そしてLLMは、自然言語処理の技術が積み上がった先に出てきました。
新しい別の分野ではなく、本記事でたどる流れの終着点にあたります。LLMそのものの仕組みはLLMとは何か。仕組みと種類、企業での活用方法をわかりやすく解説で、文章が生成される流れは生成AIの仕組みとは。データからテキストが生成されるまでをわかりやすく解説で扱っています。
自然言語処理が解こうとしてきた4つの課題。形態素解析から文脈解析まで
言葉を扱うとき、機械は段階を追って処理していました。この4段階は、いまのLLMの直接の仕組みではありませんが、何が難しいのかを理解する枠組みとしては有効です。
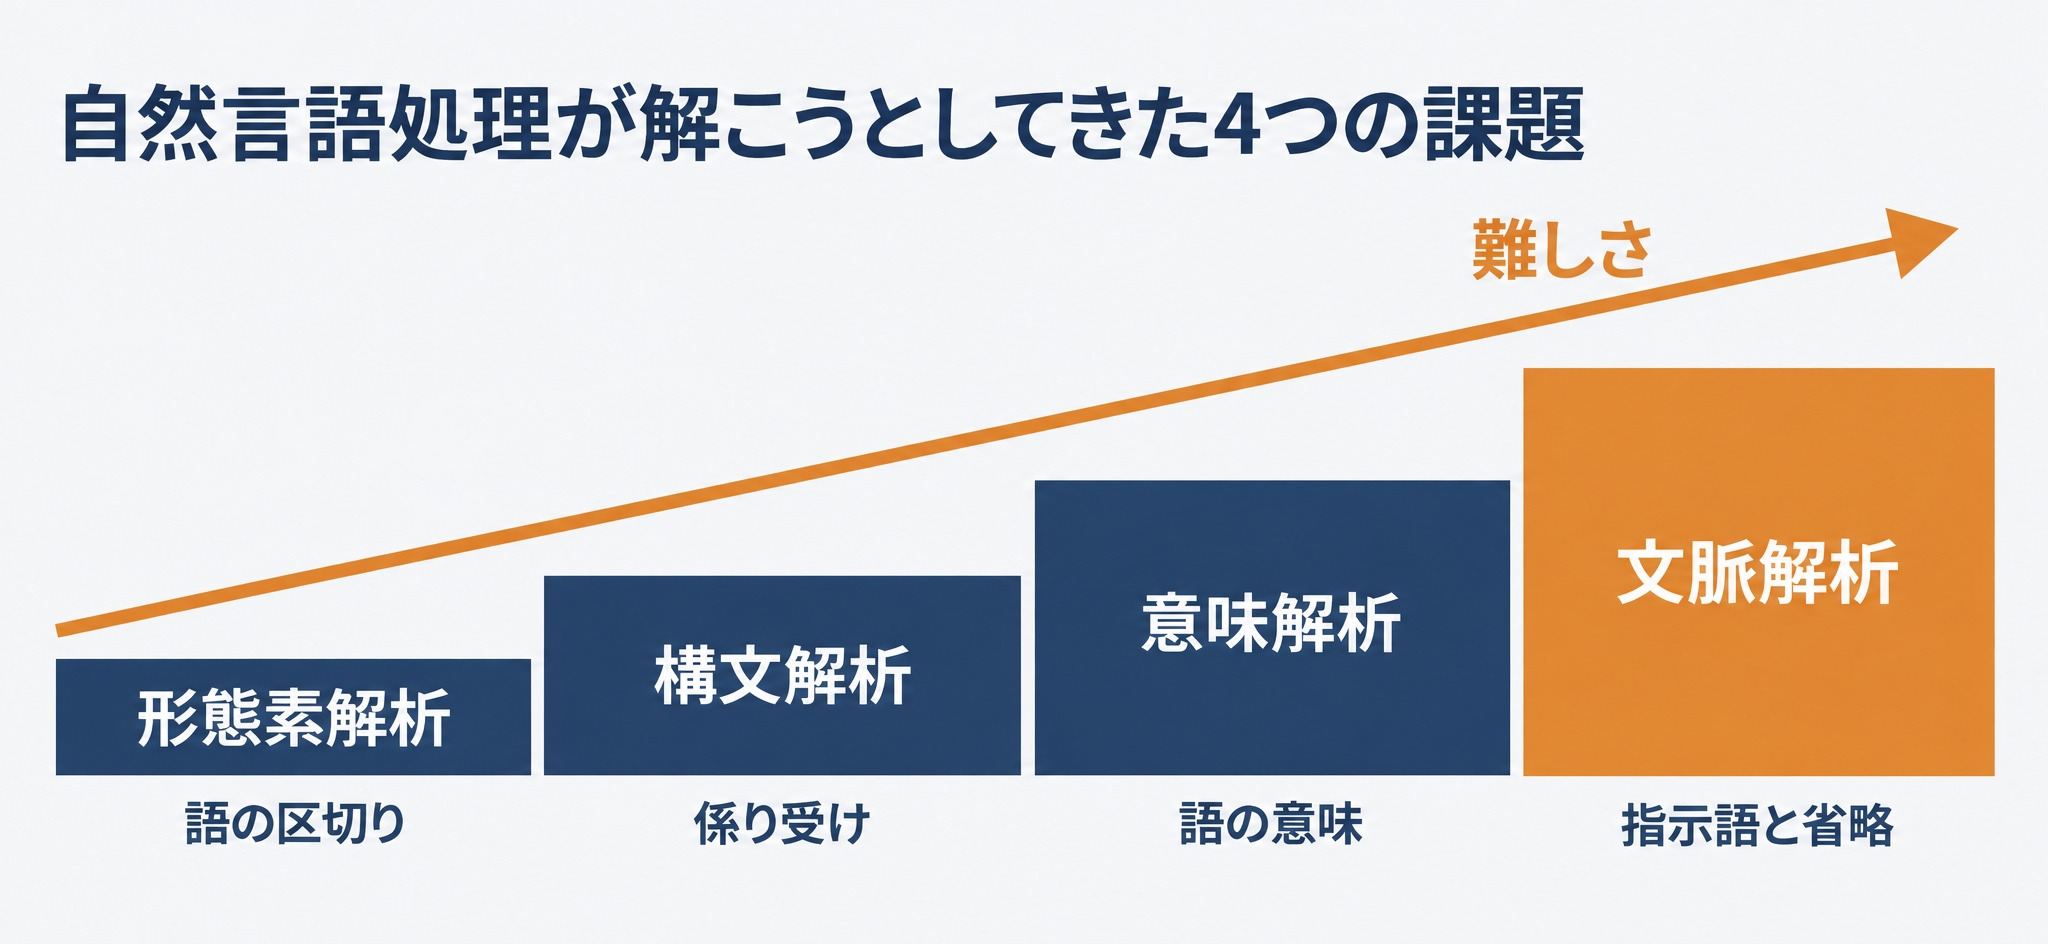
後ろの段階ほど、1つの文の中だけでは答えが決まらなくなります。語の区切りは辞書と前後の語でほぼ決まりますが、指示語が誰を指すかは前の文まで読まないと決まりません。
形態素解析。日本語には語の区切りが無い
英語は単語のあいだに空白があります。日本語にはありません。「すもももももももものうち」をどこで切るかを機械が決める必要があります。
形態素解析は、文を意味を持つ最小の単位に分け、それぞれの品詞を判定する処理です。日本語では MeCab などが広く使われてきました。
MeCabの公式ドキュメントによれば、MeCabは京都大学情報学研究科と日本電信電話株式会社コミュニケーション科学基礎研究所の共同研究ユニットプロジェクトで開発されました。切り方の候補を辞書から列挙し、どの切り方がもっともらしいかを、条件付き確率場(CRF)という統計モデルで学習したパラメータで判定します。つまり形態素解析の時点で、すでに人が書いたルールではなく、データから学んだ確率で判断しているということです。
切り方を間違えると、その後の処理がすべてずれます。日本語の自然言語処理が英語より一段難しいと言われるのは、ここが理由です。
構文解析。どの語がどの語にかかるのかを決める
次に、語と語の関係を決めます。「黒い目の大きな猫」は、黒いのが目なのか猫なのか、大きいのが目なのか猫なのかで、組み合わせが複数あります。
構文解析は、こうした係り受けの関係を決める処理です。文が長くなるほど候補が増え、正しい組み合わせを選ぶのが難しくなります。
意味解析。同じ表記でも意味が変わる
同じ語でも意味が違うことがあります。「はし」は橋なのか箸なのか端なのか。「かける」も、電話をかけるのか、椅子に腰かけるのか、保険をかけるのかで意味が変わってしまいます。
意味解析は、語の意味の候補の中から、文脈に合うものを選ぶ処理です。ここで必要になるのが、世の中の常識にあたる知識です。機械はこれを持っていないため、長く難所であり続けました。
文脈解析。文をまたいだ指示語と省略を補う
「田中さんが来た。彼は書類を持っていた。」の「彼」が誰を指すのかを決める必要があります。日本語ではさらに、主語がそもそも書かれないことが多くあります。
文脈解析は、文をまたいで指示語や省略を補う処理です。4つのなかで最も難しく、長いあいだ実用水準に届いていませんでした。
自然言語処理の手法の変化。ルールと統計から分散表現へ
ここからが本記事の軸です。技術がなぜ変わってきたのかを、順に見ていきます。
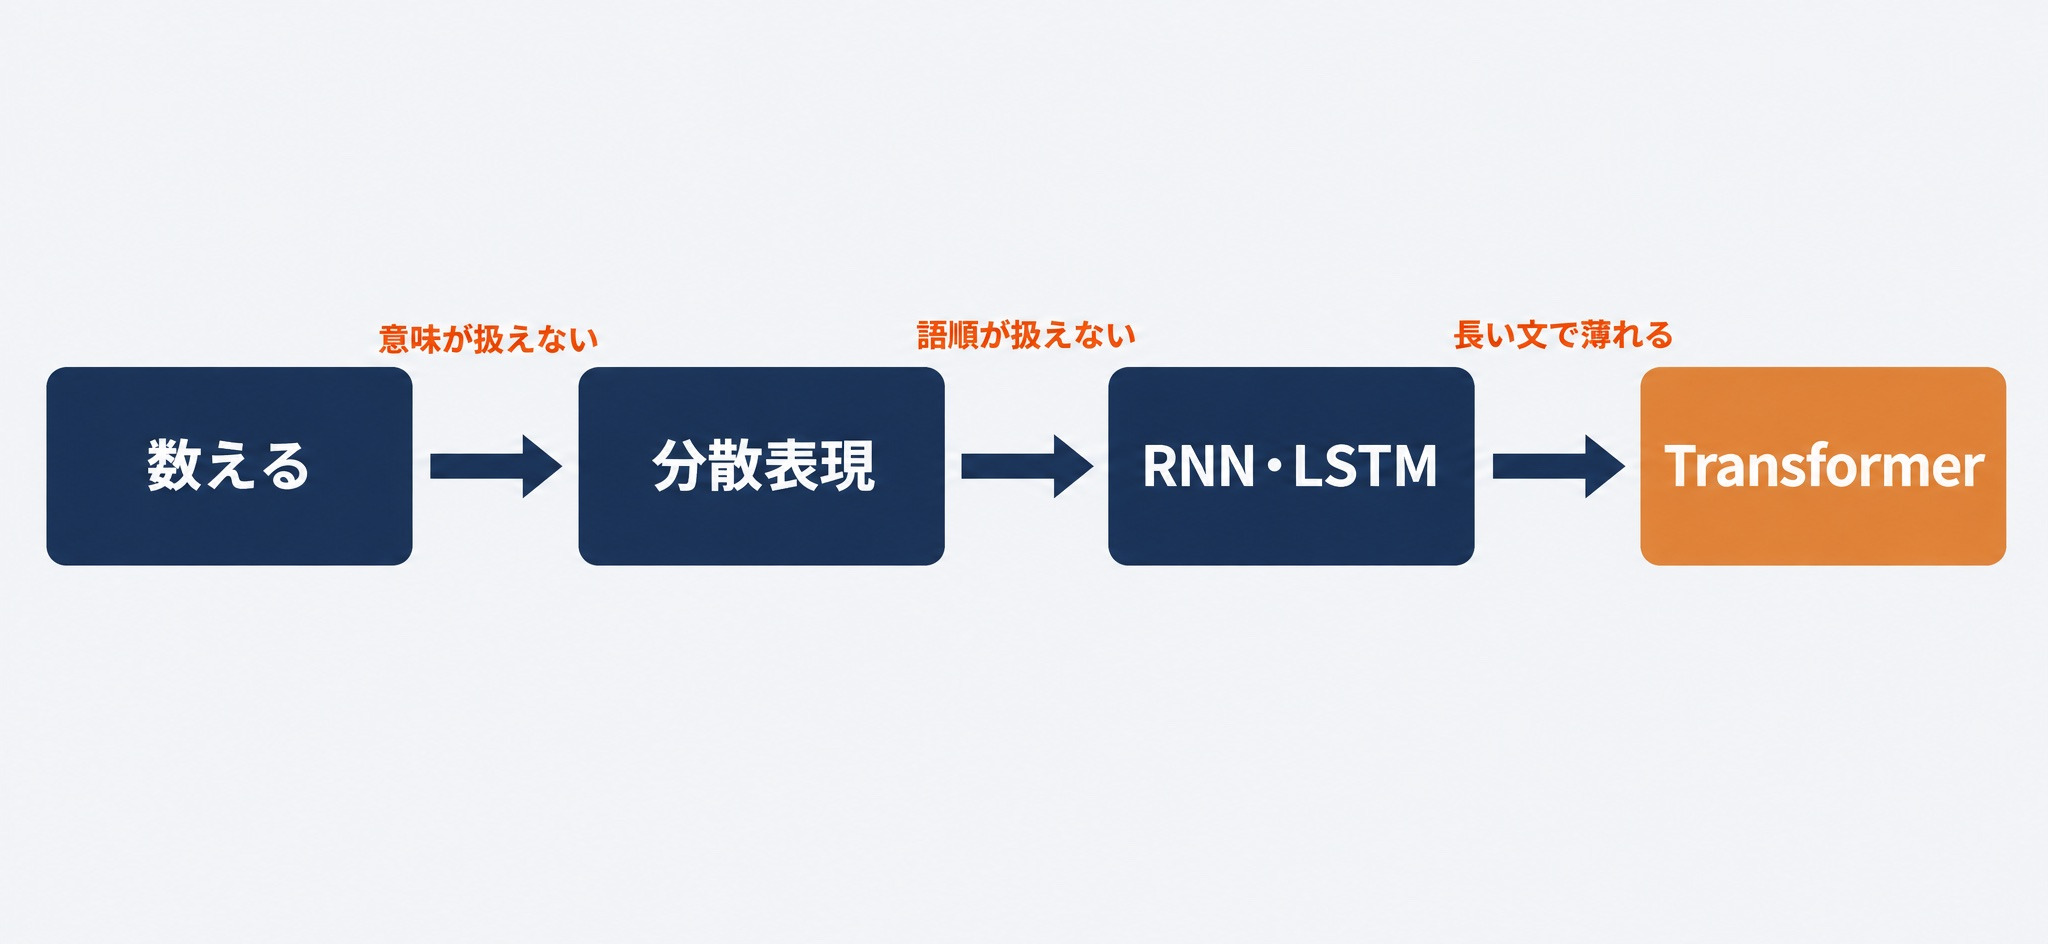
全体の流れは次のとおりです。矢印の上にあるのが、次の手法が必要になった理由です。
ルールと辞書で解く時代。コーパスが支えた統計的手法
初期は、人が文法のルールを書き、辞書を作って解いていました。しかし自然言語の例外はルールで書き切れません。
次に来たのが統計的手法です。大量の文章を集めたデータ(コーパス)から、語の出現頻度や共起を数えて確率的に判断します。ルールを人が書かなくてよくなった点で、大きな前進でした。
単語を数える方法の限界。意味の近さが扱えない
しかし、数える方法には決定的な弱点がありました。単語を記号として数えているだけなので、意味の近さが扱えません。
「犬」と「猫」は、どちらも動物で近い意味を持ちます。しかし出現頻度を数えるだけの方式では、「犬」と「猫」の距離も、「犬」と「会計」の距離も、同じく「別の記号」でしかありません。
学習データに「犬が走る」があっても、「猫が走る」を理解する助けになりませんでした。
分散表現。単語を意味のベクトルで表す
そこで出てきたのが分散表現です。単語を1つの記号ではなく、数百次元の数値の並び(ベクトル)で表します。
似た文脈に現れる単語は、似たベクトルになるように学習させます。すると「犬」と「猫」のベクトルが近くなり、意味の近さを計算で扱えるようになりました。word2vec がこの方式を広く知らしめた手法です。
2013年に Mikolov らが発表したword2vecの論文は、15億語のデータから高品質な単語ベクトルを1日以内で学習できたと報告しています。それまでのニューラルネットワークを使う方法より精度を上げながら、計算コストを大きく下げた点が普及の決め手になりました。大量の文章さえあれば、人が辞書を作らなくても語どうしの近さを数値で得られるようになったわけです。
ここが、記号として数える時代からの決定的な転換点でした。
RNN・LSTM。語順を扱えるようになったが、長い文が苦手だった
単語をベクトルで表せても、文としての順番を扱う必要があります。RNNは、前の語の処理結果を次の語の処理に回すことで、順番を扱えるようにしました。LSTMはその改良型です。
ただし、この方式には2つの弱点が残りました。ひとつは、語が離れるほど情報が薄れることです。もうひとつは、前から順に処理する以上、計算を並列化できないことです。長い文ほど時間がかかり、しかも精度が落ちました。
Transformer以降の自然言語処理。LLMで何が変わったか
この2つの弱点を同時に外したのがTransformerです。
Transformerと注意機構。文全体を一度に見る
Transformerは、前から順に処理するのをやめました。代わりに、文中のどの語とどの語が関係しているかを一度に見る仕組み(注意機構)を導入しました。
これによって、離れた語の関係も1ステップで捉えられるようになり、同時に計算を並列化できるようになりました。扱える文の長さと、学習の速さが同時に変わったことになります。2017年のTransformerの論文は、英語からドイツ語への翻訳の評価で28.4 BLEUという当時の最高値を、従来より短い学習時間で記録しています。
事前学習と微調整。タスクごとにモデルを作らなくてよくなった
もうひとつ大きかったのが、学習のやり方の変化です。
それまでは、翻訳なら翻訳用、分類なら分類用と、タスクごとにモデルを一から作っていました。Transformer以降は、大量のテキストでまず言葉の扱い方そのものを学ばせ(事前学習)、そのあと少量のデータで用途に合わせる(微調整)という二段構えが主流になりました。
この転換を示したのが、2018年にGoogleの研究者が発表したBERTの論文です。ラベルの無い文章で事前学習したモデルに出力層を1つ足して微調整するだけで、11種類の自然言語処理タスクで当時の最高性能を出しました。言語理解の総合評価であるGLUEのスコアは80.5%で、それまでの最高値を7.7ポイント上回っています。
用途ごとに大量の正解データを用意する必要がなくなり、自然言語処理の導入コストが大きく下がりました。この調整の方法はファインチューニングとは。仕組み・種類・RAGとの違いをわかりやすく解説で扱っています。
LLMで、4つの処理工程を分けずに扱えるようになった
ここが本記事でいちばん伝えたい点です。
いまのLLMは、形態素解析・構文解析・意味解析・文脈解析を、工程として分けて実行していません。大量のテキストから言葉の扱い方をまとめて学習した結果、これらを区別せずに処理しています。
先の4工程は、いまでも「何が難しいのか」を理解する枠組みとしては有効です。ただし、現在のモデルの中身の説明としては正しくありません。この区別を持っておくと、古い解説を読んだときに混乱せずに済みます。
それでも残る自然言語処理の課題
LLMで解けるようになったことは多いのですが、すべてが解決したわけではありません。
もっともらしい誤りを出すこと、学習データに無い社内の固有名詞や規程を知らないこと、なぜその答えになったかを説明しにくいことは、いまも残っています。
日本語の性能も、以前ほど大きな壁ではなくなってきました。国立情報学研究所は2026年4月、約12兆トークンのコーパスで学習した国産LLM「LLM-jp-4」をオープンソースのライセンスで公開しました。日本語での対話性能を測るベンチマーク(日本語MT-Bench)では、8Bモデルが7.54、32B-A3Bモデルが7.82を記録し、比較対象としたGPT-4oの7.29を上回ったと報告されています。自社の環境で動かせる日本語モデルの選択肢が増えていることは、社内文書を外に出せない企業にとって意味があります。
社内の情報を扱えないという点は、次の章で扱う仕組みで補います。
ここまで自然言語処理の流れを解説しましたが、「仕組みは分かったが、自分で手を動かして作れるようになるには何をすればよいのか」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeでは、Pythonでのデータ処理から、社内文書に答えるAIの構築までを段階的に学べます。教材を進めるだけでなく、課題の添削と週1回の面談で詰まった箇所を確認できるため、自分の手で作れる状態まで持っていけます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
自然言語処理でできること。業務での4つの使い方
技術の流れが分かったところで、業務でどう使われているかを見ていきます。
総務省の令和7年版 情報通信白書によれば、何らかの業務で生成AIを使っていると回答した日本企業は55.2%でした。一方で、導入にあたっての懸念として最も多かったのは「効果的な活用方法がわからない」です。技術は使える段階にありますが、どの業務に当てるかが決まっていない企業が多いことが分かります。以下の4つは、自然言語処理の技術と業務の対応が比較的はっきりしている使い方です。
検索。キーワードの一致から、意味の近さで探す形へ
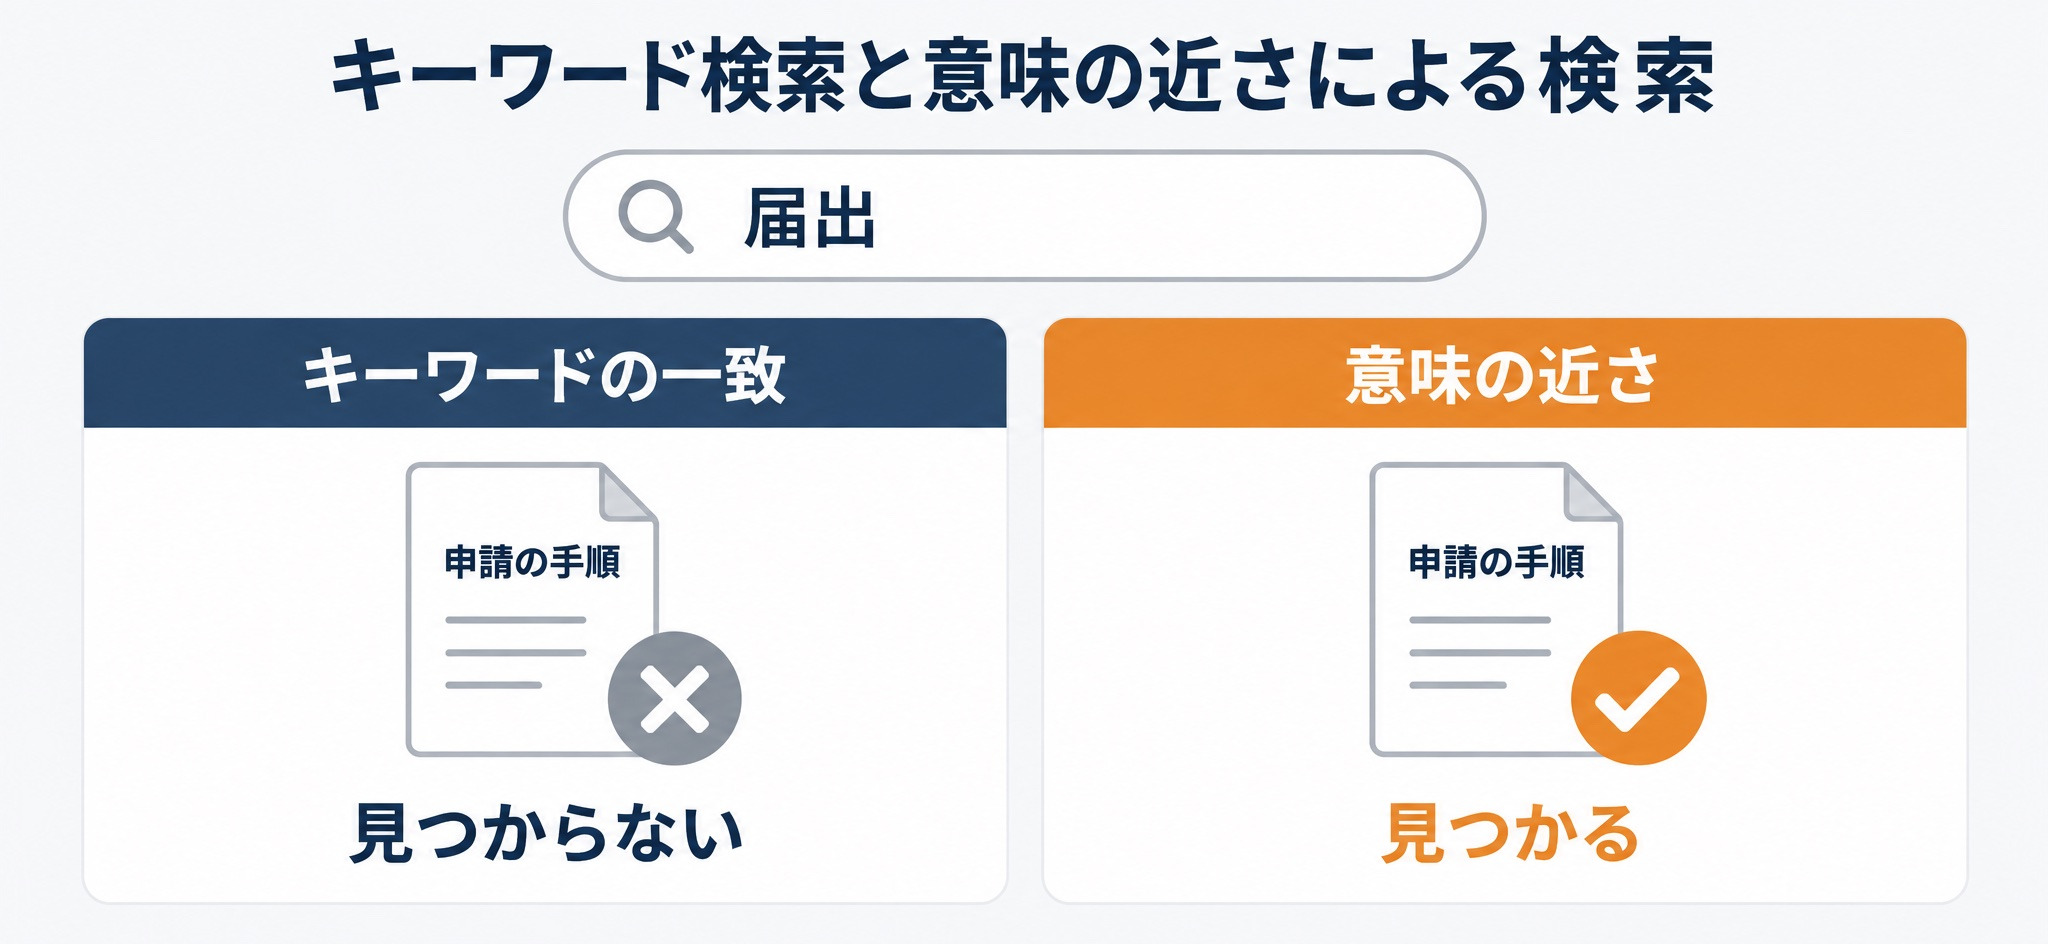
従来の検索は、キーワードが一致するかどうかで探していました。この方式だと、社内文書で「申請」と書かれているものを「届出」で探しても見つかりません。
分散表現を使うと、意味の近さで探せます。言葉が違っても、意味が近ければ見つかります。社内文書の検索で効き目が大きいのがこの点です。
たとえば「届出」で検索したとき、キーワードの一致では「申請の手順」という文書は候補に上がりません。文書も質問もベクトルに変換して近さで比べる方式なら、「届出」と「申請」が近い意味として扱われ、この文書が見つかります。
ただし、意味の近さによる検索は、型番や社員番号のような「一字違えば別物」の検索が苦手です。実務では、キーワードの一致と意味の近さの両方で探し、結果を合わせる構成がよく使われます。
要約。長い文書から必要なところだけ取り出す
長い議事録や報告書から要点を取り出します。LLM以降、実用水準に達した用途のひとつです。
注意点として、元の文書に無いことを書いてしまうことがあります。要約結果をそのまま使わず、元の文書のどこから取ったかをたどれる形にしておくのが安全です。
分類・抽出。問い合わせの振り分けと項目の切り出し
問い合わせを内容ごとに振り分ける、契約書から金額や期日を切り出す、といった用途です。
この2つは、実はLLMを使わなくても解ける場合があります。分類の種類が決まっていて、正解データが集まるなら、軽いモデルのほうが速く安く済みます。何でもLLMにする必要はありません。
判断の目安は3つあります。1日に処理する件数が多く、1件あたりの費用や応答時間が効いてくるか。分類の種類が頻繁に変わるか。過去に人が振り分けた記録が数百件以上残っているか。件数が多く、種類が安定していて、記録が残っているなら軽いモデルが向いています。種類がよく変わる、あるいは記録が無いなら、指示を書き換えるだけで対応できるLLMのほうが立ち上げは早くなります。
対話。チャットボットで社内外の質問に答える
問い合わせ対応をチャットボットに任せる用途です。ここで社内の情報を扱うには、次章の仕組みが要ります。
自然言語処理で社内文書を検索可能にする進め方
リベルクラフトが受託でよく扱う領域です。作る側が踏む手順として整理します。
社内文書を検索可能にする仕組み。文書を探してから答えさせる
LLMは社内の文書を知りません。そこで、質問が来たらまず社内文書から関連する部分を探し、それを渡したうえで答えさせるという仕組みを作ります。RAGと呼ばれる方式です。
このとき見落とされやすいのが、文書の閲覧権限です。人事や経営の資料を検索対象に入れると、本来は見られない社員にも、LLMの回答を通じて内容が伝わってしまいます。検索の段階で、質問した人が閲覧できる文書だけを候補にする設計が欠かせません。
この方式の詳細は社内データをRAGで活用する方法とAgentic RAGとは。通常のRAGとの違いと仕組みを解説で扱っています。
進め方の5つのステップ
- 答えさせたい質問を先に決める。どの質問にどう答えられれば成功かを、作り始める前に固定します。たとえば問い合わせ窓口の担当者が、過去によく受けた質問を20〜30問選び、それぞれの正しい答えと根拠の文書を書き出しておきます
- 対象の文書を絞る。全部を入れず、その質問に答えるために要る文書だけにします
- 文書を分けて、検索できる形にする。目次や章節の構造を壊さない単位で分けます
- 検索の精度を確かめる。答えの前に、正しい文書を引けているかを先に見ます
- 答えの正しさを確かめる。1で決めた質問に対して、期待した答えが返るかを測ります
4番目を飛ばす例が多くあります。答えが間違っているとき、モデルが悪いのか、そもそも正しい文書を引けていないのかを切り分けられなくなります。評価の方法はRAGの評価とRAGASの使い方で扱っています。
精度が出ないときに見る3つの箇所
- 文書の分け方。細かく切りすぎて文脈が切れているか、大きすぎて関係ない部分が混ざっているか
- 文書の版。古い手順書と新しい手順書が両方入っていて、古いほうを引いている
- 言葉のずれ。質問で使う言葉と、文書で使われている言葉が違う
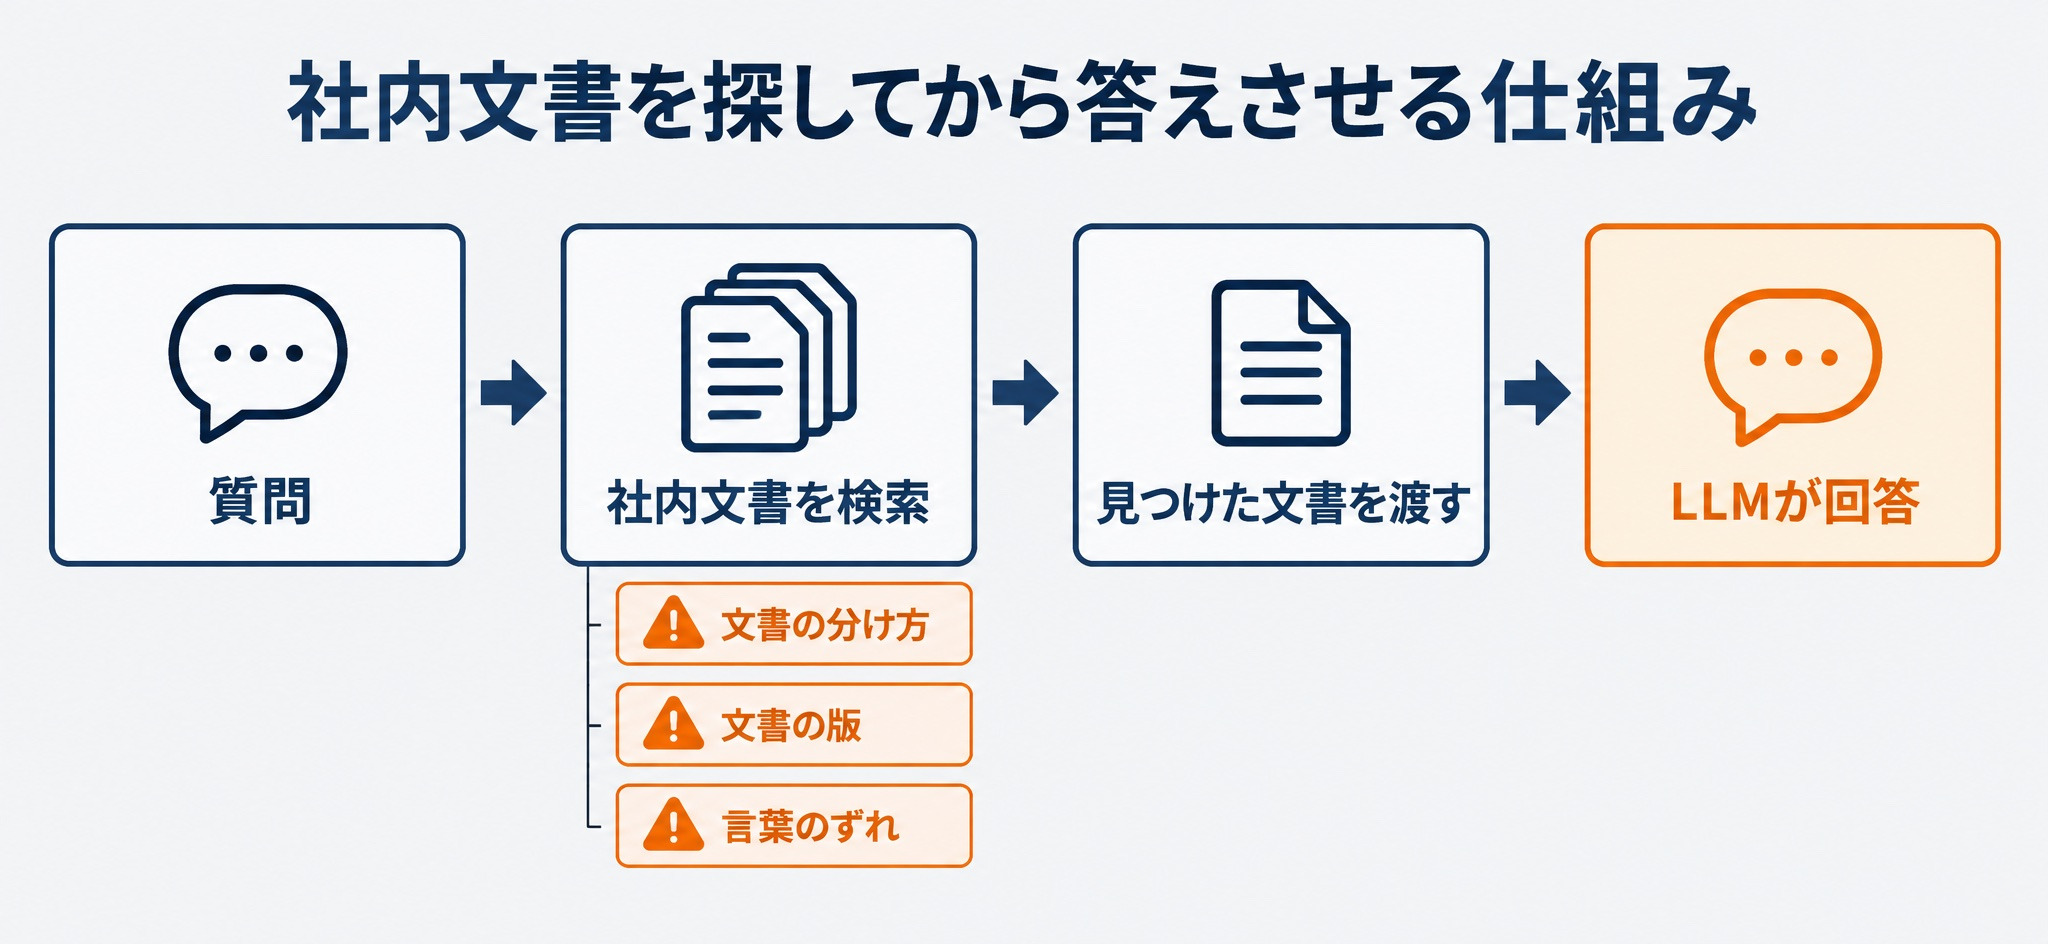
3つとも、LLMに文書を渡す前の検索の段階で起きる問題です。文書の版は、古い手順書を検索対象から外すか、更新日を持たせて新しいものを優先させることで解消できます。言葉のずれは、社内の略語や言い換えの対応表を用意して、質問を検索する前に補うと改善します。
モデルを大きくする前に、この3つを見てください。この3箇所で解決することがほとんどです。自社環境にモデルを置く場合の構成はローカルLLMで扱っています。
自然言語処理の学び方。何からどの順番で学ぶか
未経験から自然言語処理を学ぶ5つのステップ
- Pythonの基本文法。文字列の扱いまで
- テキストデータの前処理。読み込み、表記ゆれの統一、形態素解析でテキストを単語に分ける
- 分散表現を実際に作って、単語の近さを見る。「犬」に近い単語が何になるかを自分で確かめます
- 公開されているモデルで分類を1つ解く。自分でモデルを作らず、既存のモデルを使います
- 自分の関心があるテキストで、課題設定からやり直す。社内文書でも、趣味のデータでもかまいません
3番目を実際に手で動かすと、それまで抽象的だった「意味をベクトルで表す」が腑に落ちます。ここは飛ばさないほうがよいところです。
データサイエンス全体の中での位置づけはデータサイエンスとは。定義・活用事例・学び方をわかりやすく解説で扱っています。
まとめ
- 自然言語処理とは、人が日常的に使う言葉をコンピュータが扱えるようにする技術。曖昧さをどう扱うかが中心の課題
- 解いてきたのは形態素解析・構文解析・意味解析・文脈解析の4課題。日本語は語の区切りが無いぶん一段難しい
- 単語を数える方法では意味の近さが扱えなかったため、分散表現が出てきた
- 語順を扱うRNNは、離れた語で情報が薄れ、並列化もできなかった。この2つを同時に外したのがTransformer
- いまのLLMは4つの工程を分けて実行していない。4工程は難しさを理解する枠組みであって、現在のモデルの説明ではない
- 業務では検索・要約・分類抽出・対話の4つ。分類は軽いモデルで足りる場合がある
- 社内文書を検索可能にするときは、答えの前に「正しい文書を引けているか」を先に確かめる
自然言語処理を学ぶなら「Craft College」へ
「自然言語処理の流れは分かったが、自分で作れるようになるには何から始めればいいのか」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- 用語の解説を読む段階から、自分で作れる段階へ進めたい方
- 社内文書に答える仕組みを、自分で設計できるようになりたい方
- 独学で何から手をつければいいか分からず、止まってしまっている方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。