Qwenとは。Alibabaのオープンモデルを系列・ライセンス・日本語の実力で整理する
オープンモデルを業務や検証に使おうとして、Qwenを候補に挙げた方も多いでしょう。ところが調べ始めると、Qwen3.5・Qwen3.6・Qwen3.8と世代が続き、サイズも0.8Bから2.4Tまで並んでいます。ライセンスはモデルによって違い、日本語でどこまで使えるのかも一目では分かりません。社内からは「中国企業のモデルを入れて大丈夫か」と聞かれます。
そこで本記事では、次の5つを順に整理します。
- Qwenとは何か、どこから使えるのか
- 2026年9月時点の系列とサイズ
- モデルごとに違うライセンスの確かめ方
- ローカルで動かす方法と、日本語の実力の見方
- Kimi・GLM・DeepSeekとの違いと、業務で使う前の判断材料
本記事の事実は、2026年9月23日時点の公式のモデルカードとLICENSEファイルで確認したものです。ローカルで動かした出力は、Apple M1 Pro上で実際に実行して得たものだけを載せています。
Qwenを使ったローカルLLMの構築や評価を相談したい方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
Qwenとは。Alibabaが開発する大規模言語モデルのシリーズ
Qwenの開発元と位置づけ
Qwenとは、Alibaba GroupのQwenチームが開発している大規模言語モデル(LLM)と、画像や音声も扱うマルチモーダルモデルのシリーズです。中国語名は通義千問で、Alibaba Cloudのサービスとして提供されてきた経緯から「Alibaba Cloudのモデル」と紹介されることもあります。公式ドキュメントは、文章の理解と生成、画像や音声の理解、ツールの利用、AIエージェントとしての動作までを守備範囲に挙げています(Qwen公式ドキュメント)。
ライセンス文書の権利者欄を見ると、2026年9月公開のQwen-Image-2.1では Hangzhou Tongyi Laboratory Technology Co., Ltd. が契約の当事者になっています。モデルを業務で使うときに契約相手を確かめる場面があるため、覚えておくと役に立ちます。
Qwenを使う3つの入口(Qwen Chat・API・オープンウェイト)
Qwenには、使い方の違う3つの入口があります。
- Qwen Chat(Qwen Studio):ブラウザやアプリから使うチャットサービスです。「qwen ai」で検索する方の多くは、この入口を探しています
- API:Alibaba Cloud Model Studio や Qwen Cloud から、アプリケーションに組み込んで呼び出します
- オープンウェイト:Hugging FaceのQwenのページから重みを取得し、自社のPCやサーバーで動かします。2026年9月23日時点で468個のリポジトリが公開されています
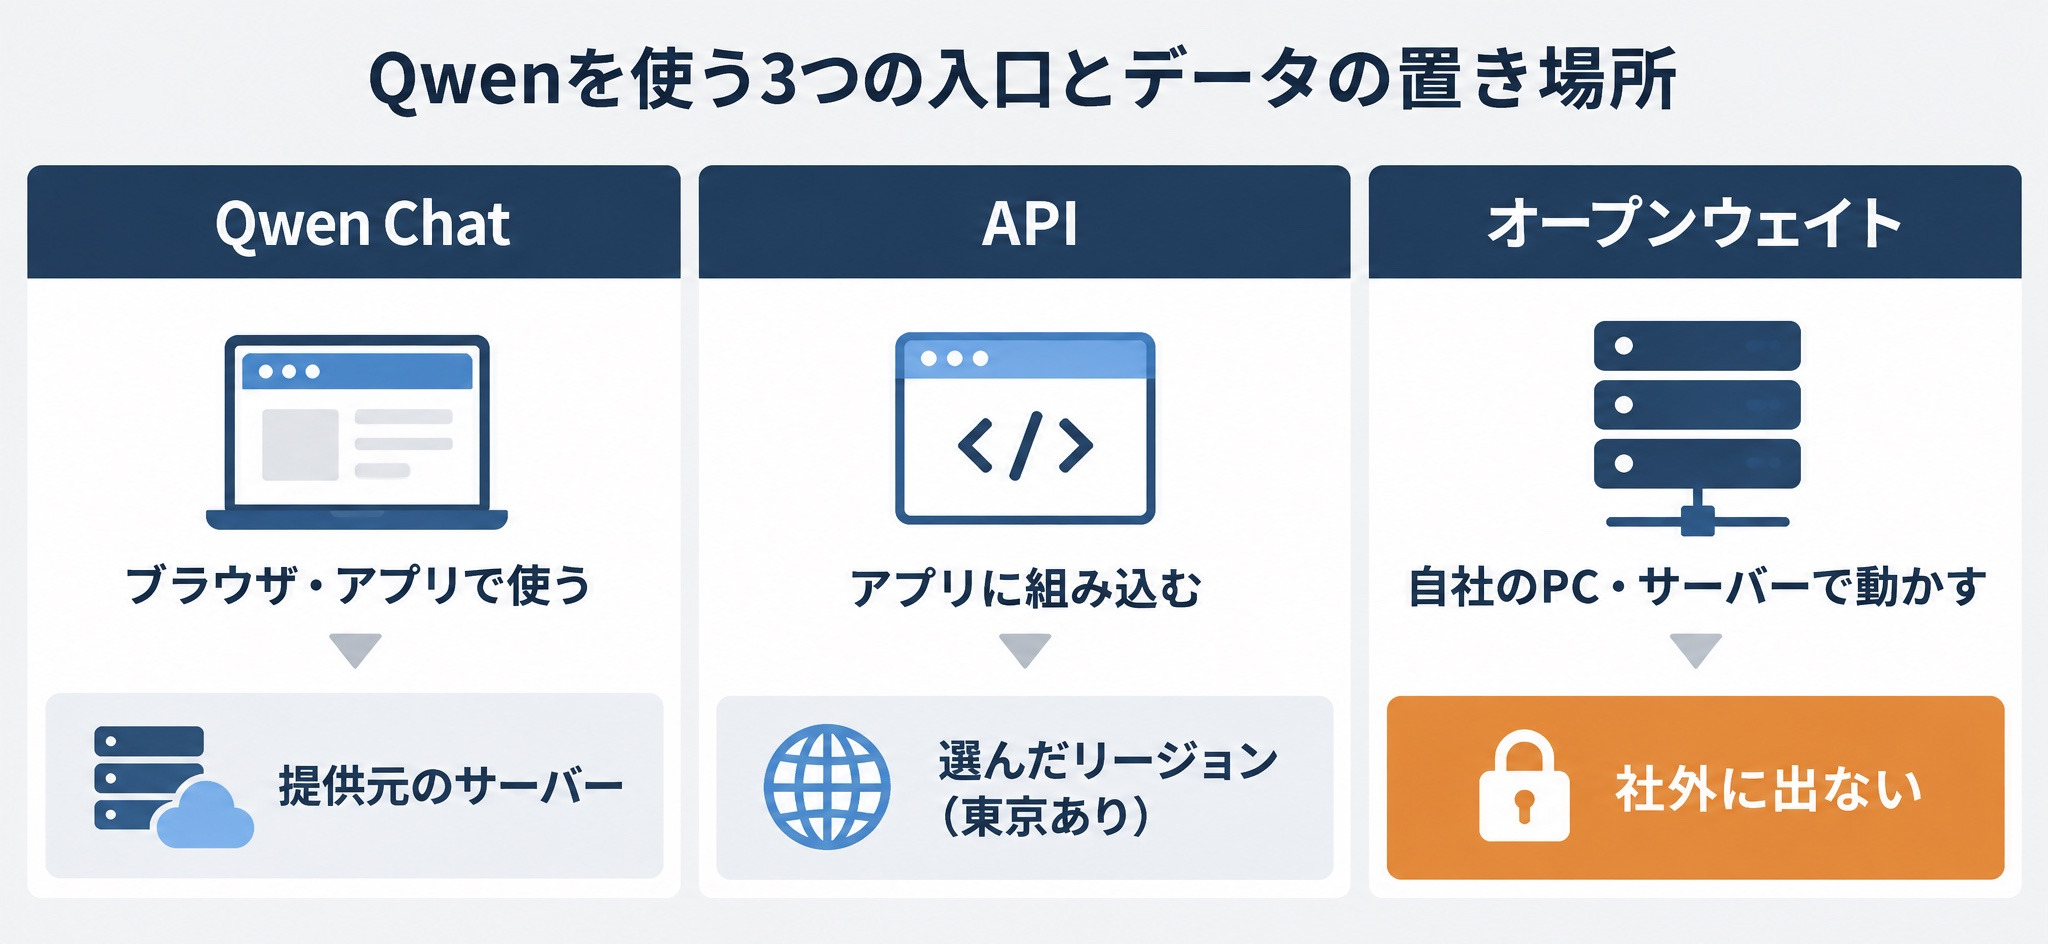
同じ「Qwen」でも、入口によってデータがどこで処理されるかが変わります。業務で使ってよいかを判断するときは、まずどの入口を使うかを決めることになります。
Qwen3からQwen3.8までの世代の流れ
オープンウェイトとしてのQwenは、2023年8月の Qwen-7B から始まりました。2024年にQwen1.5・Qwen2・Qwen2.5と続き、2025年4月のQwen3で、1つのモデルの中で思考モードと非思考モードを切り替えられるようになりました。思考モードとは、回答の前に推論の過程を出力させて、数学やコードのような複雑な問題に強くする動かし方です。
2026年に入ってからは、2月にQwen3.5、4月にQwen3.6、8月にQwen3.8が出ています。Qwen3.8の比較表にはAPIで提供されるQwen3.7-PlusとQwen3.7-Maxが登場しますが、Hugging Faceには Qwen3.7 のオープンウェイトは見当たりません。さらに Qwen3.8-Flash-Next のモデルカードは、このモデルを「Qwen4の土台になる構造の試験公開」と説明しています(Qwen3.8-Flash-Next)。
Qwenの系列とサイズ。2026年9月時点のオープンウェイト
ここまでで、Qwenの入口と世代を見ました。次に、オープンウェイトとして手に入るモデルの中身を整理します。
テキストと画像を扱う主力の系列
Qwen3.5以降の主力モデルの多くは、画像も入力できる構成です(2.4T-A95Bのオープンウェイトはテキストのみ)。各モデルカードの記載を並べると、次のとおりです。
| 系列 | 主なモデル | 構成 | ネイティブのコンテキスト長 | ライセンス |
|---|---|---|---|---|
| Qwen3.5 | 0.8B・2B・4B・9B・27B | Dense | 262,144 | Apache 2.0 |
| Qwen3.5 | 35B-A3B・122B-A10B・397B-A17B | MoE | 262,144 | Apache 2.0 |
| Qwen3.6 | 27B・35B-A3B | Dense・MoE | 262,144 | Apache 2.0 |
| Qwen3.8 | 27B | Dense | 262,144 | Apache 2.0 |
| Qwen3.8 | Flash-Next | MoE(総125B、稼働6B、別にn-gram埋め込み51B) | 262,144 | Qwen Community License 1.0 |
| Qwen3.8 | 2.4T-A95B | MoE(総2.4T、稼働95B) | 262,144 | Qwen3.8-Max License |
この表から読み取れるのは、同じQwen3.8の中でも、ライセンスが3種類に分かれている点です。27Bは Apache 2.0 ですが、上位の2モデルは独自のライセンスです。コンテキスト長は0.8Bを除き、設定を変えると約100万トークンまで延ばせるとモデルカードに書かれています(Qwen3.8-27B)。
Qwenのモデル名の読み方(27B・35B-A3B・FP8)
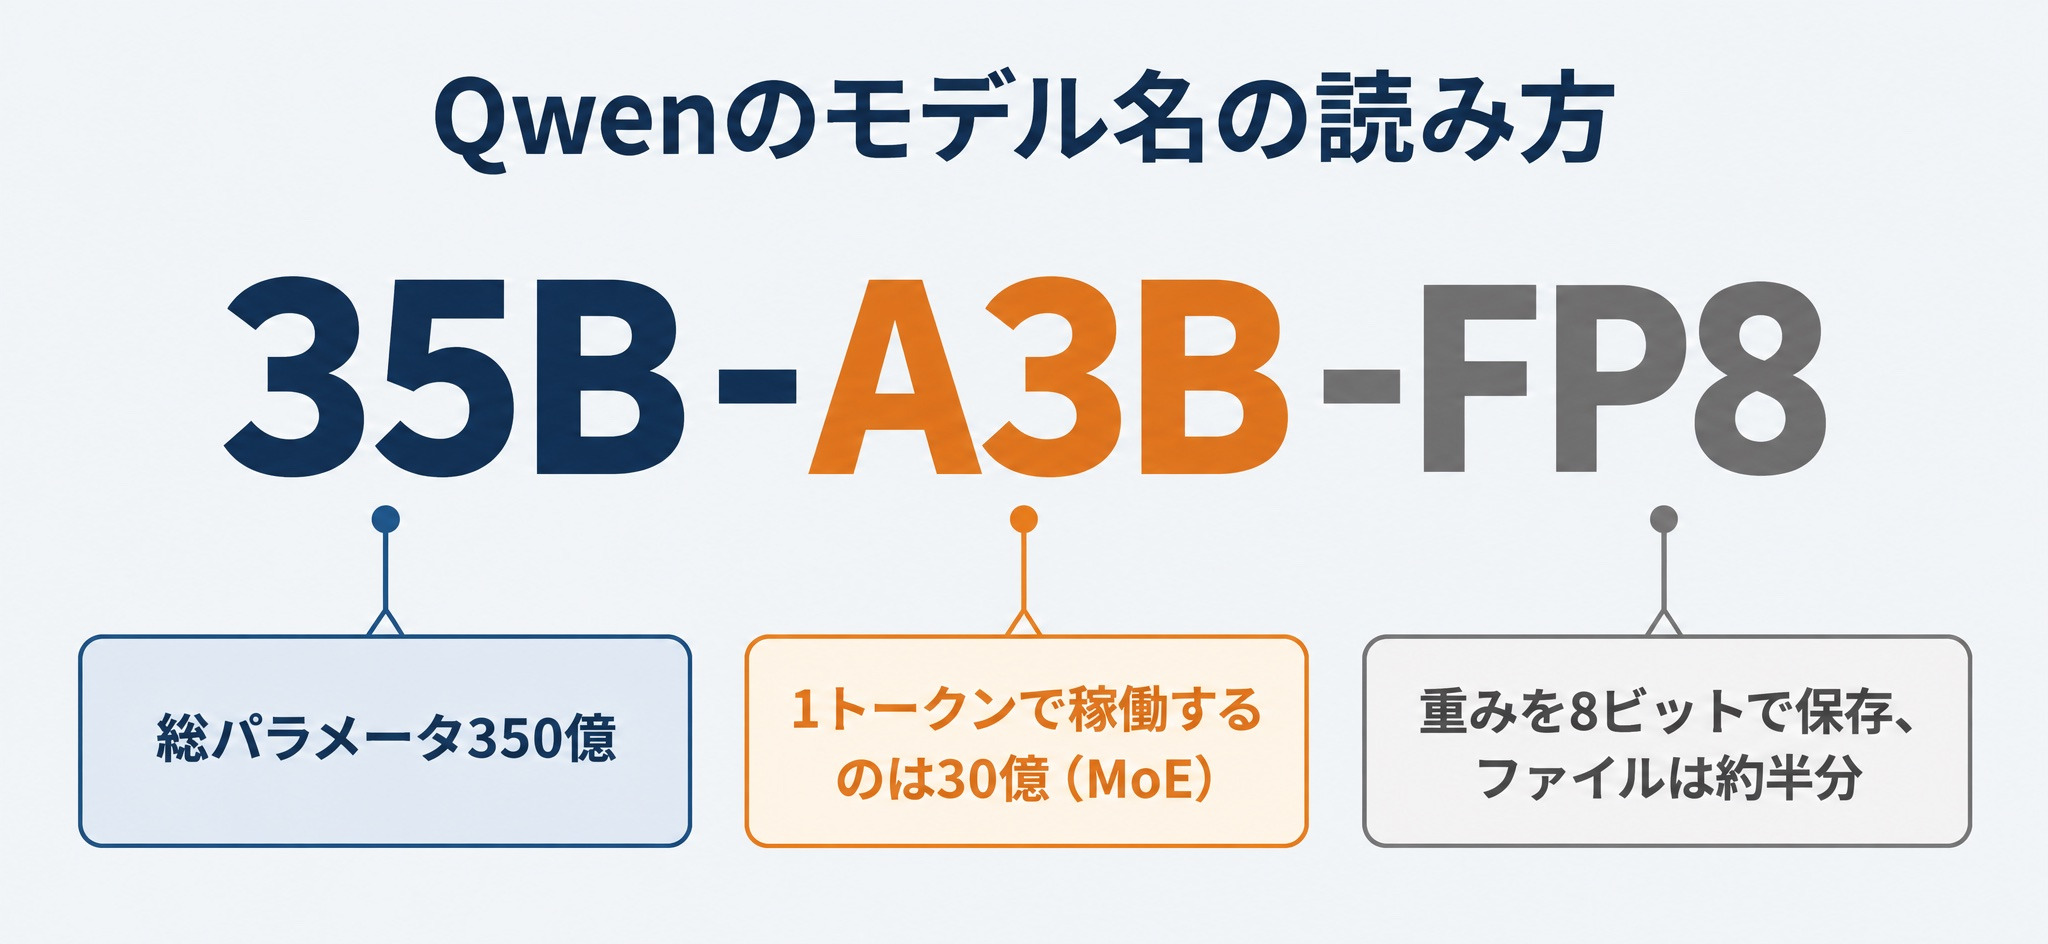
モデル名の数字は、パラメータ数を表しています。27Bは270億個のパラメータを持つDenseモデルで、Denseとは推論のたびにすべてのパラメータを使う構成です。
35B-A3Bのように「A」が付くものはMoE(Mixture of Experts)モデルで、総パラメータは350億でも、1トークンを処理するときに稼働するのは30億だけという意味です。計算量は稼働分で決まるため速く動きますが、重みはすべてメモリに載せる必要があります。末尾のFP8は、重みを8ビットの浮動小数点で保存した版で、ファイルが元の約半分になります。
用途別に分かれたQwenの派生モデル
主力の系列とは別に、用途を絞った派生モデルも公開されています。例えば、コード生成向けのQwen3-Coder-Next、検索の前処理に使うQwen3-VL-EmbeddingとQwen3-VL-Reranker、音声認識のQwen3-ASR、音声合成のQwen3-TTS、画像生成のQwen-Imageがあります。RAGを組むときの埋め込みモデルまでQwenの中で揃えられるのは、この系列の広さによるものです。
Qwenのライセンスはモデルごとに違う
系列を見たところで、使う前にライセンスを確かめます。「QwenはApache 2.0なので商用利用が自由」とまとめられることが多いのですが、実際にはモデルごとに違います。
Qwenの公開モデルにある4種類のライセンス
2026年9月23日時点で、Hugging Face上のQwenの公開モデルには、次の4種類のライセンスが混在していました。
| ライセンス | 対象の例 | 商用利用 | 主な条件 |
|---|---|---|---|
| Apache 2.0 | Qwen3.5全サイズ・Qwen3.6・Qwen3.8-27B | 可 | 著作権表示とライセンス文を残す |
| Qwen3.8-Max License | Qwen3.8-2.4T-A95B | 条件付きで可 | 大規模サービスではモデル名を表示する。API提供などで売上が一定額を超えたら別ライセンス |
| Qwen Community License 1.0 | Qwen3.8-Flash-Next | 条件付きで可 | API提供などの事業で商用利用するなら、売上に関係なく別ライセンス |
| Qwen Research License | Qwen-Image-2.1 | 不可 | 研究と評価の目的に限る。商用は別契約 |
この表から分かるのは、「Qwen」という名前だけでは商用利用の可否が決まらないことです。過去の世代も同様で、Qwen2.5では7Bが Apache 2.0、3Bが qwen-research、72Bが qwen というライセンス表記でした(Qwen2.5-3B-Instruct、Qwen2.5-72B-Instruct)。Apache 2.0やMITといったライセンスの一般的な読み方は、オープンソースLLMとは?商用利用の可否とライセンスの見方で整理しています。
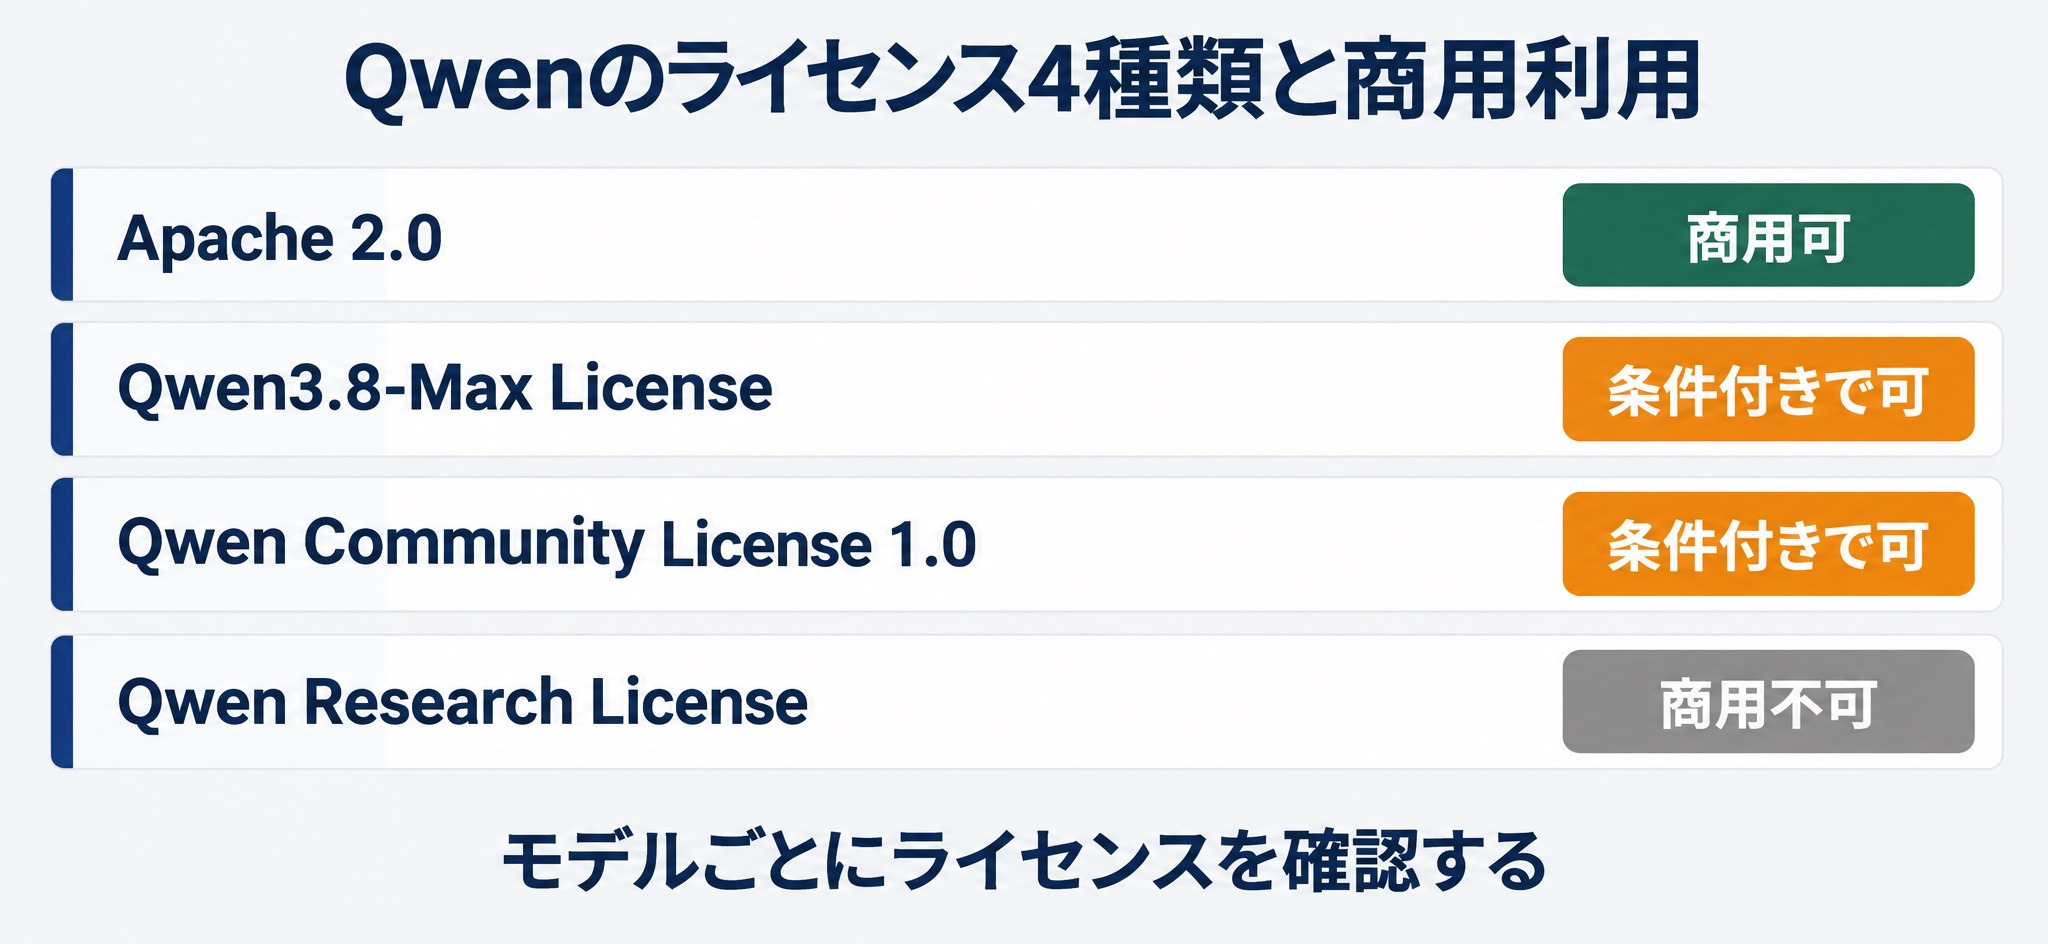
4種類のうち、条件を読み込む必要があるのは独自ライセンスの2つです。
Qwen3.8-Max LicenseとQwen Community Licenseの条件
この2つは、書き出しがMITライセンスに近く、使用・改変・再配布・販売・ファインチューニングを認めたうえで条件を足す形になっています。
Qwen3.8-Max License の条件は次の2つです。
- 月間アクティブユーザーが1億人を超えるか、月の売上が2,000万米ドルを超える商用サービスで使う場合は、画面にモデル名を目立つように表示する
- 第三者にAPIなどで推論やファインチューニングを提供する事業(Model as a Service)や、コーディングや事務作業向けのAIアシスタント事業を営み、連続12か月の売上が5,000万米ドルを超える場合は、商用利用の前に別ライセンスを取る
Qwen Community License 1.0 は、2つ目の条件から売上の閾値を外した形です。API提供やAIアシスタントの事業で商用利用するなら、規模に関係なく別ライセンスが必要です。どちらのライセンスも、成果物や出力を第三者に提供しない社内利用は、2つ目の条件の対象外と明記しています。
Qwenのライセンスを確かめる3つの手順
モデルを落とす前に、次の順で確かめます。
- モデルカード冒頭のlicense欄を見る:Hugging Faceのページ右側と、README冒頭の
license:に表記があります。otherと書かれていたら独自ライセンスです - LICENSEファイルを全文読む:独自ライセンスは、閾値と対象事業の定義が条件の中身です。自社の使い方が「社内利用」「第三者への提供」のどちらに当たるかを確かめます
- 量子化版や派生モデルでも元のライセンスを確かめる:GGUFなどの量子化版を配布している第三者のリポジトリにも、元のモデルのライセンスが引き継がれます。配布元の表記だけで判断しないようにします
Qwenをローカルで動かす方法
ライセンスを確かめたら、手元で動かします。ここでは必要な容量を見積もり、2つの動かし方を紹介します。
Qwenのサイズごとに必要な容量
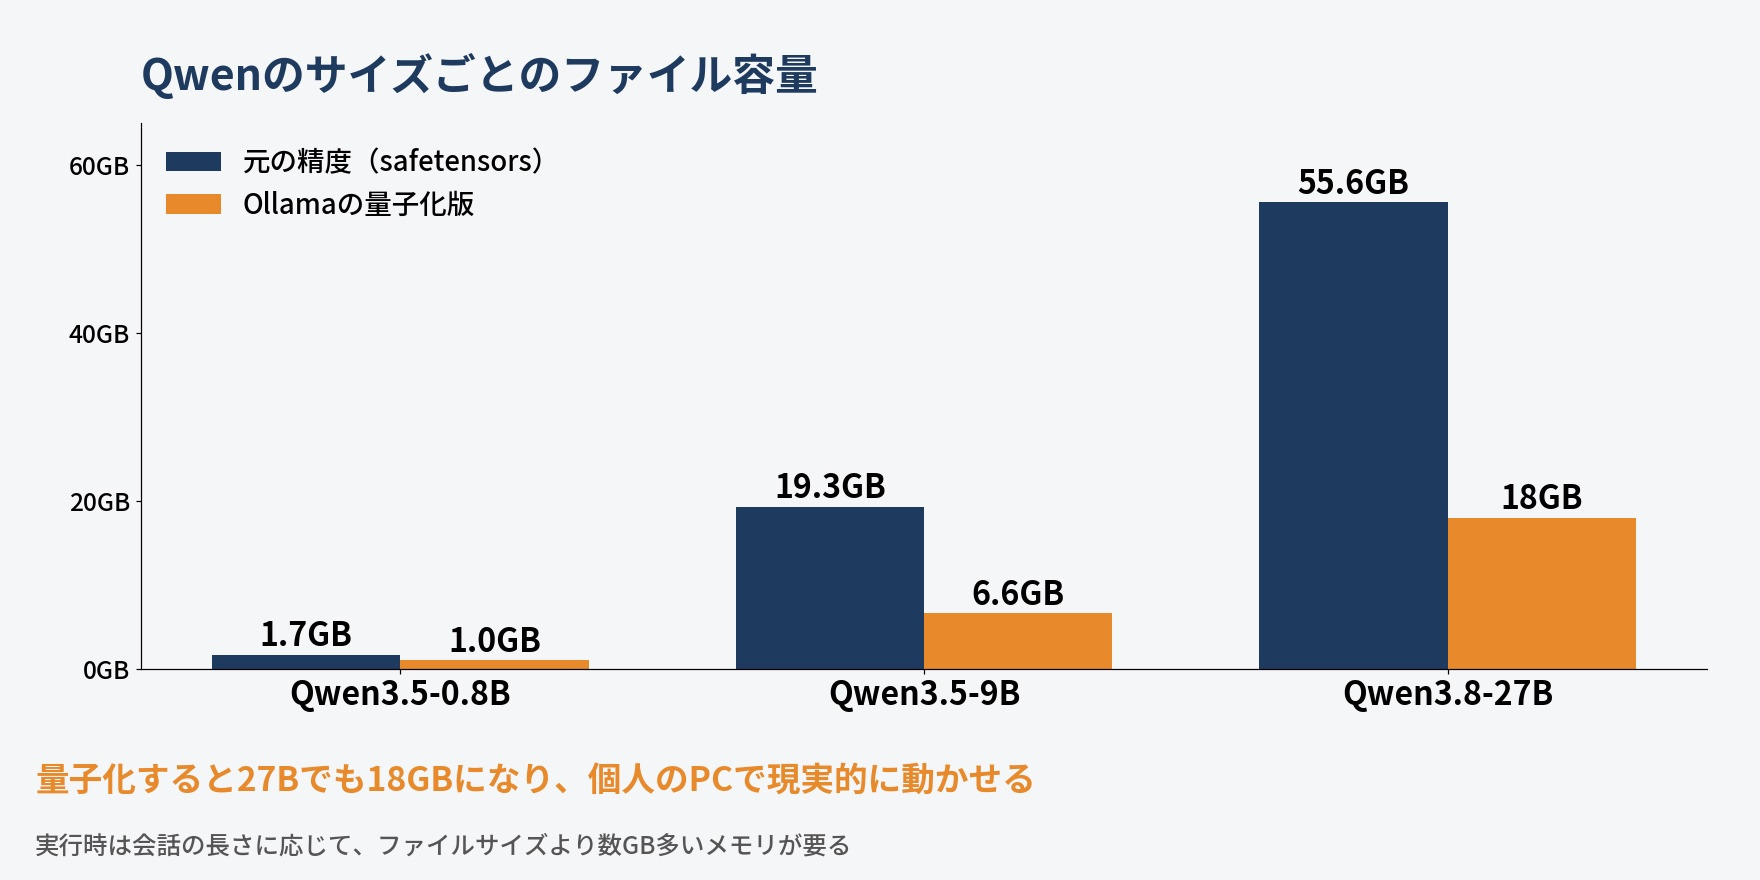
Hugging FaceのAPIで重みファイル(safetensors)の合計を取ると、元の精度での容量は次のとおりでした。
- Qwen3.5-0.8B:1.7GB
- Qwen3.5-9B:19.3GB
- Qwen3.8-27B:55.6GB(FP8版は30.9GB)
- Qwen3.6-35B-A3B:71.9GB(FP8版は37.5GB)
- Qwen3.8-2.4T-A95B:FP8版でも2,496.1GB
量子化すると、これがさらに小さくなります。Ollamaの公式ライブラリでは、qwen3.8:27b が18GB、qwen3.5:9b が6.6GB、qwen3.5:0.8b が1.0GBです(Ollama qwen3.8、Ollama qwen3.5)。実行時にはこれに会話の長さに応じたメモリが加わるため、ファイルサイズより数GB多いメモリを見込んでおきます。GPUやメモリの選び方はローカルLLMに必要なスペック早見で詳しく扱っています。
つまり、個人のPCで現実的なのは27Bまでで、2.4T-A95Bはデータセンター級のGPUを複数枚並べる前提のモデルです。
OllamaでQwenを動かす
最も手早いのはOllamaです。インストール後、タグ名を指定するだけでモデルの取得から対話まで進みます。下のコマンドは、Ollamaのライブラリにあるタグ名を示したもので、本記事の検証では実行していません。
# 9Bの量子化版(約6.6GB)を取得して対話を始める
ollama run qwen3.5:9b

# 27Bの量子化版(約18GB)。メモリに余裕がある場合
ollama run qwen3.8:27bOllamaの導入手順とAPIとしての使い方はOllamaの使い方にまとめています。複数人で同時に使うサーバー運用では、モデルカードが対応を明記している vLLM や SGLang を検討します。
PythonからQwen3-0.6Bを動かした結果
今回は、ダウンロード量を1GB未満に抑えるため、公式が配布している Qwen3-0.6B の8ビット量子化版(Qwen3-0.6B-Q8_0.gguf、約640MB)を使いました。最新世代のQwen3.5-0.8Bは元の精度で1.7GBあり、公式のGGUF版が見当たらなかったためです。
実行環境は Apple M1 Pro、macOS 14.6.1、Python 3.11.6、llama-cpp-python 0.3.35(Metal有効)で、実行日は2026年9月23日です。
import time, platform, llama_cpp
from llama_cpp import Llama

llm = Llama(model_path="models/Qwen3-0.6B-Q8_0.gguf", n_ctx=4096, n_gpu_layers=-1, seed=42, verbose=False)

prompts = [
    "次の文を、取引先に送る丁寧なメールの1文に書き直してください。「明日の打ち合わせ、30分遅らせてもらえますか」 /no_think",
    "日本で一番高い山の名前と、その標高を答えてください。 /no_think",
    "次の文章を30字以内で要約してください。「社内の問い合わせ対応では、同じ質問が何度も寄せられるため、担当者の負担が大きくなっている。そこでFAQを整備し、よくある質問への回答を自動化する仕組みを導入することにした。」 /no_think",
]
print("llama-cpp-python", llama_cpp.__version__, "|", platform.platform())
for p in prompts:
    t0 = time.perf_counter()
    out = llm.create_chat_completion(
        messages=[{"role": "user", "content": p}],
        temperature=0.7, top_p=0.8, top_k=20, min_p=0.0, presence_penalty=1.5, max_tokens=300, seed=42)
    dt = time.perf_counter() - t0
    u = out["usage"]
    print("=" * 40)
    print("Q:", p)
    print("A:", out["choices"][0]["message"]["content"])
    print(f"[生成トークン {u['completion_tokens']} / {dt:.2f}秒 = {u['completion_tokens']/dt:.1f} tok/s]")
末尾の /no_think は、Qwen3で思考モードを切るための指示です。サンプリングの値は、モデルカードが非思考モードに推奨している設定に合わせました(Qwen3-0.6B-GGUF)。出力のうち、回答本文と速度の行を抜き出すと次のとおりです。バージョン表示・区切り線・質問文の行と、各回答の先頭に出る空の思考タグ(<think> と </think>)は省いています。
明日の打ち合わせ、30分お待ちいただけますか?
[生成トークン 19 / 1.41秒 = 13.5 tok/s]

日本で一番高い山は **富士山**(**富士山**)で、標高は **8234米**。
[生成トークン 35 / 0.32秒 = 108.9 tok/s]

社内問い合わせ対応で負担増加を防ぐためにFAQ整備と自動化仕組みの導入。
[生成トークン 33 / 0.34秒 = 97.5 tok/s]
2問目と3問目は毎秒約100トークンで返ってきました。1問目だけ遅いのは、初回の呼び出しに準備の時間が含まれるためと考えられます。速さは十分ですが、中身には問題があります。次の章で、この出力をどう評価するかを見ていきます。
Qwenの日本語の実力をどう見るか
前の章で動かした出力を手がかりに、Qwenの日本語の実力を見極める方法を整理します。
公式ベンチマークの多言語スコアは平均値
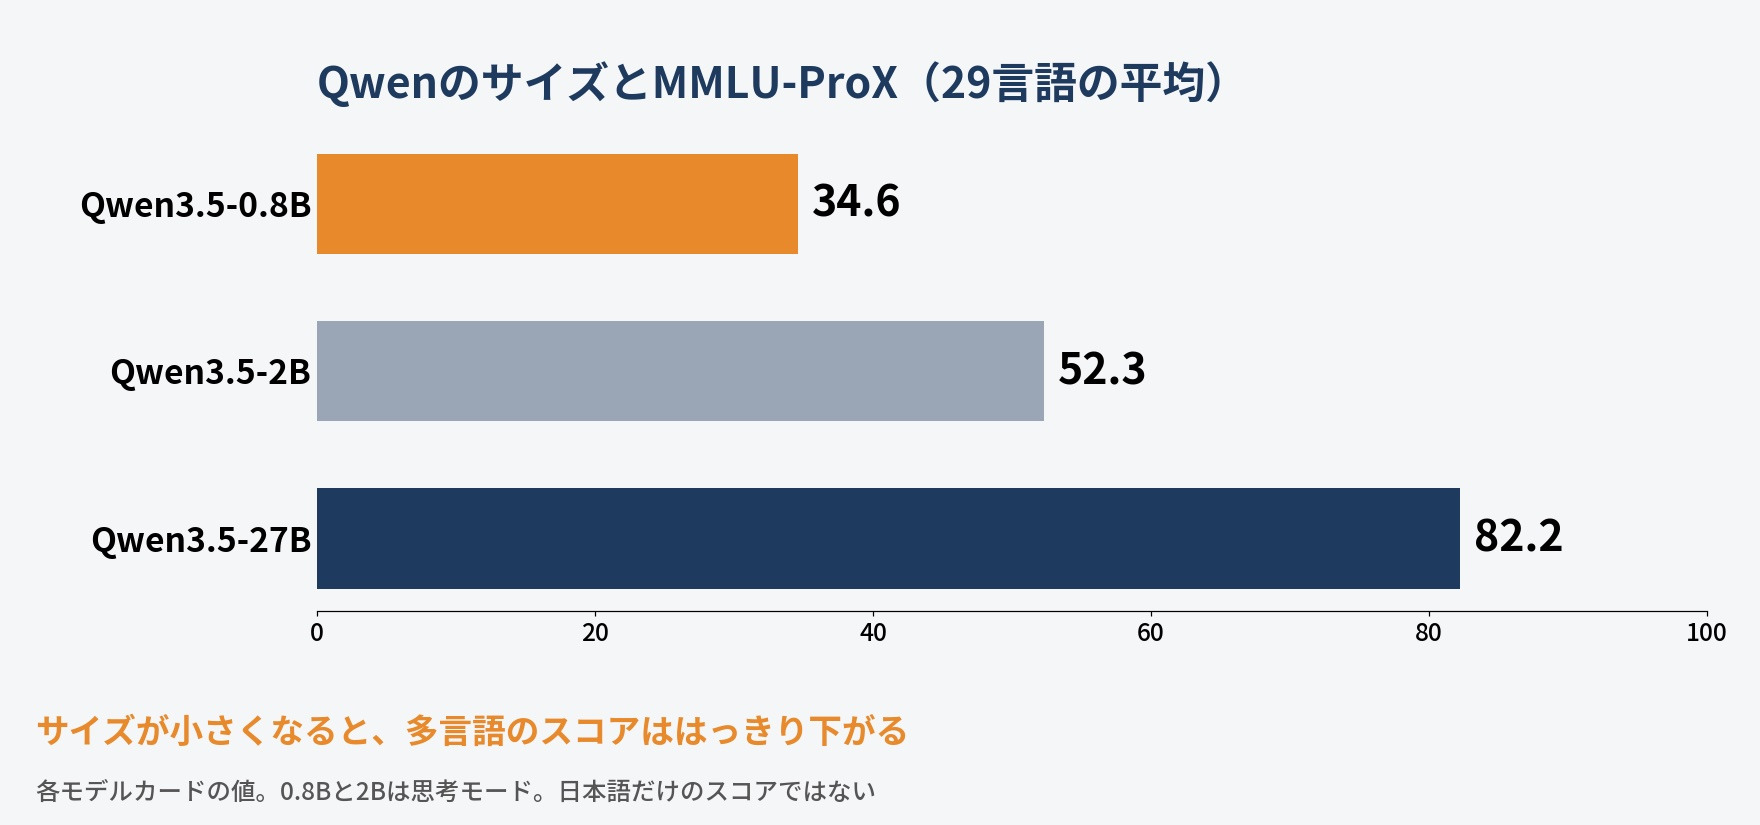
Qwenのモデルカードには多言語の評価が載っていますが、日本語だけのスコアではありません。例えばQwen3.5-27Bのモデルカードでは、MMLU-ProXが82.2、WMT24++が77.6です。注記によると、MMLU-ProXは29言語の平均、WMT24++は55言語の平均です(Qwen3.5-27B)。同じ表でGPT-5-miniはMMLU-ProX 78.5なので、多言語の平均では同等以上と読めますが、日本語で同じ差が出るかはこの表からは分かりません。
一方、サイズが小さくなるとスコアははっきり下がります。Qwen3.5-0.8BのモデルカードではMMLU-ProXが34.6、Qwen3.5-2Bが52.3でした(いずれも思考モード、Qwen3.5-0.8B)。なお、2026年8月公開のQwen3.8-27Bのモデルカードには、多言語の評価表そのものがありません。
小さいQwenは流暢な日本語で事実を誤る
先ほどの出力を見直すと、3問とも文の形は整っていますが、内容には誤りがあります。
- メールの書き換えは「遅らせてもらえますか」が「お待ちいただけますか」になり、依頼の意味が変わっています
- 富士山の標高を「8234米」と答えています。国土地理院の日本の主な山岳標高では、剣ヶ峯の3,776mです
- 要約は句点を含めて36字で、30字以内という指示を守れていません
思考モードにすれば直るのかも試しました。同じ富士山の質問を、モデルカードが思考モードに推奨する設定(temperature 0.6、top_p 0.95)で投げると、255トークンの思考のあとに次の答えが返ってきました。
日本の最高山は**ミトマス(Mount Fuji)**であり、標高は約**3,718メートル**。この山は東北の北海道に位置し、世界中で最も高い山として知られています。思考タグの後の回答部分をそのまま載せています。名前も標高も所在地も誤っています。1B未満のモデルは、日本語の文体は整っていても知識の正確さは期待できません。用途は、文章の整形や分類のように答えが入力の中にあるタスクか、パイプラインの動作確認に限るのが現実的です。
日本語を強化したQwenの派生モデル
日本語の知識を補う方法として、Qwenを土台に日本語で追加学習した派生モデルがあります。東京科学大学と産業技術総合研究所は、2026年2月20日に Qwen3 Swallow(8B・30B-A3B・32B、Apache 2.0)を公開しました。開発元の発表では、8B版が日本の知識を問う JamC-QA で元のQwen3 8Bより4.6ポイント高くなっています(Qwen3 Swallow)。
自社のタスクでQwenの日本語を評価する4つの手順
公式の数字も派生モデルの発表も、自社の業務で同じ結果が出る保証にはなりません。導入前には、次の手順で自社のタスクを使って確かめます。
- 評価用の問題を30〜50問作る:実際の業務で使う入力(問い合わせ文、社内文書の要約対象など)と、正解または合格の基準を対にします
- 候補を2〜3サイズに絞って同じ条件で回す:温度などの設定とプロンプトを固定し、例えば9Bと27Bを並べます
- 誤りの種類を分けて数える:事実の誤り、指示の無視(字数など)、敬語や言い回しの不自然さを別々に数えます。今回の0.6Bでは3種類すべてが出ました
- 結果を記録して、モデルを更新するたびに回し直す:Qwenは数か月ごとに新しい世代が出るため、同じ問題で比べ直せる形で残します
ここまでQwenの日本語の見方を解説しましたが、候補のモデルを自社のタスクで測って比べたいものの、評価の仕組みを一人で組み立てきれるか不安だという方もいらっしゃると思います。
リベルクラフトが運営するCraft CollegeのDS ADVANCEDは、実務でデータやモデルを扱っている方に向けた12週の上級プログラムです。Fine-tuningやAgentic RAGの実装に加えて、W&BやMLflowを使った評価と精度改善までを扱うため、本記事の「同じ問題で測って比べ直す」進め方を、記録して比較する仕組みとして身につけられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft College DS ADVANCEDの詳細はこちら
Qwenと中国系オープンモデル(Kimi・GLM・DeepSeek)の比較
Qwen単体の見方が揃ったところで、同じ中国系のオープンモデルと比べます。中国企業のオープンモデルとして候補に挙がりやすいのは、Kimi・GLM・DeepSeekの3系統です。
4系統の規模とライセンス
各社がHugging Faceで公開している最新の主なモデルを、モデルカードとLICENSEファイルで確かめました。
| 系統(開発元) | 主なオープンウェイト | 規模 | ライセンス |
|---|---|---|---|
| Qwen(Alibaba) | Qwen3.8-27B・Qwen3.8-2.4T-A95B | 27B(Dense)・総2.4Tで稼働95B | Apache 2.0・Qwen3.8-Max License |
| Kimi(Moonshot AI) | Kimi K3 | 総2.8Tで稼働104B | Kimi K3 License |
| GLM(Zhipu AI) | GLM-5.3・GLM-5.3-Flash | GLM-5.3は約753B、Flashは総320Bで稼働18B | GLM-5.3 License・MIT |
| DeepSeek(DeepSeek) | DeepSeek-V4.1-Flash | バックボーン552B | MIT |
この表から読み取れるのは、4系統とも最上位のモデルは数千億から数兆パラメータの規模で、1台のPCでは動かせない点です。ライセンスは、MITのように条件の少ないものと、事業規模に応じた条件を付けるものに分かれます。GLM-5.3の規模は、Hugging Faceが表示するパラメータ数の合計です。
KimiとGLMのライセンスの特徴
KimiとGLMの独自ライセンスは、Qwen3.8-Max Licenseと同じく、使用と改変を広く認めたうえで大規模事業にだけ条件を付ける作りです。ただし閾値が違います。
- Kimi K3 License:API提供などの事業で連続12か月の売上が2,000万米ドルを超える場合は、商用利用の前にMoonshot AIと別の契約を結ぶ(Kimi K3 LICENSE)
- GLM-5.3 License:同じくAPI提供などの事業で連続12か月の売上が100億米ドルを超える場合は、商用利用の前に開発元の安全審査を受ける(GLM-5.3 LICENSE)
同じ「中国系のオープンモデル」でも、閾値は500倍違います。DeepSeekの性能や危険性、商用利用の論点はDeepSeekとは何か?性能・危険性・商用利用と業務での使い方で詳しく扱っています。
手元で動かせるサイズを揃えているのはQwen
4系統を比べたときのQwenの特徴は、1B未満から27BまでのDenseモデルと、35B-A3BのようなMoEの中型モデルを、同じ世代の中で揃えている点です。KimiとGLMとDeepSeekの最新世代は大規模モデルが中心で、手元のPCで試すにはQwenのほうが入りやすいと言えます。国内外のモデルを用途別に選びたい場合は、ローカルLLMのおすすめは?業務で使うモデルの選び方と用途別比較や主要なLLMモデル8選一覧比較表もあわせてご覧ください。
Qwenを業務で使うときの判断材料
候補を比べたら、最後に社内で使ってよいかを判断します。ここでは「データの所在」と「モデル自体の挙動」を分けて考えます。
データの所在は使い方で変わる
Qwen Chatのようなサービスや外部のAPIを使う場合、入力したデータはサービス提供者の環境で処理されます。中国系のサービスについては、公的機関の注意喚起が出た例があります。
- 個人情報保護委員会は2025年2月3日、DeepSeek社が取得したデータは中華人民共和国に所在するサーバに保存され、同国の法令が適用されると情報提供しました(個人情報保護委員会)
- デジタル社会推進会議幹事会事務局は同年2月6日の事務連絡で、利用規約への同意だけで使うサービスでは原則として要機密情報を扱えないこと、国外にサーバがある場合は現地の法令が適用されることを各府省庁に示しました(デジタル庁の事務連絡)
Qwenを対象にした国内の公的な注意喚起は、2026年9月23日時点で見つかりませんでした。ただ、同じ考え方は当てはまります。APIの場合、Alibaba Cloud Model Studioには東京リージョンがあり、公式ドキュメントはリクエストのデータを選んだリージョンに保存すると説明しています。推論を実行する場所は「デプロイ範囲」で決まり、東京リージョンでは Global と Japan から選べます(Model Studio Regions and endpoints)。
一方、オープンウェイトを自社の環境で動かせば、データは外部に出ません。ここが、Qwenを業務で使うときの最大の選択肢になります。
モデル自体の挙動はローカルでも変わらない
ただし、自社の環境で動かしても変わらないものがあります。モデル自体の挙動です。
米国立標準技術研究所(NIST)のCAISIは、DeepSeekのモデルを評価した報告書で、Hugging Faceから取得した重みを自前の環境で動かしても中国共産党の主張に沿った検閲的な回答が出たとして、検閲はモデルに組み込まれていると結論づけました(CAISI Evaluation of DeepSeek AI Models)。2025年12月のKimi K2 Thinkingの評価では、こうした回答の割合が中国語で約26%、英語で約7%と、言語によって大きく違いました(CAISI Evaluation of Kimi K2 Thinking)。
Qwenを単独で扱ったCAISIの評価は見つかりませんでした。Qwenに同じ傾向があるかは、公開情報からは断定できません。政治や歴史に関わる文章を生成する用途では、自社の評価問題に該当する質問を入れて確かめるのが確実です。
Qwenの業務利用を判断する5つの手順
ここまでの材料を、社内での判断の順番に並べます。
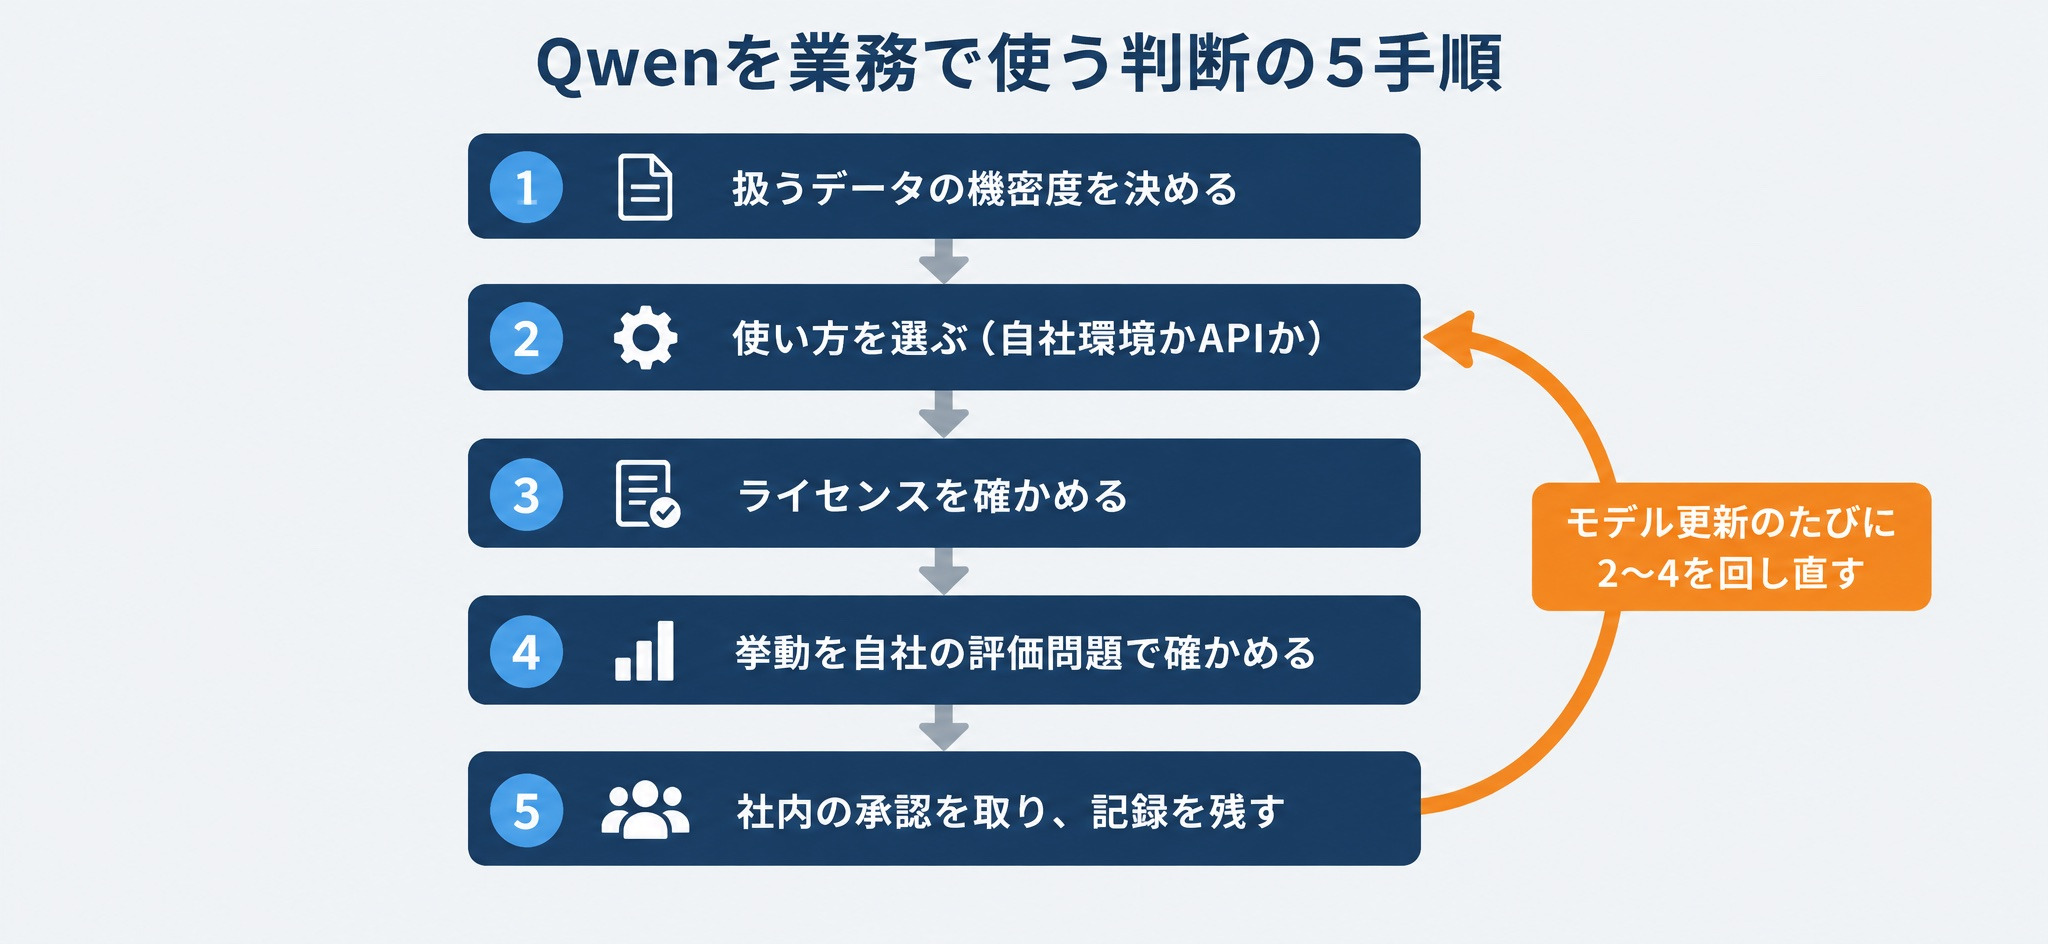
- 扱うデータの機密度を決める:個人情報や取引先の情報を入れるかを、業務の担当者と情報システム部門で決めます
- 使い方を選ぶ:機密情報を扱うならオープンウェイトを自社環境で動かします。APIを使うなら、リージョンとデプロイ範囲、規約の学習利用の有無を確かめます
- ライセンスを確かめる:前述の3つの手順で、社内利用か第三者への提供かを含めて確認します
- 挙動を自社の評価問題で確かめる:日本語の精度に加え、偏りが問題になる話題の質問も入れます
- 社内の承認を取り、記録を残す:選んだモデルのバージョン、ライセンス、評価結果を残し、モデルを更新するたびに2〜4を回し直します
自社環境での構築の進め方は、ローカルLLMの構築ガイドで5つのステップに分けて解説しています。
まとめ
- Qwenは、Alibaba GroupのQwenチームが開発するLLMとマルチモーダルモデルのシリーズで、Qwen Chat・API・オープンウェイトの3つの入口があります
- 2026年9月時点の主力は、Qwen3.5(0.8B〜397B-A17B)、Qwen3.6(27B・35B-A3B)、Qwen3.8(27B・Flash-Next・2.4T-A95B)です
- ライセンスはモデルごとに違い、Apache 2.0・Qwen3.8-Max License・Qwen Community License 1.0・Qwen Research Licenseが混在しています。落とす前にLICENSEを全文読みます
- 手元で現実的なのは27Bまでです。Ollamaの量子化版なら27Bが18GB、9Bが6.6GBです
- 公式の多言語スコアは多言語の平均値です。今回動かした0.6Bは流暢な日本語で富士山の標高を誤りました。日本語の実力は自社のタスクで確かめます
- 業務で使うときは、データの所在とモデル自体の挙動を分けて判断します。自社環境で動かせばデータは外に出ませんが、挙動は変わりません
Qwenを使ったローカルLLMの構築とAI開発は「リベルクラフト」へ
「Qwenの候補は絞れたが、自社のデータで評価し、ライセンスと社内の承認まで通して本番に乗せるところまで進められるだろうか」と感じた方もいらっしゃるのではないでしょうか。
リベルクラフトが運営するCraft CollegeのDS ADVANCEDは、すでに実務でモデルを扱っている方に向けた12週の上級プログラムです。Agentic RAGやマルチエージェントの実装、Fine-tuning、W&BとMLflowを使った評価と精度改善を扱い、オープンモデルを自分で選んで評価し、改善する力を身につけられます。
リベルクラフト本体では、ローカルLLMの構築を含むAI開発の支援も行っています。
- 機密データを外に出さずに使えるローカルLLMの環境を作りたい
- QwenなどのオープンモデルとRAGを組み合わせ、社内文書に答えられる仕組みにしたい
- 候補のモデルを自社のデータで比べて、選んだ理由を社内に説明できる形にしたい
こうした段階から、現役のデータサイエンティストとエンジニアが伴走します。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。