レコメンドとは。仕組みと主なアルゴリズムを、同じ購買データで比べて解説
ECサイトの「この商品を見た人はこちらも見ています」や、動画配信サービスのおすすめ欄は、いまや見慣れた機能です。ところが自社のサービスにレコメンドを入れる側に回ると、協調フィルタリングにするのか、商品の属性を使うのか、最近はLLMも使えるのか、と選択肢の多さで手が止まる方も多いのではないでしょうか?
しかも、どの方式が良いかを何の数値で判断するのかは、解説記事ではあまり書かれていません。
そこで本記事では、
- レコメンドとは何か。レコメンド機能・レコメンドエンジン・レコメンドシステムの違い
- レコメンドエンジンの中で動いている処理の流れ
- ルールベースからLLMまで、主なアルゴリズム6系統の得意と苦手
- 人気順・コンテンツベース・協調フィルタリングを同じ購買データで比べた結果
- Precision@K・Recall@K・NDCGといった評価指標の読み方と、コールドスタートなどの課題
- 自作・クラウド・国内SaaSからレコメンドエンジンを選ぶ手順と、公表されている事例
を解説します。
本記事のコードと数値は、すべて実際に実行して得た出力です。実行環境は Python 3.13.13・numpy 2.5.3・pandas 3.0.6・scipy 1.18.1・scikit-learn 1.9.1・openpyxl 3.1.5、機材は Apple M1 Pro のノートPC、実行日は2026年9月23日、乱数シードは42です。データは誰でも取得できる公開データを使っています。
自社のデータでレコメンドを作りたいものの、どの方式から試すかを相談できる相手が社内にいないという方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
- レコメンドとは。行動や属性から、その人に合う候補を選んで見せる仕組み
- レコメンドエンジンの仕組み。データ・候補生成・ランキングの流れ
- レコメンドの主なアルゴリズム。ルールベースからLLMまで6系統
- レコメンドのアルゴリズムを同じ購買データで比べる
- レコメンドの評価指標。Precision@K・Recall@K・NDCGの読み方
- レコメンドの課題。コールドスタート・人気への偏り・フィードバックループ
- レコメンドエンジンの選び方。自作・クラウド・国内SaaS
- レコメンドの公表事例。Netflix・Amazon・メルカリ・LINEヤフー・ZOZO
- レコメンドの要点のまとめ
- レコメンドの設計と評価を体系的に学ぶなら「Craft College」へ
レコメンドとは。行動や属性から、その人に合う候補を選んで見せる仕組み
レコメンドとは、利用者の行動履歴や属性、商品やコンテンツの情報をもとに、その人に合いそうな候補を選んで提示する仕組みです。日本語では「推薦」とも呼ばれ、学術分野では推薦システム(recommender system)という用語が使われます。
レコメンドの意味。英語の recommend は「勧める・推薦する」
レコメンドは英語の動詞 recommend から来たカタカナ語です。Cambridge Dictionary は recommend を「特定の目的に対して、ある人や物が良い、または適していると勧めること」と説明しています(Cambridge Dictionary)。名詞形は recommendation です。
ビジネスの文脈でレコメンドと言うときは、人が勧めるのではなく、システムがデータから自動で勧めることを指すのが一般的です。
レコメンド機能・レコメンドエンジン・レコメンドシステムの違い
似た3つの言葉は、指している範囲が違います。
- レコメンド機能:画面上の「おすすめ」「この商品を買った人はこんな商品も」といった表示枠のこと。利用者から見える部分です
- レコメンドエンジン:何を出すかを計算する部品のこと。アルゴリズムとモデル、候補を返すAPIを含みます。製品として販売されているのは主にこの部分です
- レコメンドシステム:行動データの収集から、学習・推薦・表示・効果測定までを含む仕組み全体のこと
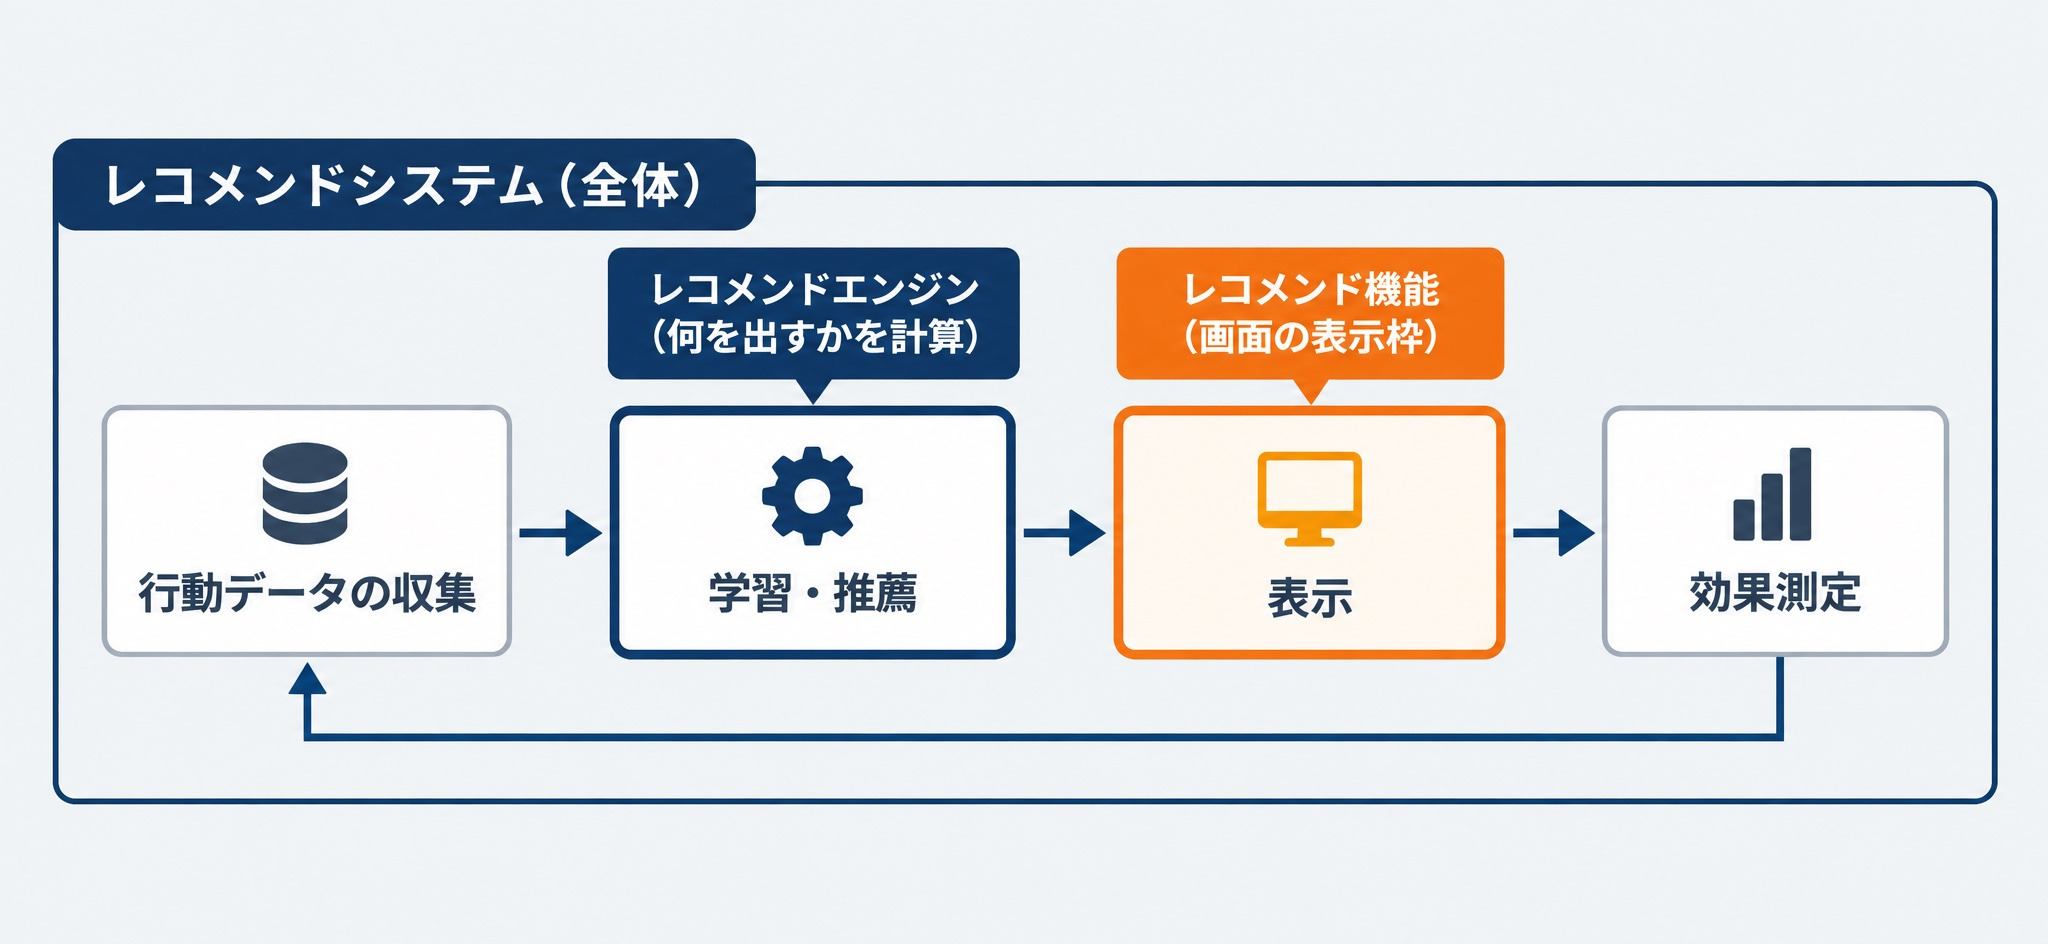
本記事では、計算の部品を指すときにレコメンドエンジン、全体を指すときにレコメンドシステムと書き分けます。
レコメンドが使われている場面
レコメンドが使われている主な場面は次のとおりです。
- ECサイトの関連商品・ついで買いの提案、メールで送るおすすめ商品
- 動画・音楽配信のトップ画面や、次に再生する作品の提案
- ニュースアプリの記事の並び順
- 求人サイトや人材サービスでの、求人と求職者の組み合わせ
- 社内ポータルでの、関連する文書やナレッジの提示
どの場面でも、候補の数が多すぎて利用者が全部を見られない、という前提は共通しています。データサイエンスを使った他の活用例は、データサイエンスの活用事例を扱った記事でまとめています。
レコメンドエンジンの仕組み。データ・候補生成・ランキングの流れ
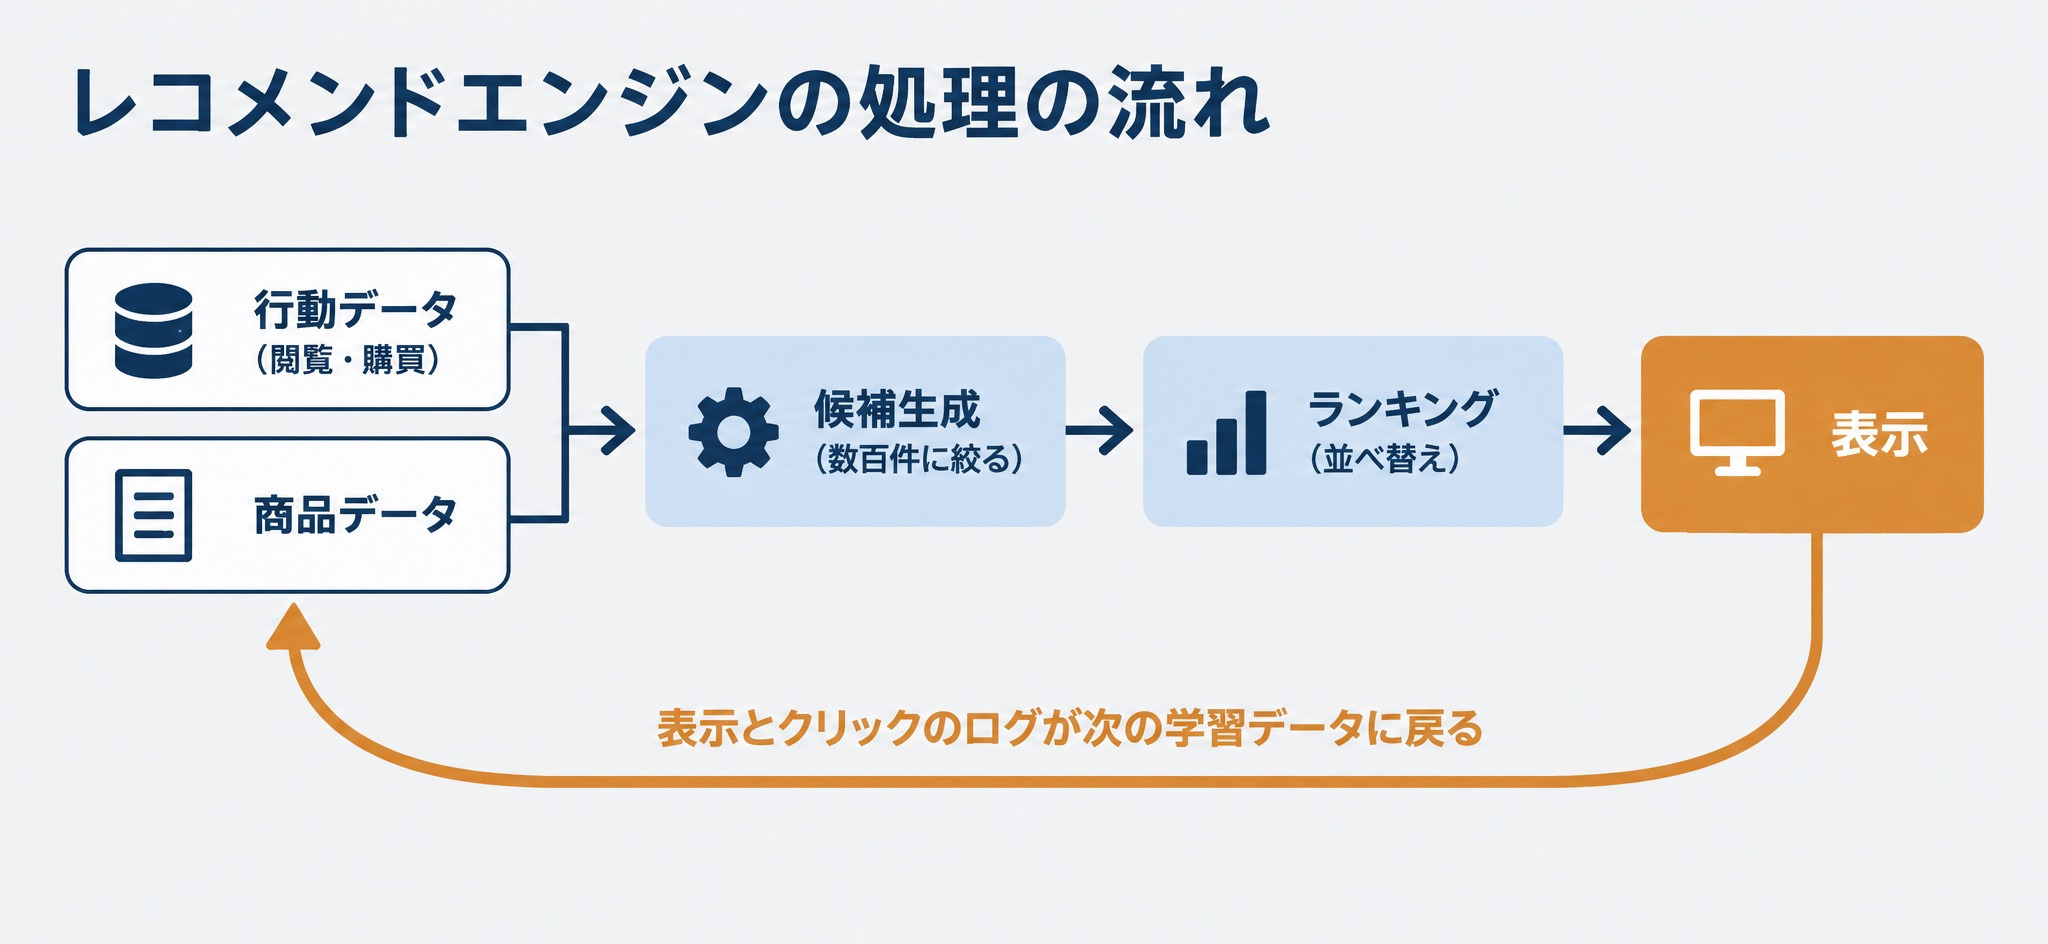
言葉の整理ができたところで、レコメンドエンジンの中で何が動いているかを見ていきます。レコメンドシステムは大きく、データを集める、候補を絞る、候補を並べ替える、表示した結果を記録する、の4つの工程で動いています。
使うデータ。評価のような明示的なデータと、購買や閲覧のような暗黙的なデータ
レコメンドに使う行動データは2種類に分かれます。
1つは明示的フィードバックで、星5つの評価やいいねのように、利用者が好き嫌いをはっきり示したデータです。もう1つは暗黙的フィードバックで、購買・閲覧・再生・滞在時間のように、行動から好みを推し量るデータを指します。
実務で量が多いのは暗黙的フィードバックです。ただし扱いには注意が要ります。Hu, Koren, Volinsky (2008) は、暗黙的フィードバックを「好みの有無を、確からしさの大きく異なる形で示すデータ」として扱う方法を提案しました(Collaborative Filtering for Implicit Feedback Datasets)。買っていない商品は「嫌い」ではなく「知らない」だけかもしれない、という点が明示的な評価との違いです。
行動データのほかに、商品名・カテゴリ・価格といった商品データと、年齢層・地域といった利用者の属性データも使います。
候補を絞ってから並べ替える2段の構成
商品や動画が数百万件あると、全件に対して細かい計算をしていては応答が間に合いません。そこで大規模なレコメンドシステムでは、処理を2段に分けるのが一般的です。
YouTubeの推薦を扱った Covington, Adams, Sargin (2016) は、この構成を具体的に書いています(Deep Neural Networks for YouTube Recommendations)。システムは候補生成とランキングの2つのニューラルネットワークでできており、候補生成は大量の動画の中から数百件の小さな集合を取り出し、ランキングは多くの特徴量を使って各動画にスコアを付けます。この2段構成によって、数百万件規模の動画から推薦できると述べています。
候補生成では速さを、ランキングでは精度を優先する、という役割分担です。
表示した結果が次の学習データになる
レコメンドシステムには、ほかの予測モデルにはあまり無い性質があります。推薦して表示した結果が、そのまま次の学習データになるという点です。
推薦された商品はクリックされやすく、推薦されなかった商品はそもそも見られません。そのため、学習に使うログは、過去の推薦の影響を受けた偏ったデータになります。この偏りが課題につながる仕組みは、後半の課題の節で扱います。
レコメンドの主なアルゴリズム。ルールベースからLLMまで6系統
レコメンドエンジンの仕組みの中で、候補を出したり並べ替えたりする計算を担うのがアルゴリズムです。主なアルゴリズムは、次の6系統に整理できます。実際のレコメンドエンジンは、複数の系統を組み合わせたハイブリッド型で作られることが多くあります。なお、製品の紹介などで「パーソナライズド型」と呼ばれるのは、個人の履歴や属性によって出す結果を変える方式の総称で、下の表ではコンテンツベースから下の系統がこれにあたります。
| 系統 | 主に使うデータ | 得意なこと | 苦手なこと |
|---|---|---|---|
| ルールベース | 人が決めた条件・売上ランキング | 意図どおりに出せる。データが少なくても動く | 個人に合わせにくい。ルールの保守に手間がかかる |
| コンテンツベース | 商品の属性・説明文 | 売れた実績の無い新商品も出せる | 似た商品ばかりになりやすい |
| 協調フィルタリング | 顧客と商品の行動履歴 | 属性に表れない好みの近さを拾える | 行動履歴の無い顧客や商品を扱えない |
| 行列分解 | 顧客と商品の行動履歴 | データがまばらでも近さを推定できる | 行動履歴の無い顧客や商品を扱えない |
| 深層学習・系列モデル | 行動の順番・多数の特徴量 | 直近の関心の変化を捉えられる | 学習と運用の費用が大きい |
| LLMを使った推薦 | 商品の説明文・行動履歴を文章にしたもの | 文章で書かれた好みや新商品に対応しやすい | 応答の遅さと費用。人気や提示順に引っ張られる |
この表から読み取れるのは、苦手なことの多くが「どのデータを使うか」で決まっている点です。行動履歴だけを使う系統は、履歴の無い相手を扱えません。この点は、次の節の実測でも数値として現れます。
ルールベース。人が決めた条件で出す
ルールベースは、「このカテゴリを見た人には、このカテゴリの売れ筋を出す」のように、人が決めた条件で推薦する方式です。全員に同じ売上ランキングを出す人気順も、ここに含まれます。
出す商品を運営側で管理できるため、キャンペーン商品を確実に見せたい場面に向いています。一緒に買われやすい商品の組み合わせをデータから見つけるアソシエーション分析の結果を、ルールとして使うこともあります。アソシエーション分析についてはデータ分析の手法を解説した記事で紹介しています。
コンテンツベース。商品の属性が似ているものを出す
コンテンツベースは、利用者が過去に買ったり見たりした商品と、属性や説明文が似ている商品を出す方式です。コンテンツベースフィルタリングとも呼ばれます。
商品の情報だけで似ているかどうかを計算できるので、発売したばかりで誰も買っていない商品でも候補に入ります。一方で、似た商品が並びやすく、利用者が自分では探さないような意外な商品は出にくくなります。
協調フィルタリング。似た行動をした人の購買から出す
協調フィルタリングは、「この商品を買った人は、あの商品も買っている」という行動の重なりから推薦する方式です。商品どうしの近さを使うアイテムベースと、顧客どうしの近さを使うユーザーベースがあります。
Amazonの Linden, Smith, York (2003) が発表したアイテムベースの協調フィルタリングは、商品どうしの類似度の表を事前に計算しておくことで、オンラインでの計算量が顧客数や商品数に依存しない形にしました(Amazon.com Recommendations: Item-to-Item Collaborative Filtering)。類似度の計算方法やユーザーベースとの違いといった協調フィルタリングの詳細は、別の記事で扱います。本記事では、レコメンドのアルゴリズム全体の中の位置づけと、他の方式と並べた実測にとどめます。
行列分解。顧客と商品を少数の因子で表す
行列分解は、顧客×商品の行動の表を、顧客の因子と商品の因子の掛け算で近似する方式です。顧客と商品を、行動の表よりずっと少ない数の因子で表すので、直接の重なりが少ない組み合わせでも近さを推定できます。
Koren, Bell, Volinsky (2009) は、Netflix Prizeのコンペティションが示したとおり、行列分解のモデルは古典的な近傍法より商品推薦で優れており、暗黙的フィードバックや時間の効果も取り込めると述べています(Matrix Factorization Techniques for Recommender Systems)。
深層学習と系列モデル。行動の順番まで使う
深層学習を使う方式では、多数の特徴量を入れてスコアを予測したり、顧客と商品をそれぞれベクトルに変換して近さを測ったりします。候補生成の段階で、ベクトルの近い商品を高速に探す近傍探索を組み合わせる構成もよく使われます。
行動の順番まで使うのが系列モデルです。SASRec(Kang & McAuley 2018)は自己注意機構を使い、直近の少数の行動から次に選ばれる商品を予測します。BERT4Rec(Sun et al. 2019)は、行動の列の一部を隠して当てる学習で、前後両方向の文脈を使います。
LLMを使った推薦。並べ替えと生成の2つの使い方
LLM(大規模言語モデル)を推薦に使う研究は、大きく2つの方向に分かれます。
1つは、既存の方式で絞った候補を、LLMに並べ替えさせる使い方です。Hou et al. (2023) は、GPT-4などのLLMが追加学習なしでも候補を並べ替える能力を持つことを示しました(Large Language Models are Zero-Shot Rankers for Recommender Systems)。同時に、履歴の順番を捉えにくいこと、人気やプロンプト内での提示位置に引っ張られることも弱点として報告しています。
もう1つは、推薦そのものを生成として解く使い方です。TIGER(Rajput et al. 2023)は、商品を意味のある符号の組で表し、次に選ばれる商品の符号をTransformerで生成します。Metaの HSTU(Zhai et al. 2024)は、推薦を系列の生成として定式化し、オンラインのA/Bテストで12.4%の改善を報告しました。
LLMの基本的な仕組みはLLM(大規模言語モデル)とは何かを解説した記事で扱っています。
レコメンドのアルゴリズムを同じ購買データで比べる
6系統のうち、手元ですぐ動かせる人気順・コンテンツベース・協調フィルタリングの3つを、同じ購買データと同じ指標で比べます。比較の基準として、ランダムに選ぶ方式も加えました。
使ったデータと評価の条件
データは、UCI Machine Learning Repository で公開されている「Online Retail」を使いました(Online Retail、DOI 10.24432/C5BW33)。英国の通信販売事業者の、2010年12月1日から2011年12月9日までの取引データで、ライセンスは CC BY 4.0 です。出典を示せば、商用を含むどの目的でも使えます。取得元のファイルは約23MBです。
購買データを次の条件で整えました。
- 取消伝票、顧客IDの無い行、数量や単価が0以下の行、送料などの商品でないコードを除く
- 2011年10月1日より前を学習期間、以降を評価期間に分ける
- 評価の対象は、両方の期間に購買がある顧客。正解は、評価期間に買った商品のうち、学習期間には買っていない商品とする
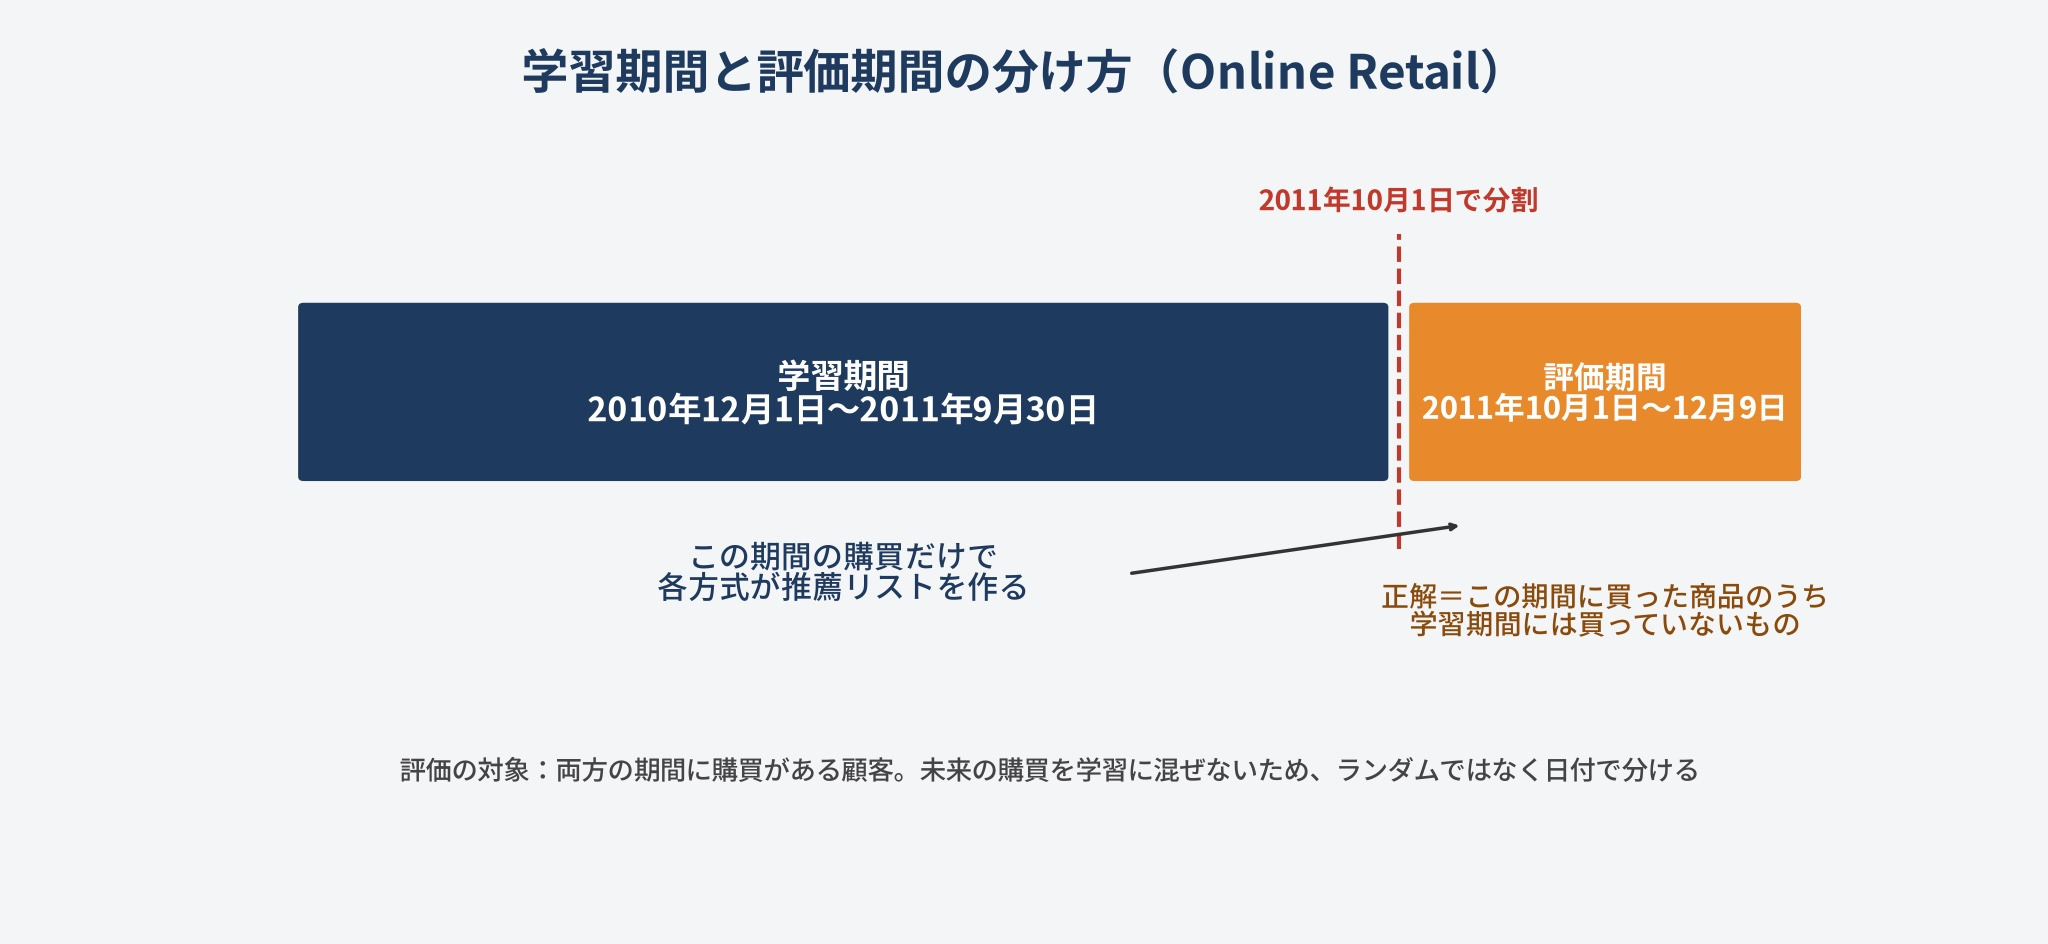
期間で分けたのは、未来の購買を使って過去を予測しないためです。ランダムに分けると、評価期間の情報が学習に混ざり、実際より良い数値が出るおそれがあります。すでに買った商品を正解から外したのは、日用品のような繰り返しの購買を当てても、推薦としての価値が小さいからです。
コードは番号を付けたブロックに分けて示します。実行は1つのファイルとして番号順に続けて行い、記事では説明の都合で4以降の掲載順を入れ替えています。記事には推薦と評価の中核になる処理だけを載せ、ライブラリの読み込み(numpy・pandas・scipy・scikit-learn)、定数の定義(乱数シード SEED = 42、推薦件数 K = 10)、件数を表示するだけの処理は省きました。まずデータの読み込みと分割です。
# ===== 1. データの読み込みと、学習期間・評価期間への分割 =====
df = pd.read_excel("Online Retail.xlsx", dtype={"InvoiceNo": str, "StockCode": str})
df = df[~df["InvoiceNo"].str.startswith("C")]                  # 取消伝票を除く
df = df.dropna(subset=["CustomerID"])                           # 顧客IDの無い行を除く
df = df[(df["Quantity"] > 0) & (df["UnitPrice"] > 0)]
df = df[df["StockCode"].str.match(r"^\d{5}[A-Za-z]?$")]         # 送料などの非商品コードを除く
df["user"] = df["CustomerID"].astype(int)
df["item"] = df["StockCode"].str.upper()

split = pd.Timestamp("2011-10-01")
train = df[df["InvoiceDate"] < split]
test = df[df["InvoiceDate"] >= split]
train_items = train.groupby("user")["item"].apply(set)
test_items = test.groupby("user")["item"].apply(set)
users = sorted(set(train_items.index) & set(test_items.index))
truth = {u: test_items[u] - train_items[u] for u in users}      # その人にとって新しい商品だけを正解にする
truth = {u: s for u, s in truth.items() if s}
eval_users = sorted(truth)

# 商品カタログ(全期間の商品と商品名)。候補はカタログ全体から選ぶ
catalog = df.groupby("item")["Description"].agg(lambda s: s.astype(str).mode().iloc[0])
items = catalog.index.to_numpy()
idx = {it: i for i, it in enumerate(items)}
new_items = set(items) - set(train["item"])                     # 学習期間に一度も売れていない商品
除外の条件を当てたあとのデータは、顧客4,334人、商品3,658点、購買396,046行でした。評価の対象は1,768人で、正解は合計52,329件です。1人あたり平均およそ30点の「初めて買う商品」がある計算になります。正解のうち4,663件(8.9%)は、学習期間に誰も買っていない商品でした。この8.9%は、行動履歴だけを使う方式では原理的に当てられない部分で、後半のコールドスタートの節で効いてきます。
人気順・コンテンツベース・協調フィルタリングの実装
次に3つの方式を実装します。どの方式も、商品ごとにスコアを出し、すでに買った商品を除いて上位10件を返す、という同じ形にそろえました。
# ===== 2. 3つの推薦方式 =====
uidx = {u: i for i, u in enumerate(sorted(train_items.index))}
rows = [uidx[u] for u, s in train_items.items() for it in s]
cols = [idx[it] for u, s in train_items.items() for it in s]
X = sparse.csr_matrix((np.ones(len(rows)), (rows, cols)),
                      shape=(len(uidx), len(items)))            # 顧客×商品の購買有無(0か1)

def recommend(scores, u):
    """買ったことのある商品を除き、スコアの高い順にK件返す"""
    scores = scores.astype(float).copy()
    scores[[idx[it] for it in train_items[u]]] = -np.inf
    top = np.argpartition(-scores, K)[:K]
    return list(items[top[np.argsort(-scores[top])]])

# (a) 人気順:学習期間に買った顧客数が多い順。全員に同じ並び
popularity = np.asarray(X.sum(axis=0)).ravel()
def rec_popular(u):
    return recommend(popularity, u)

# (b) コンテンツベース:商品名のTF-IDFで、買った商品に似た商品名を探す
tfidf = TfidfVectorizer(ngram_range=(1, 2), min_df=2)
V = normalize(tfidf.fit_transform(catalog.values))              # 商品×語(行を長さ1に正規化)
def rec_content(u):
    profile = normalize(np.asarray(V[[idx[it] for it in train_items[u]]].mean(axis=0)))
    return recommend(np.asarray(V @ profile.ravel()).ravel(), u)

# (c) 協調フィルタリング(アイテムベース):同じ顧客に買われている商品どうしを似ているとみなす
t0 = time.perf_counter()
Xn = normalize(X.T.tocsr())                                     # 商品ベクトルを長さ1に
S = (Xn @ Xn.T).tocsr()                                         # 商品×商品のコサイン類似度
S.setdiag(0)
print(f"商品間類似度の計算: {time.perf_counter() - t0:.2f}秒({S.shape[0]:,}×{S.shape[1]:,})")
def rec_itemcf(u):
    return recommend(np.asarray((X[uidx[u]] @ S).todense()).ravel(), u)
商品間類似度の計算: 0.13秒(3,658×3,658)コンテンツベースで使ったのは商品名だけです。英語の商品名を単語と2語の組に分けてTF-IDFで数値にし、その顧客が買った商品の平均に近い商品を探しています。協調フィルタリングは、同じ顧客に一緒に買われている度合いを商品どうしのコサイン類似度で表し、買った商品に近い商品のスコアを足し上げます。3,658点どうしの類似度の計算は0.13秒で終わりました。比較の基準にするランダムは、シード42の乱数を商品ごとのスコアにして、同じ recommend 関数に渡したものです(関数名は rec_random)。
結果。精度の差は小さく、推薦に出る商品の数が大きく違った
3つの方式とランダムを、同じ1,768人に対して同じ指標で評価します。指標の意味は次の節で説明します。
# ===== 3. 同じ指標で比べる:Precision@10・Recall@10・NDCG@10・カバレッジ =====
def evaluate(rec_fn):
    P, R, N, shown = [], [], [], set()
    for u in eval_users:
        recs = rec_fn(u)
        rel = np.array([it in truth[u] for it in recs], dtype=float)
        P.append(rel.sum() / K)
        R.append(rel.sum() / len(truth[u]))
        dcg = (rel / np.log2(np.arange(2, K + 2))).sum()
        idcg = (1 / np.log2(np.arange(2, min(K, len(truth[u])) + 2))).sum()
        N.append(dcg / idcg)
        shown.update(recs)
    return np.array(P), np.array(R), np.array(N), shown

methods = {"ランダム": rec_random, "人気順": rec_popular,
           "コンテンツベース": rec_content, "協調フィルタリング": rec_itemcf}
results = {}
for name, fn in methods.items():
    P, R, N, shown = evaluate(fn)
    results[name] = (P, R, N)
    print(f"{name} P@10={P.mean():.4f} R@10={R.mean():.4f} NDCG@10={N.mean():.4f} "
          f"推薦に出た商品={len(shown):,}点({len(shown) / len(items):.1%}) "
          f"新商品を含む割合={len(shown & new_items) / len(shown):.1%}")
evaluate は、評価対象の1人ごとに上位10件を出させ、正解との重なりから3つの指標を計算します。あわせて、1,768人の誰かに一度でも推薦した商品を集合 shown に溜め、その点数をカバレッジとして数えています。出力を表にまとめると次のとおりです。括弧内はカタログ3,658点に占める割合です。
| 方式 | Precision@10 | Recall@10 | NDCG@10 | 推薦に出た商品 | 新商品を含む割合 |
|---|---|---|---|---|---|
| ランダム | 0.0081 | 0.0026 | 0.0079 | 3,629点(99.2%) | 4.3% |
| 人気順 | 0.0407 | 0.0168 | 0.0433 | 69点(1.9%) | 0.0% |
| コンテンツベース | 0.0679 | 0.0400 | 0.0792 | 1,854点(50.7%) | 2.5% |
| 協調フィルタリング | 0.0718 | 0.0404 | 0.0848 | 892点(24.4%) | 0.0% |
新商品を含む割合は、推薦に出た商品のうち、学習期間に一度も売れていない商品が占める割合です。
この表から読み取れることは2つあります。
1つ目は、精度の指標では協調フィルタリングが先頭ですが、コンテンツベースとの差は小さい点です。NDCG@10の差0.0055が偶然の範囲かどうかを、顧客を復元抽出して平均を取り直すブートストラップで確かめました。
# ===== 6. 協調フィルタリングとコンテンツベースの差は偶然の範囲か(顧客単位のブートストラップ) =====
diff = results["協調フィルタリング"][2] - results["コンテンツベース"][2]
boot_rng = np.random.default_rng(SEED)
boot = [diff[boot_rng.integers(0, len(diff), len(diff))].mean() for _ in range(2000)]
lo, hi = np.percentile(boot, [2.5, 97.5])
print(f"NDCG@10の差(協調フィルタリング − コンテンツベース)= {diff.mean():.4f}、95%区間 [{lo:.4f}, {hi:.4f}]")
NDCG@10の差(協調フィルタリング − コンテンツベース)= 0.0055、95%区間 [-0.0016, 0.0127]95%区間が0をまたいでいるので、この1,768人のデータでは、どちらが上かを言い切れません。
2つ目は、推薦に出た商品の数に大きな差がある点です。人気順は1,768人に対して69点しか出しておらず、カタログの1.9%にとどまりました。協調フィルタリングは892点、コンテンツベースは1,854点です。精度の平均が近くても、店の品ぞろえのどれだけを利用者に見せているかは、方式によって大きく変わります。
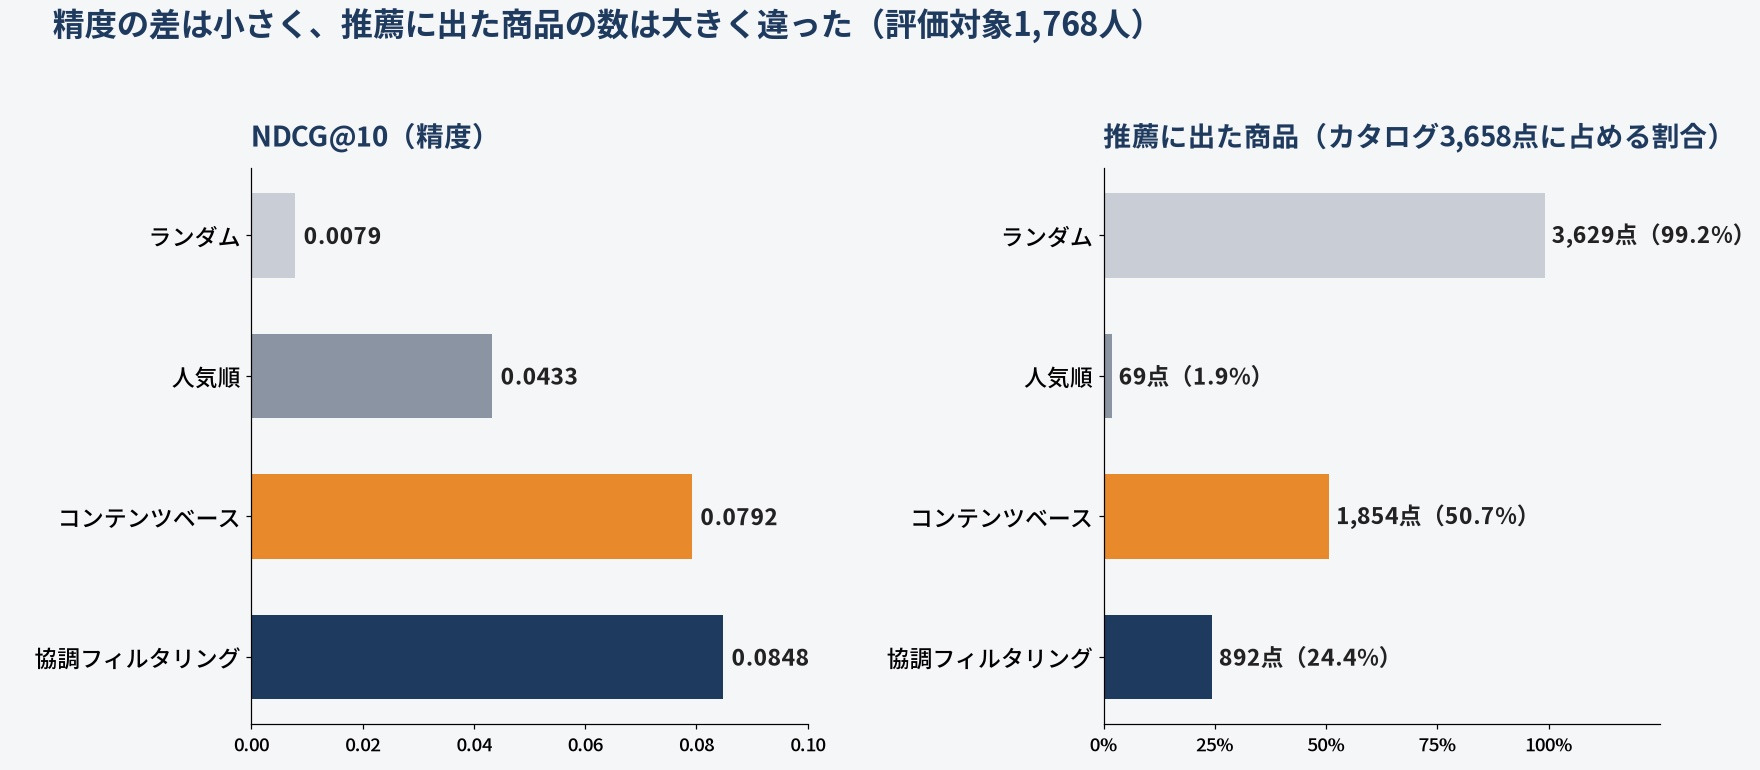
1回の分割・1つのデータセットでの結果なので、協調フィルタリングとコンテンツベースの優劣を一般化はできません。商品名が短い英語の文字列だけというこのデータの条件では、両者がほぼ互角でした。商品説明が長いデータや、行動データがもっと多いデータでは、結果が変わる可能性があります。
1人の顧客で、3つの方式の出力を並べる
数値だけでは違いがつかみにくいので、顧客1人について、各方式が出した上位5件を並べます。評価対象を顧客ID順に見て、学習期間に8〜12点を買った最初の顧客を選びました。顧客12358で、学習期間に10点を買っています。そのうち4点は「EDWARDIAN PARASOL NATURAL」「EDWARDIAN PARASOL PINK」「FAIRY CAKE DESIGN UMBRELLA」「EDWARDIAN PARASOL RED」でした。先ほどの推薦関数を、この顧客に対して呼んだ結果が次の表です。商品名はデータに入っている英語のままです。
| 順位 | 人気順 | コンテンツベース | 協調フィルタリング |
|---|---|---|---|
| 1 | REGENCY CAKESTAND 3 TIER | CERAMIC CAKE DESIGN SPOTTED MUG | MINI CAKE STAND WITH HANGING CAKES |
| 2 | WHITE HANGING HEART T-LIGHT HOLDER | CERAMIC PLATE STRAWBERRY DESIGN | CERAMIC CAKE BOWL + HANGING CAKES |
| 3 | PARTY BUNTING | CERAMIC CAKE BOWL + HANGING CAKES | CERAMIC CAKE DESIGN SPOTTED MUG |
| 4 | PACK OF 72 RETROSPOT CAKE CASES | STRAWBERRY FAIRY CAKE TEAPOT | STRAWBERRY FAIRY CAKE TEAPOT |
| 5 | SET OF 3 CAKE TINS PANTRY DESIGN | HANGING FAIRY CAKE DECORATION | SWEETHEART CERAMIC TRINKET BOX |
この顧客では、どの方式の上位5件にも正解は入りませんでした。それでも出し方の違いは見えます。人気順はこの顧客の購買に関係なく全員向けの売れ筋を出し、コンテンツベースは商品名に「CAKE」「FAIRY」を含む商品を集めています。協調フィルタリングの上位5件のうち3件はコンテンツベースと重なっていますが、商品名の似ていない「SWEETHEART CERAMIC TRINKET BOX」も出ています。一緒に買われた実績から近さを測っているためです。
レコメンドの評価指標。Precision@K・Recall@K・NDCGの読み方
前の節の実測で使った指標を、どう読めばよいかを整理します。レコメンドの評価指標は、上位K件に正解がどれだけ入ったかを測るものと、正解の順位まで見るものに分かれます。
Precision@KとRecall@K。上位K件に正解がいくつ入ったか
Precision@Kは、推薦した上位K件のうち正解だった割合です。協調フィルタリングのPrecision@10は0.0718でした。10件出すと、平均で0.72件が実際に買われた、という意味です。
Recall@Kは、その人の正解全体のうち、上位K件で拾えた割合です。今回の顧客は1人あたり平均およそ30点の正解を持つので、10件しか出さない推薦ではRecall@10が0.04前後にとどまります。Recallの値が小さいこと自体は、方式の良し悪しではなく、正解の多さと推薦枠の狭さから来ています。
同じ方式でも、Kを変えると値は動きます。画面に実際に表示する件数にKを合わせると、指標と利用者の体験が近づきます。
NDCG。正解が上の順位にあるほど高く評価する
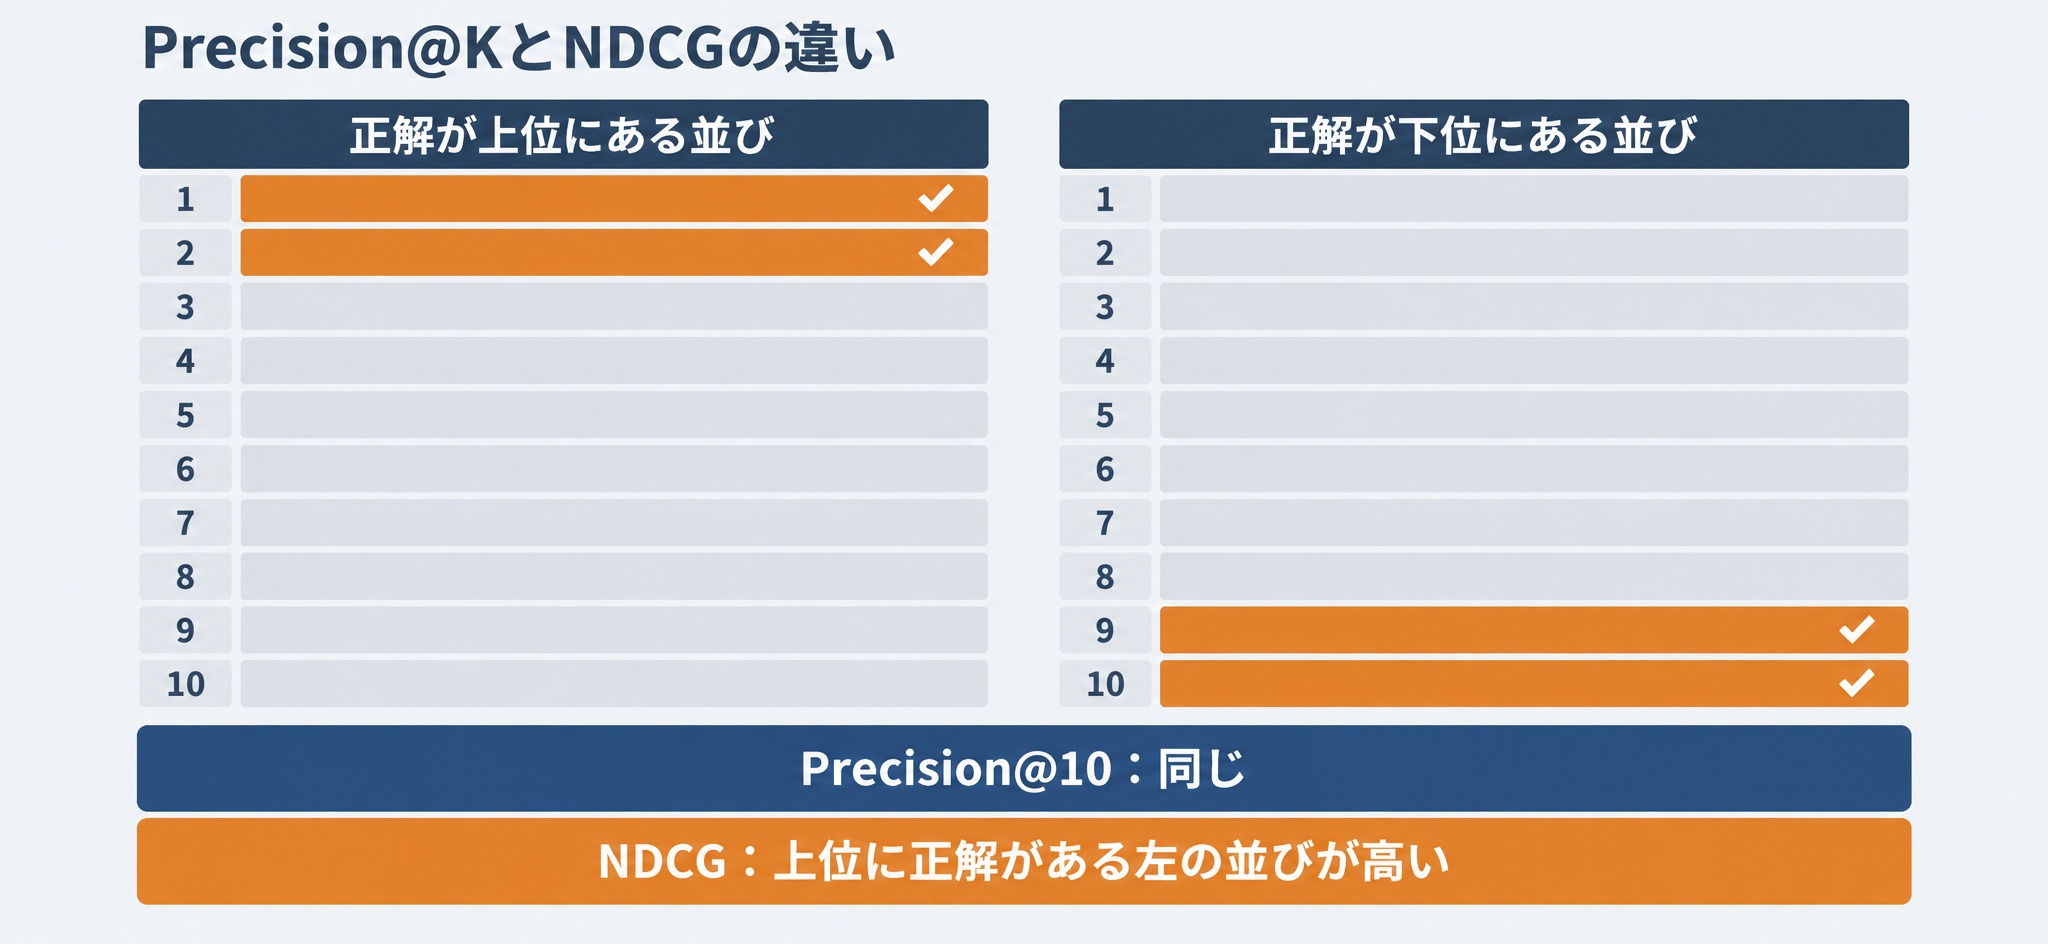
Precision@Kは、正解が1位にあっても10位にあっても同じに数えます。ところが画面では、上にある商品ほど見られます。
NDCG(Normalized Discounted Cumulative Gain)は、正解の順位が下がるほど得点を割り引いて合計し、理想の並び方での得点で割った指標です。0から1の値を取り、1が理想の並びです。考え方の原典は Järvelin & Kekäläinen (2002) で(Cumulated gain-based evaluation of IR techniques)、scikit-learnにも ndcg_score として実装されています(scikit-learn ndcg_score)。今回の実測では、割り引きに順位の対数を使う同じ定義を、正解か否かの2値で自前に書きました。
NDCGやRecall@Kは、RAG(検索拡張生成)で検索部分の精度を測るときにも使われる指標です。RAGの評価についてはRagasを使ったRAGの評価の記事で扱っています。
精度だけでは足りない。カバレッジ・多様性・新しさ
精度の指標だけを追うと、前の節の人気順のように、少数の売れ筋ばかりを出す推薦を見落とします。精度と並べて見ておきたい指標は次のとおりです。
- カバレッジ:推薦に一度でも出た商品が、カタログ全体の何%か。今回は人気順1.9%、協調フィルタリング24.4%、コンテンツベース50.7%でした
- 多様性:1人に出した推薦リストの中で、商品がどれだけ互いに異なるか
- 新しさ:人気の低い商品や、利用者が知らなかった商品をどれだけ出せたか
これらは精度とトレードオフになりやすい指標です。どこまで精度を譲ってよいかは、品ぞろえの広さを売りにするのか、売れ筋を確実に売りたいのか、という事業の方針で決まります。
オフライン評価で候補を絞り、A/Bテストで決める
ここまでの指標は、過去のログで測るオフライン評価の指標です。オフラインの評価で良かった方式が、実際に画面に出したときにクリックや購買を増やすとは限りません。過去のログは過去の推薦の影響を受けているからです。
そのため実務では、オフライン評価で候補を絞り、最後はA/Bテストで決めるという2段で進めます。LINEヤフーは、Yahoo!ショッピングのランキングモデルを、協調フィルタリングと商品名をBERTでスコア化するコンテンツベースを組み合わせたハイブリッド型に変えた際、オフラインでNDCG@10が1.4%、NDCG@20が2.8%改善し、オンラインのA/BテストでCTRが1.5%、CVRが2.1%改善したと公表しています(LINEヤフー Tech Blog)。オフラインの指標とオンラインの事業指標を並べて報告している例です。
ここまでレコメンドの評価指標を見てきましたが、「アルゴリズムを入れ替えて比べる評価の枠組みを、自分の案件で一から組めるか不安」という方も多いと思います。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座 Advanced は、Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムです。RAGの検索基盤の評価や、評価とLLM-as-a-Judgeを扱い、本記事で行った「評価データを先に作り、条件を変えて数値で比べる」進め方を、毎週の実装課題と現役データサイエンティストのコードレビューを通じて身につけられます。
まずは講座の内容を確認してみてください。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
レコメンドの課題。コールドスタート・人気への偏り・フィードバックループ
評価指標の平均だけでは見えない弱点があります。ここでは、レコメンドを実際に運用すると起きる課題を、実測の続きで確かめます。
履歴の無い顧客と、まだ売れていない商品
コールドスタートとは、行動履歴の無い新しい顧客や新しい商品に対して、推薦を作れない、または精度が落ちる問題です。Schein et al. (2002) は、コミュニティの誰もまだ評価していない商品を推薦したい場面を、コールドスタート問題として扱っています(Methods and Metrics for Cold-Start Recommendations)。
実測のデータで、顧客と商品の両方の側から確かめます。
# ===== 5. 履歴の無い顧客と、まだ売れていない商品 =====
new_users = sorted(set(test_items.index) - set(train_items.index))   # 評価期間に初めて買った顧客
top_pop = list(items[np.argsort(-popularity)[:K]])
rel = [len(set(top_pop) & test_items[u]) for u in new_users]
print(f"履歴ゼロの新規顧客 {len(new_users):,}人:人気順トップ10の P@10={np.mean(rel) / K:.4f}"
      "(協調フィルタリングとコンテンツベースは入力が無く推薦を作れない)")
hits_new = sum(len(set(rec_content(u)) & truth[u] & new_items) for u in eval_users)
print(f"学習期間に売れていない商品の的中数:コンテンツベース {hits_new}件、協調フィルタリングと人気順は0件(候補に上がらない)")
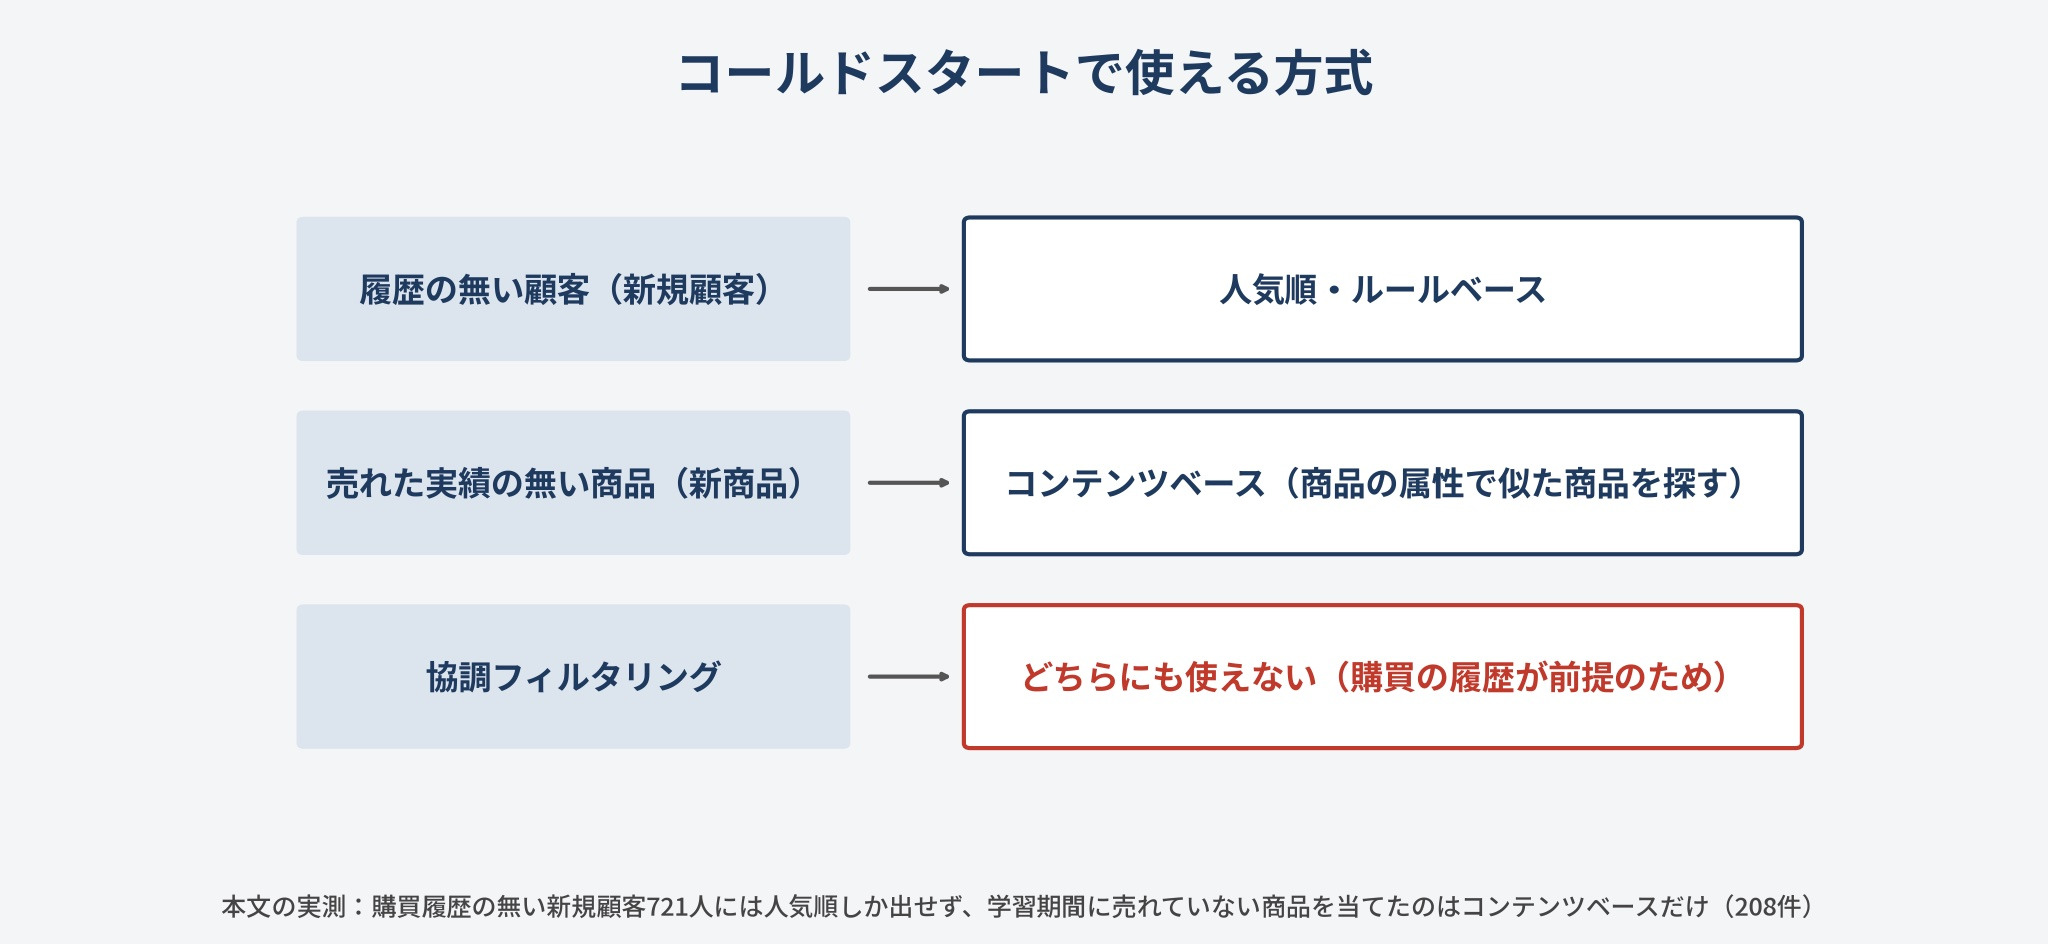
履歴ゼロの新規顧客 721人:人気順トップ10の P@10=0.0691(協調フィルタリングとコンテンツベースは入力が無く推薦を作れない)
学習期間に売れていない商品の的中数:コンテンツベース 208件、協調フィルタリングと人気順は0件(候補に上がらない)評価期間に初めて買い物をした顧客は721人いました。この人たちには購買履歴が無いので、協調フィルタリングもコンテンツベースも推薦を作れず、出せるのは人気順だけです。人気順のトップ10は、この721人に対してPrecision@10が0.0691でした。新規顧客の正解には繰り返し買う商品も含まれるため、既存顧客の数値とは直接比べられませんが、人気順が新規顧客への最初の推薦として機能していることは分かります。
商品の側では、学習期間に一度も売れていない商品を当てられたのはコンテンツベースだけで、208件でした。協調フィルタリングと人気順は、売れた実績の無い商品を候補にすら上げません。前の節の出力で両者の「新商品を含む割合」が0.0%だったのは、このためです。
履歴が少ない顧客では、どの方式が効くか
では、履歴はあるものの少ない顧客では、どの方式が当たるのでしょうか?学習期間に買った商品の数で顧客を4つに分け、NDCG@10を比べました。
# ===== 4. 購買履歴の少ない顧客ではどうなるか(コールドスタートに近い条件) =====
n_hist = np.array([len(train_items[u]) for u in eval_users])
bins = [(1, 9), (10, 29), (30, 99), (100, 10_000)]
for lo, hi in bins:
    m = (n_hist >= lo) & (n_hist <= hi)
    line = "  ".join(f"{name}={results[name][2][m].mean():.4f}" for name in methods)
    print(f"学習期間の購買商品数 {lo}〜{hi if hi < 10_000 else ''}点({m.sum():,}人) NDCG@10: {line}")
学習期間の購買商品数 1〜9点(138人) NDCG@10: ランダム=0.0052 人気順=0.0404 コンテンツベース=0.0641 協調フィルタリング=0.0797
学習期間の購買商品数 10〜29点(440人) NDCG@10: ランダム=0.0032 人気順=0.0390 コンテンツベース=0.0660 協調フィルタリング=0.0836
学習期間の購買商品数 30〜99点(804人) NDCG@10: ランダム=0.0078 人気順=0.0428 コンテンツベース=0.0777 協調フィルタリング=0.0814
学習期間の購買商品数 100〜点(386人) NDCG@10: ランダム=0.0145 人気順=0.0506 コンテンツベース=0.1029 協調フィルタリング=0.0949購買商品が1〜9点の138人でも、協調フィルタリングのNDCG@10は0.0797で、人気順の0.0404を上回りました。このデータでは、履歴が数点あれば、個人に合わせた推薦のほうが人気順より当たっています。
逆に、100点以上を買っている386人では、コンテンツベースが0.1029で協調フィルタリングの0.0949を上回りました。同じデータの中でも、顧客の履歴の量によって有利な方式が入れ替わるということです。1つの方式を全員に当てはめるより、顧客の状態で方式を切り替える、あるいは組み合わせるハイブリッド型に意味がある理由がここにあります。
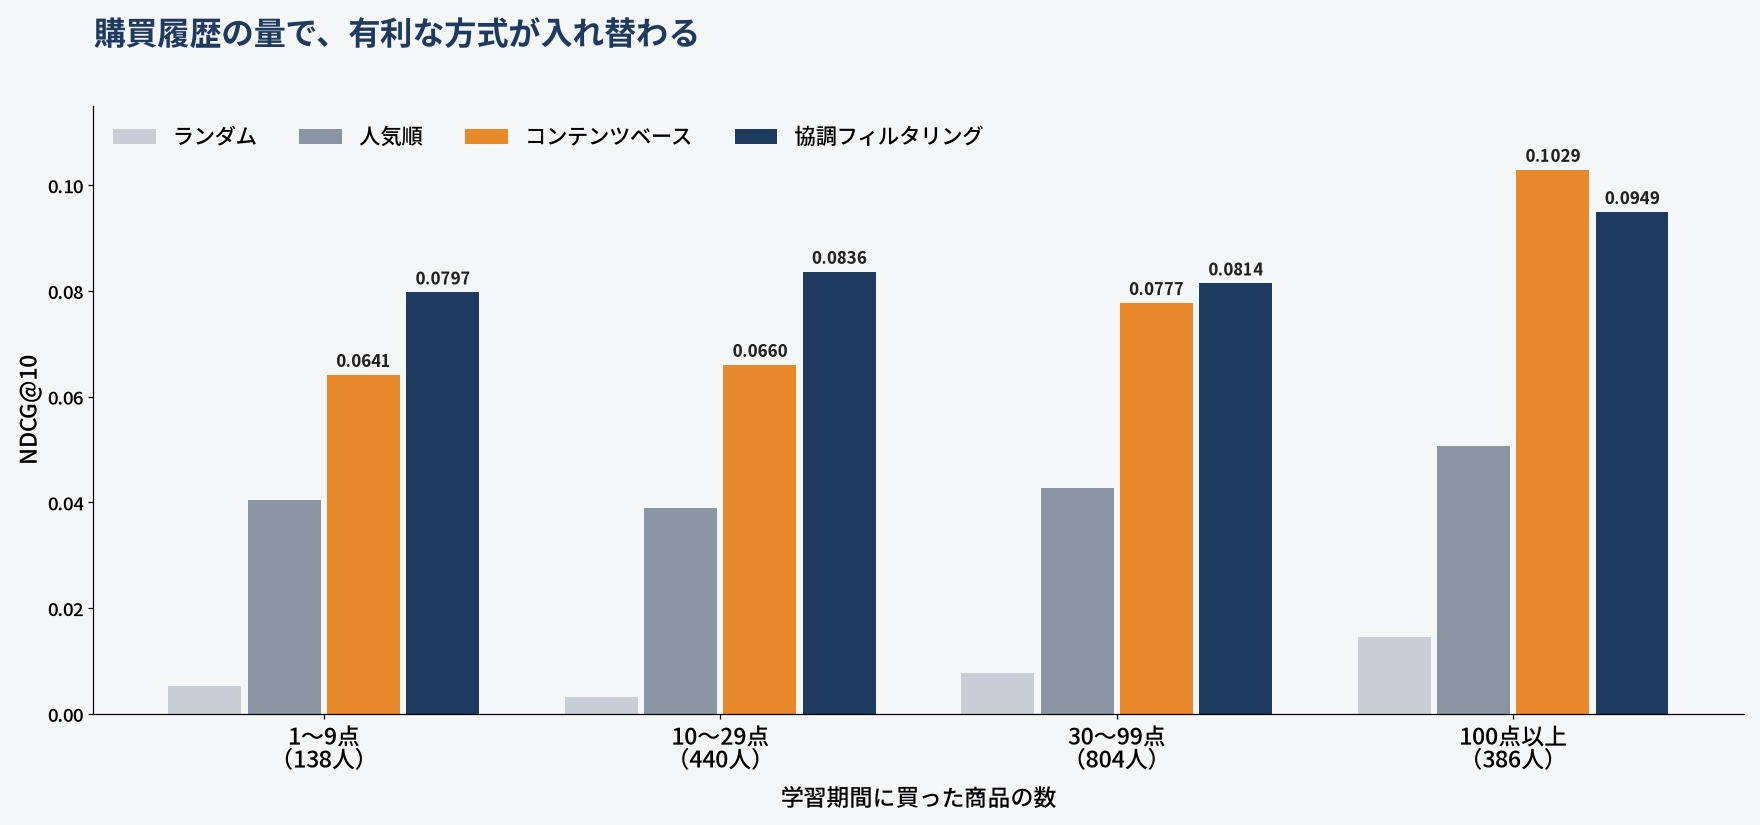
各区分の人数は138人から804人で、ブートストラップで区間を取ってはいません。区分ごとの差は、傾向として読んでください。
人気の商品に推薦が偏り、偏りが学習データに戻る
コールドスタートのほかにも、レコメンドには運用して初めて見える課題があります。
1つは人気への偏りです。実測で人気順が69点しか出さなかったように、行動データに頼る方式は、すでに売れている商品を多く推薦しがちです。
もう1つは、偏りが自分自身を強めるフィードバックループです。推薦された商品が買われ、その購買が次の学習データになり、さらに同じ商品が推薦されます。Jiang et al. (2019) は、推薦が利用者の好みを変え、それが学習データに戻ることで、エコーチェンバーやフィルターバブルが生じる仕組みを理論的に分析しています(Degenerate Feedback Loops in Recommender Systems)。フィルターバブルとは、利用者が自分の好みに合う情報だけに囲まれ、それ以外の情報に触れにくくなる状態のことです。
課題への対策を試す順番
ここまでの実測と課題を踏まえると、対策は次の順番で試すと手戻りが少なくなります。
- 人気順とルールベースを土台に置く:履歴ゼロの顧客への推薦と、他方式が候補を返せないときの補完に使います。すべての比較の基準線にもなります
- 商品データを整えてコンテンツベースを足す:商品名・カテゴリ・説明文を整えると、売れた実績の無い新商品を出せるようになります。今回は商品名だけで208件の新商品を当てました
- 行動データが溜まった顧客に協調フィルタリングや行列分解を使う:履歴の量で方式を切り替えるか、スコアを混ぜるハイブリッド型にします。その後に深層学習や系列モデルを検討します
- カバレッジを監視し、探索の枠を残す:推薦枠の一部に、新商品や推薦の少ない商品を意図して出す枠を設けると、フィードバックループで品ぞろえが狭まるのを防げます
レコメンドエンジンの選び方。自作・クラウド・国内SaaS
課題と対策の順番が見えたところで、レコメンドエンジンを自作するか、製品を使うかを決めます。選択肢は大きく、オープンソースのライブラリを使った自作、クラウドのマネージドサービス、国内のレコメンドSaaSの3つです。料金と機能は2026年9月時点の公式ページで確認しました。
| 選択肢 | 例と料金体系(2026年9月時点) | 向いている条件 |
|---|---|---|
| 自作(オープンソース) | implicit・RecBole・Microsoft Recommenders(いずれもMITライセンス)。ライセンス費用は無く、開発と運用の人件費と計算資源が主な費用 | データサイエンティストが社内にいる。評価の枠組みも自分たちで持ちたい |
| クラウドのマネージドサービス | Amazon Personalize:Transformerベースのv2レシピで学習が1,000インタラクションあたり0.002ドル、推論が1,000リクエストあたり0.15ドル(最初の2か月は無料枠あり)。Google Cloud AI Commerce Search(旧 Vertex AI Search for commerce):推薦の予測が1,000件あたり0.27ドル(月2,000万件まで)、学習とチューニングが1ノード時間あたり2.50ドル | すでにそのクラウドを使っている。行動データの取り込みとAPI連携を自社で組める |
| 国内のレコメンドSaaS | シルバーエッグ・テクノロジー「アイジェント・レコメンダー」:成果報酬型とリクエスト従量型、最低月額5万円からのプランあり。ブレインパッド「Rtoaster action+」:月額50万円から。DGビジネステクノロジー「NaviPlusレコメンド」:料金は公式ページに記載なし | ECサイトに短期間で入れたい。運用の支援や画面の部品まで含めて任せたい |
出典はAmazon Personalize の料金、Google Cloud AI Commerce Search の料金、アイジェント・レコメンダー、Rtoaster の料金、NaviPlusレコメンドです。
この表から読み取れるのは、費用の構造が選択肢ごとに違う点です。クラウドは学習と推論の量に比例し、国内SaaSは月額の下限があり、自作は人件費が中心になります。なお、MicrosoftのAzure AI Personalizerは2026年8月25日に廃止されており、公式ドキュメントはオープンソースの microsoft/learning-loop への移行を案内しています(Azure AI Personalizer)。
国内SaaSでもLLMを使う機能が出始めています。NaviPlusレコメンドは、行動履歴の無い新着商品にも対応するLLMレコメンドの提供を2025年9月に始めたと発表しました(DGビジネステクノロジーのお知らせ)。
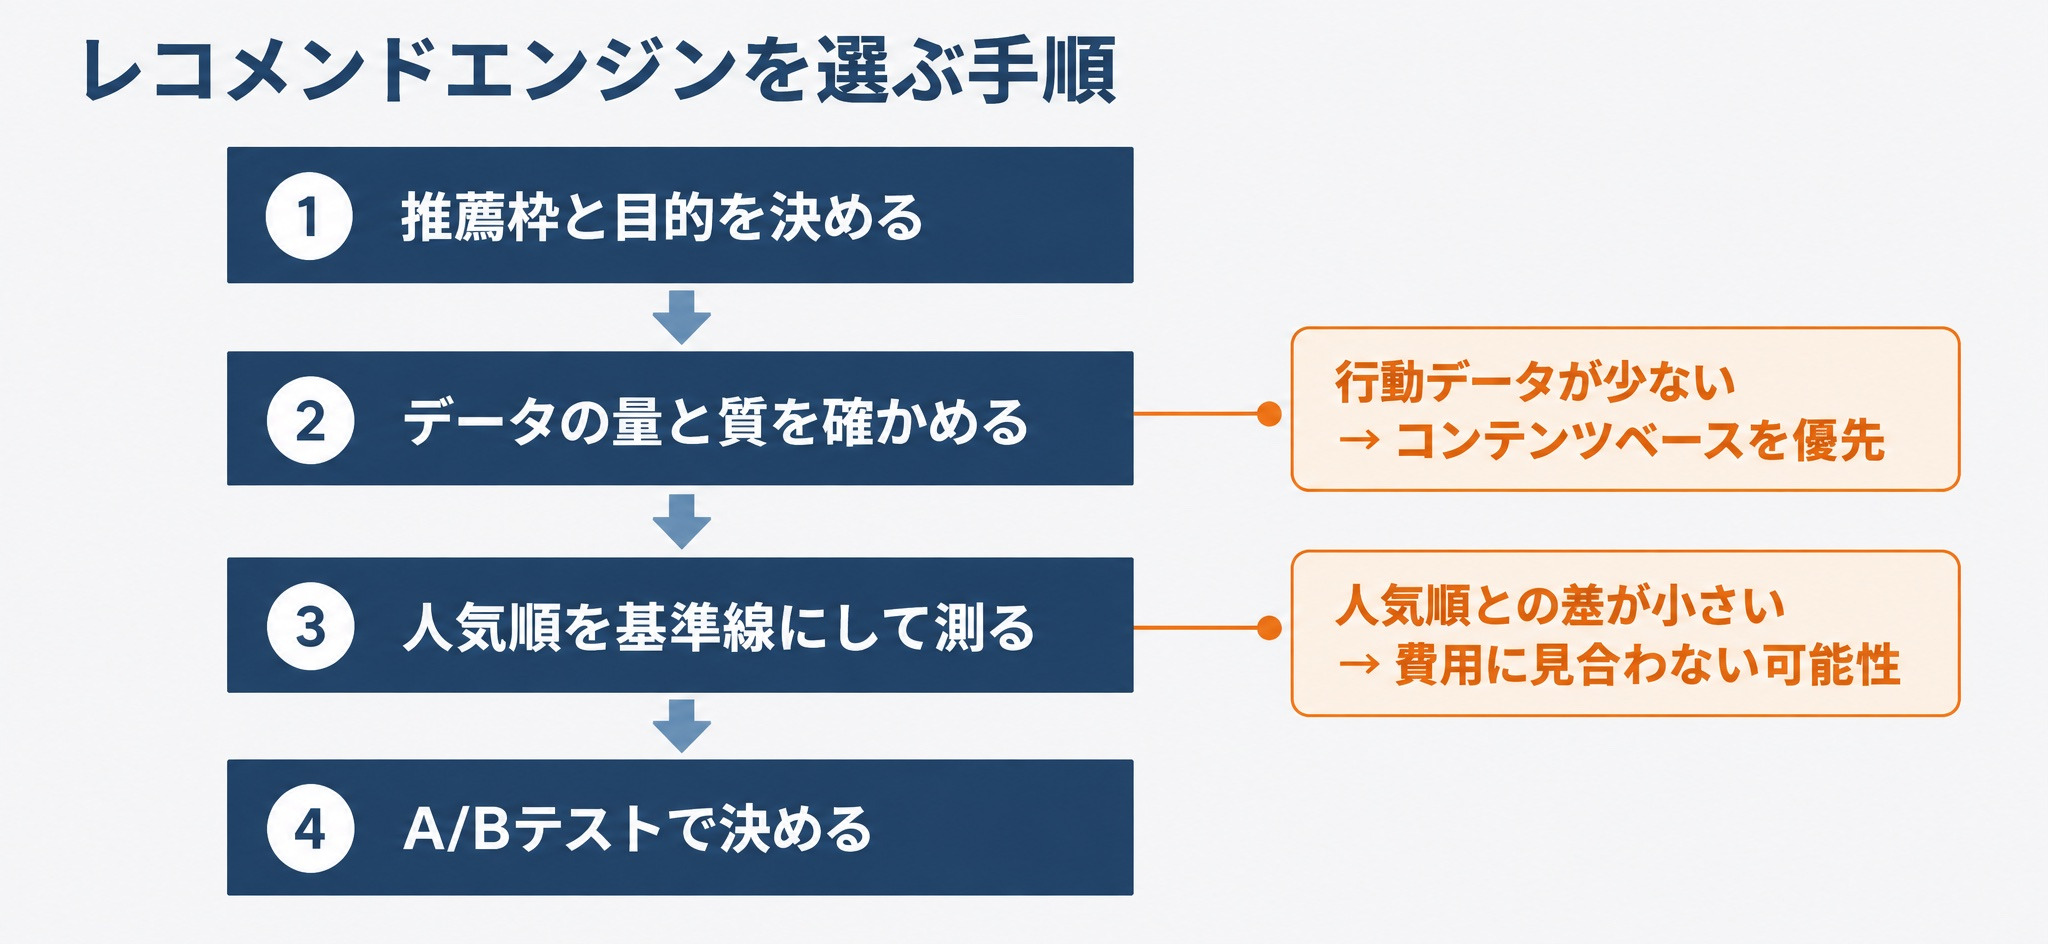
レコメンドエンジンを選ぶ手順
選択肢を比べる前に、自社側の条件を先に固めます。
- 推薦枠と目的を決める:トップ画面・商品詳細・カート・メールのどこに出し、クリック・購買・回遊のどれを増やしたいかを決めます。目的によって評価指標が変わります
- データの量と質を確かめる:行動ログの件数、顧客IDで行動をつなげられるか、商品名や説明文が整っているかを確認します。行動データが少なく商品データが整っているなら、コンテンツベースが強い製品や構成を優先します
- 評価データを作り、人気順を基準線にして測る:本記事の実測のように、過去のログを期間で分けて評価データを作ります。人気順との差が小さい方式や製品は、費用に見合わない可能性があります
- A/Bテストで決める:オフラインの評価で2〜3の候補に絞り、実際の画面で比べます。製品を選ぶ場合も、試用期間にこの比較ができるかを確認します
手順3と4は、小さく試して効果を確かめるPoC(概念実証)の進め方と同じです。PoCの進め方はAIのPoCを解説した記事で扱っています。
レコメンドの公表事例。Netflix・Amazon・メルカリ・LINEヤフー・ZOZO
最後に、企業が一次情報として公表しているレコメンドの成果を確認します。うまくいった数値だけでなく、大きな効果が出なかった数値も載せています。
- Netflix:Gomez-Uribe & Hunt (2015) は、同社のレコメンドがホーム画面以外の多くの画面で使われ、視聴時間の約80%で作品選びに影響していると書いています。パーソナライズとレコメンドの効果で解約率を数ポイント下げ、年10億ドル超を節約できていると同社は考えている、とも述べています(The Netflix Recommender System)。10億ドルは同社自身の推定です
- Amazon:2003年に発表したアイテムベースの協調フィルタリングの論文は、2017年に IEEE Internet Computing から、長く影響を与えた論文として選ばれました(Amazon Science)
- メルカリ:協調フィルタリング(Pythonのimplicitライブラリ)とニューラルネットワーク、ベクトル検索を組み合わせた商品推薦で、A/Bテストの結果、「この商品を見ている人におすすめ」のタップ率が3倍、同じ枠からの購入が20%増えたと公表しています(メルカリ エンジニアリングブログ)
- LINEヤフー:前述のとおり、Yahoo!ショッピングでハイブリッド型に変更し、NDCG@10が1.4%、CVRが2.1%改善しました(LINEヤフー Tech Blog)
- ZOZO:ZOZOTOWNのホーム画面で、表示する枠の並び順をTwo-Towerモデルでパーソナライズし、約1か月のA/Bテストを行いました。対照群に対して、表示回数が105.2%、クリック数が103.2%だった一方、受注金額は100.1%で、受注の指標には大きな改善は無かったと同社自身が書いています(ZOZO TECH BLOG)
ZOZOの例が示すように、クリックが増えても購買まで伸びるとは限りません。どの指標で成功を判断するかを、A/Bテストの前に決めておくことが、レコメンドの効果を正しく測る条件になります。
レコメンドの要点のまとめ
- レコメンドとは、行動履歴や属性をもとに、その人に合う候補を選んで提示する仕組み。英語の recommend(勧める・推薦する)から来た言葉で、画面の枠がレコメンド機能、計算の部品がレコメンドエンジン、全体がレコメンドシステム
- 大規模なレコメンドエンジンは、候補生成で数百件に絞り、ランキングで並べ替える2段構成で動く
- アルゴリズムは6系統。ルールベース・コンテンツベース・協調フィルタリング・行列分解・深層学習と系列モデル・LLMを使った推薦。苦手なことの多くは、どのデータを使うかで決まる
- 公開購買データの実測では、NDCG@10は協調フィルタリング0.0848、コンテンツベース0.0792、人気順0.0433。協調フィルタリングとコンテンツベースの差は95%区間が0をまたぎ、言い切れなかった
- 精度より大きな差が出たのはカバレッジ。人気順は69点(1.9%)しか推薦に出さず、コンテンツベースは1,854点(50.7%)を出した
- コールドスタートには方式ごとに向き不向きがある。履歴ゼロの顧客721人に出せるのは人気順だけで、売れた実績の無い商品を当てたのはコンテンツベースだけ(208件)だった
- 選ぶときは、推薦枠と目的、データの量と質を先に固め、人気順を基準線にして測り、最後はA/Bテストで決める
レコメンドの設計と評価を体系的に学ぶなら「Craft College」へ
本記事で行ったのは、方式を同じ条件で並べ、評価データと指標を先に決めてから数値で選ぶという作業でした。実務でこの次に来るのは、この比較を一度で終わらせず、データや方式が変わるたびに測り直せる仕組みにすることです。
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced を提供しています。Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムで、LLMアプリケーションの設計、コンテキストエンジニアリング、RAG、マルチモーダルAI、評価とLLM-as-a-Judge、AIエージェントとマルチエージェント、LLMセキュリティ、ローカルLLM、ファインチューニング、卒業制作までを扱います。既製のフレームワークに寄せず、生のAPIと自作のコードで骨格を実装するのが方針です。毎週の実装課題には現役データサイエンティストのコードレビューが付き、少人数のコホートで進みます。
機械学習の基礎から始めたい方には、9ヶ月36週のデータサイエンティスト養成講座があります。AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に進む構成です。経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座で、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。支給の可否は最終的にハローワーク等が判断します。
リベルクラフトでは、AI開発・データサイエンス開発の支援も行っています。購買や閲覧のログを使った推薦の設計、評価データの作り方、自作か製品かの判断まで、要件定義からPoC、本番運用までを一貫して支援しています。自社のデータで何から試すかを決める段階からご相談いただけます。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
⇨AI開発・データサイエンス開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。