確率分布とは。確率分布表の求め方から正規分布の確率密度関数までPythonで解説
統計の勉強を始めて「確率分布」でつまずいた、という方も多いでしょう。調べると確率測度の定義や、20を超える分布名の一覧が出てきます。どれを覚えればよいのか、データ分析の仕事で何に使うのかが見えないまま、正規分布の式の前で手が止まってしまいます。
しかし、確率分布は暗記する数式ではありません。データがどんな値を、どのくらいの確率でとるのかを書き表す道具です。表を1枚作れるようになれば、あとは同じ考え方の延長で読めます。
そこで本記事では、
- 確率分布とは何か。離散型と連続型、確率質量関数と確率密度関数の違い
- 確率分布表の読み方と、自分で作る求め方の4ステップ
- 代表的な6つの確率分布と、データ分析の実務で出会う場面
- 正規分布の確率密度関数の読み方と、Pythonのscipy.statsで確かめる方法
についてわかりやすく解説します。データ職を目指して統計を学び始めた方は、ぜひ最後までご覧ください。
掲載するコードは2026年9月23日に実際に実行し、出力を確認したものです。実行環境は Apple M1 Pro、Python 3.13.13、NumPy 2.5.3、SciPy 1.18.1 です。乱数を使うコードはシードを0に固定し、データはすべてコードの中で生成しています。
「統計の基礎を、データ分析の仕事で使える形で身につけたい」という方は、リベルクラフトへご相談ください。
⇨Craft Collegeへの無料相談はこちら
確率分布とは。確率変数がとる値と確率の対応
確率分布とは、確率変数がとりうる値と、それぞれの値が出る確率との対応を表したものです。表で書くことも、式で書くことも、グラフで描くこともできます。どの書き方でも、中身は「どの値が、どのくらい出やすいか」という情報です。
この定義には「確率変数」という言葉が入っています。まずはここから確認します。
確率変数とは
確率変数とは、試行の結果によって値が決まる変数を指します。試行は、結果が偶然に左右される実験や観測のことです。
例えば、サイコロを1回投げて出る目は、1から6のどれかになる確率変数です。業務のデータでも同じ見方ができます。あるECサイトで、訪問者が購入するかどうかを「購入=1、購入しない=0」と表せば、これも確率変数です。明日の問い合わせ件数や、ある作業にかかる時間も、実際に観測するまでは値が決まらない確率変数として扱えます。
確率変数は大文字の X で、実際に出た値は小文字の x で書くのが慣例です。「X が 3 になる確率」は P(X=3) と表します。
離散型と連続型。確率質量関数と確率密度関数の違い
確率変数は、とる値の種類によって2つに分かれます。
- 離散型:0件、1件、2件のように、とびとびの値をとる。購入した人数、問い合わせ件数など
- 連続型:170.3cm、170.31cmのように、区間の中のどんな実数もとりうる。身長、処理時間、気温など
離散型の確率分布は、値ごとの確率 P(X=x) を返す関数で表します。この関数を確率質量関数(確率関数)と呼びます。とりうる値すべての確率を足すと1になります。
連続型では、1点の確率を考えても意味がありません。処理時間がちょうど30.000…分になる確率は0だからです。そこで、値の出やすさを表す曲線 f(x) を使い、X が a から b の間に入る確率を、曲線の下の面積で表します。この f(x) を確率密度関数と呼び、曲線の下の面積は全体で1になります。
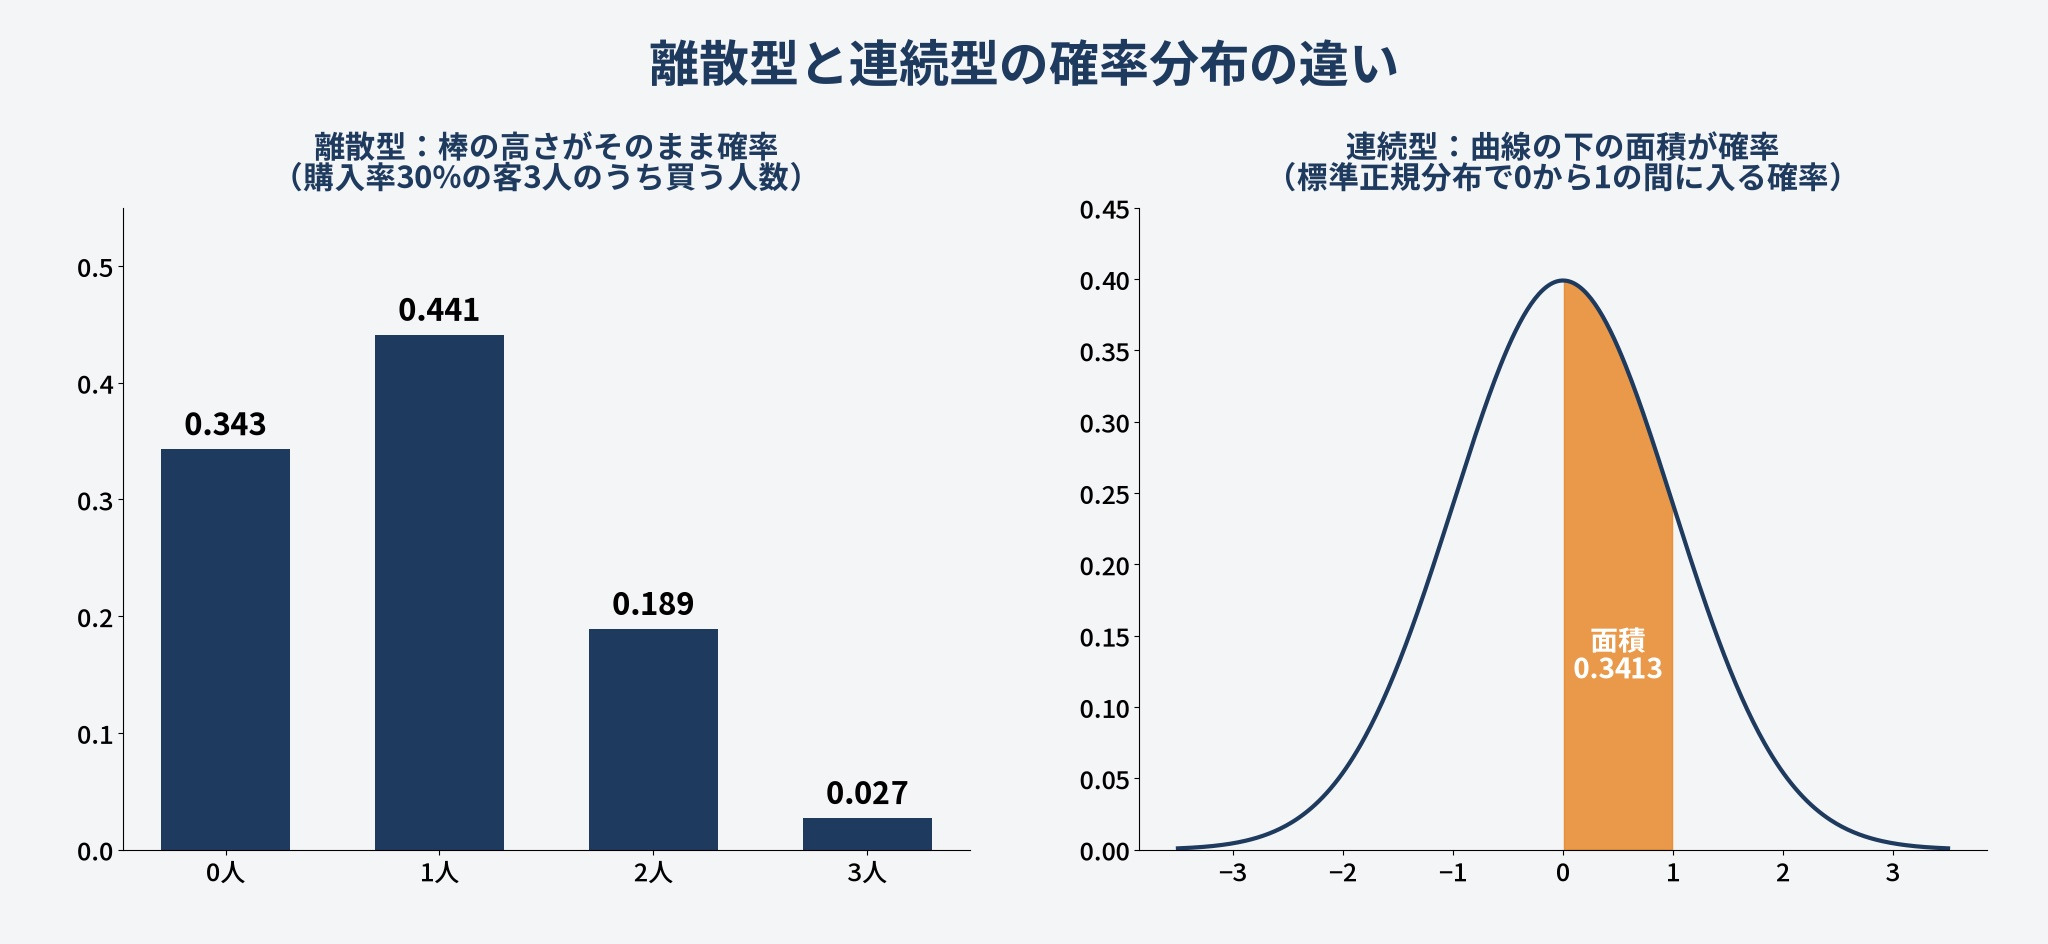
どちらの型にも共通して使うのが累積分布関数(分布関数)です。X が x 以下になる確率 P(X≦x) を返す関数で、あとで出てくるPythonの cdf がこれにあたります。
以上の定義は、東北大学の講義資料「統計学入門 ~確率変数と確率分布~」(石垣司、2025年度)と、金沢工業大学の数学教材「確率分布(確率関数,確率密度関数)」に沿っています。
確率分布を要約する期待値と分散
確率分布の形を数値で短く伝えるときは、期待値と分散を使います。
期待値 E[X] は、確率分布の中心の位置です。離散型なら「値×その確率」をすべて足して求めます。何度も繰り返したときの平均的な値と考えてください。
分散 V[X] は、期待値からのずれの大きさです。「(値−期待値)の2乗×その確率」をすべて足して求めます。V[X]=E[X²]−(E[X])² と書き直せることも覚えておくと、手計算が楽になります。分散の平方根が標準偏差で、記号は σ(シグマ)を使います。
連続型では、足し算の代わりに確率密度関数を使った積分で同じ量を求めます。定義は東北大学の講義資料「統計学入門 ~期待値~」を参照してください。
確率分布表の読み方と、確率分布の求め方
ここまで確率分布の定義を確認しました。次は、離散型の確率分布を表にした「確率分布表」を、実際に読んで作ってみます。
確率分布表の読み方
確率分布表は、上の行に確率変数がとる値、下の行にその値が出る確率を並べた表です。例として、購入率が30%の顧客3人に商品を案内したとき、購入する人数 X の確率分布表を示します。3人はそれぞれ独立に購入を判断するものとします。
| 購入する人数 X | 0人 | 1人 | 2人 | 3人 | 合計 |
|---|---|---|---|---|---|
| 確率 P(X=x) | 0.343 | 0.441 | 0.189 | 0.027 | 1 |
この表からは、3人とも購入しない確率が34.3%、ちょうど1人が購入する確率が44.1%だと読めます。「2人以上が購入する確率」のような区間の確率は、該当する列を足して 0.189+0.027=0.216 と求めます。確率の行の合計は1になります。1にならない表は、どこかで数え漏れか計算の誤りがあります。
確率分布の求め方。表を作る4ステップ
上の表は、次の4ステップで作りました。サイコロでも購入データでも、手順は同じです。
- 確率変数がとる値をすべて書き出す。3人のうち購入する人数なので、0・1・2・3の4通りです
- それぞれの値になる確率を求める。3人の「購入する・しない」の組み合わせは2×2×2=8通りあります。例えば1人だけが購入するのは3通りで、どれも確率は 0.3×0.7×0.7=0.147 です。したがって P(X=1)=3×0.147=0.441 になります
- 確率の合計が1になるかを確かめる。0.343+0.441+0.189+0.027=1 です
- 期待値と分散を計算する。期待値は 0×0.343+1×0.441+2×0.189+3×0.027=0.9人です。分散は、各値と0.9との差を2乗して確率を掛けて足し、0.63になります
ステップ2で「組み合わせの数×1通りの確率」という形が出てきました。この形には名前がついていて、次の章で扱う二項分布の確率質量関数そのものです。確率分布の求め方の基本は、全パターンを数え上げることです。代表的な分布の式は、その数え上げを公式にまとめたものと考えると、式の意味が追いやすくなります。
データから作る相対度数の表との違い
確率分布表と形がよく似たものに、観測データから作る相対度数の表があります。例えば、過去100日分の「1日に購入した人数」を数え、日数を100で割った表です。
2つは役割が違います。確率分布表は「購入率30%で3人が独立に判断する」という仮定から計算した、いわばモデルです。相対度数の表は、実際に起きたことの記録です。仮定がデータに合っていれば、観測する回数を増やすほど相対度数は確率分布表の値に近づきます。この様子は、後半のPythonのシミュレーションで確かめます。
代表的な確率分布6つと、データ分析の実務で出会う場面
確率分布表を自分で作れるようになりました。実務では、毎回数え上げなくても済むように、よく出てくる形に名前と式がついています。データ分析の入門で押さえたい6つを一覧にしました。
| 確率分布 | 型 | パラメータ | 期待値 | 分散 | 実務で出会う場面 |
|---|---|---|---|---|---|
| ベルヌーイ分布 | 離散 | 成功確率 p | p | p(1−p) | 1人の訪問者が購入するかどうか |
| 二項分布 | 離散 | 試行回数 n、成功確率 p | np | np(1−p) | 1,000人のうち購入した人数、検品した100個のうちの不良品数 |
| ポアソン分布 | 離散 | 単位時間あたりの平均回数 λ | λ | λ | 1時間あたりの問い合わせ件数、1日のシステム障害件数 |
| 一様分布(連続) | 連続 | 区間の下端 a、上端 b | (a+b)/2 | (b−a)²/12 | 乱数の生成、ランダムな割り付け |
| 指数分布 | 連続 | 単位時間あたりの平均回数 λ | 1/λ | 1/λ² | 次の問い合わせまでの待ち時間 |
| 正規分布 | 連続 | 平均 μ、分散 σ² | μ | σ² | 測定値のばらつき、多数のデータの平均値 |
表から読み取れるのは、どの分布も1つか2つのパラメータで形が決まるということです。パラメータとは、分布の形を決める数値のことです。データを見て「どの分布に近いか」を決めたら、あとはパラメータを推定すれば確率を計算できます。各分布の式は、東北大学の講義資料「統計学入門 ~代表的な確率分布~」で確認できます。
ベルヌーイ分布と二項分布。購入した人数
ベルヌーイ分布は、結果が「成功=1」か「失敗=0」の2通りしかない1回の試行を表します。確率質量関数は P(X=x)=p^x (1−p)^(1−x)(x は0か1)です。Webサイトのコンバージョン、メールの開封、製品の合否など、データ分析で扱う「はい・いいえ」のデータの多くがこれにあたります。
二項分布は、ベルヌーイ試行を n 回独立に繰り返したときの成功回数の分布です。確率質量関数は P(X=k)=nCk p^k (1−p)^(n−k) です。nCk は n 個から k 個を選ぶ組み合わせの数を表します。先ほどの確率分布表は、n=3、p=0.3 の二項分布でした。購入率を比べるABテストの集計も、この分布が土台になります。
ポアソン分布。一定時間に起きた件数
ポアソン分布は、一定の時間や範囲の中で、まれに起きる出来事の回数を表します。確率質量関数は P(X=k)=λ^k e^(−λ) / k! です。λ(ラムダ)は単位時間あたりの平均回数、e は自然対数の底(約2.718)、k! は1から k までの積です。
期待値と分散がどちらも λ になるのが特徴です。コールセンターへの1時間あたりの問い合わせ件数、1日あたりのシステム障害件数など、件数を数えるデータで最初に試す分布です。講義資料でも注意されているとおり、λ は「1時間あたり」「1日あたり」のように単位時間とセットで決まるため、単位を取り違えると結果が変わります。
一様分布。どの値も同じ出やすさ
一様分布は、ある範囲の中のどの値も同じ出やすさになる分布です。離散型ならサイコロの目、連続型なら区間 a から b の確率密度関数が 1/(b−a) で一定になる分布です。
実務でそのまま観測データに当てはめる場面は多くありません。一方で、乱数を作る土台として頻繁に使います。例えば訪問者をランダムに2群へ振り分ける処理は、0から1の一様乱数を1つ引き、0.5未満ならA群、それ以外ならB群とする形で書けます。
指数分布。次の出来事までの待ち時間
指数分布は、ポアソン分布に従う出来事が次に起きるまでの待ち時間を表す連続型の分布です。確率密度関数は f(x)=λe^(−λx)(x≧0)で、期待値は 1/λ です。1時間に平均3件の問い合わせが来るなら、次の問い合わせまでの平均の待ち時間は1/3時間、つまり20分になります。
ポアソン分布が「一定時間に何回起きるか」、指数分布が「次に起きるまでどれだけ待つか」を表す、表裏の関係です。窓口の人員配置や、サーバーの処理待ちの見積もりで使われます。
正規分布。測定値のばらつきと平均の分布
正規分布は、平均を中心に左右対称な、釣り鐘の形をした連続型の分布です。測定誤差や、多くの要因が少しずつ足し合わさってできる値のばらつきをよく表します。
データ分析で正規分布が特別に扱われる理由は、中心極限定理にあります。元のデータがどんな分布でも、たくさんのデータの平均値は正規分布に近づくという定理です。仮説検定や信頼区間の多くは、この性質の上に組み立てられています。検定で使う t分布・カイ二乗分布・F分布も、正規分布から導かれる分布です。
正規分布の確率密度関数。式の読み方と標準化
代表的な6つの分布を見てきました。ここからは、データ分析で最もよく使う正規分布を、確率密度関数の式から読んでいきます。
正規分布の確率密度関数の式
平均 μ(ミュー)、分散 σ² の正規分布の確率密度関数は、次の式で表されます。
f(x)=1/√(2πσ²) × exp(−(x−μ)²/(2σ²))
記号の意味は次のとおりです。
- x:確率変数がとる値
- μ:平均。分布の中心の位置を決める
- σ²:分散。σ は標準偏差で、分布の横への広がりを決める
- exp(…):自然対数の底 e の「…」乗
- π:円周率
この分布を N(μ, σ²) と書き、特に N(0, 1) を標準正規分布と呼びます。定義は広島大学の講義スライド「確率統計基礎講義A」(若木宏文、2019年)と同じ形です。
式の読み方は、exp の中に注目すると分かります。(x−μ)² は x が平均から離れるほど大きくなり、先頭にマイナスがついているので、exp の値は x が μ のときに最大になり、離れるほど0に近づきます。そのため曲線は μ で一番高くなり、左右対称に下がっていきます。σ が大きいほど下がり方がゆるやかになり、平たい形になります。先頭の 1/√(2πσ²) は、曲線の下の面積をちょうど1にそろえるための係数です。
確率密度は確率ではない
確率密度関数の値 f(x) は、その点での確率ではありません。連続型では1点の確率は0で、確率になるのは区間の面積だけです。
このことは数値で確かめると納得できます。後のPythonの実行結果では、標準正規分布の頂上の高さは0.3989でした。標準偏差を0.1に縮めると、頂上の高さは3.9894になります。確率は1を超えられないので、f(x) が確率ではないことが分かります。曲線が細く高くなっても、面積は1のままです。
標準化と、平均±1σ・2σ・3σに入る確率
平均や標準偏差が違う正規分布でも、Z=(X−μ)/σ という変換をすると、すべて標準正規分布 N(0, 1) にそろいます。この変換を標準化と呼びます。標準化した値は「平均から標準偏差いくつ分離れているか」を表すので、単位の違うデータどうしでも位置を比べられます。
標準正規分布では、平均±1σ の範囲に約68.27%、±2σ に約95.45%、±3σ に約99.73% のデータが入ります。
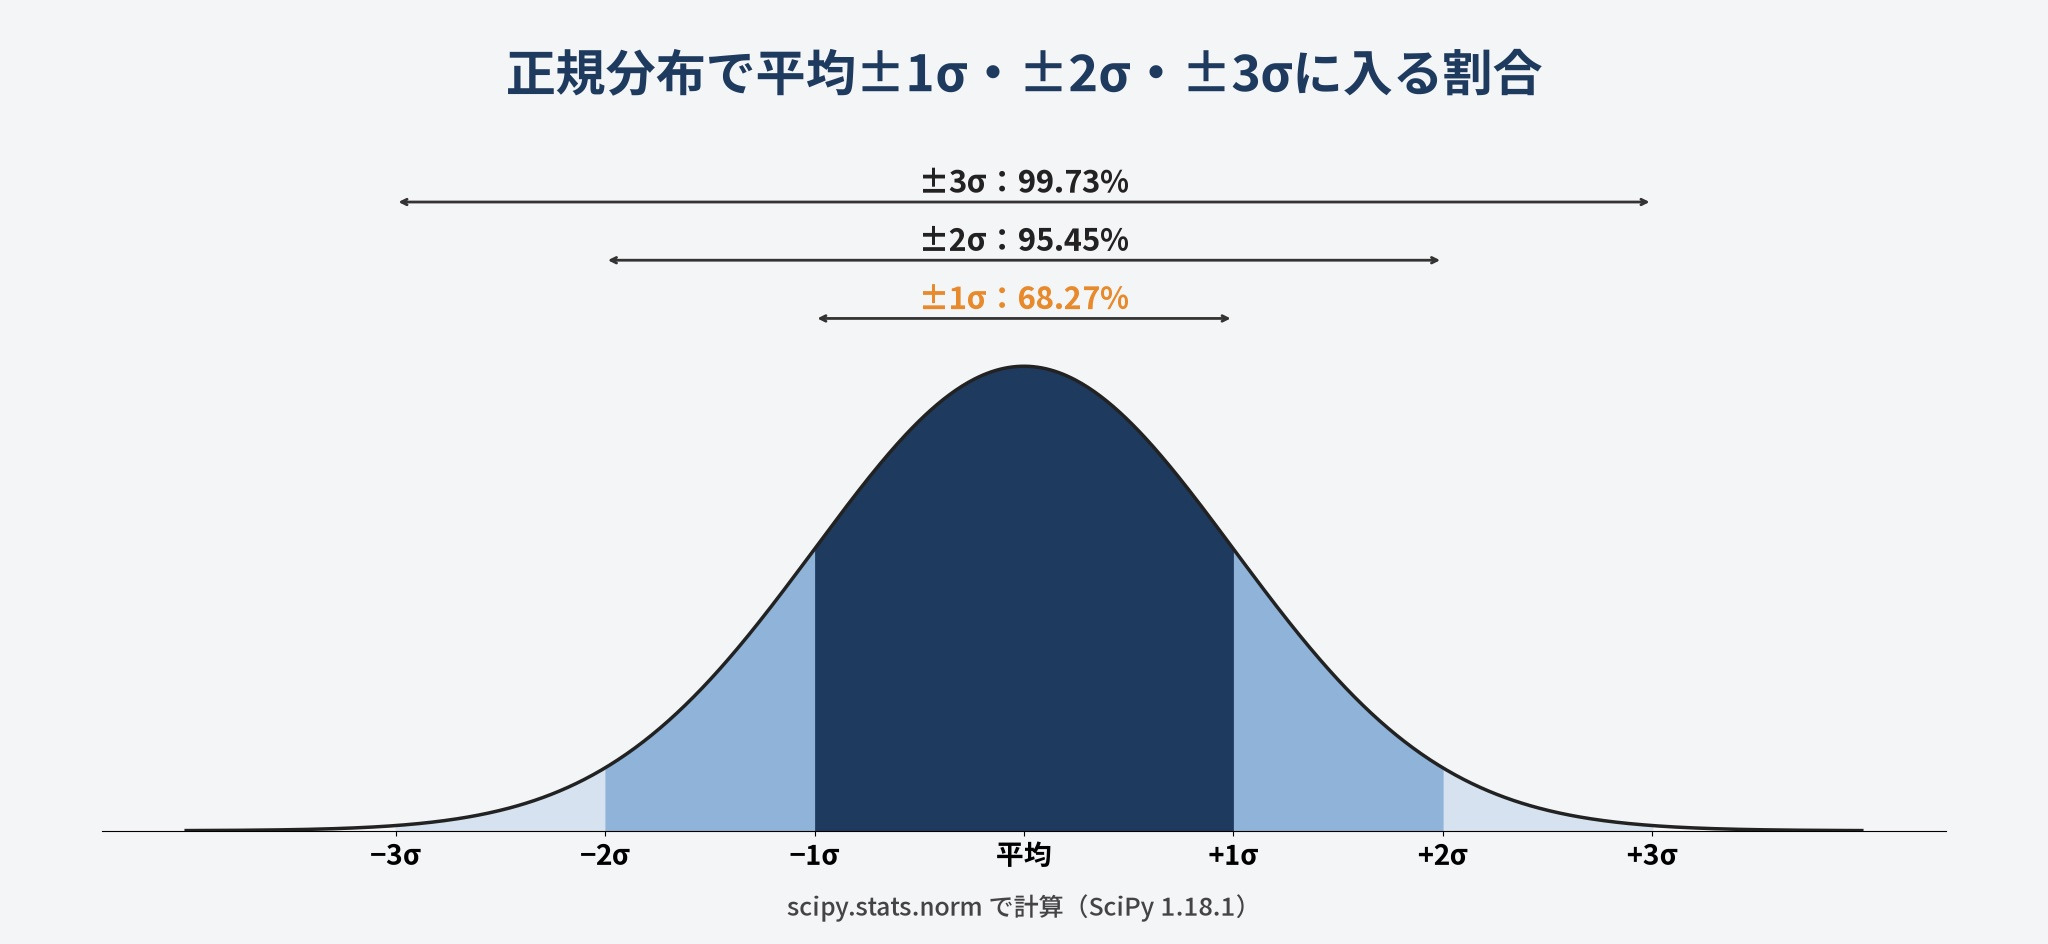
身近な例が偏差値です。偏差値は平均50、標準偏差10の正規分布を想定した指標で、偏差値60は平均から1σ上にあたります。1σより上に入る確率は約16%なので、偏差値60は上位約16%の位置です。この数値は東北大学の講義資料「統計学入門 ~代表的な確率分布~」にも示されています。
確率分布をPythonのscipy.statsで計算して確かめる
ここまでの計算を、Pythonで確かめます。確率分布の計算には、SciPyというライブラリの scipy.stats を使います。手で計算した値とコードの出力が一致すれば、式の理解が正しいことを確認できます。
最初に、実行環境のバージョンを記録しておきます。
import sys, numpy, scipy
print(sys.version.split()[0], numpy.__version__, scipy.__version__)
本記事の実行環境では 3.13.13 2.5.3 1.18.1 と出力されました。
pmf・pdf・cdf・sf・ppfの使い分け
scipy.stats の分布は、どれも同じ名前のメソッドで計算できます。よく使うものを整理しました。
| メソッド | 返す値 | 使う場面 |
|---|---|---|
| pmf | 離散型の P(X=k)(確率質量関数) | 確率分布表を作る |
| 連続型の f(x)(確率密度関数) | 曲線の高さを描く | |
| cdf | P(X≦x)(累積分布関数) | 「x 以下になる確率」を求める |
| sf | P(X>x)(1−cdf) | 「x を超える確率」を求める |
| ppf | cdf の逆関数 | 「下から95%の点はどこか」を求める |
| rvs | 乱数 | シミュレーションする |
この表から分かるとおり、離散型では pmf、連続型では pdf と名前が分かれます。確率として使えるのは pmf と cdf・sf の値で、pdf の値は確率ではありません。
確率分布表をPythonで作り、シミュレーションと照合する
購入率30%の顧客3人の確率分布表を、4ステップどおりに数え上げで作ります。同じ値が二項分布の binom.pmf でも出るか、10万回のシミュレーションの相対度数が近づくかも同時に確かめます。
from itertools import product
import numpy as np
from scipy import stats

p = 0.3  # 1人が購入する確率
n = 3    # 顧客の人数

# ステップ1〜2:3人の購入・非購入の全パターンを数え上げ、購入人数ごとに確率を足す
table = {k: 0.0 for k in range(n + 1)}
for pattern in product([0, 1], repeat=n):
    prob = 1.0
    for x in pattern:
        prob *= p if x == 1 else 1 - p
    table[sum(pattern)] += prob

for k, prob in table.items():
    print(k, round(prob, 3), round(stats.binom.pmf(k, n, p), 3))

# ステップ3:確率の合計が1になるかを確かめる
print("合計", round(sum(table.values()), 10))

# ステップ4:期待値と分散
mean = sum(k * q for k, q in table.items())
var = sum((k - mean) ** 2 * q for k, q in table.items())
print("期待値", round(mean, 3), "分散", round(var, 3))

# 10万回のシミュレーションで、相対度数が確率分布表に近づくかを見る
rng = np.random.default_rng(0)
sim = rng.binomial(n, p, size=100_000)
print(np.bincount(sim) / sim.size)
出力は次のとおりです。
0 0.343 0.343
1 0.441 0.441
2 0.189 0.189
3 0.027 0.027
合計 1.0
期待値 0.9 分散 0.63
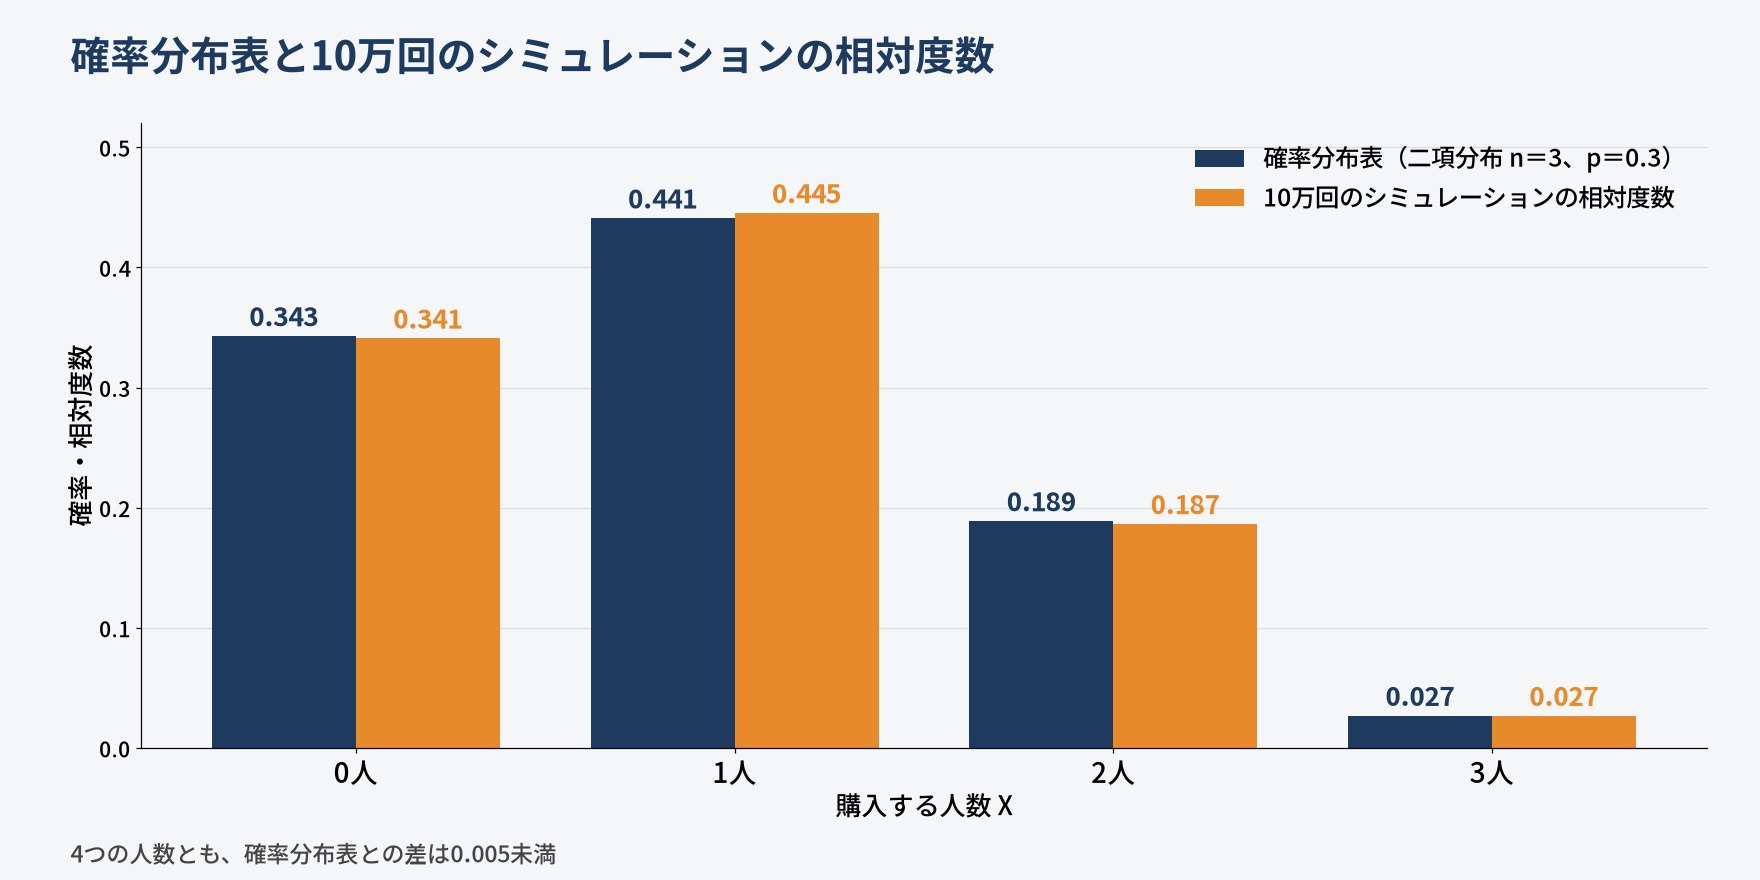
[0.34102 0.44539 0.1866  0.02699]
数え上げた確率と binom.pmf の値は、4つの人数すべてで一致しました。期待値0.9と分散0.63も、一覧表の式 np=3×0.3、np(1−p)=3×0.3×0.7 と同じです。10万回のシミュレーションの相対度数は0人が0.341、1人が0.445で、4つの人数とも確率分布表との差は0.005未満でした。
正規分布の確率をPythonで求める
次に、正規分布の確率密度と確率を計算します。loc に平均、scale に標準偏差を渡します。
from scipy import stats

# 確率密度は確率ではない:平均での高さ
print(round(stats.norm.pdf(0, loc=0, scale=1), 4))
print(round(stats.norm.pdf(0, loc=0, scale=0.1), 4))

# 平均±1σ・±2σ・±3σに入る確率
for k in [1, 2, 3]:
    print(k, round(stats.norm.cdf(k) - stats.norm.cdf(-k), 4))

# 偏差値(平均50・標準偏差10)が60以上になる確率と、上位2.5%の境目
print(round(stats.norm.sf(60, loc=50, scale=10), 4))
print(round(stats.norm.ppf(0.975, loc=50, scale=10), 2))
0.3989
3.9894
1 0.6827
2 0.9545
3 0.9973
0.1587
69.61行目と2行目が、確率密度が1を超えうることの確認です。±1σ・2σ・3σの確率は、それぞれ0.6827・0.9545・0.9973で、前の章で紹介した値と一致しました。偏差値60以上になる確率は0.1587で、上位約16%です。最後の69.6は、下から97.5%の位置、つまり上位2.5%の境目です。50+1.96×10 にあたり、この「1.96」は95%の区間を作るときに何度も出てくる数値です。
ポアソン分布と指数分布で問い合わせ件数を計算する
最後に、件数と待ち時間の例です。1時間に平均3件の問い合わせが来る窓口で、「1時間に4件以上来る確率」と「次の問い合わせまで20分以上空く確率」を求めます。
from scipy import stats

lam = 3  # 1時間あたりの平均問い合わせ件数

# 1時間に4件以上の問い合わせが来る確率
print(round(stats.poisson.sf(3, lam), 4))
# 次の問い合わせまで20分(1/3時間)以上空く確率。scale は 1/λ
print(round(stats.expon.sf(1/3, scale=1/lam), 4))
0.3528
0.36791時間に4件以上来る確率は約35%でした。離散型の sf(3) は「3を超える」、つまり4以上の確率を返す点に注意してください。20分以上空く確率は0.3679で、式で計算した e^(−3×1/3)=e^(−1) と一致します。この2つの数字があれば、窓口を1人で回せる時間帯かどうかを見積もる材料になります。
ここまで確率分布の計算をPythonで確かめてきましたが、「計算は追えたが、仮説検定や機械学習までつなげて、自分の業務のデータで使えるところまで独学で進められるか不安」という方は、リベルクラフトへご相談ください。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座では、Pythonでのデータ分析・機械学習の基礎から、生成AIを使った開発までを6つのSTEPで順に学べます。自分のデータにどの分布を当てはめればよいか迷ったときも、現役データサイエンティストと1対1で画面を見ながら確かめられます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
確率分布を実務で使うときの4つの落とし穴
計算の方法が分かったところで、実務の分析で間違えやすい点を4つ挙げます。どれも、コードはエラーなく動くのに結果だけが誤るため、気づきにくいものです。以下のコードで、間違えたときにどれだけ結果がずれるかを示します。
import numpy as np
from scipy import stats

# 落とし穴1:scale に分散を渡してしまう(正しくは標準偏差)
print(round(stats.norm.sf(60, loc=50, scale=10), 4), round(stats.norm.sf(60, loc=50, scale=100), 4))
# 指数分布の scale に λ をそのまま渡してしまう(正しくは 1/λ)
print(round(stats.expon.sf(1/3, scale=1/3), 4), round(stats.expon.sf(1/3, scale=3), 4))

# 落とし穴3:件数データを正規分布で近似すると、負の件数に確率が付く
lam = 2
print(round(stats.norm.cdf(-0.5, loc=lam, scale=np.sqrt(lam)), 4))

# 落とし穴4:平均と分散が大きく違う件数データ(生成データ)
rng = np.random.default_rng(0)
counts = rng.negative_binomial(n=1, p=0.25, size=365)
print(round(counts.mean(), 2), round(counts.var(ddof=1), 2))
print(round(stats.poisson.sf(9, counts.mean()), 4), round((counts >= 10).mean(), 4))
0.1587 0.4602
0.3679 0.8948
0.0385
3.28 14.43
0.0021 0.08221. scipyの引数に分散やλをそのまま渡す
教科書では正規分布を N(μ, σ²) と分散で書きますが、scipy.stats.norm の scale は標準偏差です(SciPy公式ドキュメント)。分散100をそのまま渡すと、偏差値60以上の確率が正しい0.1587から0.4602に変わりました。
指数分布も同じです。教科書の λ に対して、scipy.stats.expon は scale=1/λ で指定します(SciPy公式ドキュメント)。λ=3 を scale に入れると、20分以上空く確率が0.3679から0.8948に跳ね上がります。教科書の記号とライブラリの引数は、1対1で対応するとは限りません。新しい分布を使うときは、公式ドキュメントで引数の意味を確かめてから使ってください。
2. 確率密度の値を確率として読む
pdf の値をそのまま「その値になる確率」と説明してしまう誤りです。前の章で見たとおり、標準偏差0.1の正規分布では pdf が3.9894になり、確率では説明がつきません。
連続型のデータで確率を答えるときは、「処理時間が30分から35分の間に入る確率」のように区間で考え、cdf の差で計算します。
3. 件数データに正規分布を当てはめる
件数のデータは0より小さくなりません。ところが、平均2件のように件数が小さいデータを正規分布で近似すると、負の件数にも確率が付きます。上のコードでは、平均2・分散2の正規分布で「−0.5以下」になる確率が0.0385でした。約4%の確率で「マイナスの件数」が起きる、というありえない予測になります。
件数が小さいデータは、まずポアソン分布や二項分布のような離散型の分布で考えるのが基本です。正規分布は便利ですが、データの範囲や形を見ずに当てはめないようにしましょう。売上金額や滞在時間のように、右に長く裾を引くデータでも同じ注意が必要です。
4. 平均と分散が大きく違うデータにポアソン分布を使う
ポアソン分布は、平均と分散が等しいことを前提にした分布です。実際の件数データでは、キャンペーンの日だけ問い合わせが急増するなど、分散が平均よりずっと大きくなることがよくあります。
上のコードでは、そうした性質を持つデータを乱数で365日分作りました。平均は3.28件なのに、分散は14.43と4倍以上あります。このデータにポアソン分布を当てはめると、「1日に10件以上来る確率」は0.0021と見積もられます。実際のデータでは、10件以上の日が0.0822、365日のうち30日ありました。ポアソン分布を使う前に、平均と分散を並べて比べるだけで、この見積もりの誤りは防げます。分散が大きく上回るときは、負の二項分布など、ばらつきを別に持てる分布を検討します。
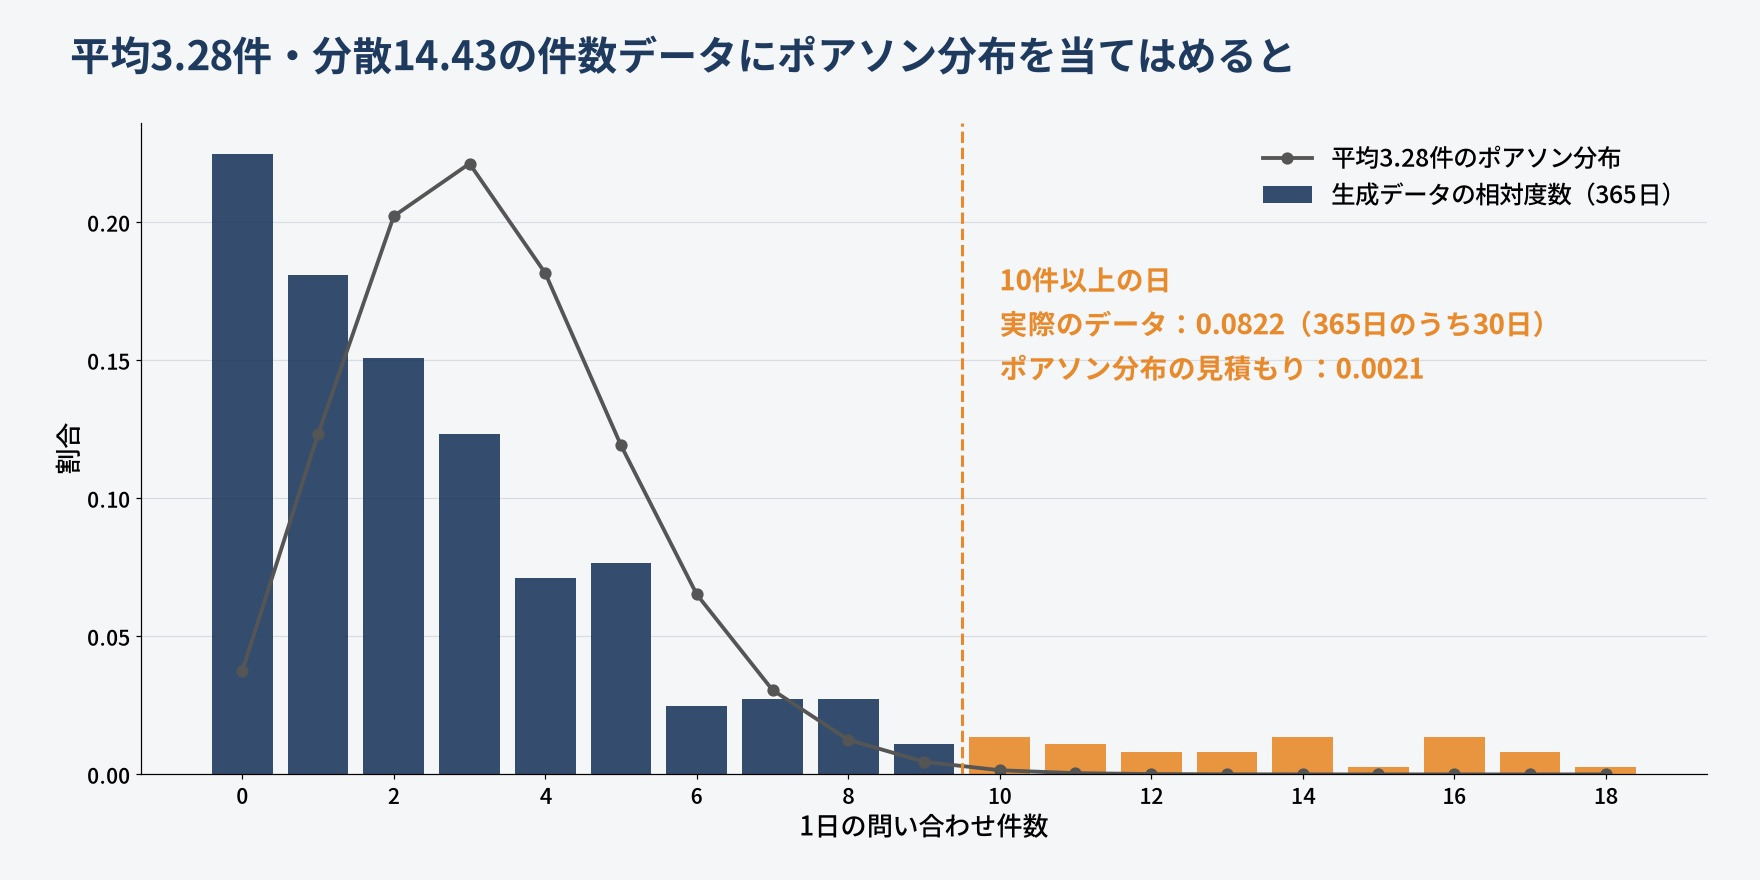
なお、これは乱数で作った1つのデータでの結果です。どれだけずれるかは、データのばらつき方によって変わります。
まとめ
- 確率分布とは、確率変数がとりうる値と、その値が出る確率との対応を表したもの
- 離散型は確率質量関数で各値の確率を、連続型は確率密度関数の下の面積で区間の確率を表す
- 確率分布表は、値を書き出し、確率を求め、合計1を確かめ、期待値と分散を計算する4ステップで作れる
- 代表的な分布は、ベルヌーイ・二項・ポアソン・一様・指数・正規の6つ。購入の有無、件数、待ち時間、測定値のばらつきと対応させて覚えると使い分けやすい
- 正規分布の確率密度関数は平均 μ で最大になる左右対称の曲線で、標準化すると N(0, 1) にそろう。±1σ に約68%、±2σ に約95% が入る
- scipy.stats を使えば手計算を照合できる。ただし
scaleの意味、確率密度と確率の違い、分布の前提を確かめてから使う
確率分布の次は、この考え方を使って「差があると言えるか」を判断する仮説検定や、推定の幅を示す信頼区間へ進むのが自然な順番です。データ分析の学習全体の順序は、以下の記事で紹介しています。
参照記事:データ分析の勉強ロードマップ。未経験からポートフォリオ完成までの全ステップ
参照記事:データ分析に必要な14のスキルを紹介!効率的な学び方も解説
統計や機械学習を含むデータサイエンスの全体像は、次の記事で整理しています。
参照記事:データサイエンスとは。身近な例・仕事内容・学び方まで初心者向けに解説
確率分布の先のデータ分析を学ぶなら「Craft College」へ
「確率分布の計算は追えたが、自分の仕事のデータでどの分布を使えばよいのか、統計をどこまで学べば分析に使えるのかまでは分からない」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- 統計の知識を、自分の業務データの分析に使える形で身につけたい方
- 数式の暗記ではなく、Pythonで確かめながら統計を学びたい方
- 独学で何から手をつければよいか分からず、止まってしまっている方
講座は9ヶ月36週で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。