ベクトル検索とは。全文検索との違いと、ハイブリッド検索が効く条件を実測で確かめる
社内文書1,844件を対象に「パソコンが立ち上がらないときの連絡先」と尋ねたところ、全文検索(BM25)が返した1位から3位は、まったく関係のないエラーコードの説明でした。正解の文書は201位です。同じ質問をベクトル検索に投げると、1位に正解が返ってきます。
ここまでは、ベクトル検索の解説記事によく書かれているとおりです。ただ、その先で「ならば両方を組み合わせたハイブリッド検索にすればよい」と進むと、話が変わります。同じ27件のクエリで測ると、BM25とベクトル検索をRRFで統合した結果は、ベクトル検索単体を下回りました。
本記事に出てくる数値は、すべて実際にコードを実行して得た出力です。実行環境は Python 3.13.13・numpy 2.5.3・scikit-learn 1.9.1・rank-bm25 0.2.2・sentence-transformers 6.1.0、機材は Apple M1 Pro のノートPC(CPUのみ)、実行日は2026年9月21日で、乱数シードはコード中に固定しています。外部のAPIは使わず、すべてローカルで動かしています。
そこで本記事では、
- ベクトル検索とは何か。全文検索(キーワード検索)と何を変えているのか
- 同じデータで両方を動かすと、どちらがどう外すのか
- 近傍探索の索引が、再現率と検索時間をどう交換しているのか
- BM25と密ベクトルをRRFで統合するハイブリッド検索が、効く条件と効かない条件
- ハイブリッド検索を入れる前に、効き幅を見積もる測り方
- 精度が出ないときに手を付ける順番
を解説します。
検索の設計を1人で決めていて、その判断が妥当かどうか確かめる相手が社内にいないという方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
ベクトル検索とは。意味の近さで文書を並べる検索
ベクトル検索の定義。埋め込みで数値に変え、近い順に並べる
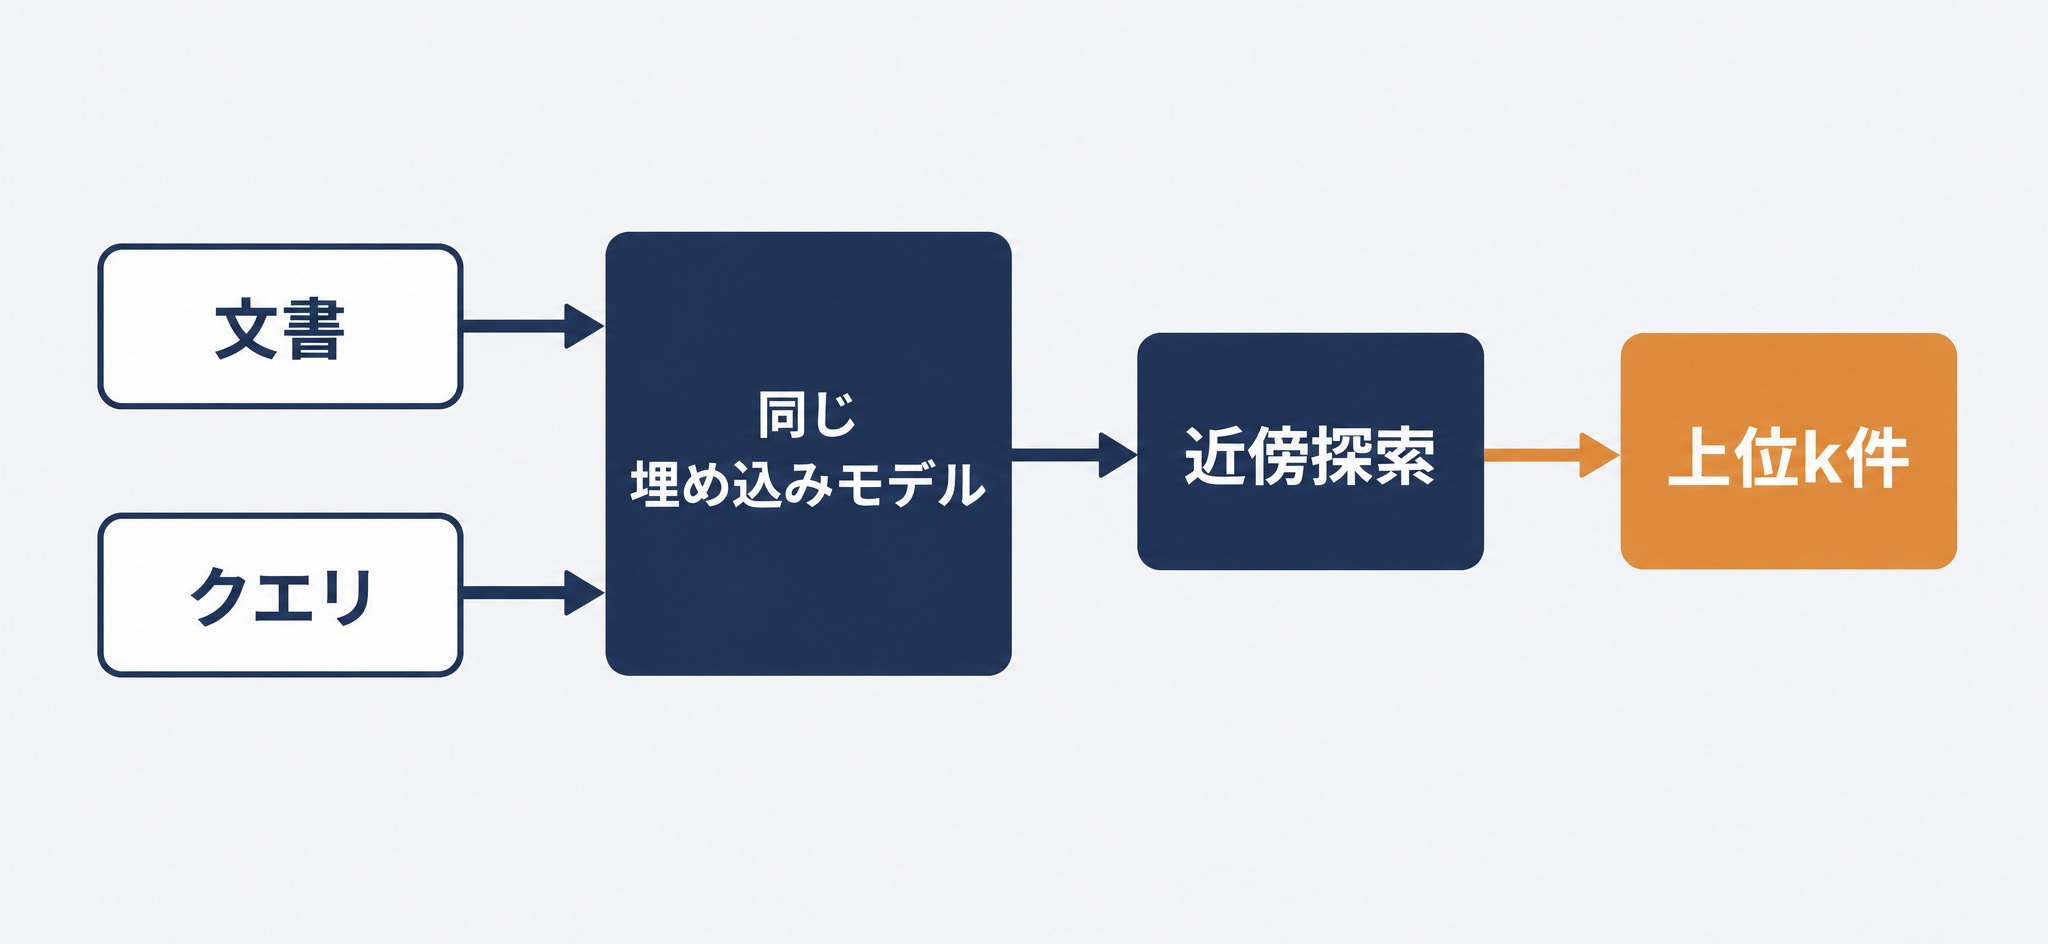
ベクトル検索とは、文書とクエリを同じ埋め込みモデルで数値の並び(ベクトル)に変換し、ベクトル同士の近さの順に文書を並べて返す検索です。
ここで言う埋め込みとは、テキストを決まった長さの数値列に写す変換のことで、意味の近い文章どうしが近い位置に来るように学習されています。本記事で使う intfloat/multilingual-e5-small は、文を384個の数値に変換します。
検索のとき、システムは語が一致しているかどうかを見ていません。クエリのベクトルと各文書のベクトルの距離だけを見ています。だから「リモートワーク」と書かれたクエリで「在宅勤務」と書かれた文書が返りますし、逆に、語がぴったり一致していても意味が遠ければ順位は上がりません。
RAG(検索拡張生成)でLLMに社内文書を読ませる場合、この検索の部分がベクトル検索にあたります。RAGの全体像はLLMとRAGの関係を整理した記事にまとめています。
全文検索(キーワード検索)との違いは、語の一致を見るか距離を見るか
全文検索は、クエリに含まれる語が文書のどこに何回出てくるかを数えて順位を決めます。ベクトル検索は、語の一致を経由せずにベクトル間の距離で順位を決めます。両者の差は、この一点から生まれます。
| 全文検索(BM25) | ベクトル検索 | |
|---|---|---|
| 順位を決める材料 | 語の出現回数、語の希少さ、文書の長さ | クエリと文書のベクトルの距離 |
| 表記ゆれ・言い換え | 語が一致しないと拾えない | 意味が近ければ拾える |
| 型番・エラーコード | 完全一致するので強い | 似た番号と混ざることがある |
| 準備するもの | 転置索引、日本語なら分かち書き | 埋め込みモデル、ベクトルの索引 |
| スコアの範囲 | 上限なし。コーパスの統計で変わる | コサインなら決まった範囲に収まる |
この表は使い分けの目安にはなりますが、自分のデータでどちらがどれだけ効くかは、この表からは分かりません。後半で実際に測ります。
BM25が計算しているもの。出現回数の飽和・語の希少さ・文書の長さ
ハイブリッド検索の話に進むために、全文検索側で使われるBM25が何を計算しているかを押さえておきます。
BM25は、クエリに含まれる語ごとに3つの要素を掛け合わせ、それを足し合わせたものをスコアにします。
- 出現回数の飽和:その語が文書に何回出てくるか。ただし回数に比例して伸び続けるのではなく、増えるほど効きが鈍る形になっています。効きの鈍り方を決めるのがパラメータ
k1です - 語の希少さ:コーパス全体で珍しい語ほど重く扱います。関連情報が与えられない通常の検索では、この部分はidfに近い形になります
- 文書の長さによる正規化:長い文書ほど語がたくさん出るので、平均文書長と比べて割り引きます。割り引きの強さを決めるのがパラメータ
bです
この定式化は、Robertson と Zaragoza の解説(The Probabilistic Relevance Framework: BM25 and Beyond、Foundations and Trends in Information Retrieval 第3巻第4号、2009年)にまとまっています。この文献は、パラメータの決め方について理論からは指針が出ないとしたうえで、多くの実験から 0.5 < b < 0.8・1.2 < k1 < 2 が多くの状況で妥当だと述べています。Elasticsearchの既定値は k1 が1.2、b が0.75で、この範囲に入っています(similarity)。
重要なのは、BM25のスコアに上限が無いことです。コーパスの統計と文書の長さで値が変わります。この性質が、後半でスコアをそのまま足せない理由になります。
ベクトル検索と全文検索を同じデータで動かして違いを見る
定義と仕組みを整理したので、ここからは同じデータで両方を動かします。表の比較ではなく、実際に外した順位を見ます。
測定の条件。1,844件の日本語コーパスと27件のクエリ
測定に使ったのは、社内文書を模した日本語のコーパス1,844件です。内訳は次のとおりです。
- 48件:就業規則、情報システムの運用、製品仕様を模して1件ずつ書いた短文
- 1,000件:
エラーコード ERR-XXXX は(原因)を示し、(対処)が必要である。という同じ書式で、番号と原因だけが違う文書 - 796件:
産業用コントローラ XR-XXXX の定格消費電力は XXW である。という同じ書式の製品仕様
後ろの1,796件を入れているのは、実務のコーパスには「書式が同じで識別子だけ違う文書」が大量に含まれるからです。エラーコード一覧、部品表、条文がこれにあたります。48件だけの小さなコーパスで測ると、この性質が消えてしまいます。
クエリは27件を用意し、3種類に分けました。
- 言い換え 10件:正解の文書と語が一致しない(「有給を取りたいときの手続き」に対して正解は「年次有給休暇を取得する場合は、勤務管理システムから前営業日までに届け出る。」)
- 識別子 13件:型番、エラーコード、条番号を含む(「ERR-5263 の対処方法」「就業規則第12条」)
- 中間 4件:語もおおむね一致し、意味も近い(「経費精算の締め日」)
各クエリには正解の文書を1件ずつ決めてあります。評価指標は、正解が1位に来た割合(Recall@1)、3位以内に入った割合(Recall@3)、10位以内に入った割合(Recall@10)、正解順位の逆数の平均(MRR)の4つです。
社内文書をAIに読ませる前の整理については、RAGで社内データを扱うときの記事で別途扱っています。
言い換えのクエリでは全文検索が大きく外す
全文検索側はBM25を使います。日本語は語の区切りが自動では分かれないため、英数字の語はそのまま1語として扱い、日本語の連続は文字2つずつに区切ります。形態素解析器を使わずに日本語を検索するときの、一般的なやり方です。
import re
import numpy as np
from rank_bm25 import BM25Okapi

def tokenize(text):
    """英数字はそのまま1語、日本語の連続は文字2-gramに分ける"""
    tokens = []
    for m in re.finditer(r"[0-9a-z][0-9a-z.\-]*|[ぁ-んァ-ヶ一-龥ー]+", text.lower()):
        s = m.group()
        if re.match(r"[0-9a-z]", s):
            tokens.append(s.rstrip(".-"))
        elif len(s) == 1:
            tokens.append(s)
        else:
            tokens += [s[i:i + 2] for i in range(len(s) - 1)]
    return tokens

bm25 = BM25Okapi([tokenize(d) for d in DOCS])
scores = bm25.get_scores(tokenize("パソコンが立ち上がらないときの連絡先"))
for i in np.argsort(-scores)[:3]:
    print(round(scores[i], 2), DOCS[i])
出力された上位3件は、いずれもスコア3.81で、次のような文書でした。
3.81 エラーコード ERR-5347 は時刻設定のずれを示し、保守窓口への連絡が必要である。
3.81 エラーコード ERR-5357 は時刻設定のずれを示し、保守窓口への連絡が必要である。
3.81 エラーコード ERR-5367 は時刻設定のずれを示し、保守窓口への連絡が必要である。正解は「端末の故障および起動不良は、ヘルプデスクへ内線で連絡する。」ですが、201位でした。クエリの「連絡」という語だけが一致し、同じ書式の文書が同点で並んだ結果です。「新しく入った人の教育はどうなっているか」では正解が1,226位まで落ちました。
同じクエリをベクトル検索に投げます。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("intfloat/multilingual-e5-small")
D = model.encode(["passage: " + d for d in DOCS], normalize_embeddings=True)
q = model.encode("query: パソコンが立ち上がらないときの連絡先", normalize_embeddings=True)
sims = D @ q
for i in np.argsort(-sims)[:3]:
    print(round(float(sims[i]), 3), DOCS[i])
0.85 端末の故障および起動不良は、ヘルプデスクへ内線で連絡する。
0.836 社用スマートフォンの紛失時は、ただちにヘルプデスクへ連絡し遠隔消去を依頼する。
0.826 エラーコード ERR-5817 は時刻設定のずれを示し、保守窓口への連絡が必要である。1位が正解で、2位も内容として近い文書です。「パソコン」と「端末」、「立ち上がらない」と「起動不良」が語としては一致していないのに拾えているのが、ベクトル検索の効きどころです。
識別子のクエリでは全文検索が強い
一方、型番やエラーコードを含むクエリでは関係が変わります。「ERR-5263 の対処方法」で測ると、ベクトル検索の上位3件はこうなりました。
0.893 エラーコード ERR-5263 は記録領域の逼迫を示し、ログの退避が必要である。
0.89 エラーコード ERR-5260 は通信の輻輳を示し、再起動により復旧する。
0.887 エラーコード ERR-5265 はセンサ出力の異常を示し、再起動により復旧する。1位は正解ですが、2位と3位のスコアが0.890と0.887で、1位の0.893とほとんど差がありません。番号が3つ違うだけの別の文書が、ほぼ同じ近さに並んでいます。同じクエリのBM25は、正解に6.81というスコアを付けて1位に置き、2位以下を大きく離しました。
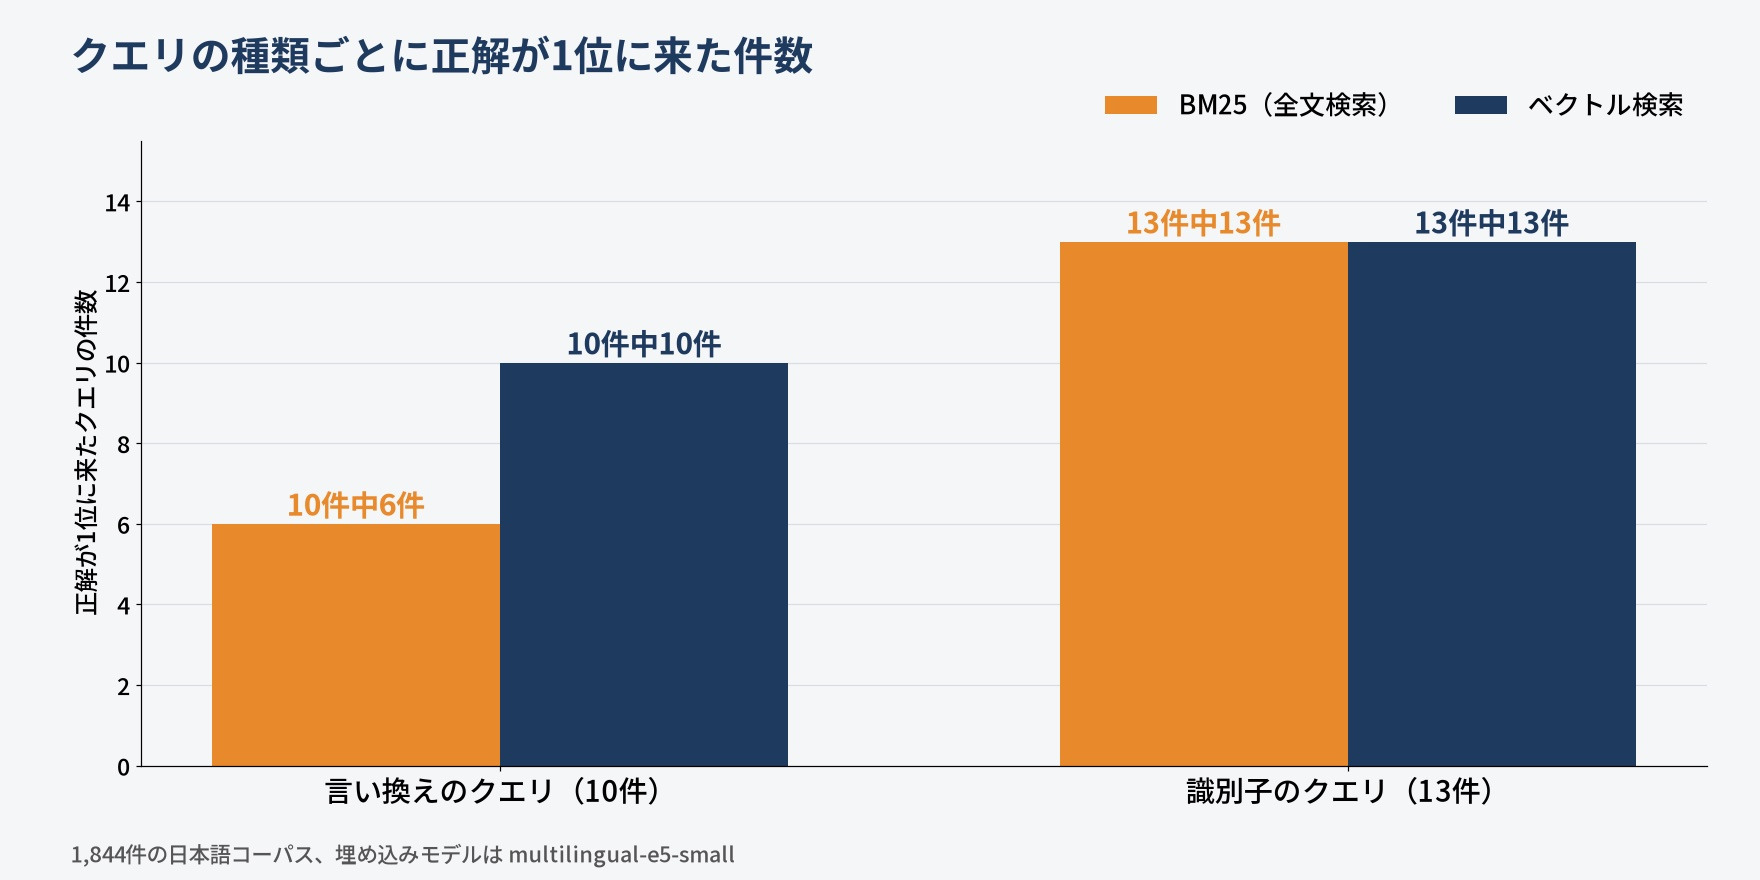
27件のクエリ全体では、BM25は識別子クエリ13件すべてで正解を1位にしました。言い換えクエリは10件中6件です。両者は「どれくらい当たるか」ではなく「どこで外すか」が違います。この違いが、ハイブリッド検索を試す動機になります。
ベクトル検索の内訳。埋め込みモデル・類似度・近傍探索
外し方の違いは分かりました。次に、ベクトル検索の側が何をしているかを部品に分けます。ベクトル検索は3つの部品でできています。
埋め込みモデルが、ベクトル検索の精度の上限を決める
1つ目の部品は埋め込みモデルです。ここが、ベクトル検索で到達できる精度の上限を決めます。索引や統合の工夫は、このモデルが作ったベクトルの上で行う後処理にすぎません。
どれくらい効くかは、後半でモデルを差し替えた実測で示します。先に結論だけ書くと、同じコーパス・同じクエリで、埋め込みモデルを替えるだけでRecall@1が1.000から0.481まで落ちました。
実装上、押さえておく点は2つあります。
- 文書側とクエリ側で同じモデルを使う。別のモデルで作ったベクトルは、同じ空間の点ではないので距離に意味がありません
- モデルが要求する接頭辞を守る。今回使った multilingual-e5 系は、文書に
passage:、クエリにquery:を付けることを前提に学習されています。付け忘れると精度が落ちます
埋め込みモデルの中身と選び方は、それだけで1本の記事になる話題なので、本記事では上限を決める部品という位置づけにとどめます。
コサイン類似度・内積・L2距離の使い分けと、正規化の効果
2つ目の部品は、近さの測り方です。実務で使われるのは主に3つあります。
- コサイン類似度:2つのベクトルのなす角だけを見ます。長さの違いに影響されません
- 内積:角度と長さの両方を見ます。長いベクトルほどスコアが大きくなります
- L2距離(ユークリッド距離):2点間の直線距離を測ります
選び方の基準は、使う埋め込みモデルが何を前提に学習されたかです。多くのテキスト埋め込みモデルはコサイン類似度を前提にしています。
実装では、ベクトルを長さ1に正規化しておくのが定石です。正規化すると内積とコサイン類似度が一致するため、行列の掛け算1回で類似度が求まります。Azure AI Searchの公式ドキュメントも、正規化済みベクトルでは dotProduct がコサインと同じ結果になり、わずかに高速だと明記しています(ベクターの関連性とランク付け)。前掲のコードで normalize_embeddings=True を指定し、D @ q という1行で類似度を計算しているのはこのためです。
3つ目の部品が近傍探索です。件数が増えたときに最初に問題になるのがここなので、章を分けて扱います。
近傍探索(ANN)。全探索が持たなくなる境目と、索引が交換するもの
全探索のコストを実測する。件数に比例して伸びる
近傍探索でいちばん素朴なやり方は、クエリのベクトルと全文書のベクトルの類似度を計算して、上位を取る全探索です。実装は D @ q の1行で済み、結果は常に正確です。
問題は件数が増えたときの時間です。384次元のベクトルを20万件用意して測りました。
import numpy as np

rng = np.random.default_rng(0)
NLIST, DIM, N = 256, 384, 200_000
centers = rng.normal(size=(NLIST, DIM)).astype("float32") * 0.35
X = centers[rng.integers(0, NLIST, size=N)] + rng.normal(size=(N, DIM)).astype("float32")
X /= np.linalg.norm(X, axis=1, keepdims=True)
X = X.astype("float32")
このデータは実際の埋め込みではなく、256個の中心の周りに散らした合成ベクトルです。実際の埋め込みほど強い構造は持っていませんが、まったくの一様乱数よりは実データに近い形になります。
1クエリあたりの全探索の時間は、1万件で0.37ミリ秒、5万件で2.57ミリ秒、20万件で9.65ミリ秒でした(200件のクエリで3回測り、最小値を取りました)。件数におおむね比例して伸びます。メモリは、384次元のfloat32が1件あたり1,536バイトなので、20万件で293MB、100万件で1.43GB、1,000万件で14.31GBという計算になります。
ここから読み取れるのは、数万件までなら全探索でも1桁ミリ秒に収まるということです。Faissの公式ガイドも、検索回数が1,000回から1万回程度なら索引の構築コストを回収できないため全探索(Flat)を使う、正確な結果が必要なら全探索が唯一の選択肢だ、と書いています(Guidelines to choose an index)。pgvectorも既定では完全一致の最近傍探索を行い、近似索引を足したときに「再現率と引き換えに速度が得られる」と明記しています(pgvector)。
IVFとHNSW。候補を絞る2つの考え方
件数が増えて全探索が持たなくなったとき、近似最近傍探索(ANN)の索引を入れます。正確さを少し落とす代わりに、走査する件数を減らします。よく使われるのは2つの考え方です。
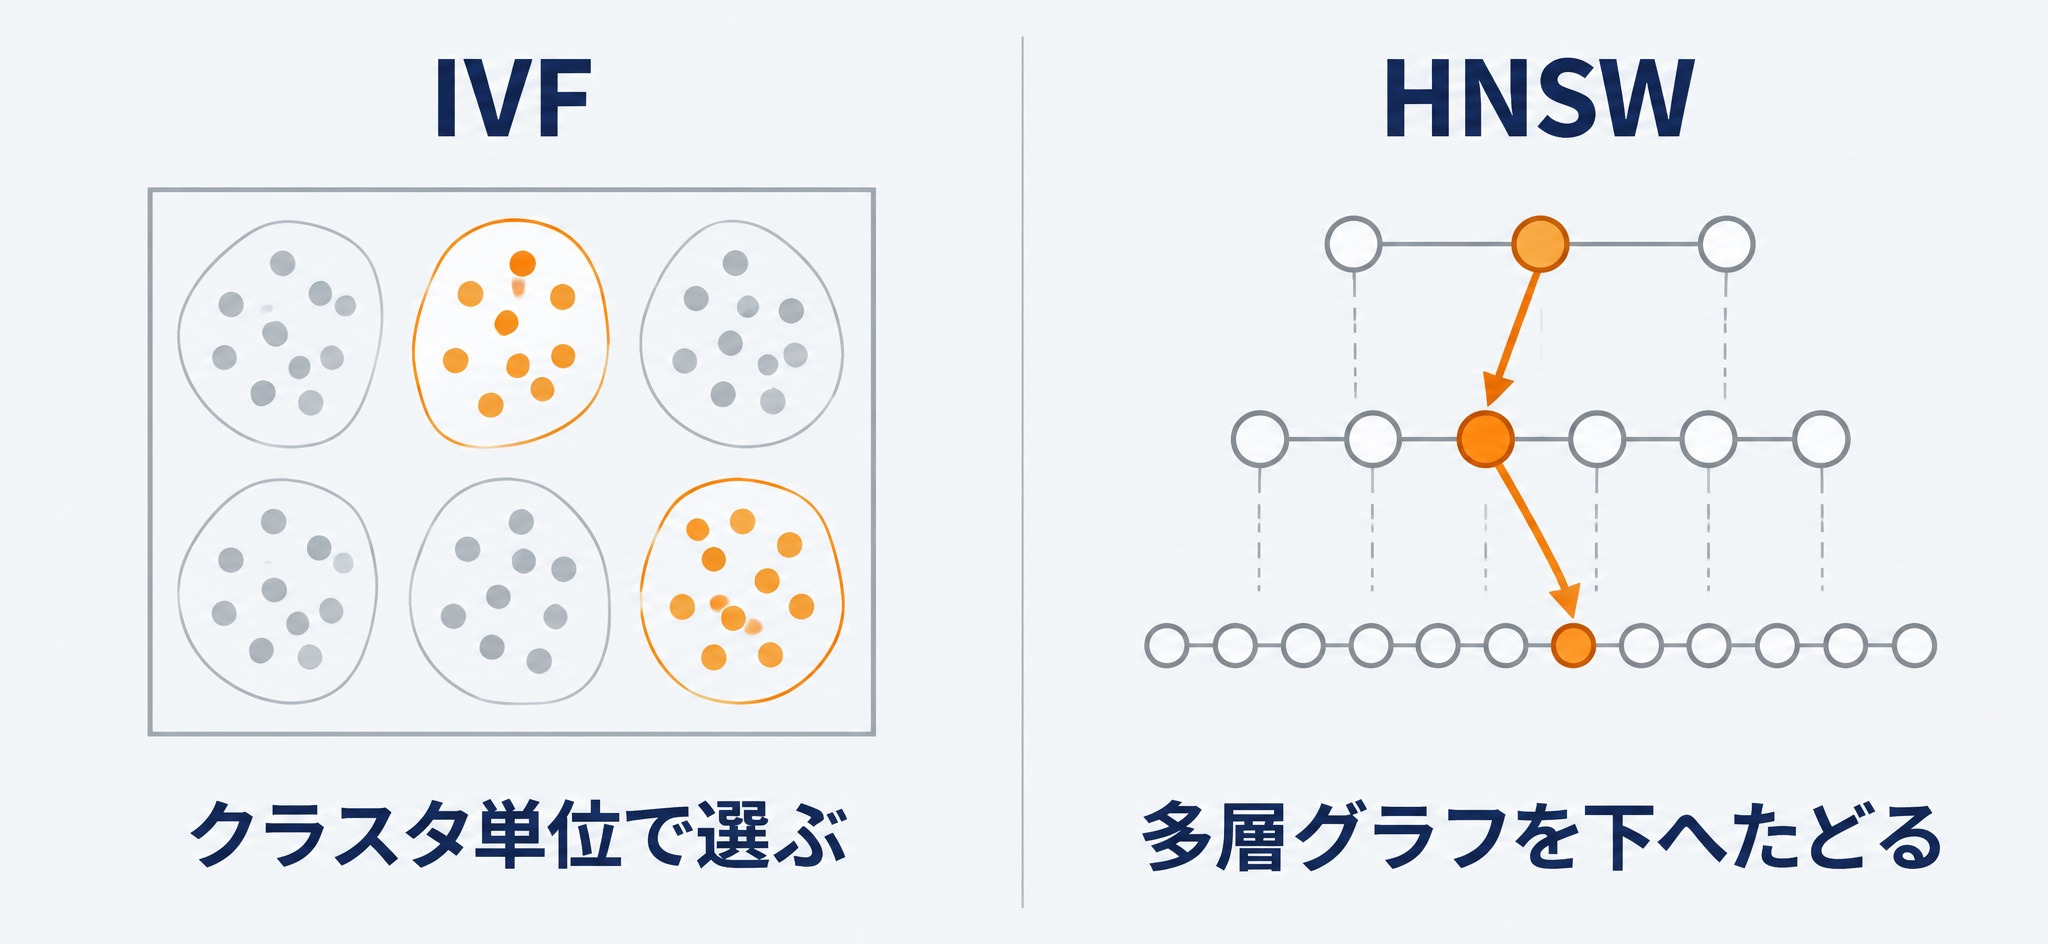
- IVF(転置ファイル):ベクトルをあらかじめクラスタに分けておき、検索時はクエリに近いクラスタだけを走査します。いくつのクラスタに分けるかが
nlist、検索時にいくつ見るかがnprobeです - HNSW(階層的なナビゲーション可能スモールワールドグラフ):ベクトルをノードとするグラフを多層に作り、粗い上の層で大きく移動してから、細かい下の層で近傍を詰めます
HNSWの原論文(Malkov, Yashunin「Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs」arXiv:1603.09320)は、指数的に減衰する確率で各要素の最上位層を決め、上の層から探索を始めることで、階層を持たない構造に対して計算量の伸びが対数的になると主張しています。
OpenSearchのk-NNフィールドでは、この2つを含めて hnsw・ivf・flat・disk_ann が選べます。Faissエンジンを使う場合、HNSWの既定値は m が16、ef_construction が100、ef_search が100です。IVFは学習が必要で、最低でも nlist 件の学習データが要ります(Methods and engines)。
nprobeを振って、再現率と時間の交換を測る
索引が何を交換しているかを、IVFで実際に測ります。scikit-learnのKMeansで粗い分割を作り、nprobe を変えながら、全探索の上位10件をどれだけ取り戻せるか(recall@10)を見ます。
from sklearn.cluster import MiniBatchKMeans

km = MiniBatchKMeans(n_clusters=NLIST, random_state=0, n_init=3, batch_size=4096).fit(X)
buckets = [np.where(km.labels_ == c)[0] for c in range(NLIST)]
C = km.cluster_centers_.astype("float32")
C /= np.linalg.norm(C, axis=1, keepdims=True)

def ivf_search(q, nprobe, k=10):
    cl = np.argpartition(-(C @ q), nprobe - 1)[:nprobe] if nprobe > 1 else [int(np.argmax(C @ q))]
    idx = np.concatenate([buckets[c] for c in cl])
    top = np.argpartition(-(X[idx] @ q), min(k, len(idx) - 1))[:k]
return idx[top]256クラスタへの分割には10.7秒かかり、1バケットあたりの件数は最小1件、中央値787件、最大3,171件になりました。バケットの大きさは均一になりません。min(k, len(idx) - 1) を挟んでいるのは、1件しか入っていないバケットを引いたときに上位10件を取り出せないためです。この偏りは、検索時間のばらつきにもなります。
200件のクエリで測った結果です。nprobe が1のときは平均957件だけを走査して0.35ミリ秒、recall@10は0.776でした。nprobe を8にすると6,401件を走査して2.70ミリ秒、recall@10は0.848です。16で12,542件・5.12ミリ秒・0.883、32で24,925件・10.48ミリ秒・0.915、64まで上げると49,903件・20.57ミリ秒・0.947になりました。
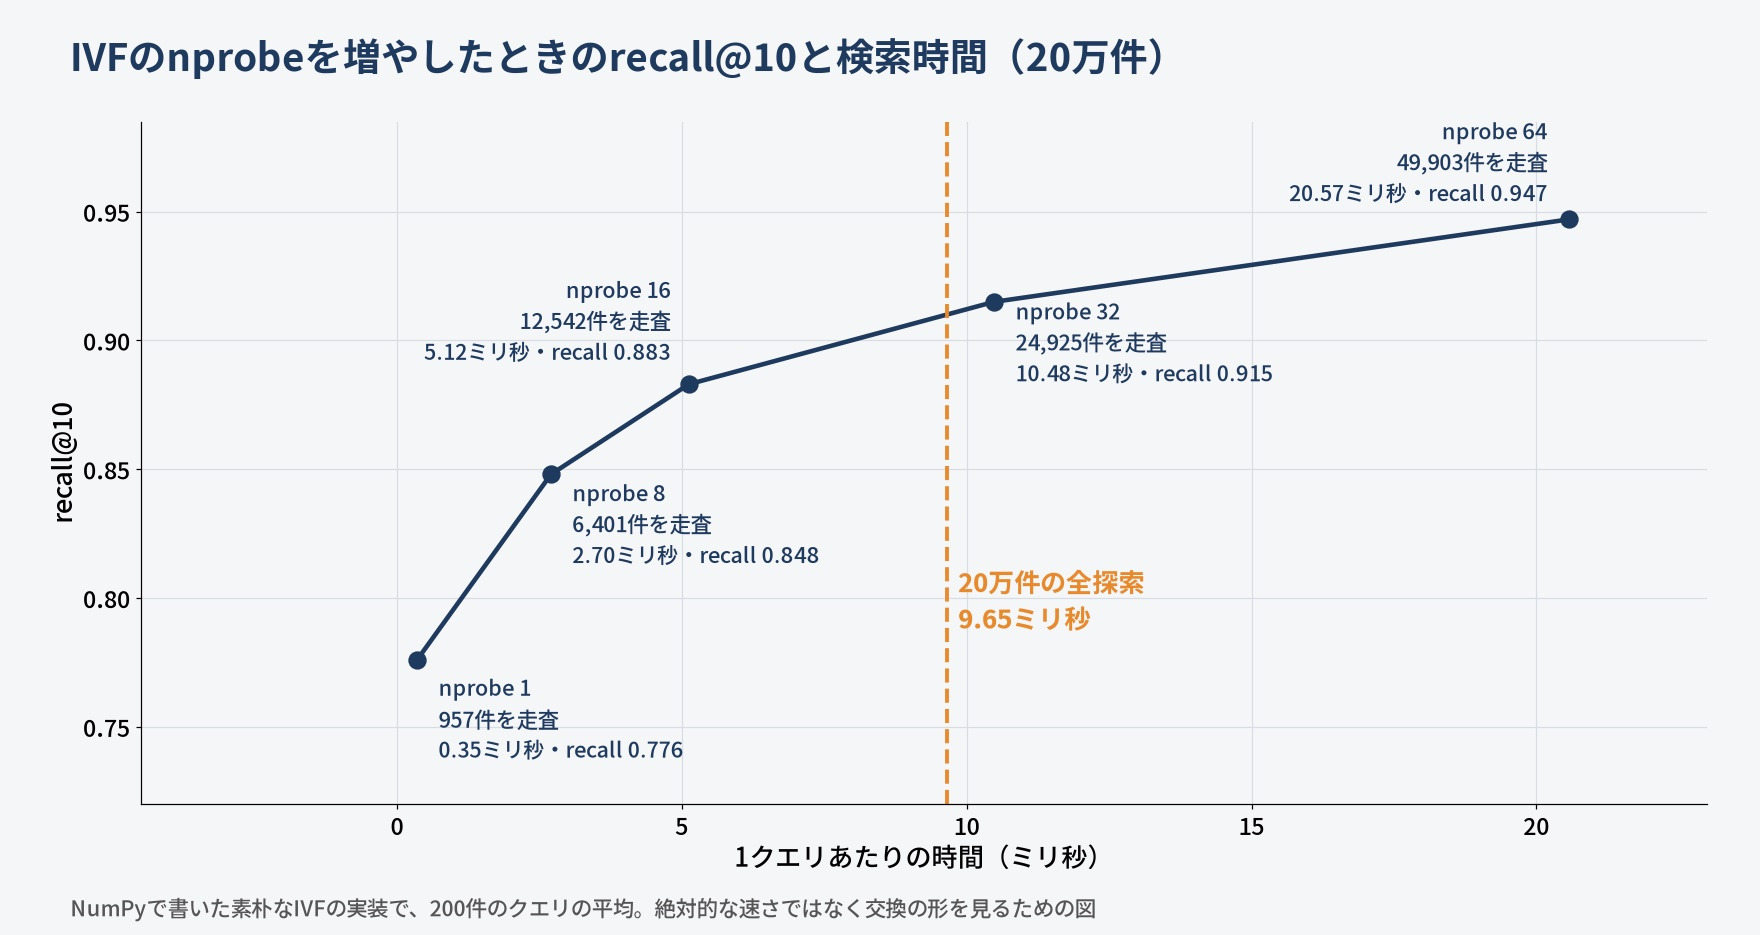
読み取れることが2つあります。1つは、走査件数はほぼ2倍ずつ増えるのに、recallは0.776から0.947までしか伸びないことです。精度を最後まで詰めようとすると、時間の対価が急に重くなります。もう1つは、nprobe が32の時点で1クエリ10.48ミリ秒になり、20万件の全探索(9.65ミリ秒)を上回っていることです。走査しているのは全体の12.5%にすぎないのに、全件を見るより遅くなっています。
この逆転は、NumPyで書いた素朴な実装で、バケットの中身を集める処理に時間がかかっているために起きています。FaissやHNSWの実装はここが最適化されているので、同じ条件でもっと速く動きます。Faissの論文(Johnson, Douze, Jégou「Billion-scale similarity search with GPUs」arXiv:1702.08734)は、4基のGPUで10億ベクトルを結ぶk近傍グラフを12時間未満で構築したと報告しています。ここで見てほしいのは絶対的な速さではなく、再現率と走査件数の交換の形です。
索引を入れる判断。全探索のままでよい規模はどこまでか
以上を踏まえると、索引を入れるかどうかは次の順で決められます。
- いまの件数で全探索の時間を測る。許容する応答時間に収まっているなら、索引は入れません。Elasticsearchの公式ドキュメントも、完全一致のkNNは「小さいデータセットや正確なスコアが必要な場合」に向くとしています(kNN search)
- 収まらない場合、先にフィルタで母集団を減らせないか確認する。部署、期間、文書種別で絞れるなら、全探索のままで足りることがあります
- それでも大きいなら索引を入れ、全探索の結果を正解としてrecallを測る。Azure AI Searchの公式ドキュメントは、完全なKNNをANNの再現率評価用のグラウンドトゥルース作成に使えると書いています
- 業務として許せるrecallの下限を先に決めてから、パラメータを決める。「速いほうがよい」ではなく「recall 0.95を保ったまま最速」という形にします
メモリも判断材料になります。HNSWは全データ点をメモリに置く必要があるため、1,000万件・384次元なら生のベクトルだけで14GB強を見込みます。OpenSearchが持つ sq エンコーダのように32bitを16bitに落とす量子化は、この見積もりを半分にします。
ハイブリッド検索。BM25と密ベクトルをRRFで統合する
ここまでベクトル検索の側を見てきました。ただ、H2-2で測ったとおり、全文検索とベクトル検索は外す場所が違います。ならば両方を動かして結果を混ぜればよい、という発想がハイブリッド検索です。本章では、その統合方法と、効く条件を測ります。
BM25のスコアとベクトルの類似度を、そのまま足せない理由
まず、単純に足し算できない理由から確認します。2つのスコアは、そもそも尺度が違います。
Azure AI Searchの公式ドキュメントは、フルテキスト検索のBM25スコアを「上限なし」、ベクトル検索のスコアをコサインで「0.333から1.00」と整理しています(ハイブリッド検索スコアリング(RRF))。前章で見たとおり、BM25のスコアはコーパスの語の希少さと文書の長さで決まるので、同じシステムでもクエリによって桁が変わります。
この2つを足すには、どちらかの尺度に合わせる正規化が要ります。そして正規化の基準(最大値で割るのか、上位N件の分布で標準化するのか)はクエリごとに動くので、調整が終わりません。そこで、スコアを捨てて順位だけを使う方法が採られます。
RRFの式と、定数kの決め方
順位だけを使う統合方法が、RRF(Reciprocal Rank Fusion)です。式は単純で、文書 d のスコアは、統合したい各ランキング r における順位 r(d) を使って次のように書けます。
RRFscore(d) = Σ 1 / (k + r(d))原典は Cormack, Clarke, Büttcher「Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods」(SIGIR ’09)です。論文には「k=60は予備実験で決めた値で、その後の検証では変更していない」と書かれています。Elasticsearchの rank_constant の既定値も60で、Azure AI Searchの説明も「実験ではkを60などの小さな値にすると性能が最も高い」としています。
ここで実務上たいせつなのは、kが調整の主役ではないことです。原論文の予備実験(TREC topics 351-400、30構成の統合)のMAPは、k=0で.2072、k=10で.2123、k=60で.2145、k=80で.2147、k=500で.2098でした。k=10から100の範囲ではほとんど動きません。比較対象のBest individualが.2016、Condorcetが.2074、CombMNZが.2039なので、kをどう選ぶかより、RRFで統合したこと自体の効きのほうが大きいという読み方になります。論文は4つのTRECセットでの統合を通じて、RRFが平均して4〜5%上回ったと報告しています。
今回のコーパスで同じことを確かめました。kを1、10、60、100、500と振ると、MRRは0.9444、0.9158、0.9081、0.9081、0.9081でした。k=1だけがやや高く、10以降はほとんど動きません。kを触る時間があるなら、後述する重みに使うほうが効きます。
RRFを実装して、全文検索とベクトル検索の順位を統合する
実装は数行で済みます。順位だけを使うので、両者のスコアの性質を気にする必要がありません。
def rrf(rank_lists, weights=None, k=60, top_n=60):
    weights = weights or [1.0] * len(rank_lists)
    scores = {}
    for ranked, w in zip(rank_lists, weights):
        for pos, doc_id in enumerate(ranked[:top_n], start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + w / (k + pos)
    return sorted(scores, key=scores.get, reverse=True)
top_n は、各検索から何位までを統合の対象にするかです。Elasticsearchでは rank_window_size という名前で、既定値は返す件数と同じになっています(Reciprocal rank fusion)。ここを小さくすると、片方の検索が深い順位でしか拾えていない正解が統合の対象から外れます。
実測。ハイブリッド検索がベクトル検索単体を下回った条件
1,844件・27クエリで、BM25単体、ベクトル検索単体、RRFで統合したものを並べて測りました。
| 手法 | Recall@1 | Recall@3 | Recall@10 | MRR | 言い換え10件の1位 | 識別子13件の1位 |
|---|---|---|---|---|---|---|
| BM25 | 0.852 | 0.889 | 0.926 | 0.876 | 6 | 13 |
| ベクトル検索 | 1.000 | 1.000 | 1.000 | 1.000 | 10 | 13 |
| RRF(重み1対1) | 0.889 | 0.926 | 0.963 | 0.908 | 7 | 13 |
| RRF(重み0.3対1) | 0.926 | 0.926 | 1.000 | 0.940 | 8 | 13 |
| RRF(重み0.1対1) | 0.963 | 1.000 | 1.000 | 0.975 | 9 | 13 |
この表から読み取れるのは、この条件ではベクトル検索単体が最も強く、RRFで統合すると指標が下がったということです。BM25が言い換えクエリで大きく外した順位が、統合後の順位に混ざってきたためです。
ここで「ハイブリッド検索は効果がない」とは言えません。1つのコーパス、1つの埋め込みモデル、27件のクエリで測った結果にすぎず、コーパスの性質や埋め込みモデルが変われば結果は変わります。実際、後述するようにモデルを替えると関係が逆転します。言えるのは、ハイブリッド検索が常に上がるわけではないので、入れる前に測る必要があるということです。
効くかどうかを先に測る。取りこぼしの重なりを数える
では、何を測れば事前に判断できるのでしょうか?「片方だけが拾えている正解が何件あるか」を数えます。これが統合で得られる伸びしろの上限になります。
only_bm25 = only_vec = 0
for i, (query, gold, _) in enumerate(QUERIES):
    in_bm25 = gold in bm_ranks[i][:10]
    in_vec = gold in vec_ranks[i][:10]
    only_bm25 += in_bm25 and not in_vec
    only_vec += in_vec and not in_bm25
print(only_bm25, only_vec)今回の結果は、BM25のtop-10にだけ正解が入っていたクエリが0件、ベクトル検索のtop-10にだけ入っていたクエリが2件でした。BM25が新しく持ち込む正解が1件も無いので、統合しても増えようがありません。表でRRFがベクトル単体を超えなかったのは、この数字から予測できたことです。
同じコーパスとクエリのまま、埋め込みモデルだけを日本語に弱いもの(sentence-transformers/stsb-xlm-r-multilingual)に差し替えると、数字が反転します。
- ベクトル検索単体:Recall@1 0.481、Recall@3 0.556、Recall@10 0.556、MRR 0.519
- RRFで統合(重み1対1):Recall@1 0.481、Recall@3 0.704、Recall@10 1.000、MRR 0.640
- BM25のtop-10にだけ正解が入るクエリ:12件
このときのBM25単体はRecall@10が0.926、弱いベクトル検索は0.556です。統合するとRecall@10が1.000になり、どちらの単体よりも高くなりました。片方だけが拾える正解が12件あったので、その件数の分だけ取りこぼしが減っています。
一方でRecall@1は0.481のまま伸びていません。ハイブリッド検索が増やすのは「候補の中に正解が含まれる割合」で、「1位が正しい割合」は別の工程で上げる必要があるということです。RAGでLLMに上位数件を渡す設計なら前者が効きますし、1件だけ見せる設計なら後者を詰める必要があります。
重みを付ける。弱いほうの検索を弱く入れる
片方が明らかに強いと分かっている場合は、統合時に重みを変えます。先ほどの表で、BM25側の重みを1.0から0.3、0.1へ下げると、Recall@1が0.889、0.926、0.963と回復しました。識別子クエリの13件はどの重みでも1位を保ったままです。弱いほうを弱く入れると、強いほうの1位を崩さずに、弱いほうが拾える正解だけを足せます。
Azure AI Searchは、この重み付けを機能として持っています。ベクトルクエリに乗数を掛けられ、既定値は1.0、0.5にすると統合後の順位での重要度が下がると説明されています。
ただし重みは、クエリ集合を作って測らないと決められません。手順としては次のようになります。
- 自分の業務のクエリを30件程度集め、正解の文書を人手で決める。ここを飛ばすと、以降の調整は勘になります
- BM25単体、ベクトル検索単体をそれぞれ測る。どちらがどの種類のクエリで外しているかを見ます
- 片方だけが拾えている正解の件数を数える。0件に近ければ、ハイブリッド検索は入れません
- 重みを1対1から始めて、弱いほうを下げる方向に振る。kは60のまま動かしません
- 業務で見せる件数(top-1なのかtop-5なのか)に対応する指標で判断する。Recall@1とRecall@10は別の話です
検索エンジンごとのハイブリッド検索の実装
自分で実装しなくても、主要な検索エンジンはハイブリッド検索を機能として持っています。
- Elasticsearch:
rrfリトリーバでBM25クエリとkNNクエリを統合します。rank_constantの既定値は60です。公式ドキュメントは「BM25クエリとELSERクエリの上位文書を組み合わせるのが主な用途」で、「どちらのクエリ単独よりも良い関連性を示す」「チューニングを必要としない」と説明しています - OpenSearch:
hybridクエリと、検索パイプラインの正規化プロセッサで統合します。RRFのほかにスコアの正規化による統合も選べます - Azure AI Search:フルテキストクエリとベクトルクエリを同じリクエストで投げると、自動的にRRFで統合されます。ベクトル側に重み乗数を指定できます
- PostgreSQL(pgvector):全文検索とベクトル検索を別々に実行し、順位を取り出してアプリケーション側でRRFを計算します。本記事で示した数行の実装がそのまま使えます
なお、Elasticsearchの公式ドキュメントが書いている「チューニングを必要としない」は、kの調整が不要という意味であって、効果の検証が不要という意味ではありません。前節の測り方で、自分のデータでの効き幅を先に確かめてください。
ここまでハイブリッド検索の判断手順を見てきましたが、「毎回こうした判断を1人で決めていて、それが妥当かどうかを確かめてくれる相手が社内にいない」という方も多いと思います。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座 Advanced は、Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムです。LLMアプリケーションの設計、コンテキストエンジニアリング、RAGの検索基盤と生成・運用、評価とLLM-as-a-Judgeまでを、既製のフレームワークに寄せず生のAPIと自作のコードで実装しながら進めます。本記事で行った「測ってから決める」という作業を、毎週の実装課題と現役データサイエンティストのコードレビューを通じて身につけられます。
まずは講座の内容を確認してみてください。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
ベクトル検索の精度が出ないときに見る順番
統合しても足りない場合に、次にどこを触るかの順番を示します。上から順に効果と手間の比が良い順に並べています。
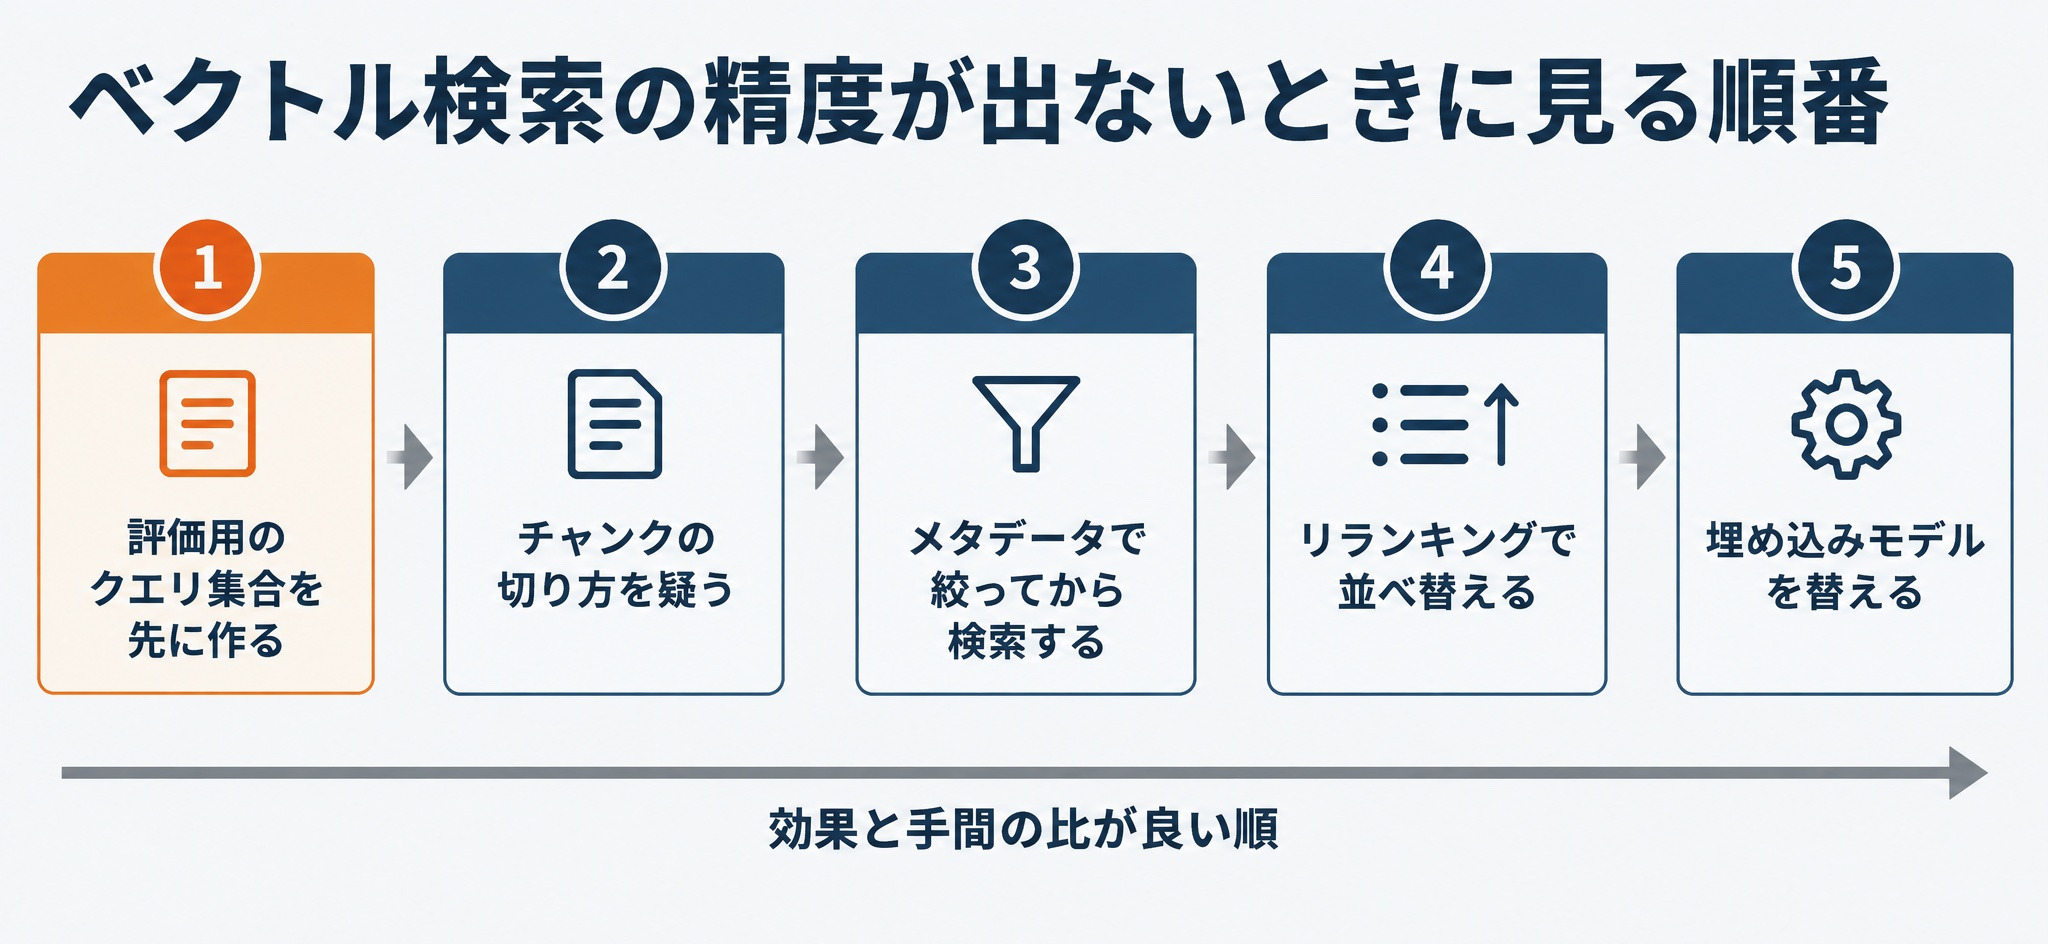
1. 評価用のクエリ集合を先に作る
最初にやるのは、チューニングではなく評価の準備です。業務で実際に来る質問を30件程度集め、それぞれに正解の文書を人手で決めます。この集合が無いと、以降の変更が良くなったのか悪くなったのかを判定できません。
RAG全体の評価指標については、RAGの評価をRagasで行う記事で扱っています。
2. チャンクの切り方を疑う
ベクトル検索が外す原因で多いのが、文書の切り方です。1つのチャンクに話題が複数入っていると、埋め込みベクトルがそれらの平均のような位置に落ち、どのクエリからも中途半端な距離になります。逆に細かく切りすぎると、前後の文脈が失われて意味が取れなくなります。
目次や章節の区切りを壊さずに切る、表は行単位で切らずに見出し行を各チャンクに複製する、といった処理が効きます。
3. メタデータで絞ってから検索する
文書種別、部署、有効期間といったメタデータで母集団を絞ってから検索すると、精度と速度の両方が改善します。「就業規則から探す」と分かっているクエリに対して、製品マニュアル1,000件を候補に含める理由はありません。
近似索引を使っている場合は、絞り込みと索引の相性に注意が要ります。絞り込みが強すぎると、索引がたどった候補の大半が条件から外れ、結果の件数が足りなくなることがあります。
4. リランキングで並べ替える
前章で見たとおり、ハイブリッド検索が増やすのは候補の中に正解が含まれる割合です。1位の精度を上げたいなら、上位20件から50件をクロスエンコーダで並べ直すリランキングを足します。クエリと文書を1組ずつモデルに入れて関連度を出す方式なので、精度は上がりますが計算量も増えます。だから全件ではなく上位数十件にだけ適用します。
5. 埋め込みモデルを替える
ここまでで足りなければ、埋め込みモデルを替えます。本記事の実測で示したとおり、モデルの差はRecall@1で1.000と0.481という開きになりました。ただし、替えると全文書のベクトルを作り直すことになるので、1から4を試したあとの手段です。
検索が外した文書をLLMに渡せば、生成の側でも誤りが出ます。検索の失敗が回答の誤りにつながる仕組みは、AIのハルシネーションを扱った記事で整理しています。
ベクトル検索をどこに置くか。既存のデータベースと検索エンジンの選択肢
改善の順番が決まったところで、ベクトルをどこに置くかを決めます。判断軸は、いま何を使っているか、全文検索を併用するか、件数はどれくらいか、の3つです。
| 置き場所 | 向いている条件 | 押さえておく点 |
|---|---|---|
| PostgreSQL(pgvector) | すでにPostgreSQLを使っている。数万から数十万件 | 既定は全探索で完全な再現率。索引はHNSWとIVFFlat。索引を張れるのは2,000次元まで |
| Elasticsearch・OpenSearch | 全文検索をすでに運用している。ハイブリッド検索を組む | BM25とkNNを同じクエリで投げてRRFで統合できる。HNSWはメモリに載せる前提 |
| 専用のベクトルデータベース | 数千万件以上、またはベクトル検索が主用途 | 量子化や分散の機能が厚い。運用対象が1つ増える |
多くの社内ナレッジ検索は、数万から数十万チャンクの規模に収まります。この規模なら、いま使っているデータベースや検索エンジンに機能を足すほうが、運用の手数が増えません。社内ナレッジの整理そのものは、ナレッジベースの作り方の記事にまとめています。
ベクトル検索の要点整理
- ベクトル検索とは、文書とクエリを同じ埋め込みモデルでベクトルに変え、近さの順に並べる検索。語の一致を見ない点が全文検索との違い
- 全文検索とベクトル検索は、当たる量ではなく外す場所が違う。1,844件のコーパスで、BM25は識別子クエリ13件すべてを1位にした一方、言い換えクエリでは正解を201位や1,226位に落とした
- 近似索引は再現率と時間を交換する道具。
nprobeを1から64へ上げると走査件数は52倍になり、recall@10は0.776から0.947までしか伸びなかった - 数万件なら全探索のままでよい。20万件・384次元の全探索は1クエリ9.65ミリ秒だった
- ハイブリッド検索は常に効くわけではない。この条件ではRRFの統合(重み1対1)がRecall@1 0.889で、ベクトル検索単体の1.000を下回った
- 入れる前に、片方だけが拾えている正解の件数を数える。今回は0件で伸びしろが無く、弱い埋め込みモデルに替えると12件になり、統合後のRecall@10が1.000へ上がった
- ハイブリッド検索が増やすのは候補に正解が入る割合で、1位の精度はリランキングで詰める
ベクトル検索とRAGの設計を体系的に学ぶなら「Craft College」へ
本記事で扱ったのは、検索方式を並べて測り、数値を根拠に選ぶという作業でした。実務でこの次に来るのは、その判断を一度きりで終わらせず、評価用のクエリ集合を資産として持ち、変更のたびに測り直す仕組みです。
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced を提供しています。Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムで、LLMアプリケーションの設計、コンテキストエンジニアリング、RAG、マルチモーダルAI、評価とLLM-as-a-Judge、AIエージェントとマルチエージェント、LLMセキュリティ、ローカルLLM、ファインチューニング、卒業制作までを扱います。既製のフレームワークに寄せず、生のAPIと自作のコードで骨格を実装するのが方針です。毎週の実装課題には現役データサイエンティストのコードレビューが付き、少人数のコホートで進みます。
機械学習の基礎から始めたい方には、9ヶ月36週のデータサイエンティスト養成講座があります。AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に進む構成です。経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座で、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。支給の可否は最終的にハローワーク等が判断します。
リベルクラフトでは、AI開発・データサイエンス開発の支援も行っています。社内文書を対象にした検索基盤の設計、評価用データの作り方、精度が出ないときの原因の切り分けまで、要件定義からPoC、本番運用までを一貫して支援しています。自社のデータで何から手をつけるかを決める段階からご相談いただけます。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
⇨AI開発・データサイエンス開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。