RAGとは。生成AIに社内データを答えさせる仕組みと精度を左右する検索の設計
社内の規程やマニュアルを生成AIに読ませて、問い合わせに答えさせたい。そう考えて調べるうちにRAGという言葉にたどり着いた方も多いのではないでしょうか?
ただ、調べるほど「作ってみたが精度が出ない」という話も一緒に出てきます。そしてこの精度の問題は、ほとんどの場合、回答を書く生成AIの側ではなく、社内データを探す検索の側で起きています。
生成AIの利用そのものは広がっています。総務省の令和7年版 情報通信白書によると、何らかの業務で生成AIを利用していると回答した日本企業の割合は55.2%、生成AIの活用方針を定めている企業は49.7%(2023年度調査は42.7%)でした。一方、導入に際しての懸念事項として最も多く挙がったのは「効果的な活用方法がわからない」です。使い始めたものの、自社の業務に効く形に落とし込むところで止まっている企業が多い状況を示しています。
そこで本記事では、
- RAGとは何か。生成AI単体と何が違い、なぜ必要になるのか
- RAGの仕組み。事前の準備と、質問してから回答が返るまでの流れ
- ファインチューニングとの違いと、どちらを選ぶかの判断
- 社内で成果が出やすい業務と、RAGに向かない仕事
- 精度が出ない原因を、探せていない・渡せていない・読めていないの3層に分けて特定する方法
- 導入にあたって社内で最初に決める5つのこと
を解説します。
RAGとは。生成AIに社内データを検索させて回答の根拠にする仕組み
RAGの定義。検索拡張生成という日本語訳が示すもの
RAGとは、生成AIが回答を作る前に社内データなどの外部の情報を検索させ、その検索結果を根拠として回答を作らせる仕組みです。Retrieval(検索)、Augmented(拡張)、Generation(生成)の頭文字を取った略称で、日本語では検索拡張生成と訳されます。読み方は「ラグ」です。
名前の3語が、そのまま処理の順番になっています。まず質問に関係する文書を検索し、見つかった文書を質問文に付け足してAIへの指示を拡張し、その内容を踏まえて回答を生成します。
AWSの解説でも、RAGは「応答を生成する前に、トレーニングデータソース以外の信頼できる知識ベースを参照する」処理として説明されています(RAG (検索拡張生成) とは何ですか?)。学習し直すのではなく、答える直前に参照先を見に行く、という点が要になります。
RAGが必要な理由。生成AI単体は社内の情報を知らない
ChatGPTのような生成AIは、公開されている大量のテキストから言葉のつながりを学んでいます。そのため一般的な知識には答えられますが、次の3つは扱えません。
- 社内にしかない情報を知らない。自社の就業規則、製品の仕様書、過去の議事録は学習データに入っていません
- 学習した時点より後のことを知らない。組織変更や新しい規程は反映されていません
- 知らないことを、それらしい文章で答えてしまう。この現象はハルシネーションと呼ばれます
3つ目がとくに厄介です。誤りが自信のある文体で出てくるため、読んだ側が気づけません。ハルシネーションが起きる仕組みと対策はAIのハルシネーションとはで詳しく扱っています。
RAGは、この3つに対して「答える直前に、信頼できる文書を渡す」という解き方をします。モデルを作り直さず、渡す資料を差し替えることで対応する方法です。LLMそのものの仕組みについてはLLMとは何か。仕組みと種類、企業での活用方法をわかりやすく解説をあわせてご覧ください。
RAGという言葉の出どころ。2種類の記憶を組み合わせる
RAGという呼び方は、2020年の論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(arXiv:2005.11401)で提案されたものです。
この論文は、学習済みのモデルが内部に持っている知識をパラメトリックメモリ、外部のデータベースから引いてくる知識を非パラメトリックメモリと呼び、この2種類の記憶を組み合わせる構成を示しました。実験では、Wikipediaの記事をベクトルの索引にしておき、質問に応じて関連箇所を引いてから文章を生成しています。
この「2種類の記憶」という整理は、後で出てくるファインチューニングとの違いを考えるときにそのまま使えます。モデルの中に覚えさせるのか、外に置いて引きにいくのか。RAGは後者を担当する技術です。
RAGの仕組み。事前の準備と、質問してから回答が返るまでの流れ
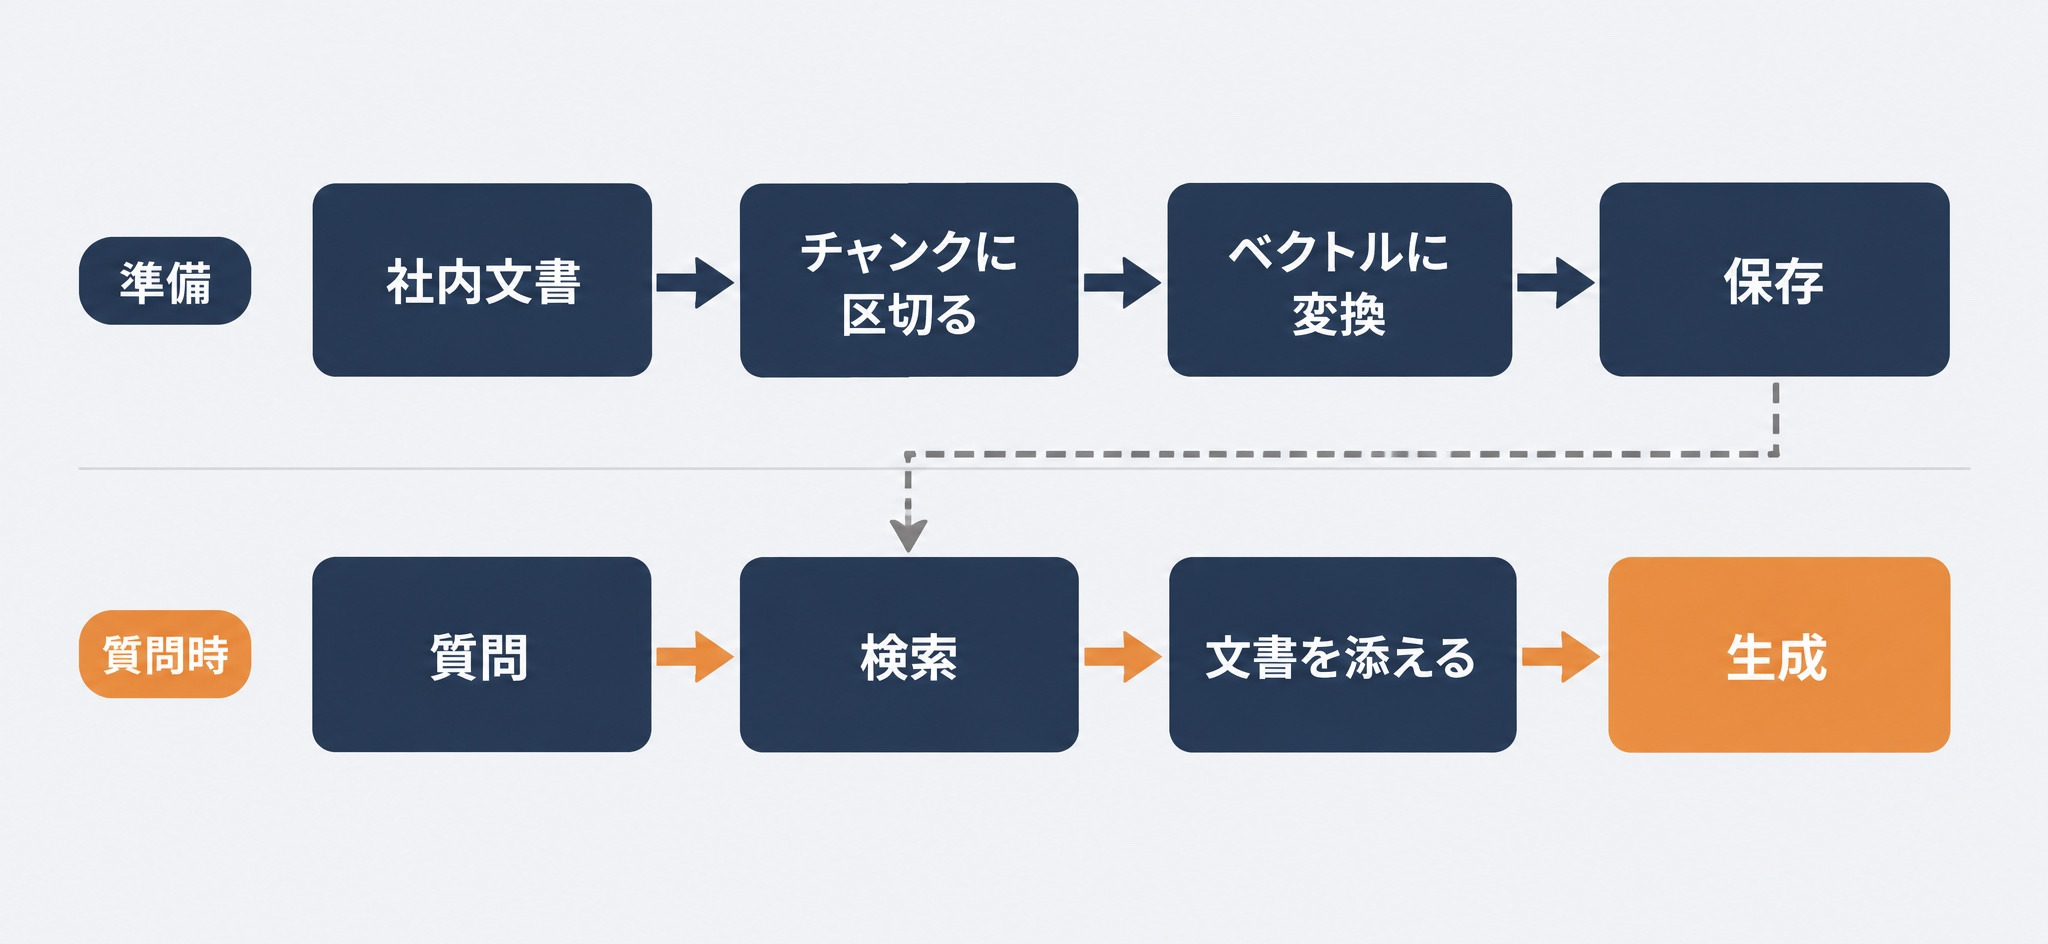
RAGが何をするものかを示したので、次はその中で何が起きているのかを見ていきます。RAGの処理は、質問を受ける前に済ませておく準備と、質問を受けてから走る処理の2つに分かれます。この2つを分けて理解しておくと、後で精度の話をするときに原因の場所を言い当てやすくなります。
事前の準備。社内文書を区切ってベクトルに変換しておく
準備の工程は4段階です。
- 対象の文書を集める。規程集、マニュアル、FAQ、過去の問い合わせ記録などを1か所に集めます
- チャンクに区切る。チャンクとは、検索の単位として文書を区切った断片のことです。1件の文書をまるごと渡すと量が多すぎるため、段落や章節の単位に切り分けます
- ベクトルに変換する。各チャンクを、意味の近さを数値の並びで表したベクトルに変換します。この変換に使うモデルを埋め込みモデルと呼びます
- 保存する。変換したベクトルを、大量のベクトルから似たものを高速に探せるデータベースに入れておきます
ベクトルにしておく利点は、言葉が一致しなくても意味が近ければ探せる点にあります。「有給の申請方法」と書かれた質問に対して、「年次有給休暇の届出手続」という見出しの文書を引ける、という具合です。生成AIが文章を扱う仕組みそのものについては生成AIの仕組みとはで整理しています。
質問時の流れ。検索・拡張・生成の3ステップ
利用者が質問を投げてから回答が返るまでは、次の3段階です。
- 検索(Retrieval)。質問文も同じ埋め込みモデルでベクトルに変換し、保存しておいたチャンクの中から近いものを数件から数十件取り出します
- 拡張(Augmented)。取り出したチャンクを、質問文と一緒にAIへの指示文へ組み込みます。「以下の資料だけを根拠にして答えてください」といった条件もここで付けます
- 生成(Generation)。AIが渡された資料を読んだうえで回答を作ります。どの文書を根拠にしたかを一緒に出力させれば、利用者が出典をたどれます
出典を示せることは、業務で使ううえで大きな違いになります。回答が正しいかどうかを、読んだ人がその場で確かめられるからです。
ragシステムの構成部品。検索側と生成側に分けて考える
RAGをシステムとして組むとき、必要になる部品は検索側と生成側に分かれます。
- 検索側:文書を取り込む処理、チャンクに区切る処理、埋め込みモデル、ベクトルデータベース、検索の実行とアクセス権限の制御
- 生成側:大規模言語モデル、指示文の組み立て、出典の付与、利用者向けの画面
このうち、手をかける量が多いのは検索側です。生成側は既存のモデルとサービスを使えば済む部分が大半ですが、検索側は自社の文書の状態に合わせて作り込む必要があります。RAGとLLMの役割分担はRAGとLLMの違いで扱っています。
RAGとファインチューニングの違い。社内データの扱い方で選び分ける
仕組みが分かると、社内データをAIに反映するもう1つの方法との違いが問題になります。ファインチューニングです。
変えている対象が違う。知識を足すのか、答え方を変えるのか
ファインチューニングとは、既存のモデルに自社のデータを追加で学習させ、モデルそのものを調整する方法です。先ほど触れた2種類の記憶でいえば、ファインチューニングはモデルの中に覚えさせる側を担当します。詳しい仕組みはファインチューニングとはをご覧ください。
両者の性質はここから素直に導けます。RAGは外の資料を差し替えるだけなので、文書を更新すれば次の質問からその内容が反映されます。ファインチューニングは学習をやり直すため、反映には時間と費用がかかります。一方で、業界特有の言い回しや決まった書式で答えさせたい場合は、資料を渡すだけでは足りず、ファインチューニングのほうが向きます。
どちらを選ぶか。4つの条件で判断する
自社がどちらを選ぶかは、次の4つで判断できます。
| 判断の条件 | RAGが向く場合 | ファインチューニングが向く場合 |
|---|---|---|
| 情報の更新頻度 | 規程や価格が頻繁に変わる | 内容が安定していて変わりにくい |
| 出典を示す必要 | 回答の根拠を提示したい | 出典の提示は求められない |
| 変えたいもの | 知っている内容を増やしたい | 口調・書式・専門的な言い回しを変えたい |
| データの状態 | 文書として読める形で存在する | 質問と回答の組が大量に蓄積されている |
表の4行のうち、社内の問い合わせ対応やマニュアル検索はほぼすべてがRAG側に当てはまります。最初の1件でファインチューニングから入るケースは多くありません。なお、この2つは排他ではなく、答え方をファインチューニングで整えたうえでRAGで知識を渡す構成も取れます。両者の比較はRAGとファインチューニングの違いでさらに詳しく扱っています。
RAGで成果が出やすい業務。社内データが答えを持っている仕事
どちらを選ぶかが決まったら、次はどの業務に当てるかです。RAGが効く業務には共通点があります。答えがすでに社内の文書の中にあり、それを探すのに時間がかかっている仕事です。
社内の問い合わせ対応。規程や手続きを探す手間をなくす
総務、人事、情報システムへの問い合わせは、多くが「どこかに書いてあることを探す」仕事です。経費精算の期限、休暇の申請方法、端末の設定手順。担当者は毎回同じ質問に答え、質問する側は探す場所が分からず担当者に聞きます。
RAGを当てると、規程集とマニュアルを根拠に回答が返り、出典のリンクから原文を確認できるようになります。他社の活用例はRAGの活用事例にまとめています。
カスタマーサポート。回答の根拠を示しながら応答する
製品の仕様、保守条件、過去の不具合とその対処といった情報は、担当者の経験に依存しがちです。RAGを使うと、仕様書と過去の対応履歴を根拠にした回答案をオペレーターに提示できます。
ここで重要なのは、AIに直接回答させるのではなく、担当者が確認したうえで送る形から始めることです。誤りが顧客に直接届く経路を最初から作らないほうが、導入の抵抗も小さくなります。
現場のナレッジ共有。文書になっている知識から着手する
ベテランの判断基準を全社で使いたい、という相談は多く寄せられます。ただし、RAGが扱えるのは文書になっている知識だけです。したがって着手の順番は、すでに文書として存在するものから始め、文書化されていない部分は並行して書き起こしていく形になります。
この整理の進め方はナレッジベースとはとナレッジ管理の進め方で扱っています。
RAGに向かない仕事。答えが文書の中に無い場合
逆に、次の場合は成果が出にくくなります。
- 判断の根拠が文書化されていない。担当者の頭の中にしかない場合、検索しても引けるものがありません。暗黙知をAIで形式知化する方法で先に書き起こす工程が要ります
- 数値を集計して答える必要がある。「先月の受注金額の合計」のような質問は、文書検索ではなくデータベースへの問い合わせの仕事です
- 文書同士が矛盾している。新旧の規程が両方残っていると、検索は両方を引き、AIはどちらが正しいか判断できません
3つ目は導入前の棚卸しで見つかることが多い問題です。RAGを入れる前に、正本がどれかを決める作業が発生します。
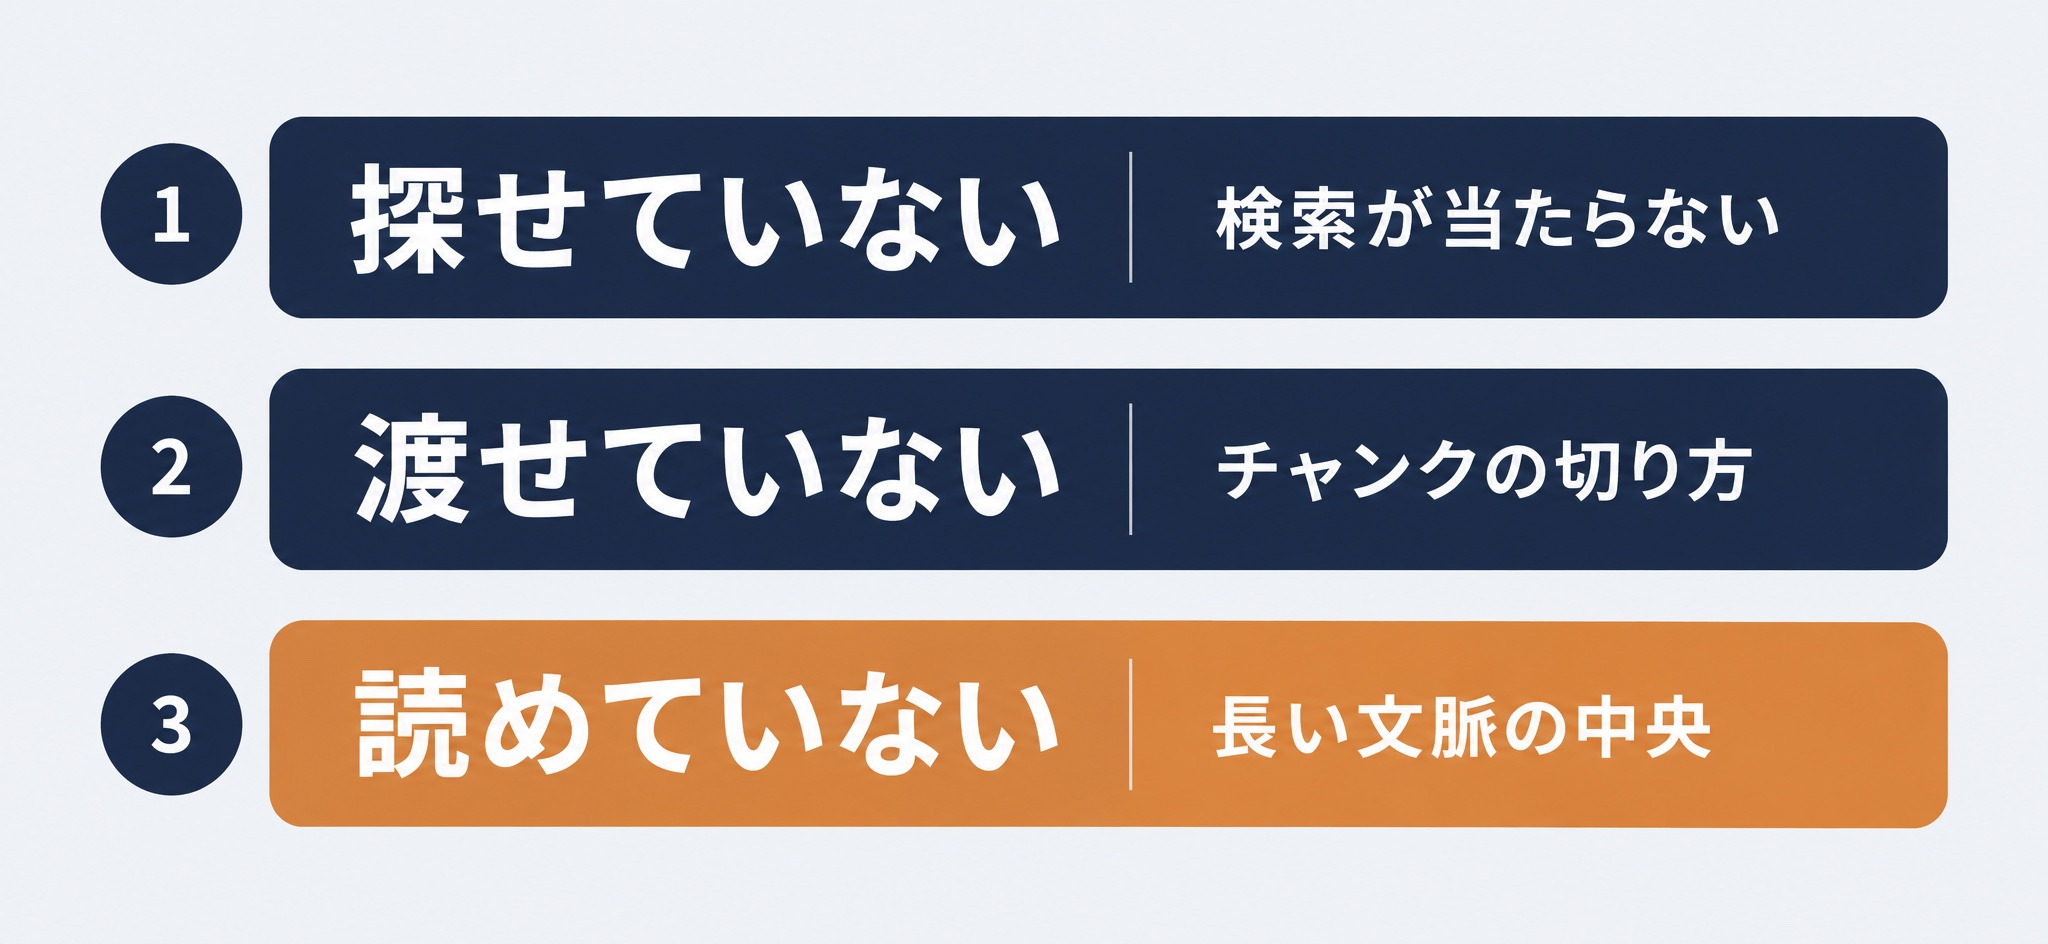
RAGの精度が出ない3つの原因。探せていない、渡せていない、読めていない
業務に当ててみると、多くの現場が同じ壁に当たります。「それらしい回答は返るが、肝心のところを外す」という状態です。このとき生成AIのモデルを変えても改善しないことがほとんどで、原因は検索側の3つの層のどこかにあります。
原因1。探せていない。質問の言葉と文書の言葉が一致しない
最も多いのがこれです。利用者が使う言葉と、文書に書かれている言葉がずれています。
MicrosoftのAzure AI Search のRAG解説は、この問題を分かりやすい例で示しています。利用者が「2023年以降に採用されたリモートワーカー向けのPTOポリシーとは」と尋ねても、文書側には「休暇」「通信中」「最近の採用者」と書かれている。この場合、従来のキーワード検索は失敗します。
日本語ではさらに起きやすくなります。「申請」と書いて探しても、規程側の見出しが「届出」になっていれば引けません。ベクトル検索は意味の近さで探すので一致しなくても拾えますが、社内の略語や製品コードのように、意味ではなく字面で一致させたい語では逆に弱くなります。
原因2。渡せていない。チャンクの切り方で文脈が壊れる
検索では引けているのに、渡した断片が回答に足りていない場合です。
よくあるのは、文字数だけで機械的に区切った結果、表の見出しと中身が別のチャンクに分かれてしまう例です。「適用対象」という列名と「管理職を除く」という値が離れると、AIは誰に適用されるのか判断できません。章や節の区切りを無視して切ると、同じことが文書全体で起きます。
もう1つは順序です。検索で取ってきた候補は、関連度の高い順に並んでいるとは限りません。上位に無関係な断片が混ざったまま渡すと、次の原因3につながります。
原因3。読めていない。長い文脈の中央にある情報は使われにくい
渡してはいるのに、AIがその部分を使っていない場合があります。「多めに渡しておけば当たるはずだ」という対処が効かないのは、この層があるからです。
スタンフォード大学などの研究チームによる論文「Lost in the Middle: How Language Models Use Long Contexts」(arXiv:2307.03172)は、入力の中で関連情報が置かれた位置を変えて性能を測りました。その結果、関連情報が入力の先頭または末尾にあるときに性能が最も高く、中央にあるときには大きく低下することが示されています。長い入力を扱えるモデルであっても、中央の情報を安定して使えているわけではありません。
したがって、候補を大量に渡す対処は逆効果になり得ます。関連の高いものを絞って上位に置くほうが、結果として当たります。
自社の症状から原因を切り分ける手順
どの層で落ちているかは、症状から当たりをつけられます。
| 症状 | 考えられる原因の層 | 最初に確認する場所 |
|---|---|---|
| 「分かりません」と返る、無関係な文書を根拠に挙げる | 原因1(探せていない) | 検索結果だけを取り出し、正解の文書が候補に入っているか |
| 根拠の文書は合っているが、回答の内容が足りない | 原因2(渡せていない) | 渡したチャンクの本文に、答えに必要な記述が含まれているか |
| 正しい文書も渡っているのに、別の箇所を引用して答える | 原因3(読めていない) | 渡した候補の件数と、正解の断片が何番目に置かれていたか |
切り分けの順序は表の上から下です。まず検索結果だけを取り出して目で見るところから始めます。これをせずに指示文の書き方を調整し続けると、検索が引けていない問題を生成側で直そうとすることになり、時間だけが過ぎます。
ここまでRAGの精度が出ない原因を解説しましたが、「社内データでRAGを作ってみたが精度が出ず、どこを直せばよいか分からない」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、3つの層のどこで落ちているかを実際の検索結果から特定し、検索の設計をやり直す支援が可能です。ただ、構築するだけでなく、評価の仕組みも一緒に作るため、改善したかどうかを数字で確かめながら運用できます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
RAGの精度を上げる設計。検索の作り方でほとんど決まる
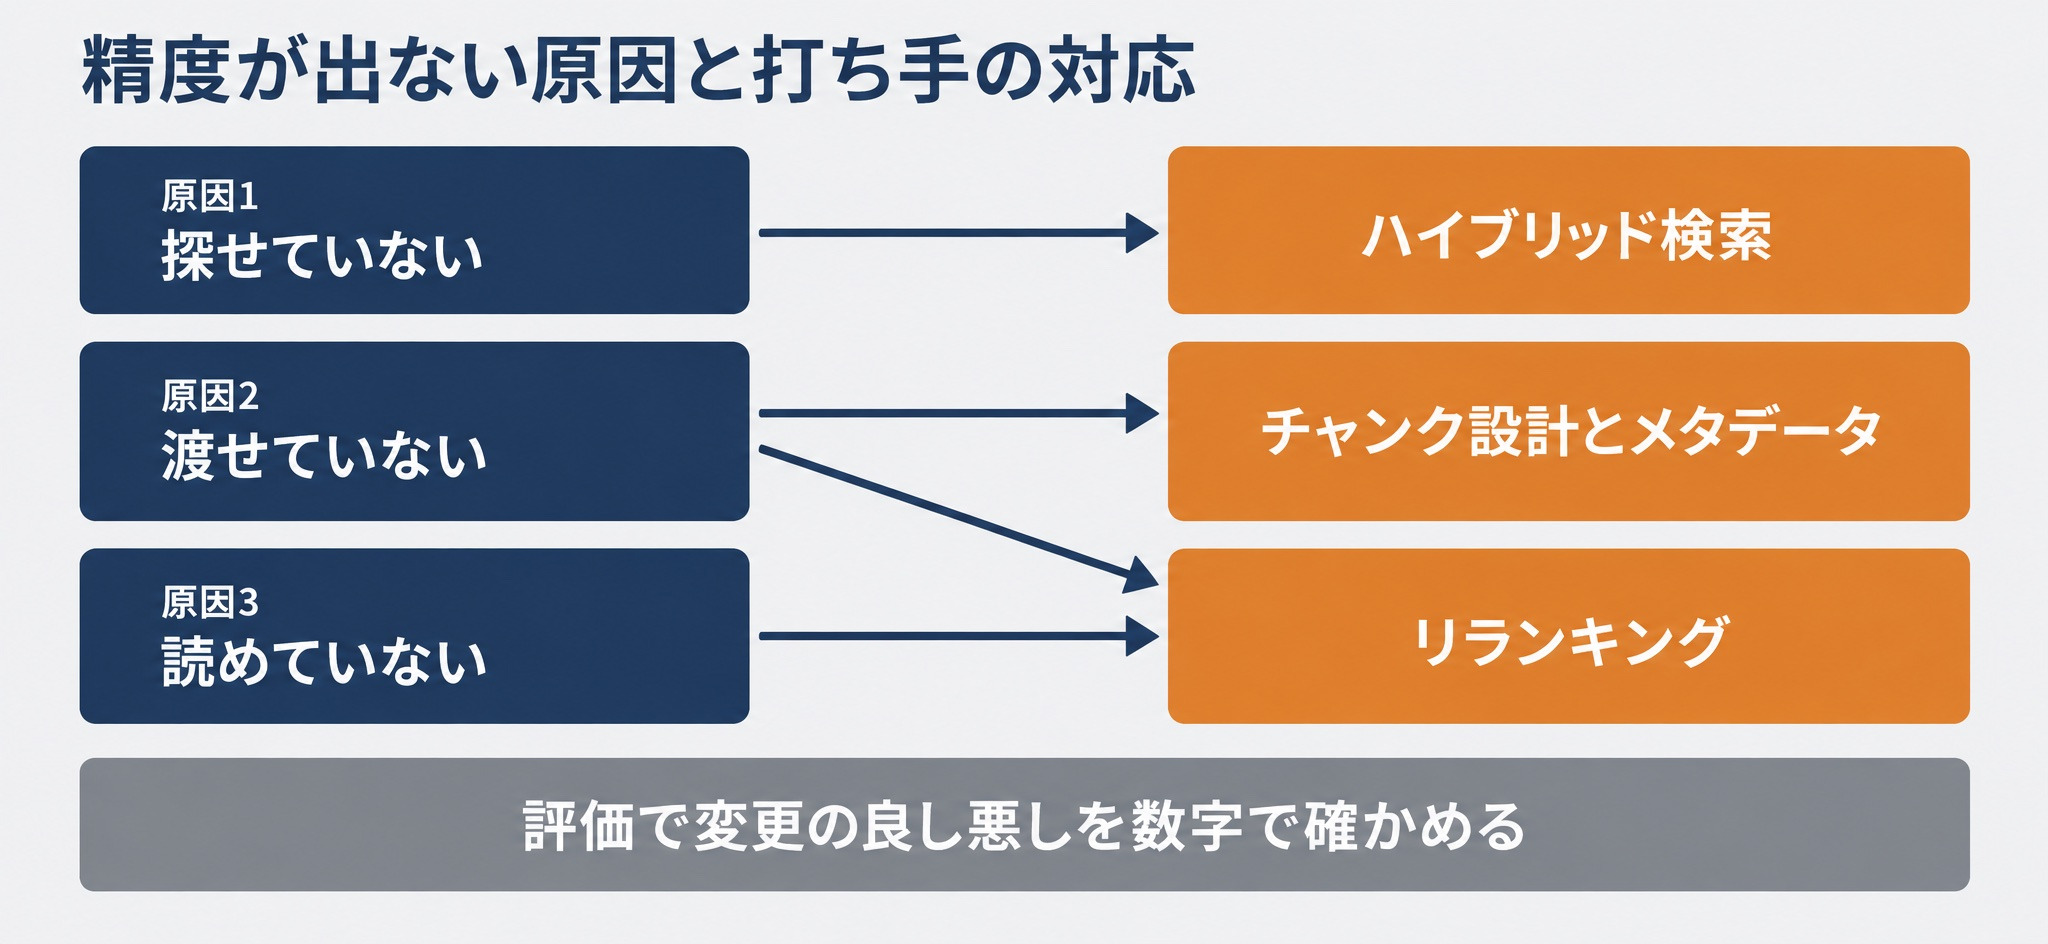
原因が3つの層に分かれるなら、打ち手も層ごとに分かれます。ここでは各層に対応する設計を順に見ていきます。
ハイブリッド検索。キーワード検索とベクトル検索を組み合わせる
原因1への打ち手です。2つの検索方式には、それぞれ得意と不得意があります。
| 検索方式 | 得意なこと | 苦手なこと |
|---|---|---|
| キーワード検索 | 型番・略語・法令名など、字面が一致する語を確実に引く | 言い換えや同義語で聞かれると引けない |
| ベクトル検索 | 「有給の申請」と「年次有給休暇の届出」のように意味が近い文を引く | 社内の略語や固有のコードで精度が落ちる |
| ハイブリッド検索 | 両方を並行して実行し、結果をまとめる | 設定する項目が増え、調整の手間がかかる |
表のとおり、2つは弱点が逆になっています。だから片方だけでは穴が残り、両方を走らせて結果を統合するハイブリッド検索が実務の既定の選択になります。前掲のMicrosoftの解説も、取りこぼしを減らすためにキーワード検索とベクトル検索を組み合わせたクエリを推奨しています。
リランキング。取ってきた候補を並べ替えてから渡す
原因2と原因3への打ち手です。検索で多めに候補を取り、そのうえで質問との関係の強さを改めて評価し、上位のものだけを渡します。この並べ替えをリランキングと呼びます。
「多く取る」と「少なく渡す」は矛盾しません。取る段階では取りこぼしを減らすために広く拾い、渡す段階では中央に埋もれさせないために絞る、という役割分担です。
チャンク設計とメタデータ。文書の構造を壊さずに区切る
原因2への打ち手です。区切り方については、次の3つが実務でよく効きます。
- 文書の構造に沿って区切る。文字数ではなく、章・節・表の単位で切ります
- 前後を少し重ねる。隣り合うチャンクの境目を数十文字ほど重ねると、文の途中で切れても意味が追えます
- メタデータを付ける。文書名、改訂日、対象部署、公開範囲をチャンクに持たせておくと、検索時に絞り込みができ、古い版を引く事故も減らせます
改訂日のメタデータは、先に挙げた「新旧の規程が両方引ける」問題への直接の対処にもなります。
評価。変更の良し悪しを数字で確かめる
最後に、ここまでの打ち手が効いたかどうかを確かめる仕組みが要ります。評価が無いまま設定を変え続けると、良くなったのか悪くなったのかが分からなくなります。
最小の形は、業務側の担当者に実際の質問と期待する回答を30件から50件ほど作ってもらい、変更のたびに同じ質問を流して結果を比べる、というものです。評価の指標と自動化の方法はRAGの評価とRagasで扱っています。
RAGの導入の進め方。社内で最初に決める5つのこと
打ち手が分かっても、その前に社内で決めることがあります。ここを飛ばしてツールの選定から入ると、後戻りが増えます。順番に見ていきます。
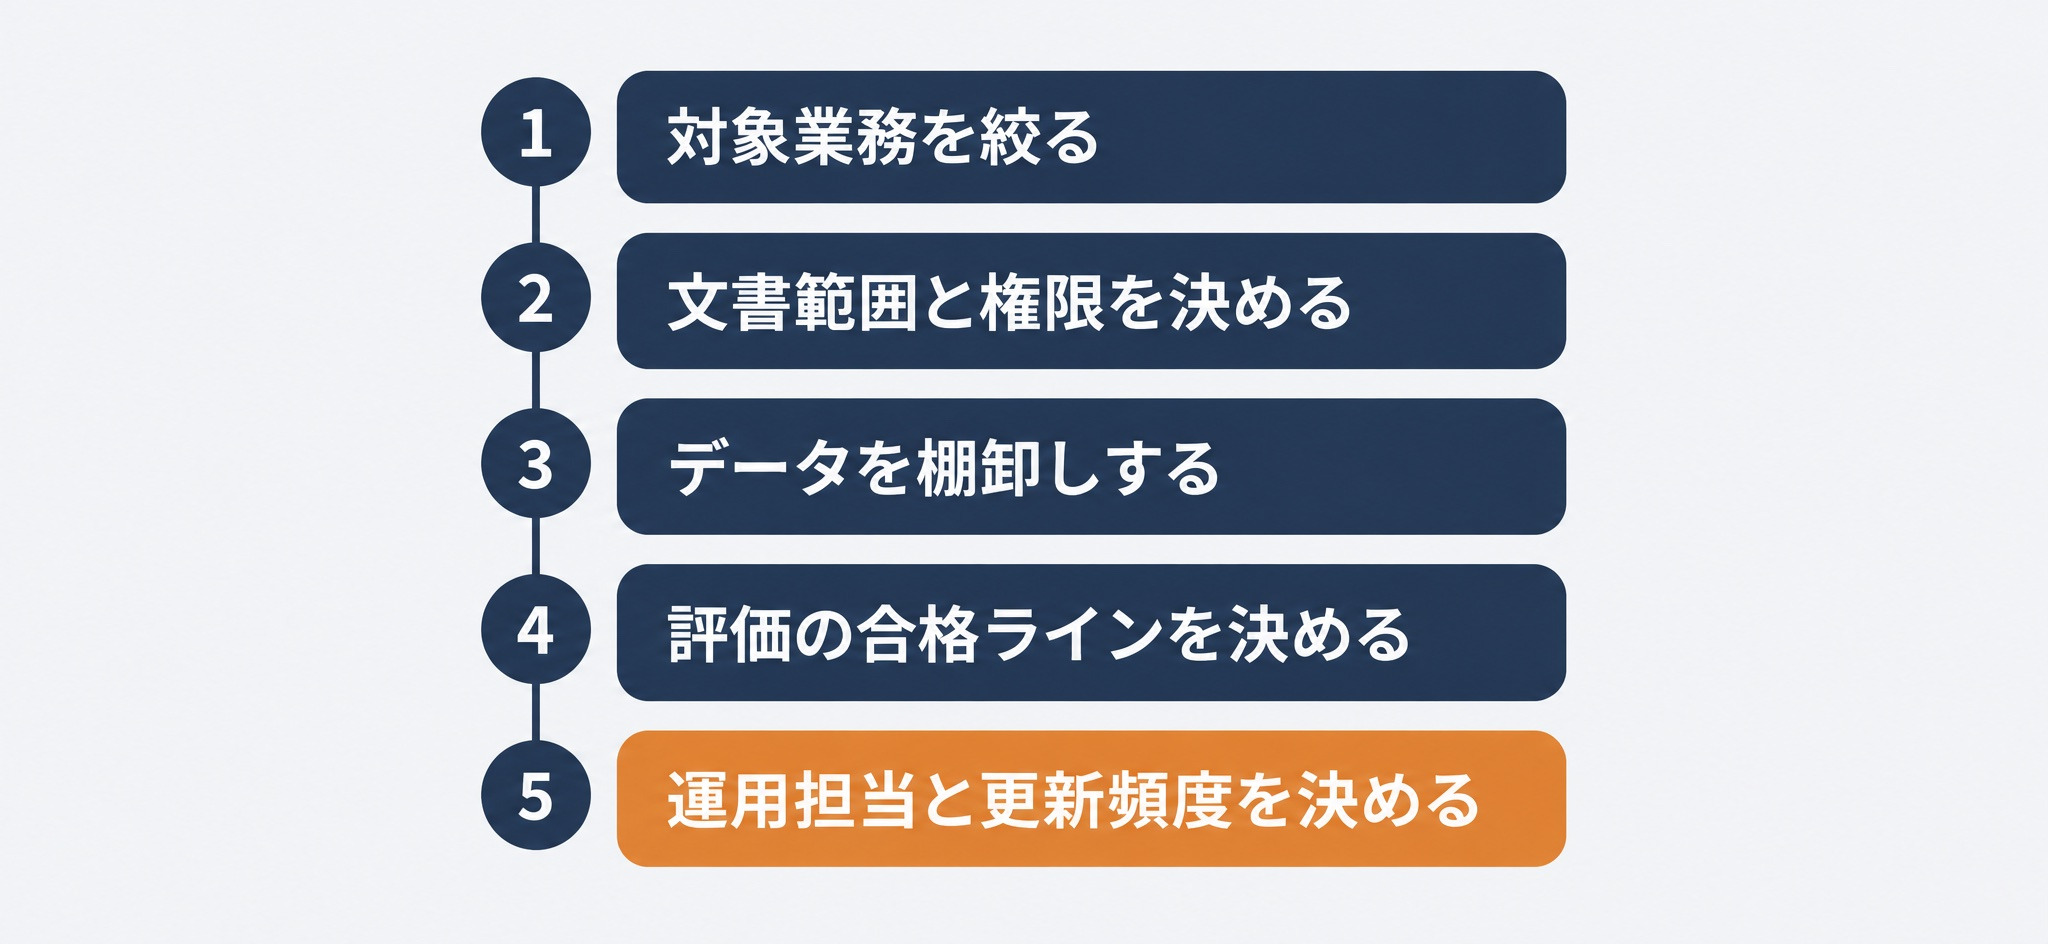
- 対象業務を1つに絞る。推進担当が、どの業務を対象にするかを利用部門の責任者と一緒に決めます。全社共通の何でも答えるAIから始めると、対象文書が膨大になり評価もできません。最初は「人事規程に関する問い合わせ」のように範囲を切ります
- 読ませる社内データの範囲とアクセス権限を決める。情報システム部門と利用部門で、どの文書を対象にするか、誰が何を見てよいかを決めます。権限の制御は後付けが難しいため、この範囲と権限の2点は着手前に決めておきます。詳細はRAGのセキュリティをご覧ください
- 対象文書の状態を棚卸しする。利用部門が、対象の文書について正本がどれかと、最終更新日を洗い出します。ここで新旧の重複や、紙のままの資料が見つかります。社内データの整え方はRAGで社内データを活用する方法で扱っています
- 評価のやり方と合格ラインを決める。利用部門が実際の質問と期待する回答を30件から50件作り、何割を正しく答えられたら次に進むかを決めます。これをPoCの開始前に決めておくと、結果の解釈で揉めません。PoCの進め方はAIのPoCとはで整理しています
- 運用の担当と更新の頻度を決める。規程が改訂されたときに誰がデータを入れ替えるか、どれくらいの頻度で見直すかを決めます。ここが決まっていないと、半年後に古い回答を返すシステムになります
5つのうち、決めるのに最も時間がかかるのは2と3です。RAGの導入が長引くケースの多くは、技術の問題ではなく、文書の正本とアクセス権限が社内で決まっていないことが理由になっています。1つの業務で成果を出したあとに社内の他部署へ順に広げていく段取りは、生成AIの全社導入の進め方で扱っています。
RAGのこれから。ロングコンテキストとAIエージェントとの関係
導入の段取りが見えたところで、この先どうなるのかを押さえておきます。
長い文脈を読めるモデルが出てもRAGが要る理由
近年のモデルは、一度に読み込める文章量が大幅に増えました。そのため「社内文書を全部渡せばRAGは不要では」という問いが出てきます。ただ、次の3点から、当面は検索を挟む構成が残ります。
- 中央の情報が使われにくい。前掲のLost in the Middleが示したとおり、渡す量を増やすほど、真ん中に置かれた情報は使われにくくなります
- 費用が量に比例する。質問のたびに大量の文章を読ませると、その分だけ処理の費用と応答時間が増えます
- アクセス権限を制御できない。全文を渡す方式では、その利用者が見てよい文書だけに絞るという制御が効きません
3つ目は企業利用では外せない条件です。検索の段階で権限による絞り込みを入れられることが、RAGを使う実務上の理由になっています。閉じた環境での構成はローカルLLMとRAGの組み合わせで扱っています。
エージェント型のRAG。検索を1回で終わらせない
もう1つの方向が、検索を1回で終わらせない構成です。ここまで説明してきたRAGは、質問を受けて1回検索し、1回答える形でした。これに対し、AIが自分で検索の回数と内容を決める方式が出てきています。
たとえば、最初の検索結果が不十分だと判断したら質問を言い換えて検索し直す、複数の観点に分けて別々に検索してから統合する、といった動きです。この形はAgentic RAGと呼ばれ、Agentic RAGとはとLangGraphで作るCorrective RAGで扱っています。
ただし、この方式に進む前提として、1回の検索が機能している必要があります。検索が引けていない状態で回数を増やしても、外した結果が増えるだけです。まずは基本の構成で精度を出すことが先になります。
まとめ
- RAG(検索拡張生成)とは、生成AIが回答を作る前に社内データなどを検索させ、その内容を根拠に回答を作らせる仕組み
- 生成AI単体は社内の情報を知らず、学習時点より後のことも知らず、知らないことをそれらしく答えてしまう。RAGは答える直前に資料を渡すことでこれに対処する
- 処理は事前の準備(文書を集める、チャンクに区切る、ベクトルに変換して保存する)と、質問時の3ステップ(検索・拡張・生成)に分かれる
- 情報が頻繁に変わり、出典を示したい場合はRAG。口調や書式を変えたい場合はファインチューニング
- 精度が出ない原因は、探せていない・渡せていない・読めていないの3層に分かれる。まず検索結果だけを取り出して目で見て、どの層で落ちているかを特定する
- 打ち手は層ごとに、ハイブリッド検索・リランキング・チャンク設計とメタデータ。効いたかどうかは評価用の質問セットで確かめる
- 導入で最初に決めるのは、対象業務・文書範囲とアクセス権限・文書の棚卸し・評価の合格ライン・運用担当の5つ
最初に手をつけるのは、ツールの選定ではなく、対象業務を1つに絞ることです。
RAGの導入相談は「リベルクラフト」へ
ここまで読んで、「仕組みと進め方は分かったが、自社の文書でどこまで精度が出るのか、何から着手すべきかまでは決めきれない」と感じた方も多いのではないでしょうか?
リベルクラフトでは、戦略・構想の立案、AIシステムのものづくり、社内人材を育てる教育・スクールの3軸で、企業のAI・データ活用の内製化を支援しています。RAGについても、対象業務の選定から社内データの整理、検索の設計、評価の仕組みづくり、本番運用までを一貫してお受けしています。
次のようなニーズをお持ちの方に適しています。
- 社内データを使ったAIの導入を検討していて、進め方から相談したい
- すでにRAGを作ったが精度が出ず、どこを直せばよいか切り分けたい
- 自社でどこまで内製し、どこからを外部に任せるかを整理したい
構想段階のご相談でも問題ありません。自社の社内データをどう扱えばよいか、まずはお気軽にご相談ください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。