GraphRAGとは。インデックス作成の費用を数え、投資に見合う問いを見分ける
GraphRAGを試そうとして最初に当たるのは、精度の話ではなく費用の話です。公式リポジトリのREADMEにも「GraphRAGのインデックス作成は高くつく操作になりうるので、工程と費用を理解したうえで小さく始めてほしい」という警告が置かれています(microsoft/graphrag)。ところが、その費用が何回のLLM呼び出しと何トークンでできているのかを説明した資料は多くありません。
本記事では、費用の内訳を工程ごとに分解します。GraphRAGのうちLLMを呼ばない部分、つまりチャンク分割とコミュニティ検出とトークン計算はローカルで再現できるので、実際に動かした数値を載せます。実行環境は Python 3.13.13・networkx 3.6.1・tiktoken 0.14.0、実行日は2026年9月21日です。GraphRAG本体はLLMのAPIを使うため動かしておらず、APIを要する工程については論文と公式ドキュメントの数値を原文で確認して引用しています。
そこで本記事では、
- GraphRAGとは何か。通常のRAGが外す2種類の問いをどう埋めるのか
- インデックス作成の6工程で、どこでLLMを何回呼んでいるのか
- コミュニティ検出が作る階層は、どれくらいの速さでどれくらい増えるのか
- インデックス作成の呼び出し回数と入力トークンを、自分のコーパスで見積もる方法
- ローカル検索・グローバル検索・DRIFT検索の使い分け
- 費用を下げる3つの手段と、日本語データで気をつける点
- GraphRAGに投資するかを決める手順
を解説します。
ベクトル検索だけでは答えられない問いが社内に出てきていて、次の一手を1人で決めているという方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
GraphRAGとは。グラフとコミュニティ要約を根拠に使うRAG
GraphRAGの定義。LLMがグラフを作り、集団ごとの要約を先に用意しておく
GraphRAGとは、LLMに文書からエンティティと関係を抜き出させてグラフを作り、そのグラフを密につながった集団に分け、集団ごとの要約をあらかじめ生成しておいて、質問に答えるときの根拠に使う仕組みです。Graph RAGと2語で書かれることもあります。
Microsoft Researchが2024年2月13日に公開したGraphRAG: Unlocking LLM discovery on narrative private dataが出発点で、リファレンス実装は2024年7月にオープンソースとして公開されました。2026年9月21日時点の最新版は v3.1.2(2026年8月21日公開・MITライセンス)です。ただしREADMEには、最初の公開以降にモデル側の能力が大きく変わったため、このプロジェクトは保守中心の状態にあり、新機能の追加は受け付けていないと書かれています。仕組みを学ぶ対象としては現役ですが、製品の土台として選ぶ場合はこの位置づけを踏まえる必要があります。
通常のRAGとの違いは、根拠として何を渡すかにあります。RAGと大規模言語モデルの役割分担はRAGとLLMの違いを扱った記事で整理しています。通常のRAGはチャンクの本文をそのまま渡しますが、GraphRAGはインデックス作成の時点でLLMに要約を作らせておき、その要約を渡します。この前倒しが、後で見る費用の増加の正体です。
| 通常のRAG(ベクトル検索) | GraphRAG | |
|---|---|---|
| インデックス作成でLLMを使うか | 使わない(埋め込みモデルのみ) | 全チャンクに対して使う |
| 根拠として渡すもの | 質問に近いチャンクの本文 | エンティティ、関係、集団ごとの要約 |
| 文書をまたぐ問い | 各文書の断片までしか届かない | グラフの経路と要約で届く |
| 全体を見渡す問い | 手がかりが無く検索できない | 集団の要約を畳んで答える |
| データを足したときの作り直し | 足した分だけ埋め込む | グラフと要約の再生成が要る |
表のうち、実務で効いてくるのは1行目と最終行です。インデックス作成にLLMが入る時点で、費用は文書の量に比例して増えます。
通常のRAGが外す2種類の問い。GraphRAGが埋めるのはここ
前掲のMicrosoft Researchの記事は、ベースラインのRAGが苦手とすることを2つ挙げています。1つ目は、共通の属性を通じて別々の情報を結び、新しい洞察を組み立てる作業です。2つ目は、大きなデータの集まりや1つの長い文書について、要約された意味のまとまりを全体として捉える作業です。
論文「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」(arXiv:2404.16130・2024年4月投稿、2025年2月改訂)は、後者をより明確に位置づけています。「このデータ集合の主なテーマは何か」という問いは、そもそも検索の課題ではなく、質問に沿った要約の課題である、という整理です。ベクトル検索は質問に近い断片を返す仕組みなので、近い断片を集めても答えにならない問いには構造的に届きません。
自社のデータで思い当たるものを挙げるなら、「昨年度に対応が長引いた案件に共通する原因は何か」「この製品に関わっている取引先と、その取引先が関わる別の製品は何か」といった形になります。前者が全体を見渡す問い、後者が情報を結ぶ問いです。検索が根拠を集めきれないまま回答を作らせると、もっともらしい誤りが出ます。この現象はAIのハルシネーションを扱った記事で整理しています。
ナレッジグラフとGraphRAGの関係
GraphRAGが内部で作るのはナレッジグラフです。ナレッジグラフとは、現実のモノを点、モノどうしの関係を線として表した知識のデータで、点をエンティティ、線をリレーションと呼びます。
ただしGraphRAGのグラフは、人が設計図を決めて作る従来のナレッジグラフとは成り立ちが違います。オントロジーを人が定義するのではなく、LLMが文書を読みながらエンティティと関係を提案していきます。既定のエンティティ型は organization・person・geo・event の4つだけで、自社の文書に合わせるならここを差し替えることになります。ナレッジグラフそのものの設計や名寄せは、それだけで別の主題なので本記事では扱いません。
GraphRAGのインデックス作成。どこでLLMを何回呼んでいるか
何をする仕組みかが分かったところで、中で何が起きているかに進みます。費用はここで決まります。
GraphRAGのインデックス作成は6つの工程でできています。公式ドキュメントのIndexing Methodsが、標準の方式について工程を列挙しています。
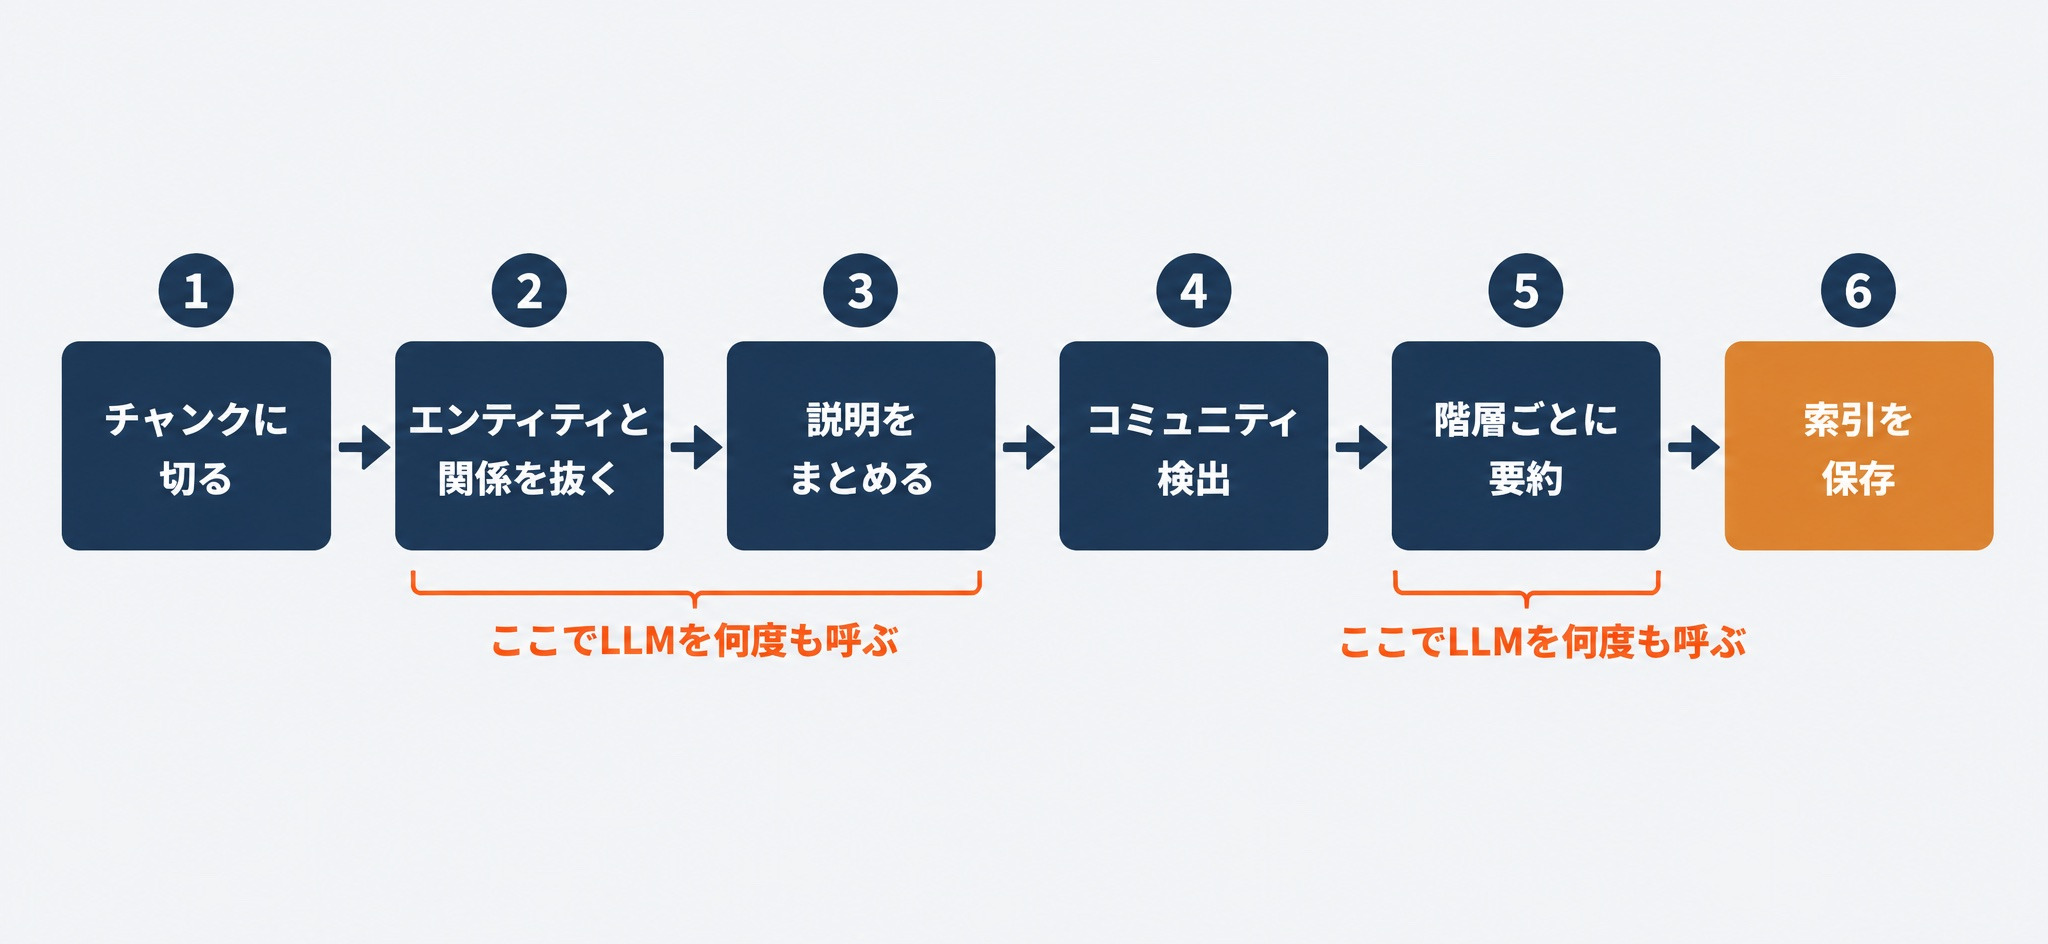
1. 文書をチャンクに切る
最初に文書をトークン単位で切ります。既定値は1チャンク1,200トークン、重なり100トークンです。
チャンクの大きさは、後続のすべての費用を決めます。小さく切れば呼び出し回数が増え、大きく切れば1回あたりの見落としが増えます。論文の付録には、HotPotQAのデータでチャンクを600トークンにしたときと2,400トークンにしたときを比べると、600トークンのほうが抽出されたエンティティ参照がほぼ2倍になったと書かれています。
2. エンティティと関係を抜く。gleaningが呼び出しを倍にする
各チャンクをLLMに渡し、エンティティと、エンティティ間の関係を抜き出させます。それぞれに短い説明文も作らせます。
ここで見落としやすいのが gleaning(拾い残しの回収)です。1回抽出したあと、抽出結果をLLMに戻して「見落としたエンティティはないか」と聞き直す工程が既定で1回入ります。論文では self-reflection として説明されており、大きめのチャンクを使っても品質が落ちないようにするための仕掛けです。設定名は max_gleanings で、既定値は1です。つまり1チャンクにつきLLM呼び出しが2回発生します。
3. 説明をまとめてノードと辺にする
同じエンティティは複数のチャンクから何度も抽出されます。そこで、同じ名前のエンティティの説明をまとめて1つの説明文に要約し、グラフのノードにします。関係も同じようにまとめて辺にし、重複した回数が辺の重みになります。
論文の実装では、同じものを指す別表記の照合に単純な文字列の完全一致を使っています。日本語の社内文書で同じ扱いをすると、表記ゆれがそのまま別ノードになります。ここは手を入れる前提で考えたほうが安全です。
4. コミュニティ検出で階層に割る
出来上がったグラフを、密につながったノードの集団に分けます。使われるのはLeidenです。Leidenは、Louvainが連結でない集団を作ってしまう問題を修正したアルゴリズムで、Traagらの論文「From Louvain to Leiden: guaranteeing well-connected communities」(Scientific Reports 9, 5233・2019年)で提案されました。
重要なのは、1回分けて終わりではないことです。検出した集団の中でさらに部分集団を探す操作を、これ以上分けられなくなるまで繰り返します。こうしてできた各階層が、それぞれグラフの全ノードを重なりなく覆う分割になります。既定では、ノード数が10を超える集団を分割の対象にします。
5. コミュニティレポートを作る
各集団について、所属するエンティティと関係の説明を集め、LLMに報告書の形の要約を作らせます。これがコミュニティレポートで、グローバル検索が読む根拠になります。
レポートは1つの階層だけでなく、すべての階層のすべての集団について作られます。下の階層ほど集団の数が多いので、レポートの本数もそこで増えます。レポート1本あたりの入力は既定で8,000トークンが上限、出力は2,000トークンが目安です。なお、事実の主張を別途抜き出すclaim抽出という工程もありますが、既定では無効になっています。
GraphRAGのコミュニティ検出を動かして、階層の増え方を見る
工程を並べたので、ここからは実際に動かします。LLMを呼ぶ工程は動かせませんが、コミュニティ検出とトークン計算はローカルで完結します。
測定の条件
用意したのは、社内の障害報告と問い合わせ記録を模した日本語の合成コーパスです。在庫管理、受発注、生産ラインの制御装置、社内ネットワーク、人事給与、品質検査の6つの領域について、部署名、ベンダー名、機器の型番、症状、対処を組み合わせた文を1万5000件生成しました。o200k_baseで数えて1,008,250トークンあり、論文が使ったPodcastデータセットとほぼ同じ規模です。乱数のシードはコード中に固定しています。
1つ断っておくと、GraphRAG本体が使うLeidenは手元の環境に入っていないため、networkxのLouvainで代用しています。集団の中をさらに分けて階層を作る手順は同じですが、分割の結果は一致しません。ここで見たいのは正確な集団の中身ではなく、階層を下げたときに要約の対象がどう増えるかという形です。
共起グラフを作る
LLMを使わずにグラフを作るため、公式が用意しているFastGraphRAGと同じ作り方をなぞります。名詞句にあたる語を機械的に拾い、同じチャンクに現れた語どうしを線でつなぐ方式です。公式ドキュメントは、この方式のときチャンクを50から100トークンと小さめにすると共起グラフの質が上がると書いているので、それに合わせます。
import re, time
import networkx as nx, tiktoken
from corpus import build

enc = tiktoken.get_encoding("o200k_base")
SEED = 20260921
ids = enc.encode("\n".join(build(n_docs=15000)))

CHUNKS = []
i = 0
while i < len(ids):
    CHUNKS.append(enc.decode(ids[i:i + 100]))
    i += 80

# 名詞句のかわりに、カタカナ語・漢字語・型番を拾う
TOKEN_RE = re.compile(r"[ァ-ヶー]{3,}|[一-鿿]{2,}|[A-Z]{2,}-\d{3,}")

t0 = time.perf_counter()
per_chunk = [set(TOKEN_RE.findall(c)) for c in CHUNKS]
df = {}
for e in per_chunk:
    for x in e:
        df[x] = df.get(x, 0) + 1
keep = {x for x, n in df.items() if n >= 3}        # 3チャンク未満にしか出ない語は落とす

G, members = nx.Graph(), {}
for ci, e in enumerate(per_chunk):
    e = sorted(e & keep)
    for x in e:
        members.setdefault(x, set()).add(ci)
    for a in range(len(e)):
        for b in range(a + 1, len(e)):
            if G.has_edge(e[a], e[b]):
                G[e[a]][e[b]]["weight"] += 1
            else:
                G.add_edge(e[a], e[b], weight=1)
G = G.subgraph(max(nx.connected_components(G), key=len)).copy()
print(f"チャンク {len(CHUNKS):,} / ノード {G.number_of_nodes():,} / "
      f"エッジ {G.number_of_edges():,} / {time.perf_counter() - t0:.2f}秒")
チャンク 12,604 / ノード 816 / エッジ 68,137 / 1.79秒100万トークンのコーパスから816ノードのグラフが1.79秒で出来ました。論文がPodcastデータセットで得たグラフは8,564ノード・20,691辺なので、ノード数は1桁小さく、辺は多い形です。合成コーパスの語彙が限られていて、同じ語が繰り返し共起するためです。ここでLLMの費用はゼロです。
階層に割る。4個から78個へ
次にコミュニティ検出です。GraphRAGの既定に合わせ、ノード数が10を超える集団を再帰的に分割します。
def sorted_subgraph(G, nodes):
    """集合の反復順に結果が左右されないよう、ノードを並べ替えて作り直す"""
    s = nx.Graph()
    s.add_nodes_from(sorted(nodes))
    s.add_edges_from((u, v, d) for u, v, d in G.edges(nodes, data=True)
                     if u in nodes and v in nodes)
    return s

MAX_CLUSTER_SIZE = 10          # GraphRAG の cluster_graph.max_cluster_size 既定値
t1 = time.perf_counter()
G = sorted_subgraph(G, set(G.nodes))
part = nx.community.louvain_communities(G, weight="weight", seed=SEED)
levels = [part]
for _ in range(4):
    nxt, split = [], False
    for g in part:
        if len(g) > MAX_CLUSTER_SIZE:
            sub = nx.community.louvain_communities(
                sorted_subgraph(G, g), weight="weight", seed=SEED)
            if len(sub) > 1:
                nxt.extend(sub); split = True; continue
        nxt.append(g)
    if not split:
        break
    part = nxt
    levels.append(part)
print(f"{len(levels)}階層 / {time.perf_counter() - t1:.2f}秒")

P_REPORT, CAP = 1927, 8000     # レポートの既定プロンプトと max_input_length
def report_tokens(groups):
    total = 0
    for g in groups:
        cids = set()
        for e in g:
            cids |= members.get(e, set())
        text = "\n".join(CHUNKS[i] for i in sorted(cids))
        total += min(len(enc.encode(text)), CAP) + P_REPORT
    return total

base = None
for i, part in enumerate(levels):
    sizes = sorted((len(g) for g in part), reverse=True)
    tok = report_tokens(part)
    base = base or tok
    print(f"level {i}: {len(part):3d}個(最大 {sizes[0]:3d}) "
          f"レポート入力 {tok:9,} トークン(level 0 の {tok / base:.1f}倍)")
allg = [g for part in levels for g in part]
print(f"全レベル合計: {len(allg)}個 / {report_tokens(allg):,} トークン")
5階層 / 0.74秒
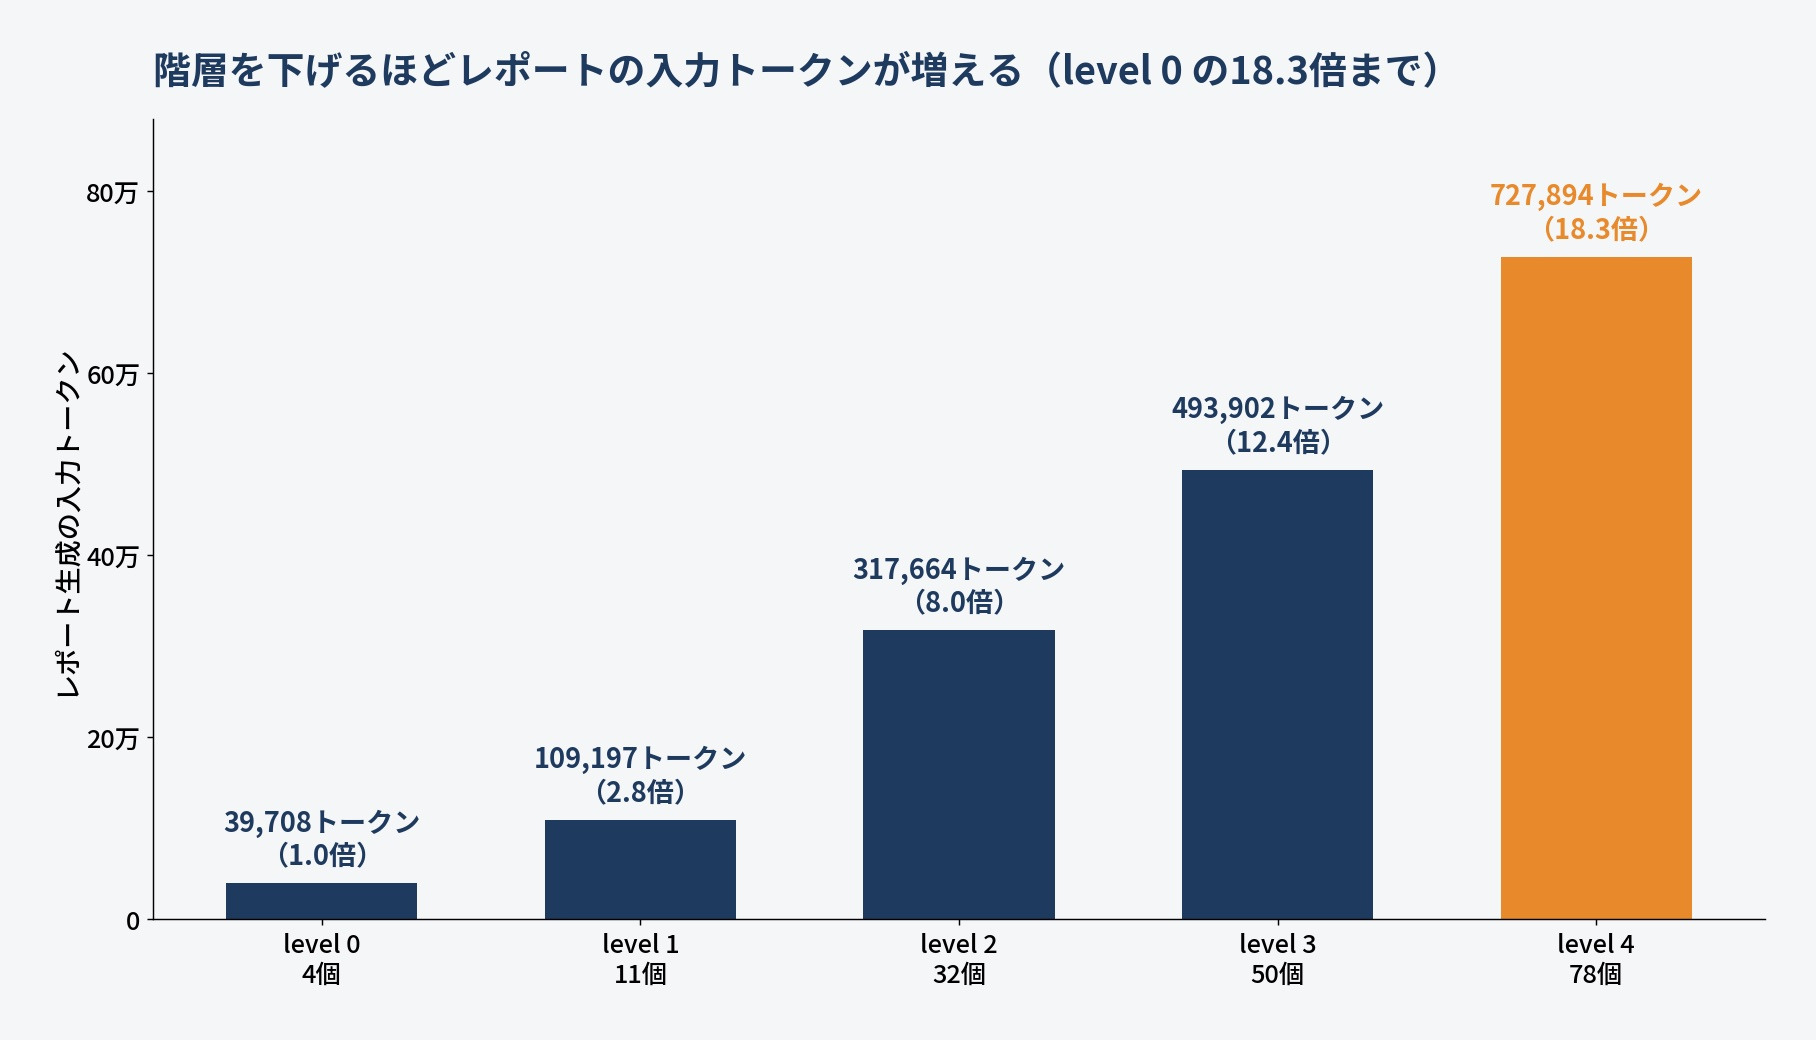
level 0: 4個(最大 275) レポート入力 39,708 トークン(level 0 の 1.0倍)
level 1: 11個(最大 135) レポート入力 109,197 トークン(level 0 の 2.8倍)
level 2: 32個(最大 64) レポート入力 317,664 トークン(level 0 の 8.0倍)
level 3: 50個(最大 57) レポート入力 493,902 トークン(level 0 の 12.4倍)
level 4: 78個(最大 57) レポート入力 727,894 トークン(level 0 の 18.3倍)
全レベル合計: 175個 / 1,688,365 トークンレベルを1段下げると要約の対象が18.3倍になる
読み取ってほしいのは、階層の深さとレポート生成の入力トークンの関係です。level 0 のレポートは4本で約4万トークンですが、level 4 では78本・約73万トークンと18.3倍になります。全階層のレポートを作ると、元のコーパスの1,008,250トークンを上回る1,688,365トークンを入力として流すことになります。
同じ形は論文でも確認できます。論文のTable 2は、Podcastデータセットについて、最上位の集団要約(C0)が34本・26,657トークン、1段下(C1)が367本・225,756トークン、2段下(C2)が969本・565,720トークン、3段下(C3)が1,310本・746,100トークンだったと報告しています。最上位と3段下で、クエリ1回あたりの文脈トークンが28倍違います。
この構造が、GraphRAGの費用を考えるときの土台になります。コミュニティ検出そのものは1秒未満で終わる、費用のかからない処理です。高いのは、検出された集団の数だけLLMに要約を書かせる部分と、その要約を検索のたびに読ませる部分です。
GraphRAGのインデックス作成にかかる費用を見積もる
階層の増え方が見えたので、費用に換算します。ここでは金額ではなく、LLMの呼び出し回数と入力トークン数で数えます。単価はモデルによって変わるので、回数とトークン数が分かれば自分の環境の料金表を掛けるだけで済みます。
既定プロンプトのトークン数を数える
見積もりで抜けやすいのが、毎回送られる定型のプロンプトです。GraphRAGの既定プロンプトは、抽出の手順と出力形式、それに複数の例示を含むため、それ自体がかなりの長さになります。実際に数えてみます。
import urllib.request
import tiktoken

BASE = "https://raw.githubusercontent.com/microsoft/graphrag/main/packages/graphrag/graphrag/prompts/index/"
enc = tiktoken.get_encoding("o200k_base")

for name in ("extract_graph.py", "community_report.py"):
    src = urllib.request.urlopen(BASE + name).read().decode("utf-8")
    ns = {}
    exec(compile(src, name, "exec"), ns)
    for key, value in ns.items():
        if key.isupper() and isinstance(value, str) and len(value) > 500:
            print(f"{key}: {len(enc.encode(value)):,} トークン")
GRAPH_EXTRACTION_PROMPT: 1,726 トークン
COMMUNITY_REPORT_PROMPT: 1,927 トークン抽出プロンプトだけで1,726トークンあり、これがチャンクの本文とは別に、全チャンク分だけ送られます。しかもgleaningでもう1回送るので、1チャンクあたり3,486トークンの定型分が乗ります。
チャンクサイズで呼び出し回数と入力トークンがどう動くか
この定型分を含めて、チャンクサイズごとの見積もりを出します。
import tiktoken
from corpus import build   # 1万5000件の合成コーパスを返す

enc = tiktoken.get_encoding("o200k_base")
ids = enc.encode("\n".join(build(n_docs=15000)))
print(f"コーパス {len(ids):,} トークン")

P_EXTRACT, P_CONT = 1726, 34      # 既定プロンプトと継続プロンプトのトークン数

def split(ids, size, overlap=100):
    out, i = [], 0
    while i < len(ids):
        out.append(ids[i:i + size])
        if i + size >= len(ids):
            break
        i += size - overlap
    return out

for size in (600, 1200, 2400):
    chunks = split(ids, size)
    body = sum(len(c) for c in chunks) * 2        # 抽出1回とgleaning1回で本文を2度送る
    prompt = (P_EXTRACT * 2 + P_CONT) * len(chunks)
    print(f"chunk={size:4d}: {len(chunks):5,}チャンク 呼び出し {len(chunks) * 2:6,}回 "
          f"入力 {body + prompt:10,} トークン(定型プロンプトが {prompt / (body + prompt):.0%})")
コーパス 1,008,250 トークン
chunk= 600: 2,017チャンク 呼び出し 4,034回 入力 9,450,962 トークン(定型プロンプトが 74%)
chunk=1200: 917チャンク 呼び出し 1,834回 入力 5,396,362 トークン(定型プロンプトが 59%)
chunk=2400: 439チャンク 呼び出し 878回 入力 3,634,454 トークン(定型プロンプトが 42%)100万トークンのコーパスに対して、既定の1,200トークンで切ると1,834回の呼び出しと約540万トークンの入力になります。元データの5.4倍のトークンを送ることになり、しかもその59%は本文ではなく定型のプロンプトです。
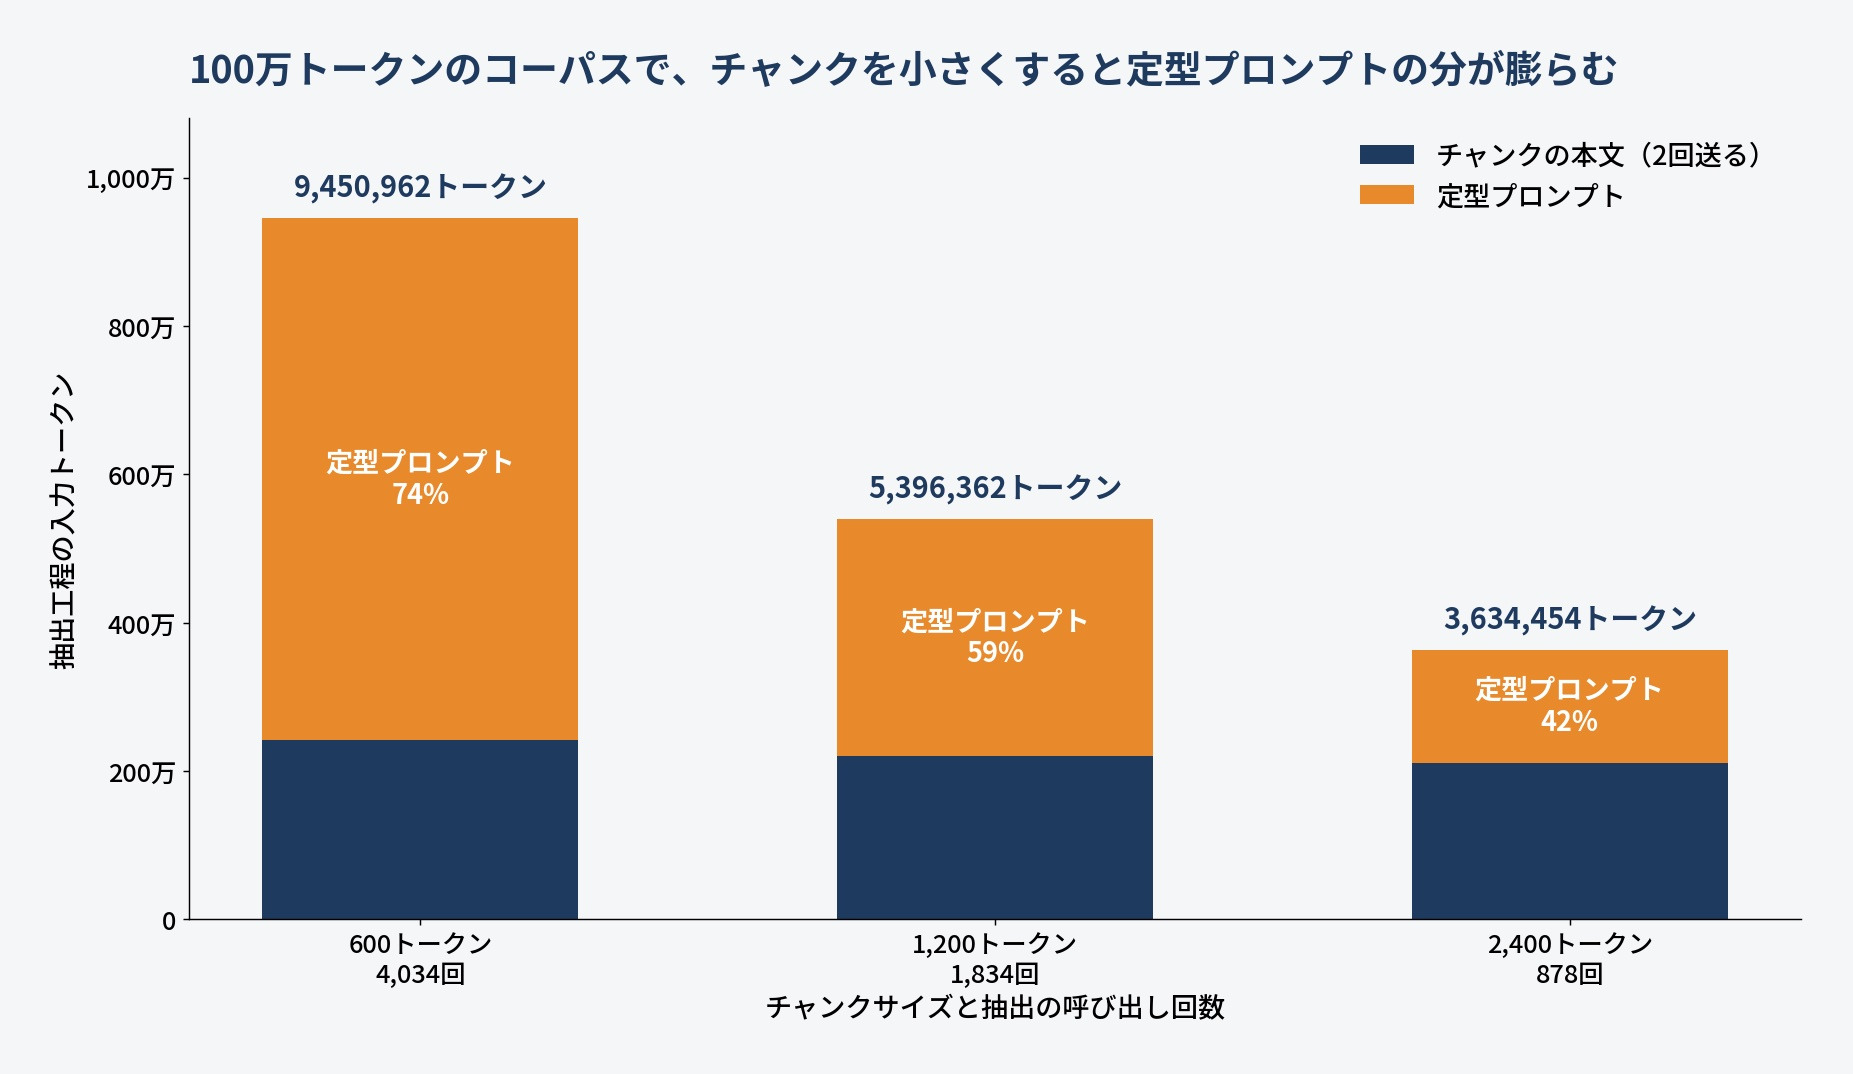
チャンクを600トークンに落とすと呼び出しは4,034回、入力は約945万トークンへ増えます。定型分の割合は74%です。前に触れたとおり、600トークンのほうが抽出されるエンティティ参照はほぼ2倍になるので、ここは品質と費用を直接交換している箇所になります。逆に2,400トークンにすれば入力は約363万トークンまで下がりますが、抽出の密度は落ちます。
なお、この見積もりにはコミュニティレポートの分が入っていません。先ほどの実測では全階層で1,688,365トークンでした。エンティティの説明をまとめる工程もあるので、実際の合計はさらに増えます。
抽出がインデックス費用の約75%という公式の見積もり
工程ごとの比率については、公式ドキュメントが目安を出しています。Indexing Methodsには、グラフ抽出がインデックス作成費用のおよそ75%を占めると見積もっている、と書かれています。
つまり、費用を下げたいときに最初に見るのは抽出の工程です。チャンクサイズ、gleaningの回数、抽出に使うモデル、この3つが効きます。コミュニティ検出のアルゴリズムやパラメータをいじっても、費用はほとんど動きません。
論文の281分をどう読むか
時間についても数字があります。論文の4.1.3節は、Podcastデータセット(約100万トークン・1,669チャンク)のグラフインデックス作成に281分かかったと報告しています。条件は、チャンク600トークン、メモリ16GBの仮想マシン、gpt-4-turboの公開エンドポイント、毎分200万トークンかつ毎分1万リクエストの上限です。
この数字をそのまま自社に当てはめることはできません。2024年時点のモデルと上限での測定であり、現在のモデルは速度も並列度も違います。読み取るべきなのはこの281分という数字そのものではなく、100万トークン程度のコーパスでも構築が分単位ではなく時間単位になるという規模感です。試したその場で終わる作業ではないので、検証計画に組み込む必要があります。
ここまでGraphRAGの費用の数え方を見てきましたが、「この見積もりの立て方や、どこまで測ってから判断すべきかを相談できる相手が社内にいない」という方も多いと思います。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座 Advanced は、Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムです。LLMアプリケーションの設計、コンテキストエンジニアリング、RAGの検索基盤と生成、評価とLLM-as-a-Judgeまでを、既製のフレームワークに寄せず生のAPIと自作のコードで実装しながら進めます。本記事で行った「構成を選ぶ前に数える」という進め方を、毎週の実装課題と現役データサイエンティストのコードレビューを通じて身につけられます。
まずは講座の内容を確認してみてください。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
GraphRAGの検索。ローカル検索・グローバル検索・DRIFT検索の使い分け
作る側の話が終わったので、使う側に移ります。GraphRAGには性格の違う検索が用意されていて、どれを使うかで費用も答えの質も変わります。
ローカル検索。エンティティを起点に周辺を集める
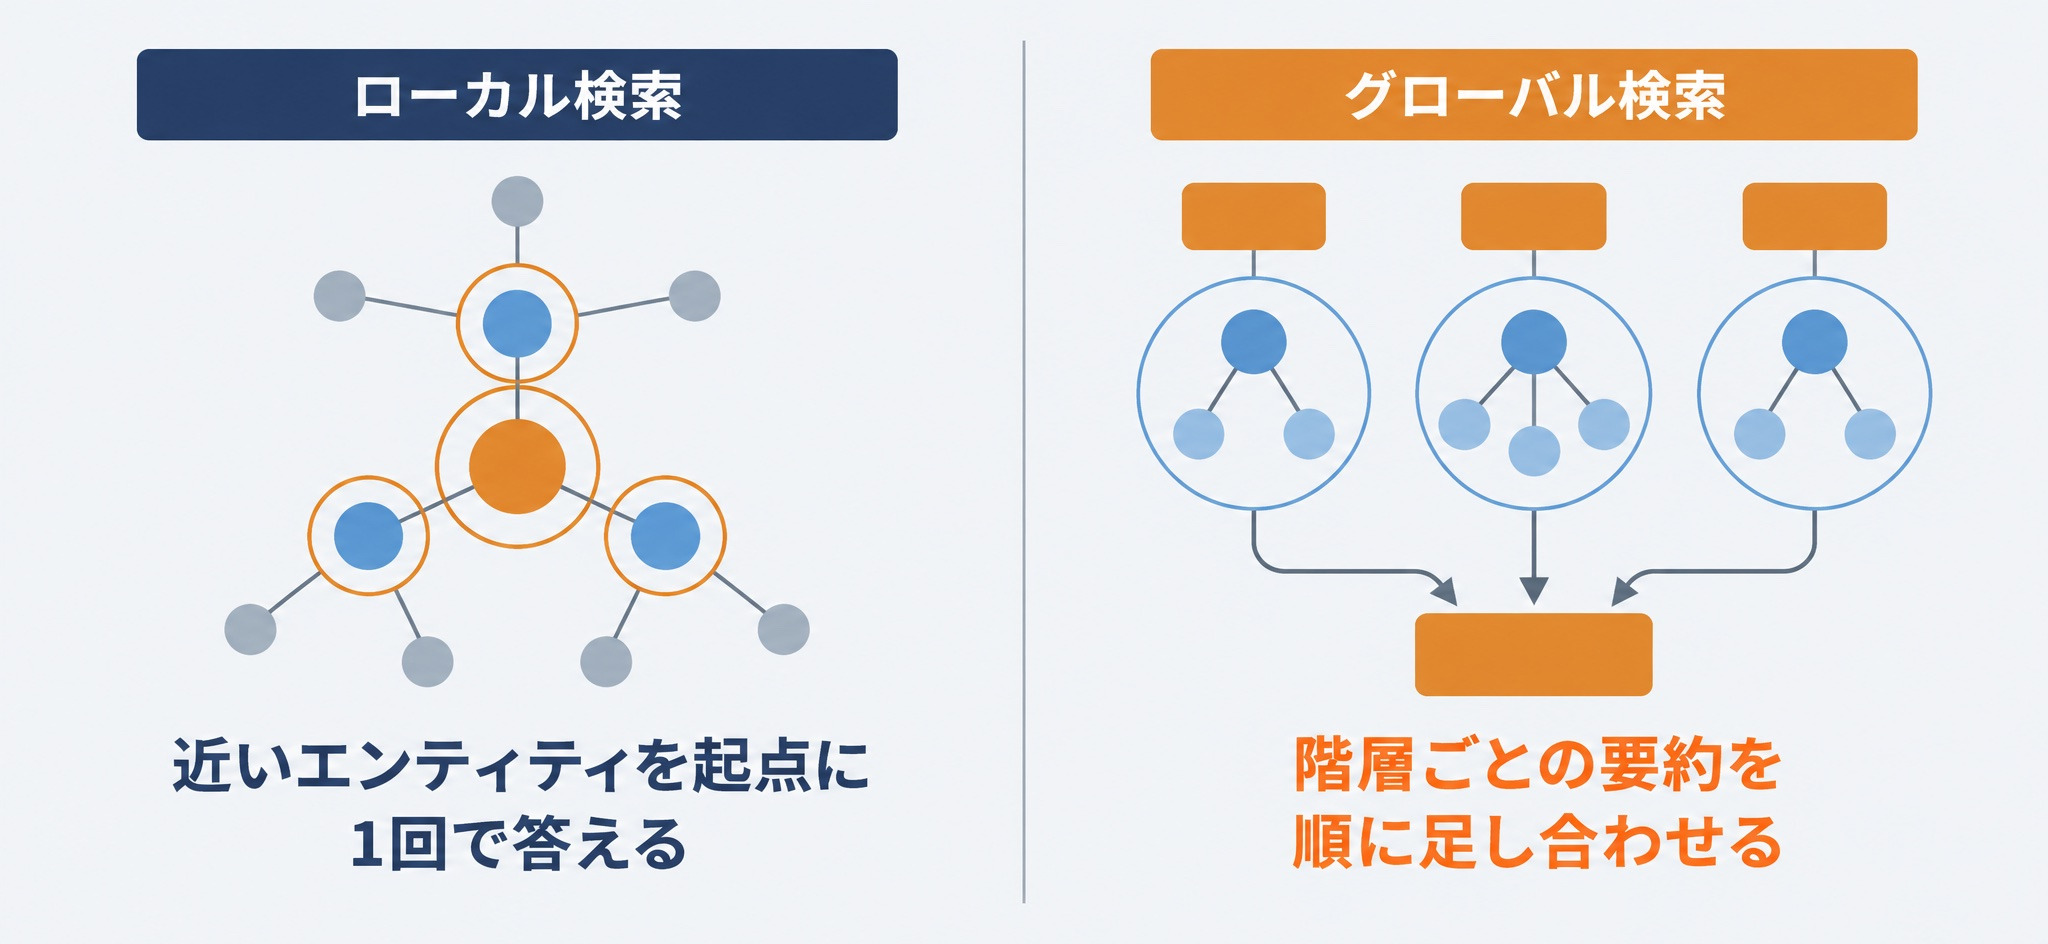
ローカル検索は、質問と意味的に近いエンティティをグラフから探し、そこを入口にします。入口が決まったら、つながっている関係、エンティティに付いた属性、そのエンティティが属する集団のレポート、そして元文書の該当チャンクを集めます。集めた候補を順位付けして絞り込み、決められた大きさの文脈に収めてLLMに渡します。
既定では、文脈全体を12,000トークンとし、そのうち半分を元文書のチャンクに、15%をコミュニティレポートに割り当てます。入口となるエンティティは上位10件、関係も上位10件です。エンティティ名が質問に含まれている問いに向いています。
グローバル検索。コミュニティレポートをmap-reduceで畳む
グローバル検索は動き方がまったく違います。特定のエンティティを探さず、指定した階層のコミュニティレポートを全部使います。
手順は2段階です。まずレポートを決まったトークン数のかたまりに分割し、それぞれについて部分的な回答を作らせます。このとき、その論点が質問にどれだけ役立つかを0から100の数値で自己採点させます。次に、点数の低いものを落とし、高いものから順に文脈に詰め直して最終回答を作ります。
費用は階層の選び方で決まります。公式ドキュメントも、下の階層のレポートを使うほど回答は厚くなるが、レポートの本数が多いため時間とLLMの消費が増えると書いています。先ほどの実測に当てはめると、level 0 を選ぶか level 4 を選ぶかで、1回の検索でLLMに読ませる量が18.3倍変わります。
DRIFT検索。グローバルの入口からローカルへ降りる
3つ目がDRIFT検索です。日本語の解説記事ではあまり扱われていませんが、公式の問い合わせ方式の1つとして用意されています。
流れは、まず質問に意味的に近いコミュニティレポートと突き合わせて最初の回答と追加の質問を作り、次にその追加の質問に対してローカル検索をかけて答えを詰めていく、というものです。結果は質問と回答の階層として構成されます。入口をグローバルに広く取り、そこからローカルの具体に降りるので、エンティティ名が質問に含まれていない具体的な問いに効きます。
問いの型で選ぶ
3つの使い分けを整理します。
| ローカル検索 | グローバル検索 | DRIFT検索 | |
|---|---|---|---|
| 入口 | 質問に近いエンティティ | 指定した階層の全レポート | 質問に近いレポート |
| 向く問い | 特定の対象について詳しく | 全体の傾向、共通点、主なテーマ | 対象が名指しできない具体的な問い |
| 1回の費用 | 小さい | 大きい(階層で変わる) | 中くらい |
| 答えの性格 | 具体的で出典に近い | 網羅的で俯瞰的 | 具体と俯瞰の中間 |
表から読み取れるのは、グローバル検索は常用するものではないということです。全体を見渡す問いにだけ当て、日常の問い合わせはローカル検索で受けるのが現実的な構成になります。
なお、質問の内容に応じて検索の当て方を変える設計そのものは、GraphRAGに限った話ではありません。エージェントが検索を繰り返して答えを組み立てる構成についてはAgentic RAGとはで扱っています。
GraphRAGの費用を下げる3つの手段と、日本語での注意点
使い分けで減らせない分は、構成そのものを変えて減らします。公式が用意している手段が3つあります。
1. FastGraphRAGに切り替える
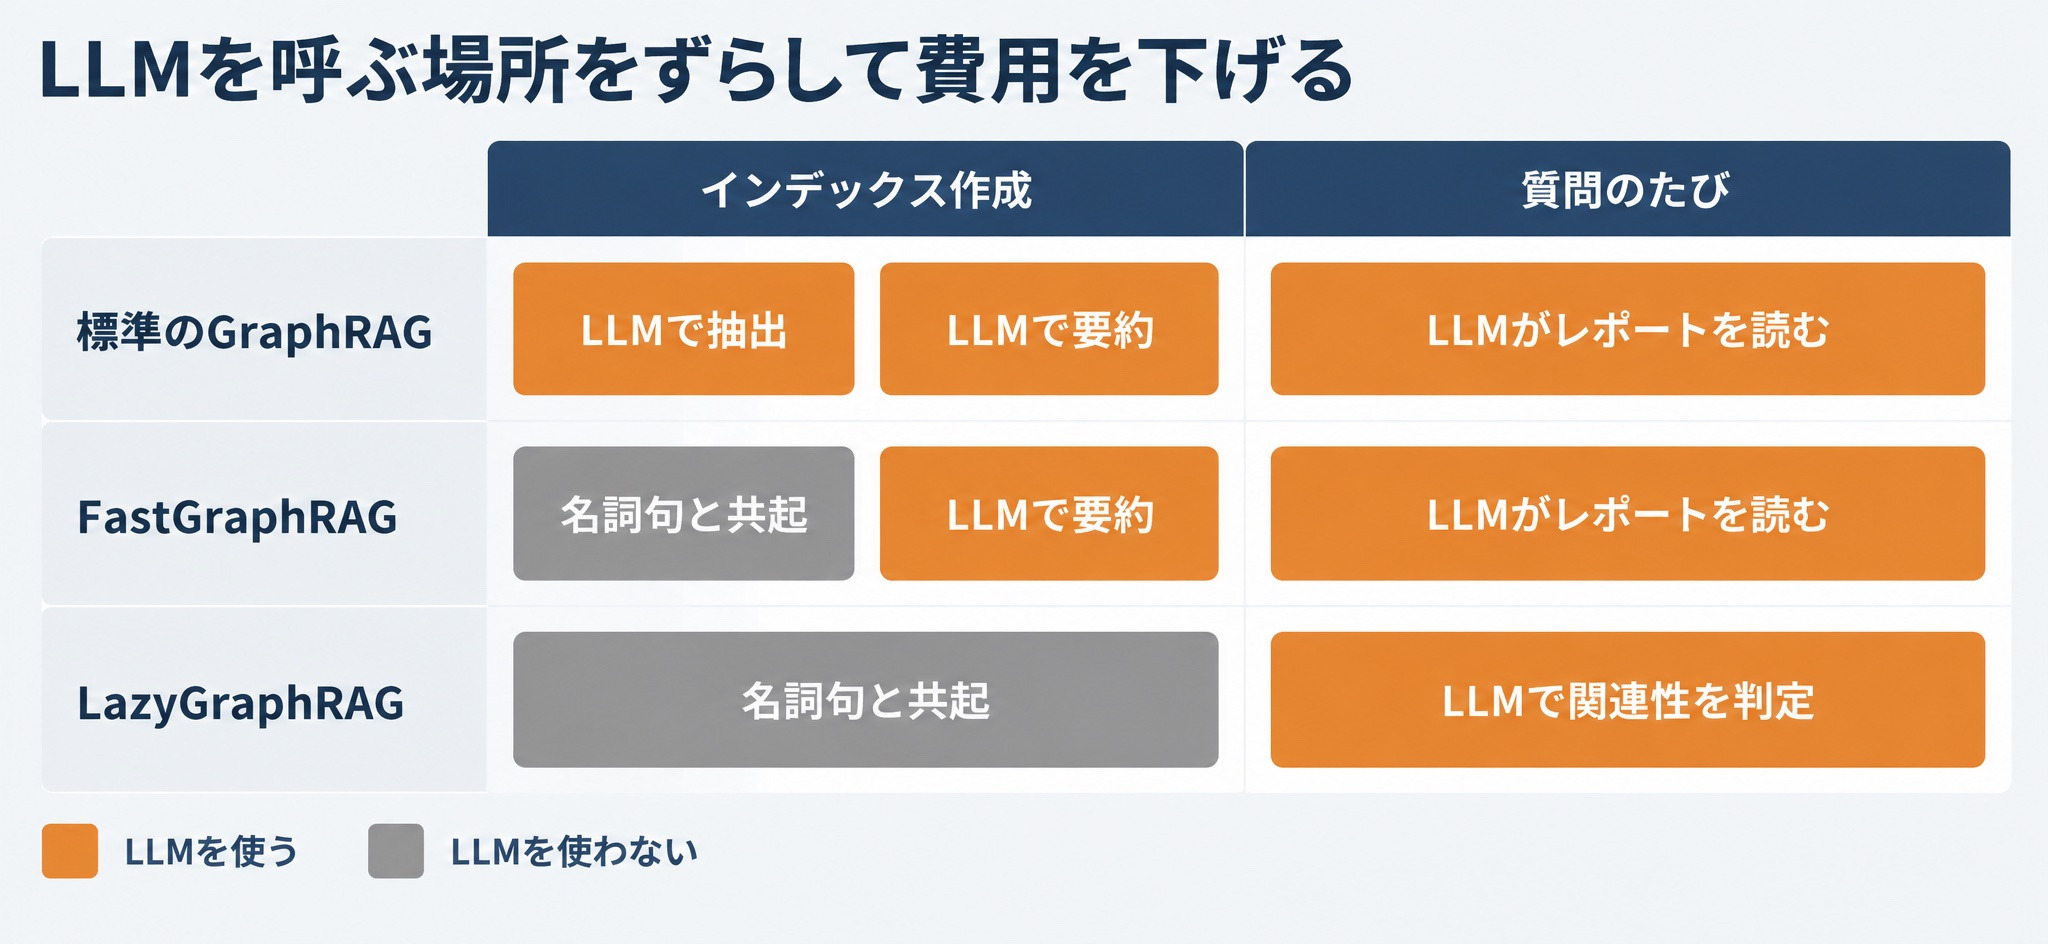
1つ目は、抽出からLLMを外す方式です。FastGraphRAGでは、エンティティをNLPライブラリで抜いた名詞句とし、関係は同じチャンクに一緒に現れたかどうかで定義します。説明文を作らないので、まとめる工程も要りません。抽出がインデックス費用の約75%なので、削減幅は大きくなります。
公式ドキュメントは、高い精度のエンティティとグラフの探索が重要ならば標準の方式を、グローバル検索による要約が主用途ならFastGraphRAGを勧めています。
日本語で使う場合は追加の作業が要ります。既定の名詞句抽出はNLTKと正規表現の組み合わせで、公式ドキュメント自身が「とても速いが主に英語向け」と書いています。日本語の文書をそのまま流すと、名詞句がまともに取れません。spaCyを使う設定に切り替えたうえで、日本語のモデルを指定する必要があります。前節で試した正規表現による語の抽出も、同じ問題に対する簡易な対処です。
2. グローバル検索のコミュニティレベルを上げる
2つ目は、検索時に使う階層を上げることです。費用は階層の深さで大きく動くので、ここは調整の効き目が最も分かりやすい箇所になります。
論文は、最上位の集団要約でも通常のベクトル検索に対して網羅性で72%、多様性で62%の勝率を保っていたと報告しています。一方で、元文書をそのまま要約する方式と比べると、最上位の要約は文脈トークンを97%以上削減できたとしています。多少の性能低下と引き換えに、繰り返し問い合わせる使い方には最上位の要約が向く、というのが論文の結論です。
自社で決めるときは、上の階層から試して、答えが粗すぎると感じたところで1段下げるのが手順として安全です。最初から下の階層を選ぶと、費用だけが先に膨らみます。
3. LazyGraphRAG。事前要約をやめる
3つ目は、事前の要約そのものをやめる方式です。Microsoft Researchが2024年11月25日に公開したLazyGraphRAG: Setting a new standard for quality and costで示されました。
LazyGraphRAGが採るのは、インデックス作成の時点ではLLMを使わず、名詞句の抽出と共起から概念のグラフを作るだけにして、LLMの出番を質問が来た時点まで遅らせるという構成です。質問が来たら、関連しそうなチャンクを順位付けし、LLMに文単位で関連性を判定させながら探索を深めます。判定の回数に上限を設けることで、費用を先に決められる設計になっています。
公表されている数字は、索引作成の費用が通常のベクトルRAGと同等でフルのGraphRAGの0.1%、グローバルな問いに対する回答の質はグローバル検索と同等でクエリ費用が700分の1以下というものです。
3つの手段を並べます。
| 標準のGraphRAG | FastGraphRAG | LazyGraphRAG | |
|---|---|---|---|
| 抽出にLLMを使うか | 使う | 使わない(名詞句と共起) | 使わない |
| 事前のコミュニティ要約 | 作る | 作る | 作らない |
| 索引の費用 | 高い | 中くらい | ベクトルRAGと同等 |
| クエリの費用 | 階層で変わる | 階層で変わる | 判定回数の上限で決める |
| グラフの使い道 | 探索や可視化にも使える | GraphRAGの中で使う前提 | 質問のたびに構成する |
表の最終行が選択の分かれ目になります。グラフ自体を業務で見たいのか、回答の質だけが目的なのかで、払う価値のある費用が変わります。
GraphRAGに投資するかを決める5つの手順
手段が揃ったので、入れるかどうかの決め方に移ります。順番を守ることが費用の節約になります。
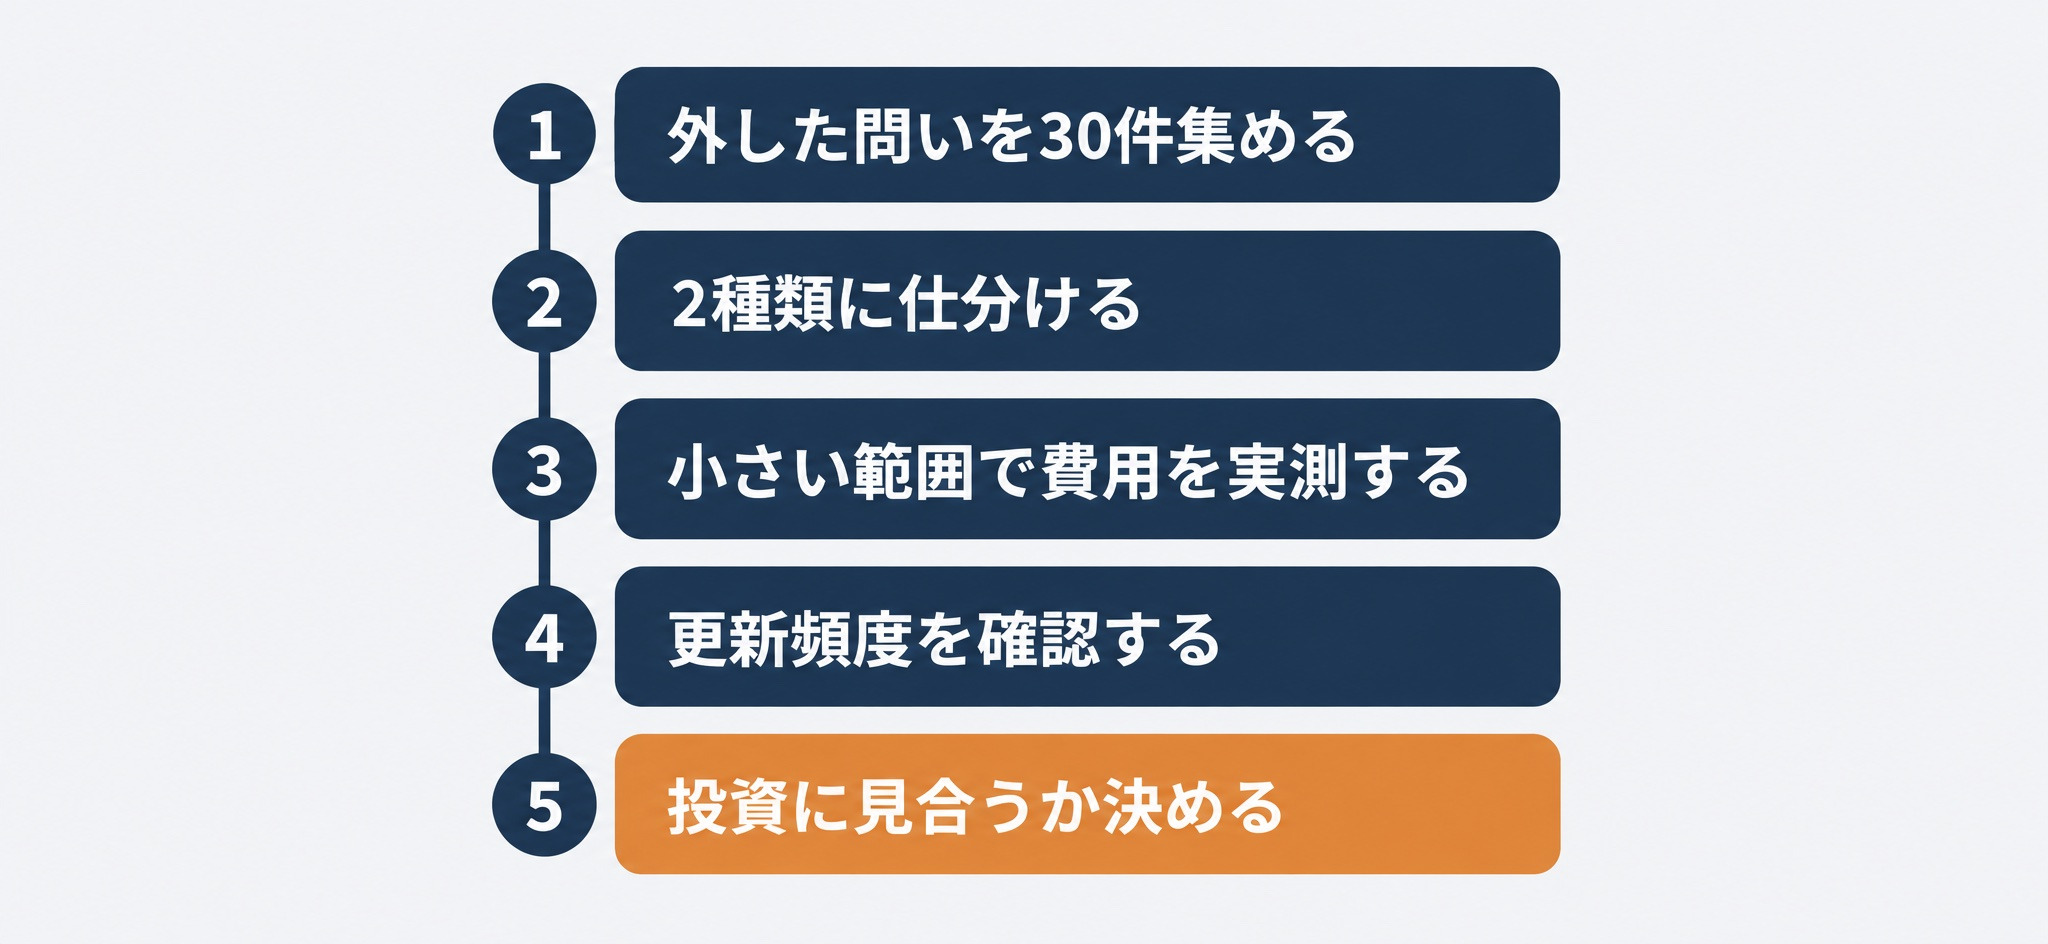
1. 通常のRAGで外した問いを30件集める
最初にやるのは技術検証ではなく、事実の収集です。いま動いているRAGに実際に来た質問のうち、答えられなかったものを30件ほど集めます。ログが無い場合は、現場の担当者に「AIに聞いて役に立たなかった質問」を挙げてもらいます。
この集合が無いまま構成を変えると、良くなったかどうかを判定できません。評価用のデータの作り方はRAGの評価をRagasで行う記事で扱っています。
2. 外した問いを2種類に仕分ける
答えが出なかった原因に応じて、集めた30件の問いを次の2つの型へ振り分けます。
- 検索の失敗:答えが1つの文書に書いてあるのに、検索がその文書を持ってこられなかった
- 構造の不足:答えが1か所に書かれておらず、複数の文書を結ぶか、全体を数えないと出ない
GraphRAGが効くのは後者だけです。前者はチャンクの切り方、メタデータでの絞り込み、リランキングで改善する範囲で、グラフを作っても変わりません。社内文書をAIに読ませる前の整理についてはRAGで社内データを扱う記事に、ナレッジ側の整備についてはナレッジベースの作り方の記事にまとめています。
仕分けた結果、構造の不足が30件中の数件にとどまるなら、ここで止めます。その数件は人が答えるほうが安上がりです。
3. 小さい範囲でインデックスを作り、費用を実測する
構造の不足がまとまった数あるなら、次は全社分ではなく1部門分、あるいは1つの文書群だけでインデックスを作ります。測るのは次の4つです。
- チャンク数と呼び出し回数:本記事のコードで、実データのトークン数から先に見積もる
- 実際のトークン消費:ログから入力と出力を取り、見積もりとの差を確認する
- 構築にかかった時間:全社分に外挿したときに現実的な時間に収まるか
- 出来たコミュニティの数:階層ごとの本数が、検索時の費用をそのまま決める
見積もりと実測が大きくずれる場合、たいていは文書の書式が原因です。表や箇条書きが多い文書は、抽出の出力が長くなります。
4. 更新の頻度と作り直しの費用を確認する
見落としやすいのが更新です。GraphRAGのインデックスは、文書を足したときに差分だけ足して終わりにはなりません。新しいエンティティが既存の集団の構成を変えれば、コミュニティの分割が変わり、レポートも作り直しになります。
そこで、対象の文書が月にどれくらい増減するかを先に数えます。日次で更新される文書を対象にするなら、構築費用を毎月何回払うことになるのかが判断材料になります。更新がほとんど無い文書、たとえば過去の案件記録や技術資料のほうが、GraphRAGとの相性は良くなります。
5. GraphRAGを入れないほうがよい場合
ここまでの手順を踏まえると、見送る判断は次のように整理できます。
- 外した問いの大半が検索の失敗だった:チャンクとリランキングに手を入れるほうが効きます
- 対象の文書が日次で入れ替わる:作り直しの費用が回収できません
- 答えさせたい問いがまだ決まっていない:作る範囲を決められないので、通常のRAGを先に動かします
- グラフを人が見る用途が無く、回答の質だけが目的:LazyGraphRAGのような軽い構成から試します
- 評価用の問いの集合を用意できない:良くなったかを判定できないので、そこから作ります
逆に、過去の案件記録や障害報告のように更新が緩やかで、文書をまたいだ問いが業務の中心にあるなら、費用を払う価値が出てきます。
GraphRAGの要点整理
- GraphRAGとは、LLMに文書からグラフを作らせ、密につながった集団ごとの要約を先に生成しておき、それを根拠に回答する仕組み。通常のRAGとの違いは、インデックス作成の時点でLLMを使う点にある
- 効くのは、複数の文書を結ぶ問いと、全体を見渡す問いの2種類だけ。検索が正しい文書を持ってこられていないだけの問題は、グラフを作っても解決しない
- コミュニティ検出そのものは安い。100万トークンのコーパスから作った816ノードのグラフに対して、階層の検出は0.74秒で終わり、LLMの費用はかからなかった
- 高いのは抽出と要約。公式ドキュメントはグラフ抽出がインデックス費用の約75%を占めると見積もっている
- 既定のチャンクサイズ1,200トークンで100万トークンを処理すると、抽出だけで1,834回の呼び出しと約540万トークンの入力になり、その59%は定型のプロンプト。チャンクを600トークンにすると4,034回・約945万トークンへ増える
- 階層を1段下げるごとに要約の対象が増える。実測では level 0 の4本・約4万トークンが、level 4 では78本・約73万トークンと18.3倍になった
- 検索は3種類を使い分ける。日常の問い合わせはローカル検索、全体を見渡す問いにだけグローバル検索、対象を名指しできない具体的な問いにDRIFT検索
- 費用を下げる手段は、FastGraphRAGへの切り替え、グローバル検索の階層を上げること、LazyGraphRAGの採用の3つ。日本語でFastGraphRAGを使うなら名詞句抽出の設定を入れ替える
- 判断の順番は、外した問いを集める、仕分ける、小さく作って測る、更新頻度を確認する。構造の不足が数件しか無いなら、そこで止めるのが正しい
GraphRAGとRAGの設計を体系的に学ぶなら「Craft College」へ
本記事で扱ったのは、構成を選ぶ前に回数とトークンを数え、数値を根拠に判断するという作業でした。実務でこの次に来るのは、その判断を一度きりで終わらせず、外した問いの集合を資産として持ち、構成を変えるたびに測り直す仕組みです。
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced を提供しています。Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムで、LLMアプリケーション設計の基礎、コンテキストエンジニアリング、RAG、マルチモーダルAI、評価とLLM-as-a-Judge、AIエージェントとマルチエージェント、LLMセキュリティ、ローカルLLM、ファインチューニング、卒業制作までを扱います。既製のフレームワークに寄せず、生のAPIと自作のコードで骨格を実装するのが方針です。毎週の実装課題には現役データサイエンティストのコードレビューが付き、少人数のコホートで進みます。
機械学習の基礎から始めたい方には、9ヶ月36週のデータサイエンティスト養成講座があります。AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に進む構成です。経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座で、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。支給の可否は最終的にハローワーク等が判断します。
リベルクラフトでは、AI開発・データサイエンス開発の支援も行っています。社内文書を対象にした検索基盤の設計、評価用データの作り方、構成を変える前の費用の見積もりまで、要件定義からPoC、本番運用までを一貫して支援しています。自社のデータで何から手をつけるかを決める段階からご相談いただけます。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
⇨AI開発・データサイエンス開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。