ナレッジグラフとは。社内ナレッジを関係でつなぐ仕組みと作り方を解説
社内の文書をAIに読ませる仕組みを作ってみたものの、「この部品を使っている製品はどれか」「似た不具合が過去にもあったか」といった問いになると答えが返ってこない、という場面に心当たりのある方も多いのではないでしょうか?
こうした問いは、1つの文書の中に答えが書かれていません。複数の情報をつなぎ合わせて初めて答えが出るため、文書を探すだけの仕組みでは届かないのです。この「つなぐ」部分を担うのがナレッジグラフです。
生成AIの利用そのものは広がっています。総務省の令和7年版 情報通信白書によると、何らかの業務で生成AIを利用していると回答した日本企業の割合は55.2%、生成AIの活用方針を定めている企業は49.7%(2023年度調査は42.7%)でした。一方、導入に際しての懸念事項として最も多く挙がったのは「効果的な活用方法がわからない」です。
そこで本記事では、
- ナレッジグラフとは何か。知識グラフとの関係と、エンティティやトリプルという基本の言葉
- オントロジー、表形式のデータベース、ベクトル検索との違い
- 社内ナレッジのどんな問いに効き、どんな場合は作らなくてよいのか
- 公開されているナレッジグラフと、企業での使い方
- 作り方の5つのステップと、工数が集中する箇所
- RDFとプロパティグラフのどちらで持つか
- 生成AIと組み合わせるときの着手の順番
を解説します。
社内ナレッジをAIで活かす進め方から相談したいという方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
- ナレッジグラフとは。モノとモノの関係を点と線で表した知識のデータ
- ナレッジグラフと紛らわしい言葉の違い。オントロジー、データベース、ベクトル検索
- ナレッジグラフが社内ナレッジに効く場面。文書検索では答えられない問い
- ナレッジグラフの活用例。公開されているものと、企業での使い方
- ナレッジグラフの作り方。社内ナレッジから組み立てる5つのステップ
- ナレッジグラフの構築でつまずく3つの箇所。技術より合意と名寄せ
- ナレッジグラフの持ち方。RDFとプロパティグラフのどちらを選ぶか
- ナレッジグラフと生成AIの関係。RAGで届かない問いを補う
- ナレッジグラフのまとめ
- ナレッジグラフと社内ナレッジ活用の相談は「リベルクラフト」へ
ナレッジグラフとは。モノとモノの関係を点と線で表した知識のデータ
まずは言葉の意味から押さえます。日本語では知識グラフと訳されることもあり、どちらも同じものを指します。
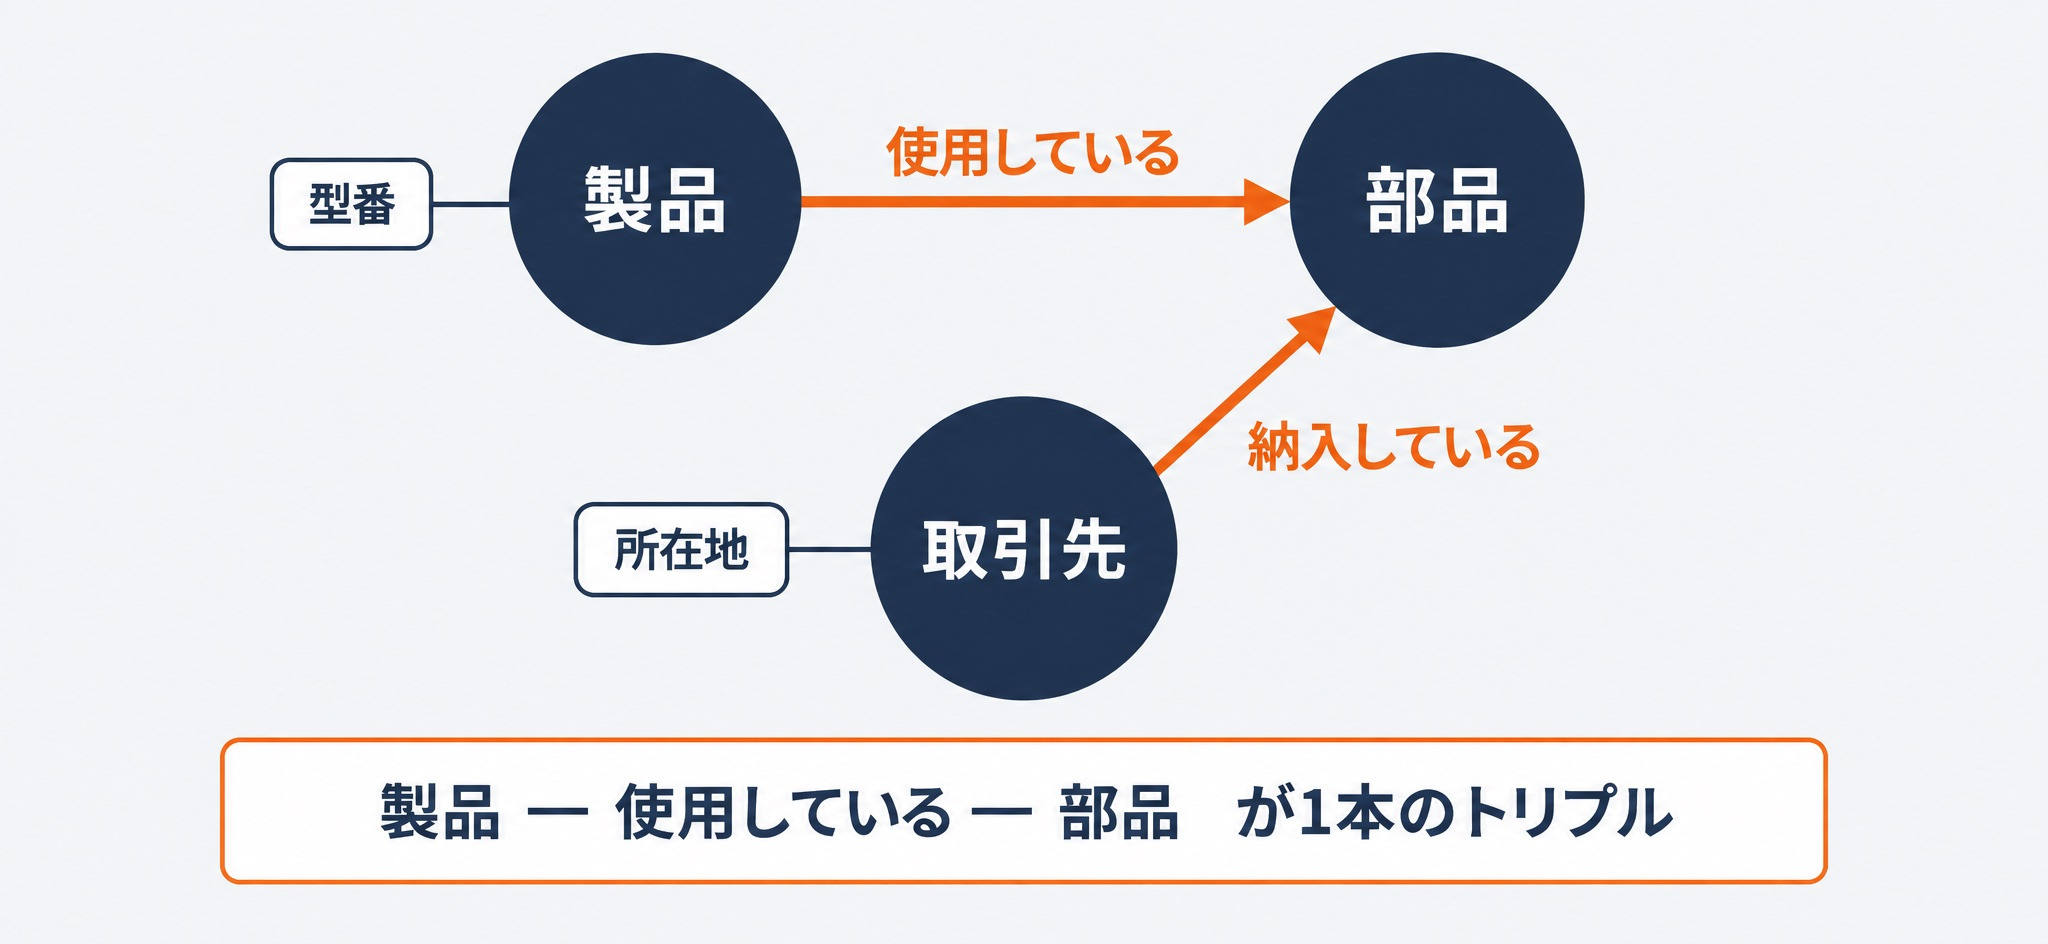
ナレッジグラフの定義。エンティティ、リレーション、プロパティの3つで組み立てる
ナレッジグラフとは、現実に存在するモノと、モノどうしの関係を、点と線のつながりとして表した知識のデータです。グラフデータベースの開発元であるNeo4jも、ナレッジグラフを「現実世界の実体とその関係を整理して表現したもの」と説明しています(What Is a Knowledge Graph?)。
組み立てに使う部品は3つです。
- エンティティ:点にあたるもので、製品、部品、取引先、社員、規程といった1つひとつの対象を指します。ノードとも呼ばれます
- リレーション:線にあたるもので、「使用している」「納入している」「承認した」といった関係の種類を表します
- プロパティ:エンティティや関係に付ける属性です。型番、所在地、契約の開始日などがこれにあたります
表計算ソフトの表と違うのは、関係そのものがデータとして置かれている点です。「製品Aは部品Bを使っている」という事実が、線として保存されています。
トリプルという最小単位。主語、述語、目的語で1つの事実を表す
この点と線の組み合わせは、3つ組に分解できます。「製品Aは、部品Bを、使用している」のように、主語と述語と目的語で1つの事実を表す形です。これをトリプルと呼びます。
トリプルはW3Cの仕様で定義されています。RDF 1.1 Concepts and Abstract Syntax(2014年2月25日勧告)では、RDFのトリプルは主語と述語と目的語の3つの要素からなると定められています。ナレッジグラフは、このトリプルを大量に集めたものだと考えると分かりやすくなります。
ナレッジグラフという言葉の出どころ。Googleが2012年に検索へ持ち込んだ
この呼び方が広まったきっかけは、Googleが2012年5月16日に公開したIntroducing the Knowledge Graph: things, not stringsという発表です。
タイトルにある「things, not strings」は、検索を文字列の一致ではなく事物の理解として扱う、という宣言でした。「Taj Mahal」という語が建造物も音楽家もカジノも指しうるように、同じ文字列が別の対象を指すことは珍しくありません。Googleはこれを区別するために、対象ごとの情報と対象どうしの関係を持たせました。発表時点で5億を超えるオブジェクトと、それらのあいだの35億を超える事実および関係を収録していると書かれています。
検索結果に出るナレッジパネルと、企業が自社で作るナレッジグラフの関係
企業名を検索したときに画面の右側へ出る情報のまとまりは、ナレッジパネルと呼ばれます。これはGoogleが持つナレッジグラフの内容を表示したものです。
ここで整理しておきたいのは、Googleのナレッジグラフと、企業が自社の社内ナレッジで作るナレッジグラフは、モノと関係を点と線で持つという構造こそ同じでも、運用する主体が違う別のものだという点です。前者はGoogleが運用するもので、企業側ができるのは構造化データの記述などを通じて情報を正しく伝えることに限られます。実際、Googleが公開しているKnowledge Graph Search APIにも、本番の重要なサービスとして使う用途には向かないという注意書きが添えられています。
本記事の以降の内容は、後者、つまり自社のデータで作るナレッジグラフを対象にします。
ナレッジグラフと紛らわしい言葉の違い。オントロジー、データベース、ベクトル検索
ナレッジグラフが何かを示したので、次は似た言葉との違いを片づけます。この3つを混同したまま検討に入ると、社内で話が噛み合わなくなります。
オントロジーとの違い。設計図と、その設計図で作った実データ
オントロジーとは、扱う領域にどんな種類のモノがあり、どんな関係が成り立つのかを定義したものです。W3Cは、オントロジーを記述する言語であるOWL 2(2012年12月11日勧告)を、意味が形式的に定義されたオントロジー言語と位置づけています。
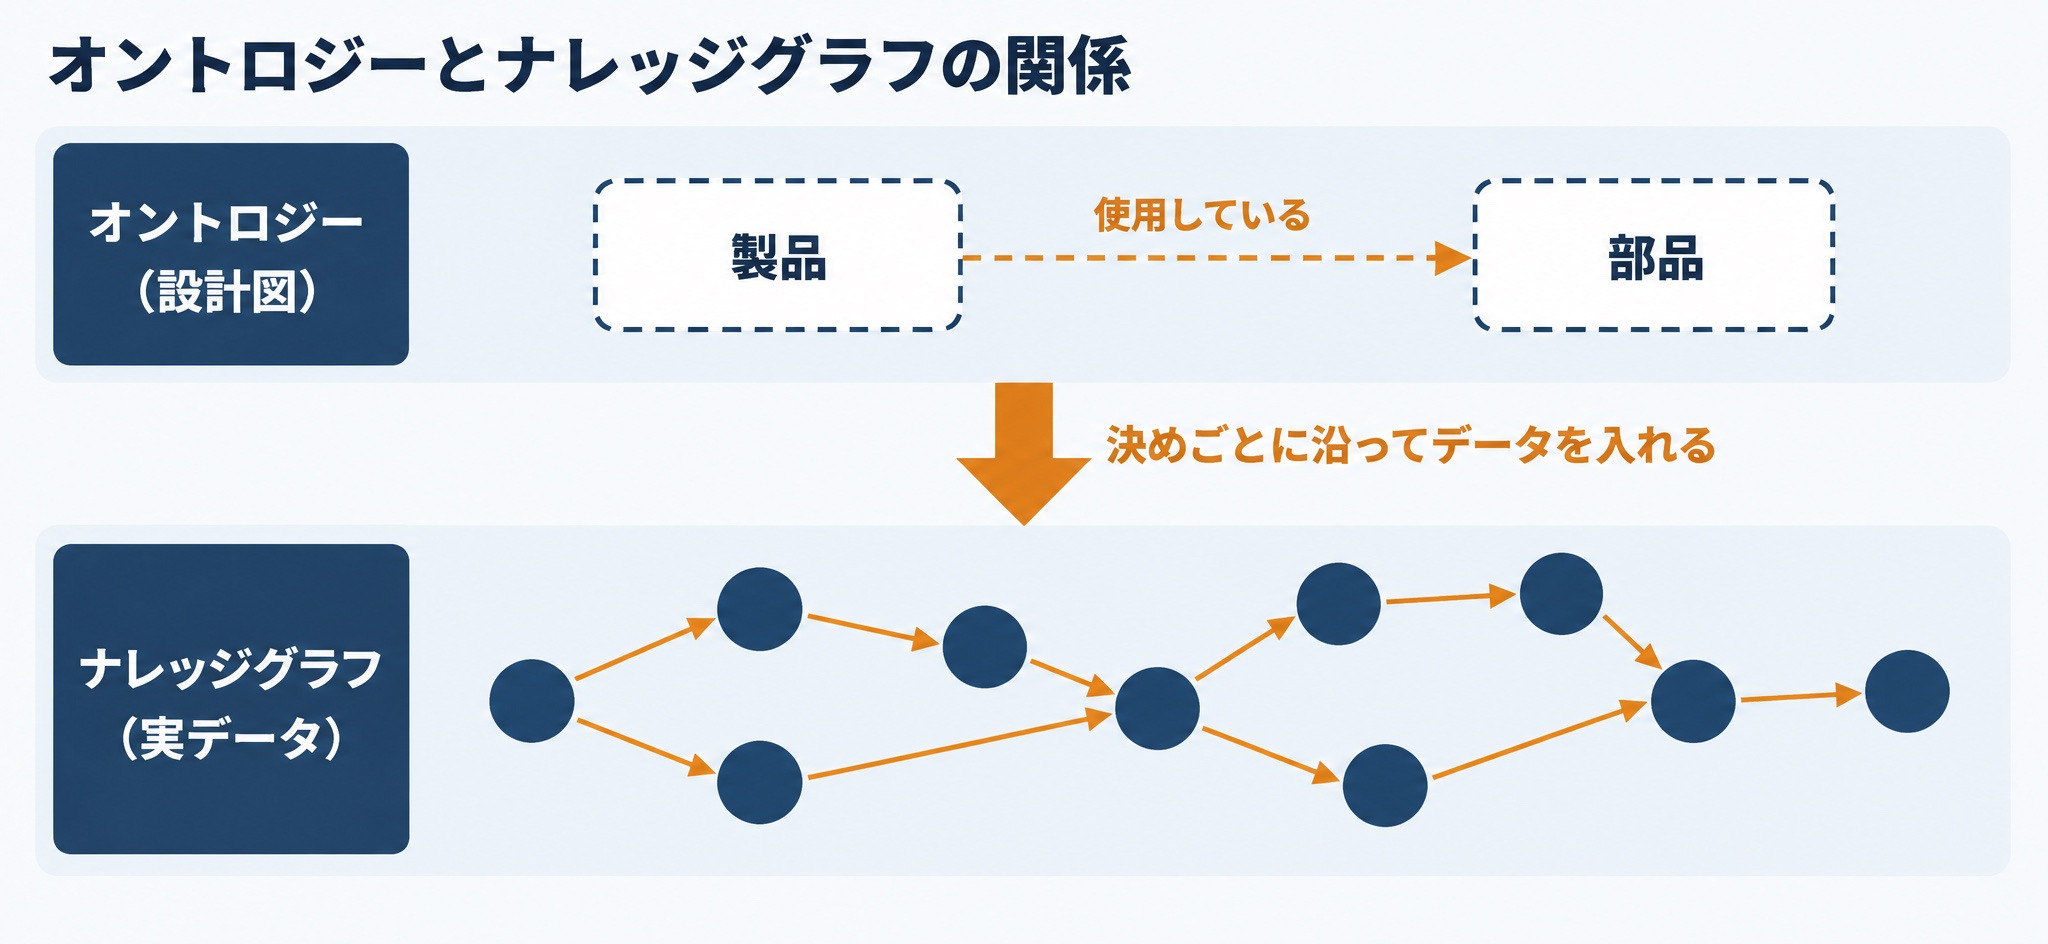
両者の関係は、設計図と建物にたとえられます。オントロジーが「製品という種類があり、部品という種類があり、製品は部品を使用しているという関係で結べる」と決める側で、ナレッジグラフはその決めごとに沿って実際のデータを入れたものです。先に設計図を決めないと、同じ関係を人によって別の名前で書いてしまい、あとからつながらなくなります。
表形式のデータベースとの違い。関係を行と列ではなく線として持つ
一般的な業務システムは、表形式のデータベースでデータを持っています。この形でも関係は表せますが、複数の表をまたいで結びつける指示を問い合わせのたびに書く必要があります。
ナレッジグラフでは、関係そのものが線として保存されています。そのため「この取引先から3段階たどった先にある製品」のように、何段階たどるかが決まっていない問いを扱いやすくなります。こうしたデータの保存と検索に向いた仕組みがグラフデータベースです。
ベクトル検索との違い。似た文を探すのか、つながりをたどるのか
社内文書をAIに読ませる仕組みでよく使われるのが、文章の意味の近さで探すベクトル検索です。これとナレッジグラフは、探し方そのものが違います。
| 比べる観点 | ベクトル検索 | ナレッジグラフ |
|---|---|---|
| 探し方 | 質問文と意味の近い文章の断片を取り出す | エンティティどうしを結ぶ線をたどる |
| 得意な問い | 「有給休暇の申請方法は」のように、答えが1か所に書かれている問い | 「この部品を使う製品のうち、特定の取引先が関わるものは」のように、複数の情報を結ぶ問い |
| 苦手な問い | 情報が複数の文書に散っていて、つなげないと答えが出ない問い | 文章の言い回しの揺れを吸収すること |
| 準備の重さ | 文書を区切ってベクトルに変換すれば動く | どんな種類のモノと関係を持つかを決め、データを整える工程が必要 |
表のとおり、2つは競合する技術ではなく、得意な問いの形が違う道具です。大規模言語モデル(LLM)を使った仕組み全体の中では、両方を併用する構成も取れます。LLM自体の仕組みはLLMとは何かで整理しています。
ナレッジグラフが社内ナレッジに効く場面。文書検索では答えられない問い
言葉の違いが片づいたので、次は自社の問いのどれがナレッジグラフを求めているのかを仕分けます。ここが導入判断の分かれ目になります。
つながりをたどる問い。2つ以上の情報を結んで初めて答えが出る
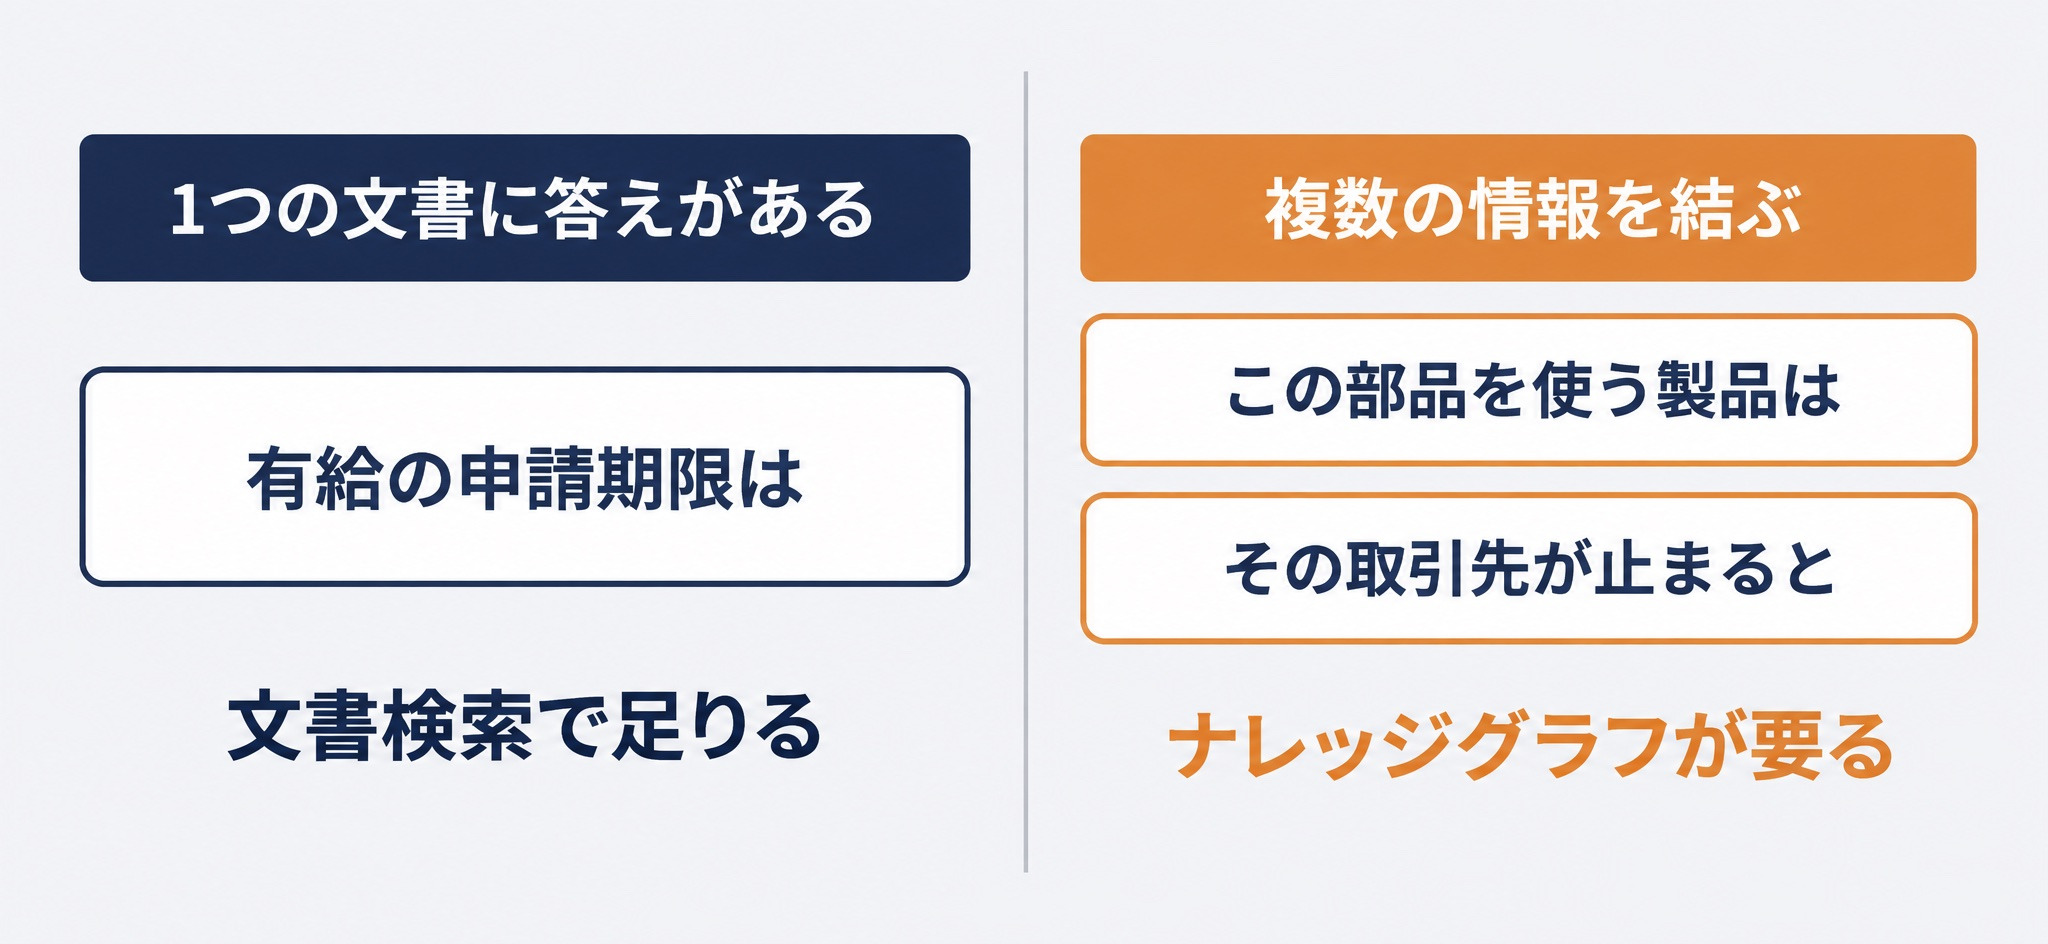
1つ目は、答えが1か所に書かれていない問いです。
たとえば製造業で「ある部品の供給が止まったとき、影響を受ける製品と出荷先はどこか」を知りたい場合、部品表、製品仕様、出荷記録という別々の資料をたどる必要があります。文書検索は各資料の中から近い記述を返しますが、資料をまたいだ先までは追えません。ナレッジグラフは、この経路そのものをデータとして持ちます。
全体を見渡す問い。文書をまたいで数える、傾向をまとめる
2つ目は、個別の記述ではなく集まり全体を見ないと答えが出ない問いです。「対応が長引いた問い合わせに共通する原因は何か」「この1年で最も多く言及された設備はどれか」といった形が該当します。
この弱点は研究でも指摘されています。GraphRAGの論文「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」(2024年4月投稿)は、従来の方式では「このデータ集合の主なテーマは何か」といった全体を見渡す問いに答えられないことを出発点に置いています。
同じものを指す別の言葉が混在している問い
3つ目は、社内で呼び方が割れている場合です。同じ製品が、正式名称、型番、現場の通称の3通りで書かれていることは珍しくありません。文書検索ではどれか1つの言い方で書かれた資料しか引けず、担当者は自分の知っている呼び方の分だけを見て判断してしまいます。
ナレッジグラフでは、これらを1つのエンティティにまとめ、別の呼び方を属性として持たせられます。呼び方が何通りあっても、指している対象が1つに定まります。
ナレッジグラフを作らなくてよい場合
一方で、次のような場合は構築の手間に見合いません。判断の目安を整理します。
| 問いの型 | 例 | 適した手段 |
|---|---|---|
| 1つの文書に答えが書いてある | 経費精算の締め日はいつか | 文書検索で足ります |
| 言い換えに強い検索がほしい | 「申請」と書かれた規程を「届出」で探したい | 文書検索で足ります |
| 複数の資料を結んで答える | この設備の保守を担当した業者と、その後の不具合 | ナレッジグラフが効きます |
| 集まり全体を数える、まとめる | 昨年度に最も多く故障した部位はどこか | ナレッジグラフが効きます |
| 呼び方が割れている対象を扱う | 型番と通称が混在する製品の履歴 | ナレッジグラフが効きます |
この表から読み取れるのは、上の2つに当てはまる問いしか出てこない段階では、ナレッジグラフを急ぐ必要はないということです。まず文書を貯めて探せるようにする段階はナレッジベースとはで扱っています。なお、そもそも担当者の頭の中にしかない知識は、どちらの手段でも扱えません。書き起こしの進め方は暗黙知をAIで形式知化する方法をご覧ください。
ナレッジグラフの活用例。公開されているものと、企業での使い方
どんな問いに効くかが分かったので、実際に使われている形を見ていきます。公開されているものから見ると、自社で作る場合の規模感もつかめます。
公開されているナレッジグラフ。Wikidataと農研機構の農作業基本オントロジー
誰でも内容を確認できる例が2つあります。
1つはWikidataです。人物、地名、作品などを構造化して収録しており、統計ページによると2026年9月21日時点で1億2,000万件を超えるアイテムが登録されています。
もう1つは、農研機構が公開している農作業基本オントロジーです。公開資料によると、2015年5月12日に公開され、RDF形式のファイルとして配布されています。作られた目的は、同じ作業が「稲刈り」と書かれたり「稲刈」と書かれたりする表記の揺れと、概念の階層の食い違いを解消することでした。2016年時点で374の農作業概念を収録しています。
この目的は、社内ナレッジで起きていることとほぼ同じです。規模は違っても、やることは変わりません。
製造業での使い方。部品、製品、取引先、不具合をつなぐ
製造業では、部品表、設計情報、調達先、不具合の記録がそれぞれ別のシステムに入っていることが一般的です。これらをエンティティと関係の形で結ぶと、部品を起点に製品と取引先をたどれるようになります。
リベルクラフトでも、ある製造業のお客様で、部門ごとに分かれた資料を横断して検索できるようにする取り組みをご支援しています。製造業での生成AI活用全般は製造業における生成AIの活用にまとめています。
保守とカスタマーサポートでの使い方。問い合わせと過去の対応をつなぐ
保守やサポートの現場では、「この症状は過去にもあったか」「そのとき何をして解決したか」が繰り返し問われます。問い合わせ、機器、部位、対処をエンティティとして結んでおくと、症状から過去の対応をたどれます。
文書検索だけで組んだ場合との違いは、同じ症状が別の言葉で記録されていても1つにまとまる点です。RAGでの事例はRAGの活用事例で扱っています。
人と組織での使い方。誰が何を知っているかをたどる
社員、担当した案件、扱った技術、作成した資料を結ぶと、「この技術に詳しいのは誰か」という問いに答えられるようになります。異動や退職で担当が変わったときに、前任者の周辺情報をたどれる点も実務では効きます。
ナレッジを組織で回す仕組みそのものについては、AIを活用したナレッジ共有をあわせてご覧ください。
ナレッジグラフの作り方。社内ナレッジから組み立てる5つのステップ
使いどころが見えたところで、作ると決めた場合に何から手をつけるかに移ります。順番を守ることが、手戻りを減らす近道になります。
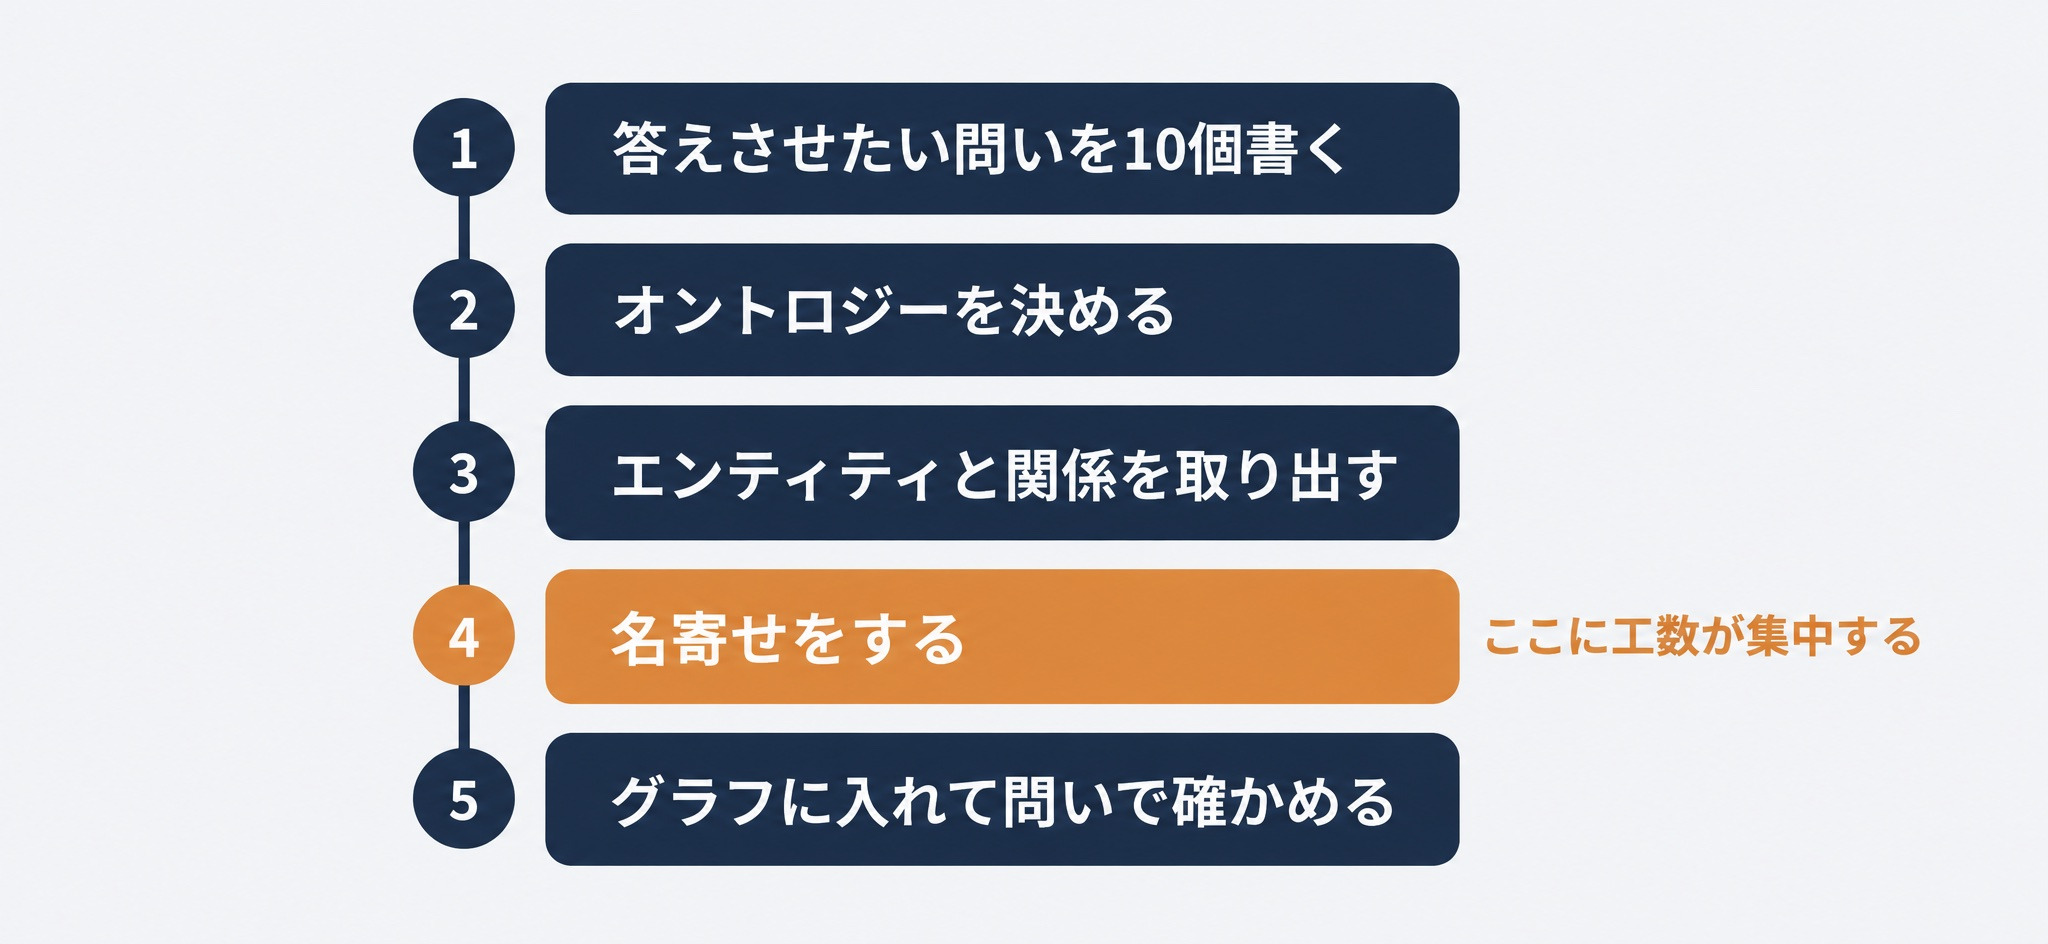
1. 答えさせたい問いを10個書き出す
推進担当が、業務部門の担当者と一緒に、実際に答えてほしい問いを10個ほど具体的な文で書き出します。「部品の供給が止まったとき、影響する製品と出荷先を知りたい」のように、誰がいつ聞くのかまで書きます。
この10個が、以降のすべての判断のよりどころになります。どのデータを対象にするか、どんな関係を持たせるか、完成したかどうかをどう判定するか。すべてここから決まります。AIの取り組みで何を決めるべきかの整理はAIの要件定義で扱っています。
2. オントロジーを決める。扱うモノの種類と関係の種類を定義する
次に、10個の問いに答えるために必要なモノの種類と関係の種類を決めます。製品、部品、取引先、不具合という4種類と、「使用している」「納入している」「発生した」という3種類の関係、といった具合です。
ここで決めるのは名前と粒度です。農研機構の例のように、「稲刈り」と「稲刈」を別の概念として扱うのか同じ概念とみなすのかを、業務部門の担当者と技術部門の担当者が一緒に決めます。技術部門だけで決めると、現場の使う言葉と合わず、あとから作り直しになります。最初は10個の問いに必要な範囲に絞り、種類を増やしすぎないことが大切です。
3. 社内データからエンティティと関係を取り出す
決めた設計に沿って、実際のデータを集めます。取り出し元は2種類に分かれます。
- 既存システムの表形式データ:部品表、顧客管理、設備台帳など。項目の対応づけを決めれば機械的に変換できます
- 文書:報告書、議事録、手順書など。文中から対象と関係を取り出す作業が必要で、近年はLLMに下書きさせて人が確認する進め方が取られます
どのデータがどこにあり、どれが最新かを先に洗い出しておくと、この工程が短くなります。対象データの棚卸しの進め方はデータ活用の進め方、社内データの整え方はRAGで社内データを活用する方法で扱っています。
4. 名寄せをする。同じものを指す表記を1つにまとめる
集めたデータには、同じ対象を指す別々の表記が混ざっています。会社名の表記の揺れ、部品の型番と通称、同姓同名の担当者。これらを1つのエンティティにまとめる作業が名寄せです。
やり方は、機械的な照合で候補を出し、判断が割れるものを人が確認する形になります。ここが構築の工数の大半を占めます。後述するとおり、多くの取り組みがこの工程で止まります。
5. グラフに入れて、最初の10個の問いで確かめる
最後に、整えたデータをグラフデータベースに取り込み、ステップ1で書いた10個の問いを実際に投げて確かめます。答えが返らない問いがあれば、原因がオントロジーの設計にあるのか、データの不足にあるのか、名寄せの漏れにあるのかを切り分けて戻ります。
この確認を最初に設計しておくことが、完成の定義になります。決めずに進めると、どこまで作れば終わりなのかが誰にも分からなくなります。
ナレッジグラフの構築でつまずく3つの箇所。技術より合意と名寄せ
手順どおりに進めても、多くの現場が同じ場所で止まります。止まる理由は技術の難しさではなく、決めごとと地道な作業にあります。
つまずき1。何に答えさせたいかが決まらないまま設計に入る
最も多いのがこれです。「社内の知識を全部つないだら便利そうだ」という動機で始めると、対象が際限なく広がります。何を入れるかの基準がないため、オントロジーの議論も終わりません。
対処は単純で、ステップ1の10個の問いに戻ることです。その問いに答えるために要らないものは、最初のうちは入れません。
つまずき2。名寄せが終わらない
2つ目は、名寄せの作業量を見積もっていないことです。部署ごとに呼び方が違い、過去の記録ほど表記が揺れています。機械的な照合では判断できない組み合わせが残り、その1件ずつに業務部門の判断が要ります。
現実的な進め方は、最初の10個の問いに関係する対象だけを名寄せの範囲にすることです。全社のデータをまとめて片づけようとすると、成果が出る前に力尽きます。
つまずき3。作ったあと誰も更新せず、権限も決まっていない
3つ目は運用です。新しい製品が増えたとき、担当が変わったとき、誰がグラフを更新するのかが決まっていないと、半年後には古い情報を返す仕組みになります。更新の担当と頻度を、作る前に決めておきます。
あわせて、誰がどの情報を見てよいかも先に決めます。人と組織の情報や、取引先ごとの契約条件を含むグラフは、全員が同じ内容を見てよいとは限りません。権限の設計は後付けが難しいため、着手前に決めておきます。詳細はRAGのセキュリティをご覧ください。運用を回す体制づくりはナレッジ管理の進め方で扱っています。
ここまでナレッジグラフの作り方を解説しましたが、「社内ナレッジをグラフにしたいが、設計や名寄せを自社だけで進められるか分からない」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、答えさせたい問いの仕分けからオントロジーの設計、名寄せ、グラフへの取り込みまでを業務部門の方と一緒に進められます。作って終わりにせず、RAGや社内の検索と組み合わせて業務で使う形にするところまでお引き受けできます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
ナレッジグラフの持ち方。RDFとプロパティグラフのどちらを選ぶか
進め方の勘所が分かったので、次はどの形式でデータを持つかを選びます。大きく2つの流儀があり、社外との連携を重視するか、社内での扱いやすさを重視するかで分かれます。
RDFとSPARQL。W3Cの標準仕様に沿って持つ
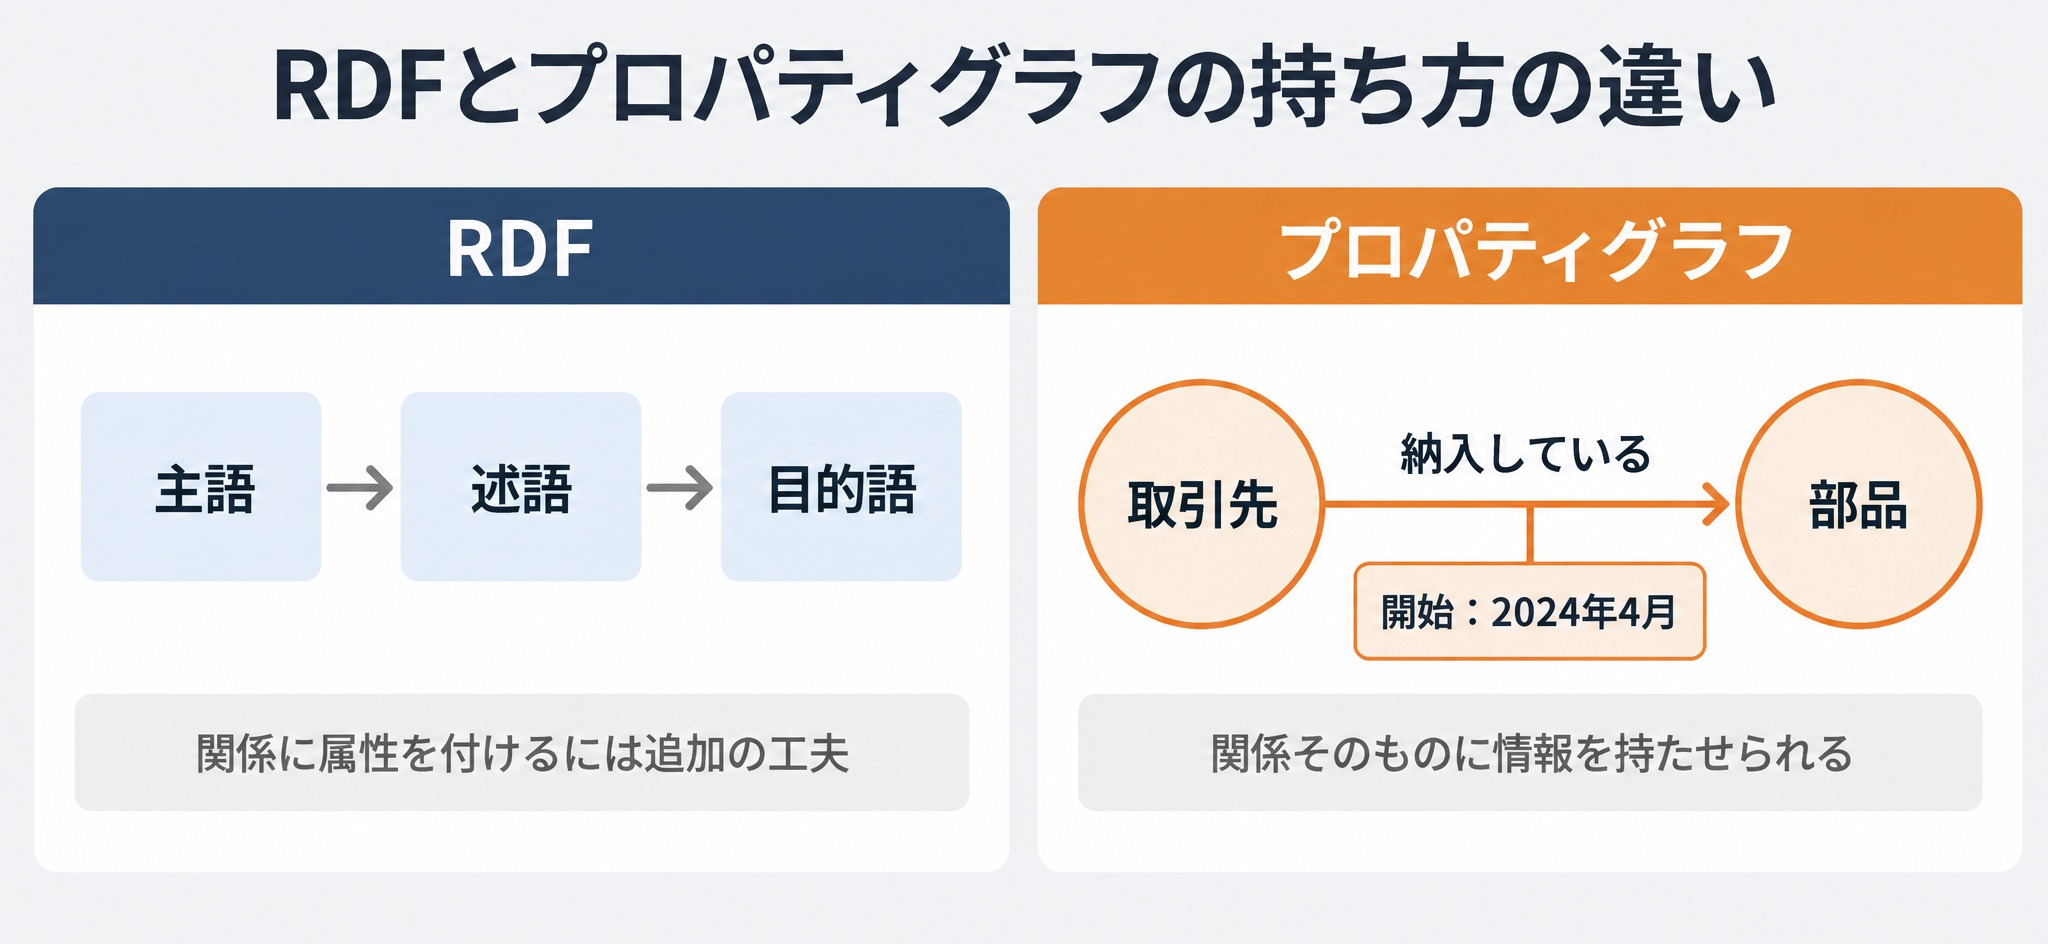
1つ目は、先に触れたトリプルの形で持つ流儀です。W3Cが標準仕様を定めており、問い合わせにはSPARQL 1.1 Query Language(2013年3月21日勧告)を使います。SPARQLは、保存形式が異なるデータ源に対しても同じ書き方で問い合わせられるように設計されています。
標準仕様の現在地も押さえておきます。2026年9月時点で勧告になっているのはRDF 1.1で、後継のRDF 1.2 Concepts and Abstract Data Modelは2026年4月7日に勧告候補として公開された段階です。RDF 1.2では、トリプルを別のトリプルの目的語に置けるようになるなどの拡張が入る予定です。いま設計するならRDF 1.1を前提に置き、1.2の動きは追いかける、という構えが現実的です。
プロパティグラフ。ノードと関係に属性を付けて持つ
2つ目は、点と線のそれぞれに属性を直接付けて持つ流儀です。Neo4jなどのグラフデータベースが採用しており、「この納入関係は2024年4月に開始した」のように、関係そのものに情報を持たせられます。
トリプルの形式では、関係に属性を付けるために追加の工夫が要ります。一方でプロパティグラフは仕様が製品ごとに分かれており、他組織のデータと直接つなぐ場面では手間が増えます。
どちらを選ぶかの判断
自社の用途からは、次のように判断できます。
| 判断の観点 | RDFが向く場合 | プロパティグラフが向く場合 |
|---|---|---|
| 標準仕様 | W3Cの仕様に沿わせたい | 製品の機能に沿って作りたい |
| 社外との連携 | 公開データや他組織のデータとつなぐ | 社内で完結する |
| 関係への属性 | 関係そのものの情報は少ない | 期間や数量など関係に情報を持たせたい |
| 主な用途 | 語彙や分類の共通化、公開 | 経路の探索、社内での分析 |
表から読み取れるのは、社内ナレッジを社内で使うだけならプロパティグラフのほうが始めやすいということです。一方、業界共通の語彙に合わせる予定があるならRDFを選びます。なお、どちらを選んでも、ステップ1からステップ4までの作業内容は変わりません。
ナレッジグラフと生成AIの関係。RAGで届かない問いを補う
持ち方まで決まったところで、生成AIとどう噛み合うのかを押さえます。ここが2026年時点で最も関心を集めている部分です。
ベクトル検索だけでは届かない問いがある
社内文書をAIに答えさせる仕組みは、文書を区切ってベクトルに変換し、質問に近い断片を取り出して回答の根拠にする構成が主流です。この構成と大規模言語モデルの役割分担はRAGとLLMの違いで扱っています。
この構成は、答えが1か所に書かれている問いには強い一方、先に挙げたつながりをたどる問いと全体を見渡す問いでは根拠を集めきれません。根拠が足りないまま回答を作らせると、もっともらしい誤りが出やすくなります。この現象と対策はAIのハルシネーションとはで扱っています。
グラフを使うRAG(GraphRAG)という方向
そこで、文書からナレッジグラフを作り、それを根拠として使う方向が出てきました。Microsoft Researchが2024年2月13日に公開したGraphRAG: Unlocking LLM discovery on narrative private dataは、従来の構成が、共通の属性を通じて別々の情報を結ぶことと、大きなデータの集まり全体を要約した概念を捉えることを苦手としていると述べ、LLMが作ったナレッジグラフを使ってこれを補う手法を示しています。エージェントが検索を繰り返す構成についてはAgentic RAGとはで扱っています。
先にナレッジグラフを作るべきか、RAGから始めるべきか
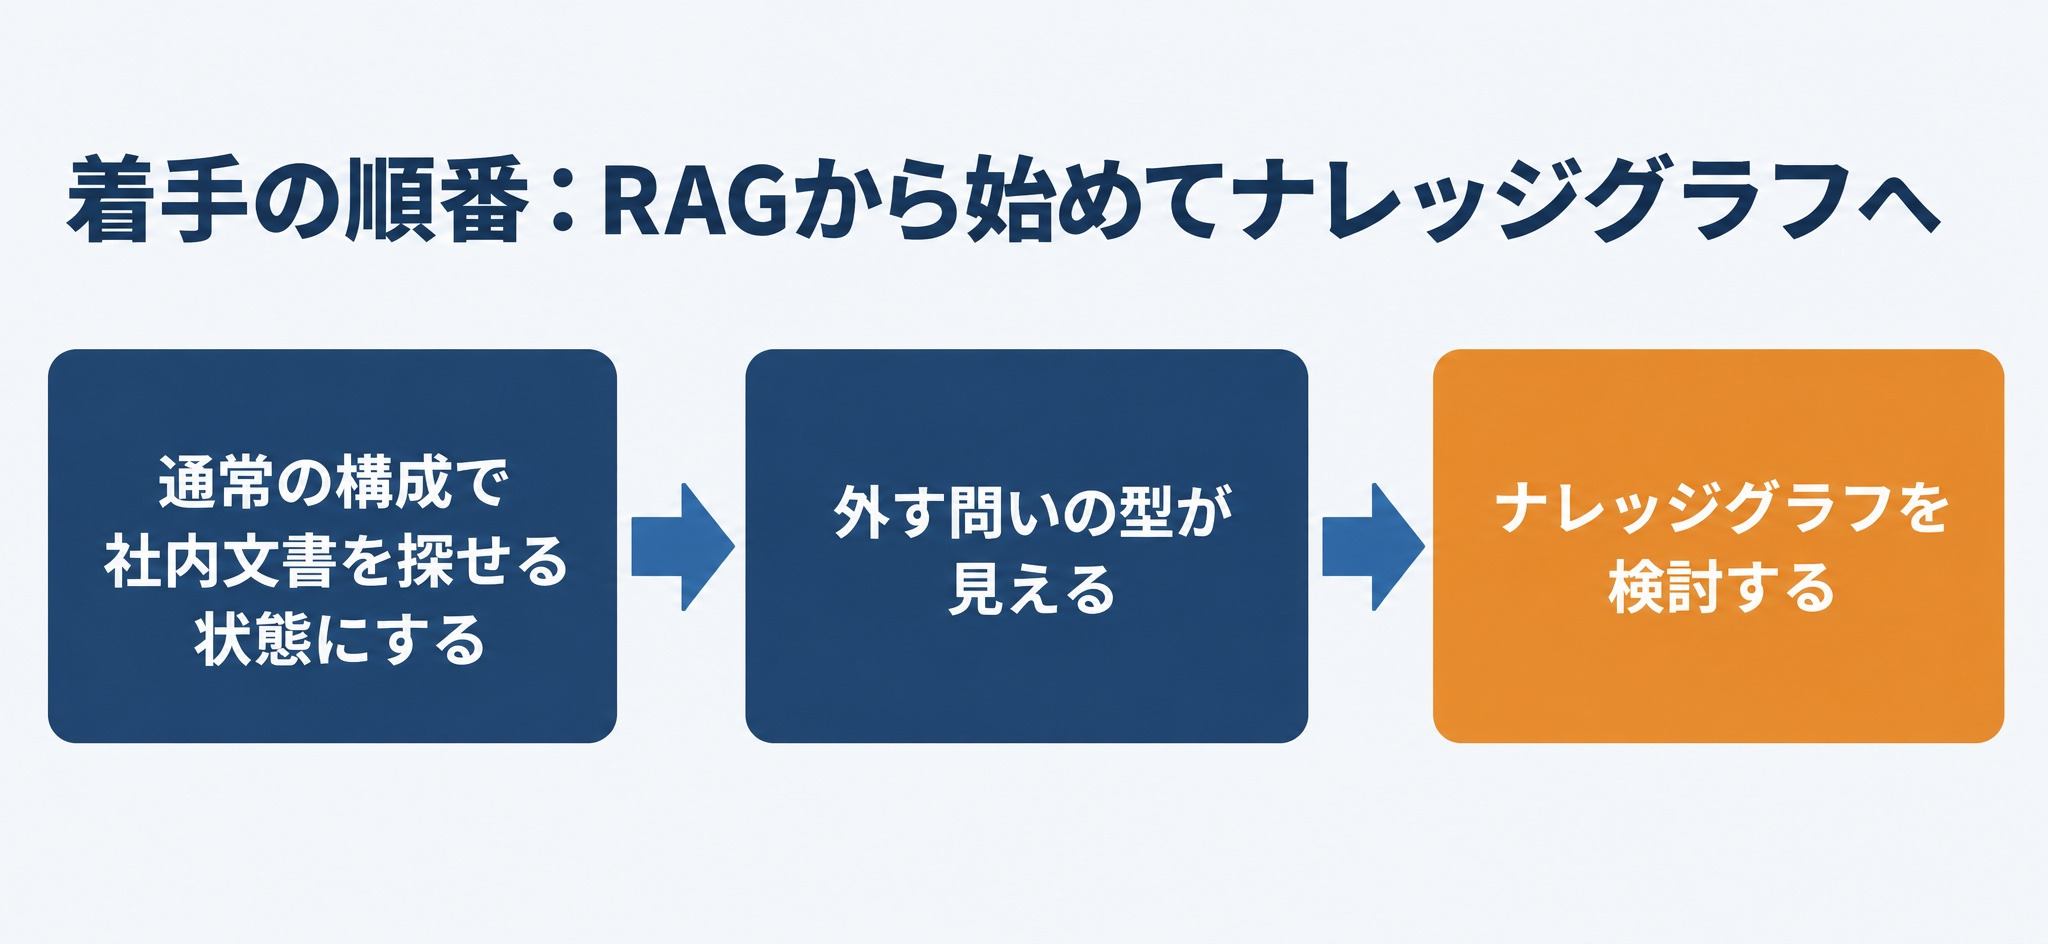
最後に着手の順番です。リベルクラフトでは、まず通常の構成で社内文書を探せる状態にし、そこで外す問いの型が見えてからナレッジグラフを検討することをおすすめしています。理由は3つあります。
- 外す問いの型が分からないと、作る範囲を決められない。ステップ1の10個の問いは、実際に使ってみて初めて具体的に書けます
- 文書検索で足りる問いが想像より多い。先に試すことで、グラフを作る対象を絞れます
- 評価の土台ができる。どの問いに答えられるようになったかを比べる相手がないと、効果を判定できません
評価の進め方はRAGの評価とRagasで扱っています。順番を逆にすると、作ったあとで「これは文書検索でも答えられた」と分かる事態が起きます。
ナレッジグラフのまとめ
- ナレッジグラフとは、現実のモノと、モノどうしの関係を、点と線のつながりとして表した知識のデータ。日本語では知識グラフとも呼ぶ
- 組み立てる部品はエンティティ、リレーション、プロパティの3つ。主語と述語と目的語の3つ組であるトリプルが最小単位にあたる
- オントロジーは設計図、ナレッジグラフはその設計図で作った実データ。先に設計図を決めないとあとからつながらない
- 効くのは、複数の情報を結ぶ問い、集まり全体を見渡す問い、呼び方が割れている対象を扱う問いの3つ。1つの文書に答えが書いてある問いは文書検索で足りる
- 作り方は、答えさせたい問いを10個書き出す、オントロジーを決める、データから取り出す、名寄せをする、最初の問いで確かめる、の5ステップ
- 工数が集中するのは名寄せと、オントロジーについての業務部門との合意。どちらも技術ではなく決めごとと地道な作業
- 生成AIと組み合わせるなら、まず通常の構成で試し、外す問いの型が見えてからグラフを検討する
最初に手をつけるのは、道具の選定ではなく、答えさせたい問いを10個書き出すことです。
ナレッジグラフと社内ナレッジ活用の相談は「リベルクラフト」へ
ここまで読んで、「仕組みと進め方は分かったが、自社のデータでどこまで作れるのか、何から着手すべきかまでは決めきれない」と感じた方も多いのではないでしょうか?
リベルクラフトでは、戦略・構想の立案、AIシステムのものづくり、社内人材を育てる教育・スクールの3軸で、企業のAI・データ活用の内製化を支援しています。社内ナレッジの活用についても、対象業務の選定からデータの整理、ナレッジグラフやRAGの設計、評価の仕組みづくり、本番運用までを一貫してお受けしています。
次のようなニーズをお持ちの方に適しています。
- 社内に散らばった情報をつないで使いたいが、進め方から相談したい
- すでに社内文書の検索を作ったものの、答えられない問いの扱いを決めたい
- 自社でどこまで内製し、どこからを外部に任せるかを整理したい
構想段階のご相談でも問題ありません。自社の社内ナレッジをどう扱えばよいか、まずはお気軽にご相談ください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。