ABテストとは?やり方6ステップと期間・有意差の決め方、ツールと事例を解説
「LPのABテストを2週間回して、成績のよかった方を採用している」という方も多いでしょう。ツールの画面に「勝ち」と表示されれば、そのまま本番に反映したくなります。
しかし、その2週間という期間や「有意差あり」という表示が、本当に自社の条件で信頼できるのかを説明できる担当者は多くありません。必要な人数が足りないまま判定したり、途中で何度も結果を見て止めたりすると、効果のない変更を「勝ち」と誤って採用してしまいます。
そこで本記事では、
- ABテストの仕組みと種類
- ABテストのやり方6ステップ
- 必要な人数と期間の決め方、有意差の判定手順(Pythonの実行結果つき)
- 結果を誤る4つの落とし穴と、ツールの選び方、公表された事例
についてわかりやすく解説します。Webサイトや広告の改善を担当していて、ABテストの結果を自信を持って社内に説明したい方は、ぜひ最後までご覧ください。
「ABテストの設計や結果の判定を、根拠のある手順で進めたい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
ABテストとは。仕組みと種類
ABテストとは、ユーザーをランダムに2つのパターン(AとB)へ振り分け、同じ期間に表示して、成果の指標を比べる検証方法です。LPの見出し、申し込みボタンの文言、広告のクリエイティブ、メールの件名など、Web上の施策の多くが対象になります。
ランダムに振り分ける理由
ABテストの核は「ランダムに振り分ける」ことにあります。
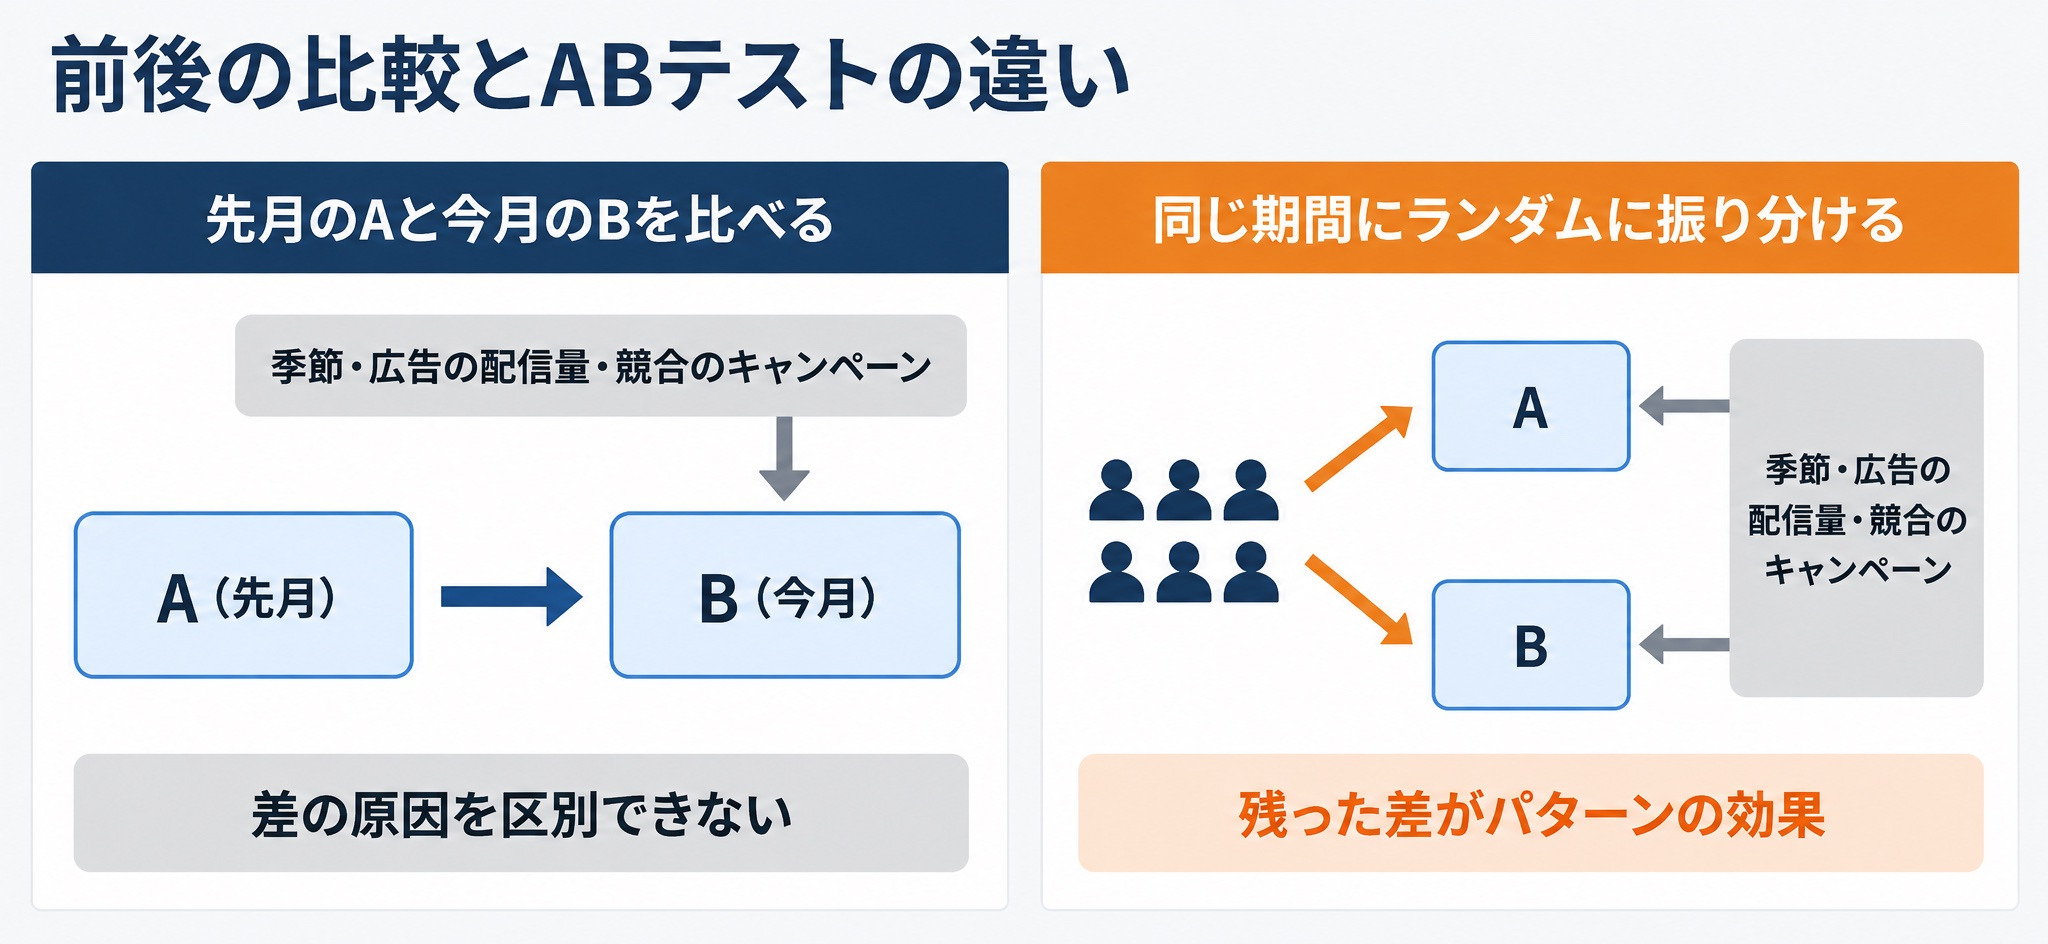
例えば、先月のLP(A)と今月の新しいLP(B)のCVRを比べるだけでは、差がLPの違いによるものか、季節・広告の配信量・競合のキャンペーンの影響によるものかを区別できません。同じ期間に訪問者をランダムに振り分けると、こうした外部の影響はAとBに同じように入ります。そのため、残った差をパターンの違いによる効果と考えられます。
ABテストは、多くのデータ分析手法の中でも「施策の効果」を直接確かめられる数少ない方法です。集計や相関分析との違いは、以下の記事で整理しています。
参照記事:データ分析の手法16選(種類・目的別にポイント解説)
ABテストの主な種類
ABテストには、変更の仕方によっていくつかの種類があります。
- 同一URLテスト:同じURLのまま、見出しや画像など一部の要素だけを出し分ける。最も基本的な形
- リダイレクトテスト:Bのパターンを別URLに用意し、訪問者の一部を転送する。ページ全体を作り替えるときに使う
- 多変量テスト:複数の要素(例:画像3種×ボタン2種)の組み合わせを同時に比べる。組み合わせの数だけ訪問者が分散するため、ABテストよりも多くのアクセスが必要
リダイレクトテストでは、転送の分だけBの表示が遅れ、読み込み中に離脱した人がBにだけ偏ることがあります。ページの速度が結果に混ざるため、判定の前に後述する振り分け比率の確認を行ってください。
ABテストが向かない場面
ABテストは万能ではありません。次のような場面では、別の方法を検討します。
- 1日の訪問者やコンバージョンが少なく、必要な人数を集めるのに数か月かかる
- 価格改定やブランド変更のように、一部の人にだけ見せると不公平や混乱が生じる
- 解約率やLTV(顧客生涯価値)のように、成果が出るまで長い期間がかかる
このような場合は、施策の前後比較に別の比較対象を組み合わせる方法(差分の差分法など)を使います。
ABテストのやり方6ステップ
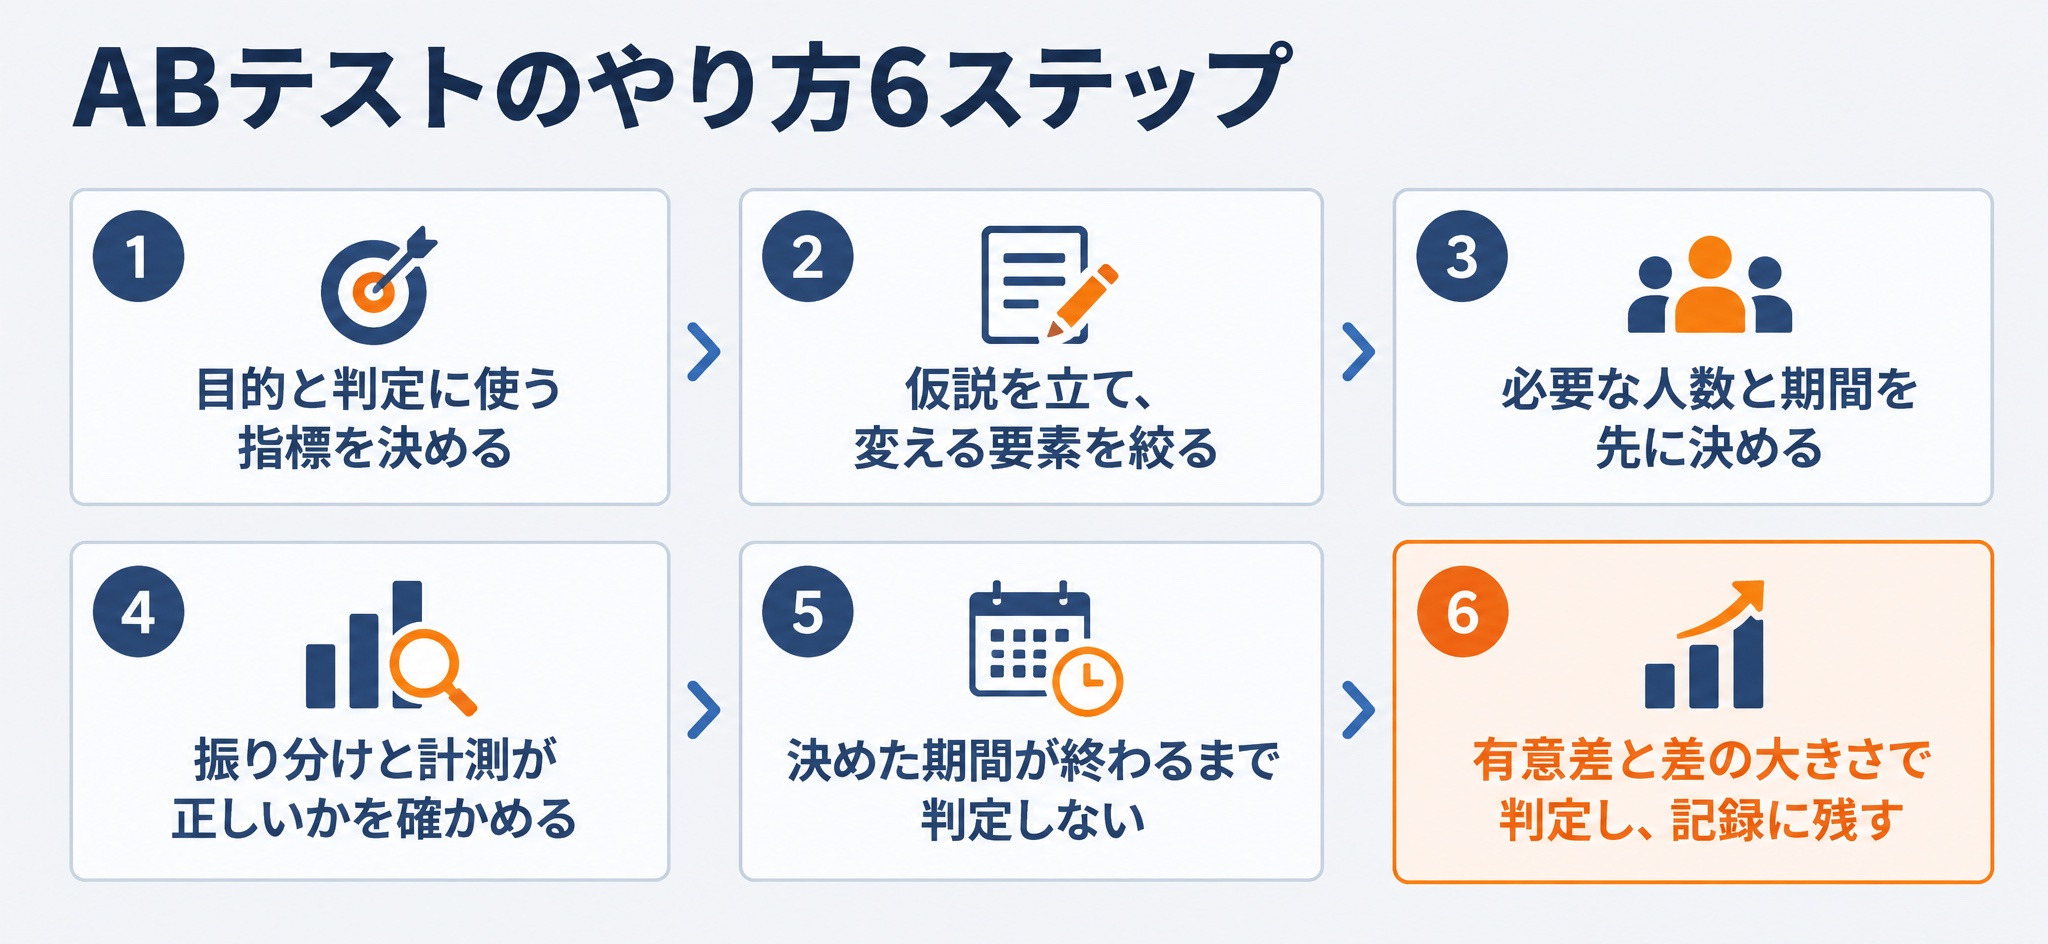
ABテストの仕組みが分かったところで、実際に何をどの順番で進めるかを6ステップで整理します。ツールの操作よりも、始める前に決めておくことのほうが結果の信頼性を左右します。
1. 目的と判定に使う指標を決める
事業の責任者と担当者で、「何が改善されれば成功とするか」を1つの主要指標に決めます。例えば資料請求LPなら、ボタンのクリック率ではなく資料請求の完了率を主要指標にします。
あわせて、悪化させてはいけない指標(ガードレール指標)も決めます。申し込み数が増えても、問い合わせの質が下がったりページの表示速度が落ちたりしては意味がないためです。
2. 仮説を立て、変える要素を絞る
担当者が、アクセス解析やヒートマップ、顧客の声から「なぜ今のCVRが低いのか」を考え、「ファーストビューで料金の目安が分からないことが離脱の原因なので、料金の目安を見出しの下に置けば資料請求率が上がるはずだ」のように、原因と打ち手をセットにした仮説を書きます。
変える要素は原則1つに絞ります。見出しと画像とボタンを同時に変えると、勝ったとしてもどの変更が効いたのかが分かりません。仮説のもとになる現状分析の進め方は、以下の記事が参考になります。
参照記事:マーケティングに効くデータ分析とは?5W1H別に使える手法15選を紹介
3. 必要な人数と期間を先に決める
テストを始める前に、現状のCVRと検出したい差から、1パターンあたりに必要な人数を計算します。その人数を1日の訪問者数で割れば、必要な期間が決まります。計算方法は次の章で詳しく解説します。
4. 振り分けと計測が正しいかを確かめる
実装担当者が、ツールの設定どおりにAとBへ振り分けられているか、コンバージョンが両方で同じように計測されているかを確認します。
余裕があれば、本番の前にA/Aテストを行います。A/Aテストとは、AとBにまったく同じページを表示するテストです。差がないはずなのに有意差が頻繁に出る場合は、計測や振り分けの仕組みに問題があります。
5. 決めた期間が終わるまで判定しない
ステップ1〜3で決めた内容(主要指標・仮説・人数・期間・有意水準)をテスト計画書に書き、関係者と共有してから開始します。開始後は、途中で「勝っているから止める」「負けているから延ばす」といった判断をしません。途中で止めると誤判定が大きく増えることを、後半のシミュレーションで確かめます。
6. 有意差と差の大きさで判定し、記録に残す
期間が終わったら、振り分け比率のずれがないかを確認したうえで、主要指標の有意差と差の大きさを判定します。勝ち負けにかかわらず、仮説・結果・学びを記録しておくと、次のテストの仮説づくりに使えます。
ABテストの期間とサンプルサイズの決め方
ステップ3で、必要な人数と期間を先に決めると書きました。ここでは、その決め方を計算で示します。
多くの解説記事では「期間は2週間以上」「1パターンあたりCV30件以上」といった目安が紹介されていますが、必要な人数は現状のCVRと、どれだけの差を見つけたいかで大きく変わります。
必要な人数を決める4つの数字
必要な人数(サンプルサイズ)は、次の4つの数字で決まります。
- 現状のCVR:Aのコンバージョン率。過去のデータから求める
- 検出したい差:「3.0%を3.6%に上げたい」のように、見逃したくない最小の改善幅
- 有意水準:本当は差がないのに「差がある」と誤判定する確率の上限。一般に5%
- 検出力:本当に差があるときに、それを「差がある」と正しく判定できる確率。一般に80%
2つのCVRを比べる場合、1パターンあたりの必要人数 n は次の式で近似できます(出典:Kim HY, Statistical notes for clinical researchers: Sample size calculation 2, 2016)。
n = (z<sub>1−α/2</sub> + z<sub>1−β</sub>)² × { p<sub>A</sub>(1−p<sub>A</sub>) + p<sub>B</sub>(1−p<sub>B</sub>) } ÷ (p<sub>A</sub> − p<sub>B</sub>)²
記号の意味は次のとおりです。p<sub>A</sub> は現状のCVR、p<sub>B</sub> は変更後に期待するCVR、α は有意水準、1−β は検出力です。z<sub>1−α/2</sub> と z<sub>1−β</sub> は標準正規分布から決まる値で、有意水準5%(両側)なら1.96、検出力80%なら約0.84になります。
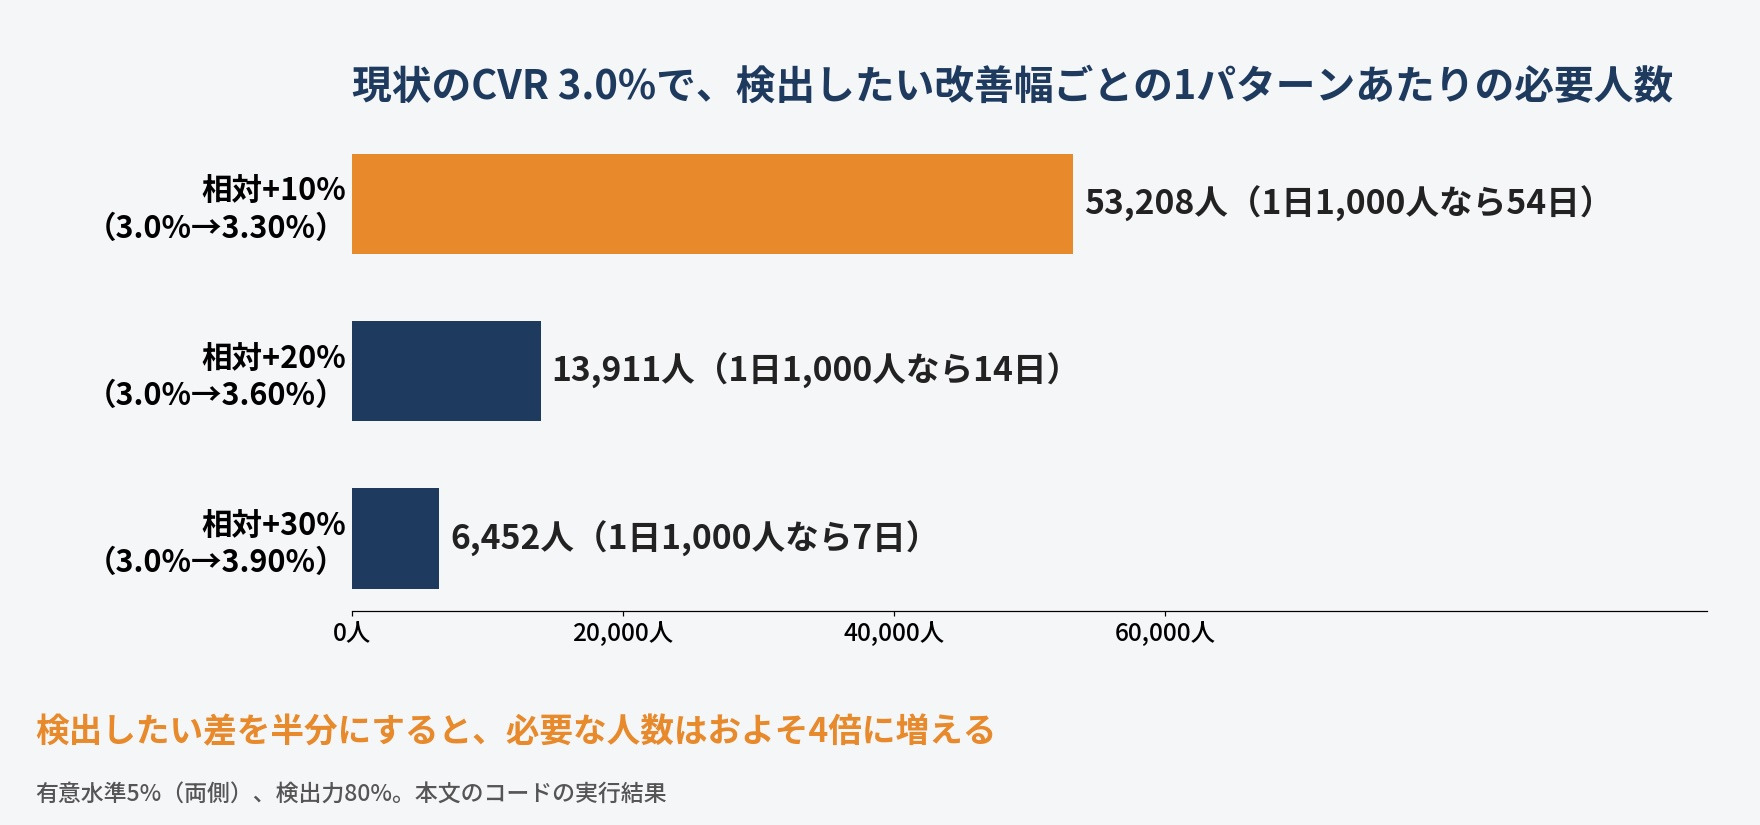
式の分母に差の2乗があるため、検出したい差を半分にすると、必要な人数はおよそ4倍に増えます。小さな改善を見つけたいほど、多くの訪問者が必要になるということです。
Pythonで必要な人数を計算する
現状のCVRを3.0%とし、相対で10%・20%・30%の改善を見つけたい場合の必要人数を、上の式とstatsmodels(Pythonの統計ライブラリ)の両方で計算しました。1日に1パターンあたり1,000人が訪れると仮定して、必要な日数も出しています。
# ABテストの必要サンプルサイズと実施期間(生成データ不要・計算のみ)
import math
from scipy.stats import norm
from statsmodels.stats.power import NormalIndPower
from statsmodels.stats.proportion import proportion_effectsize

def n_per_group(p1, p2, alpha=0.05, power=0.8):
    z_a = norm.ppf(1 - alpha / 2)   # 両側検定の臨界値
    z_b = norm.ppf(power)           # 検出力に対応する値
    n = (z_a + z_b) ** 2 * (p1 * (1 - p1) + p2 * (1 - p2)) / (p1 - p2) ** 2
    return math.ceil(n)

base = 0.03                 # 現状のCVR 3.0%
daily_per_group = 1000      # 1日あたり1パターンに振り分けられる訪問者数
for lift in [0.10, 0.20, 0.30]:
    p2 = base * (1 + lift)
    n = n_per_group(base, p2)
    h = proportion_effectsize(p2, base)
    n_sm = math.ceil(NormalIndPower().solve_power(effect_size=h, alpha=0.05, power=0.8, ratio=1.0))
    print(f"相対+{lift:.0%}({base:.1%}→{p2:.2%}): 1パターンあたり {n:,}人(statsmodels {n_sm:,}人)"
          f" → 1日{daily_per_group:,}人なら {math.ceil(n / daily_per_group)}日")
実行結果は次のとおりです。
相対+10%(3.0%→3.30%): 1パターンあたり 53,208人(statsmodels 53,182人) → 1日1,000人なら 54日
相対+20%(3.0%→3.60%): 1パターンあたり 13,911人(statsmodels 13,887人) → 1日1,000人なら 14日
相対+30%(3.0%→3.90%): 1パターンあたり 6,452人(statsmodels 6,429人) → 1日1,000人なら 7日
測定条件:Apple M1 Pro、Python 3.13.13、SciPy 1.18.0、statsmodels 0.14.6、実行日 2026年9月23日。statsmodelsの値は、比率を角変換した効果量(Cohen’s h)を使う別の近似式によるもので、手計算の式と数十人の差があります。
相対+20%の改善を狙う場合、1パターンあたり13,911人が必要で、1日1,000人なら14日かかります。一方、相対+10%の改善を見つけたい場合は53,208人、54日が必要です。「2週間」という目安は、この条件では相対+20%程度の大きな改善を狙う場合にしか当てはまりません。
期間は必要人数から逆算し、週単位で切り上げる
期間は「必要人数 ÷ 1日あたりの訪問者数」で求めます。そのうえで、曜日による行動の違いがAとBの比較に偏って入らないよう、計算した日数を7日単位に切り上げます。例えば計算上10日で必要人数に届く場合も、平日と週末が2回ずつ含まれる14日間は続けます。
計算の結果、期間が2か月を超えるようなら、テストの設計を見直します。変更をより大胆にして検出したい差を大きくする、トラフィックの多いページで試す、主要指標をより頻繁に起きる行動(例:フォームへの到達率)に置き換える、といった方法があります。
ABテストの有意差の判定手順
期間どおりにデータが集まったら、次は結果の判定です。ここでは、有意差の判定に使うp値と信頼区間の読み方を確認し、生成データで実際に判定してみます。
p値と信頼区間を両方見る
p値とは、「AとBに本当は差がない」と仮定したときに、観測された差以上の差が偶然に生じる確率です。p値が事前に決めた有意水準(例:5%)を下回れば、「差がないと考えるには不自然なほど大きな差」として有意差ありと判定します。
p値には、よくある誤解が2つあります。
- p値が0.05未満でも、「誤差が5%未満」「Bが勝つ確率が95%」という意味ではない
- p値が小さいほど効果が大きい、という意味ではない。訪問者が非常に多ければ、ごく小さな差でも有意になる
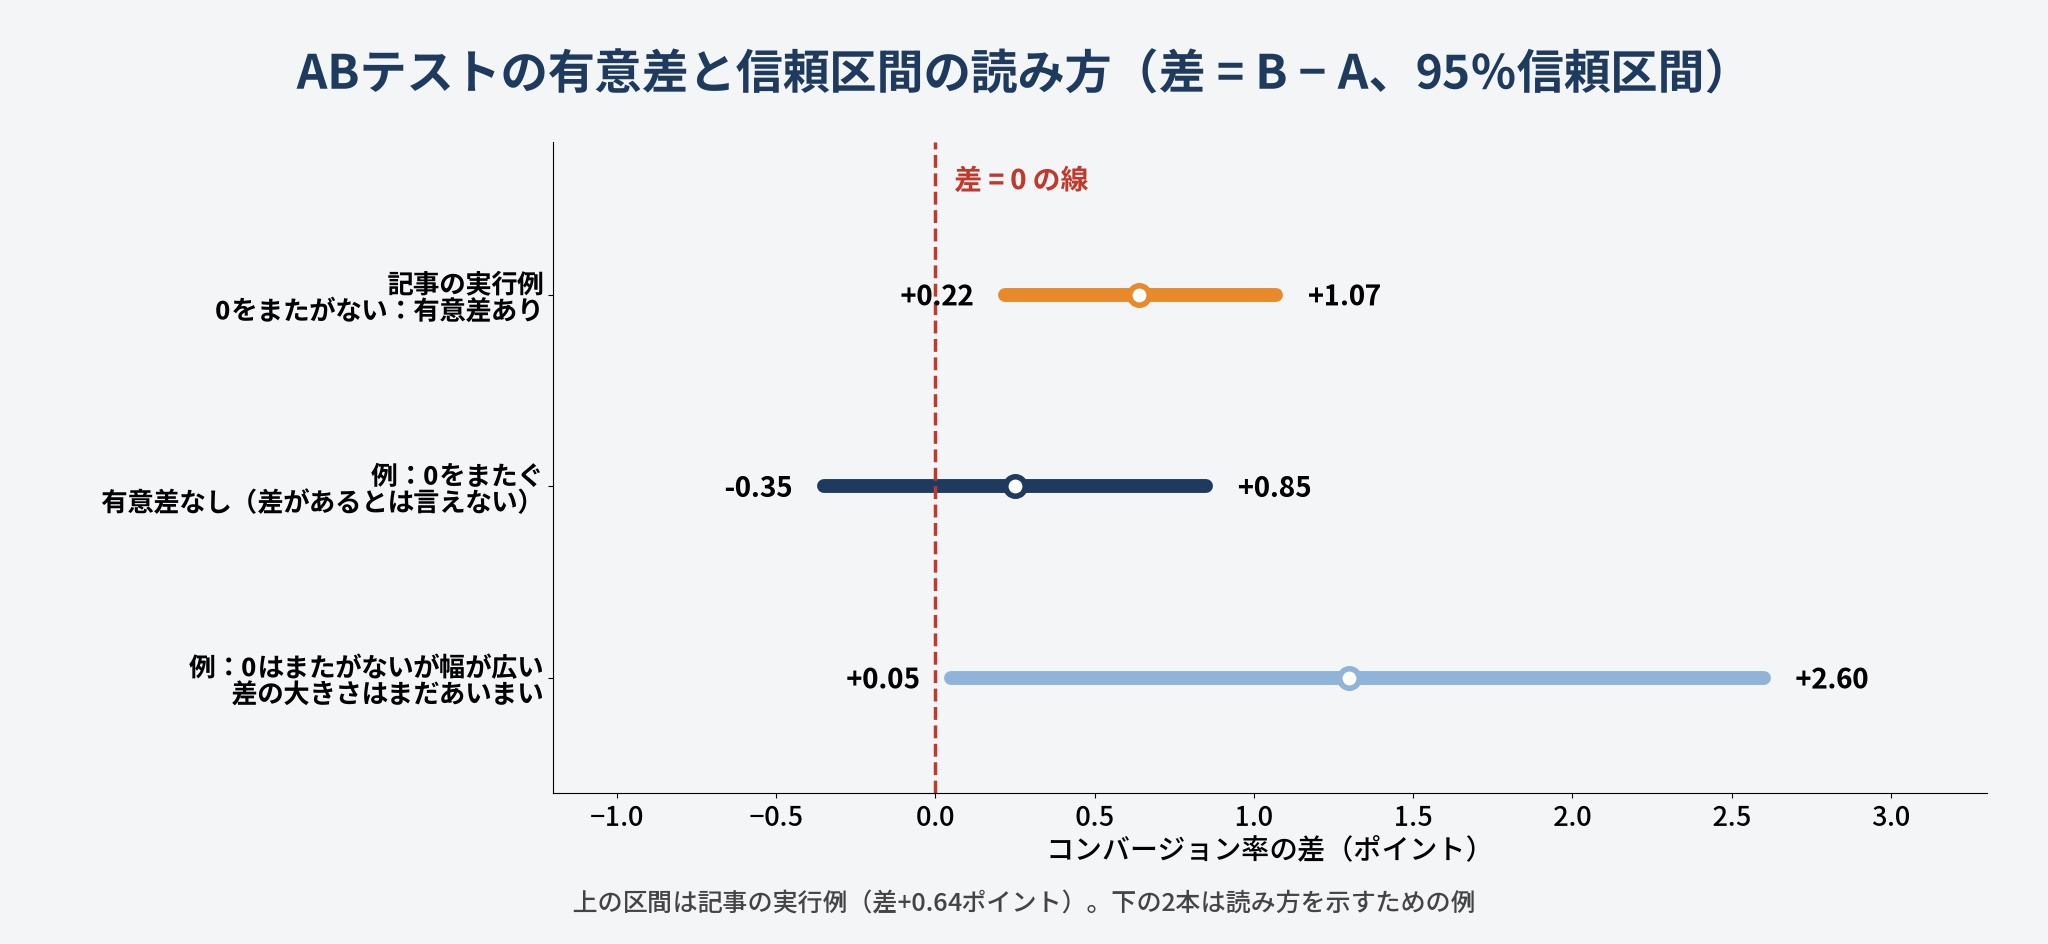
そこで、差の大きさは信頼区間で確かめます。95%信頼区間とは、同じ方法でテストを繰り返したとき、そのうち95%で真の差を含むように作られた範囲です。信頼区間が0をまたいでいなければ有意差ありと判断でき、区間の幅が広ければ差の推定がまだあいまいだと分かります。
Pythonで有意差を判定する
生成データで、判定の流れを確かめます。1日2,000人の訪問者を14日間、50:50でランダムに振り分け、Aの真のCVRを3.0%、Bを3.6%として乱数でデータを作りました。検定は2つの比率の差のz検定です(検定統計量の考え方は東北大学「統計学入門」講義資料を参照)。
# 生成データでABテストの結果を判定する(乱数シード固定)
import numpy as np
from scipy.stats import chisquare
from statsmodels.stats.proportion import proportions_ztest, confint_proportions_2indep

rng = np.random.default_rng(185)
total = 28000                          # 14日間の訪問者(1日2,000人)
n_a = rng.binomial(total, 0.5)         # 50:50でランダムに振り分け
n_b = total - n_a
cv_a = rng.binomial(n_a, 0.030)        # Aの真のCVRは3.0%と仮定して生成
cv_b = rng.binomial(n_b, 0.036)        # Bの真のCVRは3.6%と仮定して生成
print(f"A: {cv_a}/{n_a} = {cv_a/n_a:.2%}   B: {cv_b}/{n_b} = {cv_b/n_b:.2%}")

# 1) 振り分け比率の確認(サンプル比率の不一致=SRMのチェック)
_, p_srm = chisquare([n_a, n_b])
print(f"SRMチェック p値 = {p_srm:.3f}")

# 2) 2つの比率の差のz検定(両側)
z, p = proportions_ztest([cv_b, cv_a], [n_b, n_a])
print(f"z = {z:.2f}, p値 = {p:.4f}")

# 3) 差(B−A)の95%信頼区間(単位はポイント)
low, high = confint_proportions_2indep(cv_b, n_b, cv_a, n_a, compare="diff", method="wald")
diff = cv_b / n_b - cv_a / n_a
print(f"CVRの差 {diff*100:+.2f}ポイント(95%信頼区間 {low*100:+.2f} 〜 {high*100:+.2f}ポイント)")
実行結果は次のとおりです(測定条件は前の計算と同じ)。
A: 424/13956 = 3.04%   B: 517/14044 = 3.68%
SRMチェック p値 = 0.599
z = 2.99, p値 = 0.0028
CVRの差 +0.64ポイント(95%信頼区間 +0.22 〜 +1.07ポイント)
判定は次の順で読みます。
- 振り分け比率:SRMチェックのp値が0.599で、50:50の設定からずれていないと判断できる
- 有意差:p値0.0028は有意水準0.05を下回るため、有意差ありと判定する
- 差の大きさ:Bのほうが0.64ポイント高く、95%信頼区間は+0.22〜+1.07ポイント。改善幅は小さく見積もっても0.22ポイントある
この例では3つとも問題がないため、Bを採用すると判断できます。ただし、信頼区間の下限の+0.22ポイントでも事業上意味のある改善かどうかは、統計ではなく事業の目線で確かめます。
有意差が出なかったときの読み方
有意差が出なかった場合、「AとBは同じ」と結論づけるのは誤りです。有意差なしは、差がないことの証明ではなく、「この人数では差があるとは言えなかった」という意味にとどまります。
このときも信頼区間を見ます。区間が「−0.1〜+0.1ポイント」のように狭ければ、あっても小さな差だと分かります。「−0.5〜+1.0ポイント」のように広ければ人数が足りておらず、判断を保留するのが適切です。どちらの場合も、事前に決めた期間を過ぎてから延長を繰り返すと、次の章で扱う誤判定の原因になります。
ここまでABテストの期間と有意差の判定手順を解説しましたが、「必要な人数の計算や有意差の判定を、担当者の勘ではなく社内で決まった手順として回したい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、現状のCVRと訪問者数から必要な人数と期間を設計し、判定のルールを社内で使える形にまとめるご支援をしています。ツールの画面を読むだけでなく、自社のデータ基盤で結果を再集計し、振り分け比率のずれまで確かめられるため、信頼できる判断材料を継続して得られる仕組みをつくれます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
ABテストで結果を誤る4つの落とし穴
判定手順が分かったところで、手順どおりに計算しても結果を誤る典型的な原因を4つ確認します。いずれもツールの画面だけでは気づきにくいものです。
途中で何度も結果を見て止める
最も起こりやすいのが、テスト中に毎日結果を確認し、有意差が出た時点で止めてしまうことです。スタンフォード大学の研究者らは、途中で結果を監視し続けると通常のp値や信頼区間が信頼できなくなることを示しています(出典:Johari et al., Peeking at A/B Tests, KDD 2017)。
どれほど誤判定が増えるかを、差がまったくないA/Aテストのシミュレーションで確かめました。両方のCVRを3.0%、1日1パターン1,000人、28日間のテストを2,000回繰り返しています。
# 差がないA/Aテストを毎日のぞいて「有意になったら止める」と、誤判定はどれだけ増えるか
import numpy as np
from statsmodels.stats.proportion import proportions_ztest

rng = np.random.default_rng(2026)
sims, days, daily, p_true = 2000, 28, 1000, 0.03   # 2,000回試行・28日・1日1パターン1,000人・両群CVR3.0%
fp_peek = fp_fixed = 0
for _ in range(sims):
    a = rng.binomial(daily, p_true, size=days).cumsum()
    b = rng.binomial(daily, p_true, size=days).cumsum()
    n = daily * np.arange(1, days + 1)
    stopped = False
    for d in range(days):
        _, p = proportions_ztest([a[d], b[d]], [n[d], n[d]])
        if p < 0.05:
            stopped = True
            break
    fp_peek += stopped
    _, p_end = proportions_ztest([a[-1], b[-1]], [n[-1], n[-1]])
    fp_fixed += p_end < 0.05
print(f"最終日に1回だけ判定: 誤って『有意差あり』 {fp_fixed/sims:.1%}")
print(f"毎日のぞいて有意なら停止: 誤って『有意差あり』 {fp_peek/sims:.1%}")
実行結果は次のとおりです(測定条件は前の計算と同じ。NumPy 2.5.1)。
最終日に1回だけ判定: 誤って『有意差あり』 4.5%
毎日のぞいて有意なら停止: 誤って『有意差あり』 27.5%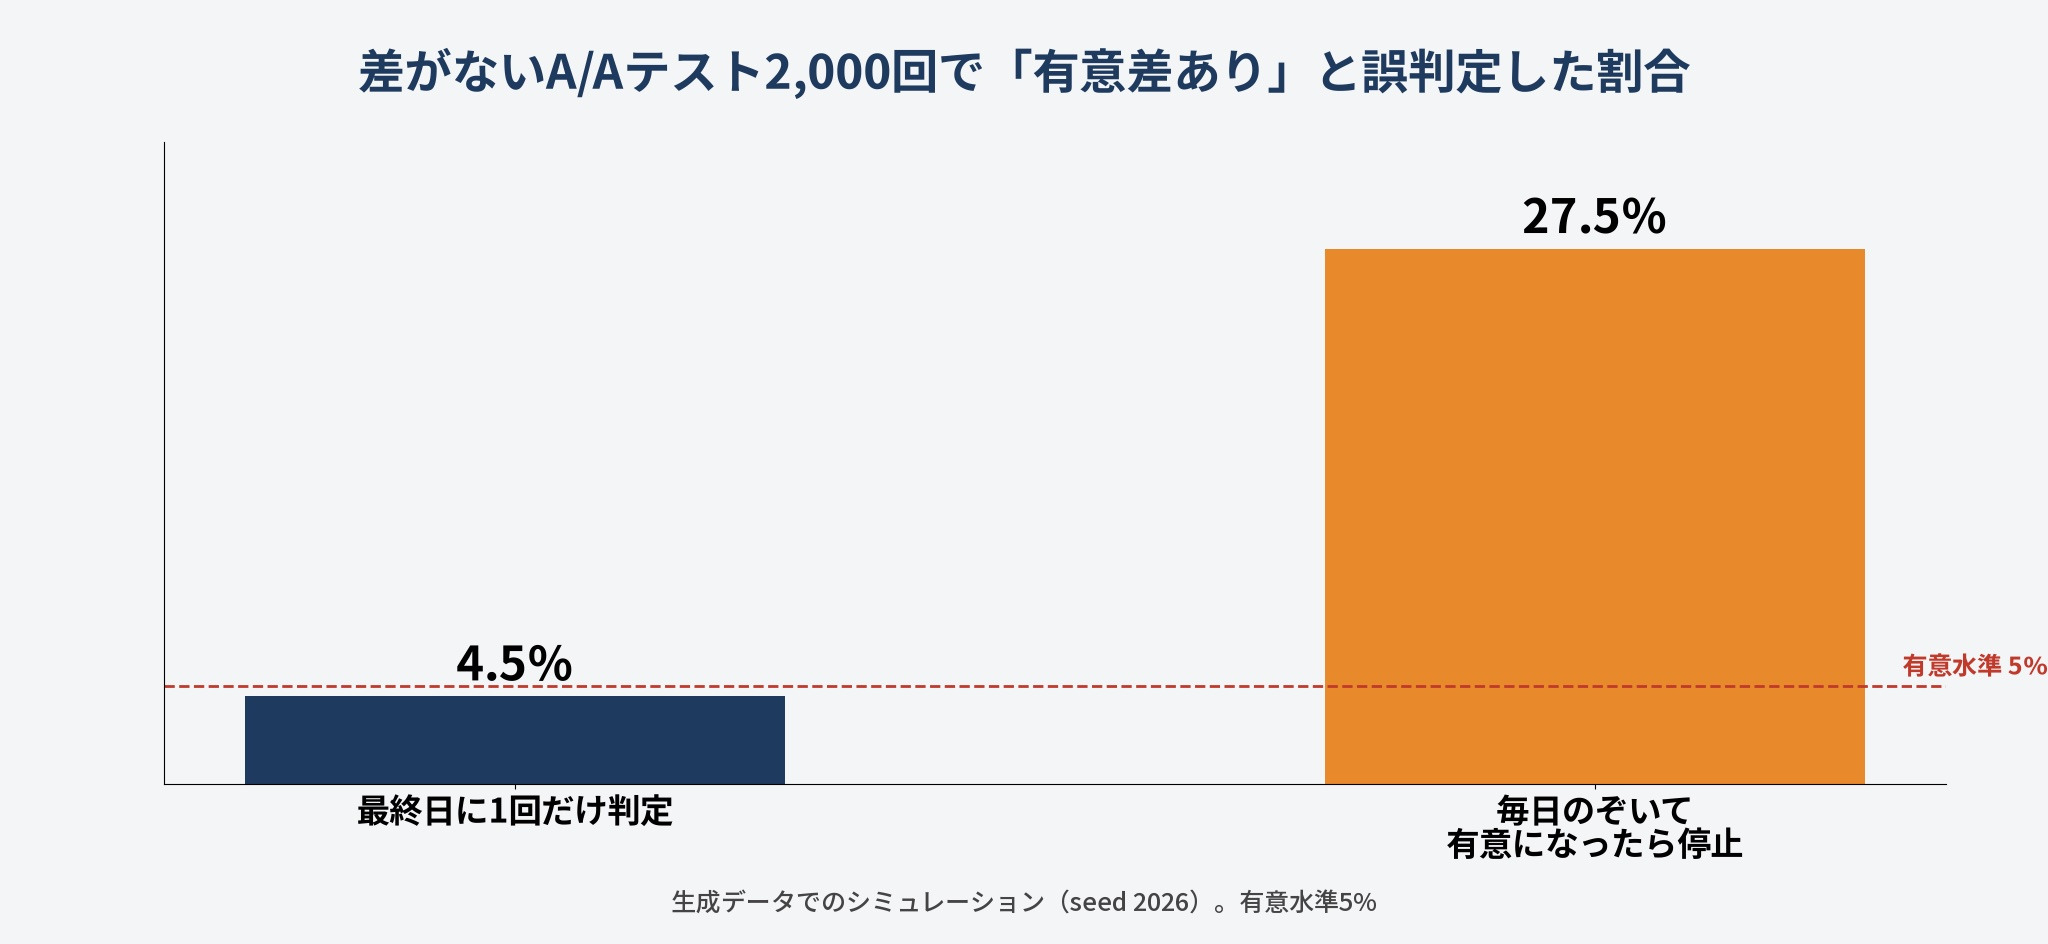
最終日に1回だけ判定すれば、誤判定は有意水準5%に近い4.5%に収まりました。一方、毎日のぞいて有意になった時点で止めると27.5%まで増えています。差のない変更の4回に1回以上を「勝ち」と判定してしまう計算です。途中経過を確認したい場合は、途中で見ることを前提に設計された逐次検定に対応したツールを使います。
比べるパターンや指標を後から増やす
3つ以上のパターンを同時に比べたり、主要指標以外に多くの指標を見て「どれかで有意差が出ればよい」としたりすると、偶然の有意差が出る確率が上がります。これを多重比較(検定の多重性)の問題といいます。実際にこの問題に直面した企業の事例は、後半の事例の章で紹介します。
対策は、主要指標を1つに絞り、それ以外の指標は参考値として扱うことです。3パターン以上を比べる場合は、有意水準を比較の数に応じて厳しくする補正(ボンフェローニ補正など)を事前に決めておきます。
振り分けの比率がずれている
50:50で振り分けたはずなのに、実際の人数が大きくずれている状態をSRM(サンプル比率の不一致)と呼びます。リダイレクトによる離脱、ボットの除外の仕方、計測タグの読み込み失敗などが原因です。
Microsoftの研究者らは、同社で1年間に行われた実験の約6%でSRMが見つかったと報告しています(出典:Fabijan et al., Diagnosing Sample Ratio Mismatch in Online Controlled Experiments, KDD 2019)。SRMがあると、AとBで異なる性質の人が集まっている可能性があるため、CVRの差を効果とみなせません。前の章のコードのように、判定の前にカイ二乗検定で比率のずれを確認します。
都合のよいセグメントだけを拾う
全体では有意差が出なかったのに、「スマートフォンの新規訪問者に限れば有意」のように、後からセグメントを切って勝ちを探すのも誤判定のもとです。切り方を増やすほど、偶然の有意差が見つかりやすくなります。
また、全体とセグメント別で傾向が逆転するシンプソンのパラドックスが起きることもあります。この現象の具体例は、以下の記事で解説しています。
参照記事:AIでデータ分析はどこまでできる?限界と人間に必要な役割を解説
セグメント別の分析は、事前に計画書に書いたものだけを検証の対象にし、それ以外は次のテストの仮説として扱います。
ABテストのツールの選び方
ここまでの落とし穴の多くは、ツールの機能で防げます。ここでは2026年9月時点の公式情報をもとに、ツールの種類と選ぶときの確認項目を整理します。
なお、無料で使えたGoogle オプティマイズは、2023年9月30日をもって提供が終了しています(出典:Google アナリティクス ヘルプ)。古い記事で紹介されていても、現在は使えません。
ツールの3つの種類(2026年9月時点)
ABテストのツールは、大きく次の3種類に分けられます。
| 種類 | 代表例 | 料金の公開状況(2026年9月時点) | 向いている場面 |
|---|---|---|---|
| 広告媒体に組み込まれたテスト機能 | Google 広告のカスタムテスト | 元のキャンペーンの予算とトラフィックを分けて実施 | 広告の入札戦略やクリエイティブの比較 |
| Webサイト向けの実験ツール(SaaS) | Optimizely、Wingify(旧VWO・AB Tasty) | Optimizelyは個別見積もり。Wingifyは3プラン構成で価格は非掲載、無料トライアルあり | ノーコードでLPやサイトを出し分けたい |
| オープンソースの実験基盤 | GrowthBook | 自社サーバーで動かすオープンソース版は無料。クラウド版はStarter 0ドル(3ユーザーまで)、Pro 1シートあたり月40ドル | 自社のデータ基盤で結果を集計したい |
この表から分かるのは、Webサイト向けの有料ツールの多くが価格を公開しておらず、見積もりが前提になることです。まずは広告媒体の機能やオープンソース版で小さく始め、テストの本数が増えてから有料ツールを検討する進め方もあります。
表のWingifyは、VWOとAB Tastyが2026年1月に統合を発表し、2026年9月16日から1つのブランドにまとめたものです。表の情報は、Google 広告 ヘルプ、Optimizelyの料金ページ、Wingifyの発表と料金ページ、GrowthBookの料金ページで確認しています。
ツールを選ぶときの確認項目
機能の多さよりも、前の章の落とし穴を防げるかどうかで選びます。
- 振り分け比率のずれ(SRM)を自動で検知するか:Wingifyの料金ページでは、Proプラン以上の機能としてSRM検知が挙げられています
- 途中で結果を見ても誤判定が増えない検定に対応しているか:逐次検定やベイズ統計による判定など、途中経過の確認を前提にした方法があるか
- 生データを自社で再集計できるか:ツールの画面の数字だけでなく、振り分けとコンバージョンのログをデータ基盤に取り込み、自社で検算できるか
- 複数のテストが同じユーザーに重ならないよう管理できるか:同時に走るテストが互いに影響しないか
ABテストの事例
ツールが決まったところで、実際にどのような結果と教訓があったかを、企業や研究者が公表した事例で確認します。
| 企業・組織 | 課題 | 対象 | 実施したこと | 成果・学び |
|---|---|---|---|---|
| Microsoft(Bing) | 優先度が低いとされた改善案の価値が分からない | 検索結果の広告見出し | 見出しの表示方法を変えるABテスト | 収益が12%増加。米国だけで年1億ドル超 |
| オバマ陣営(2008年大統領選) | 登録ページで、どの画像とボタンがよいか分からない | 登録ページの画像6種とボタン4種 | 24通りの組み合わせを比べる多変量テスト | 登録率が8.26%から11.6%に向上 |
| LINEヤフー(Yahoo!ショッピング) | 差がないはずのテストで有意差が出た | 購入率(CVR) | 多重性の影響をシミュレーションで定量化 | 3群比較の偽陽性率は約23.3%。仕組みの問題ではないと確認 |
表から読み取れるのは、大きな成果を出した事例ほど、結果をうのみにせず検証を重ねているという点です。以下で1件ずつ説明します。
Bing:広告見出しの変更で収益12%増
2012年、MicrosoftのBingで、検索結果に表示する広告の見出しを変えるという案が社員から出されます。数百ある案の1つとして優先度は低く、6か月以上も手つかずのままでした。その後、実装が簡単だと考えたエンジニアがABテストを始めると、数時間で「収益が高すぎる」という異常検知の警告が出たといいます。
通常この警告はバグを意味しますが、分析の結果、収益は12%増え、米国だけで年1億ドルを超える規模になったと報告されています。ユーザー体験の主要指標を損なわずに得られた、Bing史上最も収益を生んだアイデアだったとされています(出典:Kohavi & Thomke, The Surprising Power of Online Experiments, Harvard Business Review, 2017)。
この事例は、社内の経験者でも施策の価値を事前に見積もるのは難しく、小さな変更でもテストで確かめる価値があることを示しています。
オバマ陣営:登録ページの組み合わせを24通り比較
2008年の米大統領選で、オバマ陣営はメールアドレスの登録ページを改善するため、画像と動画6種類とボタン4種類の組み合わせ24通りを比べる多変量テストを行いました。テスト期間中の訪問者は310,382人で、1つの組み合わせを約13,000人が見た計算です。
結果、家族の写真と「Learn More」ボタンの組み合わせが最も成績がよく、登録率は元のページの8.26%から11.6%へ、相対で40.6%向上しました。テスト前にスタッフが最も支持していたのは動画でしたが、結果は動画を使わないパターンが勝ちました(出典:Optimizely「Obama’s $60 million dollar experiment」)。
関係者の好みと、ユーザーの実際の行動は一致しないことがあります。24通りもの比較ができたのは、1パターンあたり1万人を超える訪問者がいたためです。
Yahoo!ショッピング:差がないはずの3群で有意差が出た理由
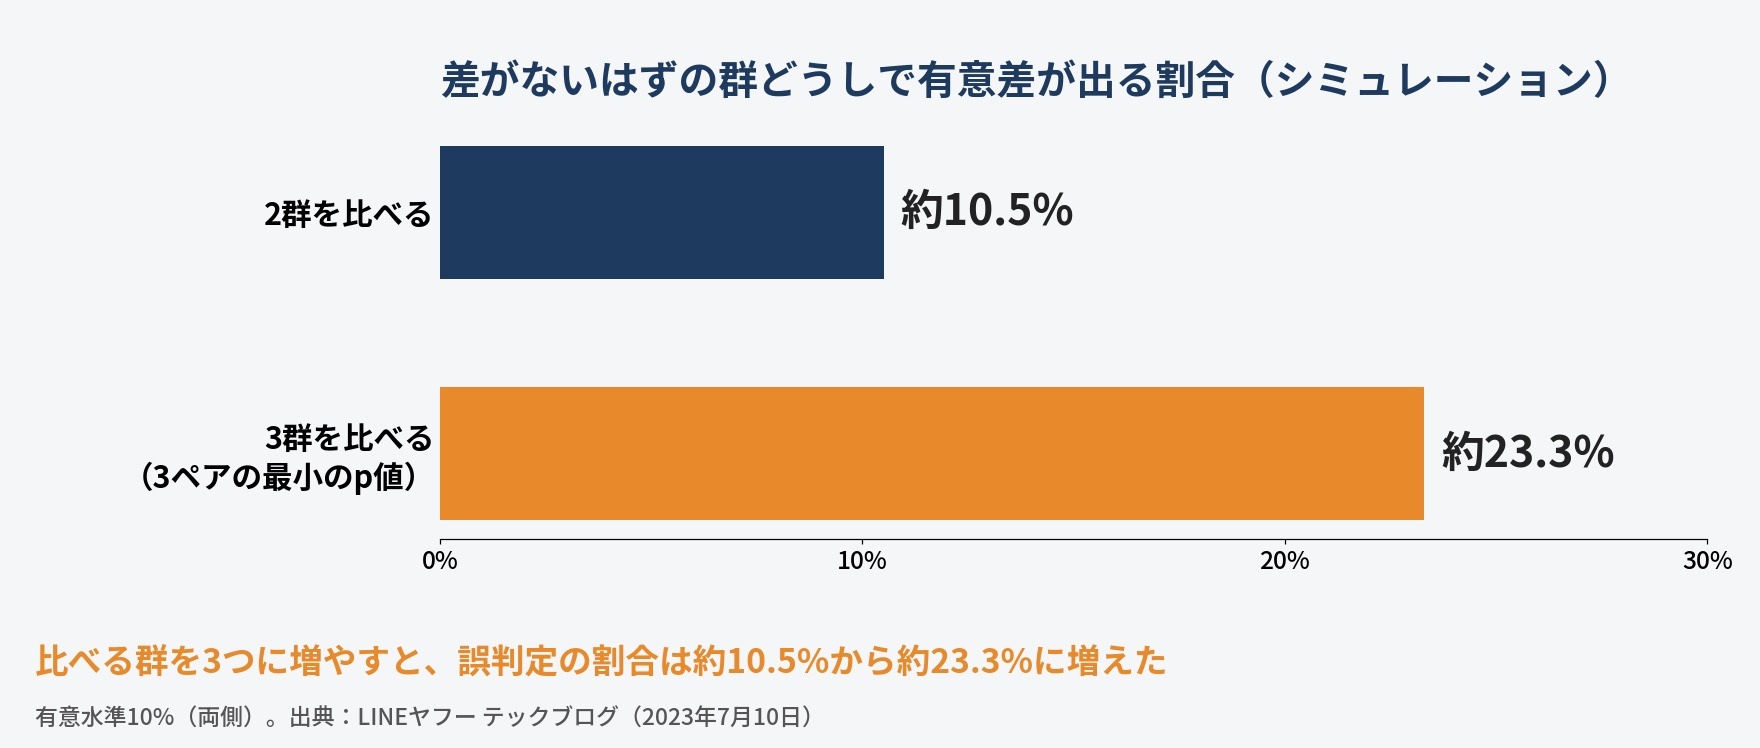
LINEヤフー(当時ヤフー)のテックブログでは、Yahoo!ショッピングで行ったABテストの検証事例が公開されています。テストの仕組みに問題がないかを確かめるため、ランダムに分けた3群にまったく同じシステムを割り当てたところ、購入率に有意差(両側、有意水準10%)が出ました。
調べてもシステムの不具合は見つからず、原因の候補になったのが多重比較です。3群を2つずつ比べる3ペアの中で最も小さいp値を見ていたため、シミュレーションで確かめると、2群なら約10.5%だった誤判定の割合が、3群では約23.3%に増えていました。その後、本番で同じテストを3回繰り返してもいずれも有意差は出ず、仕組み自体に偏りはないと判断されています(出典:LINEヤフー テックブログ「A/Bテストで想定外の結果が出たら?検定多重性の影響を定量的に分析する」2023年7月10日)。
予想外の有意差が出たときは、まず計測と比較の方法を疑い、再テストで確かめるという進め方の手本になる事例です。
まとめ
- ABテストとは、ユーザーをランダムに振り分け、同じ期間にパターンを比べる検証方法。ランダム化によって、外部の影響をAとBに均等に分けられる
- やり方は、目的と指標→仮説→必要な人数と期間→計測の確認→期間中は判定しない→判定と記録、の6ステップ
- 必要な人数は、現状のCVRと検出したい差で決まる。CVR3.0%で相対+20%なら1パターン13,911人、相対+10%なら53,208人が必要
- 有意差はp値と信頼区間の両方で判定する。有意差なしは「差がない」ことの証明ではない
- 途中で何度も結果を見て止めると、差のないテストでも誤判定が4.5%から27.5%へ増えた
- ツールはGoogle オプティマイズの終了後、広告媒体の機能・SaaS・オープンソースの3種類から、SRM検知や再集計のしやすさで選ぶ
ABテストの設計・分析の相談は「リベルクラフト」
ここまで、ABテストの仕組みからやり方、必要な人数と期間の計算、有意差の判定、結果を誤る落とし穴、ツールの選び方、公表された事例までを解説してきました。
ABテストは、ツールを導入して一定期間回すだけで信頼できる結果が得られるものではありません。何を決めるためのテストかという指標の設計、必要な人数と期間の計算、判定のルール、計測の正しさの確認がそろって、初めて意思決定に使える結果になります。
- ABテストの結果を、社内で根拠を持って説明できるようにしたい
- 必要な人数や期間の計算、判定のルールづくりを専門家と一緒に進めたい
- ツールの数字だけでなく、自社のデータ基盤で結果を検算できる仕組みを作りたい
という方は、リベルクラフトへお気軽にご相談ください。
リベルクラフトでは、データ分析とAI活用の導入支援を通じて、指標の設計からテストの設計、結果の分析、社内で継続して回すための仕組みづくりまでを一貫して伴走支援しています。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。