仮説検定とは。p値の正しい読み方から検定の選び方までPythonでわかりやすく解説
「p値が0.05を下回ったら有意差あり」と覚えたものの、そのp値が何の確率なのかを聞かれると答えに詰まる、という方も多いでしょう。統計の教科書を開くと帰無仮説や棄却域といった言葉が続き、なぜその計算で差の有無を判断できるのかを理解する前に、手順だけが頭に残りがちです。
しかし、仮説検定は手順を暗記するより、何を仮定して何を計算しているのかを押さえたほうが、実務で読み違えにくくなります。p値だけを見て「効果があった」と判断する誤りは、米国統計協会が2016年に声明を出して注意を促したほどよく起きています。
そこで本記事では、
- 仮説検定とは何か。帰無仮説とp値の考え方を、コイン投げの例でわかりやすく
- p値の正しい解釈と、第1種・第2種の過誤、検出力の関係
- 統計的仮説検定の手順と、t検定・カイ二乗検定などの選び方
- Pythonでの実行方法と、多重比較・サンプルサイズ・効果量といった実務の落とし穴
についてわかりやすく解説します。データ分析の仕事を目指して統計を学び始めた方は、ぜひ最後までご覧ください。
掲載しているコードは2026年9月23日に実際に実行し、出力を確認したものです。実行環境は Apple M1 Pro、Python 3.13.13・NumPy 2.5.3・SciPy 1.18.1 です。データはすべて乱数で生成したもので、乱数シードはコード中に固定しています。
「統計を独学しているが、実務で使える水準まで身につくか不安」という方は、リベルクラフトが運営するCraft Collegeへご相談ください。
⇨Craft Collegeへの無料相談はこちら
仮説検定とは。データの差が偶然かどうかを確率で判断する方法
仮説検定は、手元のデータに見えた差や偏りを「偶然でも起こる程度か」「偶然では説明しにくいか」に振り分けるための方法です。まず定義を確認し、次にコイン投げの例で、仮説検定が何を仮定して何を計算しているのかを見ます。
統計的仮説検定の定義
仮説検定(統計的仮説検定)とは、母集団についての仮説が成り立つかどうかを、そこから取り出した標本のデータを使って確率的に判断する方法です。
母集団とは、本来調べたい対象の全体を指します。サイトに来る全訪問者や、工場で作られる全製品がこれにあたります。全体を調べるのは難しいため、一部を取り出した標本から全体について判断します。総務省統計局の解説でも、検定は母集団に関する仮説が統計学的に成り立つかを標本のデータから判断するもので、仮説を設定する、有意水準を決める、検証する、結論を導く、の4段階で進めると説明されています(総務省統計局 なるほど統計学園「統計的推定と統計的仮説検定」)。
仮説検定の考え方をコイン投げでわかりやすく
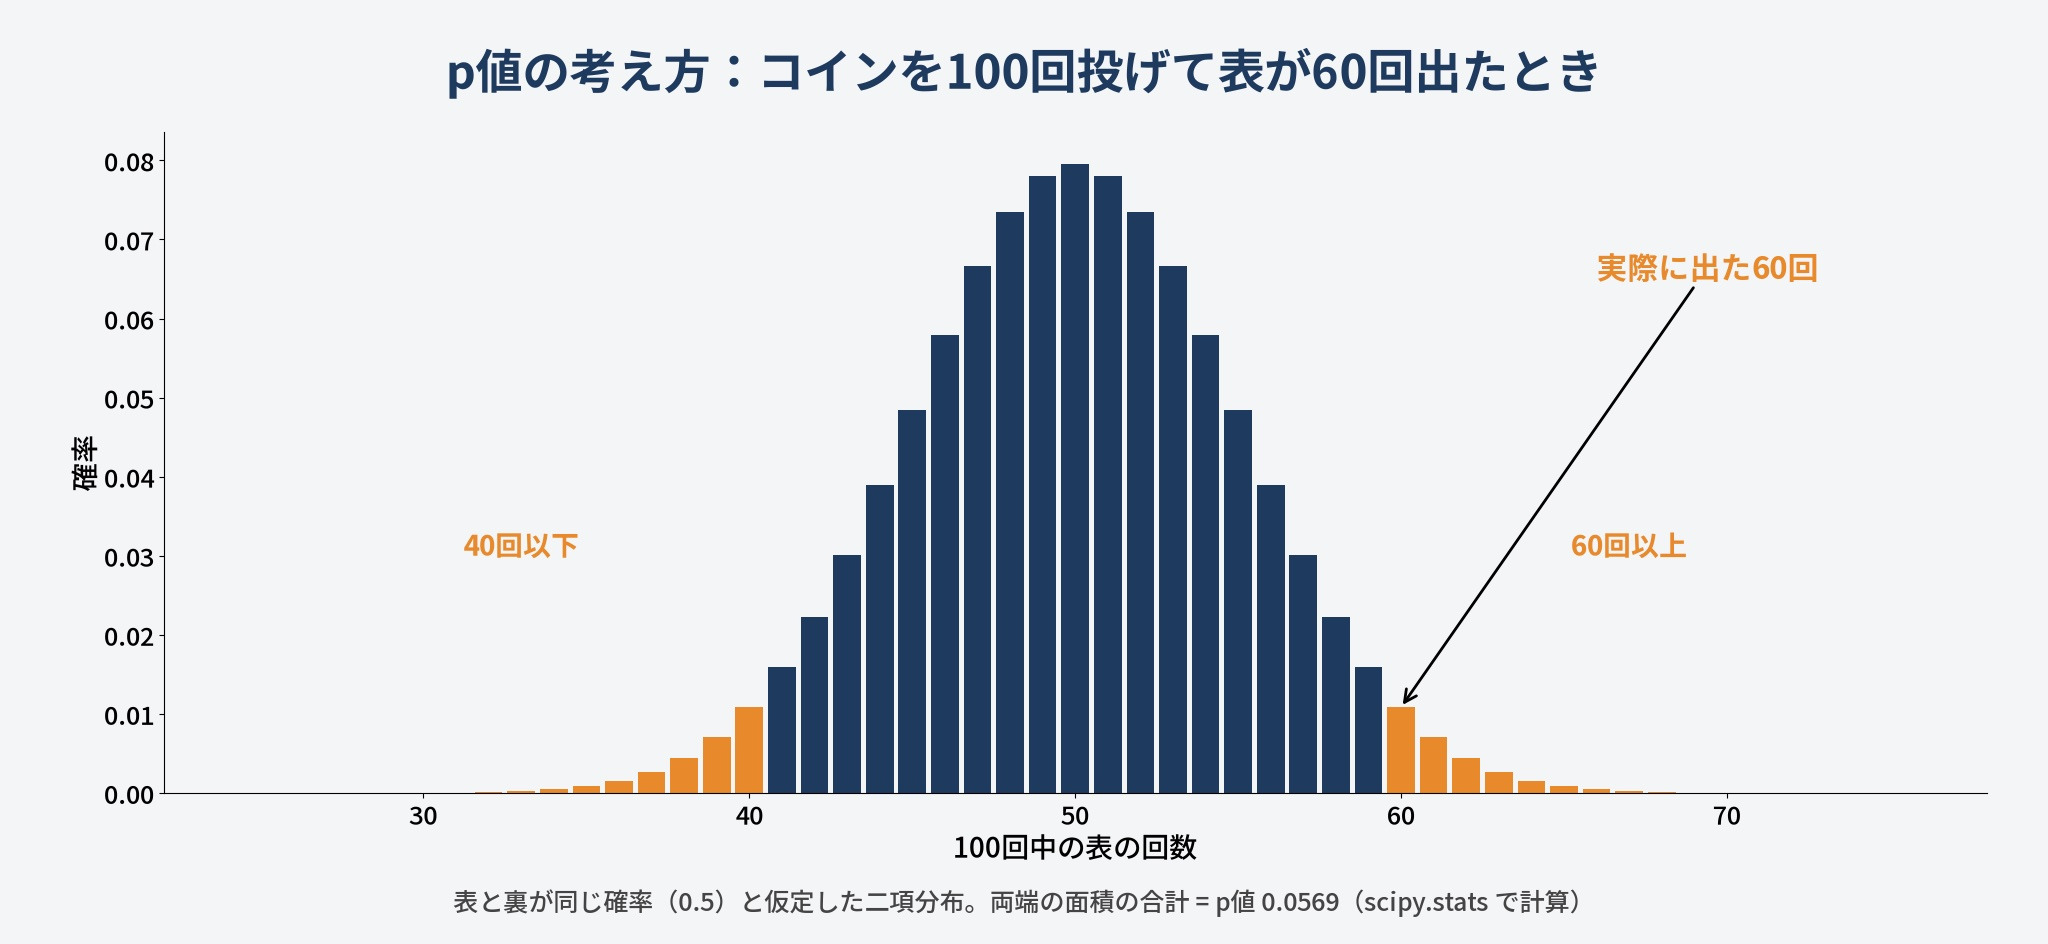
例えば、友人から渡されたコインを100回投げたら、表が60回出たとします。このコインは表が出やすいように細工されているのでしょうか?
仮説検定では、いきなり「細工されている」ことを示そうとはしません。まず「表と裏が出る確率は同じ」と仮定します。そのうえで、この仮定が正しいとしたら、表が60回以上、または40回以下という偏りがどのくらいの確率で起こるかを計算します。この確率がp値です。
import numpy as np
from scipy import stats

# 100回投げて表が60回。表と裏が同じ確率(p=0.5)と仮定したときのp値
res = stats.binomtest(60, n=100, p=0.5, alternative="two-sided")
print(f"p値: {res.pvalue:.4f}")

# 1000回投げて表が600回の場合
res_b = stats.binomtest(600, n=1000, p=0.5, alternative="two-sided")
print(f"1000回中600回のp値: {res_b.pvalue:.2e}")
p値: 0.0569
1000回中600回のp値: 2.73e-10100回中60回のp値は0.0569でした。普通のコインでも、この程度の偏りは約5.7%の確率で起こります。基準を5%と決めていたなら、「細工されている」とまでは言えません。
同じ6割でも、1000回中600回ならp値は2.73e-10、つまり0.000000000273です。普通のコインでこれが起こるとは考えにくいため、「表と裏が同じ確率」という仮定のほうを疑います。割合が同じでも、データの量によって結論が変わる点は、後半のサンプルサイズの話につながります。
以降のコードは、このブロックを先に実行した状態で続けて動かします。
仮説検定の基本用語。帰無仮説・対立仮説・有意水準・p値
コイン投げで仮説検定の流れをつかんだところで、それを支える4つの用語を正確にしておきます。用語の関係を押さえると、p値の読み違いが減ります。
帰無仮説と対立仮説
帰無仮説とは、「差がない」「効果がない」とする仮説で、記号 H0 で表します。対立仮説とは、帰無仮説を否定したときに受け入れる仮説で、H1 で表します。
コインの例では、帰無仮説が「表の出る確率は0.5」、対立仮説が「表の出る確率は0.5ではない」でした。
主張したいのは対立仮説の側なのに、あえて帰無仮説を立てるのには理由があります。「差がない」と仮定すれば、データがどう散らばるかを計算できるからです。「差がある」だけでは、どれだけ差があるかが決まらず、確率を計算できません。帰無仮説のもとで計算し、起こりにくい結果が出たら帰無仮説のほうを疑う、という背理法に似た構造になっています。
対立仮説には、差の向きを問わない両側検定(0.5ではない)と、向きを決める片側検定(0.5より大きい)があります。どちらにするかは、データを見る前に決めておきます。
有意水準とp値
有意水準とは、帰無仮説を棄却するかどうかを決める基準の確率で、記号 α(アルファ)で表します。 0.05や0.01がよく使われ、データを集める前に決めておきます。
p値とは、帰無仮説が正しいと仮定したときに、実際に観測した結果か、それ以上に極端な結果が得られる確率です。 米国統計協会(ASA)の声明の日本語訳では、「特定の統計モデルのもとで、データの統計的要約(たとえば、2グループ比較での標本平均の差)が観察された値と等しいか、それよりも極端な値をとる確率」と説明されています。
判定のルールは次のとおりです。
- p値が有意水準以下なら、帰無仮説を棄却し、対立仮説を採択する(統計的に有意)
- p値が有意水準より大きければ、帰無仮説を棄却しない
ここで注意したいのは2つ目です。京都大学のデータ分析基礎の講義資料は、帰無仮説が棄却されなかったときは「何も主張できない」と整理しています(關戸啓人「データ分析基礎 仮説検定」)。棄却できなかったことは、帰無仮説が正しいことの証明にはなりません。
p値の正しい解釈と、よくある3つの誤解
p値の誤用が広がったことを受け、米国統計協会は2016年3月7日、p値の適切な使い方と解釈について6つの原則を示す声明を発表しました(ASA プレスリリース)。日本計量生物学会が公式に翻訳した6原則は次のとおりです(統計的有意性とP値に関するASA声明 日本語訳)。
- P値はデータと特定の統計モデルが矛盾する程度をしめす指標のひとつである
- P値は、調べている仮説が正しい確率や、データが偶然のみでえられた確率を測るものではない
- 科学的な結論や、ビジネス、政策における決定は、P値がある値を超えたかどうかにのみ基づくべきではない
- 適正な推測のためには、すべてを報告する透明性が必要である
- P値や統計的有意性は、効果の大きさや結果の重要性を意味しない
- P値は、それだけでは統計モデルや仮説に関するエビデンスの、よい指標とはならない
初めて検定を学ぶ方が陥りやすいのは、このうち原則2・3・5に反する読み方です。
- 誤解1「p値0.03は、帰無仮説が正しい確率が3%という意味」:p値は帰無仮説が正しいと仮定したうえで計算したデータの起こりにくさです。仮説そのものが正しい確率ではありません(原則2)
- 誤解2「0.05を下回れば施策は成功、上回れば失敗」:0.049と0.051で結論を真逆にする読み方は、原則3が戒めています。研究や施策の設計、測定の質、これまでの知見と合わせて判断します
- 誤解3「p値が小さいほど効果が大きい」:p値はデータの量が増えるだけでも小さくなります。効果の大きさは、差そのものや効果量で見ます(原則5)
誤解3は、後半で1群20万件のデータを使って実際に確かめます。
仮説検定の2種類の誤り。第1種の過誤・第2種の過誤と検出力
ここまででp値の正しい読み方を押さえました。次に、検定の判断が外れるパターンを整理します。仮説検定は確率で判断するため、正しく手順を踏んでも一定の割合で誤ります。
検定の結果は4通りある
本当に差があるかどうかと、検定の判断の組み合わせは、次の4通りです。
| 検定の判断 | 本当は差がない(帰無仮説が正しい) | 本当は差がある(帰無仮説が誤り) |
|---|---|---|
| 帰無仮説を棄却した(有意) | 第1種の過誤(確率α) | 正しい判断(確率1−β=検出力) |
| 帰無仮説を棄却しなかった | 正しい判断 | 第2種の過誤(確率β) |
第1種の過誤とは、本当は差がないのに「差がある」と判断してしまう誤りです。 その確率が有意水準αにあたります。第2種の過誤とは、本当は差があるのに見逃してしまう誤りで、その確率をβで表します。 1からβを引いた値を検出力と呼び、本当にある差を正しく見つけられる確率を表します(東京医科歯科大学 徳永伸一「第14章 検定 の内容」、神戸大学 分寺杏介「経営統計 10 統計的仮説検定の考え方」)。
この表から読み取れるのは、αを小さくすれば第1種の過誤は減るものの、そのぶん差を見逃しやすくなるという関係です。2種類の誤りを同時にゼロにはできません。
差がないのに有意になる割合をPythonで確かめる
有意水準を5%にすると、本当に差がなくても約5%は有意になるはずです。同じ分布から30件ずつ取り出した2つのグループを1万回比べて確かめます。
rng = np.random.default_rng(0)
n_sim = 10_000
false_pos = 0
for _ in range(n_sim):
    x = rng.normal(0, 1, 30)
    y = rng.normal(0, 1, 30)
    if stats.ttest_ind(x, y, equal_var=False).pvalue < 0.05:
        false_pos += 1
print(f"本当は差がないのに有意になった割合: {false_pos / n_sim:.3f}")
本当は差がないのに有意になった割合: 0.0481万回のうち4.8%が「有意」と判定されました。有意水準5%とは、差がないときに20回に1回ほどは偶然で有意になる、という約束のもとで判断している、ということです。
検出力はサンプルサイズで変わる
次は、本当に差があるときに、どのくらいの確率で見つけられるかを確かめます。2つのグループの平均の差を標準偏差の0.3倍(効果量0.3)に設定し、1グループの人数を変えて、それぞれ1万回検定します。
rng = np.random.default_rng(1)
for n in [30, 100, 175, 300]:
    hits = 0
    for _ in range(n_sim):
        x = rng.normal(0, 1, n)
        y = rng.normal(0.3, 1, n)
        if stats.ttest_ind(y, x, equal_var=False).pvalue < 0.05:
            hits += 1
    print(f"1群{n:>3}人: 検出力 {hits / n_sim:.3f}")
1群 30人: 検出力 0.203
1群100人: 検出力 0.549
1群175人: 検出力 0.801
1群300人: 検出力 0.952本当に差があるのに、1グループ30人では5回に1回しか有意になりませんでした。残りの約8割は「有意差なし」、つまり第2種の過誤です。175人まで増やすと検出力は0.801になります。神戸大学の講義資料も、検定力は効果の大きさとサンプルサイズで上がり、自分で動かせるのはサンプルサイズのほうだと説明しています。
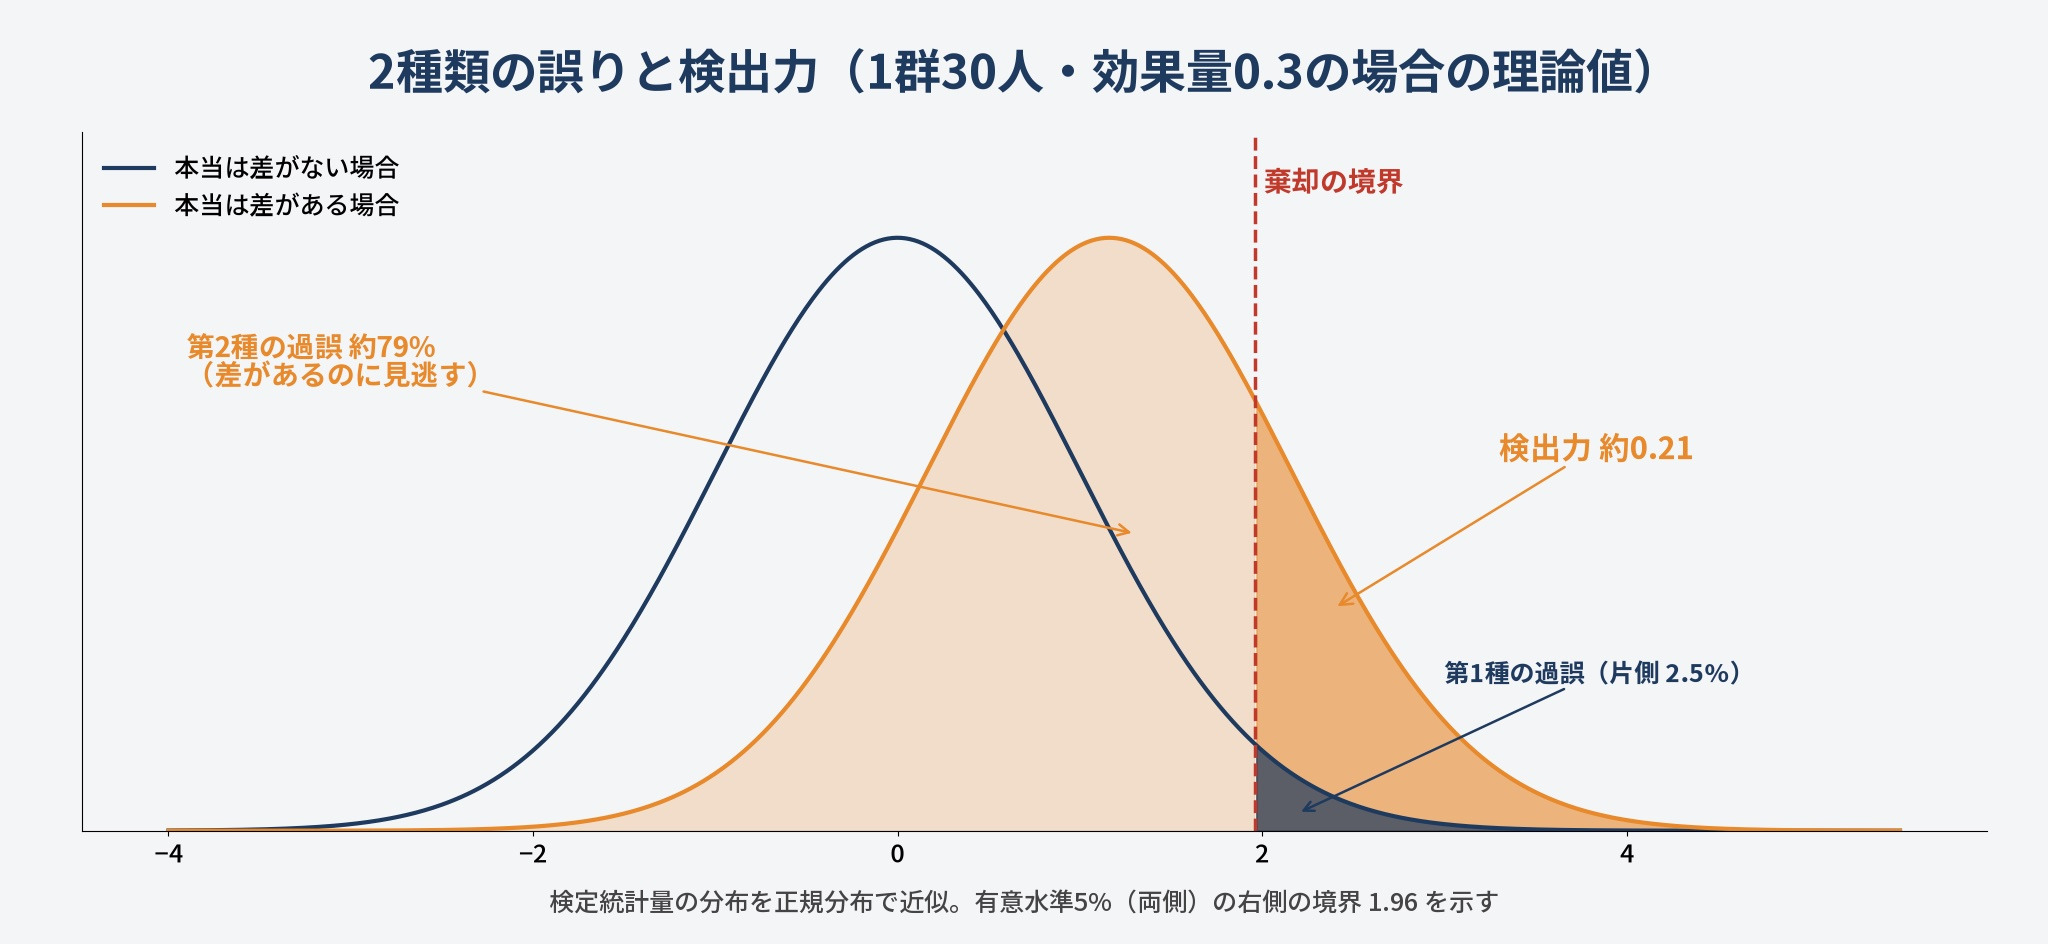
つまり「有意差なし」という結果を見たら、差がなかったと読む前に、そもそもその人数で差を見つけられる設計だったかを確かめる必要があります。
統計的仮説検定の手順5ステップ
2種類の誤りがどう生まれるかが分かったので、誤りを抑える進め方に落とします。統計的仮説検定は、次の5ステップで進めます。ステップ1から4は、データを見る前に決めておきます。
- 問いと仮説を決める:何と何を比べるのかを1文で書き、帰無仮説と対立仮説を立てます。両側検定か片側検定かもここで決めます。例えば「新しい商品ページは従来のページより購入率が違うか」なら、帰無仮説は「購入率は同じ」、対立仮説は「購入率は違う」です
- 有意水準を決める:多くの場合は0.05です。見逃しより誤検出の損害が大きい場面では、0.01のように厳しくします
- サンプルサイズを決める:見つけたい差の大きさと検出力から、必要な件数を決めます。Cohenは、検出力の目安を0.8とすることを提案しています(Cohen, J. (1992). A power primer)。先ほどの結果では、効果量0.3を検出力0.8で見つけるには1グループ175人ほどが必要でした
- 検定の種類を決める:比べたいものとデータの型から選びます(次の章で表にまとめます)
- データを集めて検定し、結果をすべて報告する:p値だけでなく、差の大きさ、信頼区間、効果量、サンプルサイズを並べて報告します。試した分析が複数あるなら、その数も書きます
ステップ1から4を先に決める理由は、結果を見てから基準や分析方法を選ぶと、p値の意味が失われるからです。ASA声明の原則4は、複数の解析を行って有意水準を下回ったものだけを報告すると、報告されたp値は解釈できなくなると指摘しています。
代表的な仮説検定の選び方。t検定・カイ二乗検定などの使い分け
手順のステップ4にあたる検定の選び方を、比べたいものとデータの型で整理します。SciPyの scipy.stats にある関数名も並べました。
| 比べたいこと | データの例 | 検定の種類 | scipy.stats の関数 |
|---|---|---|---|
| 別々の2グループの平均 | 新旧ページの客単価 | t検定(Welchのt検定) | ttest_ind(equal_var=False) |
| 同じ対象の前と後の平均 | 研修の前後のテスト点 | 対応のあるt検定 | ttest_rel |
| 2グループの分布(外れ値が多い、正規分布から遠い) | サイトの滞在時間 | マン・ホイットニーのU検定 | mannwhitneyu |
| 3グループ以上の平均 | 3店舗の客単価 | 一元配置分散分析 | f_oneway |
| 割合やクロス集計の偏り | ページごとの購入した・しなかった | カイ二乗検定 | chi2_contingency |
| 件数が少ない2×2の表の割合 | 期待される件数が小さいセルがある | フィッシャーの正確検定 | fisher_exact |
この表から読み取れるのは、最初に見るべきは「平均を比べるのか、割合を比べるのか」という点です。客単価や点数のような量のデータの平均ならt検定の系統、購入したかどうかのような件数のデータならカイ二乗検定の系統になります。
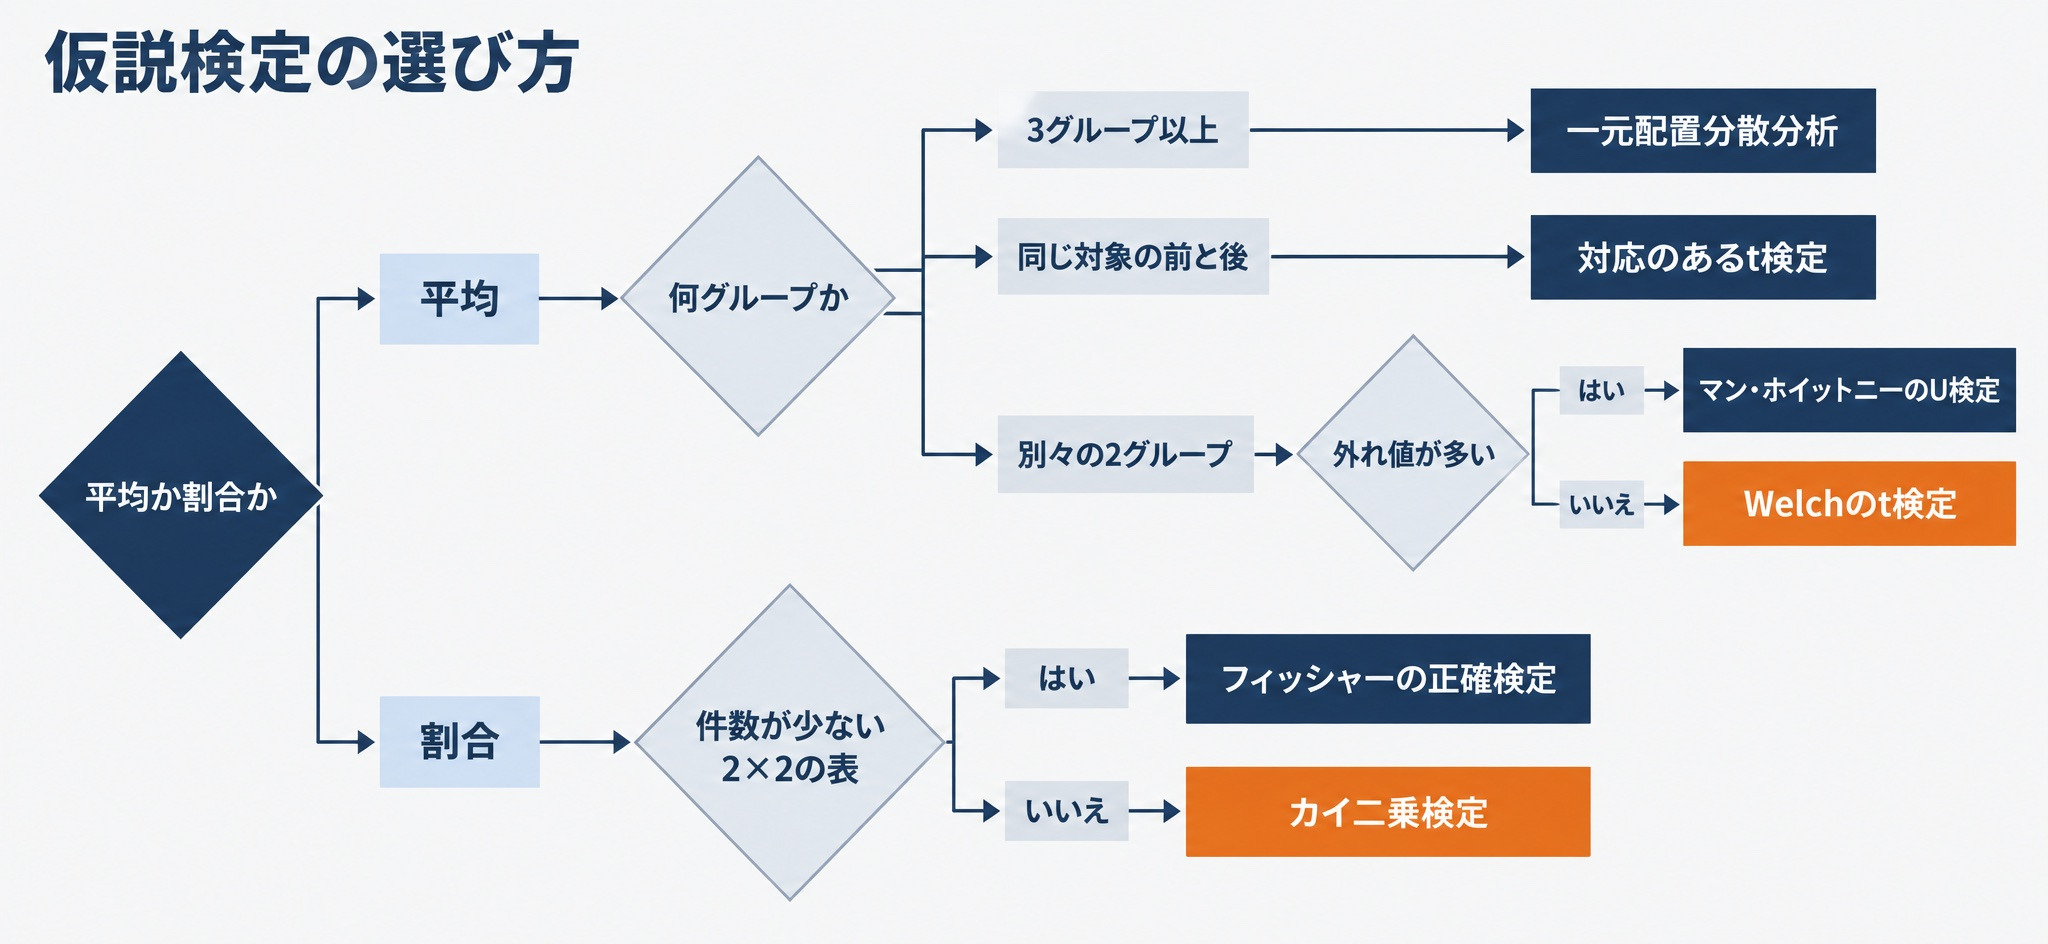
t検定を使うときは、2グループのばらつきが等しいと仮定するかどうかにも注意します。ttest_ind は既定で等しいばらつきを仮定しており、equal_var=False を指定すると、その仮定を置かないWelchのt検定になります(SciPy scipy.stats.ttest_ind)。ばらつきが等しいと言える根拠がなければ、Welchのt検定を選ぶと無難です。
仮説検定以外のデータ分析の手法を目的別に知りたい方は、データ分析の手法を種類と目的別に整理した記事をご覧ください。
Pythonで仮説検定を実行する。scipy.statsでのt検定とカイ二乗検定
検定の選び方が決まったところで、実際に動かします。ここでは、よく使う2つの検定を、結果の読み方と合わせて解説します。
2つのグループの平均を比べる(Welchのt検定)
従来の商品ページと新しい商品ページで、客単価に差があるかを調べる場面を考えます。データは、新しいページの平均が600円高くなるように設定して乱数で生成しました。 つまり、本当は差があるデータです。
rng = np.random.default_rng(218)
a = rng.normal(loc=5000, scale=1200, size=40)   # 従来のページの客単価(円)
b = rng.normal(loc=5600, scale=1500, size=40)   # 新しいページの客単価(円)
print(f"平均 A: {a.mean():.0f}円  B: {b.mean():.0f}円  差: {b.mean()-a.mean():.0f}円")

t = stats.ttest_ind(b, a, equal_var=False)
print(f"t統計量: {t.statistic:.3f}  p値: {t.pvalue:.4f}")

ci = t.confidence_interval(confidence_level=0.95)
print(f"平均の差の95%信頼区間: {ci.low:.0f}円 〜 {ci.high:.0f}円")

sp = np.sqrt(((len(a)-1)*a.var(ddof=1) + (len(b)-1)*b.var(ddof=1)) / (len(a)+len(b)-2))
print(f"効果量 d: {(b.mean()-a.mean())/sp:.2f}")
平均 A: 4869円 B: 5104円 差: 236円
t統計量: 0.810 p値: 0.4208
平均の差の95%信頼区間: -344円 〜 815円
効果量 d: 0.18Welchのt検定で計算しているt統計量は、次の式です。
t =(Bの平均 − Aの平均)÷ √(Aの分散 ÷ Aの件数 + Bの分散 ÷ Bの件数)
分子は平均の差、分母は差のばらつきの目安です。差がばらつきに比べて大きいほど、tの絶対値が大きくなり、p値は小さくなります。
結果は、p値が0.4208で有意になりませんでした。本当は600円の差があるのに、1グループ40件では標本の平均の差が236円にとどまり、差を見つけられなかったのです。前の章で見た第2種の過誤が、そのまま起きています。
ここで「新しいページには効果がない」と結論づけるのは誤りです。95%信頼区間は−344円から815円で、差がない可能性も、800円近く高い可能性も残っています。区間の幅が広いのは、データが足りていないことの表れです。p値だけでなく信頼区間を併記すると、「差がない」のか「分からない」のかを区別できます。
効果量dは、平均の差を2グループをまとめた標準偏差で割った値です。単位に左右されないため、別の調査と差の大きさを比べるときに使えます。
2つのグループの割合を比べる(カイ二乗検定)
次は、購入したかどうかのような件数のデータです。2つのページにそれぞれ2,000人が訪れ、購入した人数が120人と156人だったとします。ABテストで「有意差が出たか」を判定するときに使われているのは、この種類の検定です。
table = np.array([[120, 1880],   # A: 購入した・しなかった
                  [156, 1844]])  # B
chi2, p, dof, expected = stats.chi2_contingency(table)
print(f"購入率 A: {120/2000:.1%}  B: {156/2000:.1%}")
print(f"カイ二乗統計量: {chi2:.3f}  自由度: {dof}  p値: {p:.4f}")
購入率 A: 6.0% B: 7.8%
カイ二乗統計量: 4.767 自由度: 1 p値: 0.0290購入率は6.0%と7.8%で、p値は0.0290でした。有意水準を5%と決めていたなら、帰無仮説「購入率は同じ」を棄却します。
カイ二乗検定は、「購入率が同じだとしたら各セルに何人入るはずか」という期待される人数と、実際の人数のずれの大きさから判断します。chi2_contingency は2×2の表では既定でイェーツの連続性補正をかけます(SciPy scipy.stats.chi2_contingency)。補正の有無でp値が少し変わるため、報告するときはどちらで計算したかを書き添えます。
ここまで仮説検定の進め方を解説しましたが、「自分の仕事のデータでどの検定を選び、結果をどう説明するかに自信がない」という方は、Craft Collegeへご相談ください。
リベルクラフトが運営するCraft Collegeでは、Pythonでのデータ分析と統計の基礎を、現役データサイエンティストと1対1で学べます。ご自身が扱いたいデータを題材に、検定の選び方から結果の説明の仕方までを講師と確認できます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨Craft Collegeの詳細はこちら
仮説検定の実務での落とし穴。多重比較・サンプルサイズ・効果量
検定を実行できるようになったところで、実務で結果を読み違える典型を3つ押さえます。いずれも、p値の計算自体は正しいのに、判断を誤るパターンです。
検定を繰り返すと、どれかは偶然有意になる(多重比較)
1つの施策について、購入率、客単価、滞在時間、再訪率と、指標を20個並べてそれぞれ検定したとします。どの指標にも本当は差がない状態を作り、この20回の検定を2,000セット繰り返しました。
rng = np.random.default_rng(2)
n_trials = 2_000
any_sig = 0
any_sig_bonf = 0
for _ in range(n_trials):
    pvals = np.array([
        stats.ttest_ind(rng.normal(0, 1, 50), rng.normal(0, 1, 50), equal_var=False).pvalue
        for _ in range(20)
    ])
    any_sig += (pvals < 0.05).any()
    any_sig_bonf += (pvals < 0.05 / 20).any()
print(f"20個のうち1つ以上が有意になった割合: {any_sig / n_trials:.3f}")
print(f"理論値 1 - 0.95^20: {1 - 0.95**20:.3f}")
print(f"Bonferroni補正(0.05/20)後: {any_sig_bonf / n_trials:.3f}")
20個のうち1つ以上が有意になった割合: 0.636
理論値 1 - 0.95^20: 0.642
Bonferroni補正(0.05/20)後: 0.050どの指標にも差がないのに、63.6%のセットで少なくとも1つの指標が「有意」になりました。1回あたり5%の誤りでも、20回重ねると、1回以上誤る確率は1−0.95の20乗で約64%に達します。
これを多重比較の問題と呼びます。対策の1つが、有意水準を検定の数で割るBonferroni補正です。20個なら0.05÷20=0.0025を基準にし、実際に誤る割合は5.0%に戻りました。Bonferroni補正は厳しい方法なので、検定の数が多いときは、誤って有意と判断されるものの割合を抑えるBenjamini-Hochberg法も使われます。SciPyでは false_discovery_control で計算できます(SciPy scipy.stats.false_discovery_control)。
補正より先にできることもあります。見る指標を事前に1つか2つに絞り、残りは参考として扱うことです。
サンプルサイズは、データを集める前に決める
検出力の章で見たとおり、人数が足りないと本当の差を見逃します。反対に、データを集めながら毎日検定し、有意になった日に止める進め方も危険です。検定の回数が増えるため、多重比較と同じ理由で、差がないのに有意になる割合が5%を超えます。
進め方は次の順番にします。
- 見つけたい最小の差を決める(例:購入率が1ポイント以上変わるなら施策を採用する)
- その差を検出力0.8で見つけるのに必要な人数を計算する
- その人数が集まるまで結果を見て判断しない
- 集まった時点で1回だけ検定する
途中経過を見たい事情があるときは、途中で見る回数を前提にした方法を最初から選びます。手順を決めずに途中で止めるのは避けてください。
大きなデータでは小さな差も有意になる。効果量を併記する
最後は、ASA声明の原則5「P値や統計的有意性は、効果の大きさや結果の重要性を意味しない」を実際に確かめます。平均客単価の差を24円(効果量0.02)に設定し、1グループ20万件のデータで検定しました。
rng = np.random.default_rng(3)
x = rng.normal(5000, 1200, 200_000)
y = rng.normal(5024, 1200, 200_000)   # 真の差は24円(効果量0.02)
t = stats.ttest_ind(y, x, equal_var=False)
sp = np.sqrt((x.var(ddof=1) + y.var(ddof=1)) / 2)
print(f"差: {y.mean()-x.mean():.1f}円  p値: {t.pvalue:.2e}  効果量 d: {(y.mean()-x.mean())/sp:.3f}")
差: 26.2円 p値: 4.87e-12 効果量 d: 0.022p値は4.87e-12と非常に小さく、文句なしに「有意」です。しかし差は客単価5,000円に対して26円、効果量は0.022です。Cohenは効果量dの目安として、0.2を小、0.5を中、0.8を大としています(Cohen, 1992)。0.022は「小」の目安の10分の1ほどです。
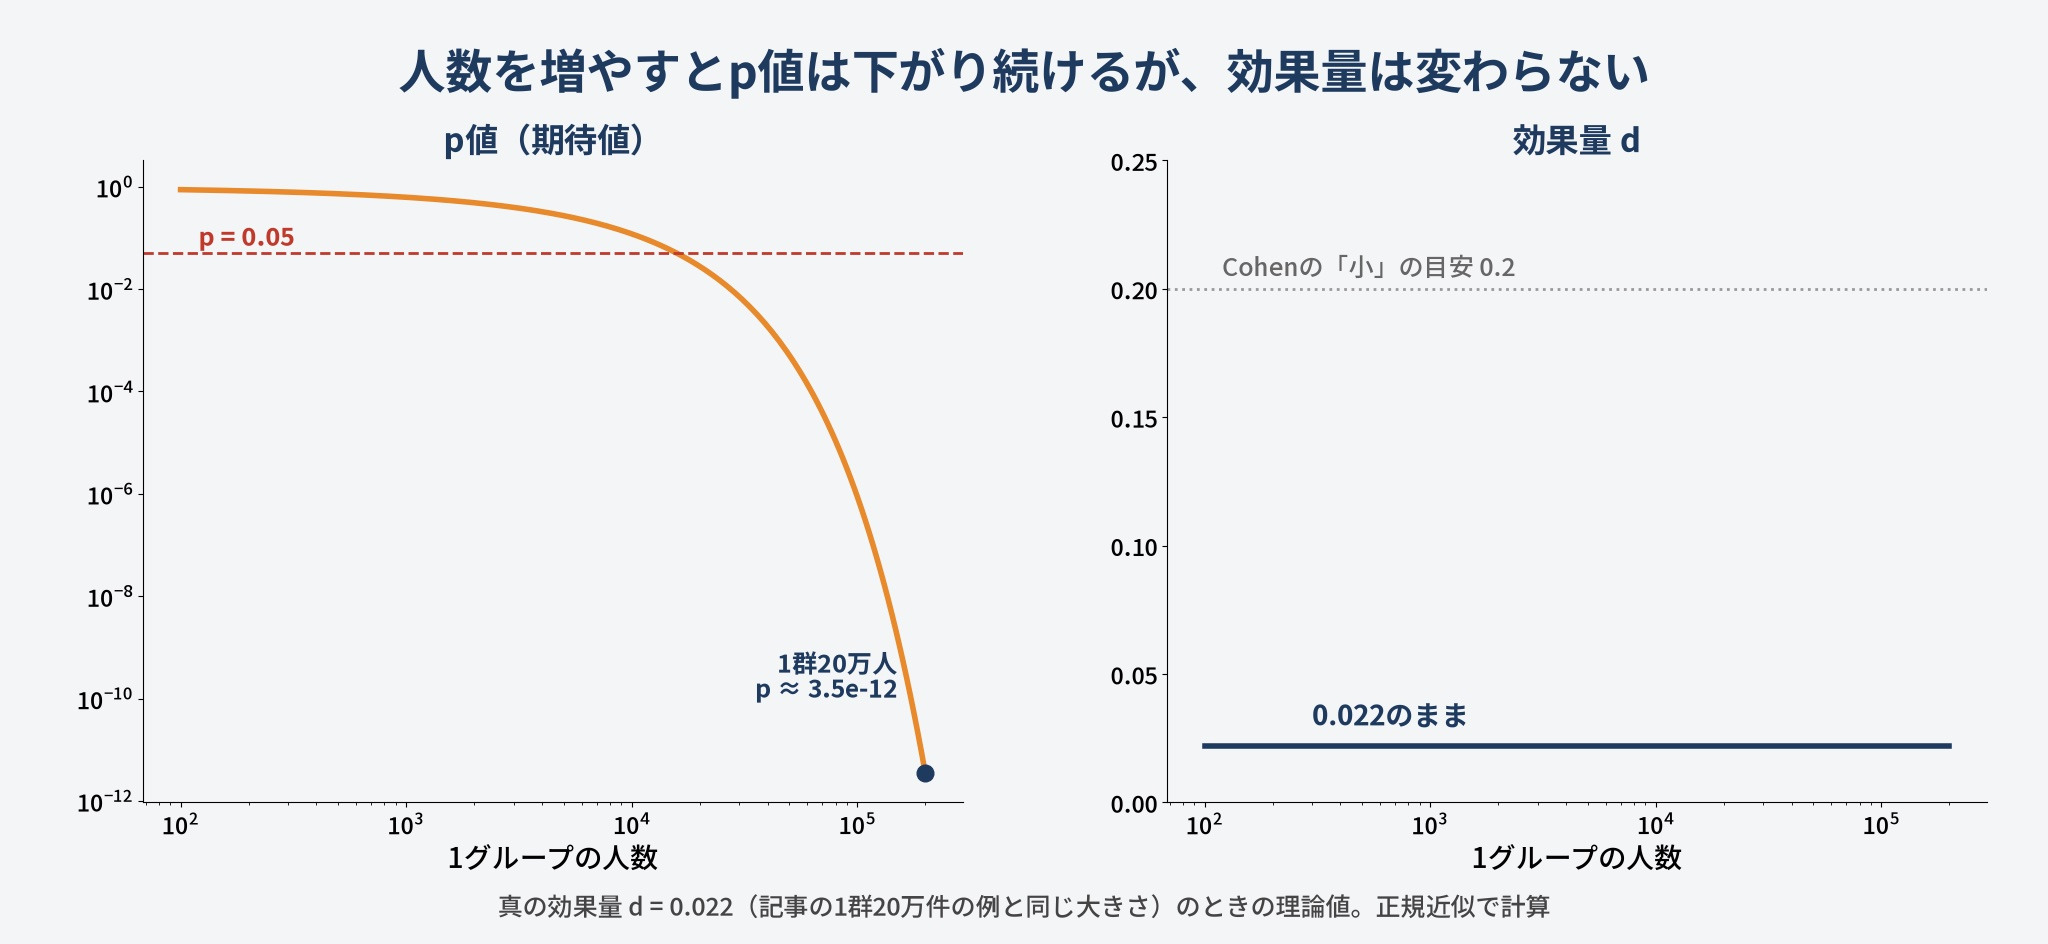
アクセスログや購買履歴のように件数が多いデータでは、ほとんどの差が有意になります。そのため、有意かどうかより「その差は施策の費用に見合うか」を問うほうが判断に役立ちます。結果を報告するときは、次の4つをそろえます。
- 差の大きさ(例:客単価の差26円、購入率の差1.8ポイント)
- 信頼区間(差がどの範囲にありそうか)
- 効果量
- p値とサンプルサイズ
生成AIに検定を任せればp値は数秒で出ますが、その差に意味があるかを判断するのは人の役割です。AIにデータ分析を任せたときの限界と、人が担う部分についてはAIでデータ分析はどこまでできるかを解説した記事で詳しく扱っています。統計を含め、データ分析の仕事に必要な学習の全体像はデータ分析の勉強ロードマップにまとめています。
まとめ
- 仮説検定とは、母集団についての仮説を、標本のデータで確率的に判断する方法。「差がない」という帰無仮説を置き、そのもとでの起こりにくさをp値で測る
- p値は仮説が正しい確率ではなく、効果の大きさも表さない。米国統計協会の2016年の声明は、p値が基準を超えたかどうかだけで判断しないよう求めている
- 有意水準5%では、差がなくても約5%は有意になる(第1種の過誤)。本当の差を見逃す誤り(第2種の過誤)は、サンプルサイズが小さいほど起きやすい
- 統計的仮説検定の手順では、仮説・有意水準・サンプルサイズ・検定の種類をデータを見る前に決める
- 平均を比べるならt検定、割合やクロス集計ならカイ二乗検定が基本。PythonではSciPyの
scipy.statsで実行できる - 実務では、多重比較で偶然の有意が増えること、大きなデータでは小さな差も有意になることに注意し、効果量と信頼区間を併記する
仮説検定を実務で使えるようになるなら「Craft College」へ
「仮説検定の考え方とPythonでの書き方は分かったが、自分の仕事のデータでどう分析を組み立て、結果をどう説明すればよいのかまでは分からない」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座を提供しています。Pythonでのデータ分析・機械学習の基礎から、生成AI・LLMを活用した開発までを、現役データサイエンティストと1対1の個別指導で学べる講座です。以下のようなニーズをお持ちの方に向いています。
- 統計の本を読んだものの、検定を実際のデータ分析でどう使うかが分からない方
- p値や有意差を、上司や顧客に根拠を添えて説明できるようになりたい方
- データ分析の仕事を目指して、統計とPythonを順序立てて学びたい方
講座は9カ月で、AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、6つのSTEPで段階的に学びます。
経済産業省が定める「第四次産業革命スキル習得講座(Reスキル講座)」の対象講座であり、厚生労働省の専門実践教育訓練給付制度の対象にもなっているため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。給付の対象になるかどうかは雇用保険の加入状況など個々の条件によって異なり、支給の可否は最終的にハローワーク等が判断します。
⇨Craft College データサイエンティスト養成講座の詳細・無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。