画像認識AIとは。仕組みと種類、活用事例、無料で試す方法を実行結果で解説
目視の検査や棚の確認をAIに任せられないかと考え、画像認識AIを調べ始めた方も多いのではないでしょうか?
調べると、製品の一覧と「高精度」という言葉が並んでいます。しかし、自社の製品や現場の画像で本当に使えるのか、分類や物体検出のどれを選べばよいのかは、製品ページを読んでも判断できません。画像認識AIの精度は、何を学習させたかと、どんな条件で撮影したかによって大きく変わるからです。
そこで本記事では、
- 画像認識AIとは何か。分類・物体検出・セグメンテーション・OCRの違い
- CNN・Vision Transformer・VLMという3つの仕組み
- 学習済みモデル5つを手元のパソコンで動かした結果と、そこから分かる限界
- 公表された活用事例と、導入の5ステップ
- 画像認識AIを無料で試す方法と、導入時の注意点
を解説します。検査や点検、店舗運営の自動化を任されたDX推進・事業部門のご担当者の方は、ぜひ最後までご覧ください。
自社の画像で画像認識AIが使えるかを早めに見極めたい、という方はリベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
画像認識AIとは。分類・物体検出・セグメンテーションの違い
画像認識AIという言葉は、出力の形が違う複数のタスクをまとめて指しています。まず定義を押さえ、次にタスクごとの違いを整理します。
画像認識AIとは、画像に何がどこに写っているかをAIで判定する技術
画像認識AIとは、写真や映像に何が写っているか、それがどこにあり、どんな状態かを、画像から学習したAIで判定する技術です。人が目で見て判断していた作業を、カメラとAIで置き換えたり補ったりする用途で使われます。総務省の自治体向け調査でも、AIの機能の分類に「画像・動画認識」があり、道路の損傷検出や、歩行者と自転車の通行量の自動計測が例に挙がっています(総務省 自治体におけるAI・RPA活用促進 R7年度版 概要版)。AIでできること全体の中での位置づけは、AIで何ができるかで整理しています。
AIの画像認識は4つのタスクに分かれる
AIの画像認識は、出力の形によって大きく4つのタスクに分かれます。
| タスク | AIが返すもの | 業務の例 | 学習データに付ける正解 |
|---|---|---|---|
| 画像分類 | 画像全体に1つのラベル(例:良品か不良品か) | 部品の良否判定、商品画像の仕分け | 画像ごとのラベル。付ける手間は最も小さい |
| 物体検出 | 物の名前と、位置を示す枠 | 棚の欠品検知、人や車の数え上げ | 物ごとの枠と名前 |
| セグメンテーション | 画素ごとのラベル(どの点が何か) | ひび割れの抽出、傷の面積の計測 | 物の輪郭を塗った正解。手間は最も大きい |
| 文字認識(OCR) | 画像に書かれた文字列 | 帳票や伝票のデータ化 | 画像と、そこに書かれた文字列 |
表の右端の列は、導入の費用に効いてきます。画像1枚にラベルを付ける分類に比べ、傷の輪郭を塗るセグメンテーションは正解づくりに何倍もの時間がかかります。「位置まで必要か」「面積まで必要か」を先に決めると、選ぶタスクと集めるデータが決まります。
文字認識(OCR)も画像認識の一分野です。ただし、帳票を項目ごとのデータにする工程や精度の数え方には固有の論点が多いため、本記事では位置づけの紹介にとどめます。
このほか、顔認識、良品だけを学習して「いつもと違うもの」を見つける異常検知、画像を文章で説明するキャプション生成も、上の4つの延長にある応用です。
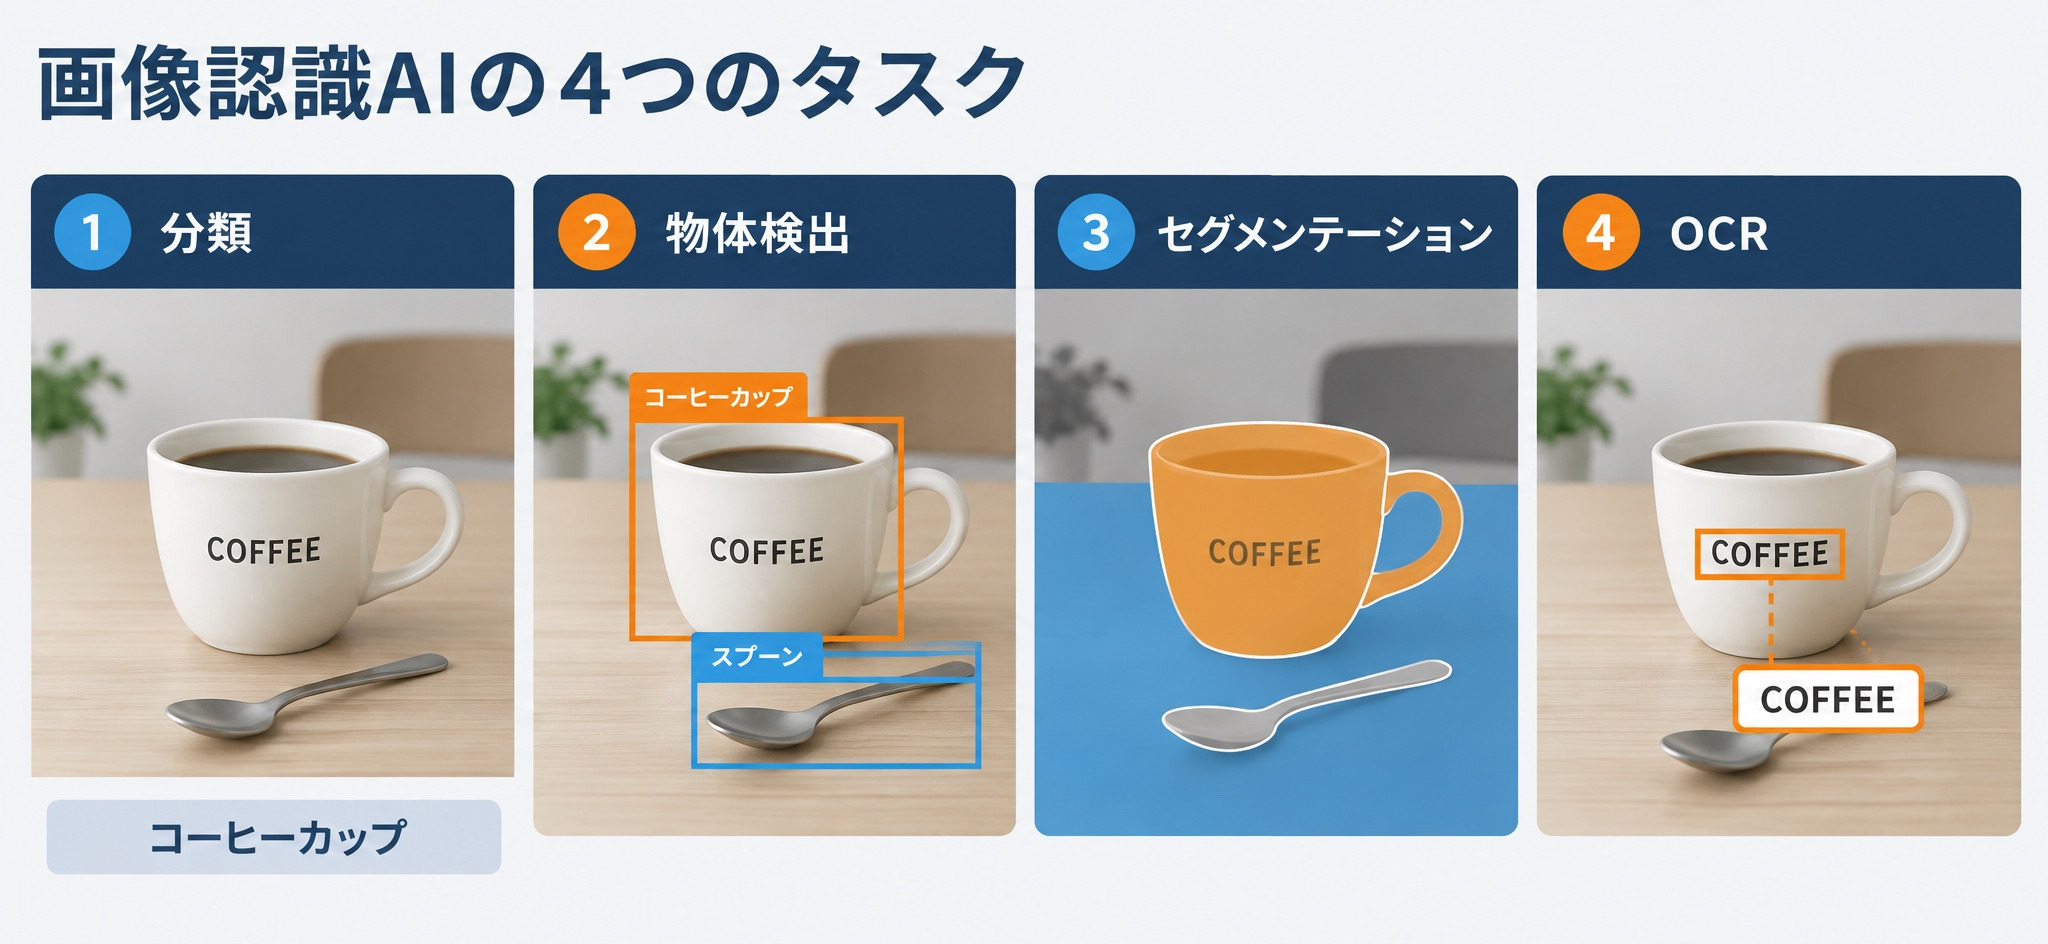
どのタスクを選ぶかは、業務で「何が分かれば判断できるか」で決まります。傷の有無だけ分かればよい検査なら分類、何個あるかを数えるなら物体検出、ひび割れの長さや幅を測るならセグメンテーションが基本になります。
画像認識AIの仕組み。CNNからVision Transformer、VLMへ
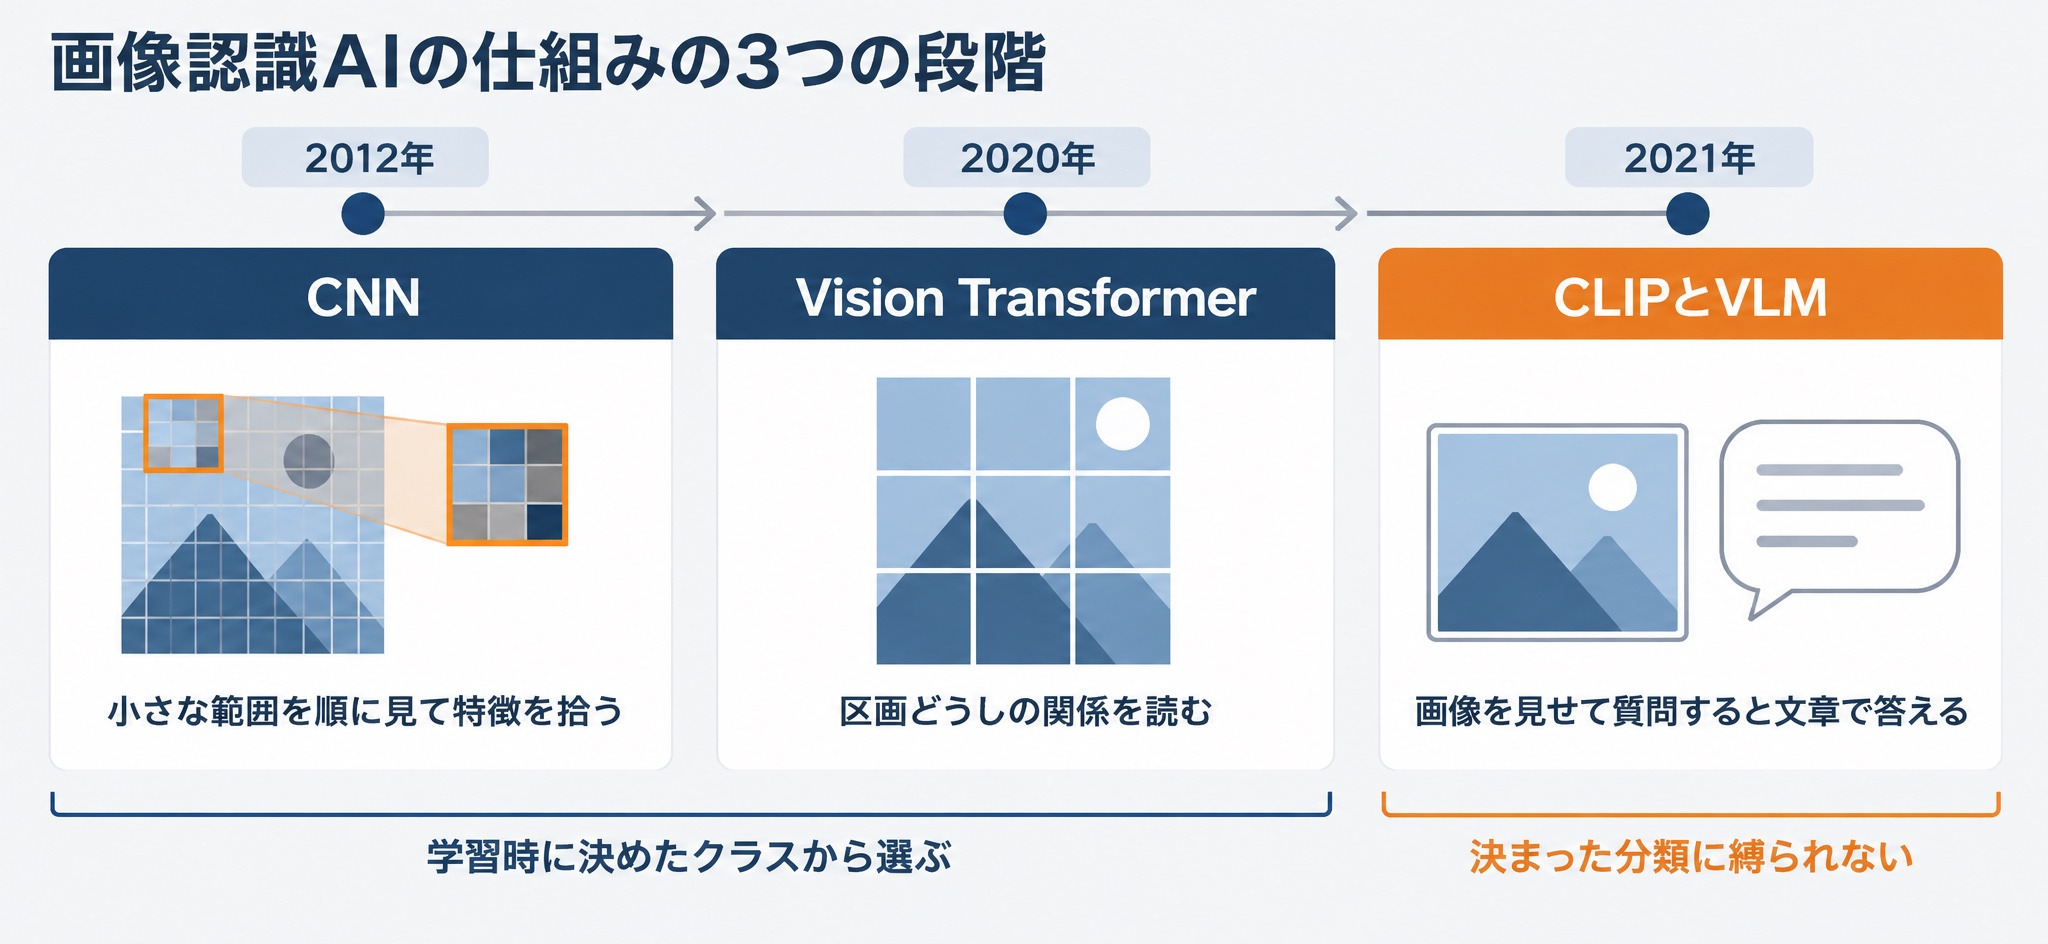
タスクの違いが分かったところで、AIがなぜ画像を見分けられるのかを見ていきます。画像認識AIの中身は、この十数年で3つの段階を経てきました。
CNN。画像の特徴を人が決めずにデータから学ぶ
従来の画像処理では、「縁の明るさの差がこれ以上なら傷」のように、見分けるための特徴を人が決めて書いていました。照明や個体差が大きい現場では、このルールを書き切れません。
CNN(畳み込みニューラルネットワーク)は、画像の小さな範囲を順に見て特徴を拾う処理を何層も重ねたモデルです。手前の層は線や色の境目を、奥の層はそれらを組み合わせた形や模様を捉えるように、大量の画像から自動で学びます。特徴を人が設計するのではなく、データから学ばせる点が、従来の画像処理との違いです。
転機になったのは、2012年の画像認識コンテスト ILSVRC です。1,000種類の物体を分類する課題で、CNNを使ったチーム SuperVision のエラー率は0.153で、2位のチームの0.262を大きく引き離しました(ILSVRC 2012 公式結果)。ここから画像認識の主流はCNNに移り、層を深くしても学習できるようにした ResNet(論文)などが続きました。
Vision Transformer。画像を小さな区画に分けて関係を読む
2020年には、文章を扱うAIで使われていた Transformer を画像に応用した Vision Transformer(ViT)が発表されました。ViTは、画像を16×16画素の小さな区画に分け、区画どうしの関係をまとめて読むことで画像を分類します。
論文は、畳み込みを使わずに区画の並びへ Transformer を直接当てはめるだけで分類がうまくいき、大量のデータで事前に学習すれば最先端のCNNに並ぶ結果が出ると報告しています(An Image is Worth 16×16 Words)。学習に大量のデータを要するため、実務では公開されている学習済みモデルを出発点にするのが一般的です。
VLM。画像と文章を一緒に学び、決まった分類に縛られない
CNNやViTの分類モデルは、学習時に決めたクラスの中から答えを選びます。この制約に対し、2021年に発表された CLIP は、インターネットから集めた4億組の画像と説明文の対で学習し、「この画像は何の写真か」を文章で指定して答えさせる方式を示しました(CLIP 論文)。論文自身も、従来の画像認識は決まったカテゴリを予測するように学習されているため、新しい対象には追加のラベル付きデータが要る、と課題を述べています。
この流れの先にあるのが、画像を見せて質問すると文章で答える VLM(視覚言語モデル)です。大規模なものに加え、SmolVLM のように推論時のメモリが1GB未満で動く小型のモデルも公開されています(SmolVLM 論文)。VLMの答えは、文章を生成する生成AIと同じ仕組みで作られます。その仕組みは生成AIの仕組みで解説しています。
3つの方式は、新しいものが古いものを置き換えたわけではなく、速さや必要なデータ量に応じて選び分けます。
画像認識AIを手元で動かした結果。学習済みモデル5つで確かめる
仕組みの違いが実際の出力にどう表れるかを、公開されている学習済みモデルを手元のパソコンで動かして確かめました。
分類・物体検出・セグメンテーション・VLMを同じ画像で動かす
使ったのは次の5つのモデルで、画像は外部に送っていません。
- 分類(CNN):ResNet-18。ImageNet の1,000クラスで学習済み(torchvision 公式の重み)
- 分類(ViT):DeiT-tiny。同じ1,000クラスで学習済みの小型のViT
- 物体検出:RT-DETRv2。COCO というデータセットの80クラスで学習済み(RT-DETRv2 論文)
- セグメンテーション:DeepLabV3(MobileNetV3版)。20クラスと背景で学習済み
- VLM:SmolVLM-256M-Instruct。画像を見て英語で答える小型のモデル
画像は、画像処理ライブラリ scikit-image に同梱されている猫・コーヒーカップ・宇宙飛行士・ロケットの4枚です(いずれも著作権の制約が無いと明記された写真)。測定条件は Apple M1 Pro の CPU・macOS 14.6.1・Python 3.12.12・torch 2.14.0・torchvision 0.29.0・timm 1.0.29・transformers 5.17.0 で、実行日は2026年9月23日です。
次のコードは、物体検出を実行した部分です。
# 物体検出:RT-DETRv2(COCOの80クラスで学習済み)で、画像のどこに何があるかを枠で出す
import time, torch, transformers
from PIL import Image, ImageDraw
from transformers import RTDetrImageProcessor, RTDetrV2ForObjectDetection

torch.set_num_threads(4)
repo = "PekingU/rtdetr_v2_r50vd"
proc = RTDetrImageProcessor.from_pretrained(repo)
model = RTDetrV2ForObjectDetection.from_pretrained(repo).eval()
print(f"transformers {transformers.__version__} / パラメータ数 {sum(p.numel() for p in model.parameters())/1e6:.1f}M")

for name in ["astronaut.png", "coffee.png", "chelsea.png", "rocket.jpg"]:
    img = Image.open(name).convert("RGB")
    inputs = proc(images=img, return_tensors="pt")
    with torch.no_grad():
        model(**inputs)  # 1回目は準備時間を含むため捨てる
        t0 = time.perf_counter()
        out = model(**inputs)
        ms = (time.perf_counter() - t0) * 1000
    r = proc.post_process_object_detection(out, target_sizes=[img.size[::-1]], threshold=0.5)[0]
    print(f"{name} ({img.size[0]}x{img.size[1]}) {ms:.0f}ms  検出 {len(r['scores'])}件")
    draw = ImageDraw.Draw(img)
    for s, l, b in zip(r["scores"], r["labels"], r["boxes"]):
        x0, y0, x1, y1 = [round(v) for v in b.tolist()]
        label = model.config.id2label[l.item()]
        print(f"  {label:12s} {s:.2f}  枠 ({x0},{y0})-({x1},{y1})")
        draw.rectangle([x0, y0, x1, y1], outline=(255, 0, 0), width=3)
        draw.text((x0 + 4, y0 + 4), f"{label} {s:.2f}", fill=(255, 0, 0))
    img.save(f"det_{name.split('.')[0]}.png")
出力は次のとおりでした(重みの読み込みの進行表示は省いています)。数字は確信度で、0.5以上の枠だけを出しています。
transformers 5.17.0 / パラメータ数 42.9M
astronaut.png (512x512) 373ms  検出 2件
  person       0.96  枠 (17,15)-(365,508)
  aeroplane    0.57  枠 (354,0)-(458,280)
coffee.png (600x400) 376ms  検出 5件
  cup          0.96  枠 (171,17)-(412,314)
  spoon        0.95  枠 (316,66)-(424,261)
  diningtable  0.91  枠 (0,1)-(600,397)
  spoon        0.90  枠 (325,66)-(424,327)
  spoon        0.55  枠 (325,194)-(407,327)
chelsea.png (451x300) 342ms  検出 2件
  cat          0.96  枠 (0,0)-(408,299)
  bed          0.58  枠 (0,0)-(451,299)
rocket.jpg (640x427) 353ms  検出 0件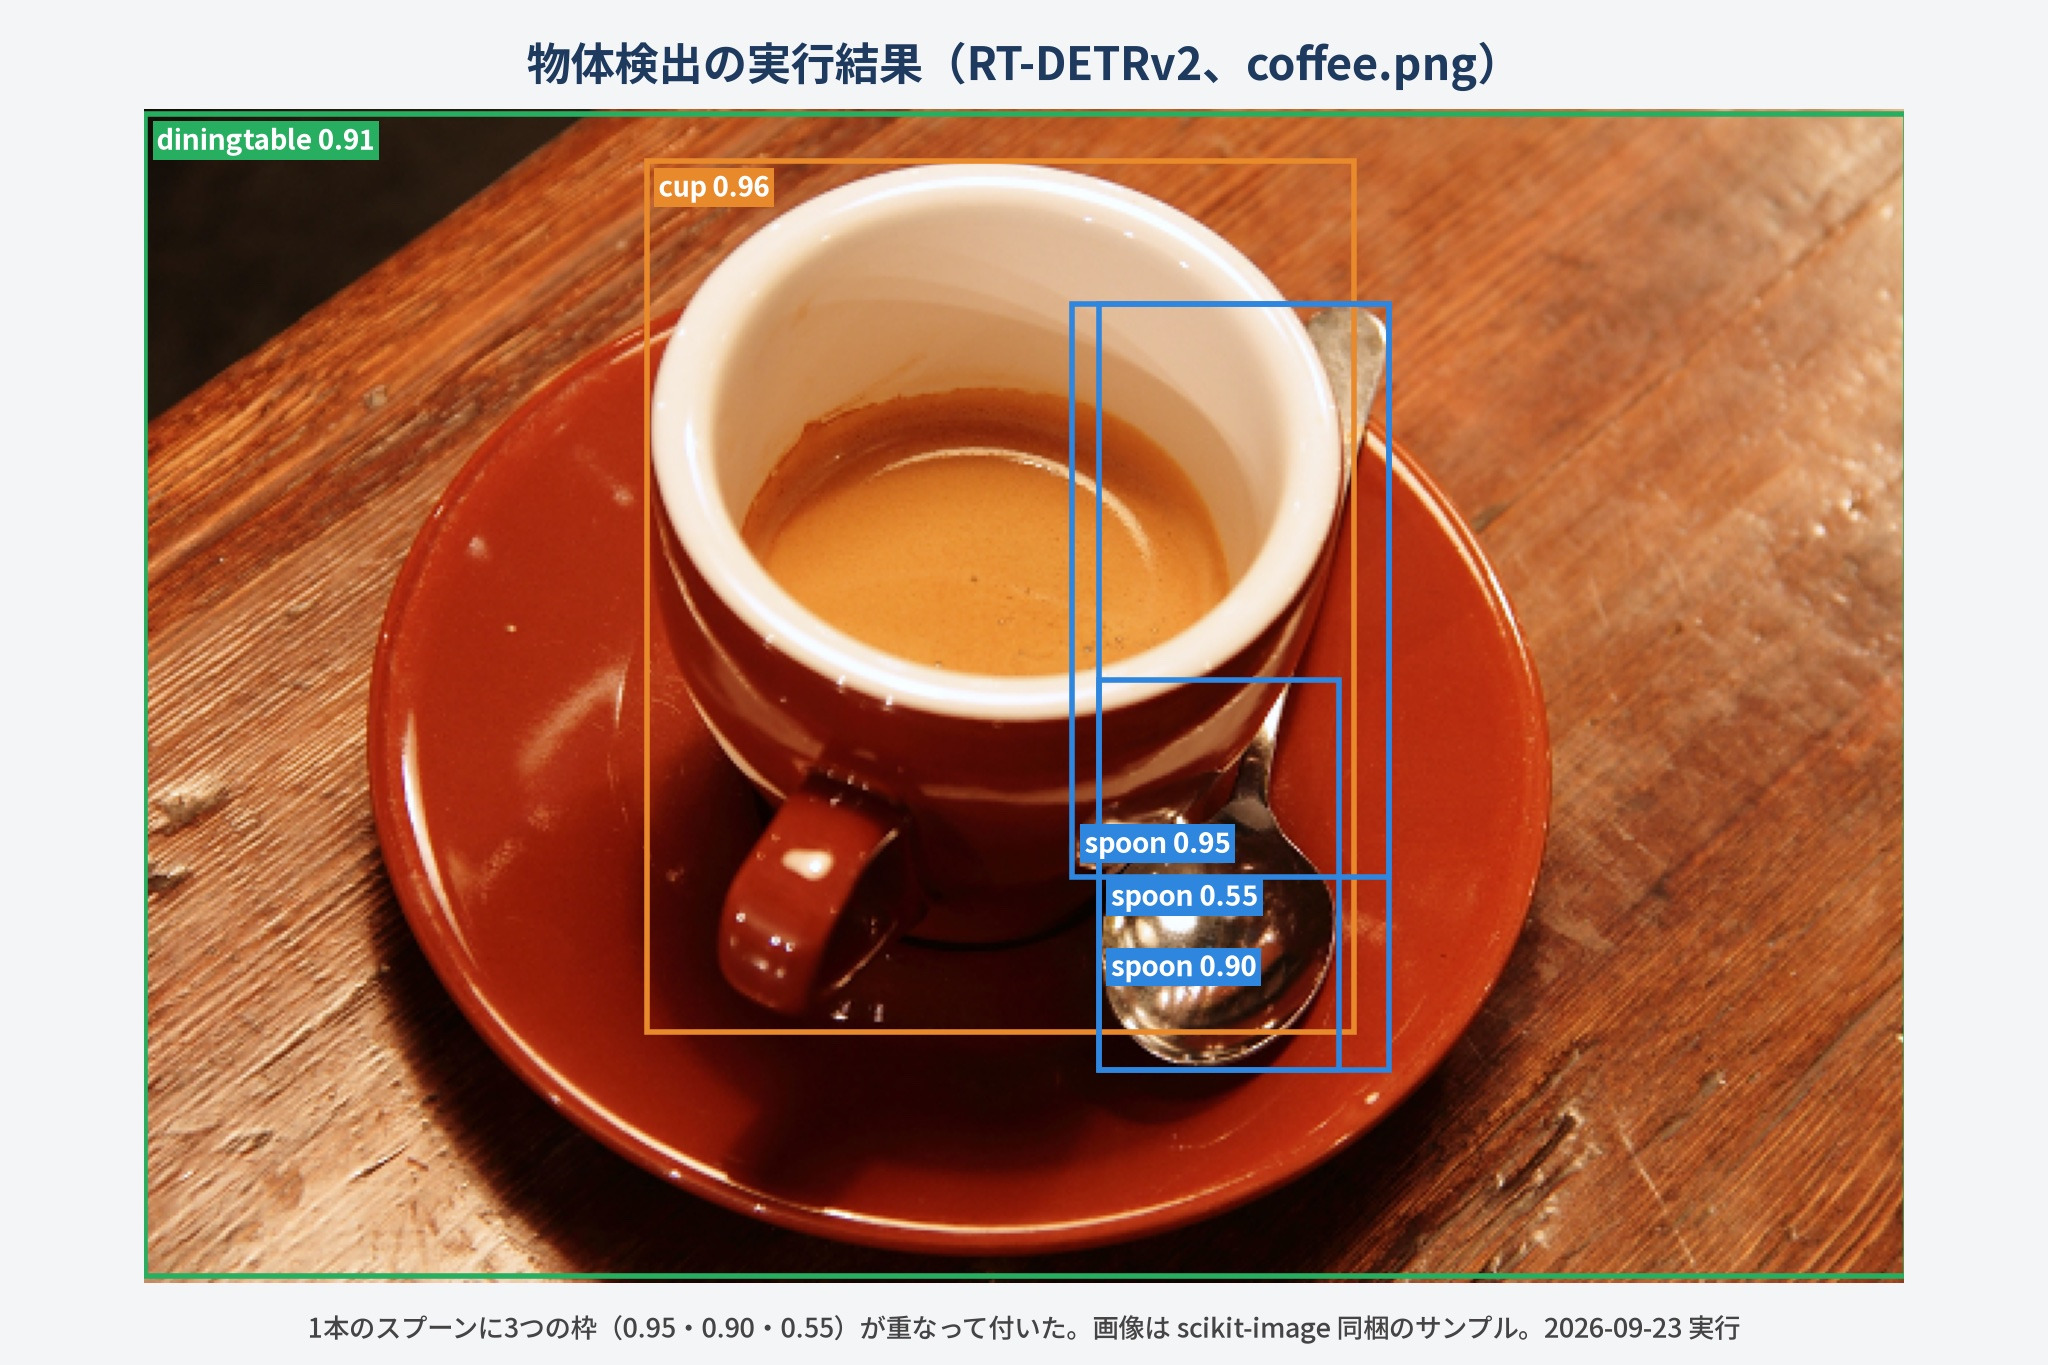
コーヒーカップの写真に写っているスプーンは1本ですが、位置の重なる3つの枠が「spoon」として出ました。宇宙飛行士の写真では、人物を0.96で検出したうえで、背後のスペースシャトルの模型を「aeroplane(飛行機)」と答えています。
同じ4枚を2つの分類モデルにかけた結果が次の表です。各モデルの確率が最も高かった答えを示しています。
| 画像 | ResNet-18(CNN) | DeiT-tiny(ViT) |
|---|---|---|
| 猫 | Egyptian cat(猫の種類の1つ)39.1% | Egyptian cat 42.4% |
| コーヒーカップ | espresso 85.2% | espresso 81.6% |
| 宇宙飛行士 | reel(釣り用のリール)11.3% | punching bag(サンドバッグ)8.4% |
| ロケット | obelisk(記念碑の塔)46.6% | crane(クレーン)47.1% |
この表から読み取れるのは、猫とコーヒーは2つのモデルがそろって妥当な答えを返した一方、宇宙飛行士とロケットはどちらも的外れだった点です。1枚あたりの処理時間は、どちらのモデルも13〜16ミリ秒でした。
セグメンテーションでは、猫の写真の画素の81.0%を「cat」、宇宙飛行士の写真の46.3%を「person」と塗り分けました。1枚あたり約0.24〜0.33秒です。
VLMの SmolVLM-256M に英語で質問すると、ロケットの写真には「a rocket in the middle of the image」を含む説明を返し、スプーンの本数には「There is one spoon in the cup.」と答えました。一方で、胸から上しか写っていない宇宙飛行士を「a woman standing(立っている女性)」と、写真からは確かめられない形で説明しています。1問あたり4.4〜6.7秒でした。
実行から分かる3つのこと
1つめは、学習したクラスの外にあるものは、正しく答えられないことです。分類モデルが学んだ ImageNet の1,000クラスに「宇宙飛行士」は無く、物体検出が学んだ COCO の80クラスに「ロケット」はありません。そのため分類モデルは宇宙飛行士の写真に「リール」と答え、物体検出はロケットの写真で1件も枠を出しませんでした。知らないものを「分からない」とは言わず、手持ちのクラスから答えを選ぶ点に注意が要ります。自社の製品や不良の種類は公開モデルのクラスに無いことが多いため、自社の画像で学習し直す工程が要ります。
2つめは、物体検出の数は、そのまま信じられないことです。1本のスプーンに3つの枠が付いたように、同じ物を重ねて検出することがあります。在庫や人数を数える用途では、重なった枠をまとめる処理や閾値の調整が要ります。ただし閾値を上げすぎると、今度は見逃しが増えます。
3つめは、できることの広さと速さが引き換えになることです。VLMは学習時のクラスに縛られず「rocket」と答え、スプーンの本数も正しく数えました。しかし1問に4〜7秒かかり、写真に無い「立っている」という記述も混ぜました。分類モデルは15ミリ秒前後、物体検出は約0.35秒です。製造ラインのように1秒に何個も判定する用途と、1日に数十枚の写真を人の代わりに説明させる用途では、向く方式が違います。
これは1台のパソコンで4枚の画像を各条件1回ずつ動かした結果で、モデルの優劣を決める材料ではありません。GPUを使えば処理時間は変わります。
画像認識AIの活用事例(公表されたもの)
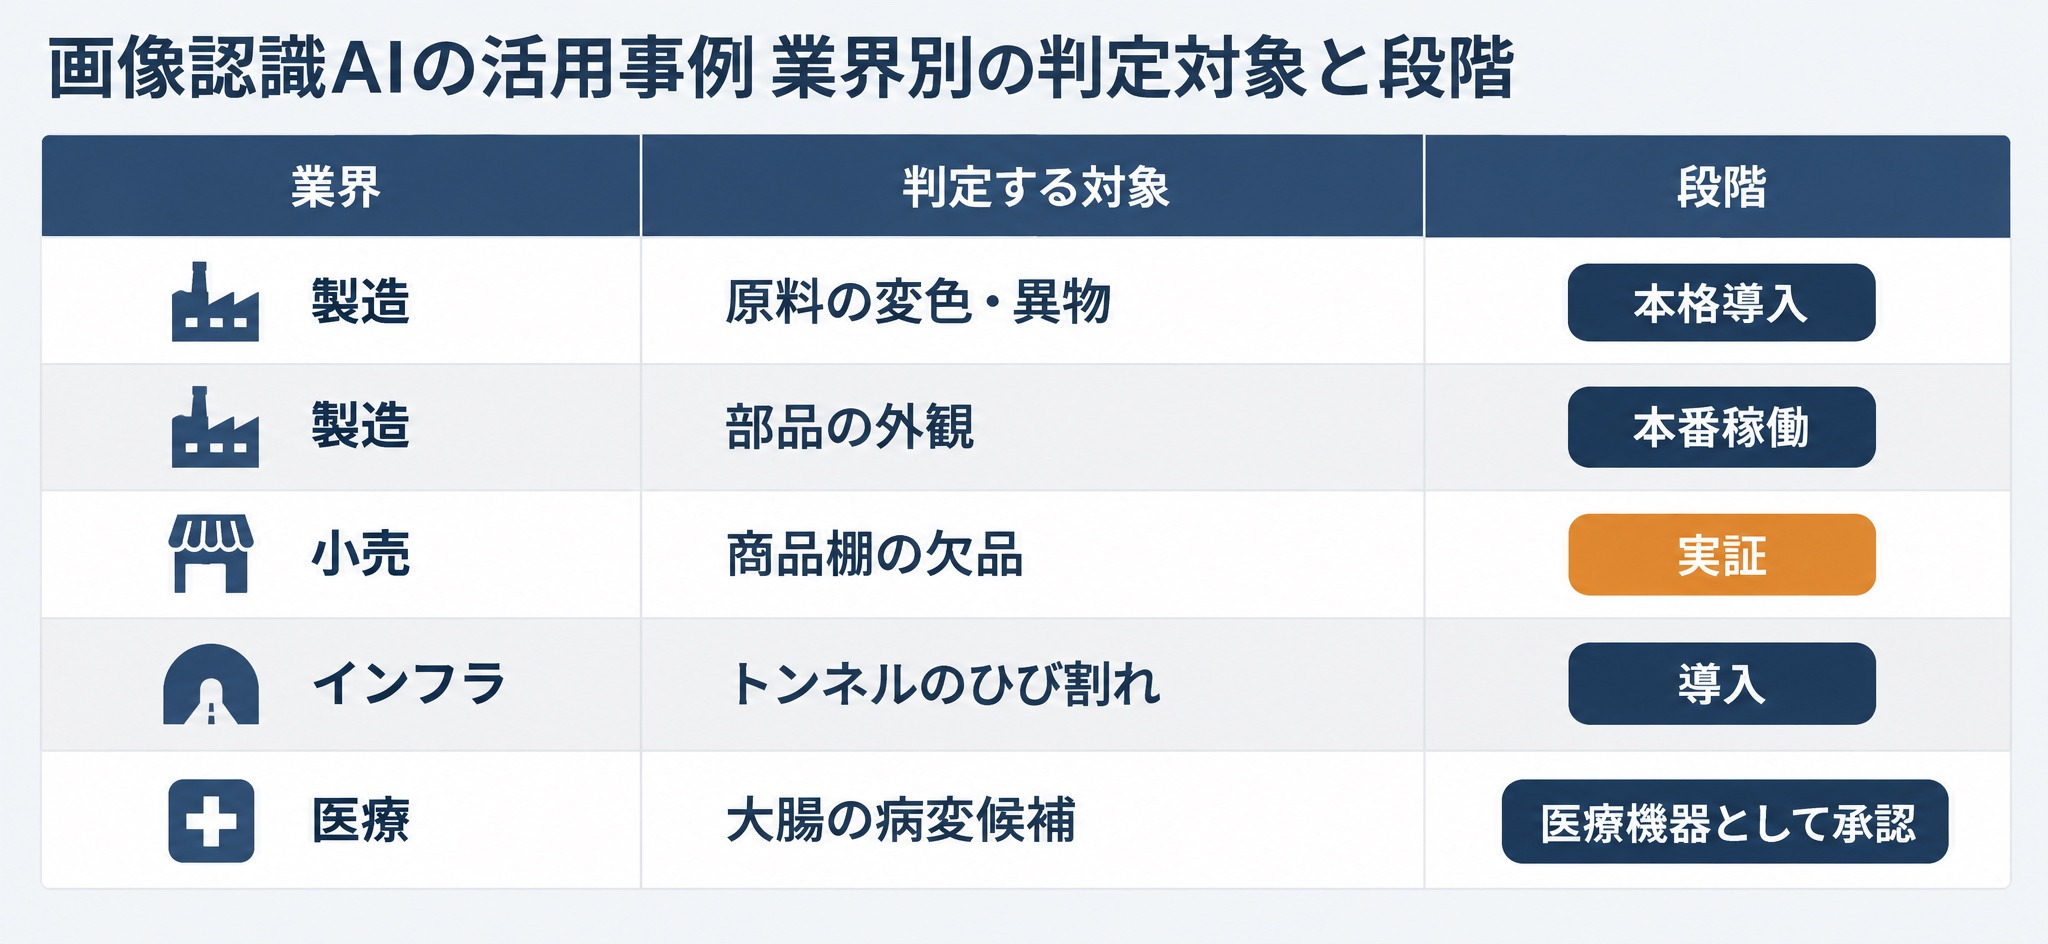
実行結果から、画像認識AIは「何を学習させるか」と「どのタスクで解くか」で性能が決まることが見えてきました。企業や医療機関が公表している事例を、業界別に紹介します。業界を問わないAI活用の事例は、AI活用事例でも整理しています。
製造の外観検査。キユーピーと福島芝浦電子
キユーピーは、ディープラーニングの画像解析を使った原料検査装置を自社で開発しました。
- 課題:原料から変色・変形したものや異物を目視で取り除く作業の負担が大きかった。不良のパターンは無数にあり、不良品を学習させる方法では精度が出にくかった
- 方式:良品のパターンだけをAIに学習させ、「良品以外」をすべて不良として検出する。前述の異常検知の考え方
- 成果:2018年8月からベビーフードの原料検査で本格導入し、2019年1月からグループ会社の惣菜工場にも展開。2020年には良品学習型の原料検査装置を世界で初めて実現・実導入した点が評価され、日本オープンイノベーション大賞の農林水産大臣賞を受賞
出典:キユーピー ニュースリリース(2019年)、キユーピー ニュースリリース(2020年)
福島芝浦電子は、日本IBMの支援を受けて、温度センサー部品サーミスタの外観検査を自動化しました。
- 課題:約20本の製造ラインで、1本あたり1秒未満の判定を8時間続ける検査員を常時20名以上配置する必要があった
- 方式:2021年1月からディープラーニングで外観検査のモデルを開発し、ガラスの反射や形状の歪みといった、従来の画像処理では難しかった要素に対応
- 成果:2024年10月に1号機、11月に2号機が本番稼働し、83%以上の省力化と24時間の安定稼働を実現。モデルの開発と運用は社内で行える体制に移した
出典:日本IBM ニュースリリース(2025年11月19日)
小売の欠品検知。KDDIとローソン
KDDIとローソンは、「ローソン S KDDI高輪本社店」で2025年11月8日から、AIとロボットを使った店舗DXの実証を始めました。
- 課題:商品棚の欠品の把握や品出しは、店舗業務の中でも人手を要する
- 方式:自律走行ロボットの4Kカメラで棚を撮影し、画像解析AIでプライスカードや商品パッケージから商品名・棚割り・商品の状況を把握する
- 成果:実証の段階で、効果の数値は未公表。目視確認を不要にし、売場から離れた場所でも棚の状況を把握することを目指している
インフラ点検。JR東日本の新幹線トンネル
JR東日本は、富士フイルムと共同で、新幹線トンネルのひび割れを自動で抽出するAIを実用化しました。
- 課題:トンネルの内壁に現れるひび割れを図にまとめる作業を、人が行っていた。前回の検査から変化した箇所を見逃さないことが重要
- 方式:富士フイルムのAI画像解析技術を基盤に、トンネルの内壁の画像からひび割れを抽出するモデルを開発。さらに2つの時期のひび割れを比べ、新しいひび割れや伸びた箇所を自動で抜き出す
- 成果:2025年度から新幹線のトンネル検査に導入。確認が必要な箇所を日中に絞り込めるようになり、夜間作業の時間を約2割削減する
出典:JR東日本 プレスリリース(2025年4月8日)、富士フイルム ニュースリリース
医療の診断支援。国立がん研究センターとNEC
国立がん研究センターとNECが共同開発した「WISE VISION 内視鏡画像解析AI」は、2020年11月30日に医療機器として承認されました。
- 課題:大腸の内視鏡検査で、早期の大腸がんや前がん病変の見逃しを減らしたい
- 方式:1万病変以上、25万枚の内視鏡画像に、内視鏡科のスタッフが1枚ずつ所見を付けて学習させた。検査中の画像をリアルタイムに解析し、病変が疑われる部位を円マークと通知音で示す
- 位置づけ:診断を行うのは医師で、AIは病変候補の部位を示して診断を支援(補助)する医療機器プログラムとして承認されている
出典:国立がん研究センター プレスリリース(2021年1月12日)
医療で画像認識AIを使う場合は、医療機器に当たるかどうかの確認や、医療情報の安全管理のガイドラインへの対応が加わります。
5つの事例に共通するのは、判定したい対象と場面を絞り込み、実証や試作を経て段階的に業務へ組み込んでいる点です。福島芝浦電子の事例では、実証実験と試作、本番稼働テストを経てから本番に移しています。
画像認識AIの導入を5つのステップで進める
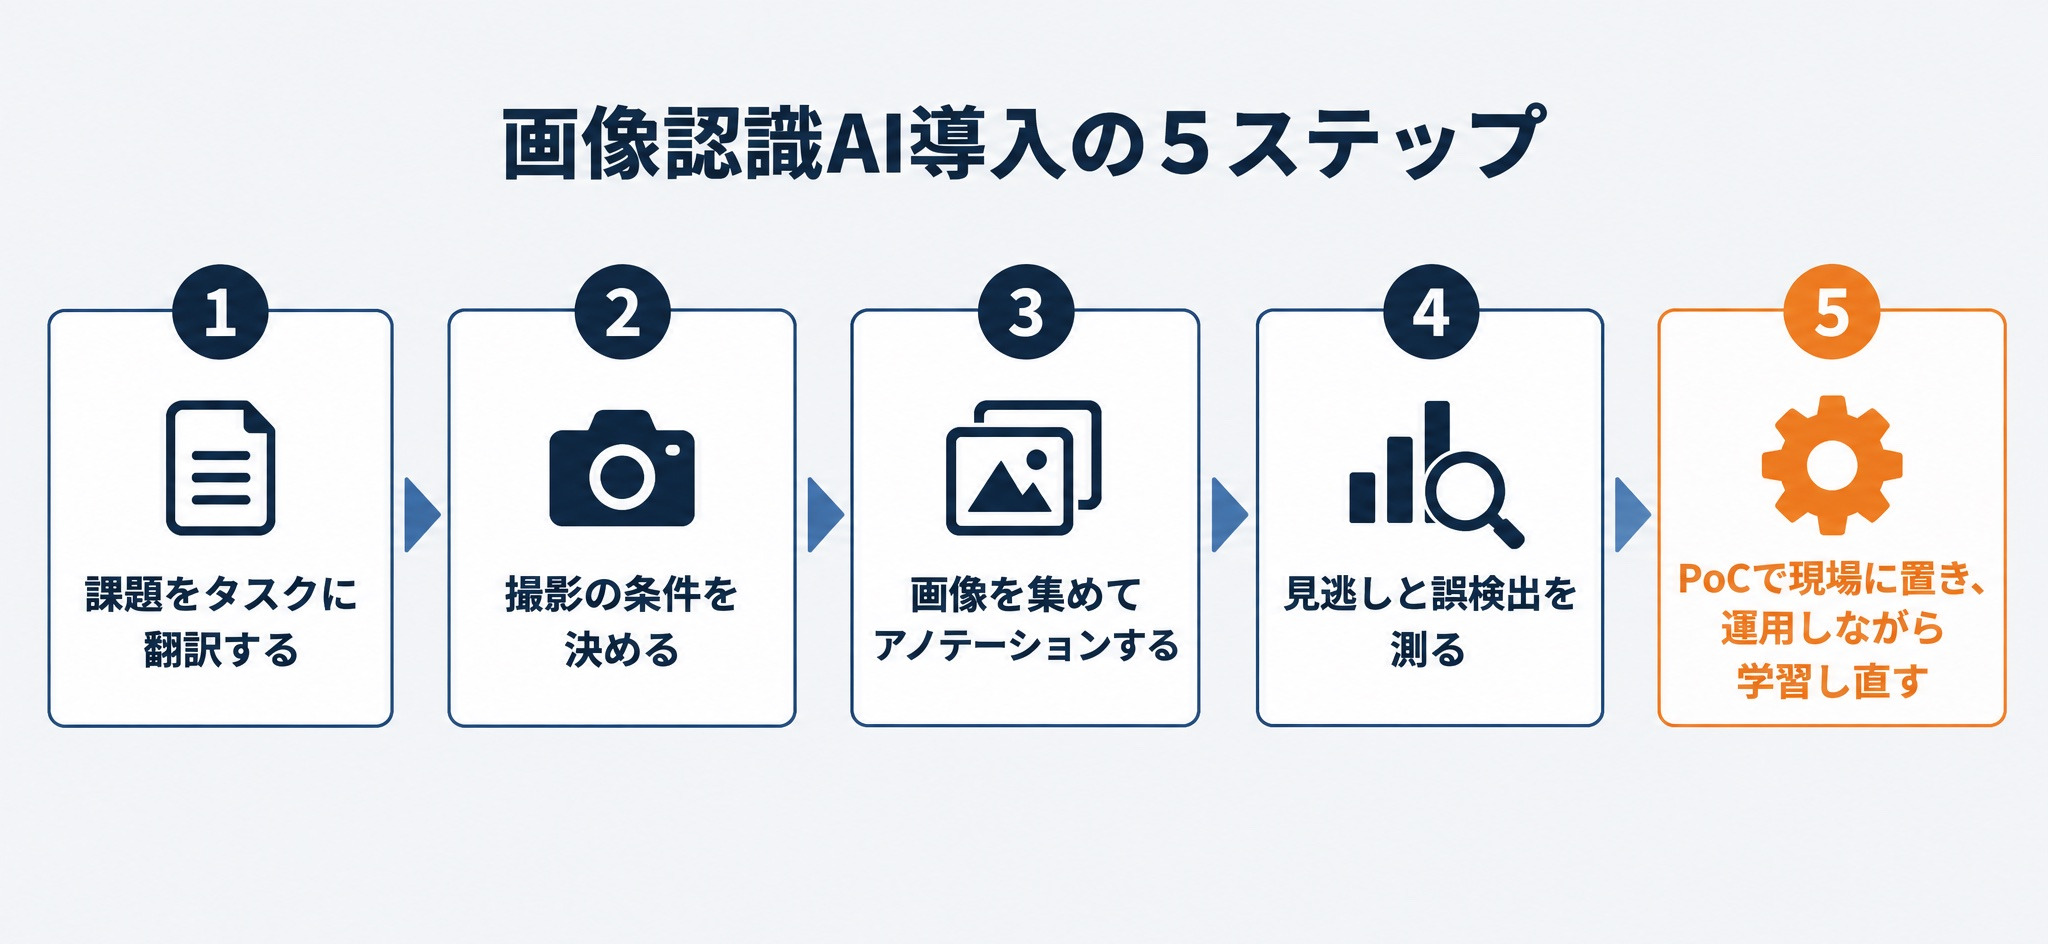
事例の共通点を、自社で導入するときの手順に落とすと、次の5つのステップになります。
1. 業務の課題を画像認識のタスクに翻訳する
業務の責任者とDX推進の担当者が、「AIに何を判断させたいか」を1文で書き、タスクに置き換えます。例えば「傷がある製品を止めたい」なら分類か異常検知、「欠品している棚の位置を知りたい」なら物体検出、「ひび割れの長さを測りたい」ならセグメンテーションです。不良品の画像がほとんど集まらない場合は、キユーピーの事例のように良品だけを学習させる異常検知が候補になります。目的と合格ラインの決め方はAIの要件定義で解説しています。
2. 撮影の条件を決める
現場の担当者と一緒に、カメラの位置・距離・角度・照明を決め、できるだけ固定します。窓からの光が時間帯で変わる、製品が向きを変えて流れてくる、といった変動は、この段階で洗い出しておきます。
3. 画像を集めてアノテーションする
学習に使う画像を集め、正解を付けます。この正解付けをアノテーションと呼びます。進め方のポイントは次の3つです。
- 現場で実際に起きる画像を混ぜる:良品と不良品だけでなく、季節や時間帯の違い、ピントのずれた画像も集める
- 判定の基準を文書にする:「どの大きさから傷とするか」を、見本の画像付きで決めておく
- 2人で同じ画像に正解を付けて比べる:食い違った画像は、基準があいまいな箇所を示している
公開されている学習済みモデルを出発点に、自社の画像で追加学習させると、ゼロから学習するより少ない枚数で始められます。この考え方は転移学習とファインチューニングの違いで詳しく解説しています。
4. 見逃しと誤検出を測って合格ラインを決める
学習に使っていない画像でモデルを試し、次の2つを数えます。
- 見逃し:本当は不良なのに、AIが良品と判定した数
- 誤検出:本当は良品なのに、AIが不良と判定した数
見逃しと誤検出は、確信度の閾値を動かすと片方が減り、もう片方が増える関係にあります。そこで、見逃し1件で起きる損失と、誤検出1件を人が確認し直す手間を比べて、閾値を決めます。安全に関わる検査なら見逃しを減らす側に、確認の人手が足りない現場なら誤検出を減らす側に寄せる、という判断です。
5. PoCで現場に置き、運用しながら学習し直す
小さな範囲で現場に置き、人の判定と並行して動かします。この小さな検証をPoC(概念実証)と呼びます。AIの判定と人の判定が食い違った画像は、次の学習データの候補になります。本番に移った後も、新しい製品や照明の変更があれば精度が落ちるため、定期的に学習し直す運用を組み込んでおきます。PoCの進め方全般はAIのPoCで解説しています。
ここまで画像認識AIの仕組みと導入の手順について解説しましたが、「自社の画像で画像認識AIが本当に使えるのか、製品やモデルを決める前に確かめたい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、業務の課題を画像認識のタスクに翻訳し、撮影条件やアノテーションの基準、見逃しと誤検出の合格ラインまでを一緒に設計できます。既存モデルの比較評価だけでなく、自社の画像での学習し直しや、判定結果を社内システムにつなぐ開発まで行えるため、現場の運用に合った画像認識AIの仕組みを作れます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
画像認識AIを無料で試す方法(2026年9月時点)
導入のステップ1からステップ4までは、費用をかけずに試せる範囲があります。「画像認識AI フリー」で探すと消費者向けのアプリも見つかりますが、業務の検証に向くのはクラウドAPIの無料枠とオープンソースの学習済みモデルです。
クラウドAPIの無料枠
主要なクラウドの画像認識APIには、公式に無料枠が設けられています。2026年9月23日に各社の公式の料金ページで確認した内容は次のとおりです。
| サービス | 無料の範囲(公式ページの記載) | 注意点 |
|---|---|---|
| Google Cloud Vision API | 毎月最初の1,000ユニットは無料(料金) | 機能ごとに1ユニットと数える。1枚にラベル検出と顔検出をかけると2ユニット |
| Azure AI Vision | Free(F0)で1か月あたり5,000件の無料トランザクション(価格) | 1分あたり20件まで。リージョンによっては対象外 |
| Amazon Rekognition | 無料利用枠の期間(アカウント作成から12か月)は、画像分析が月1,000枚まで無料(API群ごと)(料金) | 2025年7月15日以降の新規顧客は、最大200ドルの無料利用枠クレジット方式に変わっている |
この表から分かるのは、無料枠の数え方が「ユニット」「トランザクション」「枚数」と、サービスごとに違うことです。数百枚の自社画像で出力を確かめる程度なら、無料枠やクレジットの範囲に収まる規模です。
ただし、これらのAPIが返すのは、各社が決めた汎用のラベルです。自社の製品名や不良の種類を学習させるには、カスタムモデルの機能を使うか、自社でモデルを作る必要があります。Azure にはカスタム画像分類とカスタム物体検出の機能(プレビュー)があり、F0では推論が月5,000件まで無料と記載されています。
オープンソースの学習済みモデル
画像を外部に送れない場合や、自社の画像で学習し直したい場合は、オープンソースのモデルを手元で動かす方法があります。本記事の実行で使った5つのモデルは、いずれも1台のパソコンのCPUで動きました。
- ライブラリ:PyTorch の画像向けライブラリ torchvision(BSD-3-Clause)、画像モデル集 timm(Apache-2.0)、Hugging Face の transformers(Apache-2.0)、画像処理の OpenCV(Apache-2.0)
- 学習済みモデル:本記事で使った RT-DETRv2・SmolVLM-256M・DeiT-tiny は、いずれもモデルの配布ページで Apache-2.0 と表示されている
ライセンス料はかかりませんが、撮影から判定結果の保存までの仕組みは自分たちで作る必要があります。社内のパソコンやサーバーでAIを動かす選択肢の全体像は、ローカルAIでできることと限界で解説しています。
どちらの方法で試す場合も、ステップ4の見逃しと誤検出を同じ画像で数えれば、有料の製品と同じ物差しで比べられます。
画像認識AIを導入するときの注意点
無料で試し始める前に、画像認識AIの導入でつまずきやすい点を4つ押さえておきます。
学習していないものは正しく答えられない
実行結果で見たとおり、画像認識AIは学習したクラスの中から答えを選ぶため、知らないものにも手持ちのクラスのどれかを答えとして返します。製品の新しい型番や、初めて出た種類の不良には、学習し直すまで対応できません。「分からない」を判定できるよう、確信度が低い画像を人に回す経路を用意しておきます。
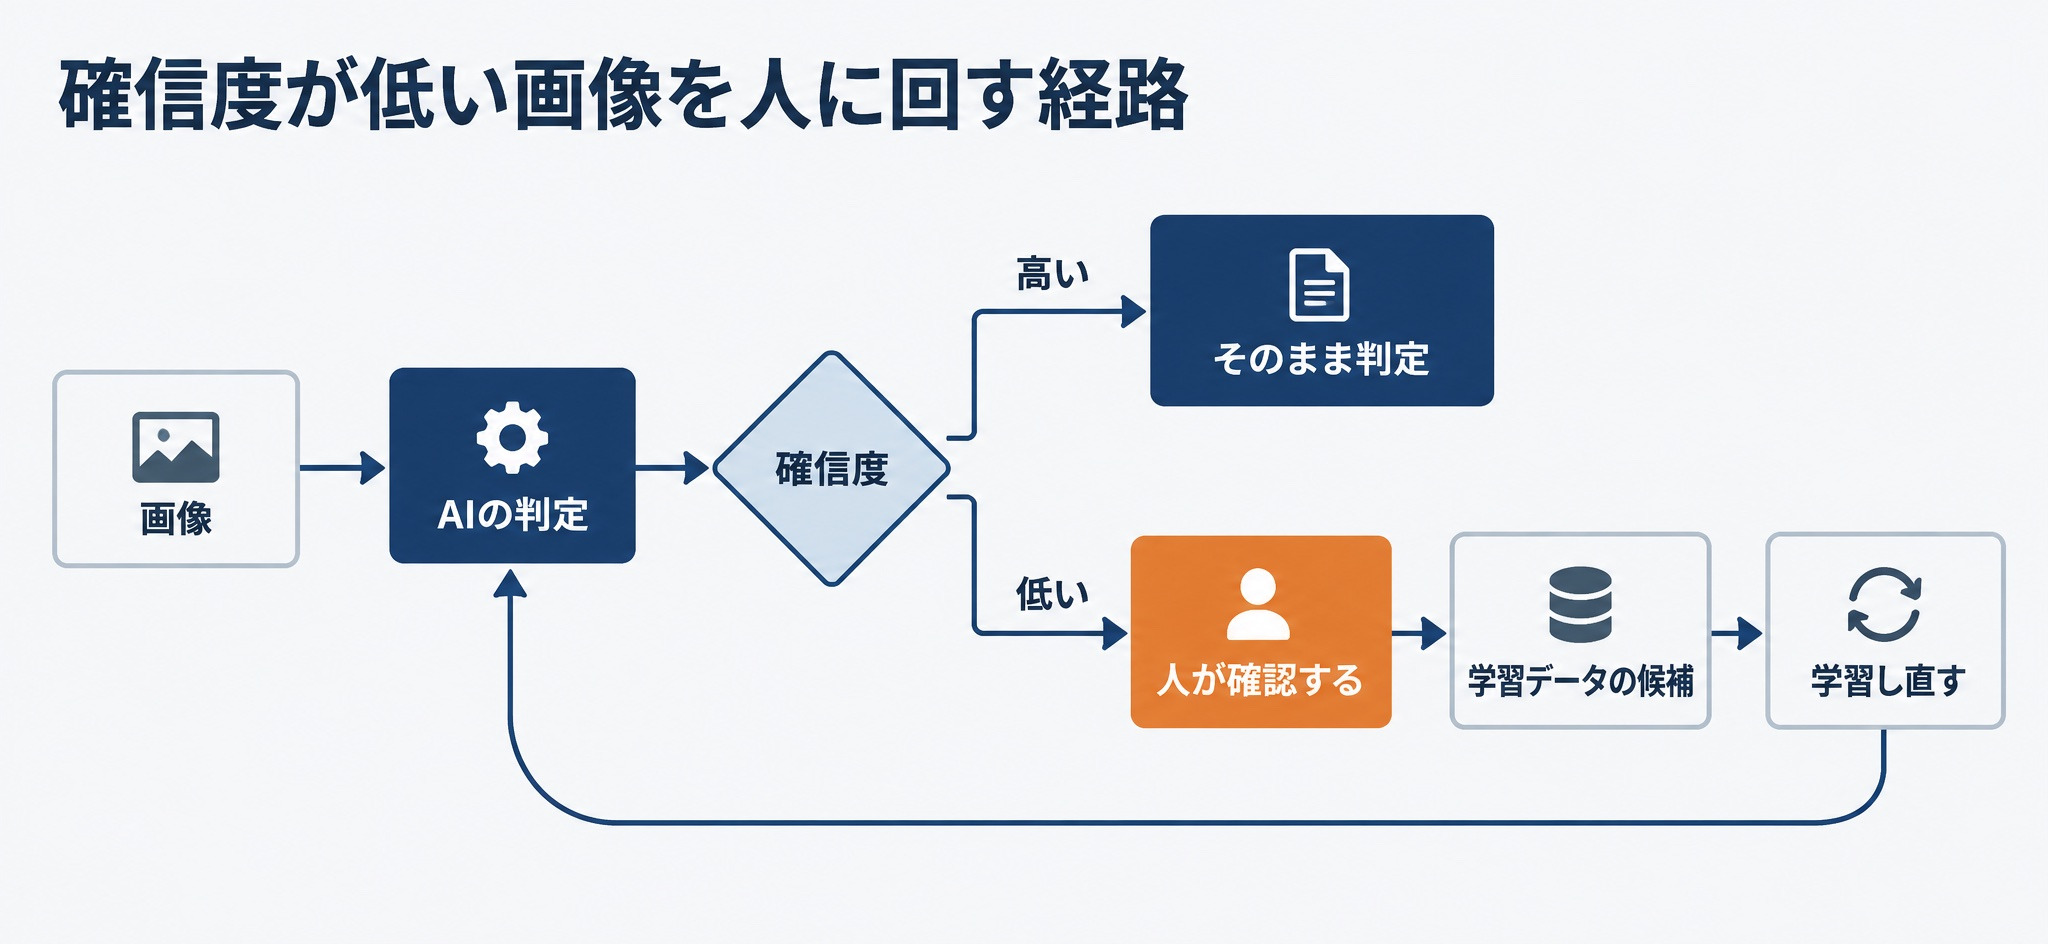
VLMは決まったクラスに縛られませんが、写真に無いことを書き加える場合があります。この種の誤りは生成AIに共通する性質で、AIのハルシネーションで起き方と抑え方を整理しています。
撮影環境が変わると精度が落ちる
照明の交換、カメラの買い替え、季節による日差しの変化などで画像の見え方が変わると、精度が下がることがあります。本番に移った後も、AIの判定と人の確認結果を定期的に突き合わせておきます。
人が写る画像はプライバシーへの配慮が要る
店舗や施設のカメラで人を撮影する場合は、個人情報保護法への対応に加え、プライバシーへの配慮が求められます。
- 総務省と経済産業省などが公表した「カメラ画像利活用ガイドブック ver3.0」は、商用目的でカメラ画像を使う事業者向けに、事前の告知や取得時の配慮事項を整理しています(総務省 報道資料)
- 個人情報保護委員会は、顔画像から顔特徴データを抽出することは、元の顔画像をすぐに捨てる場合でも個人情報の取扱いに当たると整理しています(個人情報保護委員会 顔識別機能付きカメラシステムの利用について)
棚の欠品検知のように人を判定の対象にしない用途でも、画面に客が写り込む場合は、撮影範囲や画像の保存期間を決めておきます。
オープンソースのライセンスを確かめる
「無料で使える」と紹介されるモデルでも、商用での使い方に条件が付くものがあります。例えば物体検出でよく使われる Ultralytics YOLO は AGPL-3.0 で提供されており、プロジェクト全体を公開せずに使う場合や商用の製品に組み込む場合は、Enterprise License が必要と公式に案内されています(Ultralytics ライセンス)。モデルの重みと、使うライブラリの両方のライセンスを、試す段階で確認しておくと手戻りを防げます。
まとめ
ここまでの要点をまとめます。
- 画像認識AIとは、画像に何がどこに写っているかをAIで判定する技術で、分類・物体検出・セグメンテーション・OCRに分かれます
- 仕組みは、CNN、Vision Transformer、画像と文章を一緒に学ぶVLMへと広がってきました
- 学習済みモデル5つを動かすと、学習したクラスの外は答えられない、同じ物を重ねて検出する、VLMは1問に数秒かかる、という限界が見えました
- 公表事例では、判定したい対象と場面を絞り、実証を経て段階的に業務へ組み込んでいます
- 導入は、課題をタスクに翻訳→撮影条件を決める→アノテーション→見逃しと誤検出を測る→PoCと運用の順で進めます
- クラウドAPIの無料枠とオープンソースのモデルで、費用をかけずに最初の検証ができます
画像認識AIの開発は「リベルクラフト」へ
ここまで読んで、自社の課題をどのタスクで解けばよいかは見えてきたが、撮影やデータの準備、精度の判断までを社内だけで進めるのは難しい、と感じた方も多いのではないでしょうか?
リベルクラフトでは、戦略・構想の立案、AIシステムのものづくり、社内人材を育てる教育の3軸で、企業のAI・データ活用を支援しています。AI活用コンサルティング、AI開発の受託、社内ナレッジ基盤の構築まで、要件定義から本番運用までを一貫してお受けしています。
画像認識AIについては、業務の課題をタスクに翻訳するところから入り、撮影条件とアノテーションの設計、学習済みモデルの比較評価と自社の画像での学習し直し、判定結果を社内システムにつなぐ開発までを行います。次のような状況の方に適しています。
- 目視の検査や点検を、自社の画像でAIに置き換えられるかを確かめたい
- クラウドのAPIと、手元で動かすモデルやVLMを、同じ物差しで比べたい
- 画像を外部に出さずに、社内の環境で画像認識AIを動かしたい
構想段階のご相談でも問題ありません。まずはお気軽にお問い合わせください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。