AI-OCRとは。従来のOCRとの違いと精度の測り方、選び方を実測で解説
紙の請求書や申込書の入力を減らしたくてAI-OCRを調べ始めた、という方も多いのではないでしょうか?
調べると、どの製品にも「読み取り精度99%」といった数字が並んでいます。しかし、その数字が自社の手書き帳票やFAXでも出るのかは、製品ページを読んでも分かりません。精度は、何を・どの帳票で・どう数えたかによって大きく変わるからです。
AI-OCRの利用自体は広がっています。総務省の令和7年度調査では、地方自治体が導入しているAIを機能別に数えると、AI-OCRなどの「文字認識」は629件で、「音声認識」の967件に次ぐ2番目でした(総務省 自治体におけるAI・RPA活用促進 R7年度版 概要版)。
そこで本記事では、
- AI-OCRとは何か。従来のOCRや、生成AIで読む方式と何が違うのか
- AI-OCRで読める帳票と、苦手なもの
- ローカルで動くOCR3種で請求書を読んだ実測と、精度の測り方
- 導入の5ステップと、製品の比べ方(料金体系・無料で試せる範囲)
- 公表された導入事例
を解説します。紙の帳票のデータ化を任されたDX推進・業務改善のご担当者の方は、ぜひ最後までご覧ください。
自社の帳票にAI-OCRが使えるかを早めに見極めたい、という方はリベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
AI-OCRとは。従来のOCRや生成AIで読む方式との違い
AI-OCRという言葉は、実は中身の違う複数の方式をまとめて指しています。まず定義を押さえ、次に方式ごとの違いを見ていきます。
AI-OCRとは、AIで文字を読み取り、帳票の項目をデータにする技術
AI-OCRとは、紙やPDF、画像に書かれた文字をAIで読み取り、請求番号や金額といった項目ごとのデータに変える技術です。OCRは Optical Character Recognition の略で、日本語では光学文字認識と呼びます。
ポイントは「項目ごとのデータ」にするところです。文字を読むだけなら従来のOCRでもできました。業務で必要なのは、読んだ文字のうちどれが取引先名で、どれが合計金額なのかを切り分け、会計システムやExcelに入る形にすることです。AI-OCRの製品の多くは、この項目の切り分けまでを1つの流れで行います。
従来のOCRとの違いは、文字の形をルールで照合するか、データから学ぶか
従来のOCRは、人が決めたルールで文字の形を照合していました。帳票ごとに「この位置にこの項目がある」と読取位置を定義し、定義どおりの帳票を読むのが基本です。活字の定型帳票には強い一方で、癖のある手書きや、取引先ごとに様式が違う請求書は苦手でした。
AI-OCRは、大量の文字画像から深層学習(ディープラーニング)で文字の特徴を学びます。例えばオープンソースのOCRエンジン Tesseract は、バージョン4.0でLSTMというニューラルネットワークを使う認識エンジンを加えました(Tesseract 公式ドキュメント)。ルールを書き足すのではなく、学習データを増やして読める字を増やす、という発想の転換が「AI」の中身です。
「OCRにAIを使うと何が変わるのか」を一言でいえば、手書きや様式の違う帳票のように、ルールで書き切れないものを読めるようになるという変化です。
生成AI・VLMで読むAI-OCRは、誤り方が違う
近年は、生成AIで読むAI-OCRも登場しています。画像と文章を一緒に扱えるモデルをVLM(視覚言語モデル)と呼び、帳票の画像を見せて「請求番号と合計金額を書き出して」と指示すると、項目名つきで答えを返します。
この方式の源流の1つが、2021年に発表された Donut という研究です。論文は、OCRエンジンに文字の読み取りを任せる方式の課題として、計算コスト、言語や文書の種類への柔軟性の低さ、OCRの誤りが後の処理に伝わることを挙げ、OCRを使わずに文書画像から直接答えを生成するモデルを提案しました(OCR-free Document Understanding Transformer)。生成AIが文章を作る仕組みそのものは生成AIの仕組みで解説しています。
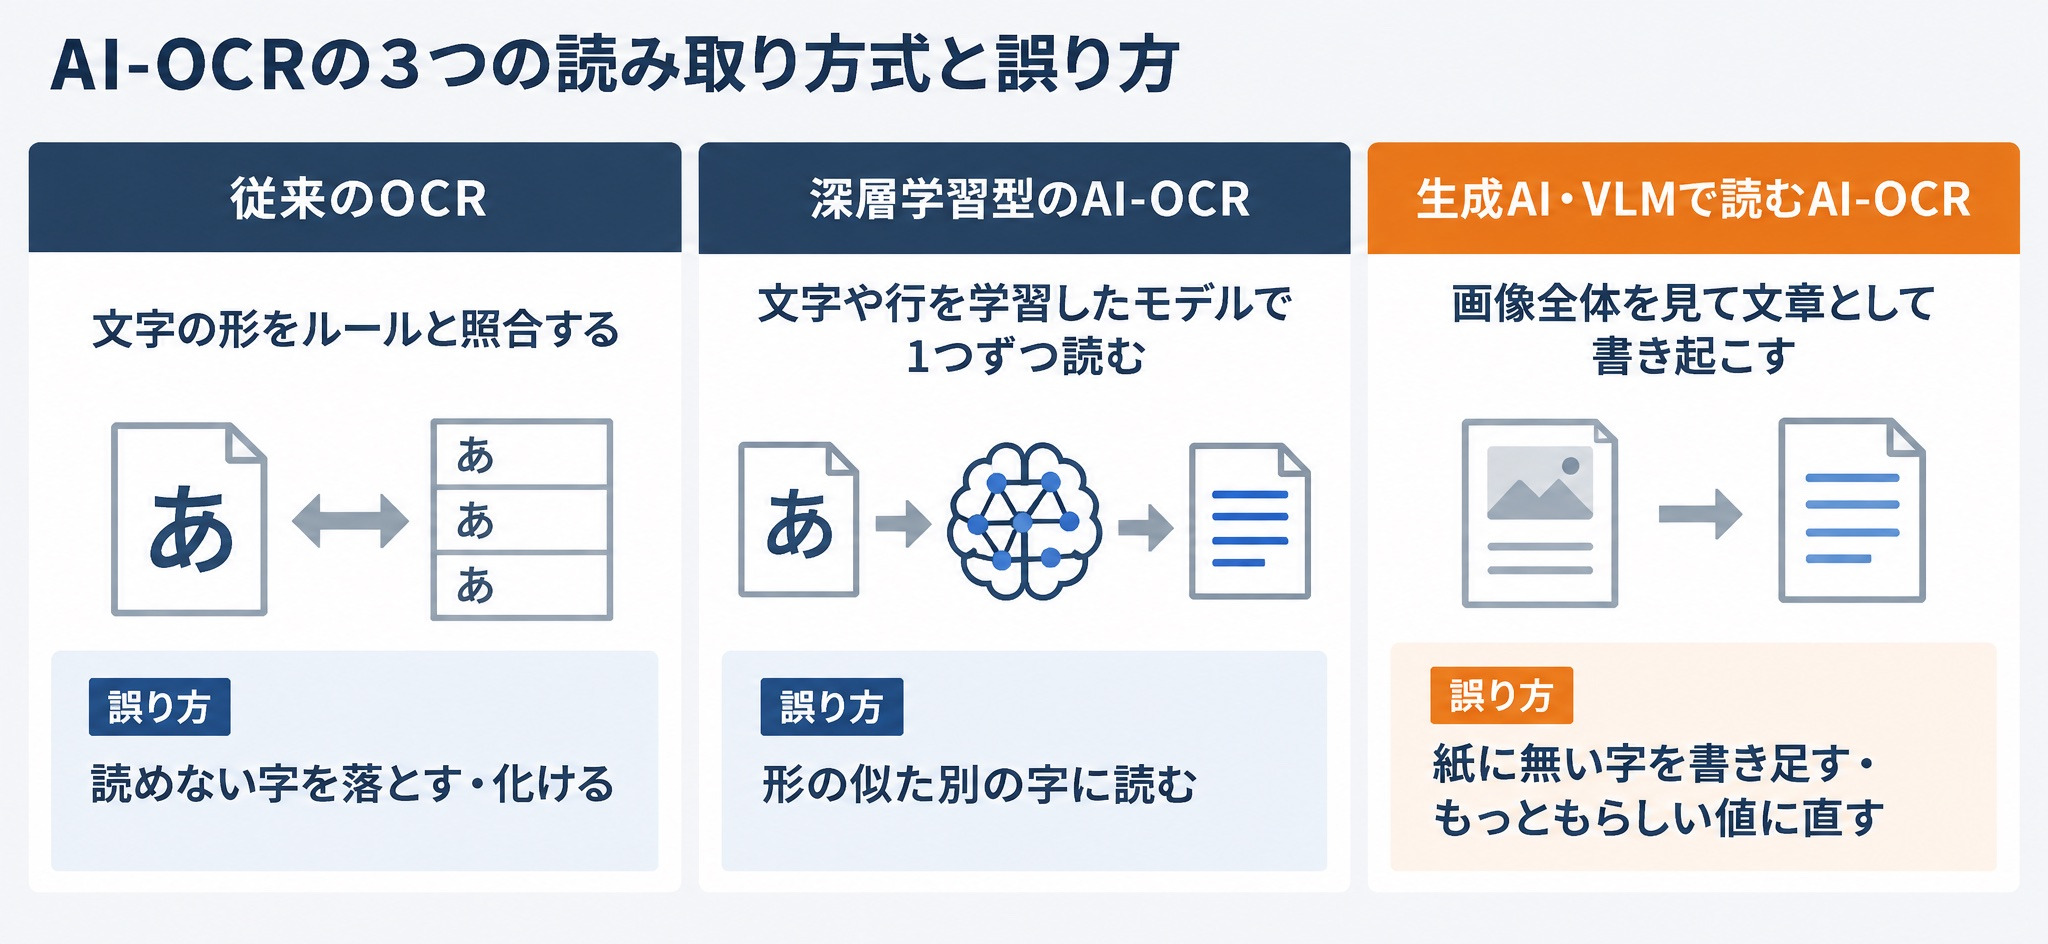
導入を検討する側が押さえたいのは、方式によって誤り方が違うという点です。
| 従来のOCR | 深層学習型のAI-OCR | 生成AI・VLMで読むAI-OCR | |
|---|---|---|---|
| 読み方 | 文字の形をルールと照合する | 文字や行の画像を、学習したモデルで1つずつ読む | 画像全体を見て、文章として書き起こす |
| 得意なもの | 活字の定型帳票 | 手書き・様式の違う帳票 | 様式が毎回違う帳票・表の構造 |
| 典型的な誤り方 | 読めない字を落とす・化ける | 形の似た別の字に読む | 紙に無い字を書き足す・もっともらしい値に直す |
| 誤りの見つけやすさ | 比較的見つけやすい | 字単位で見つけられる | 文として自然なため見落としやすい |
表の最下行が、運用で効いてくる違いです。生成AIの誤りは、ハルシネーションと呼ばれる「もっともらしい誤り」の形で出ることがあります。GPT4VやGeminiなどのモデルのOCR能力を29のデータセットで評価した研究 OCRBench も、多言語の文字や手書き文字、意味を持たない文字列の読み取りに弱みがあると報告しています(OCRBench)。請求番号や口座番号は、まさに意味を持たない文字列です。ハルシネーションの起き方と抑え方はAIのハルシネーションで整理しています。
つまり、どの方式が一番正確かを先に決めるより、自社の帳票でどう間違えるかを確かめてから選ぶほうが確実です。
AI-OCRで読める帳票と苦手なもの
方式の違いを押さえたところで、次は自社の帳票が読めるかどうかの判断材料を整理します。
定型帳票と非定型帳票
帳票は大きく2つに分かれます。定型帳票は、自社の申込書や社内の点検表のように様式が決まっているものです。非定型帳票は、取引先ごとに様式が違う請求書や納品書のように、同じ項目が毎回違う位置にあるものを指します。
製品の分類もこれに沿っていて、上位の解説記事では「汎用×定型」「汎用×非定型」「業務特化×非定型」の3つに分ける整理が定番です。業務特化型は、請求書や名刺など帳票の種類を絞る代わりに、様式の登録なしで項目を取り出せるものを指します。自社で読みたい帳票が定型中心か非定型中心かで、候補の製品が変わります。
手書き・FAX・スマホで撮った帳票
手書きは、AI-OCRと従来のOCRの差が大きく出る領域です。ただし、読みやすさは記入欄の設計に大きく左右されます。1文字ずつ枠がある欄と、自由に書く欄とでは、同じ製品でも結果が変わることがあります。
FAXやスマホで撮った画像は、解像度の低さ・傾き・影が重なります。Tesseract の公式ドキュメントは、少なくとも300dpiの画像で最もよく動くとし、傾いたページは行の切り出しの質が大きく下がるため、文字の行が水平になるよう回転させるよう勧めています(Tesseract: Improving the quality of the output)。
AI-OCRが苦手なもの
製品を問わず、次のものは精度が落ちやすくなります。
- 罫線や下線と重なった文字:線を文字の一部として読んでしまうことがあります。次の章の実測で、影響の大きさを示します
- 低い解像度・傾き・ぼけ:FAXや、斜めから撮った写真が該当します
- 形の似た文字:「0」と「O」、「1」と「l」のほか、日本語と中国語で形の近い漢字の取り違えも起きます
- 縦書き・印影に重なった文字・取り消し線:製品によって対応の差が大きい部分です
- 桁区切りのカンマと小数点:金額の「,」が「.」に化けると、別の数になります
この中で見落とされやすいのが、形の似た文字の取り違えや、カンマと小数点の混同のような「読めているように見える誤り」です。
AI-OCRの精度は測り方で変わる。ローカルOCR3種で請求書を読んだ実測
苦手なものが分かっても、自社の帳票でどの程度の精度になるかは、実際に読ませて測らないと分かりません。ここでは、測り方そのものを実測で示します。
文字正解率と項目正解率の違い
精度には、少なくとも2つの数え方があります。
- 文字正解率:正解の文字列と比べて、何文字合っているかの割合です。1文字の挿入・削除・置換を1回と数えた最小回数(編集距離)を、正解の文字数で割って1から引きます
- 項目正解率:請求番号・日付・金額といった項目のうち、1文字も違わずに読めた項目の割合です
業務で効くのは項目正解率のほうです。金額の1桁が違えば、文字正解率が99%でもその請求書は手で直す必要があります。
次のコードは、今回の実測で正解率を計算した部分です。Python の標準ライブラリだけで動きます。
import json, unicodedata

def norm(s):
    # 全角と半角をそろえ(NFKC)、空白と改行を取り除く
    return "".join(unicodedata.normalize("NFKC", s).split())

def edit_distance(a, b):
    # 1文字の挿入・削除・置換を1回と数えたときの最小回数
    prev = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        cur = [i]
        for j, cb in enumerate(b, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (ca != cb)))
        prev = cur
    return prev[-1]

truth = json.load(open("truth.json"))
gt = norm(truth["ground_truth"])
ocr = norm(open("out_B_degraded_Apple.txt").read())

char_acc = 1 - edit_distance(ocr, gt) / len(gt)
hits = [f for f in truth["fields"] if norm(f) in ocr]
print(f"文字正解率: {char_acc:.1%}")
print(f"項目一致: {len(hits)}/{len(truth['fields'])}")
print("読めなかった項目:", [f for f in truth["fields"] if f not in hits])
劣化させた請求書を Apple Vision で読んだ結果に対する出力は、次のとおりでした。
文字正解率: 76.7%
項目一致: 7/12
読めなかった項目: ['INV-2026-0918', '2026年9月18日', '検査治具(型式KJ-204)', '12個', '18,400円']
サンプル請求書4枚を3つのOCRで読んだ結果
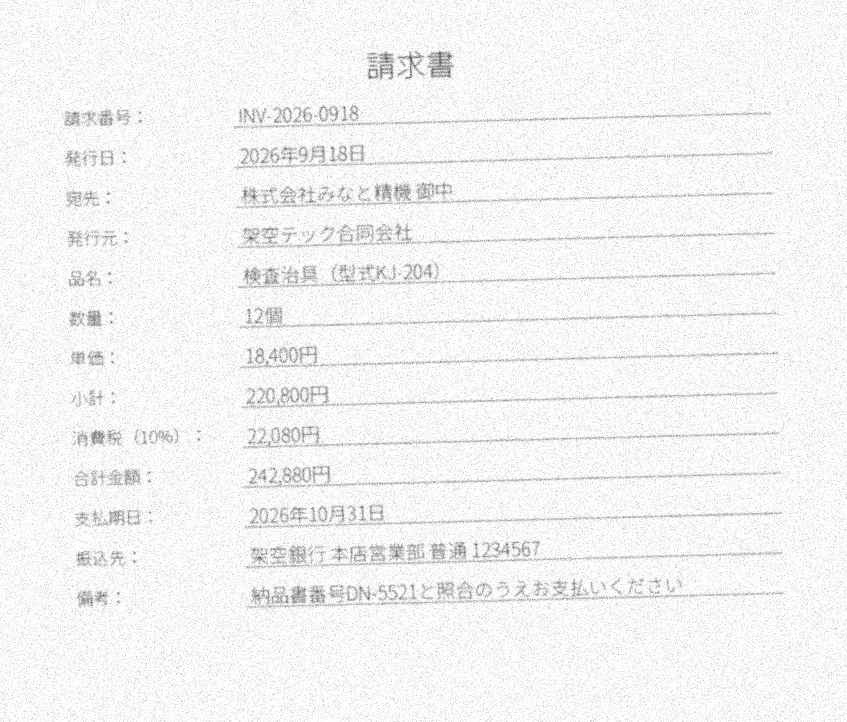
架空の請求書(14行・空白を除いて202文字・読み取りたい項目12個)を画像として作り、条件を変えた4枚を用意しました。社名や番号はすべて架空です。
- 罫線あり:記入欄に下線がある、きれいな画像(A4幅を200dpiで描いた相当)
- 罫線なし:1から下線だけを消した画像
- 劣化:1を半分の解像度に落とし、1.5度傾け、ぼかしとノイズを加えてJPEGの画質40で保存した画像。FAXや斜めに撮った写真を想定しています
- 手書き風:記入欄の値だけを、ペン字風のフォント(Klee)にした画像。実際の手書きではありません
読ませたのは、クラウドに画像を送らずに手元のパソコンで動く3つのOCRです。
- Tesseract 5.5.3:日本語の高速版モデル tessdata_fast を使いました
- RapidOCR 3.9.2:PaddleOCR の PP-OCRv5 mobile モデルを、ONNX形式で動かすライブラリです。PP-OCRv5 は、日本語を含む5種類の文字に対応すると公式に記載されています(PP-OCRv5)
- Apple Vision:macOS に標準で入っている文字認識で、精度優先の設定と、日本語と英語の指定で動かしました
| 画像 | Tesseract 5.5.3 | RapidOCR(PP-OCRv5) | Apple Vision |
|---|---|---|---|
| 1. 罫線あり | 57.9%(2/12) | 99.0%(11/12) | 100.0%(12/12) |
| 2. 罫線なし | 96.0%(9/12) | 99.5%(12/12) | 100.0%(12/12) |
| 3. 劣化 | 34.2%(2/12) | 85.6%(6/12) | 76.7%(7/12) |
| 4. 手書き風 | 34.7%(1/12) | 97.0%(12/12) | 93.6%(12/12) |
数値は文字正解率、括弧内は12項目のうち完全に一致した項目の数です。測定条件は Apple M1 Pro・macOS 14.6.1・Python 3.11.6・onnxruntime 1.30.0・pyobjc-framework-Vision 12.2.2、実行日は2026年9月23日で、各条件1回ずつの結果です。どのエンジンも、1枚の処理は1秒未満でした。
この表から読み取れるのは、同じエンジンでも画像の条件で数字が大きく動くことと、文字正解率と項目一致数が同じ順番に並ばないことです。架空の請求書1種類での測定なので、エンジンの優劣を一般化する材料にはなりません。
実測から分かる3つのこと
1つめは、罫線だけで精度が大きく変わることです。Tesseract は罫線ありの画像で57.9%でしたが、下線を消しただけで96.0%に上がりました。罫線ありの出力には、下線を読んだとみられる「0 0 0 0」のような文字の並びが混ざっていました。帳票の前処理(罫線の除去や読取範囲の指定)が効く理由がここにあります。
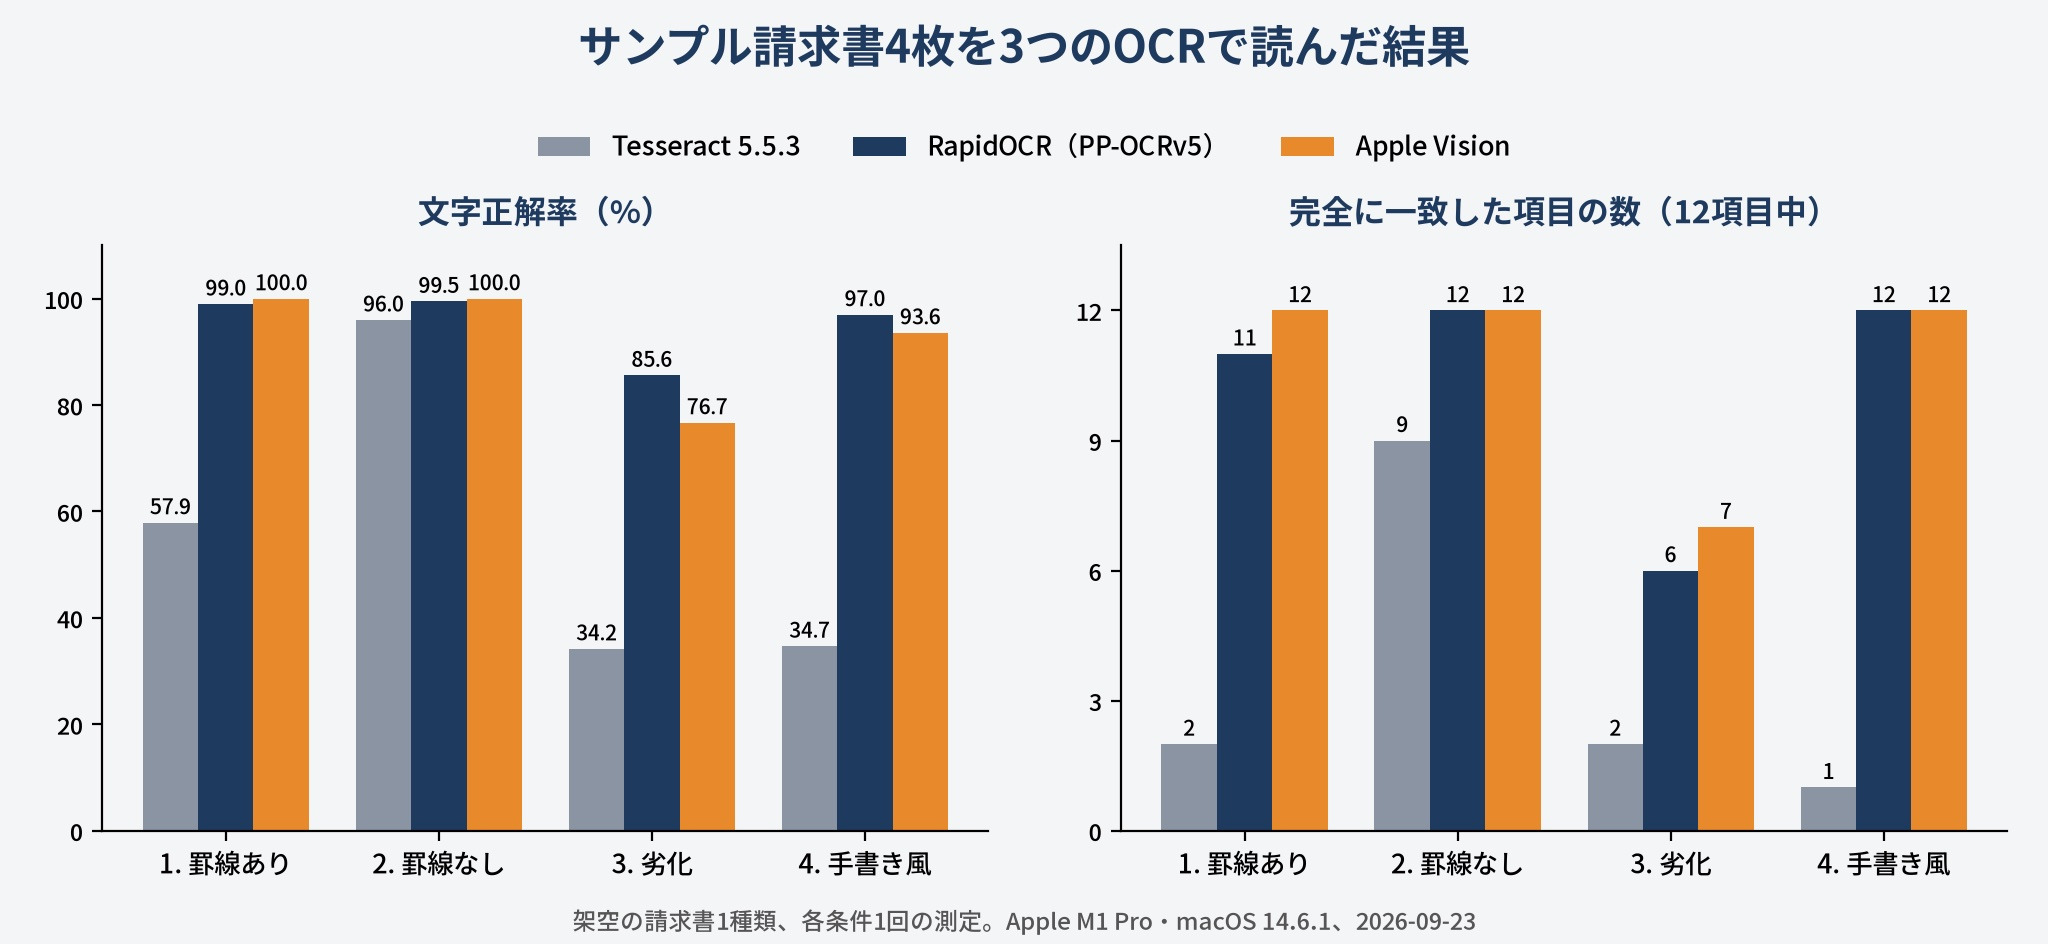
2つめは、読めているように見える誤りがあることです。罫線なしの Tesseract は「18,400円」を「18.400円」と読みました。カンマがピリオドに化けると、18,400円が18.4円という別の数になります。劣化画像の Apple Vision は「2026年9月18日」を「2026年9月13日」と読みました。日付としては正しい形なので、目で見て気づくのは難しい誤りです。RapidOCR は「検査」の「査」を中国語の簡体字の「查」と読み、罫線ありの画像で唯一落とした項目がこれでした。
3つめは、読み順が文字正解率を下げることです。手書き風の画像で Apple Vision は12項目すべてを正しく読みましたが、文字正解率は93.6%にとどまりました。出力を見ると、「数量:」と「12個」の行の順番や、「備考:」の位置が入れ替わっていました。文字は合っていても、並び方が違えば文字正解率は下がります。帳票のデータ化では、文字正解率より項目単位の一致で判断するほうが業務の実感に合います。
今回は、ダウンロード容量の上限(1GB)を超えるため、生成AI・VLM型のモデルは動かしていません。VLM型を試す場合も、同じ正解データと数え方で比べられます。
ベンダーが公表する「精度」の読み方
製品ページの精度を見るときは、次の3点を確認します。
- 文字単位か項目単位か:同じ帳票でも、項目単位のほうが低く出ます
- どの帳票で測ったか:活字の定型帳票か、手書きの非定型帳票かで数字は変わります
- 分母は何か:読み取りに失敗して結果を返さなかった帳票を、分母に含めているかどうかです
公表値は製品を絞り込む目安にとどめ、最後は自社の帳票で測った数字で決めるのが安全です。
AI-OCRの導入を5つのステップで進める
ここまでで、精度は自社の帳票で測らないと分からないことを見てきました。その測定を組み込んだ導入の手順は、次の5つです。
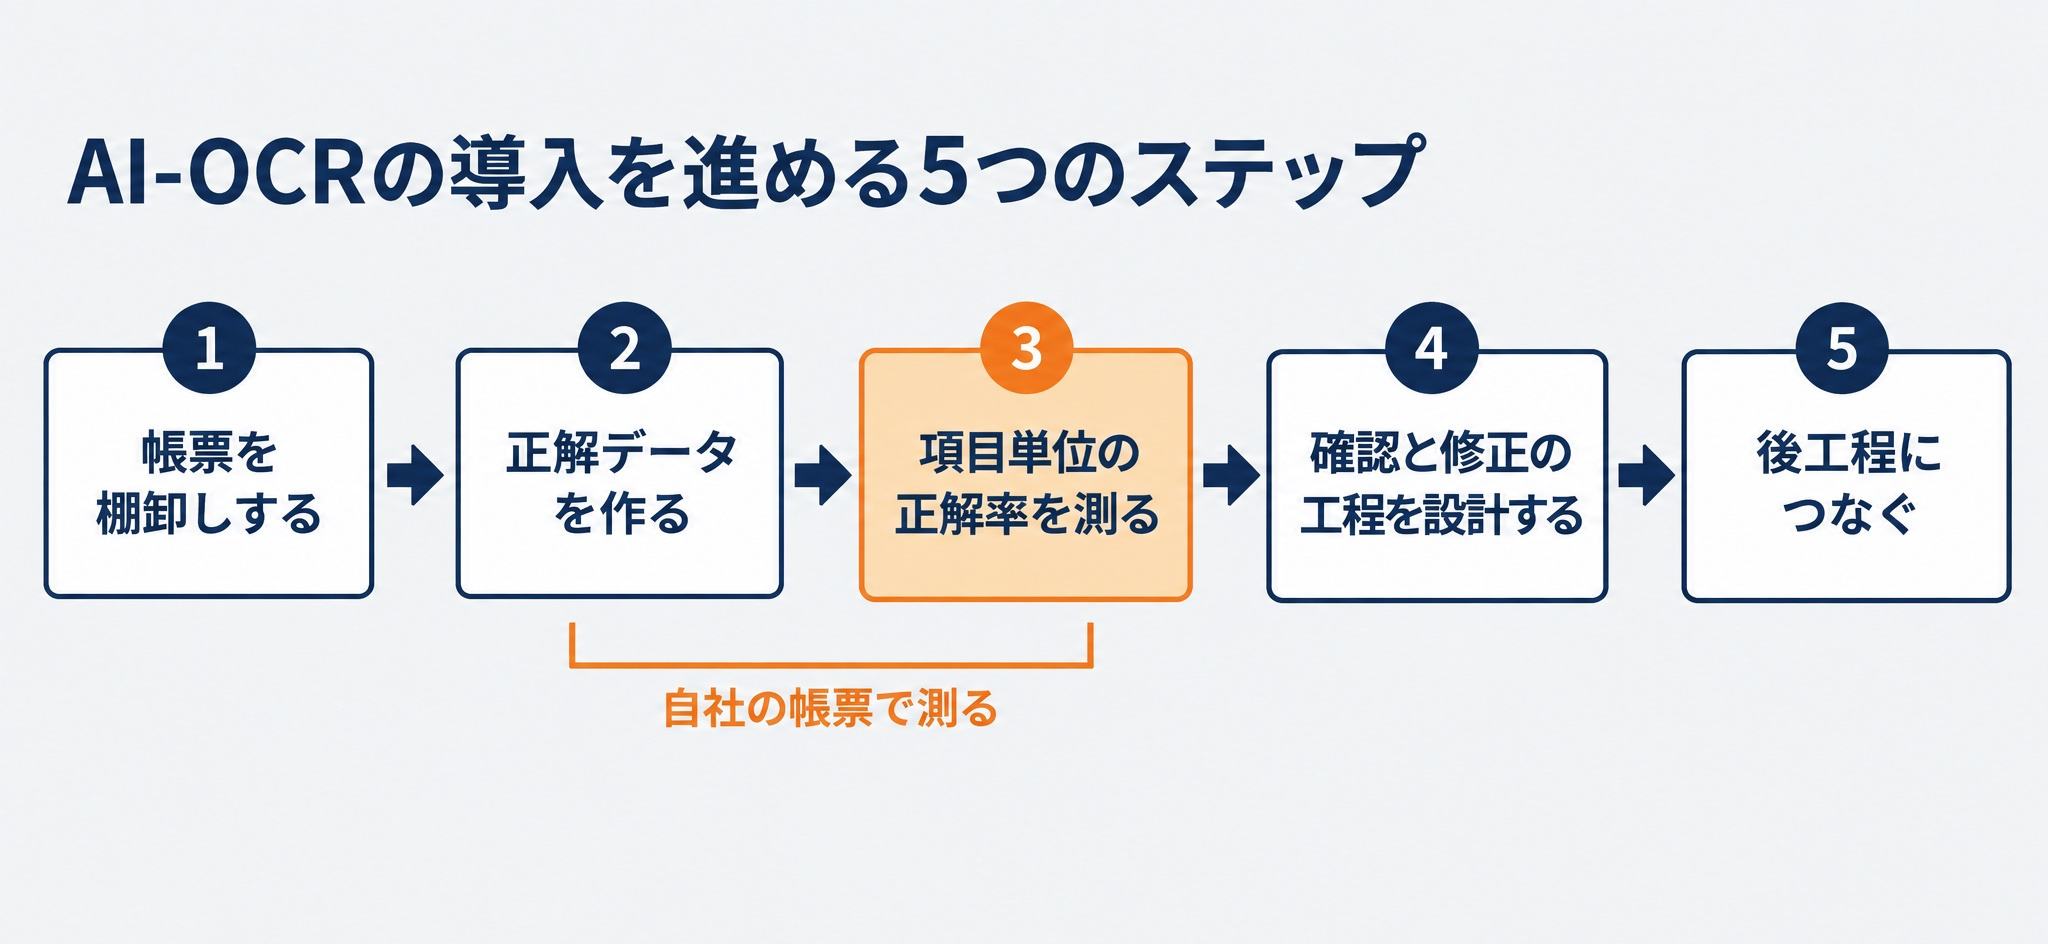
1. 対象の帳票を棚卸しする
業務の担当部署が、データ化したい帳票を一覧にします。帳票の種類、月あたりの枚数、手書きの割合、FAXや写真で届く割合、読み取りたい項目を書き出します。枚数の多い帳票から順に並べると、効果の大きい対象が見えてきます。
2. 正解データを作る
帳票の種類ごとに実物を集め、人が入力した正解を用意します。正解データには、手書き、FAX、かすれたものなど、現場で実際に届く崩れた帳票も混ぜておきます。きれいな見本だけで測ると、本番で数字が下がるためです。個人情報を含む帳票は、試験に使ってよい範囲を先に社内で確認します。
3. トライアルで項目単位の正解率を測る
候補の製品やモデルに同じ正解データを読ませ、項目ごとの正解率を出します。金額・日付・番号など、誤ると困る項目は別に集計します。AIの試行全般の進め方はAIのPoCで、目的と合格ラインの決め方はAIの要件定義で解説しています。
4. 確認と修正の工程を設計する
AI-OCRの読み取り結果は、100%は合いません。そこで、人がどこを見るかを先に決めます。
- 小計と消費税を足して合計金額と一致するかを検算する
- 取引先名や品番を、社内のマスタと照合する
- 製品が出す読み取りの確信度が低い項目だけを、人が確認する
実測で見た「18.400円」のような誤りは、検算の仕組みがあれば機械的に止められます。
5. 読み取ったデータを後工程につなぐ
CSVで出して終わりにせず、会計システムや基幹システムへの登録までをつなぎます。RPA(パソコン操作を自動で代行するツール)や各システムのAPIで連携します。請求書などの国税関係書類を電子データで保存する場合は、電子帳簿保存法の要件への対応も確認します。データ化した文書を社内の生成AIに参照させる使い方は、RAGで社内データを活用する方法で紹介しています。
ここまでAI-OCRの方式と導入の手順について解説しましたが、「自社の帳票でAI-OCRが本当に使えるのか、製品を決める前に測って確かめたい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、帳票の棚卸しと正解データの作成から、項目単位での精度評価までを一緒に設計できます。ただ読み取るだけでなく、生成AIによる項目の整理や検算、社内システムへの登録まで含めて開発できるため、自社の帳票と業務に合わせたデータ化の仕組みを作れます。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
AI-OCRの比較のしかた。料金体系と無料で試せる範囲
導入手順のステップ3で読ませる候補は、どう絞ればよいのでしょうか?ここでは特定の製品を推奨せず、比べる基準と、公式ページで確認できた料金の仕組みを整理します。
AI-OCRを比べる5つの基準
- 読みたい帳票に対応しているか:定型か非定型か、手書きやFAXを含むか、日本語に対応しているか
- 自社の帳票で測った項目正解率:公表値ではなく、ステップ2の正解データで測った数字
- データの置き場所:クラウド、自治体向けのLGWAN、自社サーバー(オンプレミス)、手元のパソコンのどこで処理するか。外部に出せない帳票が多い場合は、ローカルAIでできることと限界も判断材料になります
- 料金体系:月の枚数と項目数で、どの課金の型が安くなるか
- 後工程との連携:CSVやAPIの出力、RPAや会計システムとの接続
日本語対応は見落とされやすい基準です。例えば Amazon Textract のFAQは、対応言語を英語・スペイン語・イタリア語・ポルトガル語・フランス語・ドイツ語とし、手書きや請求書の処理は英語のみとしています(Amazon Textract FAQ)。
AI-OCRの料金体系は3つの型に分かれる
AI-OCRの料金は、製品ごとに数字を比べる前に、課金の型をそろえて見る必要があります。公式ページで確認できた例を、型ごとに並べます(2026年9月時点)。
| 課金の型 | 例(公式ページの記載) | 向いている使い方 |
|---|---|---|
| 月額+無料枠+従量 | DX Suite:Liteプラン月額40,000円〜(初期費用0円・月の無料枠18,000円分)、Standardプラン月額100,000円〜(初期費用200,000円)。無料枠を超えた読み取りは従量課金。税抜(DX Suite 料金プラン) | 月ごとの枚数が変動する業務 |
| 年額の利用枠 | SmartRead:クラウド版スモールプラン年額36万円(月額3万円相当・初期費用0円)。処理可能枚数は定型文書で10項目を読む例で1.8万枚前後。税抜(SmartRead 料金) | 年間の枚数が見込める業務 |
| クラウドAPIの従量 | Google Cloud Document AI:Enterprise Document OCR は料金表の最初の区分が無料と表示され、それを超えると区分ごとの単価で課金(Document AI pricing)。Azure AI Document Intelligence:無料プラン(F0)は月500ページまで(Azure AI Document Intelligence の価格) | 自社システムに組み込んで開発する場合 |
この表から分かるのは、同じ「月3万円前後」でも、枠が月ごとか年ごとか、1枚単位か1項目単位かで、実際の負担が変わることです。1枚あたりの読み取り項目が多い帳票では、項目単位の課金が割高になりやすくなります。ステップ1の棚卸しで出した枚数と項目数を当てはめて試算すると、比較がしやすくなります。
AI-OCRを無料で試せる範囲
「AI-OCR 無料」で探すと、無料で使えるものは次の3種類に分かれます。
- 製品の無償トライアル:SmartRead は処理可能枚数500枚までの無償トライアルを用意しています(SmartRead 無料トライアル)。一方、DX Suite の1ヶ月トライアルプランは基本料金40,000円〜の有償です。「トライアル」の言葉だけで無料と判断しないよう注意が必要です
- クラウドAPIの無料枠:上の表のとおり、Azure は月500ページまでの無料プランがあり、Google Cloud も料金表の最初の区分を無料と表示しています。開発者がAPIを呼べることが前提です
- オープンソースのOCR:今回の実測で使った Tesseract と PaddleOCR は、どちらも Apache-2.0 ライセンスで公開されています。ライセンス料はかかりませんが、帳票ごとの項目の切り出しや確認画面は自分たちで作る必要があります
無料の範囲で試すときも、ステップ2の正解データを使えば、有料製品と同じ物差しで比べられます。
AI-OCRの導入事例(公表されたもの)
最後に、企業や自治体が公表しているAI-OCRの導入事例を3つ紹介します。総務省の令和7年度調査でも、人口3.9万人の自治体がAI-OCRを使い、税収納業務の消込作業で年間1,200時間を削減(60%減)した例が挙がっています(総務省 R7年度版 概要版)。
茨城県大子町。手書きのタクシー券の入力
- 課題:65歳以上の住民向けタクシー利用助成事業で、運転手が手書きで区間と料金を記入したタクシー券が月平均約1,100枚届き、職員1人がExcelに手入力していた
- 対象帳票:手書きのタクシー券(年間1万枚超)
- 行ったこと:LGWAN対応のAI-OCR(NTT東日本「AIよみと~る」)でスキャン画像を読み取り、CSVに変換
- 成果:丸4日かかっていた処理の作業時間が約3割削減され、事業者への支払いが早まった
多摩信用金庫。年間5万枚以上の手書き帳票
- 課題:各店舗から届く振込依頼書や口座振替依頼書などの手書き帳票を、事務職員8人で手入力していた。入力システムの老朽化で後継を探す必要があった
- 対象帳票:年間5万枚以上の手書き帳票。導入後はキャッシュカード発行依頼書などカード関連帳票が中心
- 行ったこと:約4カ月のPoCで精度と業務の流れを検証したうえで、AI-OCR「DX Suite」とRPAを導入。閉域網での通信と、処理後にクラウド上のデータを自動で削除する仕組みを組んだ
- 成果:毎日200枚程度の帳票を職員4人で約1時間かけていた作業が、職員2人で同じ時間内に終わるようになった
阪急阪神ホールディングス。自治体ごとに書式が違う課税台帳
- 課題:グループ各社が持つ固定資産について、各自治体から届く名寄帳や課税明細書を見て、評価額・課税標準額・面積などをシステムに登録していた。書式が自治体ごとに違い、決算期と重なる
- 対象帳票:固定資産税課税台帳(名寄帳・課税明細書)
- 行ったこと:2026年度から、グループ共通経理システムの固定資産税サブシステムの補助ツールとして「鈴与のQuick AIOCR」を導入
- 成果:入力と加工の作業の軽減と、入力ミスの低減を目的としている。削減量の数値は公表されていない
3つに共通するのは、枚数が多く、様式や手書きの崩れがある帳票を対象に選んでいる点です。多摩信用金庫の例のように、本番の業務でPoCを行って精度と業務の流れを確かめてから広げる進め方は、前述の5ステップとも重なります。
AI-OCRの導入・開発は「リベルクラフト」へ
ここまでの要点をまとめます。
- AI-OCRとは、AIで文字を読み取り、帳票の項目をデータにする技術です。従来のOCRとの違いは、ルールで照合するか、データから学ぶかにあります
- 深層学習型と生成AI・VLM型は誤り方が違います。生成AI型は、紙に無い字をもっともらしく書くことがあります
- 罫線・解像度・傾き・形の似た文字・カンマと小数点が、精度を落とす典型です
- 実測では、罫線を消すだけで Tesseract の文字正解率が57.9%から96.0%に上がりました。精度は文字単位ではなく項目単位で判断します
- 導入は、帳票の棚卸し→正解データ→項目単位の測定→確認工程の設計→後工程との連携の順で進めます
- 製品は、課金の型と無料で試せる範囲をそろえてから比べます
ここまで読んで、測り方は分かったが、自社の帳票で何から始めるかまでは決めきれない、と感じた方も多いのではないでしょうか?
リベルクラフトでは、戦略・構想の立案、AIシステムのものづくり、社内人材を育てる教育の3軸で、企業のAI・データ活用を支援しています。AI活用コンサルティング、AI開発の受託、社内ナレッジ基盤の構築まで、要件定義から本番運用までを一貫してお受けしています。
AI-OCRについては、帳票の棚卸しと正解データづくりから入り、製品の比較評価、読み取り後の検算や社内システムへの登録まで含めた仕組みを開発します。次のような状況の方に適しています。
- 自社の手書き帳票やFAXで、AI-OCRが使えるかをまず確かめたい
- 生成AIで読む方式と既存のAI-OCRを、同じ物差しで比べたい
- 読み取ったデータを、社内システムや生成AIの検索まで活用したい
構想段階のご相談でも問題ありません。まずはお気軽にお問い合わせください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。