データクレンジングとは。汚れの直し方・名寄せの手順・ツールの選び方を解説
「顧客データを集計したら、同じ取引先が別々の会社として数えられていた」という経験をお持ちの方も多いでしょう。「(株)」と「株式会社」、全角と半角、部署ごとに違う電話番号。1件ずつ見れば小さな違いでも、集計やAIに渡した瞬間に結果を狂わせます。
しかし、「AIやBIを入れる前にデータを整えるように」と言われても、何をどこまで直せばよいのかは意外と整理されていません。名寄せとの違いや、Excelで足りるのかという判断も、現場で迷いやすいところです。
そこで本記事では、
- データクレンジングとは何か、名寄せ・前処理との違い
- よくある6つの汚れと、それぞれの直し方
- データクレンジングの手順とチェックリスト
- 名寄せの手順と、ルールの選び方で結果がどう変わるか
- ツールの選び方と、生成AIを使うときの注意点
についてわかりやすく解説します。架空の顧客マスタをPythonで実際に直した結果も載せています。社内データの整備を任されたDX推進担当の方は、ぜひ最後までご覧ください。
「AI活用の前に、社内のデータをどう整えればよいか相談したい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
データクレンジングとは。名寄せ・前処理・データ整備との違い
データクレンジングの意味と、AI活用の前に必要な理由
データクレンジングとは、データに含まれる誤り・重複・欠損・表記ゆれ・形式の不統一を見つけて直し、分析や業務にそのまま使える状態に整える作業です。「データクリーニング」とも呼ばれます。英語の cleansing は「洗浄」の意味で、汚れたデータ(ダーティデータ)を洗う作業だと捉えると分かりやすいでしょう。
データクレンジングが必要になる理由は、コンピューターが「(株)ABC」と「株式会社ABC」を同じ会社だと判断できないからです。人が見れば同じだと分かる違いでも、集計では別の行として数えられます。売上の集計がずれる、同じ顧客に案内が2通届く、AIが古い情報をもとに回答する、といった問題の多くはここから始まります。
AI活用が広がるほど、この問題は大きくなります。IPA(情報処理推進機構)の「DX動向2026」によると、AI活用に向けた学習データの整備状況は、「整備しておりAIに活用している」が7.0%にとどまりました。「整備しているが十分ではない」が28.4%、「必要性は認識しているができていない」が27.6%です。データ整備・管理・流通の課題でも、「データの標準化が難しい」が36.8%で2番目に多く挙がっています(IPA「DX動向2026」)。AIを使う段階の手前で、データを揃える作業が止まっている企業が多いということです。
社内のどこにどんなデータがあるかを洗い出す工程は、クレンジングのさらに前に来ます。棚卸しの進め方は、以下の記事で解説しています。
参照記事:AIによるデータ活用とは?分析との違いやデータ活用方法の選び方を解説
名寄せ・データクリーニング・前処理・データ整備との違い
データクレンジングと似た言葉は多く、使い分けが曖昧なまま話が進みがちです。対象とやることで整理すると、次のようになります。
| 用語 | 対象 | やること | 順番 |
|---|---|---|---|
| データクレンジング | 1件ずつのレコードの中身 | 誤り・表記ゆれ・欠損・形式の不統一を直す | 名寄せより先 |
| データクリーニング | 同上 | データクレンジングとほぼ同じ意味で使われる | – |
| 名寄せ | 複数のレコードの関係 | 同じ会社・同じ人物の重複レコードを見つけて1件にまとめる | クレンジングの後 |
| 前処理 | 分析・機械学習に渡すデータ | クレンジングに加え、集計・結合・特徴量の作成など分析向けの加工をする | 分析の直前 |
| データ整備 | 社内データ全体 | 棚卸し・クレンジング・名寄せ・定義の統一・運用ルールづくりを含む総称 | 全体を通して |
この表から分かるのは、データクレンジングは1件の中身を正す作業、名寄せは複数のレコードを1件にまとめる作業という役割の違いです。表記を揃えないまま名寄せをすると、「(株)」と「株式会社」の違いだけで同じ会社を見逃します。そのため、クレンジングを先に行い、名寄せを後に行う順番が基本になります。
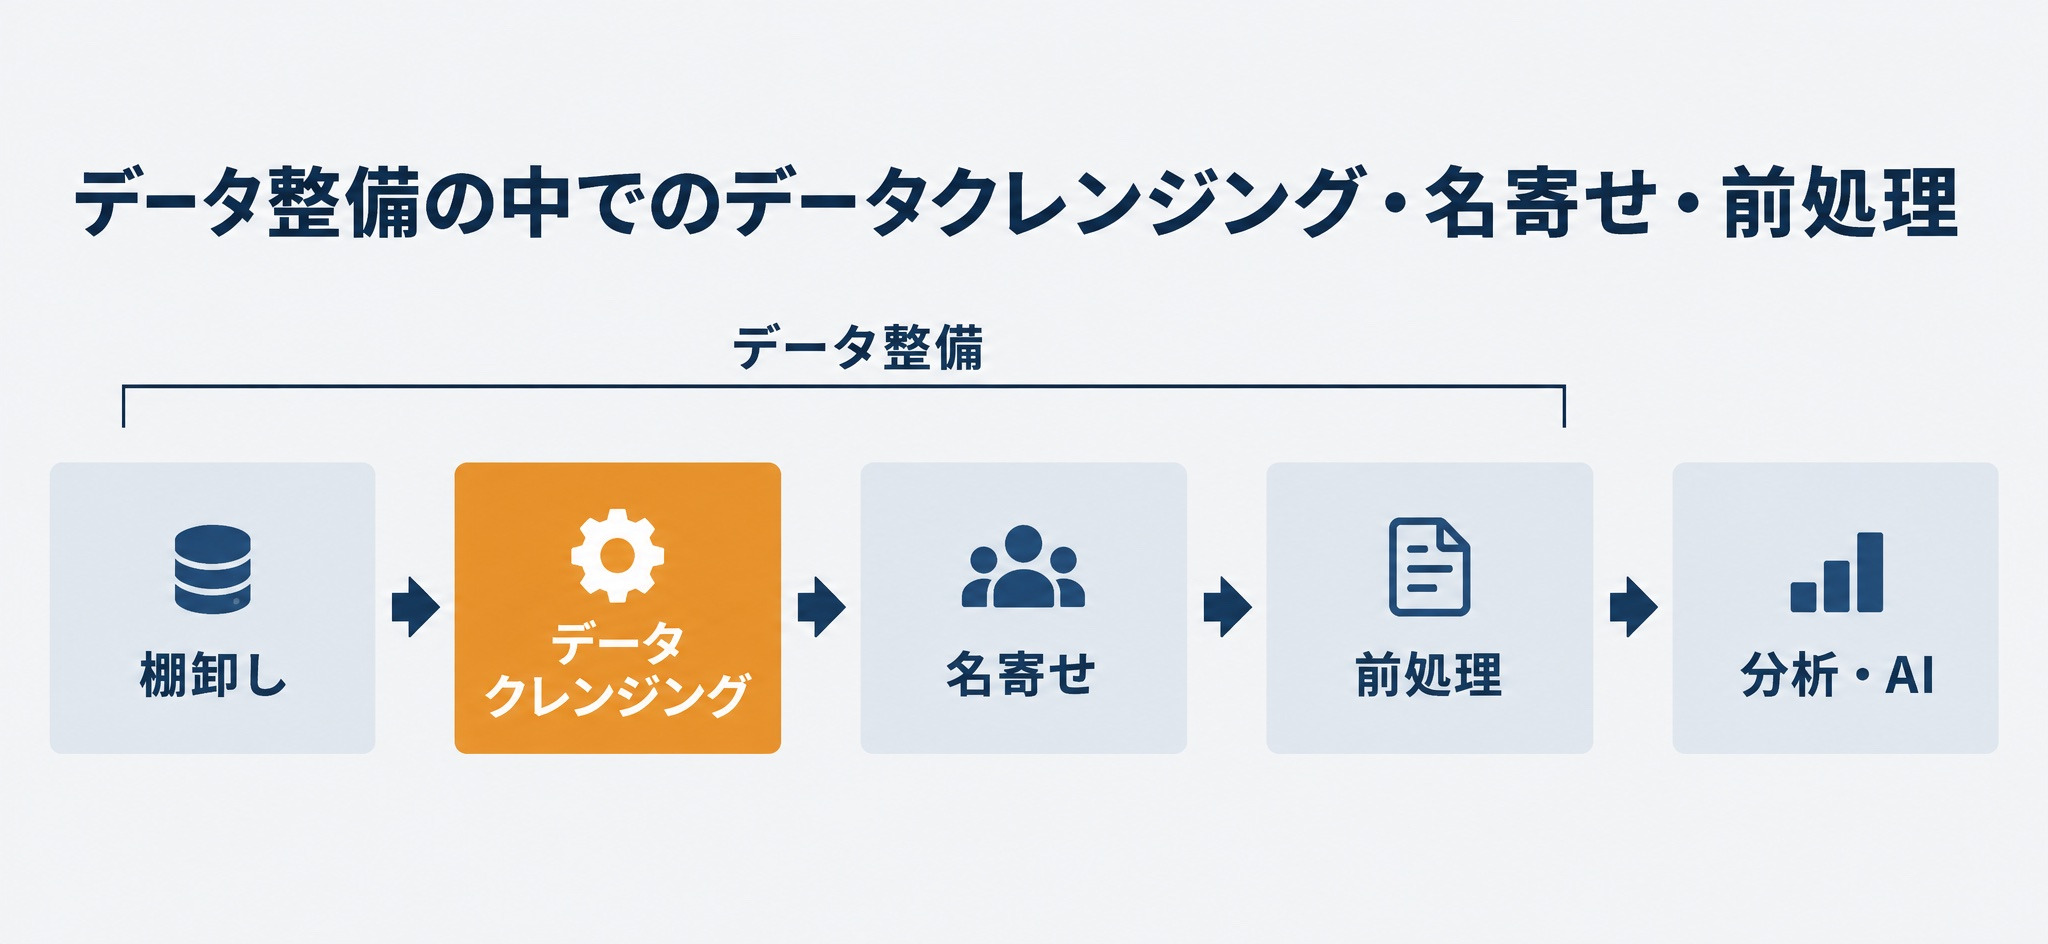
データ活用が進まない原因のうち、データの品質に関わるものは全体の一部です。組織や目的の課題も含めた全体像は、以下の記事で整理しています。
参照記事:データ活用の現状と課題を解説。活用を進める上でのポイントと成功事例も紹介
データクレンジングで直す6つの汚れと直し方
データクレンジングが何を直す作業かが分かったところで、次に直す対象である汚れの種類を見ていきます。業務データでよく出会う汚れは、次の6つに整理できます。
| 汚れ | 例 | 直し方 |
|---|---|---|
| 表記ゆれ | 「(株)」「㈱」「株式会社」、「東京」と「東京都」 | 正とする表記を決め、変換ルールで揃える |
| 全角半角 | 「ABC」と「ABC」、「03」と「03」 | Unicodeの正規化で一括して揃える |
| 重複 | 同じ行を2回取り込んだ、同じ会社が別の部署から登録された | 完全に同じ行は削除し、表記だけ違う重複は名寄せで扱う |
| 欠損 | 都道府県や従業員数が空欄 | 空欄の理由を確かめ、補える値は他のレコードや外部データで補う |
| 外れ値 | 従業員数が「30000000」 | 消さずに印を付け、元の資料で確かめる |
| 型の不一致 | 「1,200」「約300名」「2024年4月1日」「2024/4/1」 | 数値・日付の型に変換し、変換できない値を洗い出す |
表のとおり、直し方は汚れの種類によって違います。ここからは、判断に迷いやすい点を3つに分けて説明します。
表記ゆれと全角半角は、ルールを決めて機械で揃える
表記ゆれは、人が1件ずつ直すと作業者によって結果が変わります。先に「法人格は『株式会社』に統一する」「都道府県は『都』『府』『県』まで書く」のような正の表記を決め、変換ルールとして機械で当てるのが基本です。
全角と半角の違いは、Unicodeの正規化で一括して揃えられます。PythonではNFKCという正規化を使うと、全角の英数字は半角に、「㈱」は「(株)」に変換されます(Python公式ドキュメント unicodedata)。半角カタカナも全角に揃います。ただし、NFKCは「①」を「1」に、全角の波ダッシュ「~」を半角の「~」に変えるなど、意味が変わりうる変換も含みます。どの列に正規化を当てるかは、列ごとに決めます。
重複と欠損は、消す前に理由を確かめる
すべての列が同じ行は、取り込みの二重実行などで生まれた完全重複です。これは削除して問題ありません。一方、社名の表記だけが違う重複は、ここでは消さずに残し、後の名寄せで扱います。
欠損は、空欄になっている理由によって扱いが変わります。入力されなかっただけなのか、該当する値が存在しないのか。例えば「従業員数が空欄」の顧客を平均値で埋めると、分析上はきれいに見えても、実在しない数字を作ることになります。補える値は同じ会社の他のレコードや外部のデータから補い、補えない値は空欄のまま残すほうが、後で判断を誤りません。
外れ値と型の不一致は、消さずに印を付ける
従業員数が「30000000」のように桁違いの値は、入力ミスの可能性が高い外れ値です。ただし、本当に大きな値である可能性も残ります。削除するのではなく「要確認」の印を付け、元の資料で確かめられるようにしておきます。
型の不一致は、数値や日付の列に文字が混じっている状態です。「1,200」「約300名」「300人」のままでは、合計も平均も計算できません。数値だけを取り出して数値型に変換し、変換できなかった値を一覧にして確認します。
架空の顧客マスタをpandasでクレンジングした結果
ここまでの直し方を、実際のデータで確かめます。Pythonのデータ処理ライブラリpandasを使い、架空の顧客マスタを直しました。データは乱数(シード193で固定)で作った生成データで、実在の企業とは関係ありません。242社の正しいデータをもとに、次の汚れを混ぜて335件にしています。
- 70社を2回目、15社を3回目として、表記を崩して追加登録(「(株)」「㈱」、法人格の省略、末尾の空白、全角数字の電話番号、部署の直通番号、「東京」のような都道府県の省略、空欄)
- 一部の社名に変換ミス(「精機」を「精器」、「工業」を「興業」)
- 同じ社名で所在地も電話番号も違う、別の会社を2社
- 同じ行の二重取り込みを8件、従業員数の桁の打ち間違い(30000000)を4件
生成したデータの先頭6行は次のとおりです。
 顧客ID       会社名 都道府県         電話番号 従業員数        登録日
C0001  有限会社北陸電機  福岡県 09-2742-6477   12 2024-11-06
C0002 株式会社 三栄産業  東京都   0573339022   12  2024/7/28
C0003  有限会社光陽電機 神奈川県 09-1735-5575   80 2024-12-21
C0004     ㈱日新工業  NaN 09-9829-8323 約80名 2024年11月3日
C0005  株式会社北斗化成  大阪府 09-6110-5672   35 2024-10-08
C0006  株式会社北斗運輸 神奈川県 09-5689-4935  150 2024-11-13
このデータに対して、現状把握、完全重複の削除、表記ゆれと全角半角の正規化、型の変換、外れ値の印付けを順に行います。
import re
import unicodedata
import pandas as pd

raw = pd.read_csv("customers_raw.csv", dtype=str)
df = raw.drop(columns="true_id")            # 正解ラベルは評価のときだけ使う
cols = ["会社名", "都道府県", "電話番号", "従業員数", "登録日"]

# ① 現状把握(プロファイリング)
print("件数:", len(df))
print("欠損:", df[cols].isna().sum().to_dict())
print("社名の種類:", df["会社名"].nunique())

# ② 完全重複を落とす(顧客ID以外がすべて同じ行)
df = df.drop_duplicates(subset=cols)
print("完全重複を削除した後:", len(df))

# ③ 表記ゆれ・全角半角を直す
def norm_name(s):
    s = unicodedata.normalize("NFKC", s)     # 全角英数→半角、㈱→(株)
    s = re.sub(r"\s+", "", s)
    return s.replace("(株)", "株式会社").replace("(有)", "有限会社")

df["会社名"] = df["会社名"].map(norm_name)
df["電話番号"] = df["電話番号"].map(lambda s: re.sub(r"\D", "", unicodedata.normalize("NFKC", s)))
fix_pref = {"東京": "東京都", "大阪": "大阪府"}
df["都道府県"] = df["都道府県"].map(lambda p: p if pd.isna(p) or p[-1] in "都府県" else fix_pref.get(p, p + "県"))
print("社名の種類(正規化後):", df["会社名"].nunique())

# ④ 型の不一致を直す(文字列→数値・日付)
df["従業員数"] = pd.to_numeric(df["従業員数"].str.replace(r"[^\d]", "", regex=True), errors="coerce")
df["登録日"] = pd.to_datetime(df["登録日"].str.replace(r"[年月]", "-", regex=True).str.replace("日", "")
                              .str.replace("/", "-"), format="%Y-%m-%d")

# ⑤ 外れ値は消さずに印を付け、値を空にする
df["要確認_従業員数"] = df["従業員数"] > 100000
print("外れ値として印を付けた件数:", int(df["要確認_従業員数"].sum()))
df.loc[df["要確認_従業員数"], "従業員数"] = None
print("欠損(型変換・外れ値処理の後):", df[cols].isna().sum().to_dict())
df.to_csv("customers_clean.csv", index=False)
実行結果は次のとおりです。
件数: 335
欠損: {'会社名': 0, '都道府県': 30, '電話番号': 0, '従業員数': 20, '登録日': 0}
社名の種類: 302
完全重複を削除した後: 328
社名の種類(正規化後): 257
外れ値として印を付けた件数: 4
欠損(型変換・外れ値処理の後): {'会社名': 0, '都道府県': 30, '電話番号': 0, '従業員数': 24, '登録日': 0}
測定条件:Apple M1 Pro、Python 3.13.13、pandas 3.0.6、実行日 2026年9月23日。
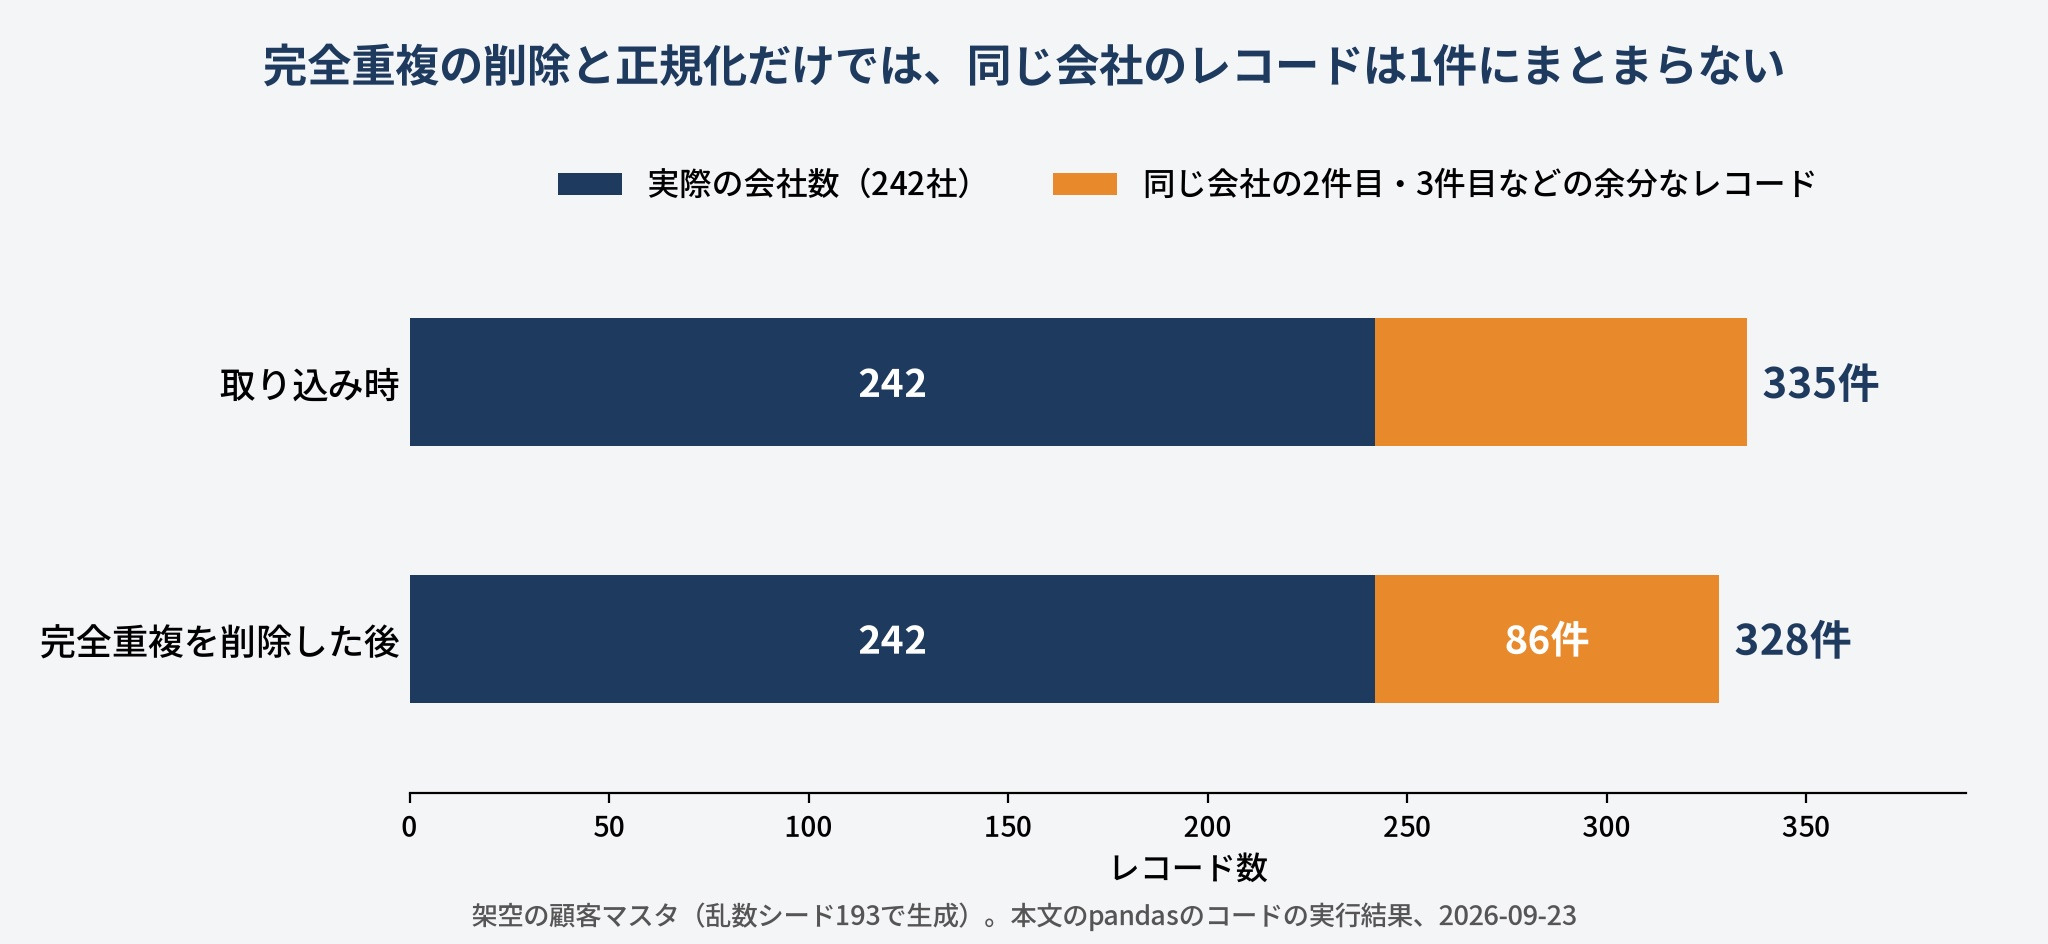
完全重複の削除で335件は328件になりました。混ぜた二重取り込みは8件でしたが、そのうち1件は片方にだけ桁の打ち間違いが入っていたため、完全重複としては消えていません。正規化によって社名の種類は302から257に減りましたが、実際の会社数は242社です。従業員数の欠損が20件から24件に増えたのは、外れ値4件を空欄にしたためです。
完全重複の削除と表記の正規化だけでは、同じ会社のレコードは1件にまとまりません。328件のうち86件は、同じ会社の2件目・3件目として残っています。これを1件にまとめるのが、後で説明する名寄せです。
データクレンジングの手順とチェックリスト
ここまで、汚れの種類ごとの直し方と、実際に直した結果を見てきました。次に、この作業を業務としてどの順番で進めるかを整理します。データクレンジングは一度で終わる作業ではないため、担当者が替わっても同じ結果になる手順にしておくことが大切です。
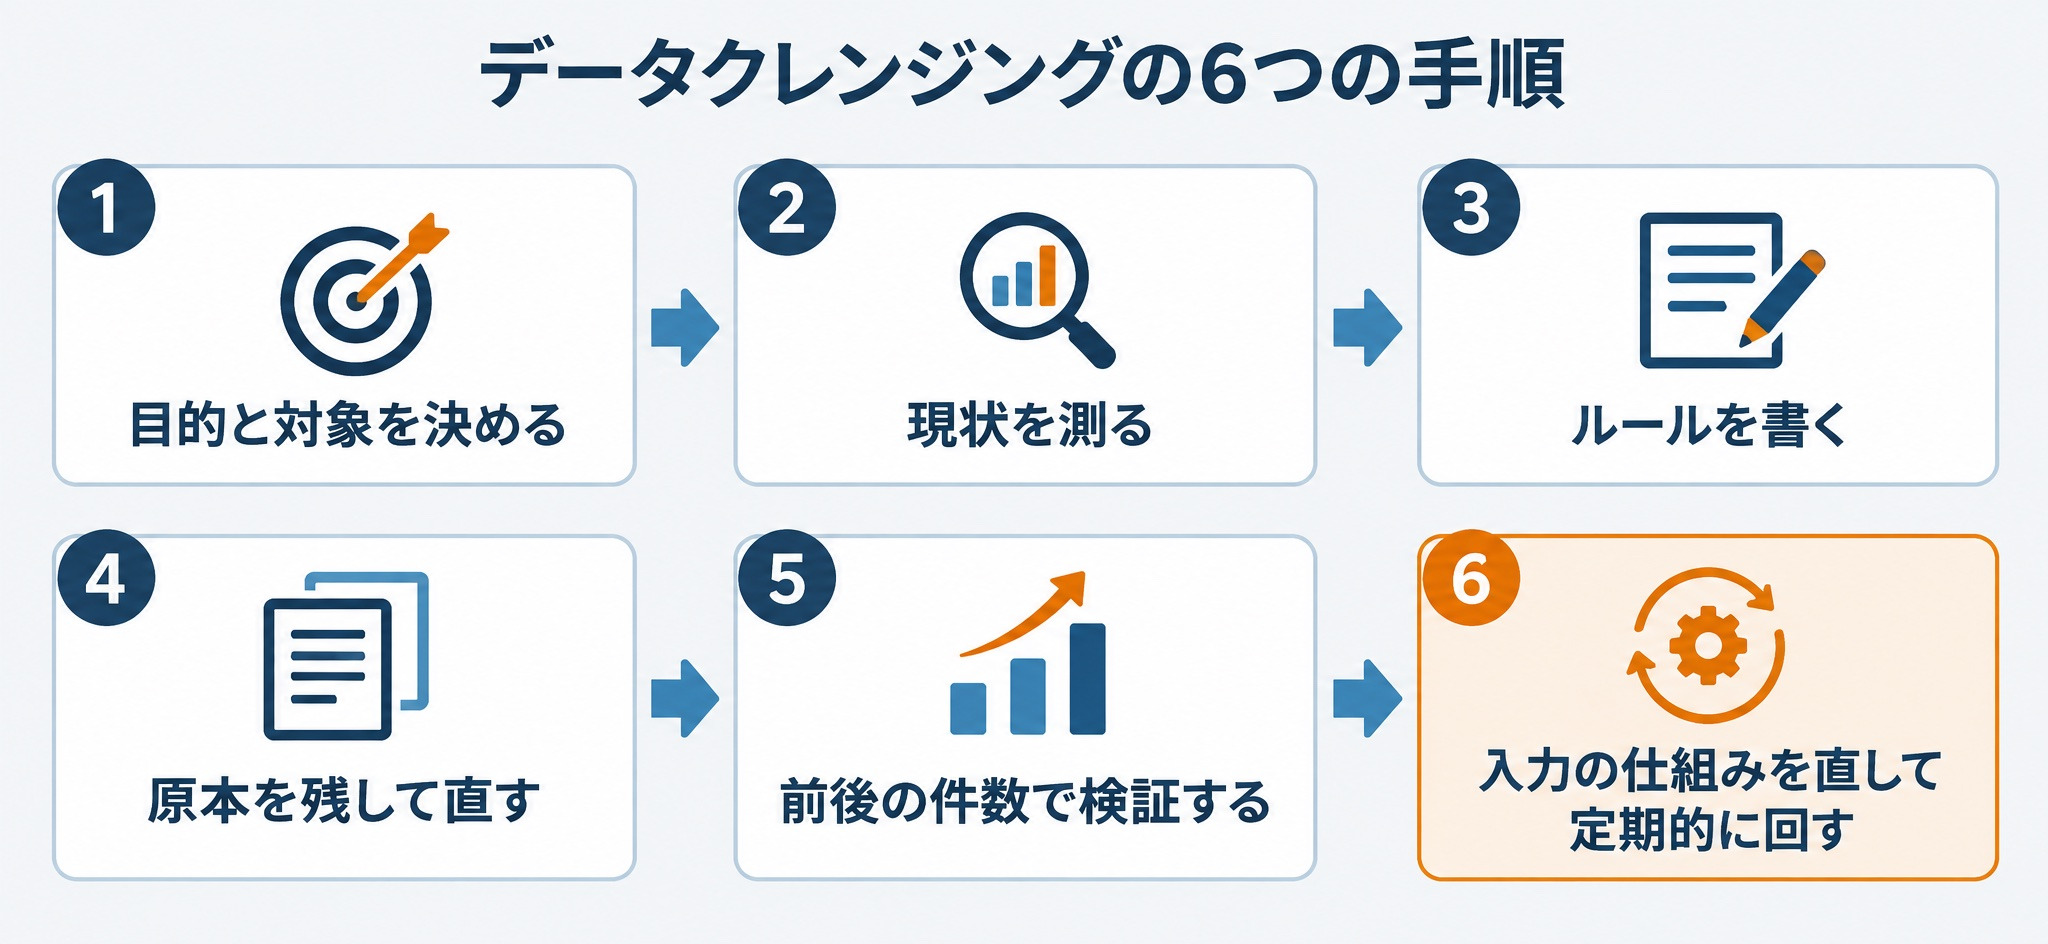
データクレンジングを進める6つの手順
- 目的と対象を決める:DX推進担当と業務部門の責任者で、「営業リストの重複をなくす」「RAGに入れる製品マスタを揃える」のように、何のために直すかを1文で決めます。目的が決まると、直す列と直さなくてよい列が分かれます
- 現状を測る:データ担当が、件数・列ごとの欠損数・値の種類の数・型を数えます。先ほどの実行例の①にあたる作業で、この数字が後で効果を測る基準になります
- ルールを書く:業務部門とデータ担当で、正とする表記、欠損の扱い、外れ値の基準を表に書き出します。「法人格は株式会社に統一」「従業員数が10万人を超えたら要確認」のように、誰が読んでも同じ判断になる粒度にします
- 原本を残して直す:データ担当が、元のファイルは上書きせずに残し、ルールを処理として当てます。Excelで手作業をする場合も、作業前のファイルを別名で保存しておきます
- 前後の件数で検証する:データ担当が手順2と同じ数字を取り直し、業務部門が要確認の行を元の資料と照らし合わせます。件数が想定以上に減っていたら、ルールが強すぎる可能性があります
- 入力の仕組みを直して定期的に回す:業務部門が、入力画面の項目を選択式にする、必須項目を設定するなど、汚れが生まれる入力の仕組みを直します。そのうえで、手順4の処理を月次などの周期で回します
作業の前後で確認するチェックリスト
次の8項目は、クレンジングを始める前と終えた後に確認しておきたい点です。
- 何のためにクレンジングするのか、目的を1文で書けているか
- 直す対象の列と、直さない列が決まっているか
- 正とする表記のルールが、表として残っているか
- 元のデータを上書きせず、別に保存しているか
- 直す前と後の件数・欠損数を記録しているか
- 削除した行と、その理由を後から追えるか
- 外れ値や判断に迷う行を「要確認」として残し、確認する担当者が決まっているか
- 汚れが生まれる入力の仕組みを直す担当者と期限が決まっているか
名寄せの手順。データクレンジングの後に同じ会社を1件にまとめる
データクレンジングで1件ずつの中身を正したので、次は複数のレコードを1件にまとめる名寄せです。名寄せとは、同じ会社や同じ人物を指すレコードを見つけ出し、1件にまとめる作業を指します。
名寄せのキーを選ぶ(法人番号・社名・電話番号・所在地)
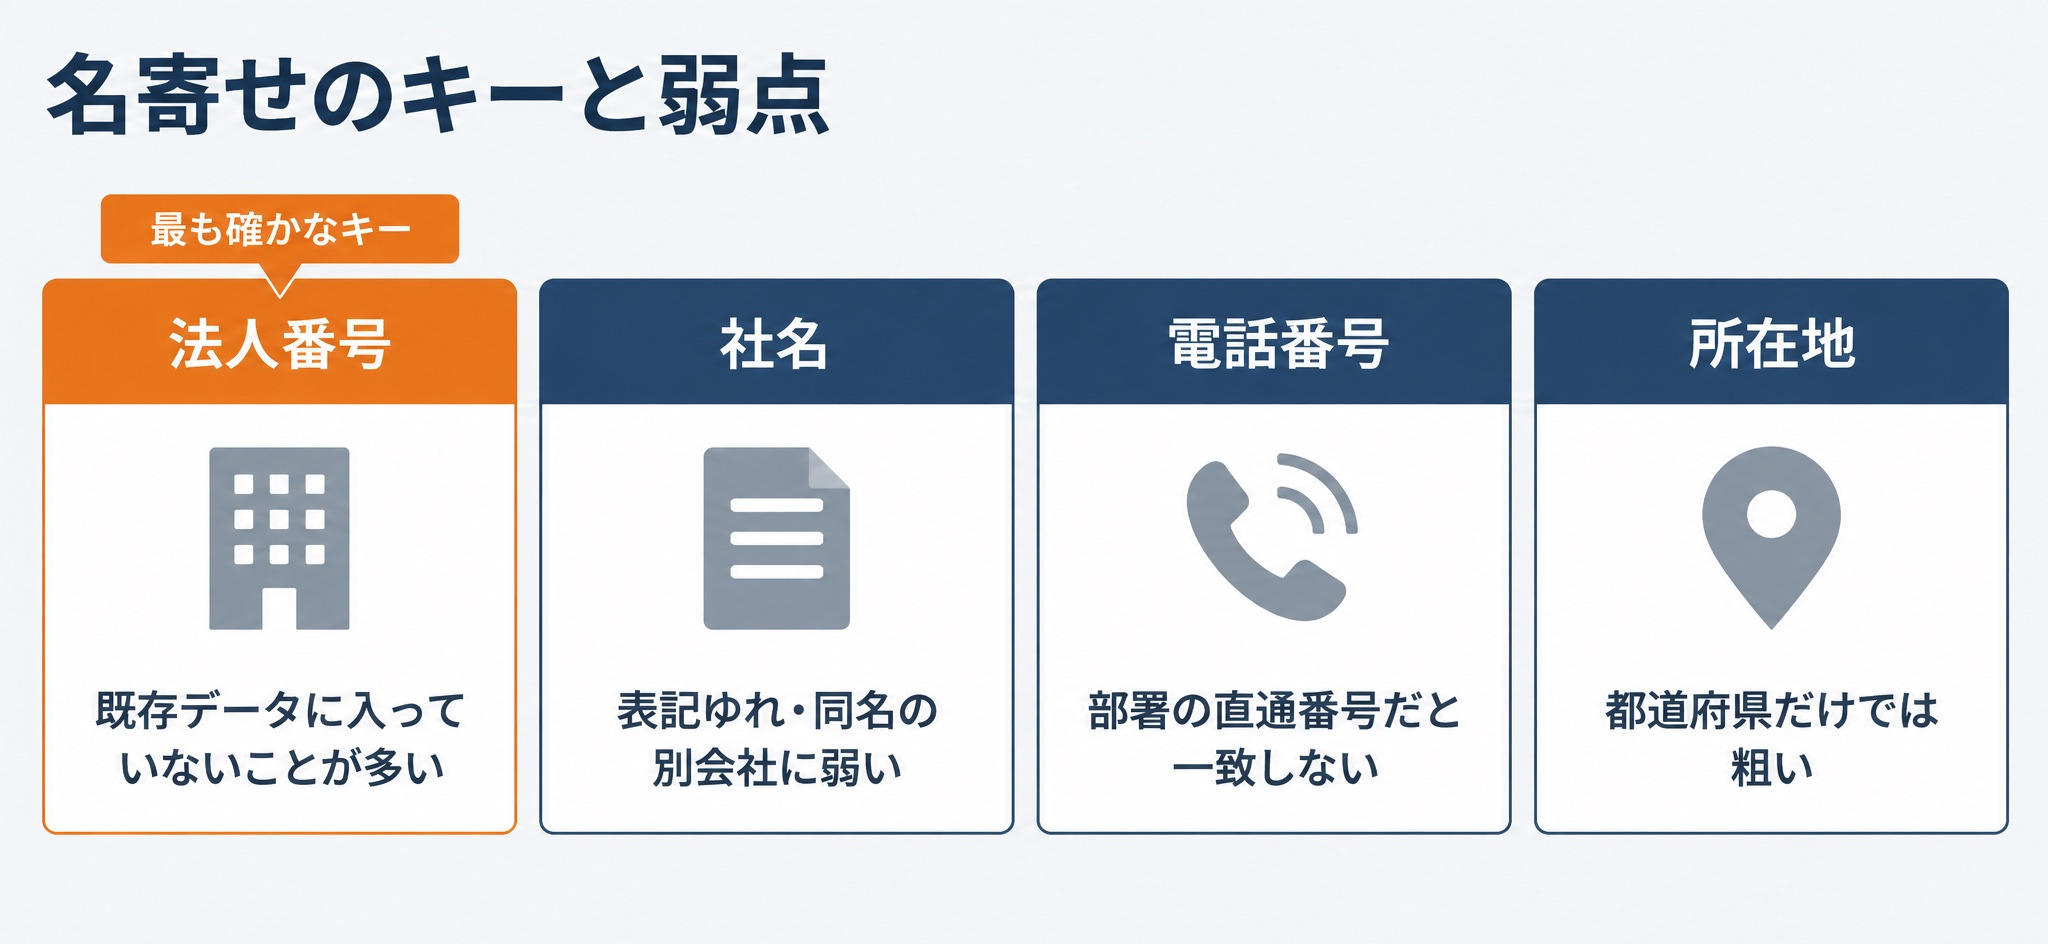
名寄せでは、「何が一致したら同じ会社とみなすか」というキーを決めます。候補ごとに弱点があります。
- 法人番号:法人に付く13桁の番号で、利用範囲の制約がなく誰でも自由に使えます。国税庁の法人番号公表サイトが商号・所在地・法人番号の基本3情報を公表しており、Web-APIやダウンロードでも取得できます(国税庁 法人番号公表サイト)。B2Bの顧客マスタなら最も確かなキーですが、既存のデータに入っていないことが多く、付与する作業が要ります
- 社名:どのデータにもありますが、表記ゆれや変換ミスに弱く、同じ社名の別会社も区別できません
- 電話番号:代表番号と部署の直通番号が混ざると、同じ会社でも一致しません
- 所在地:都道府県だけでは粗く、番地まで使うと表記ゆれの影響を受けやすくなります
名寄せのルールを3通り試すと、誤統合と取り残しが入れ替わる
先ほどクレンジングした328件に、3通りのルールで名寄せを行いました。生成データなので、どのレコードが本当はどの会社かという正解が分かります。そこで、別の会社を1件にまとめてしまった数(誤統合)と、同じ会社なのに2件以上に分かれたまま残った数(取り残し)を数えました。
import difflib
import pandas as pd

df = pd.read_csv("customers_clean.csv", dtype={"電話番号": str})
truth = pd.read_csv("customers_raw.csv", dtype=str).set_index("顧客ID")["true_id"]
df["true_id"] = df["顧客ID"].map(truth)      # 生成データなので「本当はどの会社か」が分かる
df["社名キー"] = df["会社名"].str.replace("株式会社", "").str.replace("有限会社", "")
print("名寄せ前の件数:", len(df), " 実際の会社数:", df["true_id"].nunique())

def evaluate(label, group):
    g = df.assign(g=group)
    over = (g.groupby("g")["true_id"].nunique() > 1).sum()     # 別の会社を1社にまとめた
    miss = (g.groupby("true_id")["g"].nunique() > 1).sum()     # 同じ会社が2件以上に残った
    print(f"{label}: 名寄せ後 {g['g'].nunique()}件 / 誤統合 {over}グループ / 取り残し {miss}社")

# ルールA:社名キーと電話番号が両方一致したら同じ会社
evaluate("A 社名+電話番号", df["社名キー"] + "|" + df["電話番号"])
# ルールB:社名キーだけで判定
evaluate("B 社名だけ      ", df["社名キー"])

# ルールC:社名キーが同じで、電話番号か都道府県のどちらかが一致したら同じ会社
parent = list(range(len(df)))
def find(i):
    while parent[i] != i:
        i = parent[i]
    return i
for _, idx in df.groupby("社名キー").groups.items():
    idx = list(idx)
    for a in idx:
        for b in idx:
            ra, rb = df.loc[a], df.loc[b]
            if a < b and (ra["電話番号"] == rb["電話番号"] or
                          (pd.notna(ra["都道府県"]) and ra["都道府県"] == rb["都道府県"])):
                parent[find(b)] = find(a)
df["グループ"] = [find(i) for i in range(len(df))]
evaluate("C 社名+(電話か県)", df["グループ"])

# あいまい一致:社名キーの似ている組を「候補」として出す(確定はしない)
keys = sorted(df["社名キー"].unique())
same = df.groupby("社名キー")["true_id"].agg(set)
pairs = [(a, b, round(difflib.SequenceMatcher(None, a, b).ratio(), 2))
         for i, a in enumerate(keys) for b in keys[i + 1:]]
for th in [0.75, 0.8]:
    cand = [p for p in pairs if p[2] >= th]
    hit = sum(1 for a, b, _ in cand if same[a] & same[b])
    print(f"類似度{th}以上の候補: {len(cand)}組(うち本当に同じ会社 {hit}組)")
print([p for p in pairs if p[2] >= 0.75][:6])

# ルールCで確定できなかった「同じ社名で別グループ」は、人が確認する一覧に回す
review = df.groupby("社名キー")["グループ"].nunique()
print("人の確認に回す社名:", int((review > 1).sum()), "社名")
chk = df[df["社名キー"].isin(review[review > 1].index)].groupby("社名キー")["true_id"].nunique()
print("  うち本当に同じ会社:", int((chk == 1).sum()), " 同名の別会社:", int((chk > 1).sum()))

# ルールCのグループを1件にまとめる(空欄は同じグループの他の行で埋める)
merged = df.groupby("グループ").agg(
    会社名=("会社名", lambda s: s.mode()[0]), 都道府県=("都道府県", lambda s: s.dropna().mode().get(0)),
    電話番号=("電話番号", lambda s: s.mode()[0]), 従業員数=("従業員数", "max"),
    登録日=("登録日", "min"), 元の件数=("顧客ID", "count"))
print("まとめた後の件数:", len(merged))
print("欠損(まとめた後):", merged[["都道府県", "従業員数"]].isna().sum().to_dict())
実行結果は次のとおりです(測定条件は前のコードと同じ)。
名寄せ前の件数: 328  実際の会社数: 242
A 社名+電話番号: 名寄せ後 263件 / 誤統合 0グループ / 取り残し 21社
B 社名だけ      : 名寄せ後 242件 / 誤統合 2グループ / 取り残し 2社
C 社名+(電話か県): 名寄せ後 250件 / 誤統合 0グループ / 取り残し 8社
類似度0.75以上の候補: 225組(うち本当に同じ会社 2組)
類似度0.8以上の候補: 30組(うち本当に同じ会社 0組)
[('三栄システム', '丸三システム', 0.83), ('三栄システム', '共栄システム', 0.83), ('三栄システム', '昭栄システム', 0.83), ('三栄化成', '丸三化成', 0.75), ('三栄化成', '共栄化成', 0.75), ('三栄化成', '昭栄化成', 0.75)]
人の確認に回す社名: 8 社名
  うち本当に同じ会社: 6  同名の別会社: 2
まとめた後の件数: 250
欠損(まとめた後): {'都道府県': 6, '従業員数': 4}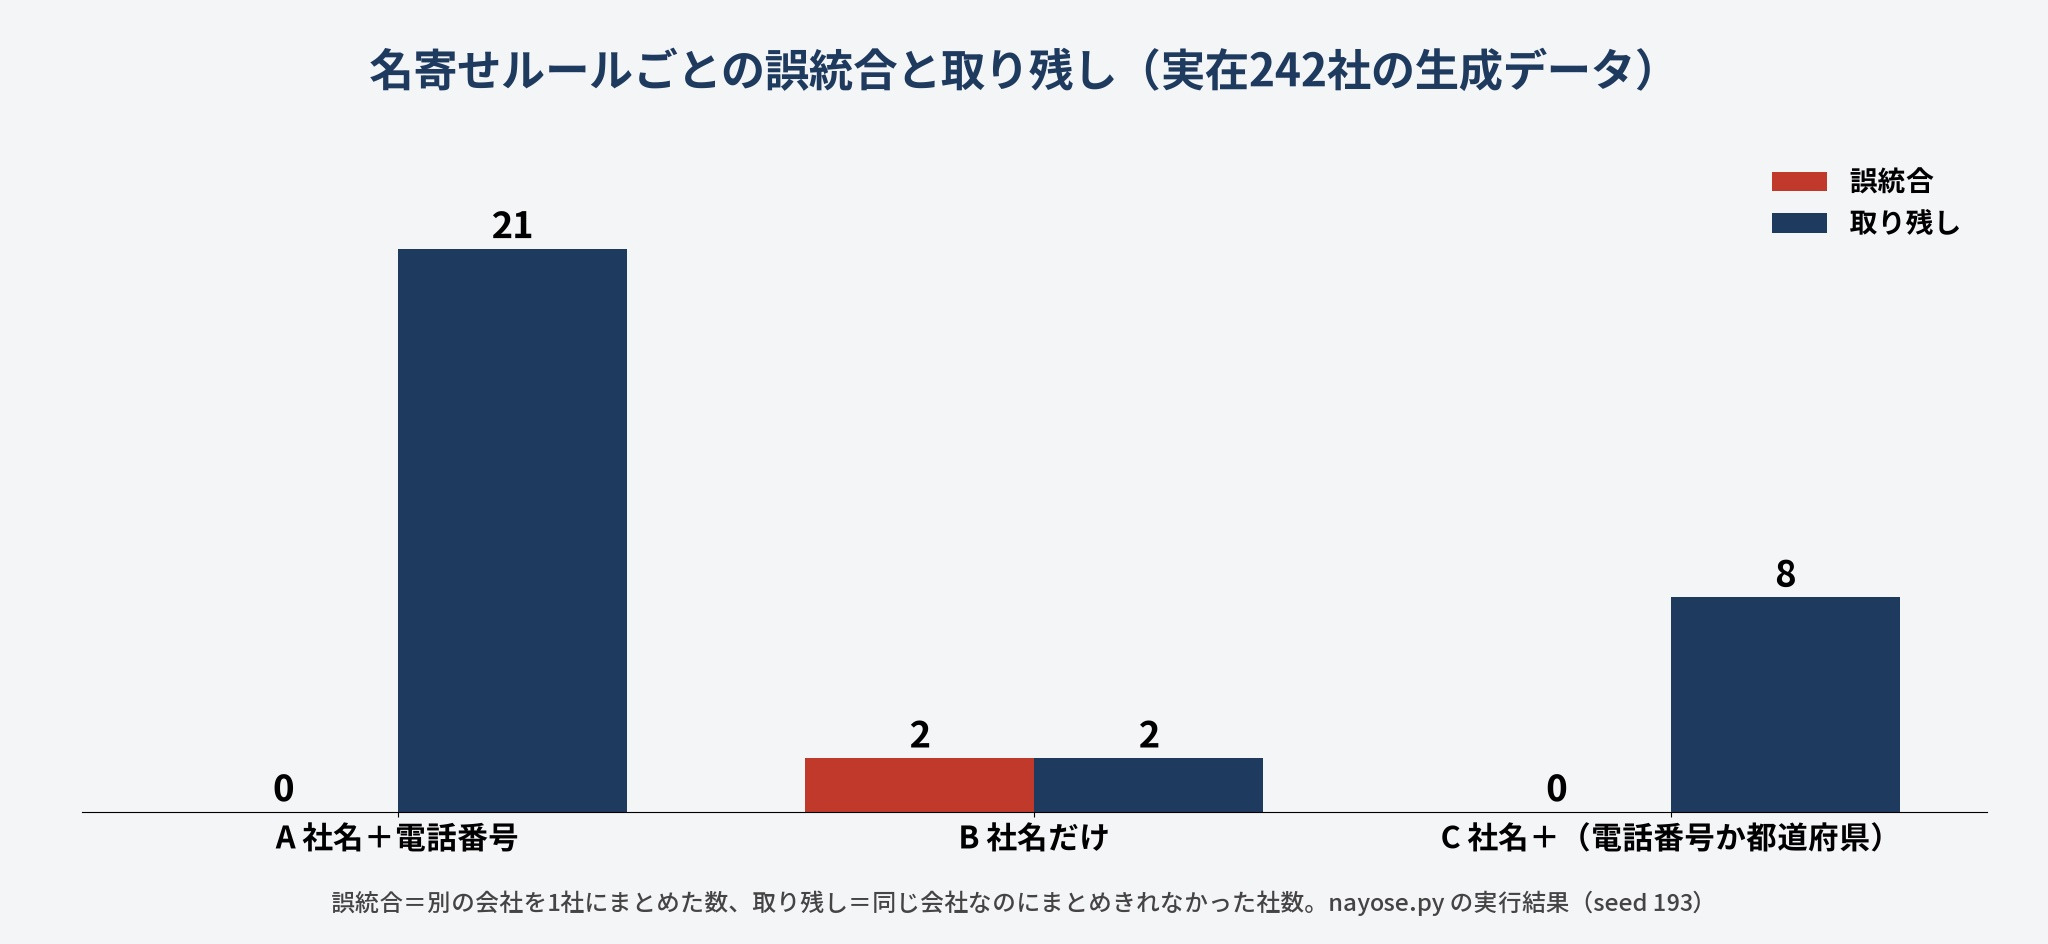
結果は、ルールによってはっきり分かれました。
- A 社名+電話番号:誤統合は0でしたが、部署の直通番号で登録された会社を拾えず、21社が取り残されました
- B 社名だけ:件数は正解と同じ242件になりましたが、同じ社名の別会社2組を1社にまとめる誤統合が起きています。取り残しの2社は、「精器」「興業」のような変換ミスで社名が変わっていた会社です
- C 社名+電話番号か都道府県:誤統合0のまま、取り残しを8社まで減らせました
件数だけを見るとルールBが正解に見えますが、中身は誤統合を含んでいます。名寄せ後の件数が正しそうに見えることと、正しく名寄せできていることは別の話です。誤統合は、別の会社の取引履歴が混ざるため、後から切り分けるのが難しくなります。一方、取り残しは確認一覧に出せば人が判断できます。そこで、誤統合を避けるルールで機械的にまとめ、残りを人が確認するという分担が現実的です。
ルールCでまとめた後の件数は250件で、同じ社名のまま別のグループに残った8社名が確認一覧に回りました。このうち6社名は本当に同じ会社、2社名は同名の別会社でした。確認一覧には、人が判断すべきものだけが載っていることになります。また、同じグループの他のレコードから値を補ったことで、都道府県の欠損は30件から6件に減りました。
あいまい一致は候補を出すところまでにする
変換ミスのような表記の違いは、文字の似ている度合いで拾う「あいまい一致」で補えそうに見えます。ExcelのPower Queryにもあいまい一致の機能があり、類似性のしきい値は既定で0.8です(Microsoft Learn「あいまい一致のサポート」)。
ただ、今回のデータで類似度0.75以上を候補にすると225組が出て、本当に同じ会社は2組だけでした。「三栄システム」と「共栄システム」のように、1文字違いの別会社が多いためです。0.8以上に上げると候補は30組に減りますが、本当に同じ会社は0組になりました。あいまい一致は、名寄せの確定には使わず、人が確認する候補を出すところまでにとどめます。社名に地域名や業種名が多い日本の会社名では、特にこの傾向が出やすいと考えられます。
ここまで名寄せの手順を解説しましたが、「自社の顧客マスタでは、どのルールで名寄せすべきか判断できない」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、クレンジングと名寄せのルールを業務部門の方と一緒に決め、毎月回せる処理として納めることが可能です。ただ、直して終わりではなく、直したデータをRAGや分析AIにつなげられるため、業務の改善まで見据えた整備が可能。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
データクレンジングツールの選び方。Excel・Power Query・Python・専用ツール
名寄せまでの作業内容が決まったら、次はそれをどの道具で行うかです。データクレンジングツールは、件数の多さと、同じ作業を何度繰り返すかで選ぶと迷いにくくなります。
| 道具 | 向いている場面 | 費用(2026年9月時点) | 作業の再現性 |
|---|---|---|---|
| Excel(関数・重複の削除) | 数百件程度を一度だけ直す | Excelのライセンスの範囲内 | 手作業が残りやすい |
| Power Query | 毎月同じ手順で直す | Excel(Windows・Mac)とPower BI Desktopで利用できる | 手順が記録され、更新で再実行できる |
| Python(pandas) | 件数が多い、ルールが複雑、他のシステムと連携する | pandasはBSD 3-Clauseライセンスのオープンソース | コードとして残り、再実行できる |
| OpenRefine | 表記ゆれを目で見ながらまとめたい | 無料のオープンソース | 操作の履歴を別のデータに再適用できる |
| クラウドのデータ準備サービス(例:AWS Glue DataBrew) | データ基盤がクラウドにあり、大量のデータを定期的に処理する | 30分のセッションあたり1.00 USD、ジョブはノード時間あたり0.48 USD(料金ページの計算例) | 保存した変換を新しいデータに適用できる |
この表から分かるとおり、上の行ほど始めやすく、下の行ほど繰り返しと大量処理に強くなります。以下、それぞれの守備範囲を見ていきます。
Excelの関数と重複の削除で足りる範囲
Excelには、全角の英数カナ文字を半角に変えるASC関数があります(Microsoft サポート「ASC 関数」)。すべての値が一致する行は、「データ」タブの「重複の削除」で消せます(Microsoft サポート「一意の値をフィルター処理する、または重複する値を削除する」)。数百件のリストを一度だけ整えるなら、Excelで十分です。
ただし、手作業の手順は記録に残りにくく、翌月に同じ作業をやり直すことになります。一度きりの作業ならExcel、繰り返すなら次のPower Queryへという線引きが目安です。Excelでの分析の進め方は、以下の記事で解説しています。
参照記事:Excelを用いたデータ分析のやり方と実施可能な分析手法一覧を紹介
同じ作業を繰り返すならPower Query
Power Queryは、Excel(WindowsとMac)やPower BI Desktopで使えるデータ変換の機能で、350種類を超える変換が用意されています(Microsoft Learn「Power Query とは」)。行った操作が手順として記録されるため、翌月は新しいデータに差し替えて更新するだけで同じクレンジングを再実行できます。あいまいマージでは、似た値の対応を「変換テーブル」として指定することもできます(Microsoft Learn「あいまいマージ」)。Excelに慣れた業務部門が自分で回し続けるなら、Power Queryが第一候補です。
件数が多くルールが複雑ならPython
本記事で使ったPythonのpandasは、件数が数十万件を超える場合や、名寄せのように条件を組み合わせたルールを書く場合に向いています。処理がコードとして残るため、ルールを変えたときの差分も追えます。pandasはBSD 3-Clauseライセンスで公開されています(pandas LICENSE)。一方で、コードを保守できる担当者が社内にいることが前提になります。
専用ツール・クラウドサービスを検討する場面
OpenRefineは、無料のオープンソースのデータ整備ツールです。似た値をまとめるクラスタリングの機能があり、データは自分のパソコンの中で処理されます(OpenRefine 公式サイト)。
AWS Glue DataBrewは、コードを書かずにデータをクリーンアップ・正規化できるAWSのサービスで、250以上の組み込み変換があります(AWS Glue の特徴)。料金ページの計算例では、30分のインタラクティブセッションあたり1.00 USD、ジョブはノード時間あたり0.48 USDです(AWS Glue 料金、2026年9月時点、リージョンにより異なる場合があります)。初めて使う場合は、最初の40セッションが無料です(AWS Glue よくある質問)。
法人データベースと照合して名寄せや属性の補完を行う専用サービスもあります。料金体系は製品ごとに異なるため、自社の件数と更新頻度を伝えたうえで見積もりを比べます。データがすでにクラウドにあるならクラウドのサービス、B2Bの顧客マスタで社外の企業情報まで補いたいなら名寄せの専用サービスが候補になります。
生成AIを使ったデータクレンジングの可能性と注意点
道具を選ぶ段階で、「生成AIに任せれば早いのでは」と考える方も多いでしょう。ここでは、生成AIに任せられる作業と、任せないほうがよい作業を分けて整理します。
生成AIが力を発揮する作業
生成AIは、表記ゆれの判定のように、ルールを書き切れない作業で力を発揮します。スタンフォード大学などの研究者による論文「Can Foundation Models Wrangle Your Data?」は、データのクレンジングと統合の5つのタスクをプロンプトとして与えたところ、大規模な基盤モデルが、これらのタスク向けに学習していないにもかかわらず高い性能を示したと報告しています(Narayan et al., 2022, arXiv:2205.09911)。同じ論文は、非公開のデータや業界固有のデータには課題が残るとも述べています。
実務で使いやすいのは、次のような作業です。
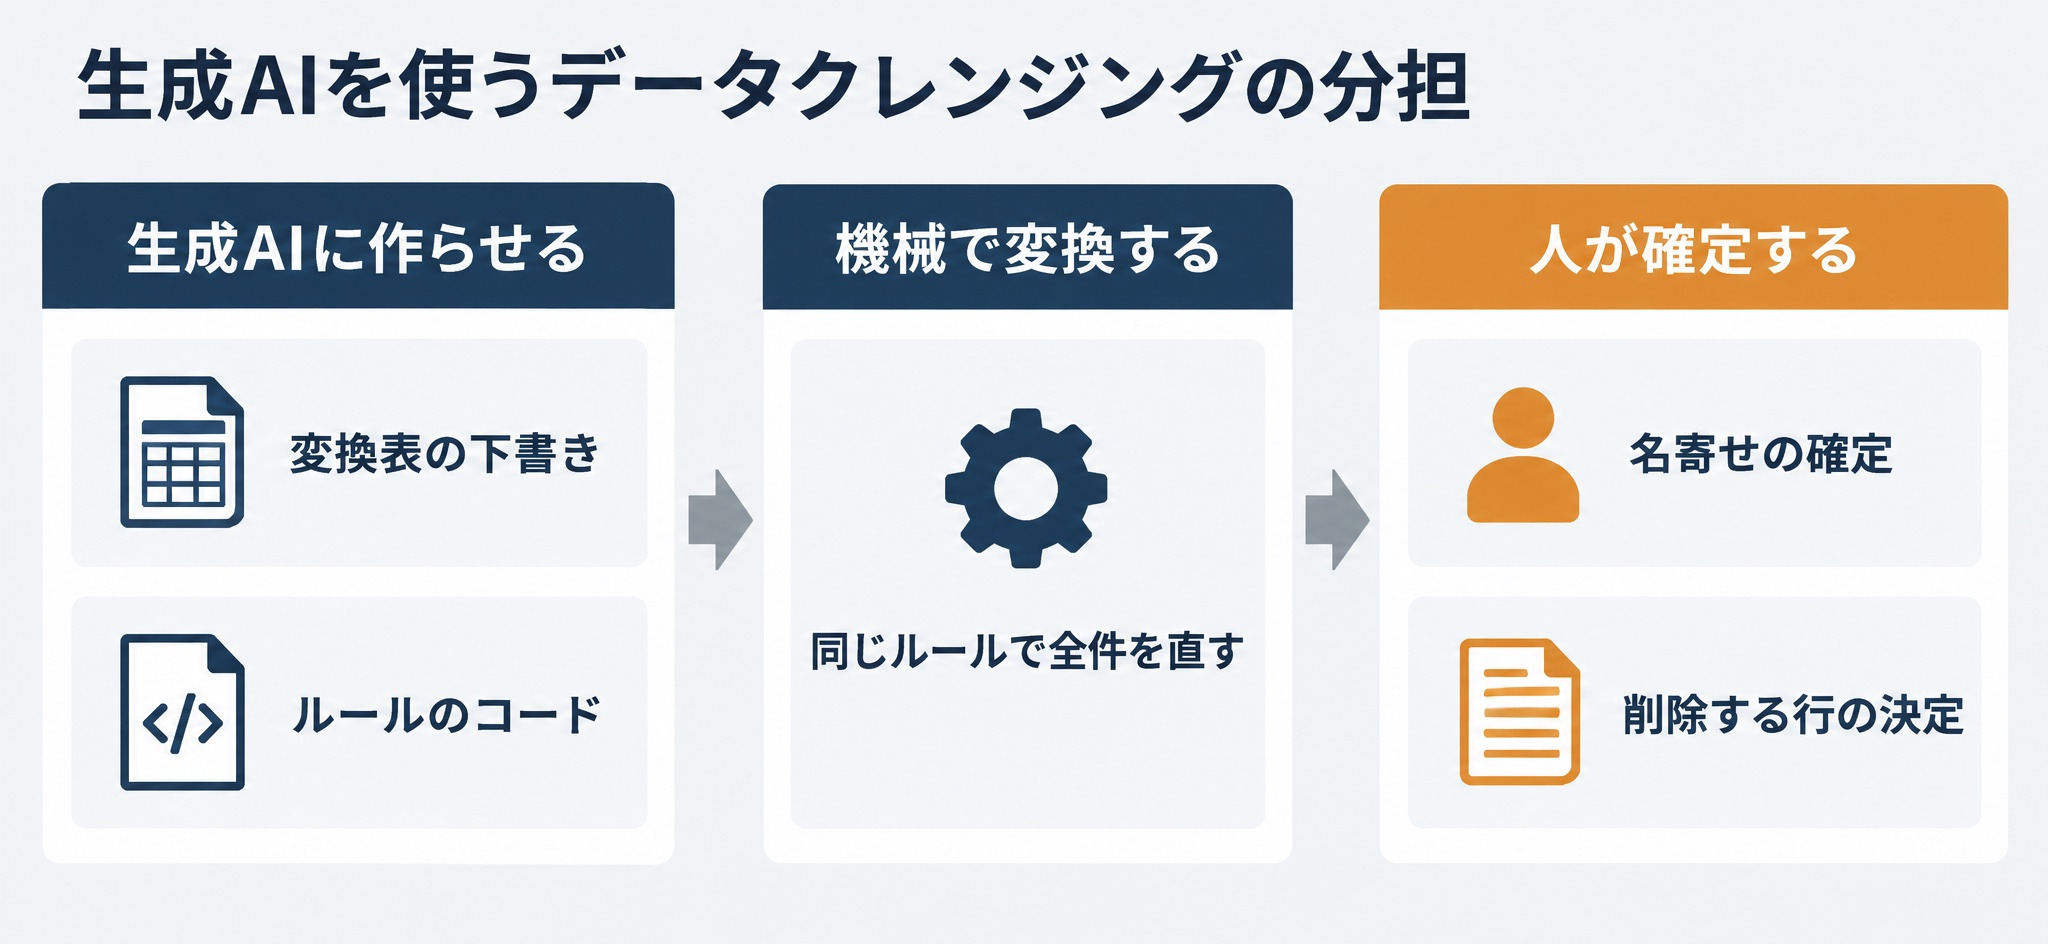
- 表記ゆれの一覧を渡し、正とする表記への変換表の下書きを作らせる
- 名寄せの確認一覧について、同じ会社と考えられる根拠と、別会社の可能性を説明させる
- 「法人格を統一する」のような日本語のルールを、Pythonのコードに書き起こさせる
生成AIに任せない作業と、使うときの注意点
一方で、次の点には注意が必要です。
- 個人情報を含むデータ:顧客マスタに担当者の氏名やメールアドレスが入っている場合、生成AIサービスへの入力は個人情報の取扱いの問題になります。個人情報保護委員会は、個人情報を含むプロンプトを入力する場合は利用目的の範囲内かを十分に確認するよう注意を促しています(個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」)
- 結果の再現性:生成AIに全件を直接直させると、同じ入力でも実行のたびに結果が変わることがあります。生成AIには変換表やコードを作らせ、実際の変換はそのルールで機械的に行います
- 確定の判断:生成AIがもっともらしい理由を付けて誤った統合を提案することもあります。名寄せの確定と、削除する行の決定は人が行います
生成AIに社内データを渡すときの情報漏洩の防ぎ方と、AIでのデータ分析の限界については、以下の記事で解説しています。
参照記事:生成AIで情報漏洩が起こる原因とは?企業が取るべき対策例7選とリスクの考え方
参照記事:AIでデータ分析はどこまでできる?限界と人間に必要な役割を解説
なお、社内文書を生成AIに参照させるRAGでも、元のデータの表記や重複が回答の精度を左右します。RAGに社内データを使う手順は、以下の記事にまとめています。
参照記事:ChatGPT×RAGで社内データを活用する5つの手順。精度を向上させる施策も解説
まとめ
- データクレンジングとは、誤り・重複・欠損・表記ゆれ・形式の不統一を直し、データを使える状態に整える作業です。1件の中身を正すのがクレンジング、複数のレコードを1件にまとめるのが名寄せで、クレンジングが先になります
- 汚れは、表記ゆれ・全角半角・重複・欠損・外れ値・型の不一致の6つに整理できます。表記はルールを決めて機械で揃え、外れ値は消さずに印を付けます
- 手順は、目的と対象を決める、現状を測る、ルールを書く、原本を残して直す、前後の件数で検証する、入力の仕組みを直して定期的に回す、の6つです
- 架空の顧客マスタ335件では、完全重複の削除と正規化の後も、同じ会社の重複が86件残りました
- 名寄せは、ルールによって誤統合と取り残しが入れ替わります。誤統合を避けるルールで機械的にまとめ、残りは人が確認します。あいまい一致は候補出しにとどめます
- 道具は、一度きりならExcel、繰り返すならPower Query、大量で複雑ならPython、クラウドや社外情報が絡むなら専用サービスが目安です。生成AIには変換表やコードを作らせ、確定は人が行います
データクレンジングとデータ整備の相談は「リベルクラフト」へ
ここまで読んで、データクレンジングの進め方は分かったが、自社のデータでどのルールを採るか、どこまで直せばAI活用に進めるかまでは決めきれない、と感じた方も多いのではないでしょうか?
リベルクラフトでは、戦略・構想の立案、AIシステムの開発、社内人材の育成の3つの軸で、企業のAI・データ活用を支援しています。データ整備については、社内データの棚卸しと現状の計測から入り、クレンジングと名寄せのルールを業務部門の方と一緒に決めます。直したデータは、RAGや分析AI、BIへの接続まで一貫して設計します。
次のようなお悩みをお持ちの方に適しています。
- 顧客マスタや製品マスタの重複と表記ゆれを、繰り返し使える仕組みで直したい
- 名寄せで誤統合を起こさないルールを、自社のデータで検証しながら決めたい
- RAGや分析AIを入れる前に、どこまでデータを整えればよいか判断したい
構想段階のご相談でも問題ありません。まずはお気軽にお問い合わせください。
⇨リベルクラフトへの無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。