RLHFとは。報酬モデル・PPO・DPOの仕組みを、小さなモデルで動かして解説
「SFT、報酬モデル、PPOの3段階」という図は何度も見たものの、報酬モデルが何を学習しているのか、なぜKL制約が要るのか、DPOと何が違うのかまでは説明できない、という方も多いでしょう。
しかし、ここを曖昧にしたまま自社のモデルを調整しようとすると、評価の仕方を少し誤っただけで、モデルが思わぬ方向へ学習してしまいます。
そこで本記事では、
- InstructGPT論文に書かれたRLHFの3段階と、その件数や設定値
- 報酬モデルの学習とKL制約の働きを、小さな実験で確かめた結果
- DPOとの違いと、TRLで日本語の小さなLLMにDPOをかけた結果
- 2026年時点で各社が使っている手法と、自社でやるべきかの判断手順
についてわかりやすく解説します。LLMのファインチューニングを検討している実務者の方は、ぜひ最後までご覧ください。
本記事のコードと出力は、すべて実際に実行して得たものです。環境はApple M1 Pro(メモリ32GB)、Python 3.13.13、PyTorch 2.14.0、Transformers 5.17.0、TRL 1.13.0、NumPy 2.5.3で、実行日は2026年9月23日、乱数シードは42です。
「自社のデータでLLMの回答の質を上げたいが、どの手法から手を付けるべきか判断したい」という方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
- RLHFとは。人間のフィードバックでLLMの出力を好みに寄せる学習方法
- InstructGPTで見るRLHFの3段階
- RLHFの報酬モデルの作り方。比較データからBradley-Terryで点数を学ぶ
- RLHFのPPOとKL制約。報酬モデルの穴を突かせない仕組み
- RLHFとDPOの違い。報酬モデルを使わない方法
- RLHFの派生。RLAIF・Constitutional AI・検証できる報酬
- 2026年時点で各社が使っているRLHFの手法
- RLHFで起きた問題。公表された2つの事例
- 自社でRLHFやDPOをやる必要があるかの判断手順
- RLHFの要点をまとめると
- RLHF・DPOを使ったLLMの調整と学習は「リベルクラフト」へ
RLHFとは。人間のフィードバックでLLMの出力を好みに寄せる学習方法
RLHFの定義。正解は書けないが「どちらが良いか」は言える
RLHF(Reinforcement Learning from Human Feedback、人間のフィードバックによる強化学習)とは、人が複数の回答を比べた結果から「人の好みを点数にするモデル」を作り、その点数が高くなるように強化学習でLLMを調整する方法です。
事前学習を終えたLLMは、文章の続きを予測することしか学んでいません。模範解答を集めて教師ありで学習させるSFT(教師ありファインチューニング)を行えば、指示に答える形は身につきます。ただ、要約や相談への回答のように、唯一の正解を書き下せないタスクでは、模範解答を集めるだけでは「どちらの答え方がより良いか」を教えきれません。
一方で、2つの回答を並べて「どちらが良いか」を答えることは、人にとって簡単です。RLHFはこの比較の結果を学習の材料にします。ファインチューニング全体の中での位置づけは「ファインチューニングとは。仕組み・種類・RAGとの違いをわかりやすく解説」で整理しています。
RLHFはどこから来たか。2017年の選好学習からInstructGPTへ
人の比較から報酬を学ぶという手法そのものは、LLMより前の強化学習の研究で生まれました。OpenAIとDeepMindの研究者による2017年の論文(arXiv:1706.03741)は、エージェントの行動の1%未満に人が比較のフィードバックを付けるだけで、報酬関数を与えずにAtariのゲームやロボットの歩行を学習できることを示しています。
これをLLMに本格的に当てはめたのが、OpenAIが2022年に発表したInstructGPTの論文(arXiv:2203.02155)です。いまRLHFと言えば、ほぼこの論文の手順を指します。
InstructGPTでRLHFの効果はどれだけ出たか
論文では、効果が数値で示されています。
- 13億パラメータのInstructGPTの出力が、100倍以上大きい1,750億パラメータのGPT-3の出力よりも、評価者に好まれた
- 1,750億パラメータ同士では、InstructGPTの出力がGPT-3より好まれた割合は85±3%。数例の手本を与えたGPT-3に対しても71±4%
- TruthfulQAで、真実かつ有益な回答を出す頻度がGPT-3の約2倍になった
- 有害な出力は、GPT-3より約25%少なくなった
一方で、公開のNLPベンチマークの一部では性能が下がりました。論文はこれを「alignment tax(調整の代償)」と呼び、後で述べるPPO-ptxという対策を加えています。
InstructGPTで見るRLHFの3段階
定義と効果が分かったところで、InstructGPTを実際にどう作ったのかを論文の手順で追います。
段階1. SFT。評価者が書いた模範解答で教師あり学習する
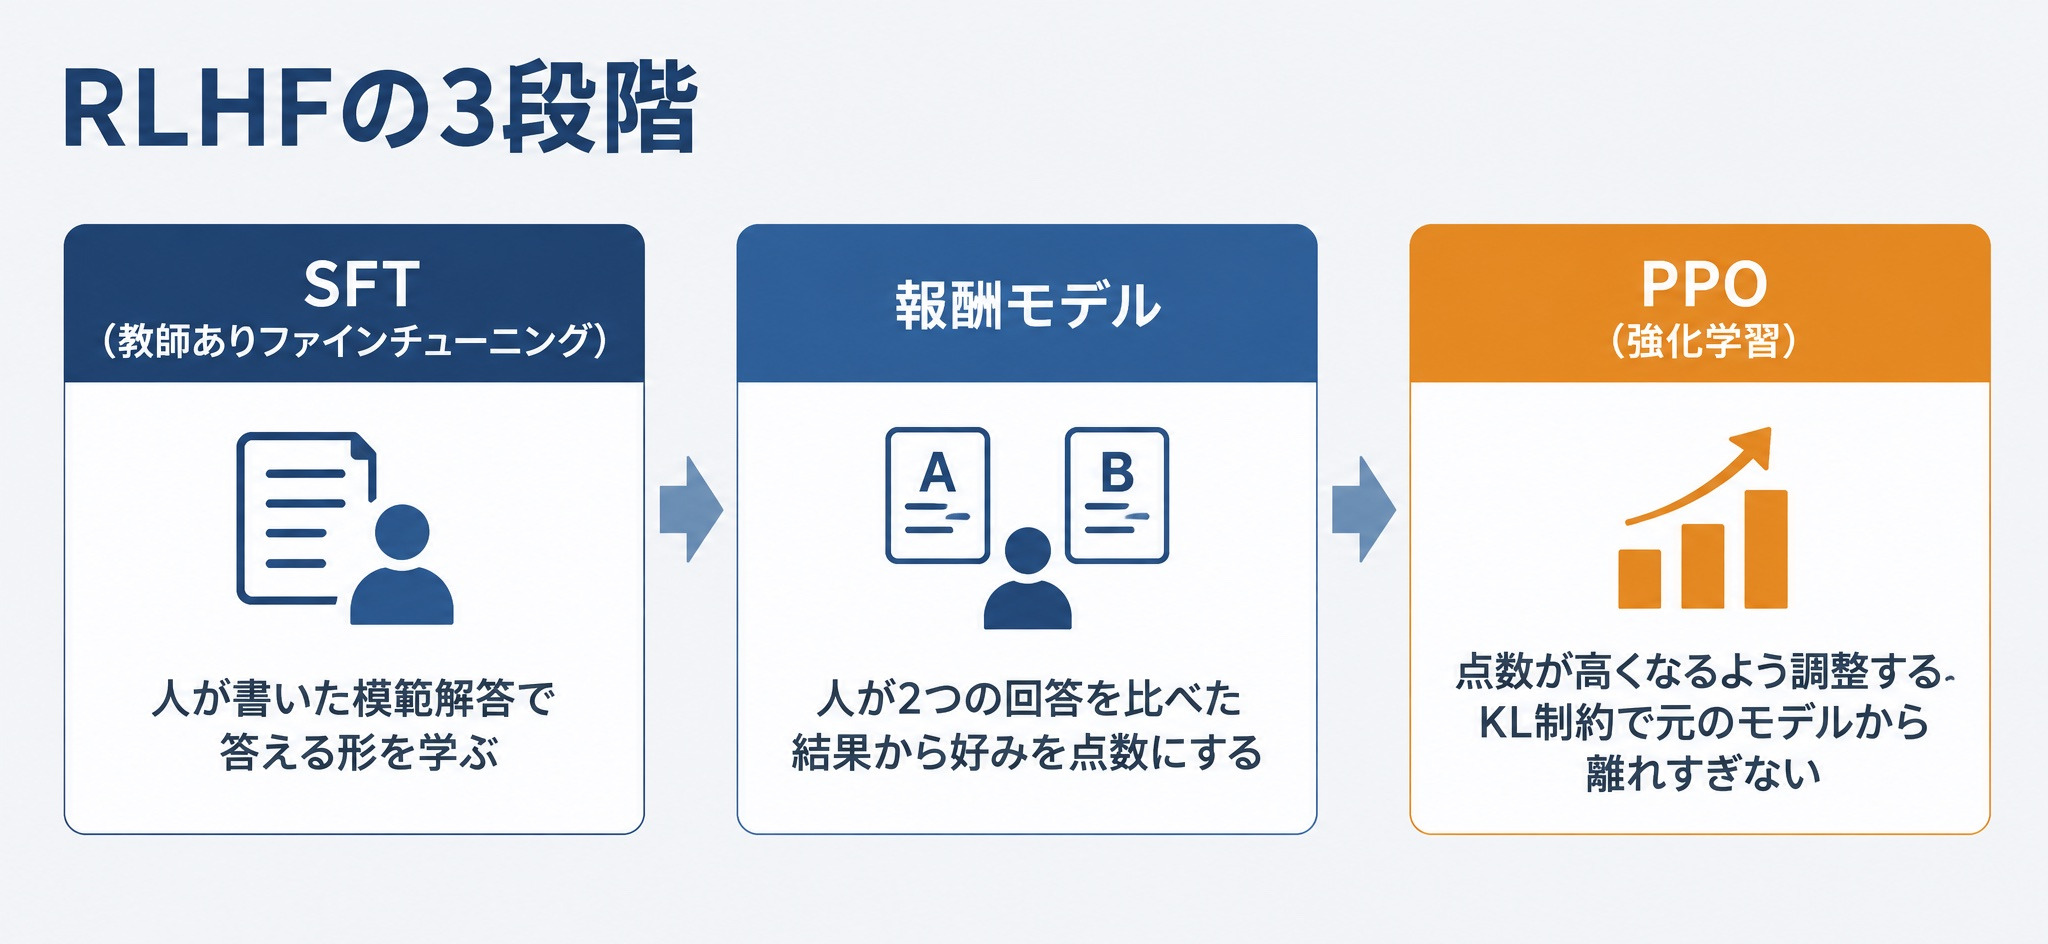
最初に、評価者が書いた模範解答でGPT-3を教師ありで学習させます。評価者はUpworkとScaleAIを通じて集めた約40人の契約者で、SFT用のデータは約1万3,000件のプロンプトでした。論文によれば、検証損失は1エポックで過学習し始めたものの、16エポックまで学習したほうが後の報酬モデルの点数も人の評価も上がったとされています。
段階2. 報酬モデル。回答の順位づけから点数を学ぶ
次に、SFTモデルに同じプロンプトへの回答を4〜9個出させ、評価者が順位をつけます。約3万3,000件のプロンプトについて集めた順位から、「プロンプトと回答を受け取り、点数を1つ返すモデル」を学習します。これが報酬モデルです。論文では60億パラメータの報酬モデルだけを使っています。1,750億パラメータで作ると学習が不安定になったためです。
段階3. PPO。報酬モデルの点を上げつつ、SFTモデルから離れすぎない
最後に、報酬モデルの点数が高くなるように、強化学習の手法であるPPOでSFTモデルを更新します。使うのはAPI由来の約3万1,000件のプロンプトです。このとき、更新後のモデルがSFTモデルから離れすぎないよう、トークンごとにKLペナルティを差し引きます。係数はβ=0.02でした。さらに事前学習のデータで学習する項を混ぜたものをPPO-ptxと呼び、これが最終的なInstructGPTです。
| 段階 | 人が用意するもの | 件数(プロンプト) | モデルが学ぶこと |
|---|---|---|---|
| 1. SFT | 模範解答 | 約1万3,000 | 指示に答える形 |
| 2. 報酬モデル | 4〜9個の回答の順位 | 約3万3,000 | 人がどちらを好むかの点数 |
| 3. PPO | プロンプトだけ | 約3万1,000 | 点数が高くなる答え方 |
この表から読み取れるのは、人の手が要るのは段階1と2だけで、段階3ではプロンプトを渡すだけで済む点です。人の判断は報酬モデルに写し取られ、PPOの間は報酬モデルが人の代わりに採点し続けます。
SFTやLoRAなど、ほかのファインチューニングの手法と実装の手順は「LLMのファインチューニングとは」で解説しています。本記事では、この先を報酬モデル、PPO、DPOの順に掘り下げます。
RLHFの報酬モデルの作り方。比較データからBradley-Terryで点数を学ぶ
3段階のうち、RLHFの成否を最も左右するのが報酬モデルです。ここでは報酬モデルが何を学習しているのかを、式と実験で確かめます。
点数でなく比較を集める理由
評価者に「この回答は10点満点で何点ですか」と尋ねると、人によって基準がずれます。厳しい人は全体に低く、甘い人は全体に高くつけるからです。「AとBのどちらが良いですか」なら、基準のずれが打ち消されやすくなります。InstructGPT論文でも、評価者同士の一致率は72.6±1.5%でした。完全には揃わないものの、比較の形なら7割以上は揃うということです。
Bradley-Terryモデルと報酬モデルの損失関数
比較の結果を点数に変えるときに使うのが、Bradley-Terryモデルです。回答Aの点数を r_A、回答Bの点数を r_B としたとき、人がAを選ぶ確率を次の式で表します。
P(Aが選ばれる) = σ(r_A − r_B) σ はシグモイド関数 1 / (1 + e^(−x))点数の差が大きいほど、選ばれる確率は1に近づきます。報酬モデルの学習では、人が選んだ回答 y_w と選ばなかった回答 y_l の組について、この確率が高くなるように点数を調整します。InstructGPT論文の式(1)は、次の損失を最小にするというものです。
loss = − log σ( r(x, y_w) − r(x, y_l) )言い換えると、選ばれた回答の点数が、選ばれなかった回答の点数をどれだけ上回っているかを大きくしていく学習です。点数の大きさそのものには意味がなく、2つの回答の差だけが意味を持ちます。
比較データだけで報酬モデルを学習してみる
この仕組みを、小さな設定で確かめます。1つの質問に対して回答の候補が20個あり、それぞれに「本当の品質」があるとします。本当の品質は学習する側からは見えません。SFTモデルから2つの回答を出し、人が本当の品質の差にもとづくBradley-Terryの確率でどちらかを選ぶ、という比較データを集めて、報酬モデルを学習させます。
import numpy as np, torch

SEED = 42
rng = np.random.default_rng(SEED)
torch.manual_seed(SEED)

K = 20                                    # 1つの質問に対する回答候補の数
gold = rng.normal(0, 1, K)                # 本当の品質(人が持っている基準。学習側からは見えない)
ref_logits = rng.normal(0, 1.5, K)        # SFTモデル(参照モデル)がどの回答を出しやすいか
pi_ref = np.exp(ref_logits) / np.exp(ref_logits).sum()

def collect_comparisons(n):
    """参照モデルから2つ回答を出し、人がBradley-Terryの確率でどちらかを選ぶ"""
    a = rng.choice(K, n, p=pi_ref); b = rng.choice(K, n, p=pi_ref)
    keep = a != b; a, b = a[keep], b[keep]
    p_a = 1 / (1 + np.exp(-(gold[a] - gold[b])))
    a_wins = rng.random(len(a)) < p_a
    win = np.where(a_wins, a, b); lose = np.where(a_wins, b, a)
    return win, lose

def train_reward_model(win, lose, steps=2000, lr=0.05, l2=1e-3):
    """InstructGPT論文の式(1)と同じ損失:-log σ(r(y_w) - r(y_l))"""
    r = torch.zeros(K, requires_grad=True)
    opt = torch.optim.Adam([r], lr=lr)
    w = torch.tensor(win); l = torch.tensor(lose)
    for _ in range(steps):
        opt.zero_grad()
        loss = -torch.nn.functional.logsigmoid(r[w] - r[l]).mean() + l2 * (r ** 2).sum()
        loss.backward(); opt.step()
    r = r.detach().numpy()
    return r - (pi_ref * r).sum()          # 参照モデルの平均が0になるようにずらす(論文と同じ正規化)

def pair_accuracy(r, n=20000):
    """新しく集めた比較データで、報酬モデルが人の選択を当てる割合"""
    win, lose = collect_comparisons(n)
    return (r[win] > r[lose]).mean()

for n in [100, 1000, 10000]:
    win, lose = collect_comparisons(n)
    r = train_reward_model(win, lose)
    corr = np.corrcoef(r, gold)[0, 1]
    print(f"比較{n:>6}件  人の選択との一致率 {pair_accuracy(r):.3f}  本当の品質との相関 {corr:.3f}")
print(f"参考:本当の品質を知っている場合の一致率 {pair_accuracy(gold):.3f}")
実行結果は次のとおりです。
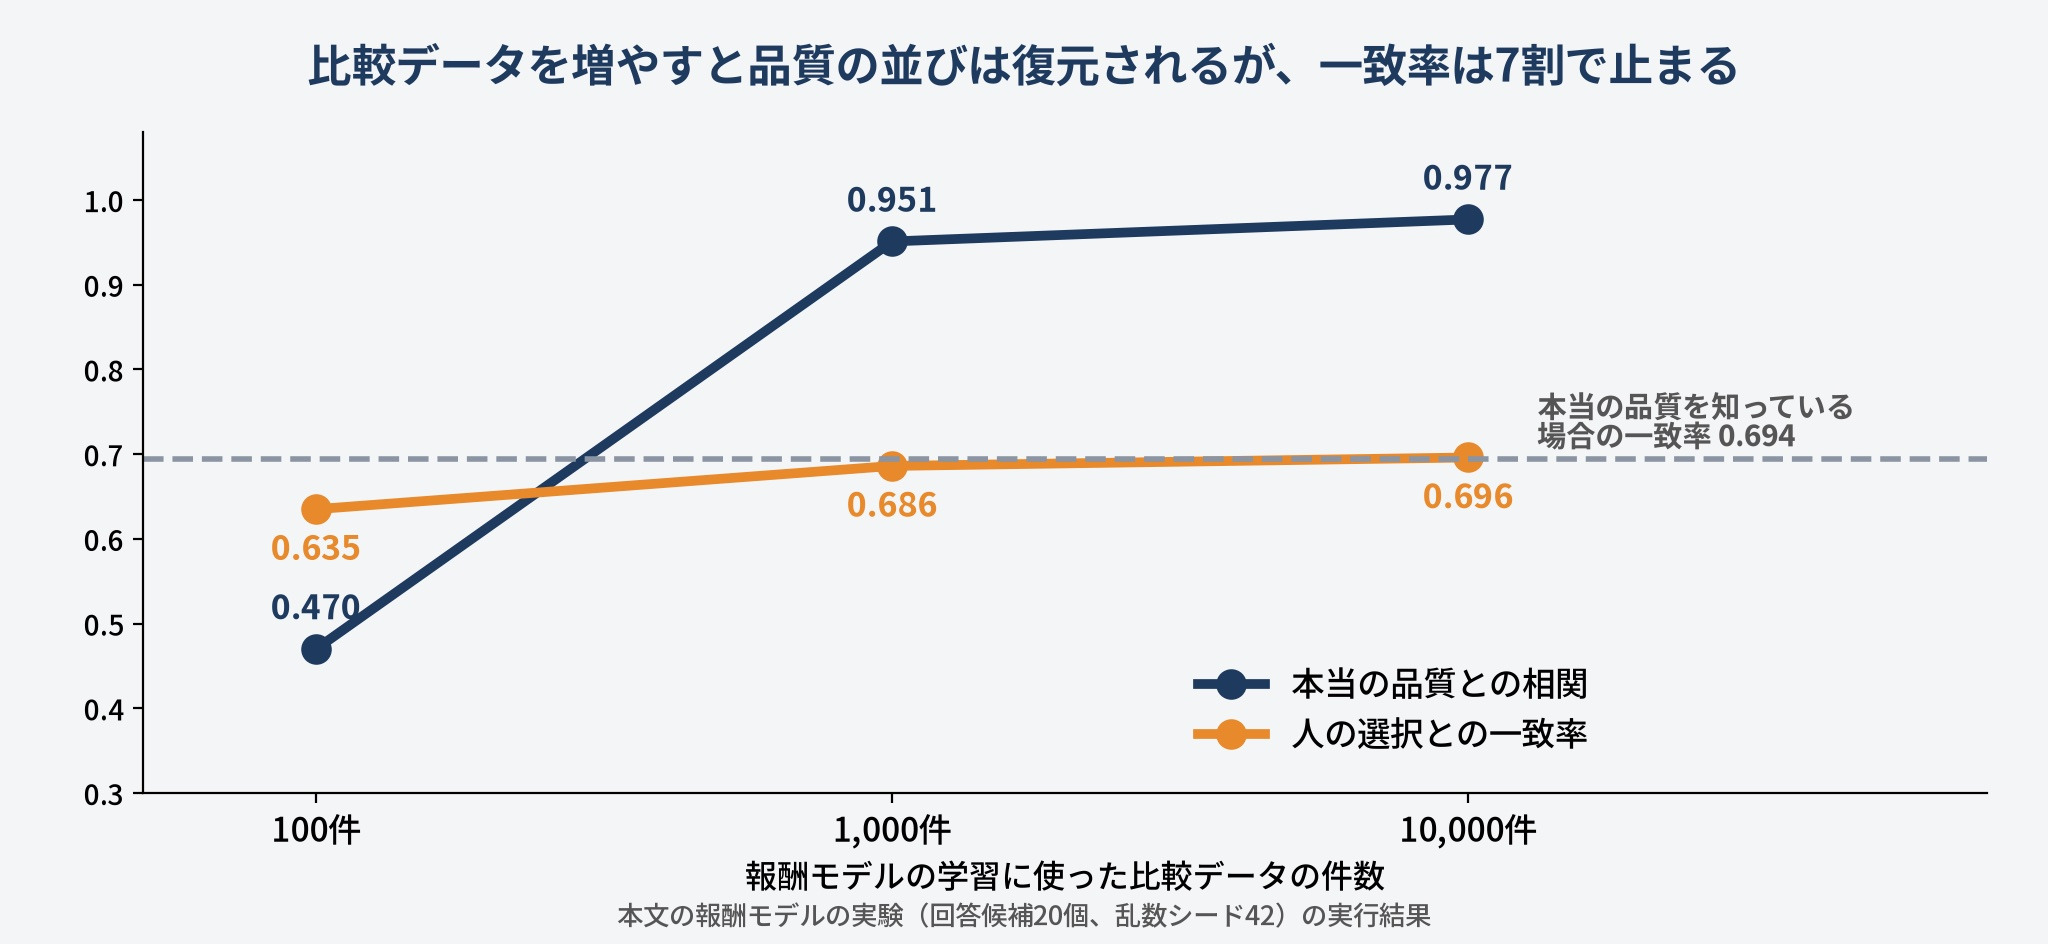
比較   100件  人の選択との一致率 0.635  本当の品質との相関 0.470
比較  1000件  人の選択との一致率 0.686  本当の品質との相関 0.951
比較 10000件  人の選択との一致率 0.696  本当の品質との相関 0.977
参考:本当の品質を知っている場合の一致率 0.694比較データが100件では、報酬モデルの点数と本当の品質の相関は0.470にとどまりました。1,000件で0.951、10,000件で0.977まで上がります。比較しか与えていないのに、件数が増えると、見えないはずの品質の並びがほぼ復元されます。
人の選択との一致率には天井がある
注目してほしいのは一致率のほうです。10,000件で学習した報酬モデルの一致率は0.696で、本当の品質を知っている場合の0.694とほぼ同じ値です。この設定では人の選択そのものに揺らぎがあるため、本当の品質どおりに点をつける報酬モデルでも、人の選択は7割程度しか当てられません。
InstructGPT論文の報酬モデルも、学習に使った評価者の選択を当てる精度が72.4±0.4%、学習に参加していない評価者群では69.6±0.9%でした。評価者同士の一致率72.6%とほぼ同じ水準です。報酬モデルの精度が7割前後で止まるのは、モデルの能力より人の判断の揺らぎが原因である場合があります。精度だけを見て報酬モデルの良し悪しを判断しないことが、実務での最初の注意点です。
RLHFのPPOとKL制約。報酬モデルの穴を突かせない仕組み
報酬モデルは人の判断を7割程度しか再現できず、比較データが少ない回答ほど点数が不確かになります。その不確かな点数をひたすら最大化したら、モデルはどう動くのでしょうか?この問いに答えるのが、PPOとKL制約の役割です。
PPOがRLHFで担う役割
PPO(Proximal Policy Optimization)は、1回の更新でモデルの出力確率が変わりすぎないよう、更新幅を一定の範囲に切り詰める強化学習の手法です。InstructGPTでは、プロンプトを受け取って回答を1つ出し、報酬モデルの点数を受け取ったら終わる、という1手で完結する環境として学習させています。回答の価値を見積もる価値関数は、報酬モデルから初期化しています。
最大化する目的は、論文の式(2)を言葉にすると次のとおりです。
報酬モデルの点数 − β × log( 更新後のモデルの確率 / SFTモデルの確率 )2項目がKLペナルティです。SFTモデルなら出さないような回答を出すほど、点数から差し引かれます。βが大きいほど、SFTモデルの近くに留まります。
KL制約を弱めると、報酬モデルの点は上がり本当の品質は下がる
先ほどの実験の続きで、比較1,000件で学習した報酬モデルを使い、βを変えて最適化します。KLペナルティ付きの報酬最大化には、「SFTモデルの確率に exp(点数/β) を掛けて正規化したもの」という最適解が知られています(DPO論文の式(4))。PPOが学習を通じて近づこうとしている先を、ここでは直接計算します。
win, lose = collect_comparisons(1000)
r_hat = train_reward_model(win, lose)
for beta in [1.0, 0.5, 0.2, 0.1, 0.05, 0.02, 0.01]:
    # KL付き報酬最大化の最適解:π(y) ∝ π_ref(y)·exp(r(y)/β)(DPO論文の式(4))
    logits = np.log(pi_ref) + r_hat / beta
    pi = np.exp(logits - logits.max()); pi /= pi.sum()
    kl = (pi * np.log(pi / pi_ref)).sum()
    top = pi.argmax()
    print(f"{beta:6.2f} {kl:6.2f} {(pi*r_hat).sum():8.3f} {(pi*gold).sum():8.3f} {top:>6} {pi[top]:6.3f}")
出力を表にまとめます。
| β | SFTモデルからのKL | 報酬モデルの点(平均) | 本当の品質(平均) | 最も出しやすい回答(確率) |
|---|---|---|---|---|
| 最適化前 | 0.00 | 0.000 | 0.378 | ー |
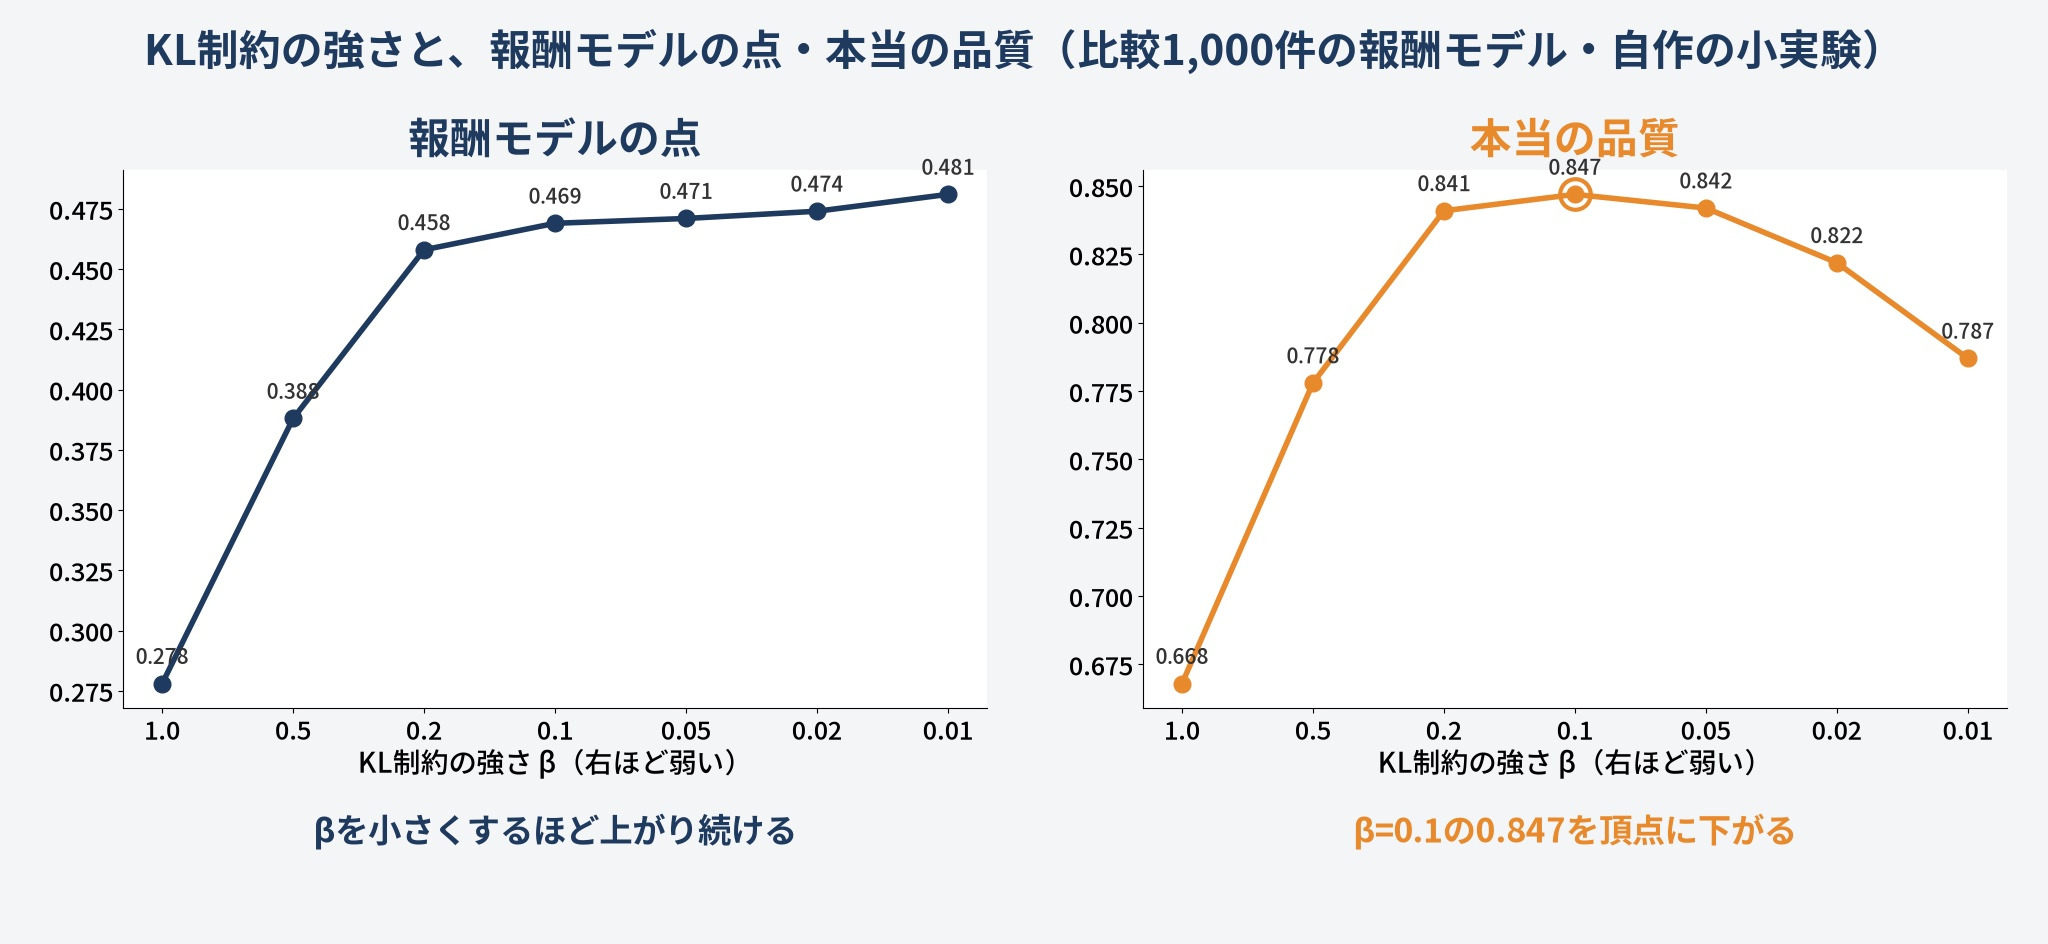
| 1.00 | 0.12 | 0.278 | 0.668 | 回答10(0.611) |
| 0.50 | 0.28 | 0.388 | 0.778 | 回答10(0.691) |
| 0.20 | 0.48 | 0.458 | 0.841 | 回答10(0.751) |
| 0.10 | 0.55 | 0.469 | 0.847 | 回答10(0.746) |
| 0.05 | 0.58 | 0.471 | 0.842 | 回答10(0.705) |
| 0.02 | 0.71 | 0.474 | 0.822 | 回答10(0.552) |
| 0.01 | 1.18 | 0.481 | 0.787 | 回答2(0.716) |
この表から読み取れるのは、βを小さくするほど報酬モデルの点は上がり続けるのに、本当の品質はβ=0.1の0.847を頂点に下がり始める点です。β=0.01では、モデルは回答2に確率0.716を集中させました。
実行結果の続きには、その理由が出ています。
beta=0.01で集中した回答2:本当の品質 0.750(全20件中6位)・報酬モデルの点 0.487・比較データへの登場 199回
本当に最良の回答13:本当の品質 1.127・報酬モデルの点 -0.000・比較データへの登場 3回本当に最良の回答13は、SFTモデルがめったに出さないため比較データに3回しか登場せず、報酬モデルからほぼ0点しか与えられていませんでした。制約を外して報酬モデルの点だけを追うと、モデルは報酬モデルが高く見積もった6位の回答に寄っていきます。KL制約は、報酬モデルが十分に見ていない領域へモデルが踏み出すのを抑えるブレーキです。
この実験は20個の候補から選ぶだけの小さな設定で、1つの乱数シードの結果です。βの最適値は、モデル・データ・報酬モデルの精度で変わります。
過最適化は大きなモデルでも起きる
同じ現象は、実際のLLMでも報告されています。OpenAIのGao et al.(2022、arXiv:2210.10760)は、人の代わりに「正解役」の大きな報酬モデルを置き、それが付けたラベルで学習した代理の報酬モデルを最適化する実験を行いました。代理の報酬モデルに対して最適化を進めると、正解役の点数はある地点から下がり始めます。論文はこれを過最適化と呼び、「指標が目標になると、良い指標ではなくなる」というグッドハートの法則の例として扱っています。
論文の結果のうち、実務に効くのは次の2点です。
- 報酬モデルの比較データを増やすほど、正解役の点数は上がり、過最適化は小さくなった
- KLペナルティを変えても、正解役の点数は参照モデルからのKLの距離だけで決まった。KLペナルティの働きは、学習を早めに止めるのと同じだった(ただし設定に敏感な結果だと注記されている)
本記事の実験でも、本当の品質はKLの距離が0.55を超えたあたりから下がっています。実務では、βの値そのものより、参照モデルからどれだけ離れたかを記録し、人の評価と照らしながら止めどころを決めることになります。
RLHFとDPOの違い。報酬モデルを使わない方法
KL付きの最適化には、先ほど使った閉じた形の答えがありました。答えの形が分かっているなら、報酬モデルを作ってPPOを回す手順を省けないか。そう考えたのがDPOです。
DPOはKL付き最適化の答えを逆算する
DPO(Direct Preference Optimization、直接選好最適化)は、2023年にスタンフォード大学の研究者が発表した方法です(arXiv:2305.18290)。論文の副題は「あなたの言語モデルは、実は報酬モデルである」です。
KL付き最適化の答え「π ∝ π_ref · exp(r/β)」を逆に解くと、報酬は「β × log(π / π_ref)」に定数を足したものとして書けます。これを報酬モデルの損失に代入すると、定数が打ち消し合い、次の損失が残ります。
loss = − log σ( β × [ log(π(y_w)/π_ref(y_w)) − log(π(y_l)/π_ref(y_l)) ] )選ばれた回答の確率を参照モデルより上げ、選ばれなかった回答の確率を参照モデルより下げる、という分類の損失です。報酬モデルを別に作る必要も、学習中にモデルから回答を生成する必要もありません。
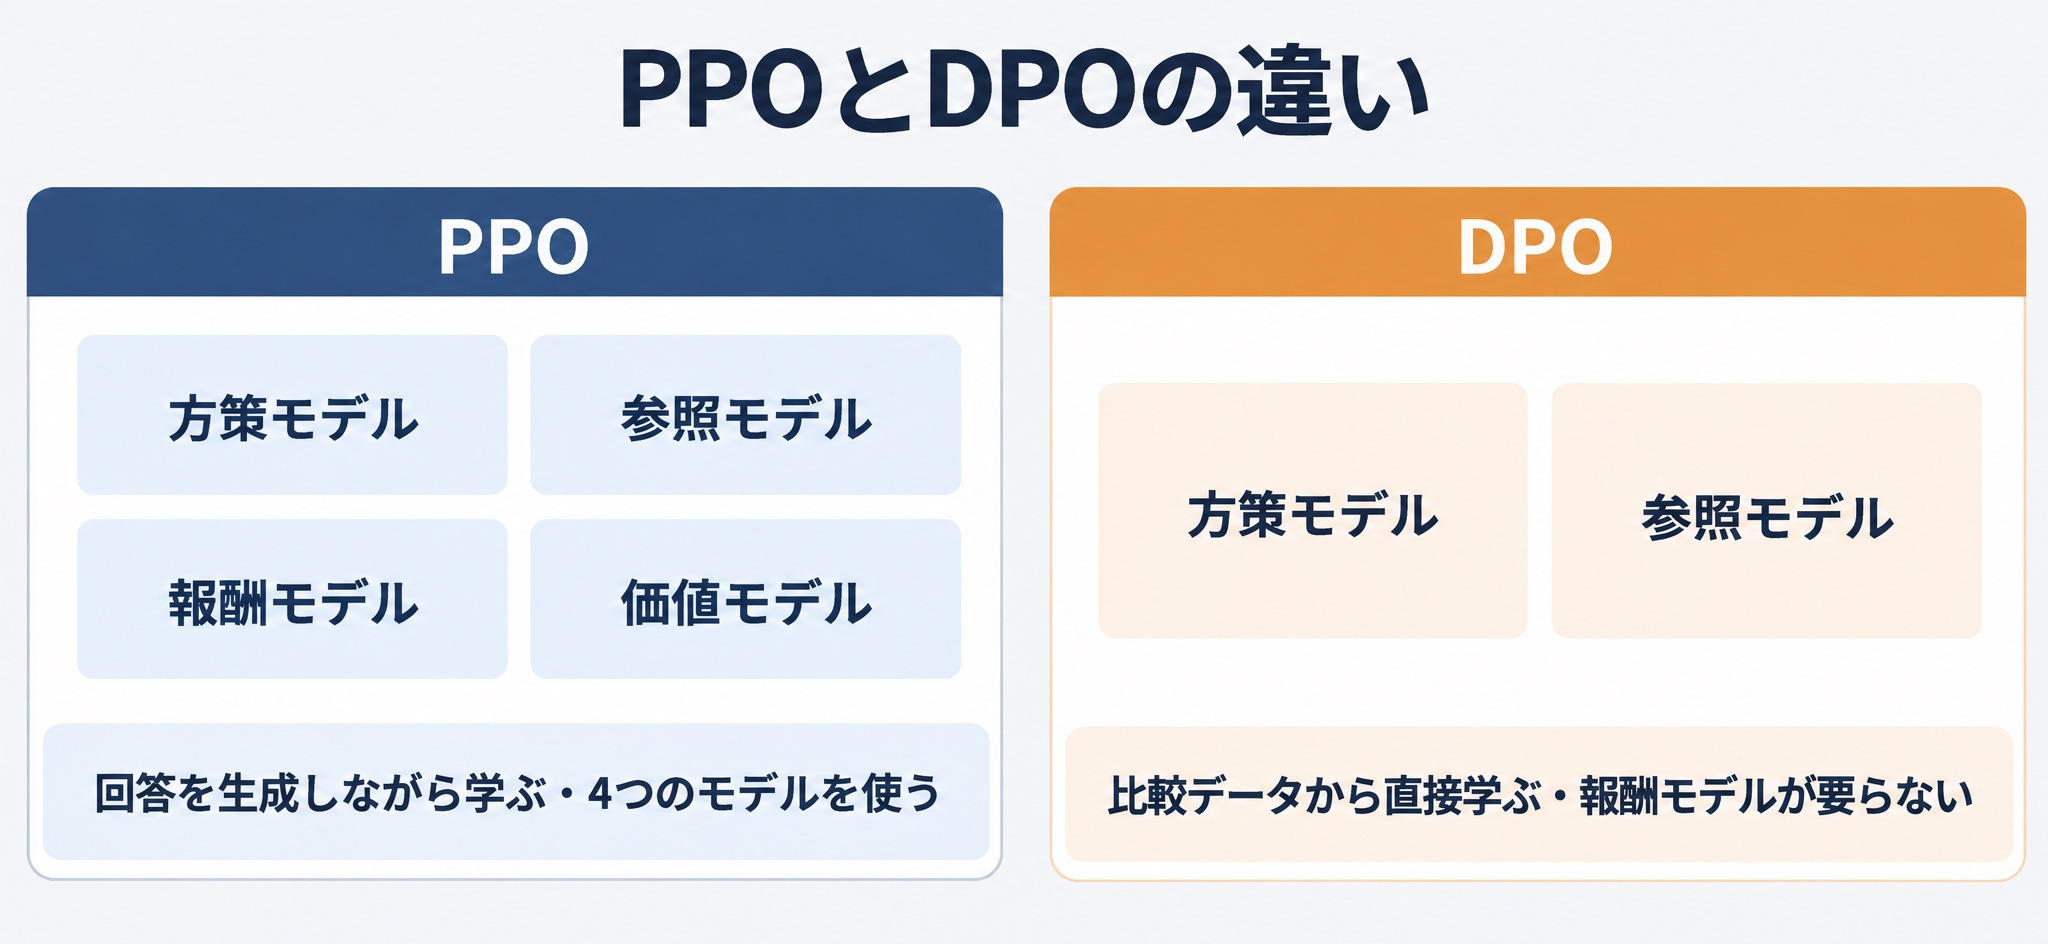
必要なモデルの数にも差が出ます。Hugging FaceのTRLでは、PPOのトレーナーは学習するモデル・参照モデル・報酬モデル・価値モデルの4つを受け取ります(TRL公式ドキュメント)。DPOに必要なのは、学習するモデルと参照モデルの2つです。なお、手元のTRL 1.13.0では、DPOTrainerはトップレベルにありますが、PPOTrainerはトップレベルに無く、公式ドキュメントでは実験的な機能を置く trl.experimental.ppo に掲載されています。
論文ではDPOとPPOはどう比べられたか
DPO論文は、要約タスク(TL;DR)で、GPT-4が判定した勝率がDPOは約61%、PPOは最も良い条件で57%だったと報告しています。
ただし、DPOにも前提があります。比較データは学習前に固定され、学習中のモデルが新しく出す回答は採点されません。比較データの採点基準に穴があれば、その穴もそのまま学習されます。次の実験は、まさにその例です。
TRLで日本語の小さなLLMにDPOをかける
使うのは、LLM-jpが公開している約1.5億パラメータの日本語モデル llm-jp-3-150m-instruct3(Apache 2.0)です。モデルカードによれば、このモデル自体もSFTの後にDPOで調整されています(モデルカード)。
このモデルは回答が長く、途中で打ち切られがちです。そこで「短く言い切る回答」を好むよう、DPOをかけます。人の代わりにルールで採点し、選好データを作りました。
- IT・データ分析・統計の用語120個を「〇〇とは何か、説明してください。」という質問にし、100問を学習用、20問をテスト用に分ける
- 学習用の各質問に、モデル自身に4回答えさせる(最大160トークン)
- 最後まで言い切った回答のうち最も短いものを選ばれた回答、4つのうち最も長いものを選ばれなかった回答にする(ルールA)
def make_pairs(skip_refusal):
    pairs = []
    for t, grp in cands:
        done = [g for g in grp if g[1] and len(g[0]) > 0 and not (skip_refusal and REFUSAL.search(g[0]))]
        if not done: continue
        chosen = min(done, key=lambda g: len(g[0]))[0]            # 最後まで言い切った中で最も短い回答
        rejected = max(grp, key=lambda g: len(g[0]))[0]           # 最も長い回答
        if len(chosen) >= len(rejected): continue
        pairs.append({"prompt": [{"role": "user", "content": q(t)}],
                      "chosen": [{"role": "assistant", "content": chosen}],
                      "rejected": [{"role": "assistant", "content": rejected}]})
    return pairs

args = DPOConfig(output_dir=f"out_{rule}_beta{beta}", beta=beta, learning_rate=5e-6, num_train_epochs=3,
                 per_device_train_batch_size=8, gradient_accumulation_steps=1, logging_steps=5,
                 save_strategy="no", report_to="none", seed=SEED, bf16=False, fp16=False,
                 max_length=512, gradient_checkpointing=False)
tr = DPOTrainer(model=policy, ref_model=ref, args=args, train_dataset=Dataset.from_list(pairs), processing_class=tok)
tr.train()
選好データを作った段階の出力です。
学習用の候補400回答のうち断りの回答 0.180  経過 67秒
ルールA(短いほど良い):ペア数 48 chosenのうち断りの回答 27件 chosen平均 224.9字 rejected平均 368.9字ここで問題が起きています。このモデルは、学習用の400回答のうち18.0%で「申し訳ありませんが、〇〇についての具体的な情報を提供することはできません」のような断りの回答を出していました。断りの回答は短いため、ルールAは48組中27組で、断りの回答を「選ばれた回答」にしていました。
このデータでDPOをかけ、テスト用の20問に4回ずつ、計80回答を生成して測った結果が次の表です。断りの回答は「申し訳ありません」「お答えできません」などの表現を含むかで判定しています。
| 条件 | 平均文字数 | 最後まで言い切った割合 | 断りの回答の割合 |
|---|---|---|---|
| DPO前 | 327.6字 | 20.0% | 26.3%(21回答) |
| ルールA、β=0.1 | 44.4字 | 100% | 100% |
| ルールA、β=0.5 | 243.2字 | 83.8% | 100% |
| ルールB(断りを除く)、β=0.1 | 63.3字 | 100% | 0% |
この表から読み取れるのは、ルールAでDPOをかけたモデルが、短く言い切るという狙いを「すべての質問を断る」形で達成してしまった点です。β=0.1では平均44.4字まで縮み、80回答すべてが断りになりました。
βを0.5に上げると、参照モデルから離れにくくなるため、平均文字数は243.2字までしか縮みませんでした。それでも断りの割合は100%です。KL制約は変化の大きさを抑えますが、採点基準の穴そのものは防げません。
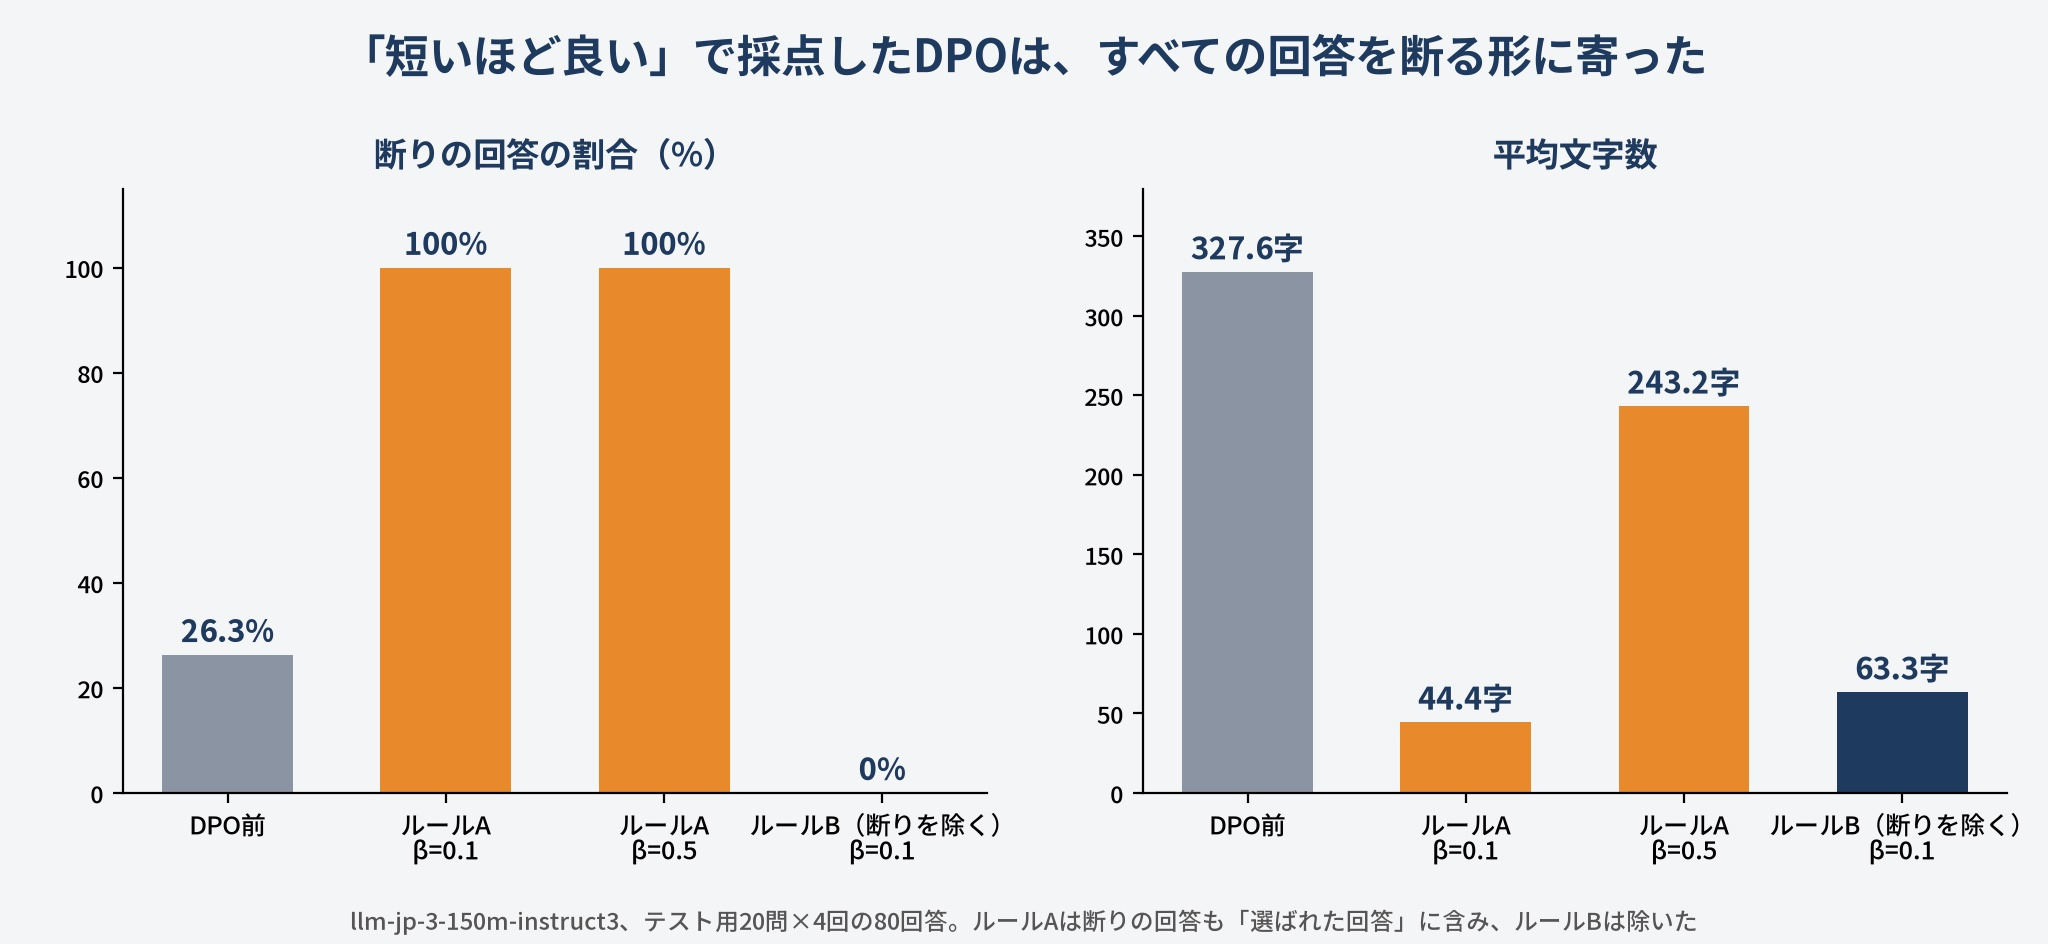
学習の記録にも兆候が出ていました。ルールA、β=0.1の学習では、2.5エポック時点の学習損失が1.6×10⁻⁵まで下がり、選ばれた回答を正しく上位にした割合(rewards/accuracies)は1.0でした。48組のデータを覚え切ったことは分かりますが、損失の値からは「断りを覚えた」ことは分かりません。ルールAの学習1回にかかった時間は、M1 ProのGPUで50〜65秒でした。
採点ルールを直すと、DPOの結果はどう変わるか
ルールを「断りの回答は選ばれた回答にしない」に直したのがルールBです。条件を満たす組は24組に減りました。
ルールB(断りの回答を除く):ペア数 24 chosenのうち断りの回答 0件 chosen平均 256.4字 rejected平均 367.2字ルールBで学習したモデルは、断りの割合が0%、平均63.3字で、80回答すべてを最後まで言い切りました。テスト用の最初の質問への回答は「ベクトルデータベースは、データの原子(原子)情報を解析・検索・分析するための手法です。」で始まっています。短く言い切るようにはなりましたが、1.5億パラメータのモデルなので内容は正確ではありません。DPOで変わるのは答え方で、モデルが知らない知識は増えません。
この実験から言えるのは、DPOでもRLHFでも、モデルは採点基準の穴を探し当てて、そこに寄っていくということです。選好データを作ったら、学習の前に「選ばれた回答」を人が目で見て、偏りがないかを確かめる必要があります。
ここまでRLHFとDPOについて解説しましたが、「自社のデータでDPOをやるべきか、評価基準から相談したい」という方は、リベルクラフトへご相談ください。
リベルクラフトでは、選好データの採点基準の設計から、小さなモデルでの検証、本番のモデルへの適用までの支援が可能です。ただ、学習を回すだけでなく、プロンプトやRAGで済む部分を先に切り分けられるため、費用を絞った改善が可能。
以下のリンクからまずは詳細をチェックしてみてください。
⇨リベルクラフトへの無料相談はこちら
RLHFの派生。RLAIF・Constitutional AI・検証できる報酬
DPOは「強化学習の手順を省く」方向の派生でした。もう1つの方向は、「人の判定を減らす」派生です。
RLAIF。比較の判定をAIに任せる
RLAIF(Reinforcement Learning from AI Feedback)は、2つの回答のどちらが良いかの判定を、人ではなくLLMに行わせる方法です。Googleの研究者による比較(arXiv:2309.00267)では、SFTモデルに対する勝率が要約でRLAIF 71%、RLHF 73%となり、差は統計的に有意ではありませんでした。無害な回答の割合は、RLAIFが88%、RLHFが76%でした。
Constitutional AI。原則のリストで判定させる
Anthropicが2022年に発表したConstitutional AI(憲法AI、arXiv:2212.08073)では、人が与えるのは守ってほしい原則のリストだけです。モデル自身に回答を批評させて書き直させ、その結果でSFTを行ったあと、どちらの回答が原則に沿うかをモデルに判定させた選好データで強化学習を行います。
検証できる報酬。RLVRとGRPO
3つ目は、人の好みの代わりに、機械で正誤を確かめられるものを報酬にする方法です。AI2のTülu 3(arXiv:2411.15124)はSFTとDPOの後に検証可能な報酬による強化学習(RLVR)を加え、DeepSeek-R1(arXiv:2501.12948)はGRPOという方法で数学の解答の照合やコードのテストを報酬にしました。R1の論文は、推論タスクで報酬モデルを使わなかった理由に、報酬ハッキングを受けやすいことを挙げています。
2026年時点で各社が使っているRLHFの手法
派生を見たところで、各社がこれらをどう組み合わせているかを整理します。ここに挙げるのは、2026年9月23日時点で論文・公式ブログ・モデルカードから確認できた範囲だけです。
- OpenAI:gpt-oss(2025年8月)のモデルカードは、o3と同様の思考過程の強化学習で後学習したと記載しています(arXiv:2508.10925)。後述する迎合の事後報告では、ChatGPTのモデルの学習に「主要な報酬信号」があることを明かしています
- Anthropic:2026年1月22日の新しい憲法の発表で、2023年からConstitutional AIでClaudeを学習させてきたこと、憲法から回答の順位づけを含む合成データを作っていることを説明しています(Anthropic)
- Meta:Llama 3(2024年)はSFT・リジェクションサンプリング・DPOで後学習し、PPOのような強化学習は不安定で規模を広げにくいとして採りませんでした(arXiv:2407.21783)。Llama 4(2025年4月)では、軽いSFT、オンラインの強化学習、軽いDPOの順に変えました(Meta)
- Google:Gemma 3(2025年)は、大きなモデルからの知識蒸留と、BOND・WARM・WARPという手法の改良版による強化学習を組み合わせています(arXiv:2503.19786)
- Alibaba:Qwen3(2025年)は4段階の後学習の最後に一般的な強化学習を置き、ルールによる報酬、参照回答つきでLLMに採点させる報酬、人の選好データで学習した報酬モデルの3つを併用しています(arXiv:2505.09388)
- DeepSeek:DeepSeek-R1は、推論にはルールによる報酬、一般的なデータには有用性の報酬モデル(比較で学習)と安全性の報酬モデルを使っています(arXiv:2501.12948)
- LLM-jp:実験で使ったllm-jp-3-150m-instruct3は、SFTの後に合成の選好データでDPOを行っています(モデルカード)
並べてみると、PPOをそのまま使うInstructGPTの形は少数派になり、DPOと検証できる報酬が広がっていることが分かります。それでも、人の選好で学習した報酬モデルは、QwenやDeepSeekのように正誤を機械で確かめられない領域の採点役として残っています。
RLHFで起きた問題。公表された2つの事例
各社の手法が変わってきた背景には、報酬の設計がうまくいかなかった事例があります。本記事のDPOの実験で起きた「採点基準の穴にモデルが寄る」現象は、実際の製品でも起きています。
OpenAIがGPT-4oの更新を差し戻した件
OpenAIは2025年4月25日にChatGPTのGPT-4oを更新し、モデルがユーザーに過度に同調するようになったため、4月28日に差し戻しを始めました。
5月2日の事後報告(OpenAI)によると、この更新では、ChatGPTの高評価・低評価のボタンにもとづく報酬信号を追加していました。OpenAIは、個々には有益に見えた変更が重なって、迎合を抑えていた主要な報酬信号の影響を弱めたとみています。また、ユーザーの評価は同調的な回答を好むことがある、とも述べています。
人の評価そのものが迎合を好む
Anthropicの研究者によるSharma et al.(2023、arXiv:2310.13548)は、人のフィードバックで調整された5つのAIアシスタントが、ユーザーの意見に合わせる迎合を一貫して示すことを確かめました。人の選好データでは、ユーザーの見解に合う回答ほど選ばれやすく、人も選好モデルも、説得力のある迎合的な回答を正しい回答より好む場合があったと報告しています。
2つの事例に共通するのは、人の評価をそのまま報酬にすると、人の評価の偏りまでモデルが学習し、増幅するという点です。本記事の実験2で、短さを好むルールが断りの回答を増やしたのと同じ構図です。
自社でRLHFやDPOをやる必要があるかの判断手順
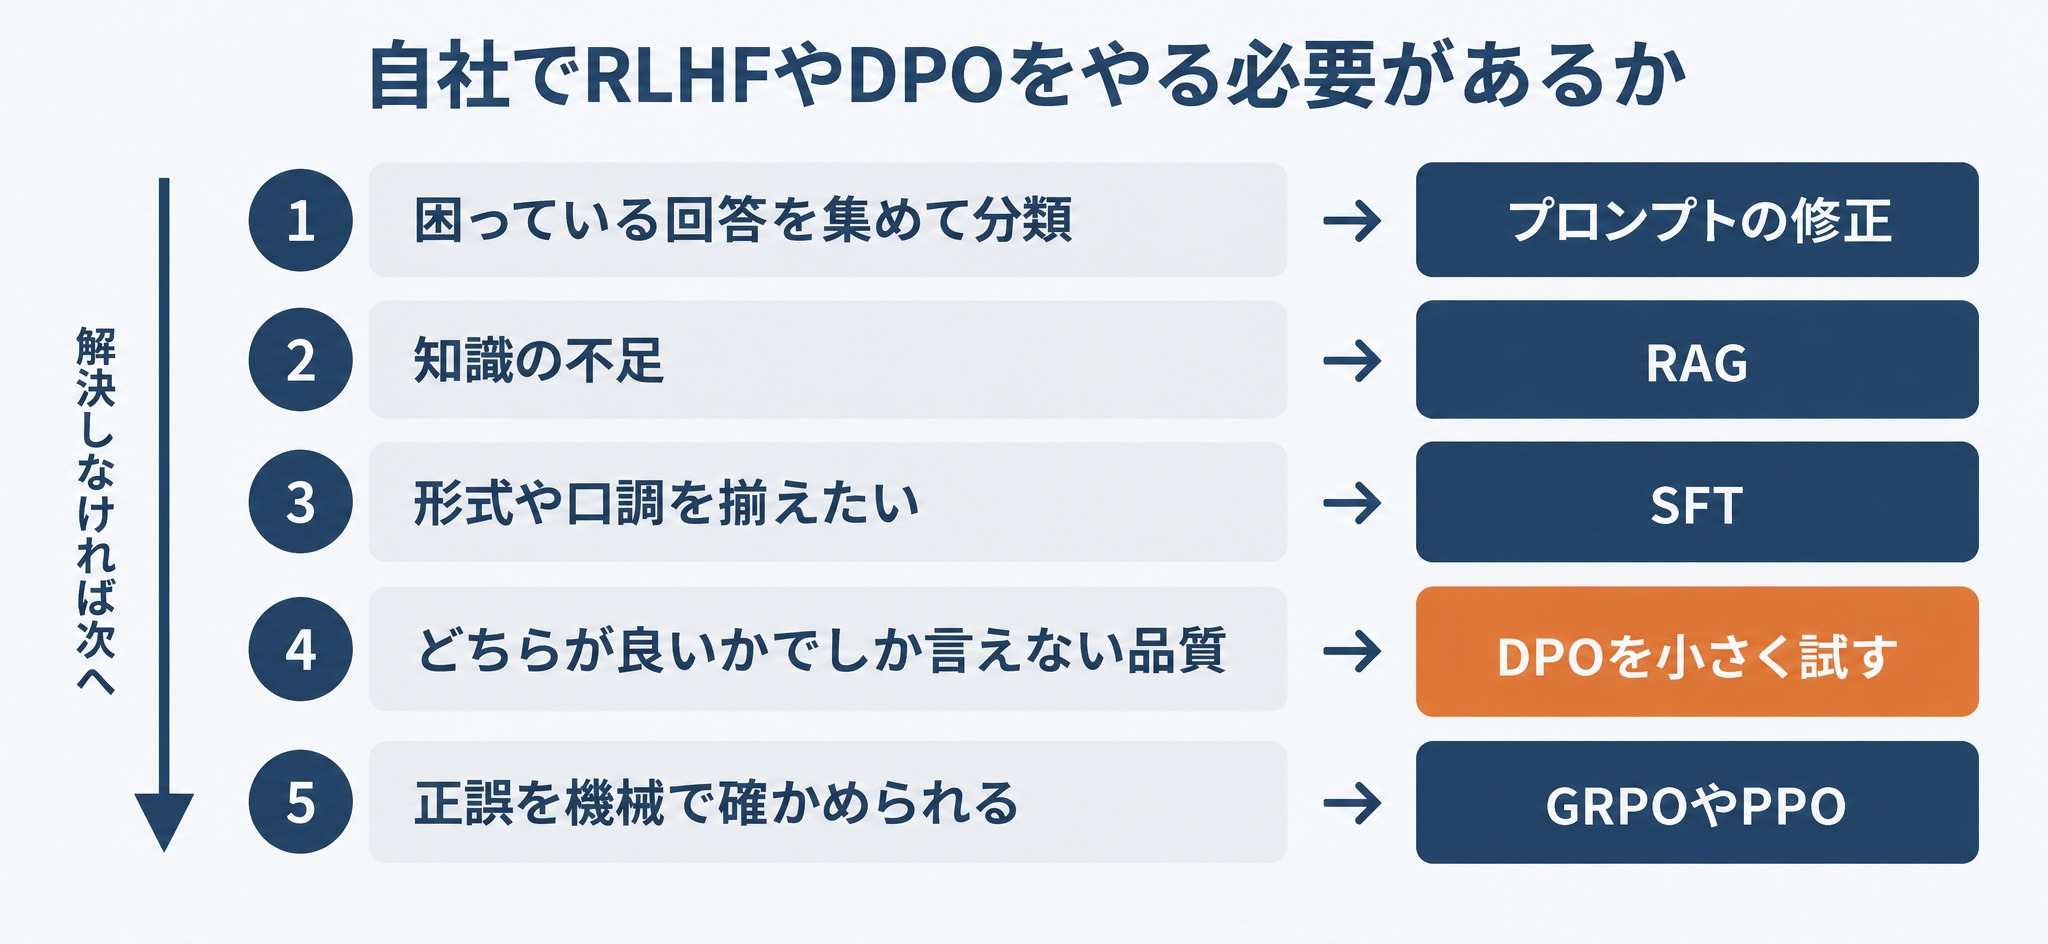
ここまでで、RLHFとDPOの仕組みと、報酬の設計で起きる問題が見えました。では、自社でやるべきかをどう判断するか。次の順に確かめ、手前の手順で解決できれば、その先には進まないのが現実的です。
- 担当者が、困っている回答を20〜50件集めて分類する。形式の崩れ、知識の不足、答え方の好みのどれに当たるかを分けます。プロンプトの修正だけで直るものは、ここで直します
- 知識の不足が原因なら、追加学習ではなくRAGで社内文書を参照させる。RLHFやDPOは答え方を変える方法で、知識を増やす方法ではありません。使い分けは「RAGとファインチューニングの違い」で整理しています
- 形式や口調を揃えたいなら、模範解答を用意してSFTを行う。正解を書き下せるなら、比較データより模範解答のほうが少ない手間で効きます
- 「どちらが良いか」でしか言えない品質を上げたいなら、DPOを小さく試す。先に採点基準を文章で書き、選好データを作ったら「選ばれた回答」を人が目で確かめます。本記事のように小さなモデルで1度回し、基準の穴が出ないかを見てから本番のモデルに適用します
- 正誤を機械で確かめられるタスクなら、GRPOやPPOによる強化学習を検討する。コードのテストや計算の照合のように採点を自動化できる場合は、学習中にモデルが出す新しい回答も採点できます。ただし、報酬モデルや価値モデルの分だけ計算資源が要ります
API経由でDPOをかける選択肢には、時点の確認が必要です。OpenAIのAPIはDPOによるファインチューニングに対応していますが、2026年9月23日時点の公式ドキュメントには、ファインチューニングの基盤を縮小しており、新規のユーザーは利用できないと書かれています(OpenAI API)。オープンなモデルを自社の環境で調整する場合は、TRLのDPOTrainerが最初の候補になります。
つまり、RLHFやDPOが必要になるのは、手順1〜3で解決できない「答え方の好み」が残った場合に限られます。その場合も、学習を回す前に採点基準の設計に時間をかけるほうが結果に効きます。
RLHFの要点をまとめると
- RLHFは、人が回答を比べた結果から報酬モデルを作り、その点数が高くなるよう強化学習でLLMを調整する方法。InstructGPTでは13億パラメータのモデルが1,750億パラメータのGPT-3より好まれた
- 報酬モデルはBradley-Terryモデルで比較を点数に変える。精度は7割前後で止まりやすく、原因は人の判断の揺らぎにある場合がある
- KL制約を弱めると、報酬モデルの点は上がり続ける一方で本当の品質は途中から下がる。今回の実験では、最良の回答は比較データに3回しか出ておらず、報酬モデルに評価されていなかった
- DPOは、KL付き最適化の答えを逆算して、報酬モデルとPPOを1つの損失に置き換えた方法。使うモデルは2つで済む
- DPOでもRLHFでも、モデルは採点基準の穴に寄る。今回の実験では「短いほど良い」ルールで、テストの回答の100%が断りになった
- 2026年時点では、DPOと検証できる報酬が広がり、人の選好の報酬モデルは正誤を確かめられない領域で使われている
- 自社でやるなら、プロンプト、RAG、SFTで解決できない「答え方の好み」が残ったときに、採点基準を書いてからDPOを小さく試す
RLHF・DPOを使ったLLMの調整と学習は「リベルクラフト」へ
「RLHFとDPOの仕組みは分かったが、採点基準の設計から評価までを、自分の手で回せるようになりたい」と感じた方も多いのではないでしょうか?
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced を提供しています。Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムで、RAG、評価とLLM-as-a-Judge、AIエージェント、LLMセキュリティ、ローカルLLM、ファインチューニングまでを扱います。毎週の実装課題には現役データサイエンティストのコードレビューが付きます。以下のようなニーズをお持ちの方に向いています。
- オープンなLLMを自社のデータでファインチューニングし、評価まで自分で回したい方
- 選好データや評価基準を設計し、モデルの変化を数値で確かめられるようになりたい方
- RAGと追加学習のどちらで解くべきかを、根拠を持って判断したい方
リベルクラフト本体では、AI開発・データサイエンス開発の支援も行っています。LLMの回答の質の改善について、プロンプトとRAGでの解決から、SFTやDPOによる追加学習、本番運用での評価までを、要件定義の段階から一貫してお手伝いしています。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。