コンテキストエンジニアリングとは?プロンプトとの違いと4つの手法を実測で解説
Python標準ライブラリのファイルを15本読んで比較するだけのAIエージェントを、台本どおりに動かしてトークン数を数えました。1回目のLLM呼び出しに載っていたのは355トークンでしたが、最後の18回目には121,955トークンまで膨らみました。18回の呼び出しで送った入力を合計すると766,303トークンです。答えの根拠になる1行は、先頭から約1,300トークンの位置にあり、その後ろに12万トークンが積まれていました。
AIエージェントを長く動かすと、応答が遅くなり、費用が増え、途中で読んだはずの内容を取りこぼすようになります。システムプロンプトの言い回しを直しても、この症状はほとんど変わりません。原因が指示文ではなく、呼び出しのたびにモデルへ渡している情報の量と中身にあるからです。この設計を扱う分野が、コンテキストエンジニアリングです。
本記事の数値は、すべて実際にコードを実行して得た出力です。実行環境は Apple M1 Pro のノートPC、Python 3.13.13、tiktoken 0.14.0(エンコーディング o200k_base)、実行日は2026年9月23日です。外部のAPIは呼ばず、ローカルでトークン数だけを数えています。
そこで本記事では、
- コンテキストエンジニアリングとは何か。プロンプトエンジニアリングと何が違うのか
- AIエージェントで、コンテキストが肥大化し劣化するのはなぜか
- コンテキストを書き出す・選ぶ・圧縮する・分けるという4つの分類と、それぞれに属する具体的な手法
- 4つの分類から1つずつ選んだ手法で、トークン数がどれだけ変わり、何を失うのか(実測)
- 自分のエージェントに、どの順番で手法を入れるか
- 入れるときに気を付けること
を解説します。LLMのAPIやエージェントの実装を業務で触っている方は、ぜひ最後までご覧ください。
AIエージェントの精度やコストの問題を、どこから直すか1人で判断していて、相談できる相手が社内にいないという方は、リベルクラフトへご相談ください。
⇨リベルクラフトへの無料相談はこちら
コンテキストエンジニアリングとは。LLMに渡す情報を呼び出しごとに選ぶ設計
コンテキストエンジニアリングは、2025年の半ばからAIエージェントの開発者のあいだで広く使われるようになった言葉です。まず定義を一次情報で確かめ、プロンプトエンジニアリングとの関係を整理します。
コンテキストエンジニアリングの定義
Anthropicは2025年9月29日に公開した記事「Effective context engineering for AI agents」で、次のように定義しています。
- コンテキストとは、LLMが出力を生成するときに入力として含まれるトークンの集合である
- コンテキストエンジニアリングとは、LLMの推論のあいだ、最適なトークン(情報)の集合を選び、維持するための戦略の集まりであり、プロンプト以外にコンテキストへ入るすべての情報を含む
同じ記事は、良いコンテキストエンジニアリングの指針を「望む結果が得られる確率を最大にする、最小で信号の強いトークンの集合を見つけること」とまとめています。情報を足す作業と同じくらい、減らす作業を重視している点が特徴です。
この言葉が広まったきっかけとしてよく引かれるのが、Andrej Karpathy氏の2025年6月の投稿です。LangChainの公式ブログ「Context Engineering」は、その一節「次のステップのために、ちょうど必要な情報でコンテキストウィンドウを満たす、繊細な技術であり科学」を定義として引用しています。コンテキストウィンドウとは、モデルが1回の呼び出しで参照できるテキストの範囲のことです。
LangChainの公式ドキュメント「Context engineering in agents」は、エージェントが失敗する理由を2つに分けています。モデルの能力が足りない場合と、正しいコンテキストが渡されていない場合で、多くは後者だと書いています。
プロンプトエンジニアリングとの違い
Anthropicは、コンテキストエンジニアリングを「プロンプトエンジニアリングの自然な発展」と位置づけています。プロンプトエンジニアリングが不要になったわけではなく、プロンプトはコンテキストの一部で、その外側まで設計の対象を広げたものです。違いを表にまとめます。
| 比較軸 | プロンプトエンジニアリング | コンテキストエンジニアリング |
|---|---|---|
| 設計する対象 | 指示文(特にシステムプロンプト) | 指示文に加え、ツール定義・会話履歴・検索結果・ツールの実行結果・メモなど、1回の呼び出しに載る情報のすべて |
| 作業のタイミング | 書いて試す、を事前に繰り返す | エージェントが動いているあいだ、呼び出しのたびに何を載せるかを決め直す |
| 主な問い | どう書けば意図が伝わるか | 何を載せ、何を外し、何を後で取りに行かせるか |
| 失敗の現れ方 | 指示の誤解、出力形式の崩れ | 長時間の実行での精度低下、コストと遅延の増加、途中の情報の取りこぼし |
この表から読み取れるのは、両者の差が「書き方」と「載せ方」の違いであることです。1問1答のチャットならプロンプトの工夫で足りることが多く、何十回もツールを呼ぶエージェントになると、載せ方の設計が結果を左右します。
コンテキストに入るもの。指示・ツール・履歴・取得した情報
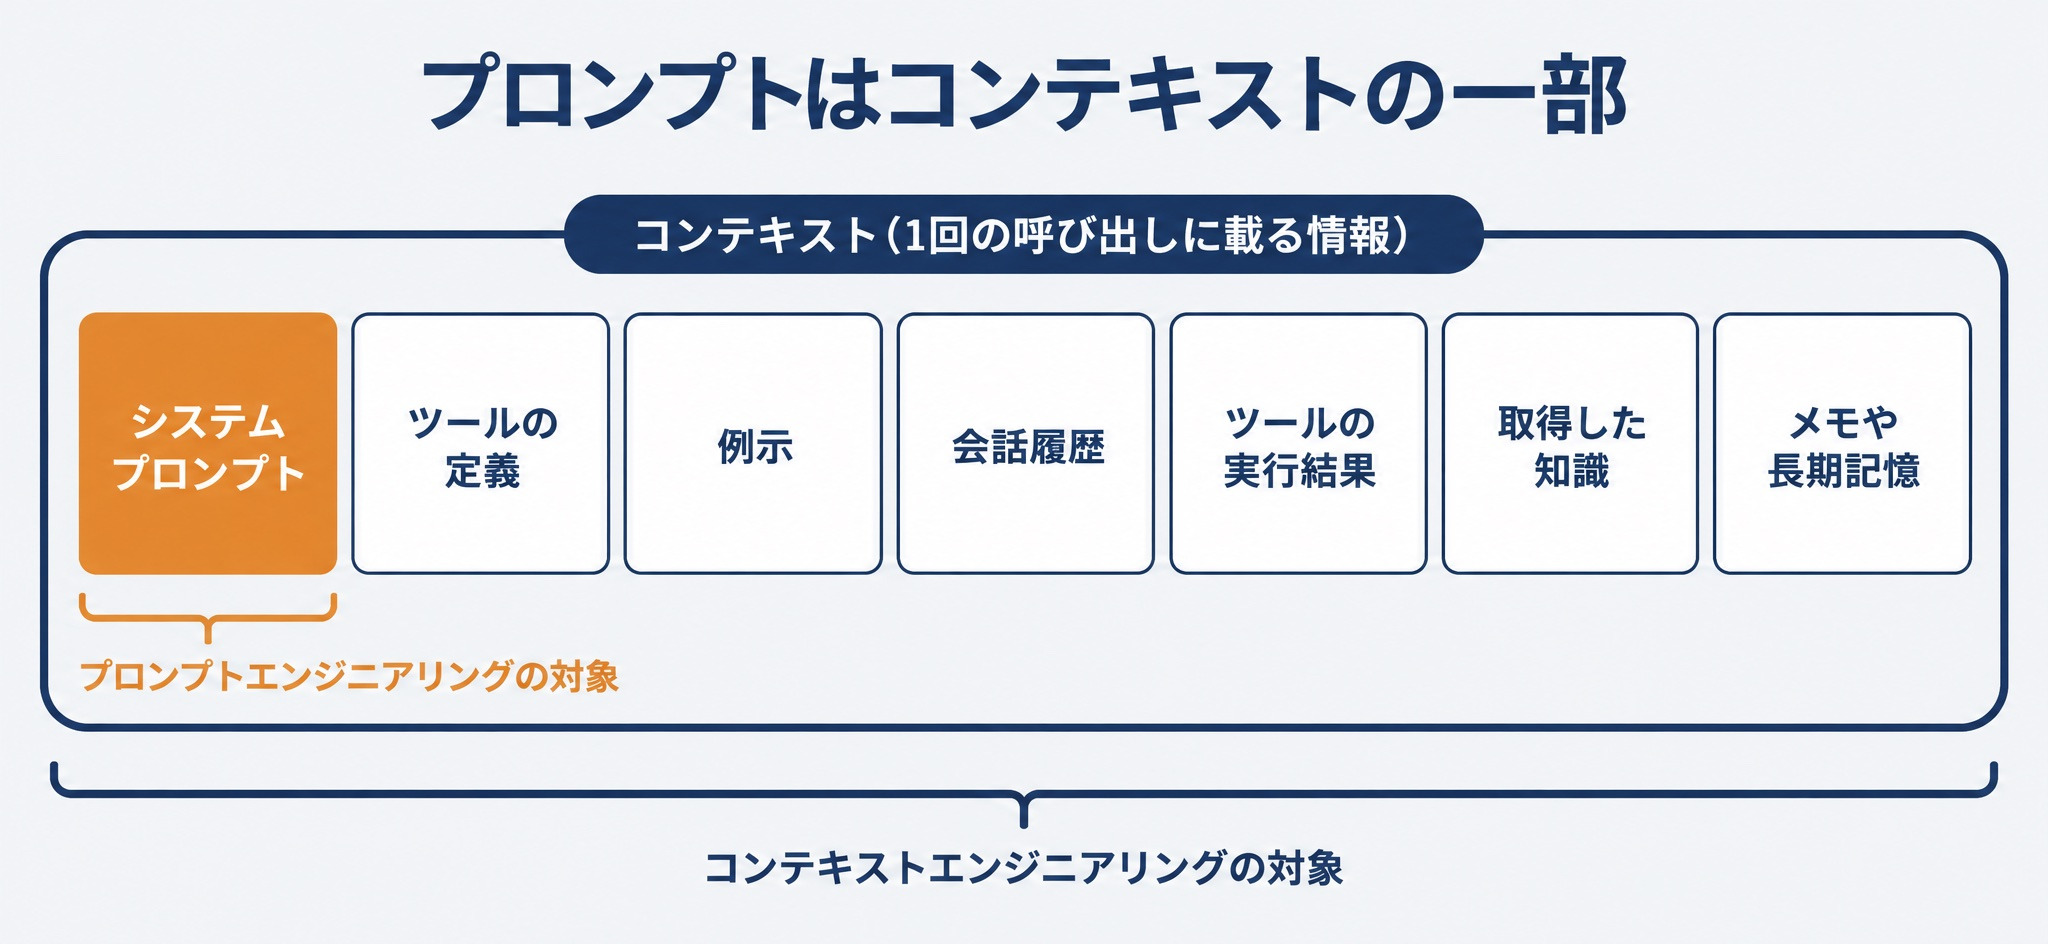
1回のLLM呼び出しのコンテキストには、次のような情報が入っています。
- システムプロンプト:役割・手順・禁止事項などの指示
- ツールの定義:使える関数の名前・説明・引数の型。ツールを増やすほど、呼び出しのたびに載るトークンが増えます
- 例示(few-shot):期待する出力の見本
- 会話履歴:ユーザーとのやり取りと、エージェント自身のこれまでの発言
- ツールの実行結果:ファイルの中身、検索結果、APIの応答など。エージェントではここが最も大きくなりやすい部分です
- 取得した知識:RAG(外部の文書を検索して回答に使う仕組み)で取ってきた文書
- メモや長期記憶:過去のセッションから引き継いだ情報
MCP(Model Context Protocol)でツールをつなぐ場合も、ツールの定義と結果はこのコンテキストに載ります。MCPの仕組みは「MCPとは」で解説しています。
つまり、コンテキストエンジニアリングで扱うのは、この一覧のすべてを、呼び出しごとにどれだけ載せるかという判断です。
AIエージェントでコンテキストが肥大化し、劣化する理由
定義で「選ぶ」と書きましたが、選ばずに放っておくと何が起きるのかを先に確かめます。AIエージェントでは、コンテキストは放っておくと増え続け、増えるほど中身を使いにくくなります。
ループのたびにツール結果が積み上がる
AIエージェントは、LLMの呼び出しとツールの実行を交互に繰り返します。LLMがツールを呼ぶと決め、アプリがツールを実行し、その結果を会話履歴に足して、次の呼び出しでまたLLMに渡します。ツールの結果は、何もしなければ最後まで履歴に残ります。
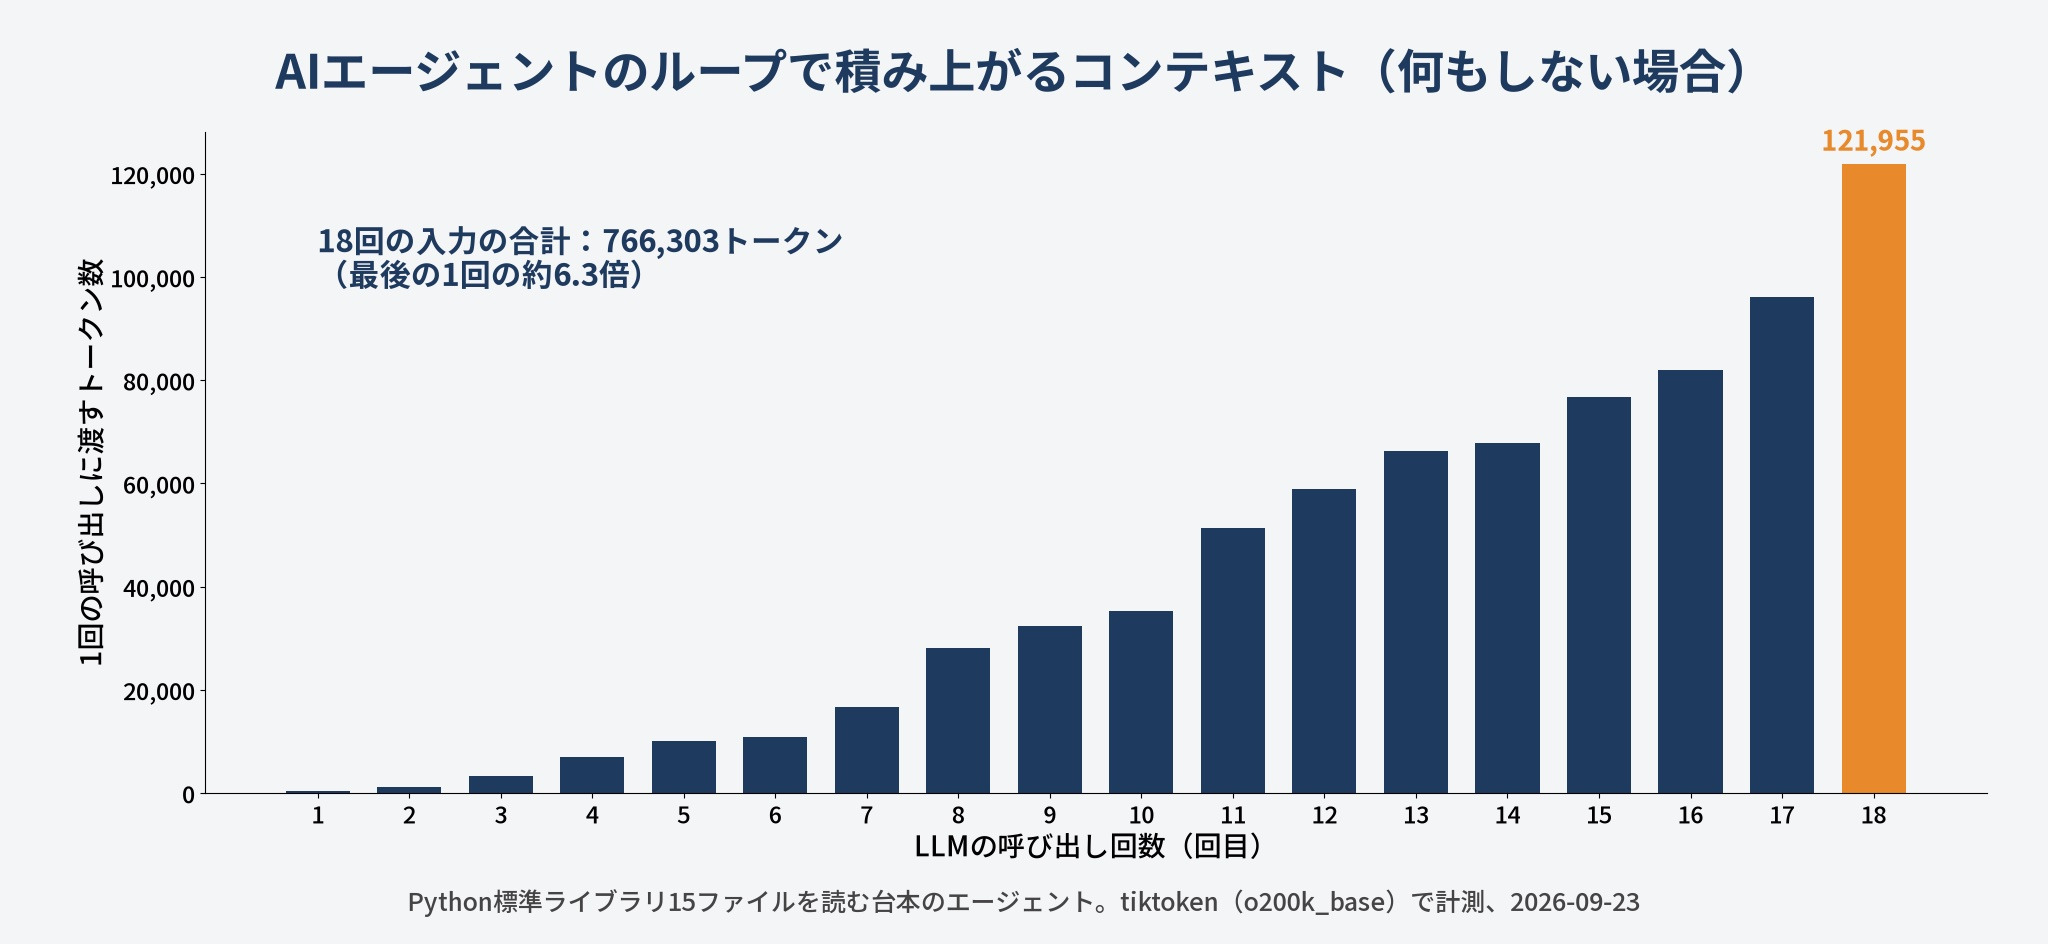
冒頭の測定では、次のように増えました。エージェントは「行番号と列番号つきの例外を出すモジュールを調べて比較する」という課題を受け、ディレクトリ一覧とgrepのあとに標準ライブラリを15ファイル読みます。
- 1回目の呼び出し:355トークン(システムプロンプト・ツール定義・課題文だけ)
- 8回目(6ファイル目を読む前):28,087トークン
- 17回目(15ファイル目を読む前):96,176トークン
- 18回目(最終回答を書く呼び出し):121,955トークン
読んだファイルの合計は118,277トークンなので、最後の呼び出しはほぼ全ファイルを抱えた状態です。しかも費用と遅延に効くのは最後の1回だけではありません。18回の呼び出しで送った入力の合計は766,303トークンで、最後の1回の約6.3倍です。履歴が伸びるほど、それ以降のすべての呼び出しが重くなるため、合計は手順の数に対して2乗に近い形で増えます。
長くなるほど、中にある情報を使えなくなる
量が増えることより厄介なのは、長いコンテキストの中にある情報を、モデルがうまく使えなくなることです。この現象は context rot(コンテキストの劣化)と呼ばれています。
Claudeの公式ドキュメント「Context windows」は、コンテキストウィンドウがモデルによって最大100万トークンあることを示したうえで、「コンテキストは多いほど良いわけではない。トークン数が増えると精度と想起が落ちる」と書いています。Anthropicの前掲記事は、この傾向は程度の差はあってもすべてのモデルに現れるとし、コンテキストを「限りがあり、足すほど効果が逓減する資源」として扱うよう勧めています。
根拠になっている研究を2つ挙げます。
- Chroma の「Context Rot」(2025年7月):18のLLMで、課題の難しさを固定したまま入力の長さだけを変えて評価しました。会話の記憶を問う LongMemEval では、答えに必要な部分だけの入力(平均約300トークン)と、無関係な部分を含む全体(平均約113,000トークン)を比べ、すべてのモデルで前者の成績が大きく上回りました
- Liu らの「Lost in the Middle」:関連情報が入力の先頭か末尾にあるときに性能が最も高く、長いコンテキストの中ほどにあると大きく下がることを示しました
冒頭の測定に当てはめると、最後の呼び出しでモデルは、12万トークンのうち答えに要る数行を探し出して使う必要があります。載っていることと、使えることは別だという点が、コンテキストエンジニアリングの出発点です。
コンテキストが壊れる4つのパターン
LangChainの公式ブログは、Drew Breunig氏の整理を引いて、長いコンテキストが失敗する形を4つ挙げています。
- Context Poisoning(汚染):ハルシネーション(もっともらしい誤り)が一度履歴に入ると、以降の判断がその誤りを前提に進みます。誤りが生まれる仕組みは「AIハルシネーションとは」で解説しています
- Context Distraction(注意散漫):履歴が長くなりすぎて、モデルが学習で身につけた判断より、履歴の繰り返しに引きずられます
- Context Confusion(混乱):課題に関係のない情報やツール定義が、応答に影響します
- Context Clash(衝突):コンテキストの中に、互いに矛盾する情報が並びます
4つのうち、Distraction と Confusion は量を減らすことで防ぎやすく、Poisoning と Clash は何を残すかの選び方で防ぎます。次の章の手法は、この2つの軸のどちらか、または両方に効きます。
コンテキストエンジニアリングの主な手法。書き出す・選ぶ・圧縮する・分ける
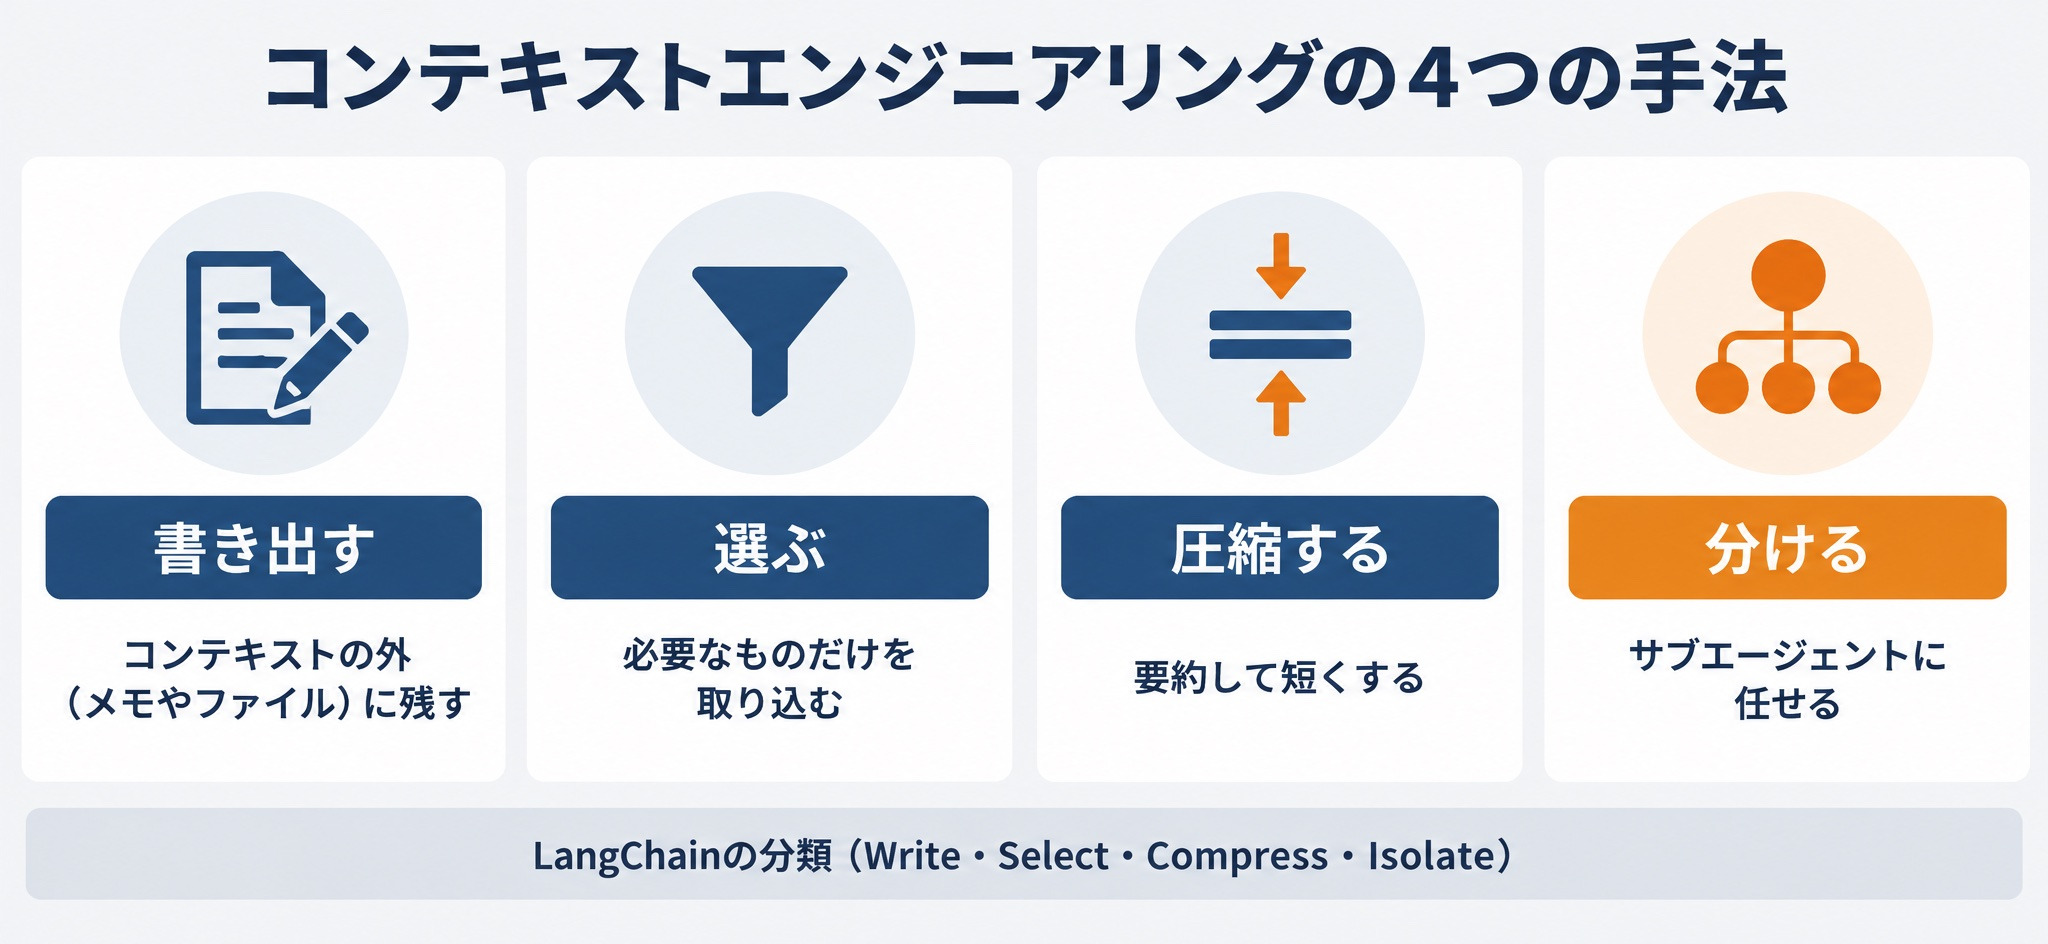
肥大化と劣化の原因が分かったので、打ち手を整理します。LangChainの公式ブログは、手法を Write(書き出す)・Select(選ぶ)・Compress(圧縮する)・Isolate(分ける)の4つに分けています。Anthropicの記事が長時間のタスク向けに挙げる3つの手法(コンパクション・構造化されたメモ・サブエージェント)も、この4分類のどこかに入ります。
選ぶ(Select)。システムプロンプト・ツール・RAGの取捨選択
選ぶとは、呼び出しのたびに、必要な情報だけをコンテキストへ引き込むことです。対象ごとに見ると次のとおりです。
- システムプロンプト:Anthropicは、細かい条件分岐を書き込みすぎた指示と、抽象的すぎて手がかりにならない指示の中間にある「適切な高度」で書くよう勧めています。最小のプロンプトから始め、失敗した箇所に指示や例を足す順番です
- ツール:同じ記事は、機能が重なるツールを並べすぎることを「最もよく見る失敗の1つ」としています。人間のエンジニアでもどれを使うか決められないツールの組み合わせは、エージェントにも決められません
- ツールの実行結果:ファイルを丸ごと返すのではなく、必要な行範囲だけを返すように設計します
- 知識:RAGで取ってきた文書を、上位の数件に絞って渡します。検索結果の妥当性を判定して探し直す設計は「LangGraphでCorrective RAGを実装する記事」で扱っています
Anthropicは、選ぶ手法の一つとして just in time(必要になった時点で取りに行く)取得を勧めています。エージェントはファイルパスやリンクのような軽い識別子だけを持っておき、中身が必要になった時点でツールを使って読み込みます。同社のClaude Codeは、プロジェクトの指示を書いた CLAUDE.md を最初から載せ、それ以外のファイルは glob や grep で探してから読む、という組み合わせで動いていると説明されています。
圧縮する(Compress)。要約とツール結果のクリア
圧縮するとは、タスクに必要なトークンだけを残し、それ以外を減らすことです。代表的な方法は2つあります。
1つ目は要約(コンパクション)です。コンテキストが上限に近づいたら、それまでの履歴を要約し、要約から新しいコンテキストで作業を続けます。Anthropicによると、Claude Codeは設計上の決定・未解決のバグ・実装の細部を残し、重複したツール出力を捨てた要約に、直近に触れた5ファイルを添えて作業を続けます。2026年9月時点のClaude APIでは、サーバー側でClaudeが要約を書く「Compaction」がベータ機能として提供されています。LangChainでは、会話が指定したトークン数を超えると古いメッセージを別のLLM呼び出しで要約し、直近のメッセージはそのまま残す SummarizationMiddleware が用意されています。
2つ目はツール結果のクリアです。すでに処理し終えた古いツール結果を、短いプレースホルダに置き換えます。Anthropicは、これを最も安全で手軽なコンパクションの一つに挙げています。Claude APIの「Context editing」では clear_tool_uses_20250919 という戦略名で提供されており、既定値は次のとおりです(2026年9月23日に公式ドキュメントで確認)。
trigger:入力が100,000トークンを超えたら消し始めるkeep:直近3回分のツール呼び出しと結果を残すexclude_tools:指定したツールの結果は消さないclear_at_least:1回に消す最小のトークン数
要約は情報を言い換えて残し、クリアは情報を捨てます。要約は残す内容をLLMに判断させるぶん柔軟ですが、要約そのものに1回分のLLM呼び出しがかかります。
書き出す(Write)。外部メモリへのメモ
書き出すとは、情報をコンテキストの外に保存し、必要なときに読み戻すことです。Anthropicは「構造化されたメモ」と呼び、エージェントが NOTES.md のようなファイルに進捗・決定事項・未解決の点を書き、コンテキストを空にしたあとで読み返す方法を紹介しています。エージェントがToDoリストを作り、項目を消しながら作業を進める方法も、メモの一種です。
Claude APIには、/memories ディレクトリのファイルを作成・参照・更新・削除して、会話をまたいで情報を保つ「Memory tool」があります。ファイル操作はアプリ側で実行するので、保存先は自分で決められます。LangGraphで作る場合は、状態(state)の中にメモ用の項目を持たせる方法もあります。状態の扱いは「LangGraph入門」で解説しています。
分ける(Isolate)。サブエージェントへの分離
分けるとは、コンテキストを複数に分割することです。代表例がサブエージェントです。メインのエージェントは計画と統合に専念し、調査や探索のような重い作業を、それぞれ空のコンテキストを持つサブエージェントに任せます。
Anthropicは、サブエージェントが数万トークン以上を使って探索しても、メインに返すのは1,000〜2,000トークン程度に絞った要約だと説明しています。探索の途中経過はサブエージェントの中に閉じ込められ、メインのコンテキストには結論だけが入ります。複数のエージェントに仕事を分ける設計は「マルチエージェントとは」、役割分担で動く仕組みは「AIエージェントの仕組み」で解説しています。
手法の比較
ここまでの5つの手法について、それぞれが何を減らし、何を失いやすいかを表で比べます。
| 手法(分類) | 減らすもの | 失いやすいもの | 2026年9月時点で使える機能の例 |
|---|---|---|---|
| 必要な行だけ読む(Select) | ツール結果の量そのもの | 絞り込みの条件から漏れた情報 | ツール側で行範囲・件数を指定させる設計 |
| ツール結果のクリア(Compress) | 古いツール結果 | 消した結果に含まれていた根拠 | Claude API の clear_tool_uses_20250919 |
| 要約(Compress) | 古い履歴全体 | 要約で落ちた細部 | Claude API の Compaction、LangChain の SummarizationMiddleware |
| メモに書き出す(Write) | コンテキストを空にして再開する | メモに書かなかった情報 | Claude API の Memory tool、NOTES.md |
| サブエージェント(Isolate) | メインのコンテキスト | サブエージェントが要約で落とした情報 | サブエージェントを呼ぶツール、LangGraph の複数グラフ |
この表から分かるのは、どの手法も「何かを捨てる」ことで軽くしている点です。捨てたものの中に後で要る情報が混じっていないかが、手法を選ぶときの判断材料になります。
コンテキストエンジニアリングの4つの手法を実測で比べる
手法の地図ができたところで、4つの分類から1つずつ手法を選び、実際にトークン数がどう変わるかを比べます。量が減るかだけでなく、答えの根拠が最後まで残るかも同時に測りました。
測定の条件
- 課題:「Python標準ライブラリで、パースに失敗したときに行番号と列番号つきの例外を出すモジュールを調べ、計算方法を比較する」
- 手順:ディレクトリ一覧、grep、続けて15ファイルを読み、最後に回答を書く。LLMの呼び出しは各手順の直前と最終回答の計18回
- 読むファイル:Python 3.13.13 の標準ライブラリ15本(
json/decoder.py・tomllib/_parser.py・re/_constants.py・email/_header_value_parser.pyなど)。合計118,277トークン - 答えの根拠:
json/decoder.pyの33行目にある列番号の計算式colno = pos - doc.rfind('\n', 0, pos) - 数え方:各LLM呼び出しの直前にコンテキストへ載っているメッセージ本文を、tiktoken の
o200k_baseで数えました。APIが付ける書式分のトークンは含めていません - 環境:Apple M1 Pro(macOS 14.6.1)、Python 3.13.13、tiktoken 0.14.0、実行日2026年9月23日。外部APIは呼んでいません
エージェントの判断はLLMではなく台本で固定しています。また、メモとサブエージェントの要約は、LLMに書かせたのではなく、grepで抜き出した行から機械的に作りました。本物のLLMを使うと、どのファイルを読むか、要約に何を残すかが毎回変わります。ここで測っているのは、同じ作業をしたときにコンテキストの量と中身がどう変わるかという点だけです。
比べた条件は、何もしない場合と4つの手法の計5つです。要約(コンパクション)は要約文を書くLLMの呼び出しが要るため、今回は測っていません。
- 何もしない:すべてのツール結果を残す
- ツール結果のクリア(圧縮する):Claude APIの既定値にそろえ、入力が100,000トークンを超えたら直近3件以外のツール結果をプレースホルダに置き換える。閾値30,000トークンの場合も測る
- 必要な行だけ読む(選ぶ):grepで当たった行の前後5行だけを返す
- メモに書き出す(書き出す):5ファイル読むごとにメモを書き、コンテキストをメモだけにして再開する
- サブエージェント(分ける):15ファイルを4グループに分けて4つのサブエージェントに読ませ、メインはそれぞれの要約だけを受け取る
条件2のクリアは、次の関数で実装しました。実際に実行したスクリプトからの抜粋です。
def run_linear(steps, clear=None):
    """全部残す。clear=(trigger, keep) なら古いツール結果をプレースホルダに置き換える"""
    msgs = base()
    calls = []
    for tool, args, res in steps:
        calls.append(ctx_tokens(msgs))           # この手順を決めるLLM呼び出し
        msgs += step_msgs(tool, args, res)
        if clear:
            trigger, keep = clear
            if ctx_tokens(msgs) > trigger:
                tool_idx = [i for i, m in enumerate(msgs) if m["role"] == "tool" and m["content"] != "[cleared]"]
                for i in tool_idx[:-keep]:
                    msgs[i] = {**msgs[i], "content": "[cleared]"}
    calls.append(ctx_tokens(msgs))               # 最終回答を書くLLM呼び出し
    return msgs, calls
測定結果
実行したときの出力は次のとおりです(ファイル別のトークン数の行とメモの中身の行は省略しています)。
A 全部残す: LLM呼び出し 18回 / 最大 121,955 / 最終 121,955 / 累計入力 766,303 / 根拠の行が最終コンテキストに残る True / 根拠の行より後ろのトークン 120,624 / 全体 121,955
B クリア trigger=100,000 keep=3: LLM呼び出し 18回 / 最大 96,176 / 最終 46,190 / 累計入力 690,538 / 根拠の行が最終コンテキストに残る False
B クリア trigger=30,000 keep=3: LLM呼び出し 18回 / 最大 46,190 / 最終 46,190 / 累計入力 342,823 / 根拠の行が最終コンテキストに残る False
C 必要な行だけ読む: LLM呼び出し 18回 / 最大 10,579 / 最終 10,579 / 累計入力 110,719 / 根拠の行が最終コンテキストに残る True
D メモに書き出してリセット: LLM呼び出し 21回 / 最大 56,401 / 最終 926 / 累計入力 303,272 / 根拠の行が最終コンテキストに残る True / メモのトークン 559
E サブエージェント(メイン側): LLM呼び出し 5回 / 最大 1,089 / 最終 1,089 / 累計入力 3,552 / 根拠の行が最終コンテキストに残る True
  サブエージェントの最大コンテキスト [14752, 20680, 32248, 57757] / サブ側の累計入力 299,722 / メイン+サブの累計入力 303,274
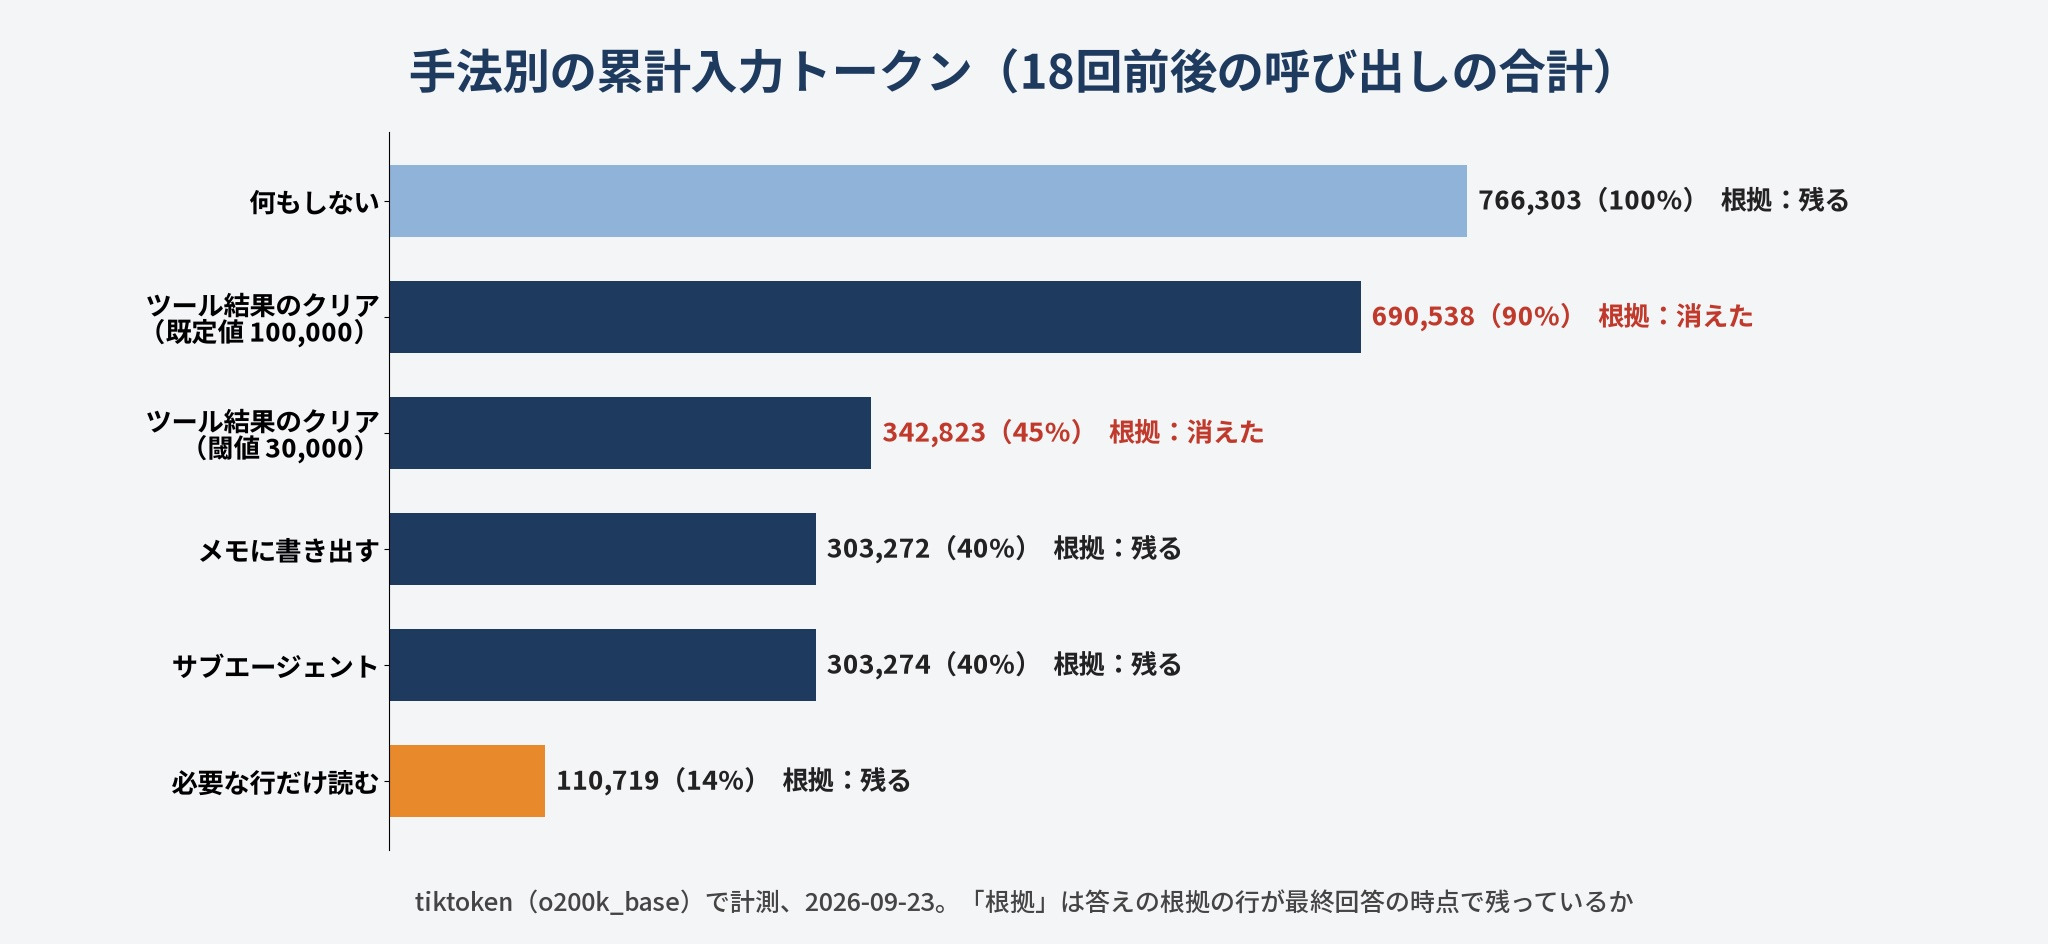
読みやすいように表に直します。累計入力は、すべての呼び出しで送った入力トークンの合計です。
| 条件 | 1回の呼び出しの最大 | 累計入力(何もしない場合との比) | 最終回答の時点で根拠が残るか |
|---|---|---|---|
| 1 何もしない | 121,955 | 766,303(100%) | 残る |
| 2 クリア(閾値100,000) | 96,176 | 690,538(90%) | 消えた |
| 2 クリア(閾値30,000) | 46,190 | 342,823(45%) | 消えた |
| 3 必要な行だけ読む | 10,579 | 110,719(14%) | 残る |
| 4 メモに書き出す | 56,401 | 303,272(40%) | 残る(メモの中に) |
| 5 サブエージェント | メイン1,089、サブ最大57,757 | 303,274(40%) | 残る(要約の中に) |
この表で目を引くのは、削減量が最も大きい条件と、根拠が残る条件が一致していない点です。3つの発見に分けて説明します。
ツール結果のクリアは、答えの根拠まで消した
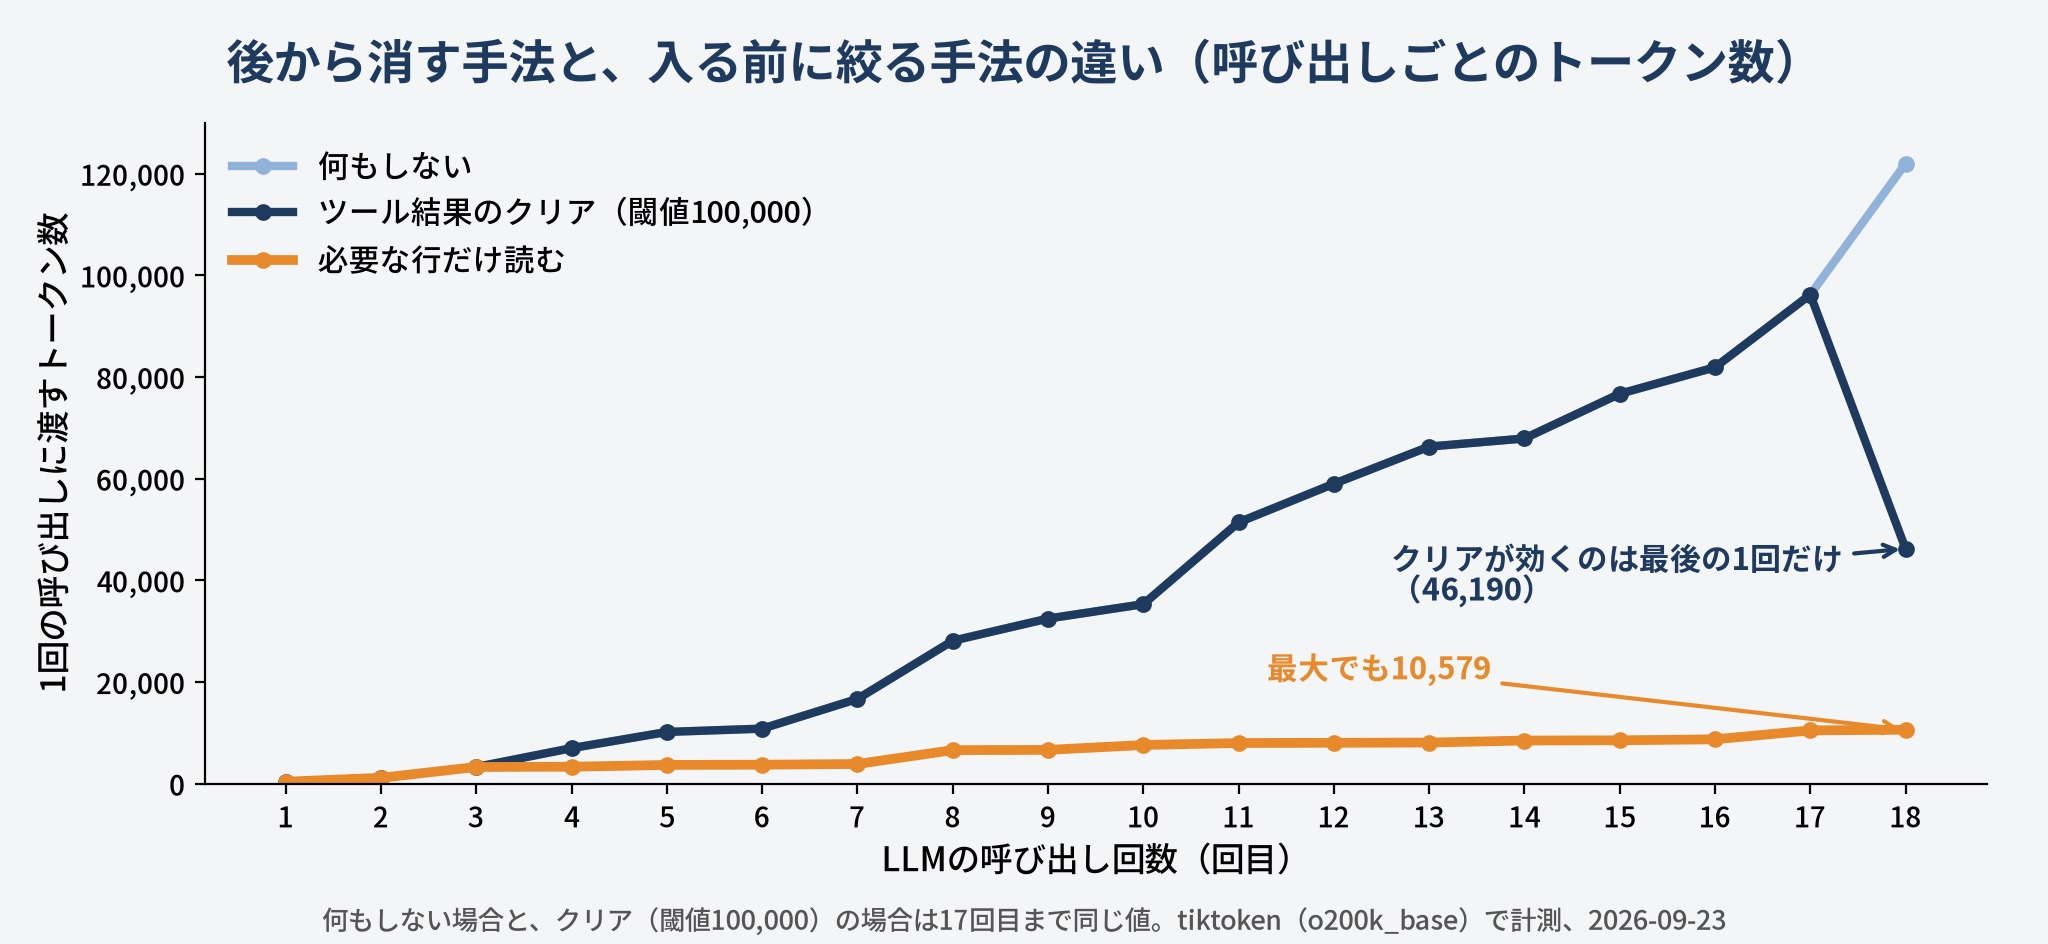
Claude APIの既定値(閾値100,000・直近3件を残す)にそろえた条件では、クリアは最後に1回しか発動しませんでした。15ファイル目の email/_header_value_parser.py(25,749トークン)を読んだ時点で100,000トークンを超え、最終回答の呼び出しは46,190トークンまで下がりました。一方で、それまでの17回の呼び出しには効かないため、累計入力は約10%しか減っていません。
問題は、消えたものの中身です。最終回答を書く呼び出しには、直近3ファイルの中身しか残らず、答えの根拠になる json/decoder.py の計算式は消えていました。閾値を30,000トークンに下げると累計入力は45%まで減りましたが、根拠が消える点は同じでした。
ツール結果のクリアは、「処理し終えた結果を、モデルはもう見なくてよい」という前提に立った手法です。ところが比較や集計のように、最初に読んだ情報を最後にもう一度使う課題では、この前提が崩れます。対策は、残す必要がある結果を exclude_tools で指定するか、消す前に要点をメモへ書き出すことです。
必要な行だけ読むと、累計入力は7分の1になった
削減量が最も大きかったのは、grepで当たった行の前後5行だけを返す条件です。1回の呼び出しの最大は10,579トークン、累計入力は110,719トークンで、何もしない場合の約7分の1でした。根拠の行も最後まで残っています。
効いた理由は単純で、コンテキストに入る前の段階で量を減らしているからです。クリアや要約は、一度載せたものを後から減らす手法です。後から減らす手法は、載せていたあいだの呼び出しでは重さを払い続けます。Anthropicが just in time の取得やトークン効率の良いツール設計を強調するのは、この差があるからだと読めます。
ただし、この条件がうまくいったのは、grepの条件(lineno|colno|class \w*Error)が課題にぴったり合っていたからでもあります。条件から漏れた行は、はじめからモデルに見えません。絞り込みの条件を誰がどう決めるかが、この手法の弱点です。
メモとサブエージェントは最大値を抑えるが、要約の質に頼る
メモに書き出す条件では、メモを書く直前の呼び出しが最大56,401トークンまで伸びましたが、書き出してリセットしたあとの最終回答は926トークンで済みました。メモ全体は559トークンです。累計入力は何もしない場合の40%でした。
サブエージェントの条件では、メインのエージェントの呼び出しは最大でも1,089トークンでした。4つのサブエージェントが返した要約は79〜193トークンです。一方で、サブエージェントは自分のコンテキストでファイルを丸ごと読むため、最大57,757トークンまで伸びています。メインとサブを合わせた累計入力は303,274トークンで、メモの条件とほぼ同じになりました。
どちらの条件でも根拠は残りましたが、それはメモと要約に「計算式の行を書き写す」処理を入れていたからです。今回は grep で抜き出したので確実に残りましたが、LLMに要約させると、何を残すかはプロンプトとモデル次第になります。Anthropicが要約のプロンプトについて「まず取りこぼしを無くすことを優先し、そのあとで余計な部分を削る」順番で調整するよう勧めているのは、このためです。
1回の台本、1種類の課題、1つのトークナイザーでの測定なので、手法の優劣を一般化する根拠にはなりません。課題が変われば、メモやサブエージェントのほうが有利になる場面もあります。自分のエージェントで同じ測り方を試すことが、次の手順の出発点です。
ここまでコンテキストエンジニアリングの手法を実測で比べましたが、「自分のエージェントでどの手法が効くかを測って決めたいが、その測り方が妥当なのかを確かめる相手が社内にいない」という方も多いと思います。
リベルクラフトが運営するCraft Collegeのデータサイエンティスト養成講座 Advanced は、Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムです。LLMアプリケーションの設計、コンテキストエンジニアリング、RAG、評価とLLM-as-a-Judge、AIエージェントまでを、既製のフレームワークに寄せず生のAPIと自作のコードで実装しながら進めます。本記事で行った「トークン数を測ってから手法を選ぶ」作業を、毎週の実装課題と現役データサイエンティストのコードレビューを通じて身につけられます。
まずは講座の内容を確認してみてください。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
AIエージェントにコンテキストエンジニアリングを入れる6つの手順
実測で手法ごとの効き方と副作用が分かったので、自分のエージェントに手法を入れる手順を6段階にまとめます。上から順に進めると、入る前に量を減らす手法を先に入れ、情報を捨てる手法を後に回せます。
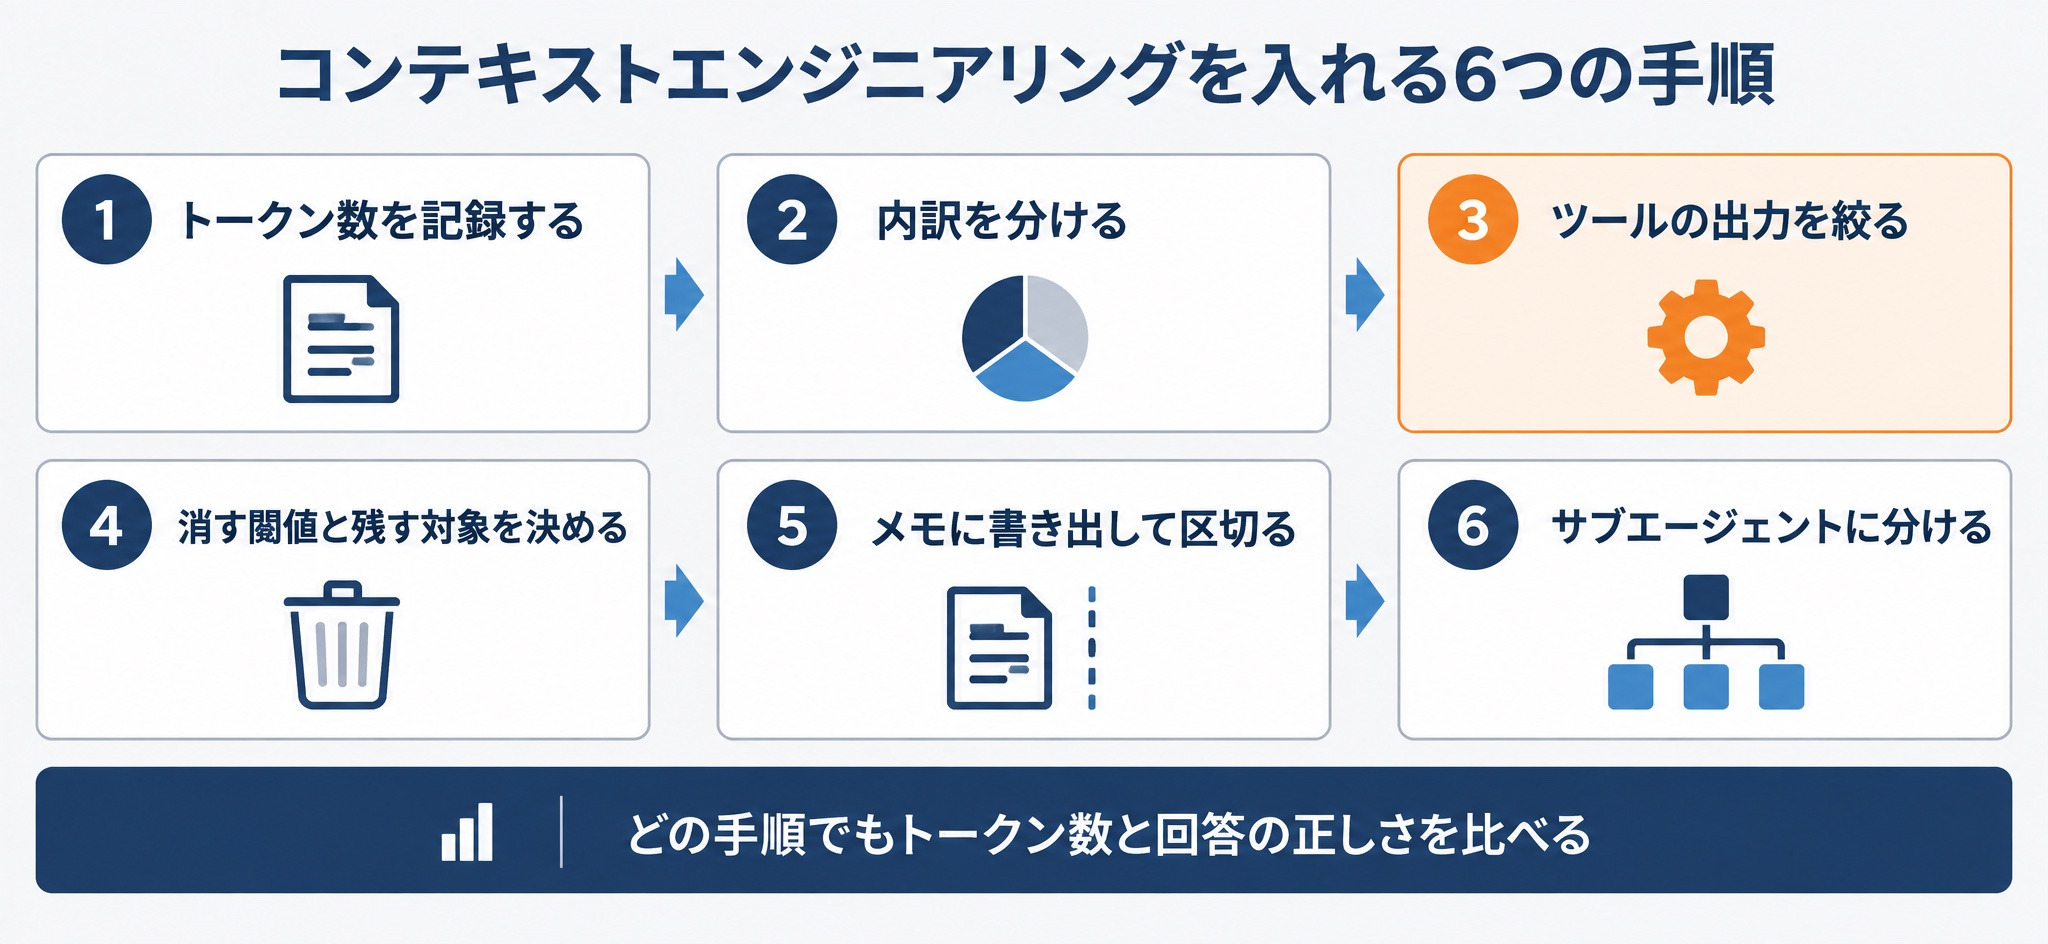
- 呼び出しごとのトークン数を記録する。エージェントがLLMを呼ぶたびに、入力トークン数と出力トークン数をログに残します。多くのAPIは応答に使用量を含めて返すので、それを保存するだけで始められます。最大値と、ループ全体の合計の両方を見ます
- コンテキストの内訳を分ける。システムプロンプト、ツール定義、会話履歴、ツール結果、検索結果のそれぞれが何トークンかを数えます。本記事の測定では、最後の呼び出しの121,955トークンのうち118,277トークンがファイルの中身でした。内訳を見ると、どこから手を付けるかが決まります
- ツールの出力を、入る前に絞る。ツール結果が大きいなら、最初に手を入れるのはツール側です。ファイルは行範囲を、検索は件数と返す項目を、APIの応答は必要なフィールドだけを返すようにします。本記事では、この手順だけで累計入力が約7分の1になりました
- 消す・圧縮するの閾値を決め、残す対象を指定する。それでも長くなるタスクには、ツール結果のクリアや要約を足します。このとき、最後まで要る結果を出すツールは消さない対象に指定します。Claude APIなら
exclude_tools、自前で実装するなら消す前に要点を残す処理を入れます - 長いタスクでは、メモに書き出してから区切る。数十回以上ツールを呼ぶタスクでは、一定の区切りで進捗・決定・未解決の点をメモに書かせ、コンテキストをメモから再開させます。メモに毎回書く項目を先に決めておくと、取りこぼしが減ります
- 独立して調べられる部分を、サブエージェントに分ける。調査対象が互いに独立していて並列に進められる場合は、その調査をサブエージェントに任せ、メインのエージェントは結果の統合だけを受け持ちます。サブエージェントに返させる要約の形式(根拠にしたファイル名と行番号を含めることなど)も、あらかじめ指示しておきます
どの手順でも、変更の前後で同じ評価用の課題を流し、トークン数と回答の正しさの両方を比べます。トークン数だけが下がって答えが間違うようになったなら、その変更は失敗です。
コンテキストエンジニアリングで注意すること
手順を進めるときにつまずきやすい点を、4つ押さえておきます。
トークン数はトークナイザーで変わる
本記事の数値は、tiktoken が GPT-4o 以降のモデルに割り当てているトークナイザー o200k_base で数えたものです。Claude・Gemini・オープンソースのモデルは、それぞれ別のトークナイザーを使うため、同じ文章でもトークン数は変わります。
同じ台本を、tiktoken が GPT-4 に割り当てている cl100k_base で数え直すと、何もしない条件の累計入力は761,713トークン、必要な行だけ読む条件は110,471トークンで、比率はどちらのトークナイザーでも約14%でした。ただし今回読んだのは英語のコードが中心のファイルです。日本語の文書を多く読むエージェントでは、トークナイザーによる差が広がる可能性があります。
トークン数をコンテキストウィンドウの上限や閾値と比べるときは、実際に使うモデルのトークナイザーで数え直してください。多くのAPIは、送る前にトークン数を数える方法や、応答に含まれる使用量で、そのモデルでの正確な値を返します。
消すとプロンプトキャッシュが無効になる
プロンプトキャッシュは、前回と同じ先頭部分の計算結果を再利用して、費用と遅延を下げる仕組みです。Claude APIの Context editing のドキュメントは、ツール結果をクリアするとキャッシュ済みの先頭部分が無効になり、書き直しの費用がかかると書いています。
そのため、少しずつ頻繁に消すと、キャッシュが効かなくなってかえって高くつくことがあります。同じドキュメントは、1回に消す最小量を決める clear_at_least を使い、キャッシュを捨てる価値があるだけの量をまとめて消すよう勧めています。
サブエージェントは合計のトークンを増やすことがある
Anthropicは「How we built our multi-agent research system」(2025年6月13日公開)で、Claude Opus 4 をリード、Claude Sonnet 4 をサブエージェントにした構成が、社内の調査評価で単一の Claude Opus 4 を90.2%上回ったと報告しています。一方で、エージェントはチャットの約4倍、マルチエージェントは約15倍のトークンを使うとも書いています。
本記事の測定でも、サブエージェントの条件はメインの呼び出しこそ最大1,089トークンでしたが、合計ではメモの条件とほぼ同じトークンを使いました。サブエージェントはメインのコンテキストを守る手法で、合計の費用を下げる手法ではありません。調べる範囲が広く、並列に進める価値があるタスクに向いています。
要約とメモは、評価で確かめてから信用する
要約・メモ・サブエージェントの返す要約は、どれもLLMが「何を残すか」を判断します。残し方を誤ると、Context Poisoning と同じく、誤りや欠落がそれ以降の判断の前提になります。
要約を入れたら、要約前の履歴と要約後のコンテキストで同じ質問に答えさせ、答えが変わらないかを確かめます。評価用の課題を固定し、手法を変えるたびに流し直す運用が、コンテキストエンジニアリングを安全に続ける土台になります。
まとめ
- コンテキストエンジニアリングとは、LLMの推論のあいだ、最適な情報の集合を選び、維持する設計です。プロンプトはその一部で、ツール定義・履歴・ツール結果・検索結果・メモまでが対象になります
- プロンプトエンジニアリングとの違いは、書き方と載せ方の違いです。エージェントでは、呼び出しのたびに何を載せるかを決め直す作業になります
- AIエージェントでは、ツール結果が積み上がってコンテキストが肥大化します。15ファイルを読む台本で、最後の呼び出しは121,955トークン、18回の累計は766,303トークンでした
- 長いコンテキストでは、中の情報を使えなくなります。context rot と呼ばれ、研究では関連部分だけの入力のほうが成績が高く出ています
- 手法は、書き出す・選ぶ・圧縮する・分けるの4つに整理できます。必要な行だけ読む、ツール結果のクリア、要約、メモ、サブエージェントがその具体例です
- 入る前に絞る手法が最も効きました。必要な行だけ読む条件で、累計入力は約7分の1になり、根拠も残りました
- 後から消す手法は、根拠まで消すことがあります。クリアの条件では、答えの根拠になるファイルの中身が最終回答の前に消えました
- 入れる順番は、計測、内訳、ツール出力の絞り込み、消す閾値と除外、メモ、サブエージェントです。どの段階でも、トークン数と回答の正しさを両方比べます
コンテキストエンジニアリングを体系的に学ぶなら「Craft College」へ
本記事で扱ったのは、エージェントの各呼び出しに何トークン載っているかを測り、内訳に応じて手法を選ぶという作業でした。実務でこの次に来るのは、評価用の課題を資産として持ち、モデルやツールを替えるたびにトークン数と回答の正しさを測り直す仕組みです。
リベルクラフトが運営するCraft Collegeでは、データサイエンティスト養成講座 Advanced を提供しています。Python・SQL・機械学習の基礎がある実務者を対象にした12週の上級プログラムで、LLMアプリケーションの設計、コンテキストエンジニアリング、RAG、マルチモーダルAI、評価とLLM-as-a-Judge、AIエージェントとマルチエージェント、LLMセキュリティ、ローカルLLM、ファインチューニング、卒業制作までを扱います。既製のフレームワークに寄せず、生のAPIと自作のコードで骨格を実装するのが方針です。毎週の実装課題には現役データサイエンティストのコードレビューが付き、少人数のコホートで進みます。
機械学習の基礎から始めたい方には、9ヶ月36週のデータサイエンティスト養成講座があります。AIと一緒に開発を始めるところから、社内ナレッジAIの構築、データサイエンスの基礎、ポートフォリオ作成まで、段階的に進む構成です。厚生労働省の専門実践教育訓練給付制度の対象講座のため、条件を満たせば受講費用の最大80%が給付金として支給される可能性があります。支給の可否は最終的にハローワーク等が判断します。
リベルクラフトでは、AI開発・データサイエンス開発の支援も行っています。AIエージェントの設計、ツールと検索基盤の設計、評価用データの作り方、精度やコストが想定と合わないときの原因の切り分けまで、要件定義からPoC、本番運用までを一貫して支援しています。自社のデータで何から手を付けるかを決める段階からご相談いただけます。
⇨Craft College データサイエンティスト養成講座 Advanced の詳細はこちら
⇨AI開発・データサイエンス開発支援の無料相談はこちら
この記事を書いた人
慶應義塾大学で金融工学を専攻。 卒業後はスタートアップのデータサイエンティストとして、AI・データ活用コンサルティング事業などに従事。 その後、株式会社セブン&アイ・ホールディングスにて、小売・物流事業におけるAI・データ活用の推進に貢献。 株式会社リベルクラフトを設立し、AIやデータサイエンスなどデータ活用領域に関する受託開発・コンサルティングや法人向けトレーニング、教育事業を展開。